rbm20 cDNA ORF clone, Poecilia reticulata(guppy)

The following rbm20 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the rbm20 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPo166880 XM_008411124.2
Latest version!
Poecilia reticulata RNA binding motif protein 20 (rbm20), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OPo166881 XM_008411197.2
Latest version!
Poecilia reticulata RNA binding motif protein 20 (rbm20), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPo166880
    Clone ID Related Accession (Same CDS sequence) XM_008411124.2
    Accession Version XM_008411124.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3285bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
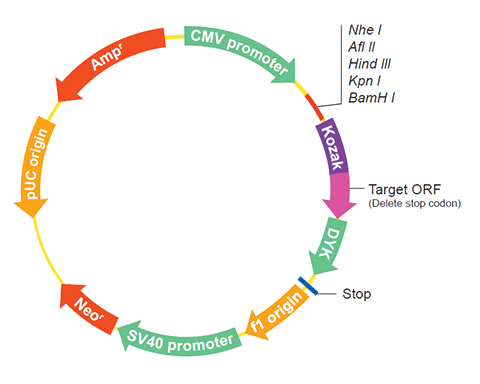
    Clone information Clone Map MSDS
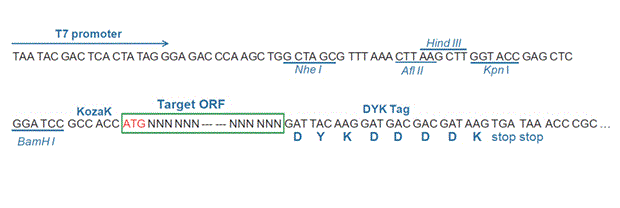
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product RNA-binding protein 20 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024331.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 21, 2016 this sequence version replaced XM_008411124.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGGGAA AAGGGCACGG CGGCGGCGCG TACGTCCCTG AGATGAACGA AGCACTGCAG 
    AGCATTATAT CACCGCCGTT GGACAGCACA GAGAAGAAGG GTCTTCTGGT GGCTGCCCAG
    CTGCCAGGCA ATGTGCAAGC TGGACCTCAG CTGCCGAACC AGTTCCTCCT GACCCCAGCA
    AGCCTTCAGC TTGCTCAGCT CCAGGCCCAG CTCACCCTCC ATCGCCTCAA ACTGGCTCAG
    GGAGGAAACA CGGCCAACGC CGCCAGCATT CTCAACCAGT TGATTTCCAA TGTCAACATG
    TCCCAGCCCC TGTTGAATCA ATTAAGGAGT TCGTCTTTGG TCGGGAATCC ACAGGGGGCC
    TTCCCCACTG GGGTGATTGG GTTCCCCTCC TCAAATTCAG CCGTTGGGTC GTTGGTGGGT
    GGGGCATTCA ACCAAAACTC AGGGAATGTG CGACTGGATC ATGCTTGTGG AGGGGCTGGG
    AAGGGGCAAC AAGGTGGGGA GTACGGAAAA AATCCTGGAT CAACTTACTC TTCTGACACC
    GACAGACGTC TTCAGTACAG CTTATCTGGA GGAACATCTG CTGACGGACA GTACGCGGGG
    ATTAAATCTC AGGCCAAGAA CATGACCAAT GTTGGCTTTC ACAGAGATTT CTACGGGCAT
    GAATTGCAGG GACAACCAGT TGGGTTTAGC TCCAATGAGC CAGTGAACTC CACCGCACAT
    AAGGAGCAAT GGAAAGGCCA TAACAACTTA AACCAAACTG GAAAGGTGAA CATGGCTTCA
    AACCCTCCCA CAGCATGGCC TTCAGCTGGG CAGCCCATTT GGTCCAGAAC AGAACTGTAC
    AACCCAGAAG AGCCGACCCC CGAGCCCAAG CTGAACTGTA GCGGGGTTTC CTCTTTCGGA
    TCCAGTGGCC CGCAGGGCTT CGGAAGCTAC CAGAACCTGC ATGGGGGCGA GGAAACCCTG
    TCGTCAGGTA CCAGGACACT CCAGGCCCAT CAAGTCAGTG ACTTTTATGG CATTASGCCT
    TCCCAGCTGC CACATCAGTG CAGCATCTGT GAAAAAAAGG TCTACAACCT CAAGGACTGG
    GACCAGCATG TGAAGGGGAA ACTACATCTG CAGAATCAAA CTTTGTACGC CACCGACAGC
    TCAGCGGCGG CGGCGGCCGG AGCCCCTCAG TACGCCGTCG GCAGGCCGTG TGATGGAGGG
    ACGAACCCAG GAGGGACGAA CCCCACAGTC GGCTCCGCCG CAAGTCAAGA TGTGTCGTCA
    GGAACCAAAG CCTCATACCT GCCAGCAGCA GCCATGAAGA CGTATCCCAC AGCAGACGCA
    GCGTTTACCC CCCACCAGCC GGAGTCAAAG CCGTTTCCAC CCAGGAAGGC CTCGGCCGGC
    CGCGTCGTTC ACATCTGCAA CCTGCCCGAA GGCAGCTGCA CGGAGAACGA CGTCATCAAC
    CTGGGAATAC CGTTCGGGAA GGTCACCAAC TACATCCTGA TGCGCTCAAC CCATCAGGCC
    TTTCTGGAGA TGGCGTATGT AGAGGCAGCT CAGGCCATGG TTCAATACTA TCAACTGACT
    CCGGCCACGA TTAACGGTCA GAAACTCCTC ATACGGATGT CTAAGAGGTA CAAGGAGCTG
    CAGCTCAAGA AACCTGGTAA AGATGTTCAG TCAATCATCC AGGATATTAC CTCACAGCAG
    GAAAGGGACA AAATGCAAGA ACTTGAACAC TACCTTCCAG ACAGAGCGCG GTCTCGCAGC
    CCCATCAGCC GCTCCCTGAG TCCTCATTCC CACAGTCCCA GTTTCACGTC GTGCAGCTCT
    GCCCACAGCC CCCCGGCGGC TCCGTGCCGG GGTCAGGACA GGGGCAGCAA CGGCCTGAGC
    CCTCACCGGG GCTCCAGAGA CTGGATATCG CACTTGAGAC GAGGGGAGGA TGAGAGGGAG
    CGGGACGGTC CCTGGAGGAA CGGCGGCAGC GGCGGCGGTG GCAGCATGGA CGACAGTCGA
    CCCAACGGGA GGACGGCCGA CCGGTGGAAG AGCTACCACA AACACTTGGG TCACTTGAGG
    TCAACAGACG AACGCGGAAG CGGCGAAGCG ACAACGACGA GGAGCAGCAG AGACTGGCAC
    CCGCGGGACA GCCCCCTGGG CTCGTCTTTC AACTCCTACA GGAGCATGGA CGAAGATTTC
    AGCAGGACAT CTCACTATCG GCATGACGCA AAGCCGAGGA GGAGGGACGG CGACCACCCC
    GTCCGGTCGA GACACTCCGA GTTTGAGACG ACGAACGAGC CGCGGTGTCG AACGCCGGAG
    GACAAGAGGC GGAGCAGAAA CCCGAGCAGG AGGCACGCCG AGAAACAGGA GAGAGAAGCT
    GCTCCCGAAA ACACTGACGC CGCAGCCAAA GAAAAATCTG TTCTGCCACA ACAAAGCAAC
    AAGTCAAGAG AGGCGGCTGA AAATGACAAG GACGGAGAAA CTGAGAATGT GCTGGAAAGT
    GCCGAGGACA CGGATGAAGA ATGTTGGTAT CCCAAAAACA TGGAGGAGCT GGTCACGGTG
    GATGAAGTGG GAGGGGAGGA CGACTGCATC CTCGAGCCAG ATCTCTCTGA GCTCGAGGAG
    TTTGCTTCCT GTCGCAAACA GCCGATAGCG GAGCAACCGC AGCAGAAGCC CACGTCTCCA
    TCGACTACAG CAGTGGAGGA GCACAAAGAA TCCGGCGAGA AACCTAAACG GGAGGACTCT
    GTTGAGGAGA TGGGGGGCGA GGCGTCAGCA TCCAAAGTTG AGAAAGCAGA GGATCAAATC
    GCCGCACCAA GTACTGAAAC CGAGAAAGTG AATTTAGAGA CGACAGAGCA AAAAGTGTCG
    GACATCAGTG GCTTCCCCAG TGAGGAGTTC AAAGCGGCGC TAGAGGAGAC GTGCTTGGAG
    AGCGCCAAGC TTCCCAACAA CACGGCGCCG GAGGAGCCAA TGGAAAATCA TGTCTGTTTG
    TTAGACGACA GCAGAAGCCA GGAAGAAACA CAGACTCCAG ATAAAATCCA TCTGGAAGTT
    CAGCTGAAGG ACGTCAGTCT GAAAAGAGAG ATCGAAGCCC CCTCCTCATC TCTAGAGCAG
    GACAAAGCTG TCAGTGAACA CAGCATTCCT TTGGGAGTGG AGTTCATTGA GCCAAGAACA
    GGCTTCTACT GCAAACTGTG TGGCTTGTTC TACAGCAGCG AGGACACTGC AAAAACCACT
    CACTGCCGCA GCACCGTACA CTACAGAAAC CTGCAGAAAT ACCTGTCCCA GCTGGCAGAG
    AACGGCCTGT CGAGCGCGCT GGCTGAACCC TCCGCGGCGC ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008409346.1
    CDS428..3712
    Translation

    Target ORF information:

    RefSeq Version XM_008411124.2
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata RNA binding motif protein 20 (rbm20), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008411124.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGGGAA AAGGGCACGG CGGCGGCGCG TACGTCCCTG AGATGAACGA AGCACTGCAG 
    AGCATTATAT CACCGCCGTT GGACAGCACA GAGAAGAAGG GTCTTCTGGT GGCTGCCCAG
    CTGCCAGGCA ATGTGCAAGC TGGACCTCAG CTGCCGAACC AGTTCCTCCT GACCCCAGCA
    AGCCTTCAGC TTGCTCAGCT CCAGGCCCAG CTCACCCTCC ATCGCCTCAA ACTGGCTCAG
    GGAGGAAACA CGGCCAACGC CGCCAGCATT CTCAACCAGT TGATTTCCAA TGTCAACATG
    TCCCAGCCCC TGTTGAATCA ATTAAGGAGT TCGTCTTTGG TCGGGAATCC ACAGGGGGCC
    TTCCCCACTG GGGTGATTGG GTTCCCCTCC TCAAATTCAG CCGTTGGGTC GTTGGTGGGT
    GGGGCATTCA ACCAAAACTC AGGGAATGTG CGACTGGATC ATGCTTGTGG AGGGGCTGGG
    AAGGGGCAAC AAGGTGGGGA GTACGGAAAA AATCCTGGAT CAACTTACTC TTCTGACACC
    GACAGACGTC TTCAGTACAG CTTATCTGGA GGAACATCTG CTGACGGACA GTACGCGGGG
    ATTAAATCTC AGGCCAAGAA CATGACCAAT GTTGGCTTTC ACAGAGATTT CTACGGGCAT
    GAATTGCAGG GACAACCAGT TGGGTTTAGC TCCAATGAGC CAGTGAACTC CACCGCACAT
    AAGGAGCAAT GGAAAGGCCA TAACAACTTA AACCAAACTG GAAAGGTGAA CATGGCTTCA
    AACCCTCCCA CAGCATGGCC TTCAGCTGGG CAGCCCATTT GGTCCAGAAC AGAACTGTAC
    AACCCAGAAG AGCCGACCCC CGAGCCCAAG CTGAACTGTA GCGGGGTTTC CTCTTTCGGA
    TCCAGTGGCC CGCAGGGCTT CGGAAGCTAC CAGAACCTGC ATGGGGGCGA GGAAACCCTG
    TCGTCAGGTA CCAGGACACT CCAGGCCCAT CAAGTCAGTG ACTTTTATGG CATTASGCCT
    TCCCAGCTGC CACATCAGTG CAGCATCTGT GAAAAAAAGG TCTACAACCT CAAGGACTGG
    GACCAGCATG TGAAGGGGAA ACTACATCTG CAGAATCAAA CTTTGTACGC CACCGACAGC
    TCAGCGGCGG CGGCGGCCGG AGCCCCTCAG TACGCCGTCG GCAGGCCGTG TGATGGAGGG
    ACGAACCCAG GAGGGACGAA CCCCACAGTC GGCTCCGCCG CAAGTCAAGA TGTGTCGTCA
    GGAACCAAAG CCTCATACCT GCCAGCAGCA GCCATGAAGA CGTATCCCAC AGCAGACGCA
    GCGTTTACCC CCCACCAGCC GGAGTCAAAG CCGTTTCCAC CCAGGAAGGC CTCGGCCGGC
    CGCGTCGTTC ACATCTGCAA CCTGCCCGAA GGCAGCTGCA CGGAGAACGA CGTCATCAAC
    CTGGGAATAC CGTTCGGGAA GGTCACCAAC TACATCCTGA TGCGCTCAAC CCATCAGGCC
    TTTCTGGAGA TGGCGTATGT AGAGGCAGCT CAGGCCATGG TTCAATACTA TCAACTGACT
    CCGGCCACGA TTAACGGTCA GAAACTCCTC ATACGGATGT CTAAGAGGTA CAAGGAGCTG
    CAGCTCAAGA AACCTGGTAA AGATGTTCAG TCAATCATCC AGGATATTAC CTCACAGCAG
    GAAAGGGACA AAATGCAAGA ACTTGAACAC TACCTTCCAG ACAGAGCGCG GTCTCGCAGC
    CCCATCAGCC GCTCCCTGAG TCCTCATTCC CACAGTCCCA GTTTCACGTC GTGCAGCTCT
    GCCCACAGCC CCCCGGCGGC TCCGTGCCGG GGTCAGGACA GGGGCAGCAA CGGCCTGAGC
    CCTCACCGGG GCTCCAGAGA CTGGATATCG CACTTGAGAC GAGGGGAGGA TGAGAGGGAG
    CGGGACGGTC CCTGGAGGAA CGGCGGCAGC GGCGGCGGTG GCAGCATGGA CGACAGTCGA
    CCCAACGGGA GGACGGCCGA CCGGTGGAAG AGCTACCACA AACACTTGGG TCACTTGAGG
    TCAACAGACG AACGCGGAAG CGGCGAAGCG ACAACGACGA GGAGCAGCAG AGACTGGCAC
    CCGCGGGACA GCCCCCTGGG CTCGTCTTTC AACTCCTACA GGAGCATGGA CGAAGATTTC
    AGCAGGACAT CTCACTATCG GCATGACGCA AAGCCGAGGA GGAGGGACGG CGACCACCCC
    GTCCGGTCGA GACACTCCGA GTTTGAGACG ACGAACGAGC CGCGGTGTCG AACGCCGGAG
    GACAAGAGGC GGAGCAGAAA CCCGAGCAGG AGGCACGCCG AGAAACAGGA GAGAGAAGCT
    GCTCCCGAAA ACACTGACGC CGCAGCCAAA GAAAAATCTG TTCTGCCACA ACAAAGCAAC
    AAGTCAAGAG AGGCGGCTGA AAATGACAAG GACGGAGAAA CTGAGAATGT GCTGGAAAGT
    GCCGAGGACA CGGATGAAGA ATGTTGGTAT CCCAAAAACA TGGAGGAGCT GGTCACGGTG
    GATGAAGTGG GAGGGGAGGA CGACTGCATC CTCGAGCCAG ATCTCTCTGA GCTCGAGGAG
    TTTGCTTCCT GTCGCAAACA GCCGATAGCG GAGCAACCGC AGCAGAAGCC CACGTCTCCA
    TCGACTACAG CAGTGGAGGA GCACAAAGAA TCCGGCGAGA AACCTAAACG GGAGGACTCT
    GTTGAGGAGA TGGGGGGCGA GGCGTCAGCA TCCAAAGTTG AGAAAGCAGA GGATCAAATC
    GCCGCACCAA GTACTGAAAC CGAGAAAGTG AATTTAGAGA CGACAGAGCA AAAAGTGTCG
    GACATCAGTG GCTTCCCCAG TGAGGAGTTC AAAGCGGCGC TAGAGGAGAC GTGCTTGGAG
    AGCGCCAAGC TTCCCAACAA CACGGCGCCG GAGGAGCCAA TGGAAAATCA TGTCTGTTTG
    TTAGACGACA GCAGAAGCCA GGAAGAAACA CAGACTCCAG ATAAAATCCA TCTGGAAGTT
    CAGCTGAAGG ACGTCAGTCT GAAAAGAGAG ATCGAAGCCC CCTCCTCATC TCTAGAGCAG
    GACAAAGCTG TCAGTGAACA CAGCATTCCT TTGGGAGTGG AGTTCATTGA GCCAAGAACA
    GGCTTCTACT GCAAACTGTG TGGCTTGTTC TACAGCAGCG AGGACACTGC AAAAACCACT
    CACTGCCGCA GCACCGTACA CTACAGAAAC CTGCAGAAAT ACCTGTCCCA GCTGGCAGAG
    AACGGCCTGT CGAGCGCGCT GGCTGAACCC TCCGCGGCGC ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPo166881
    Clone ID Related Accession (Same CDS sequence) XM_008411197.2
    Accession Version XM_008411197.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3285bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product RNA-binding protein 20 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024331.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 21, 2016 this sequence version replaced XM_008411197.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGGATCATA AACTCTGGCA AACTGCAGAA AGAAACAGAT GCACCAGTCC AAGGAAAAAG 
    ACCATTATAT CACCGCCGTT GGACAGCACA GAGAAGAAGG GTCTTCTGGT GGCTGCCCAG
    CTGCCAGGCA ATGTGCAAGC TGGACCTCAG CTGCCGAACC AGTTCCTCCT GACCCCAGCA
    AGCCTTCAGC TTGCTCAGCT CCAGGCCCAG CTCACCCTCC ATCGCCTCAA ACTGGCTCAG
    GGAGGAAACA CGGCCAACGC CGCCAGCATT CTCAACCAGT TGATTTCCAA TGTCAACATG
    TCCCAGCCCC TGTTGAATCA ATTAAGGAGT TCGTCTTTGG TCGGGAATCC ACAGGGGGCC
    TTCCCCACTG GGGTGATTGG GTTCCCCTCC TCAAATTCAG CCGTTGGGTC GTTGGTGGGT
    GGGGCATTCA ACCAAAACTC AGGGAATGTG CGACTGGATC ATGCTTGTGG AGGGGCTGGG
    AAGGGGCAAC AAGGTGGGGA GTACGGAAAA AATCCTGGAT CAACTTACTC TTCTGACACC
    GACAGACGTC TTCAGTACAG CTTATCTGGA GGAACATCTG CTGACGGACA GTACGCGGGG
    ATTAAATCTC AGGCCAAGAA CATGACCAAT GTTGGCTTTC ACAGAGATTT CTACGGGCAT
    GAATTGCAGG GACAACCAGT TGGGTTTAGC TCCAATGAGC CAGTGAACTC CACCGCACAT
    AAGGAGCAAT GGAAAGGCCA TAACAACTTA AACCAAACTG GAAAGGTGAA CATGGCTTCA
    AACCCTCCCA CAGCATGGCC TTCAGCTGGG CAGCCCATTT GGTCCAGAAC AGAACTGTAC
    AACCCAGAAG AGCCGACCCC CGAGCCCAAG CTGAACTGTA GCGGGGTTTC CTCTTTCGGA
    TCCAGTGGCC CGCAGGGCTT CGGAAGCTAC CAGAACCTGC ATGGGGGCGA GGAAACCCTG
    TCGTCAGGTA CCAGGACACT CCAGGCCCAT CAAGTCAGTG ACTTTTATGG CATTASGCCT
    TCCCAGCTGC CACATCAGTG CAGCATCTGT GAAAAAAAGG TCTACAACCT CAAGGACTGG
    GACCAGCATG TGAAGGGGAA ACTACATCTG CAGAATCAAA CTTTGTACGC CACCGACAGC
    TCAGCGGCGG CGGCGGCCGG AGCCCCTCAG TACGCCGTCG GCAGGCCGTG TGATGGAGGG
    ACGAACCCAG GAGGGACGAA CCCCACAGTC GGCTCCGCCG CAAGTCAAGA TGTGTCGTCA
    GGAACCAAAG CCTCATACCT GCCAGCAGCA GCCATGAAGA CGTATCCCAC AGCAGACGCA
    GCGTTTACCC CCCACCAGCC GGAGTCAAAG CCGTTTCCAC CCAGGAAGGC CTCGGCCGGC
    CGCGTCGTTC ACATCTGCAA CCTGCCCGAA GGCAGCTGCA CGGAGAACGA CGTCATCAAC
    CTGGGAATAC CGTTCGGGAA GGTCACCAAC TACATCCTGA TGCGCTCAAC CCATCAGGCC
    TTTCTGGAGA TGGCGTATGT AGAGGCAGCT CAGGCCATGG TTCAATACTA TCAACTGACT
    CCGGCCACGA TTAACGGTCA GAAACTCCTC ATACGGATGT CTAAGAGGTA CAAGGAGCTG
    CAGCTCAAGA AACCTGGTAA AGATGTTCAG TCAATCATCC AGGATATTAC CTCACAGCAG
    GAAAGGGACA AAATGCAAGA ACTTGAACAC TACCTTCCAG ACAGAGCGCG GTCTCGCAGC
    CCCATCAGCC GCTCCCTGAG TCCTCATTCC CACAGTCCCA GTTTCACGTC GTGCAGCTCT
    GCCCACAGCC CCCCGGCGGC TCCGTGCCGG GGTCAGGACA GGGGCAGCAA CGGCCTGAGC
    CCTCACCGGG GCTCCAGAGA CTGGATATCG CACTTGAGAC GAGGGGAGGA TGAGAGGGAG
    CGGGACGGTC CCTGGAGGAA CGGCGGCAGC GGCGGCGGTG GCAGCATGGA CGACAGTCGA
    CCCAACGGGA GGACGGCCGA CCGGTGGAAG AGCTACCACA AACACTTGGG TCACTTGAGG
    TCAACAGACG AACGCGGAAG CGGCGAAGCG ACAACGACGA GGAGCAGCAG AGACTGGCAC
    CCGCGGGACA GCCCCCTGGG CTCGTCTTTC AACTCCTACA GGAGCATGGA CGAAGATTTC
    AGCAGGACAT CTCACTATCG GCATGACGCA AAGCCGAGGA GGAGGGACGG CGACCACCCC
    GTCCGGTCGA GACACTCCGA GTTTGAGACG ACGAACGAGC CGCGGTGTCG AACGCCGGAG
    GACAAGAGGC GGAGCAGAAA CCCGAGCAGG AGGCACGCCG AGAAACAGGA GAGAGAAGCT
    GCTCCCGAAA ACACTGACGC CGCAGCCAAA GAAAAATCTG TTCTGCCACA ACAAAGCAAC
    AAGTCAAGAG AGGCGGCTGA AAATGACAAG GACGGAGAAA CTGAGAATGT GCTGGAAAGT
    GCCGAGGACA CGGATGAAGA ATGTTGGTAT CCCAAAAACA TGGAGGAGCT GGTCACGGTG
    GATGAAGTGG GAGGGGAGGA CGACTGCATC CTCGAGCCAG ATCTCTCTGA GCTCGAGGAG
    TTTGCTTCCT GTCGCAAACA GCCGATAGCG GAGCAACCGC AGCAGAAGCC CACGTCTCCA
    TCGACTACAG CAGTGGAGGA GCACAAAGAA TCCGGCGAGA AACCTAAACG GGAGGACTCT
    GTTGAGGAGA TGGGGGGCGA GGCGTCAGCA TCCAAAGTTG AGAAAGCAGA GGATCAAATC
    GCCGCACCAA GTACTGAAAC CGAGAAAGTG AATTTAGAGA CGACAGAGCA AAAAGTGTCG
    GACATCAGTG GCTTCCCCAG TGAGGAGTTC AAAGCGGCGC TAGAGGAGAC GTGCTTGGAG
    AGCGCCAAGC TTCCCAACAA CACGGCGCCG GAGGAGCCAA TGGAAAATCA TGTCTGTTTG
    TTAGACGACA GCAGAAGCCA GGAAGAAACA CAGACTCCAG ATAAAATCCA TCTGGAAGTT
    CAGCTGAAGG ACGTCAGTCT GAAAAGAGAG ATCGAAGCCC CCTCCTCATC TCTAGAGCAG
    GACAAAGCTG TCAGTGAACA CAGCATTCCT TTGGGAGTGG AGTTCATTGA GCCAAGAACA
    GGCTTCTACT GCAAACTGTG TGGCTTGTTC TACAGCAGCG AGGACACTGC AAAAACCACT
    CACTGCCGCA GCACCGTACA CTACAGAAAC CTGCAGAAAT ACCTGTCCCA GCTGGCAGAG
    AACGGCCTGT CGAGCGCGCT GGCTGAACCC TCCGCGGCGC ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008409419.1
    CDS5..3289
    Translation

    Target ORF information:

    RefSeq Version XM_008411197.2
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata RNA binding motif protein 20 (rbm20), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008411197.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGGATCATA AACTCTGGCA AACTGCAGAA AGAAACAGAT GCACCAGTCC AAGGAAAAAG 
    ACCATTATAT CACCGCCGTT GGACAGCACA GAGAAGAAGG GTCTTCTGGT GGCTGCCCAG
    CTGCCAGGCA ATGTGCAAGC TGGACCTCAG CTGCCGAACC AGTTCCTCCT GACCCCAGCA
    AGCCTTCAGC TTGCTCAGCT CCAGGCCCAG CTCACCCTCC ATCGCCTCAA ACTGGCTCAG
    GGAGGAAACA CGGCCAACGC CGCCAGCATT CTCAACCAGT TGATTTCCAA TGTCAACATG
    TCCCAGCCCC TGTTGAATCA ATTAAGGAGT TCGTCTTTGG TCGGGAATCC ACAGGGGGCC
    TTCCCCACTG GGGTGATTGG GTTCCCCTCC TCAAATTCAG CCGTTGGGTC GTTGGTGGGT
    GGGGCATTCA ACCAAAACTC AGGGAATGTG CGACTGGATC ATGCTTGTGG AGGGGCTGGG
    AAGGGGCAAC AAGGTGGGGA GTACGGAAAA AATCCTGGAT CAACTTACTC TTCTGACACC
    GACAGACGTC TTCAGTACAG CTTATCTGGA GGAACATCTG CTGACGGACA GTACGCGGGG
    ATTAAATCTC AGGCCAAGAA CATGACCAAT GTTGGCTTTC ACAGAGATTT CTACGGGCAT
    GAATTGCAGG GACAACCAGT TGGGTTTAGC TCCAATGAGC CAGTGAACTC CACCGCACAT
    AAGGAGCAAT GGAAAGGCCA TAACAACTTA AACCAAACTG GAAAGGTGAA CATGGCTTCA
    AACCCTCCCA CAGCATGGCC TTCAGCTGGG CAGCCCATTT GGTCCAGAAC AGAACTGTAC
    AACCCAGAAG AGCCGACCCC CGAGCCCAAG CTGAACTGTA GCGGGGTTTC CTCTTTCGGA
    TCCAGTGGCC CGCAGGGCTT CGGAAGCTAC CAGAACCTGC ATGGGGGCGA GGAAACCCTG
    TCGTCAGGTA CCAGGACACT CCAGGCCCAT CAAGTCAGTG ACTTTTATGG CATTASGCCT
    TCCCAGCTGC CACATCAGTG CAGCATCTGT GAAAAAAAGG TCTACAACCT CAAGGACTGG
    GACCAGCATG TGAAGGGGAA ACTACATCTG CAGAATCAAA CTTTGTACGC CACCGACAGC
    TCAGCGGCGG CGGCGGCCGG AGCCCCTCAG TACGCCGTCG GCAGGCCGTG TGATGGAGGG
    ACGAACCCAG GAGGGACGAA CCCCACAGTC GGCTCCGCCG CAAGTCAAGA TGTGTCGTCA
    GGAACCAAAG CCTCATACCT GCCAGCAGCA GCCATGAAGA CGTATCCCAC AGCAGACGCA
    GCGTTTACCC CCCACCAGCC GGAGTCAAAG CCGTTTCCAC CCAGGAAGGC CTCGGCCGGC
    CGCGTCGTTC ACATCTGCAA CCTGCCCGAA GGCAGCTGCA CGGAGAACGA CGTCATCAAC
    CTGGGAATAC CGTTCGGGAA GGTCACCAAC TACATCCTGA TGCGCTCAAC CCATCAGGCC
    TTTCTGGAGA TGGCGTATGT AGAGGCAGCT CAGGCCATGG TTCAATACTA TCAACTGACT
    CCGGCCACGA TTAACGGTCA GAAACTCCTC ATACGGATGT CTAAGAGGTA CAAGGAGCTG
    CAGCTCAAGA AACCTGGTAA AGATGTTCAG TCAATCATCC AGGATATTAC CTCACAGCAG
    GAAAGGGACA AAATGCAAGA ACTTGAACAC TACCTTCCAG ACAGAGCGCG GTCTCGCAGC
    CCCATCAGCC GCTCCCTGAG TCCTCATTCC CACAGTCCCA GTTTCACGTC GTGCAGCTCT
    GCCCACAGCC CCCCGGCGGC TCCGTGCCGG GGTCAGGACA GGGGCAGCAA CGGCCTGAGC
    CCTCACCGGG GCTCCAGAGA CTGGATATCG CACTTGAGAC GAGGGGAGGA TGAGAGGGAG
    CGGGACGGTC CCTGGAGGAA CGGCGGCAGC GGCGGCGGTG GCAGCATGGA CGACAGTCGA
    CCCAACGGGA GGACGGCCGA CCGGTGGAAG AGCTACCACA AACACTTGGG TCACTTGAGG
    TCAACAGACG AACGCGGAAG CGGCGAAGCG ACAACGACGA GGAGCAGCAG AGACTGGCAC
    CCGCGGGACA GCCCCCTGGG CTCGTCTTTC AACTCCTACA GGAGCATGGA CGAAGATTTC
    AGCAGGACAT CTCACTATCG GCATGACGCA AAGCCGAGGA GGAGGGACGG CGACCACCCC
    GTCCGGTCGA GACACTCCGA GTTTGAGACG ACGAACGAGC CGCGGTGTCG AACGCCGGAG
    GACAAGAGGC GGAGCAGAAA CCCGAGCAGG AGGCACGCCG AGAAACAGGA GAGAGAAGCT
    GCTCCCGAAA ACACTGACGC CGCAGCCAAA GAAAAATCTG TTCTGCCACA ACAAAGCAAC
    AAGTCAAGAG AGGCGGCTGA AAATGACAAG GACGGAGAAA CTGAGAATGT GCTGGAAAGT
    GCCGAGGACA CGGATGAAGA ATGTTGGTAT CCCAAAAACA TGGAGGAGCT GGTCACGGTG
    GATGAAGTGG GAGGGGAGGA CGACTGCATC CTCGAGCCAG ATCTCTCTGA GCTCGAGGAG
    TTTGCTTCCT GTCGCAAACA GCCGATAGCG GAGCAACCGC AGCAGAAGCC CACGTCTCCA
    TCGACTACAG CAGTGGAGGA GCACAAAGAA TCCGGCGAGA AACCTAAACG GGAGGACTCT
    GTTGAGGAGA TGGGGGGCGA GGCGTCAGCA TCCAAAGTTG AGAAAGCAGA GGATCAAATC
    GCCGCACCAA GTACTGAAAC CGAGAAAGTG AATTTAGAGA CGACAGAGCA AAAAGTGTCG
    GACATCAGTG GCTTCCCCAG TGAGGAGTTC AAAGCGGCGC TAGAGGAGAC GTGCTTGGAG
    AGCGCCAAGC TTCCCAACAA CACGGCGCCG GAGGAGCCAA TGGAAAATCA TGTCTGTTTG
    TTAGACGACA GCAGAAGCCA GGAAGAAACA CAGACTCCAG ATAAAATCCA TCTGGAAGTT
    CAGCTGAAGG ACGTCAGTCT GAAAAGAGAG ATCGAAGCCC CCTCCTCATC TCTAGAGCAG
    GACAAAGCTG TCAGTGAACA CAGCATTCCT TTGGGAGTGG AGTTCATTGA GCCAAGAACA
    GGCTTCTACT GCAAACTGTG TGGCTTGTTC TACAGCAGCG AGGACACTGC AAAAACCACT
    CACTGCCGCA GCACCGTACA CTACAGAAAC CTGCAGAAAT ACCTGTCCCA GCTGGCAGAG
    AACGGCCTGT CGAGCGCGCT GGCTGAACCC TCCGCGGCGC ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.