AP4B1 cDNA ORF clone, Opisthocomus hoazin

The following AP4B1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the AP4B1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OOp22702 XM_009939051.1
Latest version!
Opisthocomus hoazin adaptor-related protein complex 4, beta 1 subunit (AP4B1), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OOp22702
    Clone ID Related Accession (Same CDS sequence) XM_009939051.1
    Accession Version XM_009939051.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1608bp)
    Protein sequence
    SNP
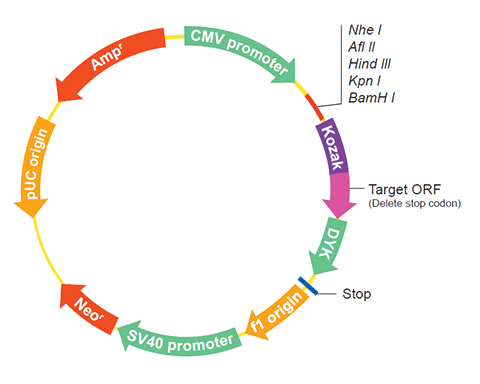
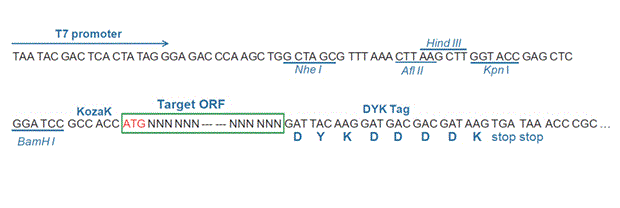
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-27
    Organism Opisthocomus hoazin
    Product AP-4 complex subunit beta-1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009902396.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Opisthocomus hoazin Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    ATGGCTGATC TGGATCCGTG GGGGCAAAGT GAGGTGCTTA CCTTCCTTCT GCGCTACAGA 
    CCCCGCAGTG AGGAGGAACT CTTCGACATA CTCAACTTAC TGGATGGCTA TCTCAAAAGC
    AGCAGCCCCA GCGTCGTGAT GGCAGCCACC AAGCTTTTCC TGGTGCTGGC CAGGGAGTAC
    CCACATGTGC AGGCAGATGT TTTGGTGAGA GTGAAGGGGC CGCTGCTGTC TGCCTGCACT
    TCCGAGAGCA GGGAGCTCTG CTTCACTGCG CTGTGCCATG TGCGTCAGAT CCTTGGTAGC
    CTTCCGGGCC ATTTCAGCAG CCACTACAAA AAGTTCTTCT GTTCATATTC AGAGCCCCAC
    TACATCAAAT GCCAGAAGAT GGAGGTGTTG TGTGAGCTGG TGAATGATGA AAACGTACAG
    CAAGTGCTGG AGGAGCTGAA GGGCTATTGC ACTGATGTGT CGGTAGAGCT TGCCCAAGGG
    GCAATCTTCG CCATAGGCAA TATTGCAAGA ACATACACAG AGCAGTGTGT GGGGATTCTG
    ACAGAGCTCC TGGGGCTGCA GCAGGAGCAT ATCACTTCAG CGGTAGTACA GGCTTTTCGG
    GACCTGGTTT GGCTGTGTCC GCAGTGCACG GATGCTGTGT GTCGGGCACT GCCCAGCTGT
    GAGGACGCCA TCCAGGACAG TGAGGGCAAG CAAGCGCTGA TCTGGCTCCT GGGCGCGCAT
    GGTGAGAAAG TACCGAATGC CCCCTATGTG TTAGAGGACT TTGTGGAGAA CGTGAAATCG
    GAGATGTTCC CAGCAGTGAA GATGGAGCTT CTGACAGCGT TGGTGCGACT CTTCCTGTCT
    CGTCCTGCTG AGTGTCAGGA CATGCTAGGG AGACTGCTCT ATTACTGCAT AGAGGAGGAG
    ATGGATATGG CAGTACGAGA CCGTGGATTG TTCTACTATC GCCTGTTGCA GTCTGGTGTG
    GAAGAAGTGA AAAGGGTCCT GTGTAGCCCC AAGTCTGACC CCTCTCTGGG GCTCCTGGAA
    GACCGAACTG AGCGACCTGT GAATACATGG GCATCAGAGT TTAATACTCT TGCACCAGTT
    TATGGCAGAG AATGCTGGGC ACTCATCACC GCTCACCAGC CAGCAGAACC CTCTTACACT
    TGTTCTCCTT GTGCTGACTC CAGGAACAGA GACACAGAGG CACTGGTTTC TGAAGGGAAT
    AAAGAAGTCC TCAAGGTTCA TCCTGATACA GGCAGCCTGA CCTTAATTCC TGATGTTCAC
    CTGACTGCAG AACAGTTTGA GAAGACCTGG CTGAGCCTGG AGATGAGCTG CCACCTCTCT
    CTGCCCTGGT GTGGGACTGC TCATCCGGAT ACCATACAGA CAGCTCTGCA CGTTGTCCAC
    ATCCAGACTA TTGCTATGAG CAAAGCTGGC GTCCAGCCGT GGAAAGCTTA TCTCAGTGCT
    CAGGACGACA CAGGTTGCCT CTTCCTCGCA GAGCTCTTGC TTGAGGCGGC CGACTCGGAG
    ATGCAGGTGT TGGTGAAGCA GAGTGAGGCG AAGCCGGAGG CACTGCGAAC CTTTCTTTCA
    GTGTTGAGGA CAGTCGTGGG GGCCGTTGCC GGACTGGGGT CCCAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009937353.1
    CDS145..1752
    Translation

    Target ORF information:

    RefSeq Version XM_009939051.1
    Organism Opisthocomus hoazin
    Definition Opisthocomus hoazin adaptor-related protein complex 4, beta 1 subunit (AP4B1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009939051.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    ATGGCTGATC TGGATCCGTG GGGGCAAAGT GAGGTGCTTA CCTTCCTTCT GCGCTACAGA 
    CCCCGCAGTG AGGAGGAACT CTTCGACATA CTCAACTTAC TGGATGGCTA TCTCAAAAGC
    AGCAGCCCCA GCGTCGTGAT GGCAGCCACC AAGCTTTTCC TGGTGCTGGC CAGGGAGTAC
    CCACATGTGC AGGCAGATGT TTTGGTGAGA GTGAAGGGGC CGCTGCTGTC TGCCTGCACT
    TCCGAGAGCA GGGAGCTCTG CTTCACTGCG CTGTGCCATG TGCGTCAGAT CCTTGGTAGC
    CTTCCGGGCC ATTTCAGCAG CCACTACAAA AAGTTCTTCT GTTCATATTC AGAGCCCCAC
    TACATCAAAT GCCAGAAGAT GGAGGTGTTG TGTGAGCTGG TGAATGATGA AAACGTACAG
    CAAGTGCTGG AGGAGCTGAA GGGCTATTGC ACTGATGTGT CGGTAGAGCT TGCCCAAGGG
    GCAATCTTCG CCATAGGCAA TATTGCAAGA ACATACACAG AGCAGTGTGT GGGGATTCTG
    ACAGAGCTCC TGGGGCTGCA GCAGGAGCAT ATCACTTCAG CGGTAGTACA GGCTTTTCGG
    GACCTGGTTT GGCTGTGTCC GCAGTGCACG GATGCTGTGT GTCGGGCACT GCCCAGCTGT
    GAGGACGCCA TCCAGGACAG TGAGGGCAAG CAAGCGCTGA TCTGGCTCCT GGGCGCGCAT
    GGTGAGAAAG TACCGAATGC CCCCTATGTG TTAGAGGACT TTGTGGAGAA CGTGAAATCG
    GAGATGTTCC CAGCAGTGAA GATGGAGCTT CTGACAGCGT TGGTGCGACT CTTCCTGTCT
    CGTCCTGCTG AGTGTCAGGA CATGCTAGGG AGACTGCTCT ATTACTGCAT AGAGGAGGAG
    ATGGATATGG CAGTACGAGA CCGTGGATTG TTCTACTATC GCCTGTTGCA GTCTGGTGTG
    GAAGAAGTGA AAAGGGTCCT GTGTAGCCCC AAGTCTGACC CCTCTCTGGG GCTCCTGGAA
    GACCGAACTG AGCGACCTGT GAATACATGG GCATCAGAGT TTAATACTCT TGCACCAGTT
    TATGGCAGAG AATGCTGGGC ACTCATCACC GCTCACCAGC CAGCAGAACC CTCTTACACT
    TGTTCTCCTT GTGCTGACTC CAGGAACAGA GACACAGAGG CACTGGTTTC TGAAGGGAAT
    AAAGAAGTCC TCAAGGTTCA TCCTGATACA GGCAGCCTGA CCTTAATTCC TGATGTTCAC
    CTGACTGCAG AACAGTTTGA GAAGACCTGG CTGAGCCTGG AGATGAGCTG CCACCTCTCT
    CTGCCCTGGT GTGGGACTGC TCATCCGGAT ACCATACAGA CAGCTCTGCA CGTTGTCCAC
    ATCCAGACTA TTGCTATGAG CAAAGCTGGC GTCCAGCCGT GGAAAGCTTA TCTCAGTGCT
    CAGGACGACA CAGGTTGCCT CTTCCTCGCA GAGCTCTTGC TTGAGGCGGC CGACTCGGAG
    ATGCAGGTGT TGGTGAAGCA GAGTGAGGCG AAGCCGGAGG CACTGCGAAC CTTTCTTTCA
    GTGTTGAGGA CAGTCGTGGG GGCCGTTGCC GGACTGGGGT CCCAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.