Iars cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

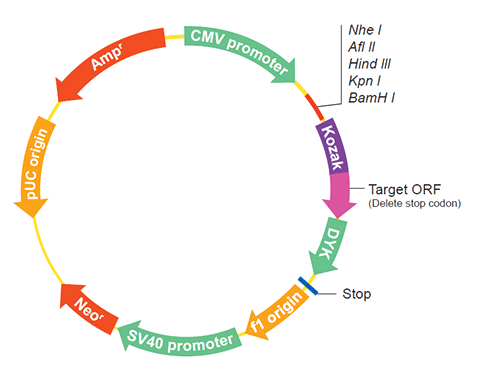
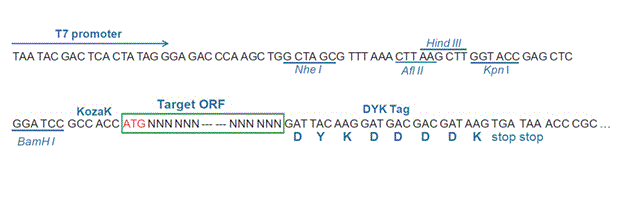
The following Iars gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Iars cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa137228 XM_029556920.1
Latest version!
Nannospalax galili isoleucine--tRNA ligase, cytoplasmic (LOC103751229), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
ONa36299 XM_008854598.2
Latest version!
Nannospalax galili isoleucyl-tRNA synthetase (Iars), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa137228
    Clone ID Related Accession (Same CDS sequence) XM_029556920.1
    Accession Version XM_029556920.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3753bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product isoleucine--tRNA ligase, cytoplasmic
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008356465.1) and transcript sequence (JO016172.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases assembly gap :: added 102 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGGTTGAAC AAGTTCCAGA AAACATCAAT TTTCCTGCTG AAGAGGAGAA GATCTTGCAG 
    TTCTGGTCCA AATTTAATTG TTTCCAGGAA TGCTTAAAGC AATCAAAACA TAGGCCAAAA
    TTTACCTTCT ATGACGGGCC TCCCTTTGCA ACTGGACTGC CTCACTATGG ACATATACTT
    GCAGGGACAA TTAAAGATAT AGTTACAAGA TATGCTCACC AGAATGGGTT TCATGTTGAC
    AGAAGATTTG GATGGGATTG TCATGGCCTA CCTGTGGAAT ATGAAATTGA TAGGACACTG
    GGAATCAACG GGCCCGAGGA TGTGGCAAAA ATGGGGATTG CGGAATATAA CAAACAGTGC
    CGAGCCATTG TGATGAGATA TTCTACTGAG TGGAGGTCTA CTGTTACCAG ACTTGGCCGA
    TGGATTGACT TTGATAACGA CTATAAGACT CTGTATCCAG AATTCATGGA ATCAGTCTGG
    TGGGTCTTCA AACAACTCTA TGACAAAGGC CTTGTGTATA GGGGTGTGAA AGTCATGCCC
    TTCTCCACTG CGTGCAGCAC TCCACTCTCC AACTTTGAGT CACACCAGAA TTACAAGGAT
    GTTCAGGATC CTTCAGTATT TGTAACCTTC CCTTTGGAGG AAGATGAAAA TACATCCTTA
    GTTGCGTGGA CAACCACTCC CTGGACTCTA CCTAGTAACC TTGCCCTATG TGTTAATCCA
    GAAACACAGT ATGTGAAGAT TAAAGATGTT GCTAGAGGAA AACTGTTCAT TTTAATGGAA
    GCCAGATTAT CTGCCCTCTA TAAGTTAGAG AGTGACTATG AAATTCTTGA AAGGTTTCCT
    GGTGCATCTC TCAAAGGCAA GAAATACAAG CCTTTATTCG ACTACTTCAT TAAGTGTAAA
    GAGAATGGTG CTTTCACTGT GCTTGTTGAC CACTATGTGA AGGACGAAGA AGGCACCGGA
    GTTGTACACC AGGCCCCTTA CTTCGGTGCT GATGACTTTC GAGTCTGTAT GGACTTCAAT
    ATTATTCAGA AAGATTCAAC CCCTATTTGC CCCGTGGATG CTTCAGGCTG CTTCACAGAA
    GAAGTGACAC ATTTTGTTGG GCAGTATGTG AAGGATGCTG ATAAAAATAT CATCAGAACA
    TTGAAGGAAC AGGGGAGACT TCTTATGGCC TCCACCTTCA CTCACAGTTA CCCTTTCTGC
    TGGAGGTCAG ACACTCCCCT TATTTACAAG TCAGTGCCCA GCTGGTTTGT GCGAGTGGAG
    CACATGGTGG ACCAGCTCCT TAAGAACAAT GACCTGTGTT ACTGGGTCCC AGAGTTTGTT
    CGAGAAAAGC GGTTTGGAAA TTGGCTGAAA GACGCACATG ACTGGGCAAT TTCCAGAAAT
    AGATACTGGG GTACTCCTAT CCCACTGTGG GTCAGTGAAG ACTTTGAGGA GGTAGTTTGC
    ATTGGGTCAA TGGCAGAACT TGAAGAACTG TCGGGAGCAA AAATCTCAGA TCTCCACAGA
    GAGAGCATTG ACCACCTGAC CATCCCATCA CGCTGTGGGA AAGGACCACT GCGGCGCATC
    TCTGAAGTGT TTGACTGCTG GTTCGAGAGT GGCAGCATGC CCTACGCTCA GGTCCATTAT
    CCCTTTGAAA ACAAGAGGGA GTTTGAGGAT GCTTTTCCTG CAGACTTCAT TGCCGAAGGC
    ATTGATCAAA CCAGAGGATG GTTTTACACC CTTCTGGTGC TGGCTACAGC TCTCTTCGGA
    CAACCACCTT TCAAGAATGT GATTGTGAAT GGACTCATCT TGGCAAGTGA TGGCCAAAAA
    ATGAGCAAGC GGAAAAAGAA CTATCCAGAT CCAGTTTCCA TCATCAATAA ATATGGTGCT
    GATGCCCTCA GATTGTATCT GATCAATTCC CCTGTGGTGA GAGCAGAAAA CCTTCGCTTT
    AAAGAGGAGG GTGTGCGGGA TGTCCTCAAG GATGTGCTGC TCCCATGGTA CAATGCATAC
    CGCTTCTTCA TCCAGAATGT CTTTAGGCTC CGCAAGGAGG AAGAAATGGA ATTTTTCTAC
    AATGAGCACA CAGTTAGAGA AAGCCCCAAC ATCACTGATC GGTGGATCCT GTCTTTCATG
    CAGTCCCTTG TTGGGTTCTT TGAGACTGAA ATGGCAGCTT ATAGGCTGTA TACTGTGGTG
    CCTCGCCTGG TCAAGTTTGT AGATATTCTG ACCAATTGGT ACGTCCGAAT GAACCGCAGA
    AGATTGAAGG GTGAGAATGG GATGGAAGAT TGTGTTATGG CTCTGGAGAC TTTGTTCAGT
    GTCCTGCTTT CTCTGTGCAG ACTGATGGCC CCTTATACAC CATTTCTCAC TGAACTGATG
    TACCAGAATC TAAAGATGCT GATTGACCCT GTTTCTGTCC AGGACAAGGA CACACTCAGC
    ATCCACTACC TCATGCTGCC ACGTGTTCGA GAGGAGCAGA TTGACAGGAA AACGGAGAGT
    GCAGTATCTA GAATGCAGTC AGTGATCGAA CTTGGGCGAG TGATCAGAGA CCGGAAAACT
    ATTCCAATAA AGTATCCTTT GAAAGAAATA GTGGTTATCC ATCAAGATCC AGAAGCTCTT
    AAAGATATCA AATCTTTGGA GAAGTATATC ATTGAGGAAT TAAATGTCCG AAAAGTCACA
    CTGTCTACTG ATGGGGCACT CTTCGTGTAC TCAGCCCAAG GGCTCCTTGA CAGAGCACCA
    GGGTCATTAA AGAGGAGCAC AGTGTGCTGC TGGCAGGGCA GCTCAAAGAT TGTCTGTTCT
    CCCATAGGGA GCATTGTCGT GGAAGGCCAC GAATTGCATG AAGAAGACAT TCGCCTCATG
    TACACCTTTG ACCAGGCCAC TGGAGGGACT GCGCAGTTTG AAGCACATTC TGATGCTCAG
    GCTTTGGTTC TCTTAGACAT CACACCCGAC CAGTCTATGG TGGATGAAGG AATGGCTCGG
    GAAGTCATCA ATCGCATCCA GAAACTTCGA AAGAAGTGCA ATCTAGTTCC AACTGATGAA
    ATAACAGTCT ATTATAATGC AAAATCTGAA GGAAGATACC TGAATAATGT AATTGAAAGC
    CACACTGACT TCATATTTGC CACTATAAAG GCTCCCTTGA AACCATATCC AGTTCCTACA
    TCAGATAACA TCCTTATTCA AGAACAAACA CAGTTAAAGG GGTCTGAACT GGAAATTACA
    CTCACTAAAG GATCATGTGT ACCTGGTCCT GCTTGTGCCT ATGTAAACCT TAACATCTGT
    GTCAATGGCA CTGAACAAGG TGGAGTATTG CTTCTGGAGA ACCCAAAAGG TGATAATAAA
    TTGGACCTTT TAAAGCTAAA GAGCATCATT ACTAGCATTT TCGGTGTTAA AAATGTAGAG
    CTGTCAGTCT TCCATGGTGA AACAGAACTA CAAAACCAAA CTGACTTGCT GAGTCTCAGT
    GGAAAAACCC TTCGTGTGAC TGCAGGAACA GCCCCATCTC TGAACAATAG TCCCAGCACC
    CTGCTGTGTC AGTATATCAA CCTGCAGCTC CTAAACGCAG AGCCACAAGA GTGTTTAGTG
    GGAACTGTGG GTACTCTCCT GCTTGAAAAT CCACTTGGAC AGAATGGACT CACCCACCAA
    GGTCTTATGT ATGAGGCAGC CAAGGTGTTT GGATTGCGCA GCAGGAAGCT AAAGCTGTTT
    CTGAATGAGA CGCAAACACA TGGTGAGAAA ATTAAGGACT ATCCAGTTTT TCCTTCTTCA
    AAAGTAGATT TTGATACTTT TAATCATTTT TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029412780.1
    CDS116..3868
    Translation

    Target ORF information:

    RefSeq Version XM_029556920.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili isoleucine--tRNA ligase, cytoplasmic (LOC103751229), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029556920.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGGTTGAAC AAGTTCCAGA AAACATCAAT TTTCCTGCTG AAGAGGAGAA GATCTTGCAG 
    TTCTGGTCCA AATTTAATTG TTTCCAGGAA TGCTTAAAGC AATCAAAACA TAGGCCAAAA
    TTTACCTTCT ATGACGGGCC TCCCTTTGCA ACTGGACTGC CTCACTATGG ACATATACTT
    GCAGGGACAA TTAAAGATAT AGTTACAAGA TATGCTCACC AGAATGGGTT TCATGTTGAC
    AGAAGATTTG GATGGGATTG TCATGGCCTA CCTGTGGAAT ATGAAATTGA TAGGACACTG
    GGAATCAACG GGCCCGAGGA TGTGGCAAAA ATGGGGATTG CGGAATATAA CAAACAGTGC
    CGAGCCATTG TGATGAGATA TTCTACTGAG TGGAGGTCTA CTGTTACCAG ACTTGGCCGA
    TGGATTGACT TTGATAACGA CTATAAGACT CTGTATCCAG AATTCATGGA ATCAGTCTGG
    TGGGTCTTCA AACAACTCTA TGACAAAGGC CTTGTGTATA GGGGTGTGAA AGTCATGCCC
    TTCTCCACTG CGTGCAGCAC TCCACTCTCC AACTTTGAGT CACACCAGAA TTACAAGGAT
    GTTCAGGATC CTTCAGTATT TGTAACCTTC CCTTTGGAGG AAGATGAAAA TACATCCTTA
    GTTGCGTGGA CAACCACTCC CTGGACTCTA CCTAGTAACC TTGCCCTATG TGTTAATCCA
    GAAACACAGT ATGTGAAGAT TAAAGATGTT GCTAGAGGAA AACTGTTCAT TTTAATGGAA
    GCCAGATTAT CTGCCCTCTA TAAGTTAGAG AGTGACTATG AAATTCTTGA AAGGTTTCCT
    GGTGCATCTC TCAAAGGCAA GAAATACAAG CCTTTATTCG ACTACTTCAT TAAGTGTAAA
    GAGAATGGTG CTTTCACTGT GCTTGTTGAC CACTATGTGA AGGACGAAGA AGGCACCGGA
    GTTGTACACC AGGCCCCTTA CTTCGGTGCT GATGACTTTC GAGTCTGTAT GGACTTCAAT
    ATTATTCAGA AAGATTCAAC CCCTATTTGC CCCGTGGATG CTTCAGGCTG CTTCACAGAA
    GAAGTGACAC ATTTTGTTGG GCAGTATGTG AAGGATGCTG ATAAAAATAT CATCAGAACA
    TTGAAGGAAC AGGGGAGACT TCTTATGGCC TCCACCTTCA CTCACAGTTA CCCTTTCTGC
    TGGAGGTCAG ACACTCCCCT TATTTACAAG TCAGTGCCCA GCTGGTTTGT GCGAGTGGAG
    CACATGGTGG ACCAGCTCCT TAAGAACAAT GACCTGTGTT ACTGGGTCCC AGAGTTTGTT
    CGAGAAAAGC GGTTTGGAAA TTGGCTGAAA GACGCACATG ACTGGGCAAT TTCCAGAAAT
    AGATACTGGG GTACTCCTAT CCCACTGTGG GTCAGTGAAG ACTTTGAGGA GGTAGTTTGC
    ATTGGGTCAA TGGCAGAACT TGAAGAACTG TCGGGAGCAA AAATCTCAGA TCTCCACAGA
    GAGAGCATTG ACCACCTGAC CATCCCATCA CGCTGTGGGA AAGGACCACT GCGGCGCATC
    TCTGAAGTGT TTGACTGCTG GTTCGAGAGT GGCAGCATGC CCTACGCTCA GGTCCATTAT
    CCCTTTGAAA ACAAGAGGGA GTTTGAGGAT GCTTTTCCTG CAGACTTCAT TGCCGAAGGC
    ATTGATCAAA CCAGAGGATG GTTTTACACC CTTCTGGTGC TGGCTACAGC TCTCTTCGGA
    CAACCACCTT TCAAGAATGT GATTGTGAAT GGACTCATCT TGGCAAGTGA TGGCCAAAAA
    ATGAGCAAGC GGAAAAAGAA CTATCCAGAT CCAGTTTCCA TCATCAATAA ATATGGTGCT
    GATGCCCTCA GATTGTATCT GATCAATTCC CCTGTGGTGA GAGCAGAAAA CCTTCGCTTT
    AAAGAGGAGG GTGTGCGGGA TGTCCTCAAG GATGTGCTGC TCCCATGGTA CAATGCATAC
    CGCTTCTTCA TCCAGAATGT CTTTAGGCTC CGCAAGGAGG AAGAAATGGA ATTTTTCTAC
    AATGAGCACA CAGTTAGAGA AAGCCCCAAC ATCACTGATC GGTGGATCCT GTCTTTCATG
    CAGTCCCTTG TTGGGTTCTT TGAGACTGAA ATGGCAGCTT ATAGGCTGTA TACTGTGGTG
    CCTCGCCTGG TCAAGTTTGT AGATATTCTG ACCAATTGGT ACGTCCGAAT GAACCGCAGA
    AGATTGAAGG GTGAGAATGG GATGGAAGAT TGTGTTATGG CTCTGGAGAC TTTGTTCAGT
    GTCCTGCTTT CTCTGTGCAG ACTGATGGCC CCTTATACAC CATTTCTCAC TGAACTGATG
    TACCAGAATC TAAAGATGCT GATTGACCCT GTTTCTGTCC AGGACAAGGA CACACTCAGC
    ATCCACTACC TCATGCTGCC ACGTGTTCGA GAGGAGCAGA TTGACAGGAA AACGGAGAGT
    GCAGTATCTA GAATGCAGTC AGTGATCGAA CTTGGGCGAG TGATCAGAGA CCGGAAAACT
    ATTCCAATAA AGTATCCTTT GAAAGAAATA GTGGTTATCC ATCAAGATCC AGAAGCTCTT
    AAAGATATCA AATCTTTGGA GAAGTATATC ATTGAGGAAT TAAATGTCCG AAAAGTCACA
    CTGTCTACTG ATGGGGCACT CTTCGTGTAC TCAGCCCAAG GGCTCCTTGA CAGAGCACCA
    GGGTCATTAA AGAGGAGCAC AGTGTGCTGC TGGCAGGGCA GCTCAAAGAT TGTCTGTTCT
    CCCATAGGGA GCATTGTCGT GGAAGGCCAC GAATTGCATG AAGAAGACAT TCGCCTCATG
    TACACCTTTG ACCAGGCCAC TGGAGGGACT GCGCAGTTTG AAGCACATTC TGATGCTCAG
    GCTTTGGTTC TCTTAGACAT CACACCCGAC CAGTCTATGG TGGATGAAGG AATGGCTCGG
    GAAGTCATCA ATCGCATCCA GAAACTTCGA AAGAAGTGCA ATCTAGTTCC AACTGATGAA
    ATAACAGTCT ATTATAATGC AAAATCTGAA GGAAGATACC TGAATAATGT AATTGAAAGC
    CACACTGACT TCATATTTGC CACTATAAAG GCTCCCTTGA AACCATATCC AGTTCCTACA
    TCAGATAACA TCCTTATTCA AGAACAAACA CAGTTAAAGG GGTCTGAACT GGAAATTACA
    CTCACTAAAG GATCATGTGT ACCTGGTCCT GCTTGTGCCT ATGTAAACCT TAACATCTGT
    GTCAATGGCA CTGAACAAGG TGGAGTATTG CTTCTGGAGA ACCCAAAAGG TGATAATAAA
    TTGGACCTTT TAAAGCTAAA GAGCATCATT ACTAGCATTT TCGGTGTTAA AAATGTAGAG
    CTGTCAGTCT TCCATGGTGA AACAGAACTA CAAAACCAAA CTGACTTGCT GAGTCTCAGT
    GGAAAAACCC TTCGTGTGAC TGCAGGAACA GCCCCATCTC TGAACAATAG TCCCAGCACC
    CTGCTGTGTC AGTATATCAA CCTGCAGCTC CTAAACGCAG AGCCACAAGA GTGTTTAGTG
    GGAACTGTGG GTACTCTCCT GCTTGAAAAT CCACTTGGAC AGAATGGACT CACCCACCAA
    GGTCTTATGT ATGAGGCAGC CAAGGTGTTT GGATTGCGCA GCAGGAAGCT AAAGCTGTTT
    CTGAATGAGA CGCAAACACA TGGTGAGAAA ATTAAGGACT ATCCAGTTTT TCCTTCTTCA
    AAAGTAGATT TTGATACTTT TAATCATTTT TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa36299
    Clone ID Related Accession (Same CDS sequence) XM_008854598.2
    Accession Version XM_008854598.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3675bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product isoleucine--tRNA ligase, cytoplasmic
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008356465.1) and transcript sequence (JO016172.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008854598.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases assembly gap :: added 102 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGGTTGAAC AAGTTCCAGA AAACATCAAT TTTCCTGCTG AAGAGGAGAA GATCTTGCAG 
    TTCTGGTCCA AATTTAATTG TTTCCAGGAA TGCTTAAAGC AATCAAAACA TAGGCCAAAA
    TTTACCTTCT ATGACGGGCC TCCCTTTGCA ACTGGACTGC CTCACTATGG ACATATACTT
    GCAGGGACAA TTAAAGATAT AGTTACAAGA TATGCTCACC AGAATGGGTT TCATGTTGAC
    AGAAGATTTG GATGGGATTG TCATGGCCTA CCTGTGGAAT ATGAAATTGA TAGGACACTG
    GGAATCAACG GGCCCGAGGA TGTGGCAAAA ATGGGGATTG CGGAATATAA CAAACAGTGC
    CGAGCCATTG TGATGAGATA TTCTACTGAG TGGAGGTCTA CTGTTACCAG ACTTGGCCGA
    TGGATTGACT TTGATAACGA CTATAAGACT CTGTATCCAG AATTCATGGA ATCAGTCTGG
    TGGGTCTTCA AACAACTCTA TGACAAAGGC CTTGTGTATA GGGGTGTGAA AGTCATGCCC
    TTCTCCACTG CGTGCAGCAC TCCACTCTCC AACTTTGAGT CACACCAGAA TTACAAGGAT
    GTTCAGGATC CTTCAGTATT TGTAACCTTC CCTTTGGAGG AAGATGAAAA TACATCCTTA
    GTTGCGTGGA CAACCACTCC CTGGACTCTA CCTAGTAACC TTGCCCTATG TGTTAATCCA
    GAAACACAGT ATGTGAAGAT TAAAGATGTT GCTAGAGGAA AACTGTTCAT TTTAATGGAA
    GCCAGATTAT CTGCCCTCTA TAAGTTAGAG AGTGACTATG AAATTCTTGA AAGGTTTCCT
    GGTGCATCTC TCAAAGGCAA GAAATACAAG CCTTTATTCG ACTACTTCAT TAAGTGTAAA
    GAGAATGGTG CTTTCACTGT GCTTGTTGAC CACTATGTGA AGGACGAAGA AGGCACCGGA
    GTTGTACACC AGGCCCCTTA CTTCGGTGCT GATGACTTTC GAGTCTGTAT GGACTTCAAT
    ATTATTCAGA AAGATTCAAC CCCTATTTGC CCCGTGGATG CTTCAGGCTG CTTCACAGAA
    GAAGTGACAC ATTTTGTTGG GCAGTATGTG AAGGATGCTG ATAAAAATAT CATCAGAACA
    TTGAAGGAAC AGGGGAGACT TCTTATGGCC TCCACCTTCA CTCACAGTTA CCCTTTCTGC
    TGGAGGTCAG ACACTCCCCT TATTTACAAG TCAGTGCCCA GCTGGTTTGT GCGAGTGGAG
    CACATGGTGG ACCAGCTCCT TAAGAACAAT GACCTGTGTT ACTGGGTCCC AGAGTTTGTT
    CGAGAAAAGC GGTTTGGAAA TTGGCTGAAA GACGCACATG ACTGGGCAAT TTCCAGAAAT
    AGATACTGGG GTACTCCTAT CCCACTGTGG GTCAGTGAAG ACTTTGAGGA GGTAGTTTGC
    ATTGGGTCAA TGGCAGAACT TGAAGAACTG TCGGGAGCAA AAATCTCAGA TCTCCACAGA
    GAGAGCATTG ACCACCTGAC CATCCCATCA CGCTGTGGGA AAGGACCACT GCGGCGCATC
    TCTGAAGTGT TTGACTGCTG GTTCGAGAGT GGCAGCATGC CCTACGCTCA GGTCCATTAT
    CCCTTTGAAA ACAAGAGGGA GTTTGAGGAT GCTTTTCCTG CAGACTTCAT TGCCGAAGGC
    ATTGATCAAA CCAGAGGATG GTTTTACACC CTTCTGGTGC TGGCTACAGC TCTCTTCGGA
    CAACCACCTT TCAAGAATGT GATTGTGAAT GGACTCATCT TGGCAAGTGA TGGCCAAAAA
    ATGAGCAAGC GGAAAAAGAA CTATCCAGAT CCAGTTTCCA TCATCAATAA ATATGGTGCT
    GATGCCCTCA GATTGTATCT GATCAATTCC CCTGTGGTGA GAGCAGAAAA CCTTCGCTTT
    AAAGAGGAGG GTGTGCGGGA TGTCCTCAAG GATGTGCTGC TCCCATGGTA CAATGCATAC
    CGCTTCTTCA TCCAGAATGT CTTTAGGCTC CGCAAGGAGG AAGAAATGGA ATTTTTCTAC
    AATGAGCACA CAGTTAGAGA AAGCCCCAAC ATCACTGATC GGTGGATCCT GTCTTTCATG
    CAGTCCCTTG TTGGGTTCTT TGAGACTGAA ATGGCAGCTT ATAGGCTGTA TACTGTGGTG
    CCTCGCCTGG TCAAGTTTGT AGATATTCTG ACCAATTGGT ACGTCCGAAT GAACCGCAGA
    AGATTGAAGG GTGAGAATGG GATGGAAGAT TGTGTTATGG CTCTGGAGAC TTTGTTCAGT
    GTCCTGCTTT CTCTGTGCAG ACTGATGGCC CCTTATACAC CATTTCTCAC TGAACTGATG
    TACCAGAATC TAAAGATGCT GATTGACCCT GTTTCTGTCC AGGACAAGGA CACACTCAGC
    ATCCACTACC TCATGCTGCC ACGTGTTCGA GAGGAGCAGA TTGACAGGAA AACGGAGAGT
    GCAGTATCTA GAATGCAGTC AGTGATCGAA CTTGGGCGAG TGATCAGAGA CCGGAAAACT
    ATTCCAATAA AGTATCCTTT GAAAGAAATA GTGGTTATCC ATCAAGATCC AGAAGCTCTT
    AAAGATATCA AATCTTTGGA GAAGTATATC ATTGAGGAAT TAAATGTCCG AAAAGTCACA
    CTGTCTACTG ATGGGGCACT CTTCGTGTAC TCAGCCCAAG GGCTCCTTGG GAGCATTGTC
    GTGGAAGGCC ACGAATTGCA TGAAGAAGAC ATTCGCCTCA TGTACACCTT TGACCAGGCC
    ACTGGAGGGA CTGCGCAGTT TGAAGCACAT TCTGATGCTC AGGCTTTGGT TCTCTTAGAC
    ATCACACCCG ACCAGTCTAT GGTGGATGAA GGAATGGCTC GGGAAGTCAT CAATCGCATC
    CAGAAACTTC GAAAGAAGTG CAATCTAGTT CCAACTGATG AAATAACAGT CTATTATAAT
    GCAAAATCTG AAGGAAGATA CCTGAATAAT GTAATTGAAA GCCACACTGA CTTCATATTT
    GCCACTATAA AGGCTCCCTT GAAACCATAT CCAGTTCCTA CATCAGATAA CATCCTTATT
    CAAGAACAAA CACAGTTAAA GGGGTCTGAA CTGGAAATTA CACTCACTAA AGGATCATGT
    GTACCTGGTC CTGCTTGTGC CTATGTAAAC CTTAACATCT GTGTCAATGG CACTGAACAA
    GGTGGAGTAT TGCTTCTGGA GAACCCAAAA GGTGATAATA AATTGGACCT TTTAAAGCTA
    AAGAGCATCA TTACTAGCAT TTTCGGTGTT AAAAATGTAG AGCTGTCAGT CTTCCATGGT
    GAAACAGAAC TACAAAACCA AACTGACTTG CTGAGTCTCA GTGGAAAAAC CCTTCGTGTG
    ACTGCAGGAA CAGCCCCATC TCTGAACAAT AGTCCCAGCA CCCTGCTGTG TCAGTATATC
    AACCTGCAGC TCCTAAACGC AGAGCCACAA GAGTGTTTAG TGGGAACTGT GGGTACTCTC
    CTGCTTGAAA ATCCACTTGG ACAGAATGGA CTCACCCACC AAGGTCTTAT GTATGAGGCA
    GCCAAGGTGT TTGGATTGCG CAGCAGGAAG CTAAAGCTGT TTCTGAATGA GACGCAAACA
    CATGGTGAGA AAATTAAGGA CTATCCAGTT TTTCCTTCTT CAAAAGTAGA TTTTGATACT
    TTTAATCATT TTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008852820.1
    CDS93..3767
    Translation

    Target ORF information:

    RefSeq Version XM_008854598.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili isoleucyl-tRNA synthetase (Iars), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008854598.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGGTTGAAC AAGTTCCAGA AAACATCAAT TTTCCTGCTG AAGAGGAGAA GATCTTGCAG 
    TTCTGGTCCA AATTTAATTG TTTCCAGGAA TGCTTAAAGC AATCAAAACA TAGGCCAAAA
    TTTACCTTCT ATGACGGGCC TCCCTTTGCA ACTGGACTGC CTCACTATGG ACATATACTT
    GCAGGGACAA TTAAAGATAT AGTTACAAGA TATGCTCACC AGAATGGGTT TCATGTTGAC
    AGAAGATTTG GATGGGATTG TCATGGCCTA CCTGTGGAAT ATGAAATTGA TAGGACACTG
    GGAATCAACG GGCCCGAGGA TGTGGCAAAA ATGGGGATTG CGGAATATAA CAAACAGTGC
    CGAGCCATTG TGATGAGATA TTCTACTGAG TGGAGGTCTA CTGTTACCAG ACTTGGCCGA
    TGGATTGACT TTGATAACGA CTATAAGACT CTGTATCCAG AATTCATGGA ATCAGTCTGG
    TGGGTCTTCA AACAACTCTA TGACAAAGGC CTTGTGTATA GGGGTGTGAA AGTCATGCCC
    TTCTCCACTG CGTGCAGCAC TCCACTCTCC AACTTTGAGT CACACCAGAA TTACAAGGAT
    GTTCAGGATC CTTCAGTATT TGTAACCTTC CCTTTGGAGG AAGATGAAAA TACATCCTTA
    GTTGCGTGGA CAACCACTCC CTGGACTCTA CCTAGTAACC TTGCCCTATG TGTTAATCCA
    GAAACACAGT ATGTGAAGAT TAAAGATGTT GCTAGAGGAA AACTGTTCAT TTTAATGGAA
    GCCAGATTAT CTGCCCTCTA TAAGTTAGAG AGTGACTATG AAATTCTTGA AAGGTTTCCT
    GGTGCATCTC TCAAAGGCAA GAAATACAAG CCTTTATTCG ACTACTTCAT TAAGTGTAAA
    GAGAATGGTG CTTTCACTGT GCTTGTTGAC CACTATGTGA AGGACGAAGA AGGCACCGGA
    GTTGTACACC AGGCCCCTTA CTTCGGTGCT GATGACTTTC GAGTCTGTAT GGACTTCAAT
    ATTATTCAGA AAGATTCAAC CCCTATTTGC CCCGTGGATG CTTCAGGCTG CTTCACAGAA
    GAAGTGACAC ATTTTGTTGG GCAGTATGTG AAGGATGCTG ATAAAAATAT CATCAGAACA
    TTGAAGGAAC AGGGGAGACT TCTTATGGCC TCCACCTTCA CTCACAGTTA CCCTTTCTGC
    TGGAGGTCAG ACACTCCCCT TATTTACAAG TCAGTGCCCA GCTGGTTTGT GCGAGTGGAG
    CACATGGTGG ACCAGCTCCT TAAGAACAAT GACCTGTGTT ACTGGGTCCC AGAGTTTGTT
    CGAGAAAAGC GGTTTGGAAA TTGGCTGAAA GACGCACATG ACTGGGCAAT TTCCAGAAAT
    AGATACTGGG GTACTCCTAT CCCACTGTGG GTCAGTGAAG ACTTTGAGGA GGTAGTTTGC
    ATTGGGTCAA TGGCAGAACT TGAAGAACTG TCGGGAGCAA AAATCTCAGA TCTCCACAGA
    GAGAGCATTG ACCACCTGAC CATCCCATCA CGCTGTGGGA AAGGACCACT GCGGCGCATC
    TCTGAAGTGT TTGACTGCTG GTTCGAGAGT GGCAGCATGC CCTACGCTCA GGTCCATTAT
    CCCTTTGAAA ACAAGAGGGA GTTTGAGGAT GCTTTTCCTG CAGACTTCAT TGCCGAAGGC
    ATTGATCAAA CCAGAGGATG GTTTTACACC CTTCTGGTGC TGGCTACAGC TCTCTTCGGA
    CAACCACCTT TCAAGAATGT GATTGTGAAT GGACTCATCT TGGCAAGTGA TGGCCAAAAA
    ATGAGCAAGC GGAAAAAGAA CTATCCAGAT CCAGTTTCCA TCATCAATAA ATATGGTGCT
    GATGCCCTCA GATTGTATCT GATCAATTCC CCTGTGGTGA GAGCAGAAAA CCTTCGCTTT
    AAAGAGGAGG GTGTGCGGGA TGTCCTCAAG GATGTGCTGC TCCCATGGTA CAATGCATAC
    CGCTTCTTCA TCCAGAATGT CTTTAGGCTC CGCAAGGAGG AAGAAATGGA ATTTTTCTAC
    AATGAGCACA CAGTTAGAGA AAGCCCCAAC ATCACTGATC GGTGGATCCT GTCTTTCATG
    CAGTCCCTTG TTGGGTTCTT TGAGACTGAA ATGGCAGCTT ATAGGCTGTA TACTGTGGTG
    CCTCGCCTGG TCAAGTTTGT AGATATTCTG ACCAATTGGT ACGTCCGAAT GAACCGCAGA
    AGATTGAAGG GTGAGAATGG GATGGAAGAT TGTGTTATGG CTCTGGAGAC TTTGTTCAGT
    GTCCTGCTTT CTCTGTGCAG ACTGATGGCC CCTTATACAC CATTTCTCAC TGAACTGATG
    TACCAGAATC TAAAGATGCT GATTGACCCT GTTTCTGTCC AGGACAAGGA CACACTCAGC
    ATCCACTACC TCATGCTGCC ACGTGTTCGA GAGGAGCAGA TTGACAGGAA AACGGAGAGT
    GCAGTATCTA GAATGCAGTC AGTGATCGAA CTTGGGCGAG TGATCAGAGA CCGGAAAACT
    ATTCCAATAA AGTATCCTTT GAAAGAAATA GTGGTTATCC ATCAAGATCC AGAAGCTCTT
    AAAGATATCA AATCTTTGGA GAAGTATATC ATTGAGGAAT TAAATGTCCG AAAAGTCACA
    CTGTCTACTG ATGGGGCACT CTTCGTGTAC TCAGCCCAAG GGCTCCTTGG GAGCATTGTC
    GTGGAAGGCC ACGAATTGCA TGAAGAAGAC ATTCGCCTCA TGTACACCTT TGACCAGGCC
    ACTGGAGGGA CTGCGCAGTT TGAAGCACAT TCTGATGCTC AGGCTTTGGT TCTCTTAGAC
    ATCACACCCG ACCAGTCTAT GGTGGATGAA GGAATGGCTC GGGAAGTCAT CAATCGCATC
    CAGAAACTTC GAAAGAAGTG CAATCTAGTT CCAACTGATG AAATAACAGT CTATTATAAT
    GCAAAATCTG AAGGAAGATA CCTGAATAAT GTAATTGAAA GCCACACTGA CTTCATATTT
    GCCACTATAA AGGCTCCCTT GAAACCATAT CCAGTTCCTA CATCAGATAA CATCCTTATT
    CAAGAACAAA CACAGTTAAA GGGGTCTGAA CTGGAAATTA CACTCACTAA AGGATCATGT
    GTACCTGGTC CTGCTTGTGC CTATGTAAAC CTTAACATCT GTGTCAATGG CACTGAACAA
    GGTGGAGTAT TGCTTCTGGA GAACCCAAAA GGTGATAATA AATTGGACCT TTTAAAGCTA
    AAGAGCATCA TTACTAGCAT TTTCGGTGTT AAAAATGTAG AGCTGTCAGT CTTCCATGGT
    GAAACAGAAC TACAAAACCA AACTGACTTG CTGAGTCTCA GTGGAAAAAC CCTTCGTGTG
    ACTGCAGGAA CAGCCCCATC TCTGAACAAT AGTCCCAGCA CCCTGCTGTG TCAGTATATC
    AACCTGCAGC TCCTAAACGC AGAGCCACAA GAGTGTTTAG TGGGAACTGT GGGTACTCTC
    CTGCTTGAAA ATCCACTTGG ACAGAATGGA CTCACCCACC AAGGTCTTAT GTATGAGGCA
    GCCAAGGTGT TTGGATTGCG CAGCAGGAAG CTAAAGCTGT TTCTGAATGA GACGCAAACA
    CATGGTGAGA AAATTAAGGA CTATCCAGTT TTTCCTTCTT CAAAAGTAGA TTTTGATACT
    TTTAATCATT TTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.