Acsl6 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

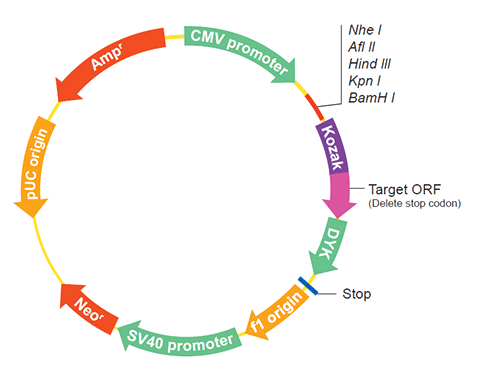
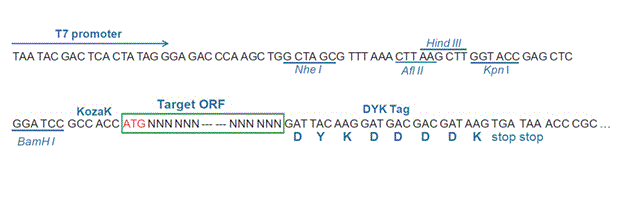
The following Acsl6 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Acsl6 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa31883 XM_017802276.2
Latest version!
Nannospalax galili acyl-CoA synthetase long chain family member 6 (Acsl6), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
ONa31884 XM_017802277.2
Latest version!
Nannospalax galili acyl-CoA synthetase long chain family member 6 (Acsl6), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
View Old Accession Versions >>
ONa31884 XM_017802277.1 Nannospalax galili acyl-CoA synthetase long-chain family member 6 (Acsl6), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
ONa31883 XM_017802276.1 Nannospalax galili acyl-CoA synthetase long-chain family member 6 (Acsl6), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa31883
    Clone ID Related Accession (Same CDS sequence) XM_017802276.1 , XM_017802276.2
    Accession Version XM_017802276.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2169bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product long-chain-fatty-acid--CoA ligase 6 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008352334.1) and transcript sequence (JO008799.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 72 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCTGACTT TCTTCCTCGT GTCCGGGGGC TCCCTCTGGC TGTTTGCGGA GATTGCCCTC 
    TCACTTCTGG AGAAGATGCA GACCCAGGAG ATCCTGAGGA TACTGCGGCT GCCCGAGCTG
    GGCGACTTGG GTCAGTTTTT CCGCAGCCTT TCAGCCACCA CCCTCTTGAG TGTGGGTGCT
    CTGGCTGCCA TCCTGGCCTA CTGGCTCACT CACCGGCCAA AGGCCTTGCA ACCACCATGC
    AACCTCCTGA TGCAGTCAGA AGAAGTGGAG GACAGTGGTG GAGCCCGGCG ATCTGTGATC
    GGAGGTAGCC CTCAGTTGCT TACCCACTAC TACGATGATG CCCGGACCAT GTACCAGGTG
    TTCCGCCGTG GGCTTAGTAT CTCAGGGAAC GGGCCCTGCC TTGGCTTCCG GAAACCTGAG
    CAGCCTTACC AGTGGCTGTC CTACCAAGAG GTGGCCAACA GAGCGGAATA CCTGGGGTCG
    GGACTTCTCC AGCACAACTG TAAAGTGGGC ACAGAGCAGT TCATTGGTGT TTTTGCCCAG
    AATCGGCCAG AGTGGATCAT TGCAGAGTTG GCTTGCTACA CGTACTCCAT GGTGGTGGTC
    CCACTTTACG ACACCCTGGG CCCAGGGGCT ATCCAATACA TCATCAATAC AGCAGACATC
    TTCGTGGTGA TTGTGGATAA GCCTCAGAAG GCTGTGCTTC TTCTGGAGCA CGTGGAGAGG
    AAAGAGACAC CAGGGCTCAA GCTGATCATC CTCATGGAAC CACTTGAGGA CACCCTGAAA
    GAGAGAGGAC AGAAATGCGG GGTGGACATC AAGTCCATGC AGGCTGTAGA AGACCATGGC
    CAAGAGAATC ACTGTGCCCC TGTGCCCCCG CAGCCCGAAG ACCTCTCCAT TGTGTGTTTC
    ACAAGTGGCA CGACAGGGAA CCCCAAAGGT GCGATGCTCA CCCATGGGAA CGTGGTGGCT
    GATTTCTCAG GCTTTCTGAA AGTGACAGAG AAAGTGATCT TTCCGAGACA GGACGATGTG
    CTCATCTCCT TCCTGCCTCT GGCTCACATG TTTGAGAGAG TGATCCAGTC CGTTGTCTAC
    TGCCACGGAG GCCGCGTGGG CTTCTTCCAG GGAGACATTC GCCTCCTCTC AGACGACATG
    AAGGCTCTGC GCCCCACCAT CTTCCCTGTG GTCCCACGGC TACTGAACCG GATGTATGAC
    AAGATCTTCT ACCAGGCAGA CACATCATTA AAGCGCTGGC TCCTAGAGTT TGCAGCAAGG
    CGCAAGCAGG CTGAGGTCCG CAGTGGAATC ATCAGGAATA ATAGTATCTG GGATGAACTC
    TTCTTTAATA AGATCCAGGC CAGTCTTGGA GGGCATGTGA GGATGATTGT TACTGGAGCA
    GCCCCTGCCT CACCAACAGT CCTGGGATTC CTCCGAGCAG CTCTGGGGTG TCAGGTCTAT
    GAAGGTTACG GACAAACTGA ATGCACAGCA GGGTGCACTT TCACGACACC AGGGGACTGG
    ACCTCAGGGC ACGTAGGGGC ACCATTGCCC TGCAATCATA TCAAACTCAT TGATGTGGAG
    GAACTCAACT ACTGGACCCA CAAAGGAGAG GGAGAGATAT GTGTGAAAGG ACCAAATGTG
    TTTAAAGGCT ACTTAAAAGA CAAGGACAGG ACAAAGGAGG CCTTGGACAG CGACGGCTGG
    CTTCACACTG GAGACATTGG GAAATGGCTG CCGGAGGGAA CTCTTAAAAT CATCGATCGG
    AAAAAGCACA TATTTAAACT TGCTCAGGGA GAATACGTTG CACCGGAGAA GATTGAGAAC
    ATCTATATAC GGAGCGAGCC TGTGGCGCAA GTCTATGTCC ATGGAGACAG CTTAAAGGCC
    TTTTTGGTAG GCATTGTGGT GCCTGACCCT GAAGTCATGC CTTCCTGGGC TCAGAAGAGA
    GGAATCGAAG GGACCTACAT GGAGCTCTGC AAAAATAAGG AGCTGAAGAG AGCCATCCTG
    GATGACATGG TGATGTTAGG AAAAGAAAGT GGACTCCATT CTTTTGAACA GGTTAAAGCC
    ATTTACATCC ACTCTGACAT GTTCTCGGTT CAGAATGGTT TGCTGACACC AACACTAAAG
    GCTAAGAGAC CCGAGCTGAG AGAGTACTTC AGAAAACAAA TAGAAGAGCT TTACTCAACC
    TCCATGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017657765.1
    CDS37..2205
    Translation

    Target ORF information:

    RefSeq Version XM_017802276.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili acyl-CoA synthetase long-chain family member 6 (Acsl6), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017802276.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCTGACTT TCTTCCTCGT GTCCGGGGGC TCCCTCTGGC TGTTTGCGGA GATTGCCCTC 
    TCACTTCTGG AGAAGATGCA GACCCAGGAG ATCCTGAGGA TACTGCGGCT GCCCGAGCTG
    GGCGACTTGG GTCAGTTTTT CCGCAGCCTT TCAGCCACCA CCCTCTTGAG TGTGGGTGCT
    CTGGCTGCCA TCCTGGCCTA CTGGCTCACT CACCGGCCAA AGGCCTTGCA ACCACCATGC
    AACCTCCTGA TGCAGTCAGA AGAAGTGGAG GACAGTGGTG GAGCCCGGCG ATCTGTGATC
    GGAGGTAGCC CTCAGTTGCT TACCCACTAC TACGATGATG CCCGGACCAT GTACCAGGTG
    TTCCGCCGTG GGCTTAGTAT CTCAGGGAAC GGGCCCTGCC TTGGCTTCCG GAAACCTGAG
    CAGCCTTACC AGTGGCTGTC CTACCAAGAG GTGGCCAACA GAGCGGAATA CCTGGGGTCG
    GGACTTCTCC AGCACAACTG TAAAGTGGGC ACAGAGCAGT TCATTGGTGT TTTTGCCCAG
    AATCGGCCAG AGTGGATCAT TGCAGAGTTG GCTTGCTACA CGTACTCCAT GGTGGTGGTC
    CCACTTTACG ACACCCTGGG CCCAGGGGCT ATCCAATACA TCATCAATAC AGCAGACATC
    TTCGTGGTGA TTGTGGATAA GCCTCAGAAG GCTGTGCTTC TTCTGGAGCA CGTGGAGAGG
    AAAGAGACAC CAGGGCTCAA GCTGATCATC CTCATGGAAC CACTTGAGGA CACCCTGAAA
    GAGAGAGGAC AGAAATGCGG GGTGGACATC AAGTCCATGC AGGCTGTAGA AGACCATGGC
    CAAGAGAATC ACTGTGCCCC TGTGCCCCCG CAGCCCGAAG ACCTCTCCAT TGTGTGTTTC
    ACAAGTGGCA CGACAGGGAA CCCCAAAGGT GCGATGCTCA CCCATGGGAA CGTGGTGGCT
    GATTTCTCAG GCTTTCTGAA AGTGACAGAG AAAGTGATCT TTCCGAGACA GGACGATGTG
    CTCATCTCCT TCCTGCCTCT GGCTCACATG TTTGAGAGAG TGATCCAGTC CGTTGTCTAC
    TGCCACGGAG GCCGCGTGGG CTTCTTCCAG GGAGACATTC GCCTCCTCTC AGACGACATG
    AAGGCTCTGC GCCCCACCAT CTTCCCTGTG GTCCCACGGC TACTGAACCG GATGTATGAC
    AAGATCTTCT ACCAGGCAGA CACATCATTA AAGCGCTGGC TCCTAGAGTT TGCAGCAAGG
    CGCAAGCAGG CTGAGGTCCG CAGTGGAATC ATCAGGAATA ATAGTATCTG GGATGAACTC
    TTCTTTAATA AGATCCAGGC CAGTCTTGGA GGGCATGTGA GGATGATTGT TACTGGAGCA
    GCCCCTGCCT CACCAACAGT CCTGGGATTC CTCCGAGCAG CTCTGGGGTG TCAGGTCTAT
    GAAGGTTACG GACAAACTGA ATGCACAGCA GGGTGCACTT TCACGACACC AGGGGACTGG
    ACCTCAGGGC ACGTAGGGGC ACCATTGCCC TGCAATCATA TCAAACTCAT TGATGTGGAG
    GAACTCAACT ACTGGACCCA CAAAGGAGAG GGAGAGATAT GTGTGAAAGG ACCAAATGTG
    TTTAAAGGCT ACTTAAAAGA CAAGGACAGG ACAAAGGAGG CCTTGGACAG CGACGGCTGG
    CTTCACACTG GAGACATTGG GAAATGGCTG CCGGAGGGAA CTCTTAAAAT CATCGATCGG
    AAAAAGCACA TATTTAAACT TGCTCAGGGA GAATACGTTG CACCGGAGAA GATTGAGAAC
    ATCTATATAC GGAGCGAGCC TGTGGCGCAA GTCTATGTCC ATGGAGACAG CTTAAAGGCC
    TTTTTGGTAG GCATTGTGGT GCCTGACCCT GAAGTCATGC CTTCCTGGGC TCAGAAGAGA
    GGAATCGAAG GGACCTACAT GGAGCTCTGC AAAAATAAGG AGCTGAAGAG AGCCATCCTG
    GATGACATGG TGATGTTAGG AAAAGAAAGT GGACTCCATT CTTTTGAACA GGTTAAAGCC
    ATTTACATCC ACTCTGACAT GTTCTCGGTT CAGAATGGTT TGCTGACACC AACACTAAAG
    GCTAAGAGAC CCGAGCTGAG AGAGTACTTC AGAAAACAAA TAGAAGAGCT TTACTCAACC
    TCCATGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa31883
    Clone ID Related Accession (Same CDS sequence) XM_017802276.1 , XM_017802276.2
    Accession Version XM_017802276.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2169bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product long-chain-fatty-acid--CoA ligase 6 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008352334.1) and transcript sequence (JO008799.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017802276.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 72 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCTGACTT TCTTCCTCGT GTCCGGGGGC TCCCTCTGGC TGTTTGCGGA GATTGCCCTC 
    TCACTTCTGG AGAAGATGCA GACCCAGGAG ATCCTGAGGA TACTGCGGCT GCCCGAGCTG
    GGCGACTTGG GTCAGTTTTT CCGCAGCCTT TCAGCCACCA CCCTCTTGAG TGTGGGTGCT
    CTGGCTGCCA TCCTGGCCTA CTGGCTCACT CACCGGCCAA AGGCCTTGCA ACCACCATGC
    AACCTCCTGA TGCAGTCAGA AGAAGTGGAG GACAGTGGTG GAGCCCGGCG ATCTGTGATC
    GGAGGTAGCC CTCAGTTGCT TACCCACTAC TACGATGATG CCCGGACCAT GTACCAGGTG
    TTCCGCCGTG GGCTTAGTAT CTCAGGGAAC GGGCCCTGCC TTGGCTTCCG GAAACCTGAG
    CAGCCTTACC AGTGGCTGTC CTACCAAGAG GTGGCCAACA GAGCGGAATA CCTGGGGTCG
    GGACTTCTCC AGCACAACTG TAAAGTGGGC ACAGAGCAGT TCATTGGTGT TTTTGCCCAG
    AATCGGCCAG AGTGGATCAT TGCAGAGTTG GCTTGCTACA CGTACTCCAT GGTGGTGGTC
    CCACTTTACG ACACCCTGGG CCCAGGGGCT ATCCAATACA TCATCAATAC AGCAGACATC
    TTCGTGGTGA TTGTGGATAA GCCTCAGAAG GCTGTGCTTC TTCTGGAGCA CGTGGAGAGG
    AAAGAGACAC CAGGGCTCAA GCTGATCATC CTCATGGAAC CACTTGAGGA CACCCTGAAA
    GAGAGAGGAC AGAAATGCGG GGTGGACATC AAGTCCATGC AGGCTGTAGA AGACCATGGC
    CAAGAGAATC ACTGTGCCCC TGTGCCCCCG CAGCCCGAAG ACCTCTCCAT TGTGTGTTTC
    ACAAGTGGCA CGACAGGGAA CCCCAAAGGT GCGATGCTCA CCCATGGGAA CGTGGTGGCT
    GATTTCTCAG GCTTTCTGAA AGTGACAGAG AAAGTGATCT TTCCGAGACA GGACGATGTG
    CTCATCTCCT TCCTGCCTCT GGCTCACATG TTTGAGAGAG TGATCCAGTC CGTTGTCTAC
    TGCCACGGAG GCCGCGTGGG CTTCTTCCAG GGAGACATTC GCCTCCTCTC AGACGACATG
    AAGGCTCTGC GCCCCACCAT CTTCCCTGTG GTCCCACGGC TACTGAACCG GATGTATGAC
    AAGATCTTCT ACCAGGCAGA CACATCATTA AAGCGCTGGC TCCTAGAGTT TGCAGCAAGG
    CGCAAGCAGG CTGAGGTCCG CAGTGGAATC ATCAGGAATA ATAGTATCTG GGATGAACTC
    TTCTTTAATA AGATCCAGGC CAGTCTTGGA GGGCATGTGA GGATGATTGT TACTGGAGCA
    GCCCCTGCCT CACCAACAGT CCTGGGATTC CTCCGAGCAG CTCTGGGGTG TCAGGTCTAT
    GAAGGTTACG GACAAACTGA ATGCACAGCA GGGTGCACTT TCACGACACC AGGGGACTGG
    ACCTCAGGGC ACGTAGGGGC ACCATTGCCC TGCAATCATA TCAAACTCAT TGATGTGGAG
    GAACTCAACT ACTGGACCCA CAAAGGAGAG GGAGAGATAT GTGTGAAAGG ACCAAATGTG
    TTTAAAGGCT ACTTAAAAGA CAAGGACAGG ACAAAGGAGG CCTTGGACAG CGACGGCTGG
    CTTCACACTG GAGACATTGG GAAATGGCTG CCGGAGGGAA CTCTTAAAAT CATCGATCGG
    AAAAAGCACA TATTTAAACT TGCTCAGGGA GAATACGTTG CACCGGAGAA GATTGAGAAC
    ATCTATATAC GGAGCGAGCC TGTGGCGCAA GTCTATGTCC ATGGAGACAG CTTAAAGGCC
    TTTTTGGTAG GCATTGTGGT GCCTGACCCT GAAGTCATGC CTTCCTGGGC TCAGAAGAGA
    GGAATCGAAG GGACCTACAT GGAGCTCTGC AAAAATAAGG AGCTGAAGAG AGCCATCCTG
    GATGACATGG TGATGTTAGG AAAAGAAAGT GGACTCCATT CTTTTGAACA GGTTAAAGCC
    ATTTACATCC ACTCTGACAT GTTCTCGGTT CAGAATGGTT TGCTGACACC AACACTAAAG
    GCTAAGAGAC CCGAGCTGAG AGAGTACTTC AGAAAACAAA TAGAAGAGCT TTACTCAACC
    TCCATGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017657765.1
    CDS102..2270
    Translation

    Target ORF information:

    RefSeq Version XM_017802276.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili acyl-CoA synthetase long chain family member 6 (Acsl6), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017802276.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCTGACTT TCTTCCTCGT GTCCGGGGGC TCCCTCTGGC TGTTTGCGGA GATTGCCCTC 
    TCACTTCTGG AGAAGATGCA GACCCAGGAG ATCCTGAGGA TACTGCGGCT GCCCGAGCTG
    GGCGACTTGG GTCAGTTTTT CCGCAGCCTT TCAGCCACCA CCCTCTTGAG TGTGGGTGCT
    CTGGCTGCCA TCCTGGCCTA CTGGCTCACT CACCGGCCAA AGGCCTTGCA ACCACCATGC
    AACCTCCTGA TGCAGTCAGA AGAAGTGGAG GACAGTGGTG GAGCCCGGCG ATCTGTGATC
    GGAGGTAGCC CTCAGTTGCT TACCCACTAC TACGATGATG CCCGGACCAT GTACCAGGTG
    TTCCGCCGTG GGCTTAGTAT CTCAGGGAAC GGGCCCTGCC TTGGCTTCCG GAAACCTGAG
    CAGCCTTACC AGTGGCTGTC CTACCAAGAG GTGGCCAACA GAGCGGAATA CCTGGGGTCG
    GGACTTCTCC AGCACAACTG TAAAGTGGGC ACAGAGCAGT TCATTGGTGT TTTTGCCCAG
    AATCGGCCAG AGTGGATCAT TGCAGAGTTG GCTTGCTACA CGTACTCCAT GGTGGTGGTC
    CCACTTTACG ACACCCTGGG CCCAGGGGCT ATCCAATACA TCATCAATAC AGCAGACATC
    TTCGTGGTGA TTGTGGATAA GCCTCAGAAG GCTGTGCTTC TTCTGGAGCA CGTGGAGAGG
    AAAGAGACAC CAGGGCTCAA GCTGATCATC CTCATGGAAC CACTTGAGGA CACCCTGAAA
    GAGAGAGGAC AGAAATGCGG GGTGGACATC AAGTCCATGC AGGCTGTAGA AGACCATGGC
    CAAGAGAATC ACTGTGCCCC TGTGCCCCCG CAGCCCGAAG ACCTCTCCAT TGTGTGTTTC
    ACAAGTGGCA CGACAGGGAA CCCCAAAGGT GCGATGCTCA CCCATGGGAA CGTGGTGGCT
    GATTTCTCAG GCTTTCTGAA AGTGACAGAG AAAGTGATCT TTCCGAGACA GGACGATGTG
    CTCATCTCCT TCCTGCCTCT GGCTCACATG TTTGAGAGAG TGATCCAGTC CGTTGTCTAC
    TGCCACGGAG GCCGCGTGGG CTTCTTCCAG GGAGACATTC GCCTCCTCTC AGACGACATG
    AAGGCTCTGC GCCCCACCAT CTTCCCTGTG GTCCCACGGC TACTGAACCG GATGTATGAC
    AAGATCTTCT ACCAGGCAGA CACATCATTA AAGCGCTGGC TCCTAGAGTT TGCAGCAAGG
    CGCAAGCAGG CTGAGGTCCG CAGTGGAATC ATCAGGAATA ATAGTATCTG GGATGAACTC
    TTCTTTAATA AGATCCAGGC CAGTCTTGGA GGGCATGTGA GGATGATTGT TACTGGAGCA
    GCCCCTGCCT CACCAACAGT CCTGGGATTC CTCCGAGCAG CTCTGGGGTG TCAGGTCTAT
    GAAGGTTACG GACAAACTGA ATGCACAGCA GGGTGCACTT TCACGACACC AGGGGACTGG
    ACCTCAGGGC ACGTAGGGGC ACCATTGCCC TGCAATCATA TCAAACTCAT TGATGTGGAG
    GAACTCAACT ACTGGACCCA CAAAGGAGAG GGAGAGATAT GTGTGAAAGG ACCAAATGTG
    TTTAAAGGCT ACTTAAAAGA CAAGGACAGG ACAAAGGAGG CCTTGGACAG CGACGGCTGG
    CTTCACACTG GAGACATTGG GAAATGGCTG CCGGAGGGAA CTCTTAAAAT CATCGATCGG
    AAAAAGCACA TATTTAAACT TGCTCAGGGA GAATACGTTG CACCGGAGAA GATTGAGAAC
    ATCTATATAC GGAGCGAGCC TGTGGCGCAA GTCTATGTCC ATGGAGACAG CTTAAAGGCC
    TTTTTGGTAG GCATTGTGGT GCCTGACCCT GAAGTCATGC CTTCCTGGGC TCAGAAGAGA
    GGAATCGAAG GGACCTACAT GGAGCTCTGC AAAAATAAGG AGCTGAAGAG AGCCATCCTG
    GATGACATGG TGATGTTAGG AAAAGAAAGT GGACTCCATT CTTTTGAACA GGTTAAAGCC
    ATTTACATCC ACTCTGACAT GTTCTCGGTT CAGAATGGTT TGCTGACACC AACACTAAAG
    GCTAAGAGAC CCGAGCTGAG AGAGTACTTC AGAAAACAAA TAGAAGAGCT TTACTCAACC
    TCCATGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa31884
    Clone ID Related Accession (Same CDS sequence) XM_017802277.1 , XM_017802277.2
    Accession Version XM_017802277.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2094bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product long-chain-fatty-acid--CoA ligase 6 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008352334.1) and transcript sequence (JO008799.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 72 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGCAGACCC AGGAGATCCT GAGGATACTG CGGCTGCCCG AGCTGGGCGA CTTGGGTCAG 
    TTTTTCCGCA GCCTTTCAGC CACCACCCTC TTGAGTGTGG GTGCTCTGGC TGCCATCCTG
    GCCTACTGGC TCACTCACCG GCCAAAGGCC TTGCAACCAC CATGCAACCT CCTGATGCAG
    TCAGAAGAAG TGGAGGACAG TGGTGGAGCC CGGCGATCTG TGATCGGAGG TAGCCCTCAG
    TTGCTTACCC ACTACTACGA TGATGCCCGG ACCATGTACC AGGTGTTCCG CCGTGGGCTT
    AGTATCTCAG GGAACGGGCC CTGCCTTGGC TTCCGGAAAC CTGAGCAGCC TTACCAGTGG
    CTGTCCTACC AAGAGGTGGC CAACAGAGCG GAATACCTGG GGTCGGGACT TCTCCAGCAC
    AACTGTAAAG TGGGCACAGA GCAGTTCATT GGTGTTTTTG CCCAGAATCG GCCAGAGTGG
    ATCATTGCAG AGTTGGCTTG CTACACGTAC TCCATGGTGG TGGTCCCACT TTACGACACC
    CTGGGCCCAG GGGCTATCCA ATACATCATC AATACAGCAG ACATCTTCGT GGTGATTGTG
    GATAAGCCTC AGAAGGCTGT GCTTCTTCTG GAGCACGTGG AGAGGAAAGA GACACCAGGG
    CTCAAGCTGA TCATCCTCAT GGAACCACTT GAGGACACCC TGAAAGAGAG AGGACAGAAA
    TGCGGGGTGG ACATCAAGTC CATGCAGGCT GTAGAAGACC ATGGCCAAGA GAATCACTGT
    GCCCCTGTGC CCCCGCAGCC CGAAGACCTC TCCATTGTGT GTTTCACAAG TGGCACGACA
    GGGAACCCCA AAGGTGCGAT GCTCACCCAT GGGAACGTGG TGGCTGATTT CTCAGGCTTT
    CTGAAAGTGA CAGAGAAAGT GATCTTTCCG AGACAGGACG ATGTGCTCAT CTCCTTCCTG
    CCTCTGGCTC ACATGTTTGA GAGAGTGATC CAGTCCGTTG TCTACTGCCA CGGAGGCCGC
    GTGGGCTTCT TCCAGGGAGA CATTCGCCTC CTCTCAGACG ACATGAAGGC TCTGCGCCCC
    ACCATCTTCC CTGTGGTCCC ACGGCTACTG AACCGGATGT ATGACAAGAT CTTCTACCAG
    GCAGACACAT CATTAAAGCG CTGGCTCCTA GAGTTTGCAG CAAGGCGCAA GCAGGCTGAG
    GTCCGCAGTG GAATCATCAG GAATAATAGT ATCTGGGATG AACTCTTCTT TAATAAGATC
    CAGGCCAGTC TTGGAGGGCA TGTGAGGATG ATTGTTACTG GAGCAGCCCC TGCCTCACCA
    ACAGTCCTGG GATTCCTCCG AGCAGCTCTG GGGTGTCAGG TCTATGAAGG TTACGGACAA
    ACTGAATGCA CAGCAGGGTG CACTTTCACG ACACCAGGGG ACTGGACCTC AGGGCACGTA
    GGGGCACCAT TGCCCTGCAA TCATATCAAA CTCATTGATG TGGAGGAACT CAACTACTGG
    ACCCACAAAG GAGAGGGAGA GATATGTGTG AAAGGACCAA ATGTGTTTAA AGGCTACTTA
    AAAGACAAGG ACAGGACAAA GGAGGCCTTG GACAGCGACG GCTGGCTTCA CACTGGAGAC
    ATTGGGAAAT GGCTGCCGGA GGGAACTCTT AAAATCATCG ATCGGAAAAA GCACATATTT
    AAACTTGCTC AGGGAGAATA CGTTGCACCG GAGAAGATTG AGAACATCTA TATACGGAGC
    GAGCCTGTGG CGCAAGTCTA TGTCCATGGA GACAGCTTAA AGGCCTTTTT GGTAGGCATT
    GTGGTGCCTG ACCCTGAAGT CATGCCTTCC TGGGCTCAGA AGAGAGGAAT CGAAGGGACC
    TACATGGAGC TCTGCAAAAA TAAGGAGCTG AAGAGAGCCA TCCTGGATGA CATGGTGATG
    TTAGGAAAAG AAAGTGGACT CCATTCTTTT GAACAGGTTA AAGCCATTTA CATCCACTCT
    GACATGTTCT CGGTTCAGAA TGGTTTGCTG ACACCAACAC TAAAGGCTAA GAGACCCGAG
    CTGAGAGAGT ACTTCAGAAA ACAAATAGAA GAGCTTTACT CAACCTCCAT GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017657766.1
    CDS275..2368
    Translation

    Target ORF information:

    RefSeq Version XM_017802277.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili acyl-CoA synthetase long-chain family member 6 (Acsl6), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017802277.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGCAGACCC AGGAGATCCT GAGGATACTG CGGCTGCCCG AGCTGGGCGA CTTGGGTCAG 
    TTTTTCCGCA GCCTTTCAGC CACCACCCTC TTGAGTGTGG GTGCTCTGGC TGCCATCCTG
    GCCTACTGGC TCACTCACCG GCCAAAGGCC TTGCAACCAC CATGCAACCT CCTGATGCAG
    TCAGAAGAAG TGGAGGACAG TGGTGGAGCC CGGCGATCTG TGATCGGAGG TAGCCCTCAG
    TTGCTTACCC ACTACTACGA TGATGCCCGG ACCATGTACC AGGTGTTCCG CCGTGGGCTT
    AGTATCTCAG GGAACGGGCC CTGCCTTGGC TTCCGGAAAC CTGAGCAGCC TTACCAGTGG
    CTGTCCTACC AAGAGGTGGC CAACAGAGCG GAATACCTGG GGTCGGGACT TCTCCAGCAC
    AACTGTAAAG TGGGCACAGA GCAGTTCATT GGTGTTTTTG CCCAGAATCG GCCAGAGTGG
    ATCATTGCAG AGTTGGCTTG CTACACGTAC TCCATGGTGG TGGTCCCACT TTACGACACC
    CTGGGCCCAG GGGCTATCCA ATACATCATC AATACAGCAG ACATCTTCGT GGTGATTGTG
    GATAAGCCTC AGAAGGCTGT GCTTCTTCTG GAGCACGTGG AGAGGAAAGA GACACCAGGG
    CTCAAGCTGA TCATCCTCAT GGAACCACTT GAGGACACCC TGAAAGAGAG AGGACAGAAA
    TGCGGGGTGG ACATCAAGTC CATGCAGGCT GTAGAAGACC ATGGCCAAGA GAATCACTGT
    GCCCCTGTGC CCCCGCAGCC CGAAGACCTC TCCATTGTGT GTTTCACAAG TGGCACGACA
    GGGAACCCCA AAGGTGCGAT GCTCACCCAT GGGAACGTGG TGGCTGATTT CTCAGGCTTT
    CTGAAAGTGA CAGAGAAAGT GATCTTTCCG AGACAGGACG ATGTGCTCAT CTCCTTCCTG
    CCTCTGGCTC ACATGTTTGA GAGAGTGATC CAGTCCGTTG TCTACTGCCA CGGAGGCCGC
    GTGGGCTTCT TCCAGGGAGA CATTCGCCTC CTCTCAGACG ACATGAAGGC TCTGCGCCCC
    ACCATCTTCC CTGTGGTCCC ACGGCTACTG AACCGGATGT ATGACAAGAT CTTCTACCAG
    GCAGACACAT CATTAAAGCG CTGGCTCCTA GAGTTTGCAG CAAGGCGCAA GCAGGCTGAG
    GTCCGCAGTG GAATCATCAG GAATAATAGT ATCTGGGATG AACTCTTCTT TAATAAGATC
    CAGGCCAGTC TTGGAGGGCA TGTGAGGATG ATTGTTACTG GAGCAGCCCC TGCCTCACCA
    ACAGTCCTGG GATTCCTCCG AGCAGCTCTG GGGTGTCAGG TCTATGAAGG TTACGGACAA
    ACTGAATGCA CAGCAGGGTG CACTTTCACG ACACCAGGGG ACTGGACCTC AGGGCACGTA
    GGGGCACCAT TGCCCTGCAA TCATATCAAA CTCATTGATG TGGAGGAACT CAACTACTGG
    ACCCACAAAG GAGAGGGAGA GATATGTGTG AAAGGACCAA ATGTGTTTAA AGGCTACTTA
    AAAGACAAGG ACAGGACAAA GGAGGCCTTG GACAGCGACG GCTGGCTTCA CACTGGAGAC
    ATTGGGAAAT GGCTGCCGGA GGGAACTCTT AAAATCATCG ATCGGAAAAA GCACATATTT
    AAACTTGCTC AGGGAGAATA CGTTGCACCG GAGAAGATTG AGAACATCTA TATACGGAGC
    GAGCCTGTGG CGCAAGTCTA TGTCCATGGA GACAGCTTAA AGGCCTTTTT GGTAGGCATT
    GTGGTGCCTG ACCCTGAAGT CATGCCTTCC TGGGCTCAGA AGAGAGGAAT CGAAGGGACC
    TACATGGAGC TCTGCAAAAA TAAGGAGCTG AAGAGAGCCA TCCTGGATGA CATGGTGATG
    TTAGGAAAAG AAAGTGGACT CCATTCTTTT GAACAGGTTA AAGCCATTTA CATCCACTCT
    GACATGTTCT CGGTTCAGAA TGGTTTGCTG ACACCAACAC TAAAGGCTAA GAGACCCGAG
    CTGAGAGAGT ACTTCAGAAA ACAAATAGAA GAGCTTTACT CAACCTCCAT GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa31884
    Clone ID Related Accession (Same CDS sequence) XM_017802277.1 , XM_017802277.2
    Accession Version XM_017802277.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2094bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product long-chain-fatty-acid--CoA ligase 6 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008352334.1) and transcript sequence (JO008799.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017802277.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 72 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGCAGACCC AGGAGATCCT GAGGATACTG CGGCTGCCCG AGCTGGGCGA CTTGGGTCAG 
    TTTTTCCGCA GCCTTTCAGC CACCACCCTC TTGAGTGTGG GTGCTCTGGC TGCCATCCTG
    GCCTACTGGC TCACTCACCG GCCAAAGGCC TTGCAACCAC CATGCAACCT CCTGATGCAG
    TCAGAAGAAG TGGAGGACAG TGGTGGAGCC CGGCGATCTG TGATCGGAGG TAGCCCTCAG
    TTGCTTACCC ACTACTACGA TGATGCCCGG ACCATGTACC AGGTGTTCCG CCGTGGGCTT
    AGTATCTCAG GGAACGGGCC CTGCCTTGGC TTCCGGAAAC CTGAGCAGCC TTACCAGTGG
    CTGTCCTACC AAGAGGTGGC CAACAGAGCG GAATACCTGG GGTCGGGACT TCTCCAGCAC
    AACTGTAAAG TGGGCACAGA GCAGTTCATT GGTGTTTTTG CCCAGAATCG GCCAGAGTGG
    ATCATTGCAG AGTTGGCTTG CTACACGTAC TCCATGGTGG TGGTCCCACT TTACGACACC
    CTGGGCCCAG GGGCTATCCA ATACATCATC AATACAGCAG ACATCTTCGT GGTGATTGTG
    GATAAGCCTC AGAAGGCTGT GCTTCTTCTG GAGCACGTGG AGAGGAAAGA GACACCAGGG
    CTCAAGCTGA TCATCCTCAT GGAACCACTT GAGGACACCC TGAAAGAGAG AGGACAGAAA
    TGCGGGGTGG ACATCAAGTC CATGCAGGCT GTAGAAGACC ATGGCCAAGA GAATCACTGT
    GCCCCTGTGC CCCCGCAGCC CGAAGACCTC TCCATTGTGT GTTTCACAAG TGGCACGACA
    GGGAACCCCA AAGGTGCGAT GCTCACCCAT GGGAACGTGG TGGCTGATTT CTCAGGCTTT
    CTGAAAGTGA CAGAGAAAGT GATCTTTCCG AGACAGGACG ATGTGCTCAT CTCCTTCCTG
    CCTCTGGCTC ACATGTTTGA GAGAGTGATC CAGTCCGTTG TCTACTGCCA CGGAGGCCGC
    GTGGGCTTCT TCCAGGGAGA CATTCGCCTC CTCTCAGACG ACATGAAGGC TCTGCGCCCC
    ACCATCTTCC CTGTGGTCCC ACGGCTACTG AACCGGATGT ATGACAAGAT CTTCTACCAG
    GCAGACACAT CATTAAAGCG CTGGCTCCTA GAGTTTGCAG CAAGGCGCAA GCAGGCTGAG
    GTCCGCAGTG GAATCATCAG GAATAATAGT ATCTGGGATG AACTCTTCTT TAATAAGATC
    CAGGCCAGTC TTGGAGGGCA TGTGAGGATG ATTGTTACTG GAGCAGCCCC TGCCTCACCA
    ACAGTCCTGG GATTCCTCCG AGCAGCTCTG GGGTGTCAGG TCTATGAAGG TTACGGACAA
    ACTGAATGCA CAGCAGGGTG CACTTTCACG ACACCAGGGG ACTGGACCTC AGGGCACGTA
    GGGGCACCAT TGCCCTGCAA TCATATCAAA CTCATTGATG TGGAGGAACT CAACTACTGG
    ACCCACAAAG GAGAGGGAGA GATATGTGTG AAAGGACCAA ATGTGTTTAA AGGCTACTTA
    AAAGACAAGG ACAGGACAAA GGAGGCCTTG GACAGCGACG GCTGGCTTCA CACTGGAGAC
    ATTGGGAAAT GGCTGCCGGA GGGAACTCTT AAAATCATCG ATCGGAAAAA GCACATATTT
    AAACTTGCTC AGGGAGAATA CGTTGCACCG GAGAAGATTG AGAACATCTA TATACGGAGC
    GAGCCTGTGG CGCAAGTCTA TGTCCATGGA GACAGCTTAA AGGCCTTTTT GGTAGGCATT
    GTGGTGCCTG ACCCTGAAGT CATGCCTTCC TGGGCTCAGA AGAGAGGAAT CGAAGGGACC
    TACATGGAGC TCTGCAAAAA TAAGGAGCTG AAGAGAGCCA TCCTGGATGA CATGGTGATG
    TTAGGAAAAG AAAGTGGACT CCATTCTTTT GAACAGGTTA AAGCCATTTA CATCCACTCT
    GACATGTTCT CGGTTCAGAA TGGTTTGCTG ACACCAACAC TAAAGGCTAA GAGACCCGAG
    CTGAGAGAGT ACTTCAGAAA ACAAATAGAA GAGCTTTACT CAACCTCCAT GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017657766.1
    CDS273..2366
    Translation

    Target ORF information:

    RefSeq Version XM_017802277.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili acyl-CoA synthetase long chain family member 6 (Acsl6), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017802277.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGCAGACCC AGGAGATCCT GAGGATACTG CGGCTGCCCG AGCTGGGCGA CTTGGGTCAG 
    TTTTTCCGCA GCCTTTCAGC CACCACCCTC TTGAGTGTGG GTGCTCTGGC TGCCATCCTG
    GCCTACTGGC TCACTCACCG GCCAAAGGCC TTGCAACCAC CATGCAACCT CCTGATGCAG
    TCAGAAGAAG TGGAGGACAG TGGTGGAGCC CGGCGATCTG TGATCGGAGG TAGCCCTCAG
    TTGCTTACCC ACTACTACGA TGATGCCCGG ACCATGTACC AGGTGTTCCG CCGTGGGCTT
    AGTATCTCAG GGAACGGGCC CTGCCTTGGC TTCCGGAAAC CTGAGCAGCC TTACCAGTGG
    CTGTCCTACC AAGAGGTGGC CAACAGAGCG GAATACCTGG GGTCGGGACT TCTCCAGCAC
    AACTGTAAAG TGGGCACAGA GCAGTTCATT GGTGTTTTTG CCCAGAATCG GCCAGAGTGG
    ATCATTGCAG AGTTGGCTTG CTACACGTAC TCCATGGTGG TGGTCCCACT TTACGACACC
    CTGGGCCCAG GGGCTATCCA ATACATCATC AATACAGCAG ACATCTTCGT GGTGATTGTG
    GATAAGCCTC AGAAGGCTGT GCTTCTTCTG GAGCACGTGG AGAGGAAAGA GACACCAGGG
    CTCAAGCTGA TCATCCTCAT GGAACCACTT GAGGACACCC TGAAAGAGAG AGGACAGAAA
    TGCGGGGTGG ACATCAAGTC CATGCAGGCT GTAGAAGACC ATGGCCAAGA GAATCACTGT
    GCCCCTGTGC CCCCGCAGCC CGAAGACCTC TCCATTGTGT GTTTCACAAG TGGCACGACA
    GGGAACCCCA AAGGTGCGAT GCTCACCCAT GGGAACGTGG TGGCTGATTT CTCAGGCTTT
    CTGAAAGTGA CAGAGAAAGT GATCTTTCCG AGACAGGACG ATGTGCTCAT CTCCTTCCTG
    CCTCTGGCTC ACATGTTTGA GAGAGTGATC CAGTCCGTTG TCTACTGCCA CGGAGGCCGC
    GTGGGCTTCT TCCAGGGAGA CATTCGCCTC CTCTCAGACG ACATGAAGGC TCTGCGCCCC
    ACCATCTTCC CTGTGGTCCC ACGGCTACTG AACCGGATGT ATGACAAGAT CTTCTACCAG
    GCAGACACAT CATTAAAGCG CTGGCTCCTA GAGTTTGCAG CAAGGCGCAA GCAGGCTGAG
    GTCCGCAGTG GAATCATCAG GAATAATAGT ATCTGGGATG AACTCTTCTT TAATAAGATC
    CAGGCCAGTC TTGGAGGGCA TGTGAGGATG ATTGTTACTG GAGCAGCCCC TGCCTCACCA
    ACAGTCCTGG GATTCCTCCG AGCAGCTCTG GGGTGTCAGG TCTATGAAGG TTACGGACAA
    ACTGAATGCA CAGCAGGGTG CACTTTCACG ACACCAGGGG ACTGGACCTC AGGGCACGTA
    GGGGCACCAT TGCCCTGCAA TCATATCAAA CTCATTGATG TGGAGGAACT CAACTACTGG
    ACCCACAAAG GAGAGGGAGA GATATGTGTG AAAGGACCAA ATGTGTTTAA AGGCTACTTA
    AAAGACAAGG ACAGGACAAA GGAGGCCTTG GACAGCGACG GCTGGCTTCA CACTGGAGAC
    ATTGGGAAAT GGCTGCCGGA GGGAACTCTT AAAATCATCG ATCGGAAAAA GCACATATTT
    AAACTTGCTC AGGGAGAATA CGTTGCACCG GAGAAGATTG AGAACATCTA TATACGGAGC
    GAGCCTGTGG CGCAAGTCTA TGTCCATGGA GACAGCTTAA AGGCCTTTTT GGTAGGCATT
    GTGGTGCCTG ACCCTGAAGT CATGCCTTCC TGGGCTCAGA AGAGAGGAAT CGAAGGGACC
    TACATGGAGC TCTGCAAAAA TAAGGAGCTG AAGAGAGCCA TCCTGGATGA CATGGTGATG
    TTAGGAAAAG AAAGTGGACT CCATTCTTTT GAACAGGTTA AAGCCATTTA CATCCACTCT
    GACATGTTCT CGGTTCAGAA TGGTTTGCTG ACACCAACAC TAAAGGCTAA GAGACCCGAG
    CTGAGAGAGT ACTTCAGAAA ACAAATAGAA GAGCTTTACT CAACCTCCAT GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.