Tagap cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

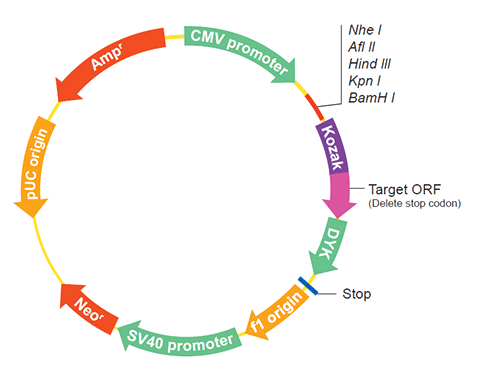
The following Tagap gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Tagap cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa26619 XM_008844318.3
Latest version!
Nannospalax galili T cell activation RhoGTPase activating protein (Tagap), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
ONa26620 XM_017800924.1
Latest version!
Nannospalax galili T cell activation RhoGTPase activating protein (Tagap), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
View Old Accession Versions >>
ONa26619 XM_008844318.2 Nannospalax galili T-cell activation RhoGTPase activating protein (Tagap), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa26619
    Clone ID Related Accession (Same CDS sequence) XM_008844318.2 , XM_008844318.3
    Accession Version XM_008844318.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2139bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
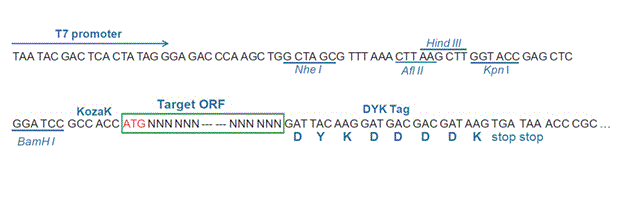
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product T-cell activation Rho GTPase-activating protein isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008347605.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008844318.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAAGTTGA TAAGCAGCTT TGATGCTTCA AAAACACTTG ATGCCAATAA TATGGAGACA 
    TTAATTGAAT GTCAGTCAGA GGGTGACATC AAGGAGCTTC CGATGTTGAC ATCATGTCAG
    AGTGAAGACA GTATTTGCCA GCTAATTGAA GTTAAAAAGA GAAAGAAAGT ACTGTCCTGG
    CCCTCTCTCA TGAGAAGACT CTCGCCTTCA TCTGATTTCT CTGGGTCTTT GGAACCAGAG
    CTGAAAGTGT CACTATTTGA TCAGTCCTTG TCAATCATCT GTGGGGAGAA TGACACACTC
    CCCAGACCCA TCCAGGACAT TCTGACCATC CTTTGCCTTA AAGGCCCTTC AACTGAAGGA
    ATATTCAGGA AAGCTGCCAG TGAGAAAGCC CGCAAGGAGT TGAAGGAGGA GCTCAACTGT
    GGGGGCTCTG TGGACCTGAA CCAGCTGCCT GTGCACCTCC TGGCTGTGGT CTTCAAGGAC
    TTCCTCCGGG GAATCCCCCT GAAGCTACTC TCCTGTGACC TCTTCGAGGA GTGGATGGGT
    GCCCTGGAGA AGCCAAGTGA GGAGGACAGA ATCGAGGCCC TAAAGCAGGT TGCAGATCGC
    CTTCCCCGGC CCAACCTTCT GCTGCTCAGG CACTTGGTCT ATGTGCTGCA TCTCATCAGC
    AAGAATGCTG AGGTCAACAA GATGGACTCC AGCAACCTGG CCATCTGCAT CGGACCCAAC
    ATGCTCACTC TGAAGAATGA CCAAAGCTTG TCCTTCCAAG CCCAGAAAGA CTTGAACAAT
    AAGGTTAAGA CACTGGTGGA ATTCCTCATT GACAACTGTT TTGAAATATT TGGAGAGAAC
    ATTCCAACAC ATTCCCGTAT CACTTCTGAT GACTCCCTGG AACACACTGA CAGTTCAGAT
    GTGTCAACTC TGCAGAATGA CTCAGCTTAT GACAGCAATG ATCCAGATGT GGAACCCACC
    AGTGTTGTCA CCTCTCCCAG CAGGCAGCTG GAAGGGCCCA CTGCCATGGT GGATGGCCTG
    GATGACAGGC ACCCAGAGGA CACCTGTGGG TTAAGCTCAG TGCCCACTGT CAGCATGGTT
    GCTAGGCTGA GAGGCTCCAT CAACCAGCAG GACAGGAGAT TCTCTGAACC CAACATGTCA
    CCCTCACAAG AGTGCTCTAT GACAAAGCAA AAGCTAACAA AAAGTGCGGA CGACTTTACG
    GTGCCCCGGG CGAGCTCTCG TCTTGGAAGT GATAAAGCTG AAGATCCGTT TACAGAGGAA
    GTCTTCCCGG TAGTAGAAGG CAAGCCCAAG AGACCAGTGG ATTTGAAGAT CAAGAACTTG
    ACCCAAGGTT TAGCATCACC ACCAGGACTG ATTCCCAAAG CCTTCTCCAG CGTCTCCCTG
    GATGAATCTT TGGACAGCTC ACCAGTGCCT TCTCCTTCCT GTCCCAAAAG AAATTTCTTC
    ATAAGACATC AGAGTTTCAC AACAAAGACA GACAAAAGCA AGTCCCACAG AGAAATCAGA
    AAGCACTCCA TGTCATTTTC CTTTGCCTCT CACAAAAAAG TGCCTCCCCA GACCCCCAGC
    TCTGGGTCTG GAAAATCCAA AGACTTTCCC AGAGACCAAA TAAGGAAGGG TTTGAGGAGA
    GAAAGTCAGC TTGCTGGCAG AATCGTCCAA GAAAATGGGT CAGACATCCA AGGCCAAACA
    GCTCTGGGCT GCAGCTTGTC TAGAACCTGG ACCCTCTCTG TTGACAATGT ATTCCAGCTA
    GTTGATGTCA GGAAGCCAGG AAGCCCCCCG TCTTACAAAG AGGCCATTCA GAGCCAAGCA
    TCTGGACTCA CAGACTACAG TGGCCAGACT GTTGCAAGTA TGAGAGCAAG AATGCTCAAC
    CAGGACACCA CCCTGTCCCC TCTGCTGCCT TCGCAACACA GGGGTGACCA CAGTGAAGCG
    ATGCCTAGAG GACACAGACT GTCTCCCATG ATTGAGCACT GGAAACAGAA TCAGACTGTC
    AGTGTTTCTG TGGAAACTCA AGGGAGATCT GAGCCTCACA GGTTGAGAAC CACATCTGAG
    TCTGTACAGA AAGATAAGTG GGATTATCTC AGGCAACGAT GTAGCCAGAC AGTCTTTGAG
    GTCGACCAAC TCCAATGTGC TAAAGAATCC TACATTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008842540.1
    CDS247..2385
    Translation

    Target ORF information:

    RefSeq Version XM_008844318.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili T-cell activation RhoGTPase activating protein (Tagap), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008844318.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAAGTTGA TAAGCAGCTT TGATGCTTCA AAAACACTTG ATGCCAATAA TATGGAGACA 
    TTAATTGAAT GTCAGTCAGA GGGTGACATC AAGGAGCTTC CGATGTTGAC ATCATGTCAG
    AGTGAAGACA GTATTTGCCA GCTAATTGAA GTTAAAAAGA GAAAGAAAGT ACTGTCCTGG
    CCCTCTCTCA TGAGAAGACT CTCGCCTTCA TCTGATTTCT CTGGGTCTTT GGAACCAGAG
    CTGAAAGTGT CACTATTTGA TCAGTCCTTG TCAATCATCT GTGGGGAGAA TGACACACTC
    CCCAGACCCA TCCAGGACAT TCTGACCATC CTTTGCCTTA AAGGCCCTTC AACTGAAGGA
    ATATTCAGGA AAGCTGCCAG TGAGAAAGCC CGCAAGGAGT TGAAGGAGGA GCTCAACTGT
    GGGGGCTCTG TGGACCTGAA CCAGCTGCCT GTGCACCTCC TGGCTGTGGT CTTCAAGGAC
    TTCCTCCGGG GAATCCCCCT GAAGCTACTC TCCTGTGACC TCTTCGAGGA GTGGATGGGT
    GCCCTGGAGA AGCCAAGTGA GGAGGACAGA ATCGAGGCCC TAAAGCAGGT TGCAGATCGC
    CTTCCCCGGC CCAACCTTCT GCTGCTCAGG CACTTGGTCT ATGTGCTGCA TCTCATCAGC
    AAGAATGCTG AGGTCAACAA GATGGACTCC AGCAACCTGG CCATCTGCAT CGGACCCAAC
    ATGCTCACTC TGAAGAATGA CCAAAGCTTG TCCTTCCAAG CCCAGAAAGA CTTGAACAAT
    AAGGTTAAGA CACTGGTGGA ATTCCTCATT GACAACTGTT TTGAAATATT TGGAGAGAAC
    ATTCCAACAC ATTCCCGTAT CACTTCTGAT GACTCCCTGG AACACACTGA CAGTTCAGAT
    GTGTCAACTC TGCAGAATGA CTCAGCTTAT GACAGCAATG ATCCAGATGT GGAACCCACC
    AGTGTTGTCA CCTCTCCCAG CAGGCAGCTG GAAGGGCCCA CTGCCATGGT GGATGGCCTG
    GATGACAGGC ACCCAGAGGA CACCTGTGGG TTAAGCTCAG TGCCCACTGT CAGCATGGTT
    GCTAGGCTGA GAGGCTCCAT CAACCAGCAG GACAGGAGAT TCTCTGAACC CAACATGTCA
    CCCTCACAAG AGTGCTCTAT GACAAAGCAA AAGCTAACAA AAAGTGCGGA CGACTTTACG
    GTGCCCCGGG CGAGCTCTCG TCTTGGAAGT GATAAAGCTG AAGATCCGTT TACAGAGGAA
    GTCTTCCCGG TAGTAGAAGG CAAGCCCAAG AGACCAGTGG ATTTGAAGAT CAAGAACTTG
    ACCCAAGGTT TAGCATCACC ACCAGGACTG ATTCCCAAAG CCTTCTCCAG CGTCTCCCTG
    GATGAATCTT TGGACAGCTC ACCAGTGCCT TCTCCTTCCT GTCCCAAAAG AAATTTCTTC
    ATAAGACATC AGAGTTTCAC AACAAAGACA GACAAAAGCA AGTCCCACAG AGAAATCAGA
    AAGCACTCCA TGTCATTTTC CTTTGCCTCT CACAAAAAAG TGCCTCCCCA GACCCCCAGC
    TCTGGGTCTG GAAAATCCAA AGACTTTCCC AGAGACCAAA TAAGGAAGGG TTTGAGGAGA
    GAAAGTCAGC TTGCTGGCAG AATCGTCCAA GAAAATGGGT CAGACATCCA AGGCCAAACA
    GCTCTGGGCT GCAGCTTGTC TAGAACCTGG ACCCTCTCTG TTGACAATGT ATTCCAGCTA
    GTTGATGTCA GGAAGCCAGG AAGCCCCCCG TCTTACAAAG AGGCCATTCA GAGCCAAGCA
    TCTGGACTCA CAGACTACAG TGGCCAGACT GTTGCAAGTA TGAGAGCAAG AATGCTCAAC
    CAGGACACCA CCCTGTCCCC TCTGCTGCCT TCGCAACACA GGGGTGACCA CAGTGAAGCG
    ATGCCTAGAG GACACAGACT GTCTCCCATG ATTGAGCACT GGAAACAGAA TCAGACTGTC
    AGTGTTTCTG TGGAAACTCA AGGGAGATCT GAGCCTCACA GGTTGAGAAC CACATCTGAG
    TCTGTACAGA AAGATAAGTG GGATTATCTC AGGCAACGAT GTAGCCAGAC AGTCTTTGAG
    GTCGACCAAC TCCAATGTGC TAAAGAATCC TACATTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26619
    Clone ID Related Accession (Same CDS sequence) XM_008844318.2 , XM_008844318.3
    Accession Version XM_008844318.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2139bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product T-cell activation Rho GTPase-activating protein isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008347605.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008844318.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAAGTTGA TAAGCAGCTT TGATGCTTCA AAAACACTTG ATGCCAATAA TATGGAGACA 
    TTAATTGAAT GTCAGTCAGA GGGTGACATC AAGGAGCTTC CGATGTTGAC ATCATGTCAG
    AGTGAAGACA GTATTTGCCA GCTAATTGAA GTTAAAAAGA GAAAGAAAGT ACTGTCCTGG
    CCCTCTCTCA TGAGAAGACT CTCGCCTTCA TCTGATTTCT CTGGGTCTTT GGAACCAGAG
    CTGAAAGTGT CACTATTTGA TCAGTCCTTG TCAATCATCT GTGGGGAGAA TGACACACTC
    CCCAGACCCA TCCAGGACAT TCTGACCATC CTTTGCCTTA AAGGCCCTTC AACTGAAGGA
    ATATTCAGGA AAGCTGCCAG TGAGAAAGCC CGCAAGGAGT TGAAGGAGGA GCTCAACTGT
    GGGGGCTCTG TGGACCTGAA CCAGCTGCCT GTGCACCTCC TGGCTGTGGT CTTCAAGGAC
    TTCCTCCGGG GAATCCCCCT GAAGCTACTC TCCTGTGACC TCTTCGAGGA GTGGATGGGT
    GCCCTGGAGA AGCCAAGTGA GGAGGACAGA ATCGAGGCCC TAAAGCAGGT TGCAGATCGC
    CTTCCCCGGC CCAACCTTCT GCTGCTCAGG CACTTGGTCT ATGTGCTGCA TCTCATCAGC
    AAGAATGCTG AGGTCAACAA GATGGACTCC AGCAACCTGG CCATCTGCAT CGGACCCAAC
    ATGCTCACTC TGAAGAATGA CCAAAGCTTG TCCTTCCAAG CCCAGAAAGA CTTGAACAAT
    AAGGTTAAGA CACTGGTGGA ATTCCTCATT GACAACTGTT TTGAAATATT TGGAGAGAAC
    ATTCCAACAC ATTCCCGTAT CACTTCTGAT GACTCCCTGG AACACACTGA CAGTTCAGAT
    GTGTCAACTC TGCAGAATGA CTCAGCTTAT GACAGCAATG ATCCAGATGT GGAACCCACC
    AGTGTTGTCA CCTCTCCCAG CAGGCAGCTG GAAGGGCCCA CTGCCATGGT GGATGGCCTG
    GATGACAGGC ACCCAGAGGA CACCTGTGGG TTAAGCTCAG TGCCCACTGT CAGCATGGTT
    GCTAGGCTGA GAGGCTCCAT CAACCAGCAG GACAGGAGAT TCTCTGAACC CAACATGTCA
    CCCTCACAAG AGTGCTCTAT GACAAAGCAA AAGCTAACAA AAAGTGCGGA CGACTTTACG
    GTGCCCCGGG CGAGCTCTCG TCTTGGAAGT GATAAAGCTG AAGATCCGTT TACAGAGGAA
    GTCTTCCCGG TAGTAGAAGG CAAGCCCAAG AGACCAGTGG ATTTGAAGAT CAAGAACTTG
    ACCCAAGGTT TAGCATCACC ACCAGGACTG ATTCCCAAAG CCTTCTCCAG CGTCTCCCTG
    GATGAATCTT TGGACAGCTC ACCAGTGCCT TCTCCTTCCT GTCCCAAAAG AAATTTCTTC
    ATAAGACATC AGAGTTTCAC AACAAAGACA GACAAAAGCA AGTCCCACAG AGAAATCAGA
    AAGCACTCCA TGTCATTTTC CTTTGCCTCT CACAAAAAAG TGCCTCCCCA GACCCCCAGC
    TCTGGGTCTG GAAAATCCAA AGACTTTCCC AGAGACCAAA TAAGGAAGGG TTTGAGGAGA
    GAAAGTCAGC TTGCTGGCAG AATCGTCCAA GAAAATGGGT CAGACATCCA AGGCCAAACA
    GCTCTGGGCT GCAGCTTGTC TAGAACCTGG ACCCTCTCTG TTGACAATGT ATTCCAGCTA
    GTTGATGTCA GGAAGCCAGG AAGCCCCCCG TCTTACAAAG AGGCCATTCA GAGCCAAGCA
    TCTGGACTCA CAGACTACAG TGGCCAGACT GTTGCAAGTA TGAGAGCAAG AATGCTCAAC
    CAGGACACCA CCCTGTCCCC TCTGCTGCCT TCGCAACACA GGGGTGACCA CAGTGAAGCG
    ATGCCTAGAG GACACAGACT GTCTCCCATG ATTGAGCACT GGAAACAGAA TCAGACTGTC
    AGTGTTTCTG TGGAAACTCA AGGGAGATCT GAGCCTCACA GGTTGAGAAC CACATCTGAG
    TCTGTACAGA AAGATAAGTG GGATTATCTC AGGCAACGAT GTAGCCAGAC AGTCTTTGAG
    GTCGACCAAC TCCAATGTGC TAAAGAATCC TACATTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008842540.1
    CDS246..2384
    Translation

    Target ORF information:

    RefSeq Version XM_008844318.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili T cell activation RhoGTPase activating protein (Tagap), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008844318.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAAGTTGA TAAGCAGCTT TGATGCTTCA AAAACACTTG ATGCCAATAA TATGGAGACA 
    TTAATTGAAT GTCAGTCAGA GGGTGACATC AAGGAGCTTC CGATGTTGAC ATCATGTCAG
    AGTGAAGACA GTATTTGCCA GCTAATTGAA GTTAAAAAGA GAAAGAAAGT ACTGTCCTGG
    CCCTCTCTCA TGAGAAGACT CTCGCCTTCA TCTGATTTCT CTGGGTCTTT GGAACCAGAG
    CTGAAAGTGT CACTATTTGA TCAGTCCTTG TCAATCATCT GTGGGGAGAA TGACACACTC
    CCCAGACCCA TCCAGGACAT TCTGACCATC CTTTGCCTTA AAGGCCCTTC AACTGAAGGA
    ATATTCAGGA AAGCTGCCAG TGAGAAAGCC CGCAAGGAGT TGAAGGAGGA GCTCAACTGT
    GGGGGCTCTG TGGACCTGAA CCAGCTGCCT GTGCACCTCC TGGCTGTGGT CTTCAAGGAC
    TTCCTCCGGG GAATCCCCCT GAAGCTACTC TCCTGTGACC TCTTCGAGGA GTGGATGGGT
    GCCCTGGAGA AGCCAAGTGA GGAGGACAGA ATCGAGGCCC TAAAGCAGGT TGCAGATCGC
    CTTCCCCGGC CCAACCTTCT GCTGCTCAGG CACTTGGTCT ATGTGCTGCA TCTCATCAGC
    AAGAATGCTG AGGTCAACAA GATGGACTCC AGCAACCTGG CCATCTGCAT CGGACCCAAC
    ATGCTCACTC TGAAGAATGA CCAAAGCTTG TCCTTCCAAG CCCAGAAAGA CTTGAACAAT
    AAGGTTAAGA CACTGGTGGA ATTCCTCATT GACAACTGTT TTGAAATATT TGGAGAGAAC
    ATTCCAACAC ATTCCCGTAT CACTTCTGAT GACTCCCTGG AACACACTGA CAGTTCAGAT
    GTGTCAACTC TGCAGAATGA CTCAGCTTAT GACAGCAATG ATCCAGATGT GGAACCCACC
    AGTGTTGTCA CCTCTCCCAG CAGGCAGCTG GAAGGGCCCA CTGCCATGGT GGATGGCCTG
    GATGACAGGC ACCCAGAGGA CACCTGTGGG TTAAGCTCAG TGCCCACTGT CAGCATGGTT
    GCTAGGCTGA GAGGCTCCAT CAACCAGCAG GACAGGAGAT TCTCTGAACC CAACATGTCA
    CCCTCACAAG AGTGCTCTAT GACAAAGCAA AAGCTAACAA AAAGTGCGGA CGACTTTACG
    GTGCCCCGGG CGAGCTCTCG TCTTGGAAGT GATAAAGCTG AAGATCCGTT TACAGAGGAA
    GTCTTCCCGG TAGTAGAAGG CAAGCCCAAG AGACCAGTGG ATTTGAAGAT CAAGAACTTG
    ACCCAAGGTT TAGCATCACC ACCAGGACTG ATTCCCAAAG CCTTCTCCAG CGTCTCCCTG
    GATGAATCTT TGGACAGCTC ACCAGTGCCT TCTCCTTCCT GTCCCAAAAG AAATTTCTTC
    ATAAGACATC AGAGTTTCAC AACAAAGACA GACAAAAGCA AGTCCCACAG AGAAATCAGA
    AAGCACTCCA TGTCATTTTC CTTTGCCTCT CACAAAAAAG TGCCTCCCCA GACCCCCAGC
    TCTGGGTCTG GAAAATCCAA AGACTTTCCC AGAGACCAAA TAAGGAAGGG TTTGAGGAGA
    GAAAGTCAGC TTGCTGGCAG AATCGTCCAA GAAAATGGGT CAGACATCCA AGGCCAAACA
    GCTCTGGGCT GCAGCTTGTC TAGAACCTGG ACCCTCTCTG TTGACAATGT ATTCCAGCTA
    GTTGATGTCA GGAAGCCAGG AAGCCCCCCG TCTTACAAAG AGGCCATTCA GAGCCAAGCA
    TCTGGACTCA CAGACTACAG TGGCCAGACT GTTGCAAGTA TGAGAGCAAG AATGCTCAAC
    CAGGACACCA CCCTGTCCCC TCTGCTGCCT TCGCAACACA GGGGTGACCA CAGTGAAGCG
    ATGCCTAGAG GACACAGACT GTCTCCCATG ATTGAGCACT GGAAACAGAA TCAGACTGTC
    AGTGTTTCTG TGGAAACTCA AGGGAGATCT GAGCCTCACA GGTTGAGAAC CACATCTGAG
    TCTGTACAGA AAGATAAGTG GGATTATCTC AGGCAACGAT GTAGCCAGAC AGTCTTTGAG
    GTCGACCAAC TCCAATGTGC TAAAGAATCC TACATTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26620
    Clone ID Related Accession (Same CDS sequence) XM_017800924.1
    Accession Version XM_017800924.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2121bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product T-cell activation Rho GTPase-activating protein isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008347605.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGCTGTATT CAAAAACACT TGATGCCAAT AATATGGAGA CATTAATTGA ATGTCAGTCA 
    GAGGGTGACA TCAAGGAGCT TCCGATGTTG ACATCATGTC AGAGTGAAGA CAGTATTTGC
    CAGCTAATTG AAGTTAAAAA GAGAAAGAAA GTACTGTCCT GGCCCTCTCT CATGAGAAGA
    CTCTCGCCTT CATCTGATTT CTCTGGGTCT TTGGAACCAG AGCTGAAAGT GTCACTATTT
    GATCAGTCCT TGTCAATCAT CTGTGGGGAG AATGACACAC TCCCCAGACC CATCCAGGAC
    ATTCTGACCA TCCTTTGCCT TAAAGGCCCT TCAACTGAAG GAATATTCAG GAAAGCTGCC
    AGTGAGAAAG CCCGCAAGGA GTTGAAGGAG GAGCTCAACT GTGGGGGCTC TGTGGACCTG
    AACCAGCTGC CTGTGCACCT CCTGGCTGTG GTCTTCAAGG ACTTCCTCCG GGGAATCCCC
    CTGAAGCTAC TCTCCTGTGA CCTCTTCGAG GAGTGGATGG GTGCCCTGGA GAAGCCAAGT
    GAGGAGGACA GAATCGAGGC CCTAAAGCAG GTTGCAGATC GCCTTCCCCG GCCCAACCTT
    CTGCTGCTCA GGCACTTGGT CTATGTGCTG CATCTCATCA GCAAGAATGC TGAGGTCAAC
    AAGATGGACT CCAGCAACCT GGCCATCTGC ATCGGACCCA ACATGCTCAC TCTGAAGAAT
    GACCAAAGCT TGTCCTTCCA AGCCCAGAAA GACTTGAACA ATAAGGTTAA GACACTGGTG
    GAATTCCTCA TTGACAACTG TTTTGAAATA TTTGGAGAGA ACATTCCAAC ACATTCCCGT
    ATCACTTCTG ATGACTCCCT GGAACACACT GACAGTTCAG ATGTGTCAAC TCTGCAGAAT
    GACTCAGCTT ATGACAGCAA TGATCCAGAT GTGGAACCCA CCAGTGTTGT CACCTCTCCC
    AGCAGGCAGC TGGAAGGGCC CACTGCCATG GTGGATGGCC TGGATGACAG GCACCCAGAG
    GACACCTGTG GGTTAAGCTC AGTGCCCACT GTCAGCATGG TTGCTAGGCT GAGAGGCTCC
    ATCAACCAGC AGGACAGGAG ATTCTCTGAA CCCAACATGT CACCCTCACA AGAGTGCTCT
    ATGACAAAGC AAAAGCTAAC AAAAAGTGCG GACGACTTTA CGGTGCCCCG GGCGAGCTCT
    CGTCTTGGAA GTGATAAAGC TGAAGATCCG TTTACAGAGG AAGTCTTCCC GGTAGTAGAA
    GGCAAGCCCA AGAGACCAGT GGATTTGAAG ATCAAGAACT TGACCCAAGG TTTAGCATCA
    CCACCAGGAC TGATTCCCAA AGCCTTCTCC AGCGTCTCCC TGGATGAATC TTTGGACAGC
    TCACCAGTGC CTTCTCCTTC CTGTCCCAAA AGAAATTTCT TCATAAGACA TCAGAGTTTC
    ACAACAAAGA CAGACAAAAG CAAGTCCCAC AGAGAAATCA GAAAGCACTC CATGTCATTT
    TCCTTTGCCT CTCACAAAAA AGTGCCTCCC CAGACCCCCA GCTCTGGGTC TGGAAAATCC
    AAAGACTTTC CCAGAGACCA AATAAGGAAG GGTTTGAGGA GAGAAAGTCA GCTTGCTGGC
    AGAATCGTCC AAGAAAATGG GTCAGACATC CAAGGCCAAA CAGCTCTGGG CTGCAGCTTG
    TCTAGAACCT GGACCCTCTC TGTTGACAAT GTATTCCAGC TAGTTGATGT CAGGAAGCCA
    GGAAGCCCCC CGTCTTACAA AGAGGCCATT CAGAGCCAAG CATCTGGACT CACAGACTAC
    AGTGGCCAGA CTGTTGCAAG TATGAGAGCA AGAATGCTCA ACCAGGACAC CACCCTGTCC
    CCTCTGCTGC CTTCGCAACA CAGGGGTGAC CACAGTGAAG CGATGCCTAG AGGACACAGA
    CTGTCTCCCA TGATTGAGCA CTGGAAACAG AATCAGACTG TCAGTGTTTC TGTGGAAACT
    CAAGGGAGAT CTGAGCCTCA CAGGTTGAGA ACCACATCTG AGTCTGTACA GAAAGATAAG
    TGGGATTATC TCAGGCAACG ATGTAGCCAG ACAGTCTTTG AGGTCGACCA ACTCCAATGT
    GCTAAAGAAT CCTACATTTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_017656413.1
    CDS80..2200
    Translation

    Target ORF information:

    RefSeq Version XM_017800924.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili T cell activation RhoGTPase activating protein (Tagap), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017800924.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGCTGTATT CAAAAACACT TGATGCCAAT AATATGGAGA CATTAATTGA ATGTCAGTCA 
    GAGGGTGACA TCAAGGAGCT TCCGATGTTG ACATCATGTC AGAGTGAAGA CAGTATTTGC
    CAGCTAATTG AAGTTAAAAA GAGAAAGAAA GTACTGTCCT GGCCCTCTCT CATGAGAAGA
    CTCTCGCCTT CATCTGATTT CTCTGGGTCT TTGGAACCAG AGCTGAAAGT GTCACTATTT
    GATCAGTCCT TGTCAATCAT CTGTGGGGAG AATGACACAC TCCCCAGACC CATCCAGGAC
    ATTCTGACCA TCCTTTGCCT TAAAGGCCCT TCAACTGAAG GAATATTCAG GAAAGCTGCC
    AGTGAGAAAG CCCGCAAGGA GTTGAAGGAG GAGCTCAACT GTGGGGGCTC TGTGGACCTG
    AACCAGCTGC CTGTGCACCT CCTGGCTGTG GTCTTCAAGG ACTTCCTCCG GGGAATCCCC
    CTGAAGCTAC TCTCCTGTGA CCTCTTCGAG GAGTGGATGG GTGCCCTGGA GAAGCCAAGT
    GAGGAGGACA GAATCGAGGC CCTAAAGCAG GTTGCAGATC GCCTTCCCCG GCCCAACCTT
    CTGCTGCTCA GGCACTTGGT CTATGTGCTG CATCTCATCA GCAAGAATGC TGAGGTCAAC
    AAGATGGACT CCAGCAACCT GGCCATCTGC ATCGGACCCA ACATGCTCAC TCTGAAGAAT
    GACCAAAGCT TGTCCTTCCA AGCCCAGAAA GACTTGAACA ATAAGGTTAA GACACTGGTG
    GAATTCCTCA TTGACAACTG TTTTGAAATA TTTGGAGAGA ACATTCCAAC ACATTCCCGT
    ATCACTTCTG ATGACTCCCT GGAACACACT GACAGTTCAG ATGTGTCAAC TCTGCAGAAT
    GACTCAGCTT ATGACAGCAA TGATCCAGAT GTGGAACCCA CCAGTGTTGT CACCTCTCCC
    AGCAGGCAGC TGGAAGGGCC CACTGCCATG GTGGATGGCC TGGATGACAG GCACCCAGAG
    GACACCTGTG GGTTAAGCTC AGTGCCCACT GTCAGCATGG TTGCTAGGCT GAGAGGCTCC
    ATCAACCAGC AGGACAGGAG ATTCTCTGAA CCCAACATGT CACCCTCACA AGAGTGCTCT
    ATGACAAAGC AAAAGCTAAC AAAAAGTGCG GACGACTTTA CGGTGCCCCG GGCGAGCTCT
    CGTCTTGGAA GTGATAAAGC TGAAGATCCG TTTACAGAGG AAGTCTTCCC GGTAGTAGAA
    GGCAAGCCCA AGAGACCAGT GGATTTGAAG ATCAAGAACT TGACCCAAGG TTTAGCATCA
    CCACCAGGAC TGATTCCCAA AGCCTTCTCC AGCGTCTCCC TGGATGAATC TTTGGACAGC
    TCACCAGTGC CTTCTCCTTC CTGTCCCAAA AGAAATTTCT TCATAAGACA TCAGAGTTTC
    ACAACAAAGA CAGACAAAAG CAAGTCCCAC AGAGAAATCA GAAAGCACTC CATGTCATTT
    TCCTTTGCCT CTCACAAAAA AGTGCCTCCC CAGACCCCCA GCTCTGGGTC TGGAAAATCC
    AAAGACTTTC CCAGAGACCA AATAAGGAAG GGTTTGAGGA GAGAAAGTCA GCTTGCTGGC
    AGAATCGTCC AAGAAAATGG GTCAGACATC CAAGGCCAAA CAGCTCTGGG CTGCAGCTTG
    TCTAGAACCT GGACCCTCTC TGTTGACAAT GTATTCCAGC TAGTTGATGT CAGGAAGCCA
    GGAAGCCCCC CGTCTTACAA AGAGGCCATT CAGAGCCAAG CATCTGGACT CACAGACTAC
    AGTGGCCAGA CTGTTGCAAG TATGAGAGCA AGAATGCTCA ACCAGGACAC CACCCTGTCC
    CCTCTGCTGC CTTCGCAACA CAGGGGTGAC CACAGTGAAG CGATGCCTAG AGGACACAGA
    CTGTCTCCCA TGATTGAGCA CTGGAAACAG AATCAGACTG TCAGTGTTTC TGTGGAAACT
    CAAGGGAGAT CTGAGCCTCA CAGGTTGAGA ACCACATCTG AGTCTGTACA GAAAGATAAG
    TGGGATTATC TCAGGCAACG ATGTAGCCAG ACAGTCTTTG AGGTCGACCA ACTCCAATGT
    GCTAAAGAAT CCTACATTTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.