Dhx30 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

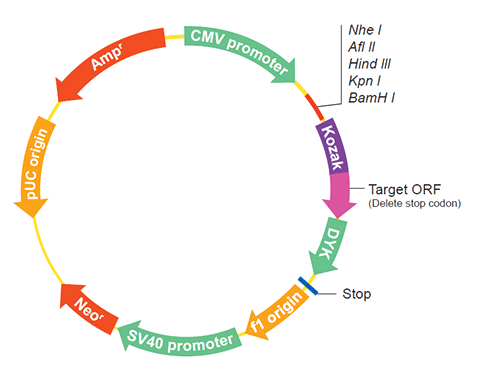
The following Dhx30 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Dhx30 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa133529 XM_029562303.1
Latest version!
Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa26834 XM_008830763.1
Latest version!
Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa26835 XM_008830772.2
Latest version!
Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa26836 XM_008830779.2
Latest version!
Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa26837 XM_008830784.2
Latest version!
Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa26838 XM_008830786.2
Latest version!
Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa26839 XM_029562305.1
Latest version!
Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa26839 XM_008830794.1
Latest version!
Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X8, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa26839 XM_017797511.2
Latest version!
Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa26839 XM_008830789.2
Latest version!
Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X7, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
View Old Accession Versions >>
ONa26835 XM_008830772.1 Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa26836 XM_008830779.1 Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa26839 XM_017797511.1 Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa133529
    Clone ID Related Accession (Same CDS sequence) XM_029562303.1
    Accession Version XM_029562303.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3468bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
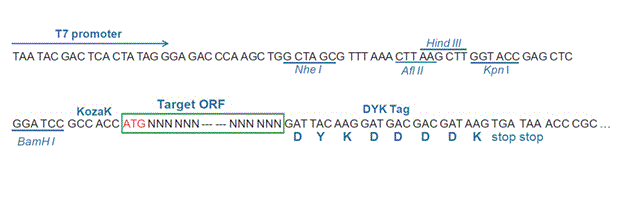
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product ATP-dependent RNA helicase DHX30 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGTTAGCTT CTAGGGACCT ATTAAAAGAG TTTCCACAGC CCAAAAACCT TCTCAACAGT 
    GTGATTGGAA GAGCCCTTGG CATCTCACAT GCAAAAGACA AGCTAGTCTA TGTGCACACT
    AATGGACCTA AGAAAAAGAA AGTTACCTTG CACATAAAGT GGCCCAAGAG CGTGGAGGTG
    GAAGGCTATG GCAGCAAGAA GATTGATGCT GAGCGGCAGG CTGCAGCAGC AGCTTGCCAG
    TTGTTTAAGG GCTGGGGTCT GTTGGGTCCC CGGAATGAGC TGTTTGATGC AGCCAAATAC
    CGAGTGCTAG CTGATCGGTT CGGCTCTCCA GCTGACAGCT GGTGGCGCCC AGAACCCACC
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418163.1
    CDS187..3654
    Translation

    Target ORF information:

    RefSeq Version XM_029562303.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029562303.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGTTAGCTT CTAGGGACCT ATTAAAAGAG TTTCCACAGC CCAAAAACCT TCTCAACAGT 
    GTGATTGGAA GAGCCCTTGG CATCTCACAT GCAAAAGACA AGCTAGTCTA TGTGCACACT
    AATGGACCTA AGAAAAAGAA AGTTACCTTG CACATAAAGT GGCCCAAGAG CGTGGAGGTG
    GAAGGCTATG GCAGCAAGAA GATTGATGCT GAGCGGCAGG CTGCAGCAGC AGCTTGCCAG
    TTGTTTAAGG GCTGGGGTCT GTTGGGTCCC CGGAATGAGC TGTTTGATGC AGCCAAATAC
    CGAGTGCTAG CTGATCGGTT CGGCTCTCCA GCTGACAGCT GGTGGCGCCC AGAACCCACC
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26834
    Clone ID Related Accession (Same CDS sequence) XM_008830763.1
    Accession Version XM_008830763.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3669bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product ATP-dependent RNA helicase DHX30 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGGCGGCCG CCAGGAGGCT CATGGCGCTG GCTGCCGGCG TCTCTCCGCG CCTGCGGCCA 
    CCGGATCCCC GAGCTTCCGG GAGATCGGGA CGCTCTCGCG CCCTCTCATC AAACTTCGTC
    AGCCCTGAGG GTACCCAGGA GGCTGCTGAG GCCGAGTCAG AGGTGGCCCC TGGCGAGCCC
    TGGGAAGGCG ACGGAAGCAT GGTGAATGCT TCTAGGGACC TATTAAAAGA GTTTCCACAG
    CCCAAAAACC TTCTCAACAG TGTGATTGGA AGAGCCCTTG GCATCTCACA TGCAAAAGAC
    AAGCTAGTCT ATGTGCACAC TAATGGACCT AAGAAAAAGA AAGTTACCTT GCACATAAAG
    TGGCCCAAGA GCGTGGAGGT GGAAGGCTAT GGCAGCAAGA AGATTGATGC TGAGCGGCAG
    GCTGCAGCAG CAGCTTGCCA GTTGTTTAAG GGCTGGGGTC TGTTGGGTCC CCGGAATGAG
    CTGTTTGATG CAGCCAAATA CCGAGTGCTA GCTGATCGGT TCGGCTCTCC AGCTGACAGC
    TGGTGGCGCC CAGAACCCAC CATGCCTCCC ACTTCCTGGC GACAGCTGAA TCCTGAAAAC
    ATTCGGCCAG GAGGTCCTGG GGGCCTATCC CGCTCCTTAG GCCGGGAGGA AGAGGAAGAT
    GAGGAAGAAG AGCTAGAAGA GGGGACCATT GATGTTACGG AGTTCCTGTC CATGACACAG
    CAAGACTCCC ATAACCCACT CAGGGACTCA AGGGGAGGCT CCTTTGAAAT GACAGATGAT
    GACAGTGCTA TTAGGGCTCT GACCCAGTTT CCACTTCCCA AGAATCTTCT GGCCAAGGTG
    ATTCAGATTG CAACATCCTC CTCCACAGCT AAGAACCTTA TGCAGTTCCA TACCGTGGGT
    ACCAAGACAA AGCTGGCTAC ACTCACTCTG CTCTGGCCCT GTCCCATGAC CTTTGTTGCC
    AAAGGGCGCC GCAAAGCAGA GGCTGAGAAT AAGGCAGCAG CCTTGGCCTG CAAGAAACTG
    AAGAGCCTGG GCCTGGTGGA CCGGAACAAT GAGCCACTTA CCCATGCCAT GTACAACCTG
    GCCTCCTTGC GTGAGTTGGG TGAGACCCAG CGCCGGCCGT GTACCATCCA GGTGCCGGAG
    CCCATCCTCC GCAAAATAGA GACCTTCCTG AATCATTACC CCGTGGACAG TTCATGGATT
    TCCCCAGAGC TCCGGCTGCA GAGTGATGAC ATCTTGCCGT TAGGCAAGGA CTCAGGGCCC
    CTGAGCGACC CTATTACAGG CAAGCCATAT GTGCCCCTGT CAGAAGCAGA GGAGGTGCGC
    CTGAGCCAGA GCCTGCTAGA GCTGTGGCGG CGGCGAGGGC CAGTCTGGCA GGAGGCCCCC
    CAGCTACCTG TGGATCCACA TCGGGACACT ATCCTCAGTG CCATTGAGCA GCACCCAGTA
    GTGGTCATCT CTGGGGACAC AGGTTGTGGA AAGACCACAC GCATCCCTCA GCTGCTGCTG
    GAGCGCTATG TGACTGAGGG CCGCGGTGCC CGCTGCAATG TGATCATCAC CCAACCACGC
    CGCATCTCAG CTGTGTCTGT GGCACAGCGG GTCAGCCACG AACTGGGCCC CTCCTTGCGC
    CGGAATGTGG GCTTCCAAGT GCGCTTGGAA AGCAAGCCCC CAGCCCGAGG TGGGGCGCTG
    CTCTTCTGCA CTGTGGGTAT ACTGCTGAGG AAGCTGCAGA GCAATCCCAG CCTGGAGGGC
    GTGAGCCATG TCATTGTGGA TGAGGTCCAT GAGCGGGATG TGAACACAGA CTTCCTGTTG
    ATCCTGCTCA AGGGCCTGCA GCGGCTCAAC CCAGCTCTAC GGCTAGTGCT CATGAGTGCT
    ACAGGTGATA ATGAGCGCTT CTCCCGCTAC TTTGGTGGCT GTCCTGTCAT CAAGGTGCCT
    GGCTTTATGT ATCCTGTCAA AGAGCACTAC CTGGAGGACA TCCTGGCCAA GCTGGGTAAA
    CACCAGTACC CGCACCGGCA CCGGCACCAT GAGTCTGAAG ATGAATGTGC ACTTGATTTG
    GACCTGGTGA CTGATCTGGT TCTGCACATC GATGCCCGTG GGGAACCAGG TGGGATCCTG
    TGCTTCTTGC CTGGTTGGCA GGAGATCAAA GGAGTGCAAC AACGCCTCCA GGAGGCCCTG
    GGCATGCACG AGAGCAAGTA CCTCATCCTG CCAGTGCACT CCAACATCCC CATGATGGAC
    CAAAAGGCCA TATTCCAGCA GCCTCCACTT GGGGTGCGCA AGATTGTACT GGCCACCAAC
    ATTGCAGAGA CCTCCATCAC AGTTAATGAC ATTGTGCATG TTGTGGACAG CGGCCTGCAC
    AAGGAGGAAC GCTATGACCT CAAGACCAAG GTGTCATGCT TAGAGACTGT GTGGGTGTCA
    AGAGCAAATG TGATCCAGCG CCGGGGCCGA GCAGGCCGCT GCCAGTCAGG TTTTGCCTAC
    CACTTGTTTC CACGGAGTCG ACTGGAGAAA ATGGTCCCTT TCCAAGTGCC AGAGATCCTG
    CGCACGCCTC TGGAGAACCT GGTGCTGCAA GCTAAAATCC ATATGCCTGA GAAGACGGCA
    GTGGAGTTCC TTTCCAAGGC TGTGGACAGT CCCAACATCA AGGCAGTGGA TGAGGCTGTG
    ATACTGCTTC AGGAGATCGG GGTGCTGGAC CAGCGGGAGT ACCTGACCAC CTTGGGGCAG
    CGCCTGGCCC ACATCTCTAC TGACCCCCGG CTGGCCAAGG CCATAGTGCT GGCTGCCATC
    TTCCGTTGCC TACACCCGTT GCTGGTGGTT GTTTCCTGCC TCACCCGGGA CCCTTTCAGC
    AGCAGTTTGC AGAACCGGGC AGAGGTGGAC AAGGTAAAGG CTCTGCTGAG CCATGACAGT
    GGCAGTGACC ACTTGGCCTT TGTGCGGGCC GTCGCTGGTT GGGAGGAGGT GCTGCGTTGG
    CAGGACCGCA CCTCCCGGGA AAACTACCTG GAAGAAAACC TGCTCTATGC CCCCAGCTTG
    CGCTTCATCC ACGGGCTTAT CAAGCAGTTC TCAGAGAATA TTTACGAGGC TTTTCTAGTG
    GGAAAGCCCT CAGACTGCAC ACTGCCTTCT GCCCAGTGCA ACGAGTACAG TGAGGAAGAG
    GAACTGGTGA AGGGTGTGCT GATGGCTGGC CTCTACCCCA ACCTCATCCA GGTGAGGCAG
    GGTAAGGTGA CTCGGCAGGG GAAGTTCAAG CCCAACAGTG TCACTTACAG GACCAAATCT
    GGCAATATCT TGCTGCACAA GTCAACTATT AACAGGGAGG CTACCCGGTT ACGGAGCCGA
    TGGCTGACAT ATTTCATGGC TGTTAAGTCC AATGGCAGCG TCTTTGTGCG AGATTCCTCC
    CAGGTGCACC CGCTAGCTGT GCTGCTCCTA ACTGATGGGG ACGTTCACAT CCGAGATGAT
    GGGCGTCGGG CTACCATCTC ACTGAGTGAC AGTGACCTGC TGCGGCTGGA AGGCGACTCA
    CGAACTGTGC GGCTGCTGAG GGAGCTGCGG CGAGCCCTGG GCCGCATGGT GGAGCGGAGC
    CTTCGCAGCG AACTGGCCGC ACTTCCTCTC AGTGTACAGC AGGAGCACGG GCAGCTGCTC
    GCGCTGCTGG CAGAACTGCT GCGAGGACCT TGTGGCAGCT TTGACGTGCG CAAGACAGCT
    GATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008828985.1
    CDS53..3721
    Translation

    Target ORF information:

    RefSeq Version XM_008830763.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830763.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGGCGGCCG CCAGGAGGCT CATGGCGCTG GCTGCCGGCG TCTCTCCGCG CCTGCGGCCA 
    CCGGATCCCC GAGCTTCCGG GAGATCGGGA CGCTCTCGCG CCCTCTCATC AAACTTCGTC
    AGCCCTGAGG GTACCCAGGA GGCTGCTGAG GCCGAGTCAG AGGTGGCCCC TGGCGAGCCC
    TGGGAAGGCG ACGGAAGCAT GGTGAATGCT TCTAGGGACC TATTAAAAGA GTTTCCACAG
    CCCAAAAACC TTCTCAACAG TGTGATTGGA AGAGCCCTTG GCATCTCACA TGCAAAAGAC
    AAGCTAGTCT ATGTGCACAC TAATGGACCT AAGAAAAAGA AAGTTACCTT GCACATAAAG
    TGGCCCAAGA GCGTGGAGGT GGAAGGCTAT GGCAGCAAGA AGATTGATGC TGAGCGGCAG
    GCTGCAGCAG CAGCTTGCCA GTTGTTTAAG GGCTGGGGTC TGTTGGGTCC CCGGAATGAG
    CTGTTTGATG CAGCCAAATA CCGAGTGCTA GCTGATCGGT TCGGCTCTCC AGCTGACAGC
    TGGTGGCGCC CAGAACCCAC CATGCCTCCC ACTTCCTGGC GACAGCTGAA TCCTGAAAAC
    ATTCGGCCAG GAGGTCCTGG GGGCCTATCC CGCTCCTTAG GCCGGGAGGA AGAGGAAGAT
    GAGGAAGAAG AGCTAGAAGA GGGGACCATT GATGTTACGG AGTTCCTGTC CATGACACAG
    CAAGACTCCC ATAACCCACT CAGGGACTCA AGGGGAGGCT CCTTTGAAAT GACAGATGAT
    GACAGTGCTA TTAGGGCTCT GACCCAGTTT CCACTTCCCA AGAATCTTCT GGCCAAGGTG
    ATTCAGATTG CAACATCCTC CTCCACAGCT AAGAACCTTA TGCAGTTCCA TACCGTGGGT
    ACCAAGACAA AGCTGGCTAC ACTCACTCTG CTCTGGCCCT GTCCCATGAC CTTTGTTGCC
    AAAGGGCGCC GCAAAGCAGA GGCTGAGAAT AAGGCAGCAG CCTTGGCCTG CAAGAAACTG
    AAGAGCCTGG GCCTGGTGGA CCGGAACAAT GAGCCACTTA CCCATGCCAT GTACAACCTG
    GCCTCCTTGC GTGAGTTGGG TGAGACCCAG CGCCGGCCGT GTACCATCCA GGTGCCGGAG
    CCCATCCTCC GCAAAATAGA GACCTTCCTG AATCATTACC CCGTGGACAG TTCATGGATT
    TCCCCAGAGC TCCGGCTGCA GAGTGATGAC ATCTTGCCGT TAGGCAAGGA CTCAGGGCCC
    CTGAGCGACC CTATTACAGG CAAGCCATAT GTGCCCCTGT CAGAAGCAGA GGAGGTGCGC
    CTGAGCCAGA GCCTGCTAGA GCTGTGGCGG CGGCGAGGGC CAGTCTGGCA GGAGGCCCCC
    CAGCTACCTG TGGATCCACA TCGGGACACT ATCCTCAGTG CCATTGAGCA GCACCCAGTA
    GTGGTCATCT CTGGGGACAC AGGTTGTGGA AAGACCACAC GCATCCCTCA GCTGCTGCTG
    GAGCGCTATG TGACTGAGGG CCGCGGTGCC CGCTGCAATG TGATCATCAC CCAACCACGC
    CGCATCTCAG CTGTGTCTGT GGCACAGCGG GTCAGCCACG AACTGGGCCC CTCCTTGCGC
    CGGAATGTGG GCTTCCAAGT GCGCTTGGAA AGCAAGCCCC CAGCCCGAGG TGGGGCGCTG
    CTCTTCTGCA CTGTGGGTAT ACTGCTGAGG AAGCTGCAGA GCAATCCCAG CCTGGAGGGC
    GTGAGCCATG TCATTGTGGA TGAGGTCCAT GAGCGGGATG TGAACACAGA CTTCCTGTTG
    ATCCTGCTCA AGGGCCTGCA GCGGCTCAAC CCAGCTCTAC GGCTAGTGCT CATGAGTGCT
    ACAGGTGATA ATGAGCGCTT CTCCCGCTAC TTTGGTGGCT GTCCTGTCAT CAAGGTGCCT
    GGCTTTATGT ATCCTGTCAA AGAGCACTAC CTGGAGGACA TCCTGGCCAA GCTGGGTAAA
    CACCAGTACC CGCACCGGCA CCGGCACCAT GAGTCTGAAG ATGAATGTGC ACTTGATTTG
    GACCTGGTGA CTGATCTGGT TCTGCACATC GATGCCCGTG GGGAACCAGG TGGGATCCTG
    TGCTTCTTGC CTGGTTGGCA GGAGATCAAA GGAGTGCAAC AACGCCTCCA GGAGGCCCTG
    GGCATGCACG AGAGCAAGTA CCTCATCCTG CCAGTGCACT CCAACATCCC CATGATGGAC
    CAAAAGGCCA TATTCCAGCA GCCTCCACTT GGGGTGCGCA AGATTGTACT GGCCACCAAC
    ATTGCAGAGA CCTCCATCAC AGTTAATGAC ATTGTGCATG TTGTGGACAG CGGCCTGCAC
    AAGGAGGAAC GCTATGACCT CAAGACCAAG GTGTCATGCT TAGAGACTGT GTGGGTGTCA
    AGAGCAAATG TGATCCAGCG CCGGGGCCGA GCAGGCCGCT GCCAGTCAGG TTTTGCCTAC
    CACTTGTTTC CACGGAGTCG ACTGGAGAAA ATGGTCCCTT TCCAAGTGCC AGAGATCCTG
    CGCACGCCTC TGGAGAACCT GGTGCTGCAA GCTAAAATCC ATATGCCTGA GAAGACGGCA
    GTGGAGTTCC TTTCCAAGGC TGTGGACAGT CCCAACATCA AGGCAGTGGA TGAGGCTGTG
    ATACTGCTTC AGGAGATCGG GGTGCTGGAC CAGCGGGAGT ACCTGACCAC CTTGGGGCAG
    CGCCTGGCCC ACATCTCTAC TGACCCCCGG CTGGCCAAGG CCATAGTGCT GGCTGCCATC
    TTCCGTTGCC TACACCCGTT GCTGGTGGTT GTTTCCTGCC TCACCCGGGA CCCTTTCAGC
    AGCAGTTTGC AGAACCGGGC AGAGGTGGAC AAGGTAAAGG CTCTGCTGAG CCATGACAGT
    GGCAGTGACC ACTTGGCCTT TGTGCGGGCC GTCGCTGGTT GGGAGGAGGT GCTGCGTTGG
    CAGGACCGCA CCTCCCGGGA AAACTACCTG GAAGAAAACC TGCTCTATGC CCCCAGCTTG
    CGCTTCATCC ACGGGCTTAT CAAGCAGTTC TCAGAGAATA TTTACGAGGC TTTTCTAGTG
    GGAAAGCCCT CAGACTGCAC ACTGCCTTCT GCCCAGTGCA ACGAGTACAG TGAGGAAGAG
    GAACTGGTGA AGGGTGTGCT GATGGCTGGC CTCTACCCCA ACCTCATCCA GGTGAGGCAG
    GGTAAGGTGA CTCGGCAGGG GAAGTTCAAG CCCAACAGTG TCACTTACAG GACCAAATCT
    GGCAATATCT TGCTGCACAA GTCAACTATT AACAGGGAGG CTACCCGGTT ACGGAGCCGA
    TGGCTGACAT ATTTCATGGC TGTTAAGTCC AATGGCAGCG TCTTTGTGCG AGATTCCTCC
    CAGGTGCACC CGCTAGCTGT GCTGCTCCTA ACTGATGGGG ACGTTCACAT CCGAGATGAT
    GGGCGTCGGG CTACCATCTC ACTGAGTGAC AGTGACCTGC TGCGGCTGGA AGGCGACTCA
    CGAACTGTGC GGCTGCTGAG GGAGCTGCGG CGAGCCCTGG GCCGCATGGT GGAGCGGAGC
    CTTCGCAGCG AACTGGCCGC ACTTCCTCTC AGTGTACAGC AGGAGCACGG GCAGCTGCTC
    GCGCTGCTGG CAGAACTGCT GCGAGGACCT TGTGGCAGCT TTGACGTGCG CAAGACAGCT
    GATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26835
    Clone ID Related Accession (Same CDS sequence) XM_008830772.2 , XM_008830772.1
    Accession Version XM_008830772.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3585bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product ATP-dependent RNA helicase DHX30 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008830772.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTTCAGCC TGGACTCATT CAGAAAAGAT CGGACCCAGC ACAGGCAGCG TCAGTGCAAA 
    CTTCCCCCAC CTCGCCTTCC TCCTATGTGT GTCAACCCTG CCCCTGGAGG GACCATCTCT
    CGAGCTTCTA GGGACCTATT AAAAGAGTTT CCACAGCCCA AAAACCTTCT CAACAGTGTG
    ATTGGAAGAG CCCTTGGCAT CTCACATGCA AAAGACAAGC TAGTCTATGT GCACACTAAT
    GGACCTAAGA AAAAGAAAGT TACCTTGCAC ATAAAGTGGC CCAAGAGCGT GGAGGTGGAA
    GGCTATGGCA GCAAGAAGAT TGATGCTGAG CGGCAGGCTG CAGCAGCAGC TTGCCAGTTG
    TTTAAGGGCT GGGGTCTGTT GGGTCCCCGG AATGAGCTGT TTGATGCAGC CAAATACCGA
    GTGCTAGCTG ATCGGTTCGG CTCTCCAGCT GACAGCTGGT GGCGCCCAGA ACCCACCATG
    CCTCCCACTT CCTGGCGACA GCTGAATCCT GAAAACATTC GGCCAGGAGG TCCTGGGGGC
    CTATCCCGCT CCTTAGGCCG GGAGGAAGAG GAAGATGAGG AAGAAGAGCT AGAAGAGGGG
    ACCATTGATG TTACGGAGTT CCTGTCCATG ACACAGCAAG ACTCCCATAA CCCACTCAGG
    GACTCAAGGG GAGGCTCCTT TGAAATGACA GATGATGACA GTGCTATTAG GGCTCTGACC
    CAGTTTCCAC TTCCCAAGAA TCTTCTGGCC AAGGTGATTC AGATTGCAAC ATCCTCCTCC
    ACAGCTAAGA ACCTTATGCA GTTCCATACC GTGGGTACCA AGACAAAGCT GGCTACACTC
    ACTCTGCTCT GGCCCTGTCC CATGACCTTT GTTGCCAAAG GGCGCCGCAA AGCAGAGGCT
    GAGAATAAGG CAGCAGCCTT GGCCTGCAAG AAACTGAAGA GCCTGGGCCT GGTGGACCGG
    AACAATGAGC CACTTACCCA TGCCATGTAC AACCTGGCCT CCTTGCGTGA GTTGGGTGAG
    ACCCAGCGCC GGCCGTGTAC CATCCAGGTG CCGGAGCCCA TCCTCCGCAA AATAGAGACC
    TTCCTGAATC ATTACCCCGT GGACAGTTCA TGGATTTCCC CAGAGCTCCG GCTGCAGAGT
    GATGACATCT TGCCGTTAGG CAAGGACTCA GGGCCCCTGA GCGACCCTAT TACAGGCAAG
    CCATATGTGC CCCTGTCAGA AGCAGAGGAG GTGCGCCTGA GCCAGAGCCT GCTAGAGCTG
    TGGCGGCGGC GAGGGCCAGT CTGGCAGGAG GCCCCCCAGC TACCTGTGGA TCCACATCGG
    GACACTATCC TCAGTGCCAT TGAGCAGCAC CCAGTAGTGG TCATCTCTGG GGACACAGGT
    TGTGGAAAGA CCACACGCAT CCCTCAGCTG CTGCTGGAGC GCTATGTGAC TGAGGGCCGC
    GGTGCCCGCT GCAATGTGAT CATCACCCAA CCACGCCGCA TCTCAGCTGT GTCTGTGGCA
    CAGCGGGTCA GCCACGAACT GGGCCCCTCC TTGCGCCGGA ATGTGGGCTT CCAAGTGCGC
    TTGGAAAGCA AGCCCCCAGC CCGAGGTGGG GCGCTGCTCT TCTGCACTGT GGGTATACTG
    CTGAGGAAGC TGCAGAGCAA TCCCAGCCTG GAGGGCGTGA GCCATGTCAT TGTGGATGAG
    GTCCATGAGC GGGATGTGAA CACAGACTTC CTGTTGATCC TGCTCAAGGG CCTGCAGCGG
    CTCAACCCAG CTCTACGGCT AGTGCTCATG AGTGCTACAG GTGATAATGA GCGCTTCTCC
    CGCTACTTTG GTGGCTGTCC TGTCATCAAG GTGCCTGGCT TTATGTATCC TGTCAAAGAG
    CACTACCTGG AGGACATCCT GGCCAAGCTG GGTAAACACC AGTACCCGCA CCGGCACCGG
    CACCATGAGT CTGAAGATGA ATGTGCACTT GATTTGGACC TGGTGACTGA TCTGGTTCTG
    CACATCGATG CCCGTGGGGA ACCAGGTGGG ATCCTGTGCT TCTTGCCTGG TTGGCAGGAG
    ATCAAAGGAG TGCAACAACG CCTCCAGGAG GCCCTGGGCA TGCACGAGAG CAAGTACCTC
    ATCCTGCCAG TGCACTCCAA CATCCCCATG ATGGACCAAA AGGCCATATT CCAGCAGCCT
    CCACTTGGGG TGCGCAAGAT TGTACTGGCC ACCAACATTG CAGAGACCTC CATCACAGTT
    AATGACATTG TGCATGTTGT GGACAGCGGC CTGCACAAGG AGGAACGCTA TGACCTCAAG
    ACCAAGGTGT CATGCTTAGA GACTGTGTGG GTGTCAAGAG CAAATGTGAT CCAGCGCCGG
    GGCCGAGCAG GCCGCTGCCA GTCAGGTTTT GCCTACCACT TGTTTCCACG GAGTCGACTG
    GAGAAAATGG TCCCTTTCCA AGTGCCAGAG ATCCTGCGCA CGCCTCTGGA GAACCTGGTG
    CTGCAAGCTA AAATCCATAT GCCTGAGAAG ACGGCAGTGG AGTTCCTTTC CAAGGCTGTG
    GACAGTCCCA ACATCAAGGC AGTGGATGAG GCTGTGATAC TGCTTCAGGA GATCGGGGTG
    CTGGACCAGC GGGAGTACCT GACCACCTTG GGGCAGCGCC TGGCCCACAT CTCTACTGAC
    CCCCGGCTGG CCAAGGCCAT AGTGCTGGCT GCCATCTTCC GTTGCCTACA CCCGTTGCTG
    GTGGTTGTTT CCTGCCTCAC CCGGGACCCT TTCAGCAGCA GTTTGCAGAA CCGGGCAGAG
    GTGGACAAGG TAAAGGCTCT GCTGAGCCAT GACAGTGGCA GTGACCACTT GGCCTTTGTG
    CGGGCCGTCG CTGGTTGGGA GGAGGTGCTG CGTTGGCAGG ACCGCACCTC CCGGGAAAAC
    TACCTGGAAG AAAACCTGCT CTATGCCCCC AGCTTGCGCT TCATCCACGG GCTTATCAAG
    CAGTTCTCAG AGAATATTTA CGAGGCTTTT CTAGTGGGAA AGCCCTCAGA CTGCACACTG
    CCTTCTGCCC AGTGCAACGA GTACAGTGAG GAAGAGGAAC TGGTGAAGGG TGTGCTGATG
    GCTGGCCTCT ACCCCAACCT CATCCAGGTG AGGCAGGGTA AGGTGACTCG GCAGGGGAAG
    TTCAAGCCCA ACAGTGTCAC TTACAGGACC AAATCTGGCA ATATCTTGCT GCACAAGTCA
    ACTATTAACA GGGAGGCTAC CCGGTTACGG AGCCGATGGC TGACATATTT CATGGCTGTT
    AAGTCCAATG GCAGCGTCTT TGTGCGAGAT TCCTCCCAGG TGCACCCGCT AGCTGTGCTG
    CTCCTAACTG ATGGGGACGT TCACATCCGA GATGATGGGC GTCGGGCTAC CATCTCACTG
    AGTGACAGTG ACCTGCTGCG GCTGGAAGGC GACTCACGAA CTGTGCGGCT GCTGAGGGAG
    CTGCGGCGAG CCCTGGGCCG CATGGTGGAG CGGAGCCTTC GCAGCGAACT GGCCGCACTT
    CCTCTCAGTG TACAGCAGGA GCACGGGCAG CTGCTCGCGC TGCTGGCAGA ACTGCTGCGA
    GGACCTTGTG GCAGCTTTGA CGTGCGCAAG ACAGCTGATG ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008828994.1
    CDS234..3818
    Translation

    Target ORF information:

    RefSeq Version XM_008830772.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830772.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTTCAGCC TGGACTCATT CAGAAAAGAT CGGACCCAGC ACAGGCAGCG TCAGTGCAAA 
    CTTCCCCCAC CTCGCCTTCC TCCTATGTGT GTCAACCCTG CCCCTGGAGG GACCATCTCT
    CGAGCTTCTA GGGACCTATT AAAAGAGTTT CCACAGCCCA AAAACCTTCT CAACAGTGTG
    ATTGGAAGAG CCCTTGGCAT CTCACATGCA AAAGACAAGC TAGTCTATGT GCACACTAAT
    GGACCTAAGA AAAAGAAAGT TACCTTGCAC ATAAAGTGGC CCAAGAGCGT GGAGGTGGAA
    GGCTATGGCA GCAAGAAGAT TGATGCTGAG CGGCAGGCTG CAGCAGCAGC TTGCCAGTTG
    TTTAAGGGCT GGGGTCTGTT GGGTCCCCGG AATGAGCTGT TTGATGCAGC CAAATACCGA
    GTGCTAGCTG ATCGGTTCGG CTCTCCAGCT GACAGCTGGT GGCGCCCAGA ACCCACCATG
    CCTCCCACTT CCTGGCGACA GCTGAATCCT GAAAACATTC GGCCAGGAGG TCCTGGGGGC
    CTATCCCGCT CCTTAGGCCG GGAGGAAGAG GAAGATGAGG AAGAAGAGCT AGAAGAGGGG
    ACCATTGATG TTACGGAGTT CCTGTCCATG ACACAGCAAG ACTCCCATAA CCCACTCAGG
    GACTCAAGGG GAGGCTCCTT TGAAATGACA GATGATGACA GTGCTATTAG GGCTCTGACC
    CAGTTTCCAC TTCCCAAGAA TCTTCTGGCC AAGGTGATTC AGATTGCAAC ATCCTCCTCC
    ACAGCTAAGA ACCTTATGCA GTTCCATACC GTGGGTACCA AGACAAAGCT GGCTACACTC
    ACTCTGCTCT GGCCCTGTCC CATGACCTTT GTTGCCAAAG GGCGCCGCAA AGCAGAGGCT
    GAGAATAAGG CAGCAGCCTT GGCCTGCAAG AAACTGAAGA GCCTGGGCCT GGTGGACCGG
    AACAATGAGC CACTTACCCA TGCCATGTAC AACCTGGCCT CCTTGCGTGA GTTGGGTGAG
    ACCCAGCGCC GGCCGTGTAC CATCCAGGTG CCGGAGCCCA TCCTCCGCAA AATAGAGACC
    TTCCTGAATC ATTACCCCGT GGACAGTTCA TGGATTTCCC CAGAGCTCCG GCTGCAGAGT
    GATGACATCT TGCCGTTAGG CAAGGACTCA GGGCCCCTGA GCGACCCTAT TACAGGCAAG
    CCATATGTGC CCCTGTCAGA AGCAGAGGAG GTGCGCCTGA GCCAGAGCCT GCTAGAGCTG
    TGGCGGCGGC GAGGGCCAGT CTGGCAGGAG GCCCCCCAGC TACCTGTGGA TCCACATCGG
    GACACTATCC TCAGTGCCAT TGAGCAGCAC CCAGTAGTGG TCATCTCTGG GGACACAGGT
    TGTGGAAAGA CCACACGCAT CCCTCAGCTG CTGCTGGAGC GCTATGTGAC TGAGGGCCGC
    GGTGCCCGCT GCAATGTGAT CATCACCCAA CCACGCCGCA TCTCAGCTGT GTCTGTGGCA
    CAGCGGGTCA GCCACGAACT GGGCCCCTCC TTGCGCCGGA ATGTGGGCTT CCAAGTGCGC
    TTGGAAAGCA AGCCCCCAGC CCGAGGTGGG GCGCTGCTCT TCTGCACTGT GGGTATACTG
    CTGAGGAAGC TGCAGAGCAA TCCCAGCCTG GAGGGCGTGA GCCATGTCAT TGTGGATGAG
    GTCCATGAGC GGGATGTGAA CACAGACTTC CTGTTGATCC TGCTCAAGGG CCTGCAGCGG
    CTCAACCCAG CTCTACGGCT AGTGCTCATG AGTGCTACAG GTGATAATGA GCGCTTCTCC
    CGCTACTTTG GTGGCTGTCC TGTCATCAAG GTGCCTGGCT TTATGTATCC TGTCAAAGAG
    CACTACCTGG AGGACATCCT GGCCAAGCTG GGTAAACACC AGTACCCGCA CCGGCACCGG
    CACCATGAGT CTGAAGATGA ATGTGCACTT GATTTGGACC TGGTGACTGA TCTGGTTCTG
    CACATCGATG CCCGTGGGGA ACCAGGTGGG ATCCTGTGCT TCTTGCCTGG TTGGCAGGAG
    ATCAAAGGAG TGCAACAACG CCTCCAGGAG GCCCTGGGCA TGCACGAGAG CAAGTACCTC
    ATCCTGCCAG TGCACTCCAA CATCCCCATG ATGGACCAAA AGGCCATATT CCAGCAGCCT
    CCACTTGGGG TGCGCAAGAT TGTACTGGCC ACCAACATTG CAGAGACCTC CATCACAGTT
    AATGACATTG TGCATGTTGT GGACAGCGGC CTGCACAAGG AGGAACGCTA TGACCTCAAG
    ACCAAGGTGT CATGCTTAGA GACTGTGTGG GTGTCAAGAG CAAATGTGAT CCAGCGCCGG
    GGCCGAGCAG GCCGCTGCCA GTCAGGTTTT GCCTACCACT TGTTTCCACG GAGTCGACTG
    GAGAAAATGG TCCCTTTCCA AGTGCCAGAG ATCCTGCGCA CGCCTCTGGA GAACCTGGTG
    CTGCAAGCTA AAATCCATAT GCCTGAGAAG ACGGCAGTGG AGTTCCTTTC CAAGGCTGTG
    GACAGTCCCA ACATCAAGGC AGTGGATGAG GCTGTGATAC TGCTTCAGGA GATCGGGGTG
    CTGGACCAGC GGGAGTACCT GACCACCTTG GGGCAGCGCC TGGCCCACAT CTCTACTGAC
    CCCCGGCTGG CCAAGGCCAT AGTGCTGGCT GCCATCTTCC GTTGCCTACA CCCGTTGCTG
    GTGGTTGTTT CCTGCCTCAC CCGGGACCCT TTCAGCAGCA GTTTGCAGAA CCGGGCAGAG
    GTGGACAAGG TAAAGGCTCT GCTGAGCCAT GACAGTGGCA GTGACCACTT GGCCTTTGTG
    CGGGCCGTCG CTGGTTGGGA GGAGGTGCTG CGTTGGCAGG ACCGCACCTC CCGGGAAAAC
    TACCTGGAAG AAAACCTGCT CTATGCCCCC AGCTTGCGCT TCATCCACGG GCTTATCAAG
    CAGTTCTCAG AGAATATTTA CGAGGCTTTT CTAGTGGGAA AGCCCTCAGA CTGCACACTG
    CCTTCTGCCC AGTGCAACGA GTACAGTGAG GAAGAGGAAC TGGTGAAGGG TGTGCTGATG
    GCTGGCCTCT ACCCCAACCT CATCCAGGTG AGGCAGGGTA AGGTGACTCG GCAGGGGAAG
    TTCAAGCCCA ACAGTGTCAC TTACAGGACC AAATCTGGCA ATATCTTGCT GCACAAGTCA
    ACTATTAACA GGGAGGCTAC CCGGTTACGG AGCCGATGGC TGACATATTT CATGGCTGTT
    AAGTCCAATG GCAGCGTCTT TGTGCGAGAT TCCTCCCAGG TGCACCCGCT AGCTGTGCTG
    CTCCTAACTG ATGGGGACGT TCACATCCGA GATGATGGGC GTCGGGCTAC CATCTCACTG
    AGTGACAGTG ACCTGCTGCG GCTGGAAGGC GACTCACGAA CTGTGCGGCT GCTGAGGGAG
    CTGCGGCGAG CCCTGGGCCG CATGGTGGAG CGGAGCCTTC GCAGCGAACT GGCCGCACTT
    CCTCTCAGTG TACAGCAGGA GCACGGGCAG CTGCTCGCGC TGCTGGCAGA ACTGCTGCGA
    GGACCTTGTG GCAGCTTTGA CGTGCGCAAG ACAGCTGATG ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26835
    Clone ID Related Accession (Same CDS sequence) XM_008830772.2 , XM_008830772.1
    Accession Version XM_008830772.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3585bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product putative ATP-dependent RNA helicase DHX30 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTTCAGCC TGGACTCATT CAGAAAAGAT CGGACCCAGC ACAGGCAGCG TCAGTGCAAA 
    CTTCCCCCAC CTCGCCTTCC TCCTATGTGT GTCAACCCTG CCCCTGGAGG GACCATCTCT
    CGAGCTTCTA GGGACCTATT AAAAGAGTTT CCACAGCCCA AAAACCTTCT CAACAGTGTG
    ATTGGAAGAG CCCTTGGCAT CTCACATGCA AAAGACAAGC TAGTCTATGT GCACACTAAT
    GGACCTAAGA AAAAGAAAGT TACCTTGCAC ATAAAGTGGC CCAAGAGCGT GGAGGTGGAA
    GGCTATGGCA GCAAGAAGAT TGATGCTGAG CGGCAGGCTG CAGCAGCAGC TTGCCAGTTG
    TTTAAGGGCT GGGGTCTGTT GGGTCCCCGG AATGAGCTGT TTGATGCAGC CAAATACCGA
    GTGCTAGCTG ATCGGTTCGG CTCTCCAGCT GACAGCTGGT GGCGCCCAGA ACCCACCATG
    CCTCCCACTT CCTGGCGACA GCTGAATCCT GAAAACATTC GGCCAGGAGG TCCTGGGGGC
    CTATCCCGCT CCTTAGGCCG GGAGGAAGAG GAAGATGAGG AAGAAGAGCT AGAAGAGGGG
    ACCATTGATG TTACGGAGTT CCTGTCCATG ACACAGCAAG ACTCCCATAA CCCACTCAGG
    GACTCAAGGG GAGGCTCCTT TGAAATGACA GATGATGACA GTGCTATTAG GGCTCTGACC
    CAGTTTCCAC TTCCCAAGAA TCTTCTGGCC AAGGTGATTC AGATTGCAAC ATCCTCCTCC
    ACAGCTAAGA ACCTTATGCA GTTCCATACC GTGGGTACCA AGACAAAGCT GGCTACACTC
    ACTCTGCTCT GGCCCTGTCC CATGACCTTT GTTGCCAAAG GGCGCCGCAA AGCAGAGGCT
    GAGAATAAGG CAGCAGCCTT GGCCTGCAAG AAACTGAAGA GCCTGGGCCT GGTGGACCGG
    AACAATGAGC CACTTACCCA TGCCATGTAC AACCTGGCCT CCTTGCGTGA GTTGGGTGAG
    ACCCAGCGCC GGCCGTGTAC CATCCAGGTG CCGGAGCCCA TCCTCCGCAA AATAGAGACC
    TTCCTGAATC ATTACCCCGT GGACAGTTCA TGGATTTCCC CAGAGCTCCG GCTGCAGAGT
    GATGACATCT TGCCGTTAGG CAAGGACTCA GGGCCCCTGA GCGACCCTAT TACAGGCAAG
    CCATATGTGC CCCTGTCAGA AGCAGAGGAG GTGCGCCTGA GCCAGAGCCT GCTAGAGCTG
    TGGCGGCGGC GAGGGCCAGT CTGGCAGGAG GCCCCCCAGC TACCTGTGGA TCCACATCGG
    GACACTATCC TCAGTGCCAT TGAGCAGCAC CCAGTAGTGG TCATCTCTGG GGACACAGGT
    TGTGGAAAGA CCACACGCAT CCCTCAGCTG CTGCTGGAGC GCTATGTGAC TGAGGGCCGC
    GGTGCCCGCT GCAATGTGAT CATCACCCAA CCACGCCGCA TCTCAGCTGT GTCTGTGGCA
    CAGCGGGTCA GCCACGAACT GGGCCCCTCC TTGCGCCGGA ATGTGGGCTT CCAAGTGCGC
    TTGGAAAGCA AGCCCCCAGC CCGAGGTGGG GCGCTGCTCT TCTGCACTGT GGGTATACTG
    CTGAGGAAGC TGCAGAGCAA TCCCAGCCTG GAGGGCGTGA GCCATGTCAT TGTGGATGAG
    GTCCATGAGC GGGATGTGAA CACAGACTTC CTGTTGATCC TGCTCAAGGG CCTGCAGCGG
    CTCAACCCAG CTCTACGGCT AGTGCTCATG AGTGCTACAG GTGATAATGA GCGCTTCTCC
    CGCTACTTTG GTGGCTGTCC TGTCATCAAG GTGCCTGGCT TTATGTATCC TGTCAAAGAG
    CACTACCTGG AGGACATCCT GGCCAAGCTG GGTAAACACC AGTACCCGCA CCGGCACCGG
    CACCATGAGT CTGAAGATGA ATGTGCACTT GATTTGGACC TGGTGACTGA TCTGGTTCTG
    CACATCGATG CCCGTGGGGA ACCAGGTGGG ATCCTGTGCT TCTTGCCTGG TTGGCAGGAG
    ATCAAAGGAG TGCAACAACG CCTCCAGGAG GCCCTGGGCA TGCACGAGAG CAAGTACCTC
    ATCCTGCCAG TGCACTCCAA CATCCCCATG ATGGACCAAA AGGCCATATT CCAGCAGCCT
    CCACTTGGGG TGCGCAAGAT TGTACTGGCC ACCAACATTG CAGAGACCTC CATCACAGTT
    AATGACATTG TGCATGTTGT GGACAGCGGC CTGCACAAGG AGGAACGCTA TGACCTCAAG
    ACCAAGGTGT CATGCTTAGA GACTGTGTGG GTGTCAAGAG CAAATGTGAT CCAGCGCCGG
    GGCCGAGCAG GCCGCTGCCA GTCAGGTTTT GCCTACCACT TGTTTCCACG GAGTCGACTG
    GAGAAAATGG TCCCTTTCCA AGTGCCAGAG ATCCTGCGCA CGCCTCTGGA GAACCTGGTG
    CTGCAAGCTA AAATCCATAT GCCTGAGAAG ACGGCAGTGG AGTTCCTTTC CAAGGCTGTG
    GACAGTCCCA ACATCAAGGC AGTGGATGAG GCTGTGATAC TGCTTCAGGA GATCGGGGTG
    CTGGACCAGC GGGAGTACCT GACCACCTTG GGGCAGCGCC TGGCCCACAT CTCTACTGAC
    CCCCGGCTGG CCAAGGCCAT AGTGCTGGCT GCCATCTTCC GTTGCCTACA CCCGTTGCTG
    GTGGTTGTTT CCTGCCTCAC CCGGGACCCT TTCAGCAGCA GTTTGCAGAA CCGGGCAGAG
    GTGGACAAGG TAAAGGCTCT GCTGAGCCAT GACAGTGGCA GTGACCACTT GGCCTTTGTG
    CGGGCCGTCG CTGGTTGGGA GGAGGTGCTG CGTTGGCAGG ACCGCACCTC CCGGGAAAAC
    TACCTGGAAG AAAACCTGCT CTATGCCCCC AGCTTGCGCT TCATCCACGG GCTTATCAAG
    CAGTTCTCAG AGAATATTTA CGAGGCTTTT CTAGTGGGAA AGCCCTCAGA CTGCACACTG
    CCTTCTGCCC AGTGCAACGA GTACAGTGAG GAAGAGGAAC TGGTGAAGGG TGTGCTGATG
    GCTGGCCTCT ACCCCAACCT CATCCAGGTG AGGCAGGGTA AGGTGACTCG GCAGGGGAAG
    TTCAAGCCCA ACAGTGTCAC TTACAGGACC AAATCTGGCA ATATCTTGCT GCACAAGTCA
    ACTATTAACA GGGAGGCTAC CCGGTTACGG AGCCGATGGC TGACATATTT CATGGCTGTT
    AAGTCCAATG GCAGCGTCTT TGTGCGAGAT TCCTCCCAGG TGCACCCGCT AGCTGTGCTG
    CTCCTAACTG ATGGGGACGT TCACATCCGA GATGATGGGC GTCGGGCTAC CATCTCACTG
    AGTGACAGTG ACCTGCTGCG GCTGGAAGGC GACTCACGAA CTGTGCGGCT GCTGAGGGAG
    CTGCGGCGAG CCCTGGGCCG CATGGTGGAG CGGAGCCTTC GCAGCGAACT GGCCGCACTT
    CCTCTCAGTG TACAGCAGGA GCACGGGCAG CTGCTCGCGC TGCTGGCAGA ACTGCTGCGA
    GGACCTTGTG GCAGCTTTGA CGTGCGCAAG ACAGCTGATG ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008828994.1
    CDS197..3781
    Translation

    Target ORF information:

    RefSeq Version XM_008830772.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830772.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTTCAGCC TGGACTCATT CAGAAAAGAT CGGACCCAGC ACAGGCAGCG TCAGTGCAAA 
    CTTCCCCCAC CTCGCCTTCC TCCTATGTGT GTCAACCCTG CCCCTGGAGG GACCATCTCT
    CGAGCTTCTA GGGACCTATT AAAAGAGTTT CCACAGCCCA AAAACCTTCT CAACAGTGTG
    ATTGGAAGAG CCCTTGGCAT CTCACATGCA AAAGACAAGC TAGTCTATGT GCACACTAAT
    GGACCTAAGA AAAAGAAAGT TACCTTGCAC ATAAAGTGGC CCAAGAGCGT GGAGGTGGAA
    GGCTATGGCA GCAAGAAGAT TGATGCTGAG CGGCAGGCTG CAGCAGCAGC TTGCCAGTTG
    TTTAAGGGCT GGGGTCTGTT GGGTCCCCGG AATGAGCTGT TTGATGCAGC CAAATACCGA
    GTGCTAGCTG ATCGGTTCGG CTCTCCAGCT GACAGCTGGT GGCGCCCAGA ACCCACCATG
    CCTCCCACTT CCTGGCGACA GCTGAATCCT GAAAACATTC GGCCAGGAGG TCCTGGGGGC
    CTATCCCGCT CCTTAGGCCG GGAGGAAGAG GAAGATGAGG AAGAAGAGCT AGAAGAGGGG
    ACCATTGATG TTACGGAGTT CCTGTCCATG ACACAGCAAG ACTCCCATAA CCCACTCAGG
    GACTCAAGGG GAGGCTCCTT TGAAATGACA GATGATGACA GTGCTATTAG GGCTCTGACC
    CAGTTTCCAC TTCCCAAGAA TCTTCTGGCC AAGGTGATTC AGATTGCAAC ATCCTCCTCC
    ACAGCTAAGA ACCTTATGCA GTTCCATACC GTGGGTACCA AGACAAAGCT GGCTACACTC
    ACTCTGCTCT GGCCCTGTCC CATGACCTTT GTTGCCAAAG GGCGCCGCAA AGCAGAGGCT
    GAGAATAAGG CAGCAGCCTT GGCCTGCAAG AAACTGAAGA GCCTGGGCCT GGTGGACCGG
    AACAATGAGC CACTTACCCA TGCCATGTAC AACCTGGCCT CCTTGCGTGA GTTGGGTGAG
    ACCCAGCGCC GGCCGTGTAC CATCCAGGTG CCGGAGCCCA TCCTCCGCAA AATAGAGACC
    TTCCTGAATC ATTACCCCGT GGACAGTTCA TGGATTTCCC CAGAGCTCCG GCTGCAGAGT
    GATGACATCT TGCCGTTAGG CAAGGACTCA GGGCCCCTGA GCGACCCTAT TACAGGCAAG
    CCATATGTGC CCCTGTCAGA AGCAGAGGAG GTGCGCCTGA GCCAGAGCCT GCTAGAGCTG
    TGGCGGCGGC GAGGGCCAGT CTGGCAGGAG GCCCCCCAGC TACCTGTGGA TCCACATCGG
    GACACTATCC TCAGTGCCAT TGAGCAGCAC CCAGTAGTGG TCATCTCTGG GGACACAGGT
    TGTGGAAAGA CCACACGCAT CCCTCAGCTG CTGCTGGAGC GCTATGTGAC TGAGGGCCGC
    GGTGCCCGCT GCAATGTGAT CATCACCCAA CCACGCCGCA TCTCAGCTGT GTCTGTGGCA
    CAGCGGGTCA GCCACGAACT GGGCCCCTCC TTGCGCCGGA ATGTGGGCTT CCAAGTGCGC
    TTGGAAAGCA AGCCCCCAGC CCGAGGTGGG GCGCTGCTCT TCTGCACTGT GGGTATACTG
    CTGAGGAAGC TGCAGAGCAA TCCCAGCCTG GAGGGCGTGA GCCATGTCAT TGTGGATGAG
    GTCCATGAGC GGGATGTGAA CACAGACTTC CTGTTGATCC TGCTCAAGGG CCTGCAGCGG
    CTCAACCCAG CTCTACGGCT AGTGCTCATG AGTGCTACAG GTGATAATGA GCGCTTCTCC
    CGCTACTTTG GTGGCTGTCC TGTCATCAAG GTGCCTGGCT TTATGTATCC TGTCAAAGAG
    CACTACCTGG AGGACATCCT GGCCAAGCTG GGTAAACACC AGTACCCGCA CCGGCACCGG
    CACCATGAGT CTGAAGATGA ATGTGCACTT GATTTGGACC TGGTGACTGA TCTGGTTCTG
    CACATCGATG CCCGTGGGGA ACCAGGTGGG ATCCTGTGCT TCTTGCCTGG TTGGCAGGAG
    ATCAAAGGAG TGCAACAACG CCTCCAGGAG GCCCTGGGCA TGCACGAGAG CAAGTACCTC
    ATCCTGCCAG TGCACTCCAA CATCCCCATG ATGGACCAAA AGGCCATATT CCAGCAGCCT
    CCACTTGGGG TGCGCAAGAT TGTACTGGCC ACCAACATTG CAGAGACCTC CATCACAGTT
    AATGACATTG TGCATGTTGT GGACAGCGGC CTGCACAAGG AGGAACGCTA TGACCTCAAG
    ACCAAGGTGT CATGCTTAGA GACTGTGTGG GTGTCAAGAG CAAATGTGAT CCAGCGCCGG
    GGCCGAGCAG GCCGCTGCCA GTCAGGTTTT GCCTACCACT TGTTTCCACG GAGTCGACTG
    GAGAAAATGG TCCCTTTCCA AGTGCCAGAG ATCCTGCGCA CGCCTCTGGA GAACCTGGTG
    CTGCAAGCTA AAATCCATAT GCCTGAGAAG ACGGCAGTGG AGTTCCTTTC CAAGGCTGTG
    GACAGTCCCA ACATCAAGGC AGTGGATGAG GCTGTGATAC TGCTTCAGGA GATCGGGGTG
    CTGGACCAGC GGGAGTACCT GACCACCTTG GGGCAGCGCC TGGCCCACAT CTCTACTGAC
    CCCCGGCTGG CCAAGGCCAT AGTGCTGGCT GCCATCTTCC GTTGCCTACA CCCGTTGCTG
    GTGGTTGTTT CCTGCCTCAC CCGGGACCCT TTCAGCAGCA GTTTGCAGAA CCGGGCAGAG
    GTGGACAAGG TAAAGGCTCT GCTGAGCCAT GACAGTGGCA GTGACCACTT GGCCTTTGTG
    CGGGCCGTCG CTGGTTGGGA GGAGGTGCTG CGTTGGCAGG ACCGCACCTC CCGGGAAAAC
    TACCTGGAAG AAAACCTGCT CTATGCCCCC AGCTTGCGCT TCATCCACGG GCTTATCAAG
    CAGTTCTCAG AGAATATTTA CGAGGCTTTT CTAGTGGGAA AGCCCTCAGA CTGCACACTG
    CCTTCTGCCC AGTGCAACGA GTACAGTGAG GAAGAGGAAC TGGTGAAGGG TGTGCTGATG
    GCTGGCCTCT ACCCCAACCT CATCCAGGTG AGGCAGGGTA AGGTGACTCG GCAGGGGAAG
    TTCAAGCCCA ACAGTGTCAC TTACAGGACC AAATCTGGCA ATATCTTGCT GCACAAGTCA
    ACTATTAACA GGGAGGCTAC CCGGTTACGG AGCCGATGGC TGACATATTT CATGGCTGTT
    AAGTCCAATG GCAGCGTCTT TGTGCGAGAT TCCTCCCAGG TGCACCCGCT AGCTGTGCTG
    CTCCTAACTG ATGGGGACGT TCACATCCGA GATGATGGGC GTCGGGCTAC CATCTCACTG
    AGTGACAGTG ACCTGCTGCG GCTGGAAGGC GACTCACGAA CTGTGCGGCT GCTGAGGGAG
    CTGCGGCGAG CCCTGGGCCG CATGGTGGAG CGGAGCCTTC GCAGCGAACT GGCCGCACTT
    CCTCTCAGTG TACAGCAGGA GCACGGGCAG CTGCTCGCGC TGCTGGCAGA ACTGCTGCGA
    GGACCTTGTG GCAGCTTTGA CGTGCGCAAG ACAGCTGATG ACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26836
    Clone ID Related Accession (Same CDS sequence) XM_008830779.2 , XM_008830779.1
    Accession Version XM_008830779.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3468bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product ATP-dependent RNA helicase DHX30 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008830779.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGGCAGCTT CTAGGGACCT ATTAAAAGAG TTTCCACAGC CCAAAAACCT TCTCAACAGT 
    GTGATTGGAA GAGCCCTTGG CATCTCACAT GCAAAAGACA AGCTAGTCTA TGTGCACACT
    AATGGACCTA AGAAAAAGAA AGTTACCTTG CACATAAAGT GGCCCAAGAG CGTGGAGGTG
    GAAGGCTATG GCAGCAAGAA GATTGATGCT GAGCGGCAGG CTGCAGCAGC AGCTTGCCAG
    TTGTTTAAGG GCTGGGGTCT GTTGGGTCCC CGGAATGAGC TGTTTGATGC AGCCAAATAC
    CGAGTGCTAG CTGATCGGTT CGGCTCTCCA GCTGACAGCT GGTGGCGCCC AGAACCCACC
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008829001.1
    CDS154..3621
    Translation

    Target ORF information:

    RefSeq Version XM_008830779.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830779.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGGCAGCTT CTAGGGACCT ATTAAAAGAG TTTCCACAGC CCAAAAACCT TCTCAACAGT 
    GTGATTGGAA GAGCCCTTGG CATCTCACAT GCAAAAGACA AGCTAGTCTA TGTGCACACT
    AATGGACCTA AGAAAAAGAA AGTTACCTTG CACATAAAGT GGCCCAAGAG CGTGGAGGTG
    GAAGGCTATG GCAGCAAGAA GATTGATGCT GAGCGGCAGG CTGCAGCAGC AGCTTGCCAG
    TTGTTTAAGG GCTGGGGTCT GTTGGGTCCC CGGAATGAGC TGTTTGATGC AGCCAAATAC
    CGAGTGCTAG CTGATCGGTT CGGCTCTCCA GCTGACAGCT GGTGGCGCCC AGAACCCACC
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26836
    Clone ID Related Accession (Same CDS sequence) XM_008830779.2 , XM_008830779.1
    Accession Version XM_008830779.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3468bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product putative ATP-dependent RNA helicase DHX30 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGGCAGCTT CTAGGGACCT ATTAAAAGAG TTTCCACAGC CCAAAAACCT TCTCAACAGT 
    GTGATTGGAA GAGCCCTTGG CATCTCACAT GCAAAAGACA AGCTAGTCTA TGTGCACACT
    AATGGACCTA AGAAAAAGAA AGTTACCTTG CACATAAAGT GGCCCAAGAG CGTGGAGGTG
    GAAGGCTATG GCAGCAAGAA GATTGATGCT GAGCGGCAGG CTGCAGCAGC AGCTTGCCAG
    TTGTTTAAGG GCTGGGGTCT GTTGGGTCCC CGGAATGAGC TGTTTGATGC AGCCAAATAC
    CGAGTGCTAG CTGATCGGTT CGGCTCTCCA GCTGACAGCT GGTGGCGCCC AGAACCCACC
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008829001.1
    CDS92..3559
    Translation

    Target ORF information:

    RefSeq Version XM_008830779.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830779.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGGCAGCTT CTAGGGACCT ATTAAAAGAG TTTCCACAGC CCAAAAACCT TCTCAACAGT 
    GTGATTGGAA GAGCCCTTGG CATCTCACAT GCAAAAGACA AGCTAGTCTA TGTGCACACT
    AATGGACCTA AGAAAAAGAA AGTTACCTTG CACATAAAGT GGCCCAAGAG CGTGGAGGTG
    GAAGGCTATG GCAGCAAGAA GATTGATGCT GAGCGGCAGG CTGCAGCAGC AGCTTGCCAG
    TTGTTTAAGG GCTGGGGTCT GTTGGGTCCC CGGAATGAGC TGTTTGATGC AGCCAAATAC
    CGAGTGCTAG CTGATCGGTT CGGCTCTCCA GCTGACAGCT GGTGGCGCCC AGAACCCACC
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26837
    Clone ID Related Accession (Same CDS sequence) XM_008830784.2
    Accession Version XM_008830784.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3333bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product putative ATP-dependent RNA helicase DHX30 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008830784.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGAAAGTTA CCTTGCACAT AAAGTGGCCC AAGAGCGTGG AGGTGGAAGG CTATGGCAGC 
    AAGAAGATTG ATGCTGAGCG GCAGGCTGCA GCAGCAGCTT GCCAGTTGTT TAAGGGCTGG
    GGTCTGTTGG GTCCCCGGAA TGAGCTGTTT GATGCAGCCA AATACCGAGT GCTAGCTGAT
    CGGTTCGGCT CTCCAGCTGA CAGCTGGTGG CGCCCAGAAC CCACCATGCC TCCCACTTCC
    TGGCGACAGC TGAATCCTGA AAACATTCGG CCAGGAGGTC CTGGGGGCCT ATCCCGCTCC
    TTAGGCCGGG AGGAAGAGGA AGATGAGGAA GAAGAGCTAG AAGAGGGGAC CATTGATGTT
    ACGGAGTTCC TGTCCATGAC ACAGCAAGAC TCCCATAACC CACTCAGGGA CTCAAGGGGA
    GGCTCCTTTG AAATGACAGA TGATGACAGT GCTATTAGGG CTCTGACCCA GTTTCCACTT
    CCCAAGAATC TTCTGGCCAA GGTGATTCAG ATTGCAACAT CCTCCTCCAC AGCTAAGAAC
    CTTATGCAGT TCCATACCGT GGGTACCAAG ACAAAGCTGG CTACACTCAC TCTGCTCTGG
    CCCTGTCCCA TGACCTTTGT TGCCAAAGGG CGCCGCAAAG CAGAGGCTGA GAATAAGGCA
    GCAGCCTTGG CCTGCAAGAA ACTGAAGAGC CTGGGCCTGG TGGACCGGAA CAATGAGCCA
    CTTACCCATG CCATGTACAA CCTGGCCTCC TTGCGTGAGT TGGGTGAGAC CCAGCGCCGG
    CCGTGTACCA TCCAGGTGCC GGAGCCCATC CTCCGCAAAA TAGAGACCTT CCTGAATCAT
    TACCCCGTGG ACAGTTCATG GATTTCCCCA GAGCTCCGGC TGCAGAGTGA TGACATCTTG
    CCGTTAGGCA AGGACTCAGG GCCCCTGAGC GACCCTATTA CAGGCAAGCC ATATGTGCCC
    CTGTCAGAAG CAGAGGAGGT GCGCCTGAGC CAGAGCCTGC TAGAGCTGTG GCGGCGGCGA
    GGGCCAGTCT GGCAGGAGGC CCCCCAGCTA CCTGTGGATC CACATCGGGA CACTATCCTC
    AGTGCCATTG AGCAGCACCC AGTAGTGGTC ATCTCTGGGG ACACAGGTTG TGGAAAGACC
    ACACGCATCC CTCAGCTGCT GCTGGAGCGC TATGTGACTG AGGGCCGCGG TGCCCGCTGC
    AATGTGATCA TCACCCAACC ACGCCGCATC TCAGCTGTGT CTGTGGCACA GCGGGTCAGC
    CACGAACTGG GCCCCTCCTT GCGCCGGAAT GTGGGCTTCC AAGTGCGCTT GGAAAGCAAG
    CCCCCAGCCC GAGGTGGGGC GCTGCTCTTC TGCACTGTGG GTATACTGCT GAGGAAGCTG
    CAGAGCAATC CCAGCCTGGA GGGCGTGAGC CATGTCATTG TGGATGAGGT CCATGAGCGG
    GATGTGAACA CAGACTTCCT GTTGATCCTG CTCAAGGGCC TGCAGCGGCT CAACCCAGCT
    CTACGGCTAG TGCTCATGAG TGCTACAGGT GATAATGAGC GCTTCTCCCG CTACTTTGGT
    GGCTGTCCTG TCATCAAGGT GCCTGGCTTT ATGTATCCTG TCAAAGAGCA CTACCTGGAG
    GACATCCTGG CCAAGCTGGG TAAACACCAG TACCCGCACC GGCACCGGCA CCATGAGTCT
    GAAGATGAAT GTGCACTTGA TTTGGACCTG GTGACTGATC TGGTTCTGCA CATCGATGCC
    CGTGGGGAAC CAGGTGGGAT CCTGTGCTTC TTGCCTGGTT GGCAGGAGAT CAAAGGAGTG
    CAACAACGCC TCCAGGAGGC CCTGGGCATG CACGAGAGCA AGTACCTCAT CCTGCCAGTG
    CACTCCAACA TCCCCATGAT GGACCAAAAG GCCATATTCC AGCAGCCTCC ACTTGGGGTG
    CGCAAGATTG TACTGGCCAC CAACATTGCA GAGACCTCCA TCACAGTTAA TGACATTGTG
    CATGTTGTGG ACAGCGGCCT GCACAAGGAG GAACGCTATG ACCTCAAGAC CAAGGTGTCA
    TGCTTAGAGA CTGTGTGGGT GTCAAGAGCA AATGTGATCC AGCGCCGGGG CCGAGCAGGC
    CGCTGCCAGT CAGGTTTTGC CTACCACTTG TTTCCACGGA GTCGACTGGA GAAAATGGTC
    CCTTTCCAAG TGCCAGAGAT CCTGCGCACG CCTCTGGAGA ACCTGGTGCT GCAAGCTAAA
    ATCCATATGC CTGAGAAGAC GGCAGTGGAG TTCCTTTCCA AGGCTGTGGA CAGTCCCAAC
    ATCAAGGCAG TGGATGAGGC TGTGATACTG CTTCAGGAGA TCGGGGTGCT GGACCAGCGG
    GAGTACCTGA CCACCTTGGG GCAGCGCCTG GCCCACATCT CTACTGACCC CCGGCTGGCC
    AAGGCCATAG TGCTGGCTGC CATCTTCCGT TGCCTACACC CGTTGCTGGT GGTTGTTTCC
    TGCCTCACCC GGGACCCTTT CAGCAGCAGT TTGCAGAACC GGGCAGAGGT GGACAAGGTA
    AAGGCTCTGC TGAGCCATGA CAGTGGCAGT GACCACTTGG CCTTTGTGCG GGCCGTCGCT
    GGTTGGGAGG AGGTGCTGCG TTGGCAGGAC CGCACCTCCC GGGAAAACTA CCTGGAAGAA
    AACCTGCTCT ATGCCCCCAG CTTGCGCTTC ATCCACGGGC TTATCAAGCA GTTCTCAGAG
    AATATTTACG AGGCTTTTCT AGTGGGAAAG CCCTCAGACT GCACACTGCC TTCTGCCCAG
    TGCAACGAGT ACAGTGAGGA AGAGGAACTG GTGAAGGGTG TGCTGATGGC TGGCCTCTAC
    CCCAACCTCA TCCAGGTGAG GCAGGGTAAG GTGACTCGGC AGGGGAAGTT CAAGCCCAAC
    AGTGTCACTT ACAGGACCAA ATCTGGCAAT ATCTTGCTGC ACAAGTCAAC TATTAACAGG
    GAGGCTACCC GGTTACGGAG CCGATGGCTG ACATATTTCA TGGCTGTTAA GTCCAATGGC
    AGCGTCTTTG TGCGAGATTC CTCCCAGGTG CACCCGCTAG CTGTGCTGCT CCTAACTGAT
    GGGGACGTTC ACATCCGAGA TGATGGGCGT CGGGCTACCA TCTCACTGAG TGACAGTGAC
    CTGCTGCGGC TGGAAGGCGA CTCACGAACT GTGCGGCTGC TGAGGGAGCT GCGGCGAGCC
    CTGGGCCGCA TGGTGGAGCG GAGCCTTCGC AGCGAACTGG CCGCACTTCC TCTCAGTGTA
    CAGCAGGAGC ACGGGCAGCT GCTCGCGCTG CTGGCAGAAC TGCTGCGAGG ACCTTGTGGC
    AGCTTTGACG TGCGCAAGAC AGCTGATGAC TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008829006.1
    CDS16..3348
    Translation

    Target ORF information:

    RefSeq Version XM_008830784.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830784.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGAAAGTTA CCTTGCACAT AAAGTGGCCC AAGAGCGTGG AGGTGGAAGG CTATGGCAGC 
    AAGAAGATTG ATGCTGAGCG GCAGGCTGCA GCAGCAGCTT GCCAGTTGTT TAAGGGCTGG
    GGTCTGTTGG GTCCCCGGAA TGAGCTGTTT GATGCAGCCA AATACCGAGT GCTAGCTGAT
    CGGTTCGGCT CTCCAGCTGA CAGCTGGTGG CGCCCAGAAC CCACCATGCC TCCCACTTCC
    TGGCGACAGC TGAATCCTGA AAACATTCGG CCAGGAGGTC CTGGGGGCCT ATCCCGCTCC
    TTAGGCCGGG AGGAAGAGGA AGATGAGGAA GAAGAGCTAG AAGAGGGGAC CATTGATGTT
    ACGGAGTTCC TGTCCATGAC ACAGCAAGAC TCCCATAACC CACTCAGGGA CTCAAGGGGA
    GGCTCCTTTG AAATGACAGA TGATGACAGT GCTATTAGGG CTCTGACCCA GTTTCCACTT
    CCCAAGAATC TTCTGGCCAA GGTGATTCAG ATTGCAACAT CCTCCTCCAC AGCTAAGAAC
    CTTATGCAGT TCCATACCGT GGGTACCAAG ACAAAGCTGG CTACACTCAC TCTGCTCTGG
    CCCTGTCCCA TGACCTTTGT TGCCAAAGGG CGCCGCAAAG CAGAGGCTGA GAATAAGGCA
    GCAGCCTTGG CCTGCAAGAA ACTGAAGAGC CTGGGCCTGG TGGACCGGAA CAATGAGCCA
    CTTACCCATG CCATGTACAA CCTGGCCTCC TTGCGTGAGT TGGGTGAGAC CCAGCGCCGG
    CCGTGTACCA TCCAGGTGCC GGAGCCCATC CTCCGCAAAA TAGAGACCTT CCTGAATCAT
    TACCCCGTGG ACAGTTCATG GATTTCCCCA GAGCTCCGGC TGCAGAGTGA TGACATCTTG
    CCGTTAGGCA AGGACTCAGG GCCCCTGAGC GACCCTATTA CAGGCAAGCC ATATGTGCCC
    CTGTCAGAAG CAGAGGAGGT GCGCCTGAGC CAGAGCCTGC TAGAGCTGTG GCGGCGGCGA
    GGGCCAGTCT GGCAGGAGGC CCCCCAGCTA CCTGTGGATC CACATCGGGA CACTATCCTC
    AGTGCCATTG AGCAGCACCC AGTAGTGGTC ATCTCTGGGG ACACAGGTTG TGGAAAGACC
    ACACGCATCC CTCAGCTGCT GCTGGAGCGC TATGTGACTG AGGGCCGCGG TGCCCGCTGC
    AATGTGATCA TCACCCAACC ACGCCGCATC TCAGCTGTGT CTGTGGCACA GCGGGTCAGC
    CACGAACTGG GCCCCTCCTT GCGCCGGAAT GTGGGCTTCC AAGTGCGCTT GGAAAGCAAG
    CCCCCAGCCC GAGGTGGGGC GCTGCTCTTC TGCACTGTGG GTATACTGCT GAGGAAGCTG
    CAGAGCAATC CCAGCCTGGA GGGCGTGAGC CATGTCATTG TGGATGAGGT CCATGAGCGG
    GATGTGAACA CAGACTTCCT GTTGATCCTG CTCAAGGGCC TGCAGCGGCT CAACCCAGCT
    CTACGGCTAG TGCTCATGAG TGCTACAGGT GATAATGAGC GCTTCTCCCG CTACTTTGGT
    GGCTGTCCTG TCATCAAGGT GCCTGGCTTT ATGTATCCTG TCAAAGAGCA CTACCTGGAG
    GACATCCTGG CCAAGCTGGG TAAACACCAG TACCCGCACC GGCACCGGCA CCATGAGTCT
    GAAGATGAAT GTGCACTTGA TTTGGACCTG GTGACTGATC TGGTTCTGCA CATCGATGCC
    CGTGGGGAAC CAGGTGGGAT CCTGTGCTTC TTGCCTGGTT GGCAGGAGAT CAAAGGAGTG
    CAACAACGCC TCCAGGAGGC CCTGGGCATG CACGAGAGCA AGTACCTCAT CCTGCCAGTG
    CACTCCAACA TCCCCATGAT GGACCAAAAG GCCATATTCC AGCAGCCTCC ACTTGGGGTG
    CGCAAGATTG TACTGGCCAC CAACATTGCA GAGACCTCCA TCACAGTTAA TGACATTGTG
    CATGTTGTGG ACAGCGGCCT GCACAAGGAG GAACGCTATG ACCTCAAGAC CAAGGTGTCA
    TGCTTAGAGA CTGTGTGGGT GTCAAGAGCA AATGTGATCC AGCGCCGGGG CCGAGCAGGC
    CGCTGCCAGT CAGGTTTTGC CTACCACTTG TTTCCACGGA GTCGACTGGA GAAAATGGTC
    CCTTTCCAAG TGCCAGAGAT CCTGCGCACG CCTCTGGAGA ACCTGGTGCT GCAAGCTAAA
    ATCCATATGC CTGAGAAGAC GGCAGTGGAG TTCCTTTCCA AGGCTGTGGA CAGTCCCAAC
    ATCAAGGCAG TGGATGAGGC TGTGATACTG CTTCAGGAGA TCGGGGTGCT GGACCAGCGG
    GAGTACCTGA CCACCTTGGG GCAGCGCCTG GCCCACATCT CTACTGACCC CCGGCTGGCC
    AAGGCCATAG TGCTGGCTGC CATCTTCCGT TGCCTACACC CGTTGCTGGT GGTTGTTTCC
    TGCCTCACCC GGGACCCTTT CAGCAGCAGT TTGCAGAACC GGGCAGAGGT GGACAAGGTA
    AAGGCTCTGC TGAGCCATGA CAGTGGCAGT GACCACTTGG CCTTTGTGCG GGCCGTCGCT
    GGTTGGGAGG AGGTGCTGCG TTGGCAGGAC CGCACCTCCC GGGAAAACTA CCTGGAAGAA
    AACCTGCTCT ATGCCCCCAG CTTGCGCTTC ATCCACGGGC TTATCAAGCA GTTCTCAGAG
    AATATTTACG AGGCTTTTCT AGTGGGAAAG CCCTCAGACT GCACACTGCC TTCTGCCCAG
    TGCAACGAGT ACAGTGAGGA AGAGGAACTG GTGAAGGGTG TGCTGATGGC TGGCCTCTAC
    CCCAACCTCA TCCAGGTGAG GCAGGGTAAG GTGACTCGGC AGGGGAAGTT CAAGCCCAAC
    AGTGTCACTT ACAGGACCAA ATCTGGCAAT ATCTTGCTGC ACAAGTCAAC TATTAACAGG
    GAGGCTACCC GGTTACGGAG CCGATGGCTG ACATATTTCA TGGCTGTTAA GTCCAATGGC
    AGCGTCTTTG TGCGAGATTC CTCCCAGGTG CACCCGCTAG CTGTGCTGCT CCTAACTGAT
    GGGGACGTTC ACATCCGAGA TGATGGGCGT CGGGCTACCA TCTCACTGAG TGACAGTGAC
    CTGCTGCGGC TGGAAGGCGA CTCACGAACT GTGCGGCTGC TGAGGGAGCT GCGGCGAGCC
    CTGGGCCGCA TGGTGGAGCG GAGCCTTCGC AGCGAACTGG CCGCACTTCC TCTCAGTGTA
    CAGCAGGAGC ACGGGCAGCT GCTCGCGCTG CTGGCAGAAC TGCTGCGAGG ACCTTGTGGC
    AGCTTTGACG TGCGCAAGAC AGCTGATGAC TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26838
    Clone ID Related Accession (Same CDS sequence) XM_008830786.2
    Accession Version XM_008830786.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3222bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product putative ATP-dependent RNA helicase DHX30 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008830786.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGGCTGGG GTCTGTTGGG TCCCCGGAAT GAGCTGTTTG ATGCAGCCAA ATACCGAGTG 
    CTAGCTGATC GGTTCGGCTC TCCAGCTGAC AGCTGGTGGC GCCCAGAACC CACCATGCCT
    CCCACTTCCT GGCGACAGCT GAATCCTGAA AACATTCGGC CAGGAGGTCC TGGGGGCCTA
    TCCCGCTCCT TAGGCCGGGA GGAAGAGGAA GATGAGGAAG AAGAGCTAGA AGAGGGGACC
    ATTGATGTTA CGGAGTTCCT GTCCATGACA CAGCAAGACT CCCATAACCC ACTCAGGGAC
    TCAAGGGGAG GCTCCTTTGA AATGACAGAT GATGACAGTG CTATTAGGGC TCTGACCCAG
    TTTCCACTTC CCAAGAATCT TCTGGCCAAG GTGATTCAGA TTGCAACATC CTCCTCCACA
    GCTAAGAACC TTATGCAGTT CCATACCGTG GGTACCAAGA CAAAGCTGGC TACACTCACT
    CTGCTCTGGC CCTGTCCCAT GACCTTTGTT GCCAAAGGGC GCCGCAAAGC AGAGGCTGAG
    AATAAGGCAG CAGCCTTGGC CTGCAAGAAA CTGAAGAGCC TGGGCCTGGT GGACCGGAAC
    AATGAGCCAC TTACCCATGC CATGTACAAC CTGGCCTCCT TGCGTGAGTT GGGTGAGACC
    CAGCGCCGGC CGTGTACCAT CCAGGTGCCG GAGCCCATCC TCCGCAAAAT AGAGACCTTC
    CTGAATCATT ACCCCGTGGA CAGTTCATGG ATTTCCCCAG AGCTCCGGCT GCAGAGTGAT
    GACATCTTGC CGTTAGGCAA GGACTCAGGG CCCCTGAGCG ACCCTATTAC AGGCAAGCCA
    TATGTGCCCC TGTCAGAAGC AGAGGAGGTG CGCCTGAGCC AGAGCCTGCT AGAGCTGTGG
    CGGCGGCGAG GGCCAGTCTG GCAGGAGGCC CCCCAGCTAC CTGTGGATCC ACATCGGGAC
    ACTATCCTCA GTGCCATTGA GCAGCACCCA GTAGTGGTCA TCTCTGGGGA CACAGGTTGT
    GGAAAGACCA CACGCATCCC TCAGCTGCTG CTGGAGCGCT ATGTGACTGA GGGCCGCGGT
    GCCCGCTGCA ATGTGATCAT CACCCAACCA CGCCGCATCT CAGCTGTGTC TGTGGCACAG
    CGGGTCAGCC ACGAACTGGG CCCCTCCTTG CGCCGGAATG TGGGCTTCCA AGTGCGCTTG
    GAAAGCAAGC CCCCAGCCCG AGGTGGGGCG CTGCTCTTCT GCACTGTGGG TATACTGCTG
    AGGAAGCTGC AGAGCAATCC CAGCCTGGAG GGCGTGAGCC ATGTCATTGT GGATGAGGTC
    CATGAGCGGG ATGTGAACAC AGACTTCCTG TTGATCCTGC TCAAGGGCCT GCAGCGGCTC
    AACCCAGCTC TACGGCTAGT GCTCATGAGT GCTACAGGTG ATAATGAGCG CTTCTCCCGC
    TACTTTGGTG GCTGTCCTGT CATCAAGGTG CCTGGCTTTA TGTATCCTGT CAAAGAGCAC
    TACCTGGAGG ACATCCTGGC CAAGCTGGGT AAACACCAGT ACCCGCACCG GCACCGGCAC
    CATGAGTCTG AAGATGAATG TGCACTTGAT TTGGACCTGG TGACTGATCT GGTTCTGCAC
    ATCGATGCCC GTGGGGAACC AGGTGGGATC CTGTGCTTCT TGCCTGGTTG GCAGGAGATC
    AAAGGAGTGC AACAACGCCT CCAGGAGGCC CTGGGCATGC ACGAGAGCAA GTACCTCATC
    CTGCCAGTGC ACTCCAACAT CCCCATGATG GACCAAAAGG CCATATTCCA GCAGCCTCCA
    CTTGGGGTGC GCAAGATTGT ACTGGCCACC AACATTGCAG AGACCTCCAT CACAGTTAAT
    GACATTGTGC ATGTTGTGGA CAGCGGCCTG CACAAGGAGG AACGCTATGA CCTCAAGACC
    AAGGTGTCAT GCTTAGAGAC TGTGTGGGTG TCAAGAGCAA ATGTGATCCA GCGCCGGGGC
    CGAGCAGGCC GCTGCCAGTC AGGTTTTGCC TACCACTTGT TTCCACGGAG TCGACTGGAG
    AAAATGGTCC CTTTCCAAGT GCCAGAGATC CTGCGCACGC CTCTGGAGAA CCTGGTGCTG
    CAAGCTAAAA TCCATATGCC TGAGAAGACG GCAGTGGAGT TCCTTTCCAA GGCTGTGGAC
    AGTCCCAACA TCAAGGCAGT GGATGAGGCT GTGATACTGC TTCAGGAGAT CGGGGTGCTG
    GACCAGCGGG AGTACCTGAC CACCTTGGGG CAGCGCCTGG CCCACATCTC TACTGACCCC
    CGGCTGGCCA AGGCCATAGT GCTGGCTGCC ATCTTCCGTT GCCTACACCC GTTGCTGGTG
    GTTGTTTCCT GCCTCACCCG GGACCCTTTC AGCAGCAGTT TGCAGAACCG GGCAGAGGTG
    GACAAGGTAA AGGCTCTGCT GAGCCATGAC AGTGGCAGTG ACCACTTGGC CTTTGTGCGG
    GCCGTCGCTG GTTGGGAGGA GGTGCTGCGT TGGCAGGACC GCACCTCCCG GGAAAACTAC
    CTGGAAGAAA ACCTGCTCTA TGCCCCCAGC TTGCGCTTCA TCCACGGGCT TATCAAGCAG
    TTCTCAGAGA ATATTTACGA GGCTTTTCTA GTGGGAAAGC CCTCAGACTG CACACTGCCT
    TCTGCCCAGT GCAACGAGTA CAGTGAGGAA GAGGAACTGG TGAAGGGTGT GCTGATGGCT
    GGCCTCTACC CCAACCTCAT CCAGGTGAGG CAGGGTAAGG TGACTCGGCA GGGGAAGTTC
    AAGCCCAACA GTGTCACTTA CAGGACCAAA TCTGGCAATA TCTTGCTGCA CAAGTCAACT
    ATTAACAGGG AGGCTACCCG GTTACGGAGC CGATGGCTGA CATATTTCAT GGCTGTTAAG
    TCCAATGGCA GCGTCTTTGT GCGAGATTCC TCCCAGGTGC ACCCGCTAGC TGTGCTGCTC
    CTAACTGATG GGGACGTTCA CATCCGAGAT GATGGGCGTC GGGCTACCAT CTCACTGAGT
    GACAGTGACC TGCTGCGGCT GGAAGGCGAC TCACGAACTG TGCGGCTGCT GAGGGAGCTG
    CGGCGAGCCC TGGGCCGCAT GGTGGAGCGG AGCCTTCGCA GCGAACTGGC CGCACTTCCT
    CTCAGTGTAC AGCAGGAGCA CGGGCAGCTG CTCGCGCTGC TGGCAGAACT GCTGCGAGGA
    CCTTGTGGCA GCTTTGACGT GCGCAAGACA GCTGATGACT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008829008.1
    CDS33..3254
    Translation

    Target ORF information:

    RefSeq Version XM_008830786.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830786.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGGCTGGG GTCTGTTGGG TCCCCGGAAT GAGCTGTTTG ATGCAGCCAA ATACCGAGTG 
    CTAGCTGATC GGTTCGGCTC TCCAGCTGAC AGCTGGTGGC GCCCAGAACC CACCATGCCT
    CCCACTTCCT GGCGACAGCT GAATCCTGAA AACATTCGGC CAGGAGGTCC TGGGGGCCTA
    TCCCGCTCCT TAGGCCGGGA GGAAGAGGAA GATGAGGAAG AAGAGCTAGA AGAGGGGACC
    ATTGATGTTA CGGAGTTCCT GTCCATGACA CAGCAAGACT CCCATAACCC ACTCAGGGAC
    TCAAGGGGAG GCTCCTTTGA AATGACAGAT GATGACAGTG CTATTAGGGC TCTGACCCAG
    TTTCCACTTC CCAAGAATCT TCTGGCCAAG GTGATTCAGA TTGCAACATC CTCCTCCACA
    GCTAAGAACC TTATGCAGTT CCATACCGTG GGTACCAAGA CAAAGCTGGC TACACTCACT
    CTGCTCTGGC CCTGTCCCAT GACCTTTGTT GCCAAAGGGC GCCGCAAAGC AGAGGCTGAG
    AATAAGGCAG CAGCCTTGGC CTGCAAGAAA CTGAAGAGCC TGGGCCTGGT GGACCGGAAC
    AATGAGCCAC TTACCCATGC CATGTACAAC CTGGCCTCCT TGCGTGAGTT GGGTGAGACC
    CAGCGCCGGC CGTGTACCAT CCAGGTGCCG GAGCCCATCC TCCGCAAAAT AGAGACCTTC
    CTGAATCATT ACCCCGTGGA CAGTTCATGG ATTTCCCCAG AGCTCCGGCT GCAGAGTGAT
    GACATCTTGC CGTTAGGCAA GGACTCAGGG CCCCTGAGCG ACCCTATTAC AGGCAAGCCA
    TATGTGCCCC TGTCAGAAGC AGAGGAGGTG CGCCTGAGCC AGAGCCTGCT AGAGCTGTGG
    CGGCGGCGAG GGCCAGTCTG GCAGGAGGCC CCCCAGCTAC CTGTGGATCC ACATCGGGAC
    ACTATCCTCA GTGCCATTGA GCAGCACCCA GTAGTGGTCA TCTCTGGGGA CACAGGTTGT
    GGAAAGACCA CACGCATCCC TCAGCTGCTG CTGGAGCGCT ATGTGACTGA GGGCCGCGGT
    GCCCGCTGCA ATGTGATCAT CACCCAACCA CGCCGCATCT CAGCTGTGTC TGTGGCACAG
    CGGGTCAGCC ACGAACTGGG CCCCTCCTTG CGCCGGAATG TGGGCTTCCA AGTGCGCTTG
    GAAAGCAAGC CCCCAGCCCG AGGTGGGGCG CTGCTCTTCT GCACTGTGGG TATACTGCTG
    AGGAAGCTGC AGAGCAATCC CAGCCTGGAG GGCGTGAGCC ATGTCATTGT GGATGAGGTC
    CATGAGCGGG ATGTGAACAC AGACTTCCTG TTGATCCTGC TCAAGGGCCT GCAGCGGCTC
    AACCCAGCTC TACGGCTAGT GCTCATGAGT GCTACAGGTG ATAATGAGCG CTTCTCCCGC
    TACTTTGGTG GCTGTCCTGT CATCAAGGTG CCTGGCTTTA TGTATCCTGT CAAAGAGCAC
    TACCTGGAGG ACATCCTGGC CAAGCTGGGT AAACACCAGT ACCCGCACCG GCACCGGCAC
    CATGAGTCTG AAGATGAATG TGCACTTGAT TTGGACCTGG TGACTGATCT GGTTCTGCAC
    ATCGATGCCC GTGGGGAACC AGGTGGGATC CTGTGCTTCT TGCCTGGTTG GCAGGAGATC
    AAAGGAGTGC AACAACGCCT CCAGGAGGCC CTGGGCATGC ACGAGAGCAA GTACCTCATC
    CTGCCAGTGC ACTCCAACAT CCCCATGATG GACCAAAAGG CCATATTCCA GCAGCCTCCA
    CTTGGGGTGC GCAAGATTGT ACTGGCCACC AACATTGCAG AGACCTCCAT CACAGTTAAT
    GACATTGTGC ATGTTGTGGA CAGCGGCCTG CACAAGGAGG AACGCTATGA CCTCAAGACC
    AAGGTGTCAT GCTTAGAGAC TGTGTGGGTG TCAAGAGCAA ATGTGATCCA GCGCCGGGGC
    CGAGCAGGCC GCTGCCAGTC AGGTTTTGCC TACCACTTGT TTCCACGGAG TCGACTGGAG
    AAAATGGTCC CTTTCCAAGT GCCAGAGATC CTGCGCACGC CTCTGGAGAA CCTGGTGCTG
    CAAGCTAAAA TCCATATGCC TGAGAAGACG GCAGTGGAGT TCCTTTCCAA GGCTGTGGAC
    AGTCCCAACA TCAAGGCAGT GGATGAGGCT GTGATACTGC TTCAGGAGAT CGGGGTGCTG
    GACCAGCGGG AGTACCTGAC CACCTTGGGG CAGCGCCTGG CCCACATCTC TACTGACCCC
    CGGCTGGCCA AGGCCATAGT GCTGGCTGCC ATCTTCCGTT GCCTACACCC GTTGCTGGTG
    GTTGTTTCCT GCCTCACCCG GGACCCTTTC AGCAGCAGTT TGCAGAACCG GGCAGAGGTG
    GACAAGGTAA AGGCTCTGCT GAGCCATGAC AGTGGCAGTG ACCACTTGGC CTTTGTGCGG
    GCCGTCGCTG GTTGGGAGGA GGTGCTGCGT TGGCAGGACC GCACCTCCCG GGAAAACTAC
    CTGGAAGAAA ACCTGCTCTA TGCCCCCAGC TTGCGCTTCA TCCACGGGCT TATCAAGCAG
    TTCTCAGAGA ATATTTACGA GGCTTTTCTA GTGGGAAAGC CCTCAGACTG CACACTGCCT
    TCTGCCCAGT GCAACGAGTA CAGTGAGGAA GAGGAACTGG TGAAGGGTGT GCTGATGGCT
    GGCCTCTACC CCAACCTCAT CCAGGTGAGG CAGGGTAAGG TGACTCGGCA GGGGAAGTTC
    AAGCCCAACA GTGTCACTTA CAGGACCAAA TCTGGCAATA TCTTGCTGCA CAAGTCAACT
    ATTAACAGGG AGGCTACCCG GTTACGGAGC CGATGGCTGA CATATTTCAT GGCTGTTAAG
    TCCAATGGCA GCGTCTTTGT GCGAGATTCC TCCCAGGTGC ACCCGCTAGC TGTGCTGCTC
    CTAACTGATG GGGACGTTCA CATCCGAGAT GATGGGCGTC GGGCTACCAT CTCACTGAGT
    GACAGTGACC TGCTGCGGCT GGAAGGCGAC TCACGAACTG TGCGGCTGCT GAGGGAGCTG
    CGGCGAGCCC TGGGCCGCAT GGTGGAGCGG AGCCTTCGCA GCGAACTGGC CGCACTTCCT
    CTCAGTGTAC AGCAGGAGCA CGGGCAGCTG CTCGCGCTGC TGGCAGAACT GCTGCGAGGA
    CCTTGTGGCA GCTTTGACGT GCGCAAGACA GCTGATGACT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26839
    Clone ID Related Accession (Same CDS sequence) XM_008830794.1 , XM_029562305.1 , XM_008830789.2 , XM_017797511.2 , XM_017797511.1
    Accession Version XM_008830794.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3108bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product putative ATP-dependent RNA helicase DHX30 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008829016.1
    CDS281..3388
    Translation

    Target ORF information:

    RefSeq Version XM_008830794.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X8, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830794.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26839
    Clone ID Related Accession (Same CDS sequence) XM_008830794.1 , XM_029562305.1 , XM_008830789.2 , XM_017797511.2 , XM_017797511.1
    Accession Version XM_029562305.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3108bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product ATP-dependent RNA helicase DHX30 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418165.1
    CDS217..3324
    Translation

    Target ORF information:

    RefSeq Version XM_029562305.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029562305.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26839
    Clone ID Related Accession (Same CDS sequence) XM_008830794.1 , XM_029562305.1 , XM_008830789.2 , XM_017797511.2 , XM_017797511.1
    Accession Version XM_008830789.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3108bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product putative ATP-dependent RNA helicase DHX30 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008830789.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008829011.1
    CDS171..3278
    Translation

    Target ORF information:

    RefSeq Version XM_008830789.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X7, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008830789.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26839
    Clone ID Related Accession (Same CDS sequence) XM_008830794.1 , XM_029562305.1 , XM_008830789.2 , XM_017797511.2 , XM_017797511.1
    Accession Version XM_017797511.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3108bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product ATP-dependent RNA helicase DHX30 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017797511.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653000.1
    CDS370..3477
    Translation

    Target ORF information:

    RefSeq Version XM_017797511.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DExH-box helicase 30 (Dhx30), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797511.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa26839
    Clone ID Related Accession (Same CDS sequence) XM_008830794.1 , XM_029562305.1 , XM_008830789.2 , XM_017797511.2 , XM_017797511.1
    Accession Version XM_017797511.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3108bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product putative ATP-dependent RNA helicase DHX30 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008329037.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653000.1
    CDS451..3558
    Translation

    Target ORF information:

    RefSeq Version XM_017797511.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili DEAH-box helicase 30 (Dhx30), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797511.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGCCTCCCA CTTCCTGGCG ACAGCTGAAT CCTGAAAACA TTCGGCCAGG AGGTCCTGGG 
    GGCCTATCCC GCTCCTTAGG CCGGGAGGAA GAGGAAGATG AGGAAGAAGA GCTAGAAGAG
    GGGACCATTG ATGTTACGGA GTTCCTGTCC ATGACACAGC AAGACTCCCA TAACCCACTC
    AGGGACTCAA GGGGAGGCTC CTTTGAAATG ACAGATGATG ACAGTGCTAT TAGGGCTCTG
    ACCCAGTTTC CACTTCCCAA GAATCTTCTG GCCAAGGTGA TTCAGATTGC AACATCCTCC
    TCCACAGCTA AGAACCTTAT GCAGTTCCAT ACCGTGGGTA CCAAGACAAA GCTGGCTACA
    CTCACTCTGC TCTGGCCCTG TCCCATGACC TTTGTTGCCA AAGGGCGCCG CAAAGCAGAG
    GCTGAGAATA AGGCAGCAGC CTTGGCCTGC AAGAAACTGA AGAGCCTGGG CCTGGTGGAC
    CGGAACAATG AGCCACTTAC CCATGCCATG TACAACCTGG CCTCCTTGCG TGAGTTGGGT
    GAGACCCAGC GCCGGCCGTG TACCATCCAG GTGCCGGAGC CCATCCTCCG CAAAATAGAG
    ACCTTCCTGA ATCATTACCC CGTGGACAGT TCATGGATTT CCCCAGAGCT CCGGCTGCAG
    AGTGATGACA TCTTGCCGTT AGGCAAGGAC TCAGGGCCCC TGAGCGACCC TATTACAGGC
    AAGCCATATG TGCCCCTGTC AGAAGCAGAG GAGGTGCGCC TGAGCCAGAG CCTGCTAGAG
    CTGTGGCGGC GGCGAGGGCC AGTCTGGCAG GAGGCCCCCC AGCTACCTGT GGATCCACAT
    CGGGACACTA TCCTCAGTGC CATTGAGCAG CACCCAGTAG TGGTCATCTC TGGGGACACA
    GGTTGTGGAA AGACCACACG CATCCCTCAG CTGCTGCTGG AGCGCTATGT GACTGAGGGC
    CGCGGTGCCC GCTGCAATGT GATCATCACC CAACCACGCC GCATCTCAGC TGTGTCTGTG
    GCACAGCGGG TCAGCCACGA ACTGGGCCCC TCCTTGCGCC GGAATGTGGG CTTCCAAGTG
    CGCTTGGAAA GCAAGCCCCC AGCCCGAGGT GGGGCGCTGC TCTTCTGCAC TGTGGGTATA
    CTGCTGAGGA AGCTGCAGAG CAATCCCAGC CTGGAGGGCG TGAGCCATGT CATTGTGGAT
    GAGGTCCATG AGCGGGATGT GAACACAGAC TTCCTGTTGA TCCTGCTCAA GGGCCTGCAG
    CGGCTCAACC CAGCTCTACG GCTAGTGCTC ATGAGTGCTA CAGGTGATAA TGAGCGCTTC
    TCCCGCTACT TTGGTGGCTG TCCTGTCATC AAGGTGCCTG GCTTTATGTA TCCTGTCAAA
    GAGCACTACC TGGAGGACAT CCTGGCCAAG CTGGGTAAAC ACCAGTACCC GCACCGGCAC
    CGGCACCATG AGTCTGAAGA TGAATGTGCA CTTGATTTGG ACCTGGTGAC TGATCTGGTT
    CTGCACATCG ATGCCCGTGG GGAACCAGGT GGGATCCTGT GCTTCTTGCC TGGTTGGCAG
    GAGATCAAAG GAGTGCAACA ACGCCTCCAG GAGGCCCTGG GCATGCACGA GAGCAAGTAC
    CTCATCCTGC CAGTGCACTC CAACATCCCC ATGATGGACC AAAAGGCCAT ATTCCAGCAG
    CCTCCACTTG GGGTGCGCAA GATTGTACTG GCCACCAACA TTGCAGAGAC CTCCATCACA
    GTTAATGACA TTGTGCATGT TGTGGACAGC GGCCTGCACA AGGAGGAACG CTATGACCTC
    AAGACCAAGG TGTCATGCTT AGAGACTGTG TGGGTGTCAA GAGCAAATGT GATCCAGCGC
    CGGGGCCGAG CAGGCCGCTG CCAGTCAGGT TTTGCCTACC ACTTGTTTCC ACGGAGTCGA
    CTGGAGAAAA TGGTCCCTTT CCAAGTGCCA GAGATCCTGC GCACGCCTCT GGAGAACCTG
    GTGCTGCAAG CTAAAATCCA TATGCCTGAG AAGACGGCAG TGGAGTTCCT TTCCAAGGCT
    GTGGACAGTC CCAACATCAA GGCAGTGGAT GAGGCTGTGA TACTGCTTCA GGAGATCGGG
    GTGCTGGACC AGCGGGAGTA CCTGACCACC TTGGGGCAGC GCCTGGCCCA CATCTCTACT
    GACCCCCGGC TGGCCAAGGC CATAGTGCTG GCTGCCATCT TCCGTTGCCT ACACCCGTTG
    CTGGTGGTTG TTTCCTGCCT CACCCGGGAC CCTTTCAGCA GCAGTTTGCA GAACCGGGCA
    GAGGTGGACA AGGTAAAGGC TCTGCTGAGC CATGACAGTG GCAGTGACCA CTTGGCCTTT
    GTGCGGGCCG TCGCTGGTTG GGAGGAGGTG CTGCGTTGGC AGGACCGCAC CTCCCGGGAA
    AACTACCTGG AAGAAAACCT GCTCTATGCC CCCAGCTTGC GCTTCATCCA CGGGCTTATC
    AAGCAGTTCT CAGAGAATAT TTACGAGGCT TTTCTAGTGG GAAAGCCCTC AGACTGCACA
    CTGCCTTCTG CCCAGTGCAA CGAGTACAGT GAGGAAGAGG AACTGGTGAA GGGTGTGCTG
    ATGGCTGGCC TCTACCCCAA CCTCATCCAG GTGAGGCAGG GTAAGGTGAC TCGGCAGGGG
    AAGTTCAAGC CCAACAGTGT CACTTACAGG ACCAAATCTG GCAATATCTT GCTGCACAAG
    TCAACTATTA ACAGGGAGGC TACCCGGTTA CGGAGCCGAT GGCTGACATA TTTCATGGCT
    GTTAAGTCCA ATGGCAGCGT CTTTGTGCGA GATTCCTCCC AGGTGCACCC GCTAGCTGTG
    CTGCTCCTAA CTGATGGGGA CGTTCACATC CGAGATGATG GGCGTCGGGC TACCATCTCA
    CTGAGTGACA GTGACCTGCT GCGGCTGGAA GGCGACTCAC GAACTGTGCG GCTGCTGAGG
    GAGCTGCGGC GAGCCCTGGG CCGCATGGTG GAGCGGAGCC TTCGCAGCGA ACTGGCCGCA
    CTTCCTCTCA GTGTACAGCA GGAGCACGGG CAGCTGCTCG CGCTGCTGGC AGAACTGCTG
    CGAGGACCTT GTGGCAGCTT TGACGTGCGC AAGACAGCTG ATGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.