ADGRG6 cDNA ORF clone, Equus asinus(ass)

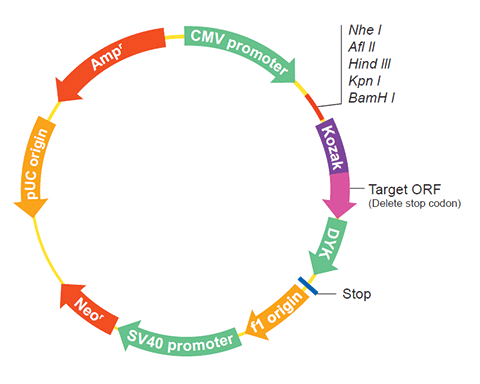
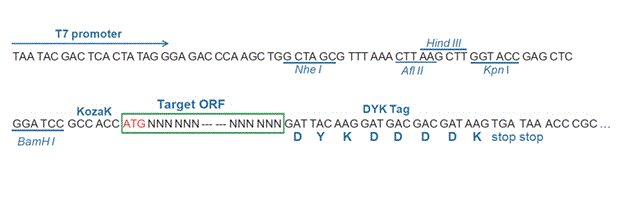
The following ADGRG6 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ADGRG6 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OEq17455 XM_014854869.1
Latest version!
Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq17456 XM_014854872.1
Latest version!
Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq17456 XM_014854871.1
Latest version!
Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq17457 XM_014854873.1
Latest version!
Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq17458 XM_014854874.1
Latest version!
Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq17459 XM_014854875.1
Latest version!
Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OEq17455
    Clone ID Related Accession (Same CDS sequence) XM_014854869.1
    Accession Version XM_014854869.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3753bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product G-protein coupled receptor 126 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638112.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGCT
    ACTGTAAACT CTCCTTGTAC TACACCACCC ACTGTCACCA CTAACATGCC TGTTACTAAT
    AGAATCGGTA AACAAAGCAA TGATGGAATT GCCTATAGAA TTTCCATAGT GATTCAAAAC
    GTACTTCGTC ACCCAGAGGT CAAAGTACAG AGCAAGGTGG CAGAATGGCT CAATTCAACC
    TTCCAAAATT GGAACTACAC TGTTTATGTG GTTAATATCA GTTTTCACCT GAGCACGGGA
    GAGGACAAGA TTAAAGTCAA GAGAAGCCTT GTGATTGATC AAAGGTTCGT GATTTGGGCA
    CTTCTAATTT ACAATGCAAC CAACAACCCC AGTTTAGAAG GAGAAGTCAT TCAGCAGAAG
    CTCTTAAAAA ACAACGAGTC CCTGGACGAG GGGTTGAGGC TGTACACGGT GAATGTGAGG
    CAGCTGGGTA TATGTGCTGG TGAGGAGAAC CCCAAAGGCT ATCAGTGGCC GACCATCTCC
    CCTTCGGAAT ACAAGCATCC CTGTCTAGAG AAGCAGGGGT TTTATGCCTC ACGGACATGT
    CATCCTGCCC CTAACAGCAC CTCTTCAGCC TACTGGGGGA CCCCTGACCT CTCCAATTGT
    TCAAAGGAGG CAAATGAAGT TGCCAATCAG ATTTTAAATT TAACTGGTGA TGGGCAGACC
    TTAAACTCAG CCAATATCAC CAGCATTGTG GAACAGGTCA GGAGGATTGT AAATAAAGAA
    GAAAACATTG ATATAACGCT TGGCTCGACT TTAATGAATA TATTTTCTAA TATCTTAACC
    AGTCCAGACA GTGACTTGCT CGAGTCTTCT TCTGAAGCTT TAAAAACAAT TGATGAATTG
    GCCTTCAAGA TAGACCTAAG CAGCACATCA CATGTGAATA TCACAACGCG GAATTTGGCT
    CTTGGAGTGT CATCCCTGTC CCCAGGGACC AATGAAATTT CGAATTTTAG CATTGGTCTT
    CCAAGCAATA ATGAATCCTA TTTCCAGATG GATTTTGCGA GTGAACAGAT GGATCCATTG
    GCTTCTGTAA TGTTGCCTCC AAACTTACTT GAGAATTTAA GTCAAGAAGA TTCTGTGTTA
    GTTAAAAGAG TACAGTTTAC TTTCTTCAAT AAAACTGGAC TTTTTCAGGG TGTGGAAACC
    AAGAAAGGCA CCTTAGTGAG TTATGTAATG GCATGCAGTA TTGGAAACAT TACTATCCAG
    GGTCTGAAGG ATCCTGTTCG AATTAAAATC AAGCATGCGA GAAGCCAGGC TGTGCATCAT
    CCCGTCTGTG CCTTCTGGGA TCTGGACAAT GGTGAAGCTT CTGGATTTTG GAACACATCA
    GGATGTGTTA CACAAGGACA TTCAGATGCA AGCGAGACGG TCTGCCTCTG TAACCACCTC
    ACACACTTCG GAGTTCTGAT GGACCTTCAA GGAACCGCCT CACAGATGGA TGCAAGAAAC
    ACCAGAATTC TCACCTTCCT CACCTATATT GGGTGCGGAA TATCTGCTAT CTTTTCAGCA
    ACTACGCTCC TGACGTATGT TGCTTTTGAA AAATTGCGAA GGGATTATCC CTCCAAAATC
    TTGATGAACC TAAGTACGGC CCTGCTGTTC CTGAATCTCA TCTTCCTCTT GGACGGCTGG
    ATCACCTCGT TTCACGTAGA TGGTCTTTGC ACGGCAGTGG CTGCCCTGCT GCATTTCTTC
    CTTCTGGCAA CCTTTACCTG GATGGGGCTG GAAGCAATTC ACATGTACAT TGCTCTTGTG
    AAAGTATTTA ACACTTACAT CCGCCGATAC ATACTGAAAT TCTGCATCAT TGGCTGGGGT
    TTGCCTGCCT TGGTCGTGTC AATTGTTCTA GCAAGCAGAA AGCAAAATGA AGTCTATGGA
    AAAGAAAGTT ATGGAAAAGA ACAAGGTGAC GAATTCTGTT GGATTCAGGA TCCAGTCGTG
    TTTTATGTGA CCTGTGCCGG GTATTTTGGA GTCATGTTTT TCCTGAATTT CGCCATGTTC
    ATCGTGGTGG TGGTGCAGAT CTGTGGCAGG AACGGCAAGA GAAGCAACCG CACGCTGCGC
    GAAGAGGTCT TAAGGAACCT GCGCAGTGTG GTCAGCCTGA CGTTTCTGCT GGGCATGACG
    TGGGGTTTTG CTTTCTTCGC CTGGGGACCC TTAAATGTCG CTTTCATGTA CCTCTTCTCC
    ATCTTCAATT CATTACAAGG CTTGTTTATA TTTGTCTTCC ACTGCGCCAT GAAGGAGAAT
    GTCCAGAAGC AGTGGAGGCG GCATCTCTGC TGCGGGAGGT TTCGGTTAGC GGACAACTCA
    GACTGGAGTA AGACAGCTAC CAATATCATC AAGAAGAGTT CTGACAATCT CGGAAAATCT
    TTGTCCTCAA GTTCCATTGG TTCCAACTCC ACCTACCTTA CATCCAAATC GAAGTCCAGC
    TCCACAACCT ACTTCAAGAG GAACAGCCAC ACTGACAGTG CTTCCACGGA CAAGCCCTCC
    TCCAAGCTGA CCCATGCTGA CGGAGAGCAG ACGTCAATCA TTCCTGTCCA TCAAGTCCTT
    GATAAGGTCA AGGGTTATTG CAATGCTCAT TCAGACAACT TCTATAAAAA TATTATCATG
    TCAGACTCCT TCAGCCACAG CACAAAGTTT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014710355.1
    CDS224..3976
    Translation

    Target ORF information:

    RefSeq Version XM_014854869.1
    Organism Equus asinus(ass)
    Definition Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014854869.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGCT
    ACTGTAAACT CTCCTTGTAC TACACCACCC ACTGTCACCA CTAACATGCC TGTTACTAAT
    AGAATCGGTA AACAAAGCAA TGATGGAATT GCCTATAGAA TTTCCATAGT GATTCAAAAC
    GTACTTCGTC ACCCAGAGGT CAAAGTACAG AGCAAGGTGG CAGAATGGCT CAATTCAACC
    TTCCAAAATT GGAACTACAC TGTTTATGTG GTTAATATCA GTTTTCACCT GAGCACGGGA
    GAGGACAAGA TTAAAGTCAA GAGAAGCCTT GTGATTGATC AAAGGTTCGT GATTTGGGCA
    CTTCTAATTT ACAATGCAAC CAACAACCCC AGTTTAGAAG GAGAAGTCAT TCAGCAGAAG
    CTCTTAAAAA ACAACGAGTC CCTGGACGAG GGGTTGAGGC TGTACACGGT GAATGTGAGG
    CAGCTGGGTA TATGTGCTGG TGAGGAGAAC CCCAAAGGCT ATCAGTGGCC GACCATCTCC
    CCTTCGGAAT ACAAGCATCC CTGTCTAGAG AAGCAGGGGT TTTATGCCTC ACGGACATGT
    CATCCTGCCC CTAACAGCAC CTCTTCAGCC TACTGGGGGA CCCCTGACCT CTCCAATTGT
    TCAAAGGAGG CAAATGAAGT TGCCAATCAG ATTTTAAATT TAACTGGTGA TGGGCAGACC
    TTAAACTCAG CCAATATCAC CAGCATTGTG GAACAGGTCA GGAGGATTGT AAATAAAGAA
    GAAAACATTG ATATAACGCT TGGCTCGACT TTAATGAATA TATTTTCTAA TATCTTAACC
    AGTCCAGACA GTGACTTGCT CGAGTCTTCT TCTGAAGCTT TAAAAACAAT TGATGAATTG
    GCCTTCAAGA TAGACCTAAG CAGCACATCA CATGTGAATA TCACAACGCG GAATTTGGCT
    CTTGGAGTGT CATCCCTGTC CCCAGGGACC AATGAAATTT CGAATTTTAG CATTGGTCTT
    CCAAGCAATA ATGAATCCTA TTTCCAGATG GATTTTGCGA GTGAACAGAT GGATCCATTG
    GCTTCTGTAA TGTTGCCTCC AAACTTACTT GAGAATTTAA GTCAAGAAGA TTCTGTGTTA
    GTTAAAAGAG TACAGTTTAC TTTCTTCAAT AAAACTGGAC TTTTTCAGGG TGTGGAAACC
    AAGAAAGGCA CCTTAGTGAG TTATGTAATG GCATGCAGTA TTGGAAACAT TACTATCCAG
    GGTCTGAAGG ATCCTGTTCG AATTAAAATC AAGCATGCGA GAAGCCAGGC TGTGCATCAT
    CCCGTCTGTG CCTTCTGGGA TCTGGACAAT GGTGAAGCTT CTGGATTTTG GAACACATCA
    GGATGTGTTA CACAAGGACA TTCAGATGCA AGCGAGACGG TCTGCCTCTG TAACCACCTC
    ACACACTTCG GAGTTCTGAT GGACCTTCAA GGAACCGCCT CACAGATGGA TGCAAGAAAC
    ACCAGAATTC TCACCTTCCT CACCTATATT GGGTGCGGAA TATCTGCTAT CTTTTCAGCA
    ACTACGCTCC TGACGTATGT TGCTTTTGAA AAATTGCGAA GGGATTATCC CTCCAAAATC
    TTGATGAACC TAAGTACGGC CCTGCTGTTC CTGAATCTCA TCTTCCTCTT GGACGGCTGG
    ATCACCTCGT TTCACGTAGA TGGTCTTTGC ACGGCAGTGG CTGCCCTGCT GCATTTCTTC
    CTTCTGGCAA CCTTTACCTG GATGGGGCTG GAAGCAATTC ACATGTACAT TGCTCTTGTG
    AAAGTATTTA ACACTTACAT CCGCCGATAC ATACTGAAAT TCTGCATCAT TGGCTGGGGT
    TTGCCTGCCT TGGTCGTGTC AATTGTTCTA GCAAGCAGAA AGCAAAATGA AGTCTATGGA
    AAAGAAAGTT ATGGAAAAGA ACAAGGTGAC GAATTCTGTT GGATTCAGGA TCCAGTCGTG
    TTTTATGTGA CCTGTGCCGG GTATTTTGGA GTCATGTTTT TCCTGAATTT CGCCATGTTC
    ATCGTGGTGG TGGTGCAGAT CTGTGGCAGG AACGGCAAGA GAAGCAACCG CACGCTGCGC
    GAAGAGGTCT TAAGGAACCT GCGCAGTGTG GTCAGCCTGA CGTTTCTGCT GGGCATGACG
    TGGGGTTTTG CTTTCTTCGC CTGGGGACCC TTAAATGTCG CTTTCATGTA CCTCTTCTCC
    ATCTTCAATT CATTACAAGG CTTGTTTATA TTTGTCTTCC ACTGCGCCAT GAAGGAGAAT
    GTCCAGAAGC AGTGGAGGCG GCATCTCTGC TGCGGGAGGT TTCGGTTAGC GGACAACTCA
    GACTGGAGTA AGACAGCTAC CAATATCATC AAGAAGAGTT CTGACAATCT CGGAAAATCT
    TTGTCCTCAA GTTCCATTGG TTCCAACTCC ACCTACCTTA CATCCAAATC GAAGTCCAGC
    TCCACAACCT ACTTCAAGAG GAACAGCCAC ACTGACAGTG CTTCCACGGA CAAGCCCTCC
    TCCAAGCTGA CCCATGCTGA CGGAGAGCAG ACGTCAATCA TTCCTGTCCA TCAAGTCCTT
    GATAAGGTCA AGGGTTATTG CAATGCTCAT TCAGACAACT TCTATAAAAA TATTATCATG
    TCAGACTCCT TCAGCCACAG CACAAAGTTT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq17456
    Clone ID Related Accession (Same CDS sequence) XM_014854872.1 , XM_014854871.1
    Accession Version XM_014854872.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3750bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product G-protein coupled receptor 126 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638112.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTACCCT CAGGCCGAAT GTGGAGCTGT CACTGGAAAT GGAAGCCAAG TTCTCTTTTG 
    TTCTTCTTTG CTTTATATAT CGTCTGTGTT CCTCACTCAG TGTGGGGATG TGCCAGCTGC
    AGGCTTATCC TCTCCAACCC TTCTGGGGCC TTCACTTCTC CCTGCTACCC TAACGACTAC
    CCTAACAGCC AGGCTTGCAT GTGGACCCTC CGAGCCCCCA CCGGCTATAT CATTCAGATA
    ACGTTTAATG ACTTTGACAT CGAAGAAGCT CCCAATTGCA TTTATGATGC ATTATCCCTT
    GATAATGGAG AGAGCCAGAC TAAATTTTGT GGAGCAACTG CCAAAGGCCT GTCATTTAAC
    TCAAGTGCGA ATGAGATGCA TGTGTCCTTT TCAAGTGACT TCAGCATCCA GAAGAAAGGT
    TTCAATGCCA GCTACATCAG AGTTGCCGTG TCCTTAAGGA ATCAAAAGGT CGTTTTACCC
    CTGACGCTAG ATGCTCACCA GGTGTCTGTC GCAAAAAGCG TCTCTATTCC AGAGCTCAGC
    GCTTTCACAC TCTGTTTTGA AGCAACCAAA ATTGGCAAGG AAGACACTGA ATGGATAGCT
    TTCTCCTACT CAAATGCATC CTTCACACAA TTGCTCAGTT TTGGAAAGGC CAAGGATGGC
    TATTTTCTAT CTGTTTCTGA CTCAAGATGC TTCCTGAGCA ACGTGTTACC TGTAAAGGAT
    AAAGAAGACA TTTTCACAGA AAGCTTCGAG CAGCTCTGCG TCGTTTGGGA TAATTCTCTG
    GGCTCCGTTG GTGTAAATTT CAAAAGAAAC TATGAAGCTG TTCCCTGCGA TTCTACCATT
    AGTAAAGTTA TTCCAGGGAA TGGGAGATTG CTGTTGGGCT CCGATCAAAG TGAAATTGCC
    TCTCTAAAAG GGGACATTTA TAACTTTCGA CTTTGGAATT TTACCATGAA TTCCAAAACC
    CTGGCCAACC TCAGCTGCAG TGTGAAAGGG AATGTGGTCG ACTGGCAGAA TGACTTCTGG
    AACATCCCAA CCGTAGCTCT GAAGGCTGAG AGCAACCTAA GCTGTGGTTC CTACCTGATC
    CCGCTCCCGG CAGCAGAACT GGCCAGCTGT GCAGACCTGG GGACCCTCTG CAGAGCTACT
    GTAAACTCTC CTTGTACTAC ACCACCCACT GTCACCACTA ACATGCCTGT TACTAATAGA
    ATCGGTAAAC AAAGCAATGA TGGAATTGCC TATAGAATTT CCATAGTGAT TCAAAACGTA
    CTTCGTCACC CAGAGGTCAA AGTACAGAGC AAGGTGGCAG AATGGCTCAA TTCAACCTTC
    CAAAATTGGA ACTACACTGT TTATGTGGTT AATATCAGTT TTCACCTGAG CACGGGAGAG
    GACAAGATTA AAGTCAAGAG AAGCCTTGTG ATTGATCAAA GGTTCGTGAT TTGGGCACTT
    CTAATTTACA ATGCAACCAA CAACCCCAGT TTAGAAGGAG AAGTCATTCA GCAGAAGCTC
    TTAAAAAACA ACGAGTCCCT GGACGAGGGG TTGAGGCTGT ACACGGTGAA TGTGAGGCAG
    CTGGGTATAT GTGCTGGTGA GGAGAACCCC AAAGGCTATC AGTGGCCGAC CATCTCCCCT
    TCGGAATACA AGCATCCCTG TCTAGAGAAG CAGGGGTTTT ATGCCTCACG GACATGTCAT
    CCTGCCCCTA ACAGCACCTC TTCAGCCTAC TGGGGGACCC CTGACCTCTC CAATTGTTCA
    AAGGAGGCAA ATGAAGTTGC CAATCAGATT TTAAATTTAA CTGGTGATGG GCAGACCTTA
    AACTCAGCCA ATATCACCAG CATTGTGGAA CAGGTCAGGA GGATTGTAAA TAAAGAAGAA
    AACATTGATA TAACGCTTGG CTCGACTTTA ATGAATATAT TTTCTAATAT CTTAACCAGT
    CCAGACAGTG ACTTGCTCGA GTCTTCTTCT GAAGCTTTAA AAACAATTGA TGAATTGGCC
    TTCAAGATAG ACCTAAGCAG CACATCACAT GTGAATATCA CAACGCGGAA TTTGGCTCTT
    GGAGTGTCAT CCCTGTCCCC AGGGACCAAT GAAATTTCGA ATTTTAGCAT TGGTCTTCCA
    AGCAATAATG AATCCTATTT CCAGATGGAT TTTGCGAGTG AACAGATGGA TCCATTGGCT
    TCTGTAATGT TGCCTCCAAA CTTACTTGAG AATTTAAGTC AAGAAGATTC TGTGTTAGTT
    AAAAGAGTAC AGTTTACTTT CTTCAATAAA ACTGGACTTT TTCAGGGTGT GGAAACCAAG
    AAAGGCACCT TAGTGAGTTA TGTAATGGCA TGCAGTATTG GAAACATTAC TATCCAGGGT
    CTGAAGGATC CTGTTCGAAT TAAAATCAAG CATGCGAGAA GCCAGGCTGT GCATCATCCC
    GTCTGTGCCT TCTGGGATCT GGACAATGGT GAAGCTTCTG GATTTTGGAA CACATCAGGA
    TGTGTTACAC AAGGACATTC AGATGCAAGC GAGACGGTCT GCCTCTGTAA CCACCTCACA
    CACTTCGGAG TTCTGATGGA CCTTCAAGGA ACCGCCTCAC AGATGGATGC AAGAAACACC
    AGAATTCTCA CCTTCCTCAC CTATATTGGG TGCGGAATAT CTGCTATCTT TTCAGCAACT
    ACGCTCCTGA CGTATGTTGC TTTTGAAAAA TTGCGAAGGG ATTATCCCTC CAAAATCTTG
    ATGAACCTAA GTACGGCCCT GCTGTTCCTG AATCTCATCT TCCTCTTGGA CGGCTGGATC
    ACCTCGTTTC ACGTAGATGG TCTTTGCACG GCAGTGGCTG CCCTGCTGCA TTTCTTCCTT
    CTGGCAACCT TTACCTGGAT GGGGCTGGAA GCAATTCACA TGTACATTGC TCTTGTGAAA
    GTATTTAACA CTTACATCCG CCGATACATA CTGAAATTCT GCATCATTGG CTGGGGTTTG
    CCTGCCTTGG TCGTGTCAAT TGTTCTAGCA AGCAGAAAGC AAAATGAAGT CTATGGAAAA
    GAAAGTTATG GAAAAGAACA AGGTGACGAA TTCTGTTGGA TTCAGGATCC AGTCGTGTTT
    TATGTGACCT GTGCCGGGTA TTTTGGAGTC ATGTTTTTCC TGAATTTCGC CATGTTCATC
    GTGGTGGTGG TGCAGATCTG TGGCAGGAAC GGCAAGAGAA GCAACCGCAC GCTGCGCGAA
    GAGGTCTTAA GGAACCTGCG CAGTGTGGTC AGCCTGACGT TTCTGCTGGG CATGACGTGG
    GGTTTTGCTT TCTTCGCCTG GGGACCCTTA AATGTCGCTT TCATGTACCT CTTCTCCATC
    TTCAATTCAT TACAAGGCTT GTTTATATTT GTCTTCCACT GCGCCATGAA GGAGAATGTC
    CAGAAGCAGT GGAGGCGGCA TCTCTGCTGC GGGAGGTTTC GGTTAGCGGA CAACTCAGAC
    TGGAGTAAGA CAGCTACCAA TATCATCAAG AAGAGTTCTG ACAATCTCGG AAAATCTTTG
    TCCTCAAGTT CCATTGGTTC CAACTCCACC TACCTTACAT CCAAATCGAA GTCCAGCTCC
    ACAACCTACT TCAAGAGGAA CAGCCACACT GACAGTGCTT CCACGGACAA GCCCTCCTCC
    AAGCTGACCC ATGCTGACGG AGAGCAGACG TCAATCATTC CTGTCCATCA AGTCCTTGAT
    AAGGTCAAGG GTTATTGCAA TGCTCATTCA GACAACTTCT ATAAAAATAT TATCATGTCA
    GACTCCTTCA GCCACAGCAC AAAGTTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014710358.1
    CDS218..3967
    Translation

    Target ORF information:

    RefSeq Version XM_014854872.1
    Organism Equus asinus(ass)
    Definition Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014854872.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTACCCT CAGGCCGAAT GTGGAGCTGT CACTGGAAAT GGAAGCCAAG TTCTCTTTTG 
    TTCTTCTTTG CTTTATATAT CGTCTGTGTT CCTCACTCAG TGTGGGGATG TGCCAGCTGC
    AGGCTTATCC TCTCCAACCC TTCTGGGGCC TTCACTTCTC CCTGCTACCC TAACGACTAC
    CCTAACAGCC AGGCTTGCAT GTGGACCCTC CGAGCCCCCA CCGGCTATAT CATTCAGATA
    ACGTTTAATG ACTTTGACAT CGAAGAAGCT CCCAATTGCA TTTATGATGC ATTATCCCTT
    GATAATGGAG AGAGCCAGAC TAAATTTTGT GGAGCAACTG CCAAAGGCCT GTCATTTAAC
    TCAAGTGCGA ATGAGATGCA TGTGTCCTTT TCAAGTGACT TCAGCATCCA GAAGAAAGGT
    TTCAATGCCA GCTACATCAG AGTTGCCGTG TCCTTAAGGA ATCAAAAGGT CGTTTTACCC
    CTGACGCTAG ATGCTCACCA GGTGTCTGTC GCAAAAAGCG TCTCTATTCC AGAGCTCAGC
    GCTTTCACAC TCTGTTTTGA AGCAACCAAA ATTGGCAAGG AAGACACTGA ATGGATAGCT
    TTCTCCTACT CAAATGCATC CTTCACACAA TTGCTCAGTT TTGGAAAGGC CAAGGATGGC
    TATTTTCTAT CTGTTTCTGA CTCAAGATGC TTCCTGAGCA ACGTGTTACC TGTAAAGGAT
    AAAGAAGACA TTTTCACAGA AAGCTTCGAG CAGCTCTGCG TCGTTTGGGA TAATTCTCTG
    GGCTCCGTTG GTGTAAATTT CAAAAGAAAC TATGAAGCTG TTCCCTGCGA TTCTACCATT
    AGTAAAGTTA TTCCAGGGAA TGGGAGATTG CTGTTGGGCT CCGATCAAAG TGAAATTGCC
    TCTCTAAAAG GGGACATTTA TAACTTTCGA CTTTGGAATT TTACCATGAA TTCCAAAACC
    CTGGCCAACC TCAGCTGCAG TGTGAAAGGG AATGTGGTCG ACTGGCAGAA TGACTTCTGG
    AACATCCCAA CCGTAGCTCT GAAGGCTGAG AGCAACCTAA GCTGTGGTTC CTACCTGATC
    CCGCTCCCGG CAGCAGAACT GGCCAGCTGT GCAGACCTGG GGACCCTCTG CAGAGCTACT
    GTAAACTCTC CTTGTACTAC ACCACCCACT GTCACCACTA ACATGCCTGT TACTAATAGA
    ATCGGTAAAC AAAGCAATGA TGGAATTGCC TATAGAATTT CCATAGTGAT TCAAAACGTA
    CTTCGTCACC CAGAGGTCAA AGTACAGAGC AAGGTGGCAG AATGGCTCAA TTCAACCTTC
    CAAAATTGGA ACTACACTGT TTATGTGGTT AATATCAGTT TTCACCTGAG CACGGGAGAG
    GACAAGATTA AAGTCAAGAG AAGCCTTGTG ATTGATCAAA GGTTCGTGAT TTGGGCACTT
    CTAATTTACA ATGCAACCAA CAACCCCAGT TTAGAAGGAG AAGTCATTCA GCAGAAGCTC
    TTAAAAAACA ACGAGTCCCT GGACGAGGGG TTGAGGCTGT ACACGGTGAA TGTGAGGCAG
    CTGGGTATAT GTGCTGGTGA GGAGAACCCC AAAGGCTATC AGTGGCCGAC CATCTCCCCT
    TCGGAATACA AGCATCCCTG TCTAGAGAAG CAGGGGTTTT ATGCCTCACG GACATGTCAT
    CCTGCCCCTA ACAGCACCTC TTCAGCCTAC TGGGGGACCC CTGACCTCTC CAATTGTTCA
    AAGGAGGCAA ATGAAGTTGC CAATCAGATT TTAAATTTAA CTGGTGATGG GCAGACCTTA
    AACTCAGCCA ATATCACCAG CATTGTGGAA CAGGTCAGGA GGATTGTAAA TAAAGAAGAA
    AACATTGATA TAACGCTTGG CTCGACTTTA ATGAATATAT TTTCTAATAT CTTAACCAGT
    CCAGACAGTG ACTTGCTCGA GTCTTCTTCT GAAGCTTTAA AAACAATTGA TGAATTGGCC
    TTCAAGATAG ACCTAAGCAG CACATCACAT GTGAATATCA CAACGCGGAA TTTGGCTCTT
    GGAGTGTCAT CCCTGTCCCC AGGGACCAAT GAAATTTCGA ATTTTAGCAT TGGTCTTCCA
    AGCAATAATG AATCCTATTT CCAGATGGAT TTTGCGAGTG AACAGATGGA TCCATTGGCT
    TCTGTAATGT TGCCTCCAAA CTTACTTGAG AATTTAAGTC AAGAAGATTC TGTGTTAGTT
    AAAAGAGTAC AGTTTACTTT CTTCAATAAA ACTGGACTTT TTCAGGGTGT GGAAACCAAG
    AAAGGCACCT TAGTGAGTTA TGTAATGGCA TGCAGTATTG GAAACATTAC TATCCAGGGT
    CTGAAGGATC CTGTTCGAAT TAAAATCAAG CATGCGAGAA GCCAGGCTGT GCATCATCCC
    GTCTGTGCCT TCTGGGATCT GGACAATGGT GAAGCTTCTG GATTTTGGAA CACATCAGGA
    TGTGTTACAC AAGGACATTC AGATGCAAGC GAGACGGTCT GCCTCTGTAA CCACCTCACA
    CACTTCGGAG TTCTGATGGA CCTTCAAGGA ACCGCCTCAC AGATGGATGC AAGAAACACC
    AGAATTCTCA CCTTCCTCAC CTATATTGGG TGCGGAATAT CTGCTATCTT TTCAGCAACT
    ACGCTCCTGA CGTATGTTGC TTTTGAAAAA TTGCGAAGGG ATTATCCCTC CAAAATCTTG
    ATGAACCTAA GTACGGCCCT GCTGTTCCTG AATCTCATCT TCCTCTTGGA CGGCTGGATC
    ACCTCGTTTC ACGTAGATGG TCTTTGCACG GCAGTGGCTG CCCTGCTGCA TTTCTTCCTT
    CTGGCAACCT TTACCTGGAT GGGGCTGGAA GCAATTCACA TGTACATTGC TCTTGTGAAA
    GTATTTAACA CTTACATCCG CCGATACATA CTGAAATTCT GCATCATTGG CTGGGGTTTG
    CCTGCCTTGG TCGTGTCAAT TGTTCTAGCA AGCAGAAAGC AAAATGAAGT CTATGGAAAA
    GAAAGTTATG GAAAAGAACA AGGTGACGAA TTCTGTTGGA TTCAGGATCC AGTCGTGTTT
    TATGTGACCT GTGCCGGGTA TTTTGGAGTC ATGTTTTTCC TGAATTTCGC CATGTTCATC
    GTGGTGGTGG TGCAGATCTG TGGCAGGAAC GGCAAGAGAA GCAACCGCAC GCTGCGCGAA
    GAGGTCTTAA GGAACCTGCG CAGTGTGGTC AGCCTGACGT TTCTGCTGGG CATGACGTGG
    GGTTTTGCTT TCTTCGCCTG GGGACCCTTA AATGTCGCTT TCATGTACCT CTTCTCCATC
    TTCAATTCAT TACAAGGCTT GTTTATATTT GTCTTCCACT GCGCCATGAA GGAGAATGTC
    CAGAAGCAGT GGAGGCGGCA TCTCTGCTGC GGGAGGTTTC GGTTAGCGGA CAACTCAGAC
    TGGAGTAAGA CAGCTACCAA TATCATCAAG AAGAGTTCTG ACAATCTCGG AAAATCTTTG
    TCCTCAAGTT CCATTGGTTC CAACTCCACC TACCTTACAT CCAAATCGAA GTCCAGCTCC
    ACAACCTACT TCAAGAGGAA CAGCCACACT GACAGTGCTT CCACGGACAA GCCCTCCTCC
    AAGCTGACCC ATGCTGACGG AGAGCAGACG TCAATCATTC CTGTCCATCA AGTCCTTGAT
    AAGGTCAAGG GTTATTGCAA TGCTCATTCA GACAACTTCT ATAAAAATAT TATCATGTCA
    GACTCCTTCA GCCACAGCAC AAAGTTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq17456
    Clone ID Related Accession (Same CDS sequence) XM_014854872.1 , XM_014854871.1
    Accession Version XM_014854871.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3750bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product G-protein coupled receptor 126 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638112.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTACCCT CAGGCCGAAT GTGGAGCTGT CACTGGAAAT GGAAGCCAAG TTCTCTTTTG 
    TTCTTCTTTG CTTTATATAT CGTCTGTGTT CCTCACTCAG TGTGGGGATG TGCCAGCTGC
    AGGCTTATCC TCTCCAACCC TTCTGGGGCC TTCACTTCTC CCTGCTACCC TAACGACTAC
    CCTAACAGCC AGGCTTGCAT GTGGACCCTC CGAGCCCCCA CCGGCTATAT CATTCAGATA
    ACGTTTAATG ACTTTGACAT CGAAGAAGCT CCCAATTGCA TTTATGATGC ATTATCCCTT
    GATAATGGAG AGAGCCAGAC TAAATTTTGT GGAGCAACTG CCAAAGGCCT GTCATTTAAC
    TCAAGTGCGA ATGAGATGCA TGTGTCCTTT TCAAGTGACT TCAGCATCCA GAAGAAAGGT
    TTCAATGCCA GCTACATCAG AGTTGCCGTG TCCTTAAGGA ATCAAAAGGT CGTTTTACCC
    CTGACGCTAG ATGCTCACCA GGTGTCTGTC GCAAAAAGCG TCTCTATTCC AGAGCTCAGC
    GCTTTCACAC TCTGTTTTGA AGCAACCAAA ATTGGCAAGG AAGACACTGA ATGGATAGCT
    TTCTCCTACT CAAATGCATC CTTCACACAA TTGCTCAGTT TTGGAAAGGC CAAGGATGGC
    TATTTTCTAT CTGTTTCTGA CTCAAGATGC TTCCTGAGCA ACGTGTTACC TGTAAAGGAT
    AAAGAAGACA TTTTCACAGA AAGCTTCGAG CAGCTCTGCG TCGTTTGGGA TAATTCTCTG
    GGCTCCGTTG GTGTAAATTT CAAAAGAAAC TATGAAGCTG TTCCCTGCGA TTCTACCATT
    AGTAAAGTTA TTCCAGGGAA TGGGAGATTG CTGTTGGGCT CCGATCAAAG TGAAATTGCC
    TCTCTAAAAG GGGACATTTA TAACTTTCGA CTTTGGAATT TTACCATGAA TTCCAAAACC
    CTGGCCAACC TCAGCTGCAG TGTGAAAGGG AATGTGGTCG ACTGGCAGAA TGACTTCTGG
    AACATCCCAA CCGTAGCTCT GAAGGCTGAG AGCAACCTAA GCTGTGGTTC CTACCTGATC
    CCGCTCCCGG CAGCAGAACT GGCCAGCTGT GCAGACCTGG GGACCCTCTG CAGAGCTACT
    GTAAACTCTC CTTGTACTAC ACCACCCACT GTCACCACTA ACATGCCTGT TACTAATAGA
    ATCGGTAAAC AAAGCAATGA TGGAATTGCC TATAGAATTT CCATAGTGAT TCAAAACGTA
    CTTCGTCACC CAGAGGTCAA AGTACAGAGC AAGGTGGCAG AATGGCTCAA TTCAACCTTC
    CAAAATTGGA ACTACACTGT TTATGTGGTT AATATCAGTT TTCACCTGAG CACGGGAGAG
    GACAAGATTA AAGTCAAGAG AAGCCTTGTG ATTGATCAAA GGTTCGTGAT TTGGGCACTT
    CTAATTTACA ATGCAACCAA CAACCCCAGT TTAGAAGGAG AAGTCATTCA GCAGAAGCTC
    TTAAAAAACA ACGAGTCCCT GGACGAGGGG TTGAGGCTGT ACACGGTGAA TGTGAGGCAG
    CTGGGTATAT GTGCTGGTGA GGAGAACCCC AAAGGCTATC AGTGGCCGAC CATCTCCCCT
    TCGGAATACA AGCATCCCTG TCTAGAGAAG CAGGGGTTTT ATGCCTCACG GACATGTCAT
    CCTGCCCCTA ACAGCACCTC TTCAGCCTAC TGGGGGACCC CTGACCTCTC CAATTGTTCA
    AAGGAGGCAA ATGAAGTTGC CAATCAGATT TTAAATTTAA CTGGTGATGG GCAGACCTTA
    AACTCAGCCA ATATCACCAG CATTGTGGAA CAGGTCAGGA GGATTGTAAA TAAAGAAGAA
    AACATTGATA TAACGCTTGG CTCGACTTTA ATGAATATAT TTTCTAATAT CTTAACCAGT
    CCAGACAGTG ACTTGCTCGA GTCTTCTTCT GAAGCTTTAA AAACAATTGA TGAATTGGCC
    TTCAAGATAG ACCTAAGCAG CACATCACAT GTGAATATCA CAACGCGGAA TTTGGCTCTT
    GGAGTGTCAT CCCTGTCCCC AGGGACCAAT GAAATTTCGA ATTTTAGCAT TGGTCTTCCA
    AGCAATAATG AATCCTATTT CCAGATGGAT TTTGCGAGTG AACAGATGGA TCCATTGGCT
    TCTGTAATGT TGCCTCCAAA CTTACTTGAG AATTTAAGTC AAGAAGATTC TGTGTTAGTT
    AAAAGAGTAC AGTTTACTTT CTTCAATAAA ACTGGACTTT TTCAGGGTGT GGAAACCAAG
    AAAGGCACCT TAGTGAGTTA TGTAATGGCA TGCAGTATTG GAAACATTAC TATCCAGGGT
    CTGAAGGATC CTGTTCGAAT TAAAATCAAG CATGCGAGAA GCCAGGCTGT GCATCATCCC
    GTCTGTGCCT TCTGGGATCT GGACAATGGT GAAGCTTCTG GATTTTGGAA CACATCAGGA
    TGTGTTACAC AAGGACATTC AGATGCAAGC GAGACGGTCT GCCTCTGTAA CCACCTCACA
    CACTTCGGAG TTCTGATGGA CCTTCAAGGA ACCGCCTCAC AGATGGATGC AAGAAACACC
    AGAATTCTCA CCTTCCTCAC CTATATTGGG TGCGGAATAT CTGCTATCTT TTCAGCAACT
    ACGCTCCTGA CGTATGTTGC TTTTGAAAAA TTGCGAAGGG ATTATCCCTC CAAAATCTTG
    ATGAACCTAA GTACGGCCCT GCTGTTCCTG AATCTCATCT TCCTCTTGGA CGGCTGGATC
    ACCTCGTTTC ACGTAGATGG TCTTTGCACG GCAGTGGCTG CCCTGCTGCA TTTCTTCCTT
    CTGGCAACCT TTACCTGGAT GGGGCTGGAA GCAATTCACA TGTACATTGC TCTTGTGAAA
    GTATTTAACA CTTACATCCG CCGATACATA CTGAAATTCT GCATCATTGG CTGGGGTTTG
    CCTGCCTTGG TCGTGTCAAT TGTTCTAGCA AGCAGAAAGC AAAATGAAGT CTATGGAAAA
    GAAAGTTATG GAAAAGAACA AGGTGACGAA TTCTGTTGGA TTCAGGATCC AGTCGTGTTT
    TATGTGACCT GTGCCGGGTA TTTTGGAGTC ATGTTTTTCC TGAATTTCGC CATGTTCATC
    GTGGTGGTGG TGCAGATCTG TGGCAGGAAC GGCAAGAGAA GCAACCGCAC GCTGCGCGAA
    GAGGTCTTAA GGAACCTGCG CAGTGTGGTC AGCCTGACGT TTCTGCTGGG CATGACGTGG
    GGTTTTGCTT TCTTCGCCTG GGGACCCTTA AATGTCGCTT TCATGTACCT CTTCTCCATC
    TTCAATTCAT TACAAGGCTT GTTTATATTT GTCTTCCACT GCGCCATGAA GGAGAATGTC
    CAGAAGCAGT GGAGGCGGCA TCTCTGCTGC GGGAGGTTTC GGTTAGCGGA CAACTCAGAC
    TGGAGTAAGA CAGCTACCAA TATCATCAAG AAGAGTTCTG ACAATCTCGG AAAATCTTTG
    TCCTCAAGTT CCATTGGTTC CAACTCCACC TACCTTACAT CCAAATCGAA GTCCAGCTCC
    ACAACCTACT TCAAGAGGAA CAGCCACACT GACAGTGCTT CCACGGACAA GCCCTCCTCC
    AAGCTGACCC ATGCTGACGG AGAGCAGACG TCAATCATTC CTGTCCATCA AGTCCTTGAT
    AAGGTCAAGG GTTATTGCAA TGCTCATTCA GACAACTTCT ATAAAAATAT TATCATGTCA
    GACTCCTTCA GCCACAGCAC AAAGTTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014710357.1
    CDS212..3961
    Translation

    Target ORF information:

    RefSeq Version XM_014854871.1
    Organism Equus asinus(ass)
    Definition Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014854871.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTACCCT CAGGCCGAAT GTGGAGCTGT CACTGGAAAT GGAAGCCAAG TTCTCTTTTG 
    TTCTTCTTTG CTTTATATAT CGTCTGTGTT CCTCACTCAG TGTGGGGATG TGCCAGCTGC
    AGGCTTATCC TCTCCAACCC TTCTGGGGCC TTCACTTCTC CCTGCTACCC TAACGACTAC
    CCTAACAGCC AGGCTTGCAT GTGGACCCTC CGAGCCCCCA CCGGCTATAT CATTCAGATA
    ACGTTTAATG ACTTTGACAT CGAAGAAGCT CCCAATTGCA TTTATGATGC ATTATCCCTT
    GATAATGGAG AGAGCCAGAC TAAATTTTGT GGAGCAACTG CCAAAGGCCT GTCATTTAAC
    TCAAGTGCGA ATGAGATGCA TGTGTCCTTT TCAAGTGACT TCAGCATCCA GAAGAAAGGT
    TTCAATGCCA GCTACATCAG AGTTGCCGTG TCCTTAAGGA ATCAAAAGGT CGTTTTACCC
    CTGACGCTAG ATGCTCACCA GGTGTCTGTC GCAAAAAGCG TCTCTATTCC AGAGCTCAGC
    GCTTTCACAC TCTGTTTTGA AGCAACCAAA ATTGGCAAGG AAGACACTGA ATGGATAGCT
    TTCTCCTACT CAAATGCATC CTTCACACAA TTGCTCAGTT TTGGAAAGGC CAAGGATGGC
    TATTTTCTAT CTGTTTCTGA CTCAAGATGC TTCCTGAGCA ACGTGTTACC TGTAAAGGAT
    AAAGAAGACA TTTTCACAGA AAGCTTCGAG CAGCTCTGCG TCGTTTGGGA TAATTCTCTG
    GGCTCCGTTG GTGTAAATTT CAAAAGAAAC TATGAAGCTG TTCCCTGCGA TTCTACCATT
    AGTAAAGTTA TTCCAGGGAA TGGGAGATTG CTGTTGGGCT CCGATCAAAG TGAAATTGCC
    TCTCTAAAAG GGGACATTTA TAACTTTCGA CTTTGGAATT TTACCATGAA TTCCAAAACC
    CTGGCCAACC TCAGCTGCAG TGTGAAAGGG AATGTGGTCG ACTGGCAGAA TGACTTCTGG
    AACATCCCAA CCGTAGCTCT GAAGGCTGAG AGCAACCTAA GCTGTGGTTC CTACCTGATC
    CCGCTCCCGG CAGCAGAACT GGCCAGCTGT GCAGACCTGG GGACCCTCTG CAGAGCTACT
    GTAAACTCTC CTTGTACTAC ACCACCCACT GTCACCACTA ACATGCCTGT TACTAATAGA
    ATCGGTAAAC AAAGCAATGA TGGAATTGCC TATAGAATTT CCATAGTGAT TCAAAACGTA
    CTTCGTCACC CAGAGGTCAA AGTACAGAGC AAGGTGGCAG AATGGCTCAA TTCAACCTTC
    CAAAATTGGA ACTACACTGT TTATGTGGTT AATATCAGTT TTCACCTGAG CACGGGAGAG
    GACAAGATTA AAGTCAAGAG AAGCCTTGTG ATTGATCAAA GGTTCGTGAT TTGGGCACTT
    CTAATTTACA ATGCAACCAA CAACCCCAGT TTAGAAGGAG AAGTCATTCA GCAGAAGCTC
    TTAAAAAACA ACGAGTCCCT GGACGAGGGG TTGAGGCTGT ACACGGTGAA TGTGAGGCAG
    CTGGGTATAT GTGCTGGTGA GGAGAACCCC AAAGGCTATC AGTGGCCGAC CATCTCCCCT
    TCGGAATACA AGCATCCCTG TCTAGAGAAG CAGGGGTTTT ATGCCTCACG GACATGTCAT
    CCTGCCCCTA ACAGCACCTC TTCAGCCTAC TGGGGGACCC CTGACCTCTC CAATTGTTCA
    AAGGAGGCAA ATGAAGTTGC CAATCAGATT TTAAATTTAA CTGGTGATGG GCAGACCTTA
    AACTCAGCCA ATATCACCAG CATTGTGGAA CAGGTCAGGA GGATTGTAAA TAAAGAAGAA
    AACATTGATA TAACGCTTGG CTCGACTTTA ATGAATATAT TTTCTAATAT CTTAACCAGT
    CCAGACAGTG ACTTGCTCGA GTCTTCTTCT GAAGCTTTAA AAACAATTGA TGAATTGGCC
    TTCAAGATAG ACCTAAGCAG CACATCACAT GTGAATATCA CAACGCGGAA TTTGGCTCTT
    GGAGTGTCAT CCCTGTCCCC AGGGACCAAT GAAATTTCGA ATTTTAGCAT TGGTCTTCCA
    AGCAATAATG AATCCTATTT CCAGATGGAT TTTGCGAGTG AACAGATGGA TCCATTGGCT
    TCTGTAATGT TGCCTCCAAA CTTACTTGAG AATTTAAGTC AAGAAGATTC TGTGTTAGTT
    AAAAGAGTAC AGTTTACTTT CTTCAATAAA ACTGGACTTT TTCAGGGTGT GGAAACCAAG
    AAAGGCACCT TAGTGAGTTA TGTAATGGCA TGCAGTATTG GAAACATTAC TATCCAGGGT
    CTGAAGGATC CTGTTCGAAT TAAAATCAAG CATGCGAGAA GCCAGGCTGT GCATCATCCC
    GTCTGTGCCT TCTGGGATCT GGACAATGGT GAAGCTTCTG GATTTTGGAA CACATCAGGA
    TGTGTTACAC AAGGACATTC AGATGCAAGC GAGACGGTCT GCCTCTGTAA CCACCTCACA
    CACTTCGGAG TTCTGATGGA CCTTCAAGGA ACCGCCTCAC AGATGGATGC AAGAAACACC
    AGAATTCTCA CCTTCCTCAC CTATATTGGG TGCGGAATAT CTGCTATCTT TTCAGCAACT
    ACGCTCCTGA CGTATGTTGC TTTTGAAAAA TTGCGAAGGG ATTATCCCTC CAAAATCTTG
    ATGAACCTAA GTACGGCCCT GCTGTTCCTG AATCTCATCT TCCTCTTGGA CGGCTGGATC
    ACCTCGTTTC ACGTAGATGG TCTTTGCACG GCAGTGGCTG CCCTGCTGCA TTTCTTCCTT
    CTGGCAACCT TTACCTGGAT GGGGCTGGAA GCAATTCACA TGTACATTGC TCTTGTGAAA
    GTATTTAACA CTTACATCCG CCGATACATA CTGAAATTCT GCATCATTGG CTGGGGTTTG
    CCTGCCTTGG TCGTGTCAAT TGTTCTAGCA AGCAGAAAGC AAAATGAAGT CTATGGAAAA
    GAAAGTTATG GAAAAGAACA AGGTGACGAA TTCTGTTGGA TTCAGGATCC AGTCGTGTTT
    TATGTGACCT GTGCCGGGTA TTTTGGAGTC ATGTTTTTCC TGAATTTCGC CATGTTCATC
    GTGGTGGTGG TGCAGATCTG TGGCAGGAAC GGCAAGAGAA GCAACCGCAC GCTGCGCGAA
    GAGGTCTTAA GGAACCTGCG CAGTGTGGTC AGCCTGACGT TTCTGCTGGG CATGACGTGG
    GGTTTTGCTT TCTTCGCCTG GGGACCCTTA AATGTCGCTT TCATGTACCT CTTCTCCATC
    TTCAATTCAT TACAAGGCTT GTTTATATTT GTCTTCCACT GCGCCATGAA GGAGAATGTC
    CAGAAGCAGT GGAGGCGGCA TCTCTGCTGC GGGAGGTTTC GGTTAGCGGA CAACTCAGAC
    TGGAGTAAGA CAGCTACCAA TATCATCAAG AAGAGTTCTG ACAATCTCGG AAAATCTTTG
    TCCTCAAGTT CCATTGGTTC CAACTCCACC TACCTTACAT CCAAATCGAA GTCCAGCTCC
    ACAACCTACT TCAAGAGGAA CAGCCACACT GACAGTGCTT CCACGGACAA GCCCTCCTCC
    AAGCTGACCC ATGCTGACGG AGAGCAGACG TCAATCATTC CTGTCCATCA AGTCCTTGAT
    AAGGTCAAGG GTTATTGCAA TGCTCATTCA GACAACTTCT ATAAAAATAT TATCATGTCA
    GACTCCTTCA GCCACAGCAC AAAGTTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq17457
    Clone ID Related Accession (Same CDS sequence) XM_014854873.1
    Accession Version XM_014854873.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3669bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product G-protein coupled receptor 126 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638112.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGAT
    GGAATTGCCT ATAGAATTTC CATAGTGATT CAAAACGTAC TTCGTCACCC AGAGGTCAAA
    GTACAGAGCA AGGTGGCAGA ATGGCTCAAT TCAACCTTCC AAAATTGGAA CTACACTGTT
    TATGTGGTTA ATATCAGTTT TCACCTGAGC ACGGGAGAGG ACAAGATTAA AGTCAAGAGA
    AGCCTTGTGA TTGATCAAAG GTTCGTGATT TGGGCACTTC TAATTTACAA TGCAACCAAC
    AACCCCAGTT TAGAAGGAGA AGTCATTCAG CAGAAGCTCT TAAAAAACAA CGAGTCCCTG
    GACGAGGGGT TGAGGCTGTA CACGGTGAAT GTGAGGCAGC TGGGTATATG TGCTGGTGAG
    GAGAACCCCA AAGGCTATCA GTGGCCGACC ATCTCCCCTT CGGAATACAA GCATCCCTGT
    CTAGAGAAGC AGGGGTTTTA TGCCTCACGG ACATGTCATC CTGCCCCTAA CAGCACCTCT
    TCAGCCTACT GGGGGACCCC TGACCTCTCC AATTGTTCAA AGGAGGCAAA TGAAGTTGCC
    AATCAGATTT TAAATTTAAC TGGTGATGGG CAGACCTTAA ACTCAGCCAA TATCACCAGC
    ATTGTGGAAC AGGTCAGGAG GATTGTAAAT AAAGAAGAAA ACATTGATAT AACGCTTGGC
    TCGACTTTAA TGAATATATT TTCTAATATC TTAACCAGTC CAGACAGTGA CTTGCTCGAG
    TCTTCTTCTG AAGCTTTAAA AACAATTGAT GAATTGGCCT TCAAGATAGA CCTAAGCAGC
    ACATCACATG TGAATATCAC AACGCGGAAT TTGGCTCTTG GAGTGTCATC CCTGTCCCCA
    GGGACCAATG AAATTTCGAA TTTTAGCATT GGTCTTCCAA GCAATAATGA ATCCTATTTC
    CAGATGGATT TTGCGAGTGA ACAGATGGAT CCATTGGCTT CTGTAATGTT GCCTCCAAAC
    TTACTTGAGA ATTTAAGTCA AGAAGATTCT GTGTTAGTTA AAAGAGTACA GTTTACTTTC
    TTCAATAAAA CTGGACTTTT TCAGGGTGTG GAAACCAAGA AAGGCACCTT AGTGAGTTAT
    GTAATGGCAT GCAGTATTGG AAACATTACT ATCCAGGGTC TGAAGGATCC TGTTCGAATT
    AAAATCAAGC ATGCGAGAAG CCAGGCTGTG CATCATCCCG TCTGTGCCTT CTGGGATCTG
    GACAATGGTG AAGCTTCTGG ATTTTGGAAC ACATCAGGAT GTGTTACACA AGGACATTCA
    GATGCAAGCG AGACGGTCTG CCTCTGTAAC CACCTCACAC ACTTCGGAGT TCTGATGGAC
    CTTCAAGGAA CCGCCTCACA GATGGATGCA AGAAACACCA GAATTCTCAC CTTCCTCACC
    TATATTGGGT GCGGAATATC TGCTATCTTT TCAGCAACTA CGCTCCTGAC GTATGTTGCT
    TTTGAAAAAT TGCGAAGGGA TTATCCCTCC AAAATCTTGA TGAACCTAAG TACGGCCCTG
    CTGTTCCTGA ATCTCATCTT CCTCTTGGAC GGCTGGATCA CCTCGTTTCA CGTAGATGGT
    CTTTGCACGG CAGTGGCTGC CCTGCTGCAT TTCTTCCTTC TGGCAACCTT TACCTGGATG
    GGGCTGGAAG CAATTCACAT GTACATTGCT CTTGTGAAAG TATTTAACAC TTACATCCGC
    CGATACATAC TGAAATTCTG CATCATTGGC TGGGGTTTGC CTGCCTTGGT CGTGTCAATT
    GTTCTAGCAA GCAGAAAGCA AAATGAAGTC TATGGAAAAG AAAGTTATGG AAAAGAACAA
    GGTGACGAAT TCTGTTGGAT TCAGGATCCA GTCGTGTTTT ATGTGACCTG TGCCGGGTAT
    TTTGGAGTCA TGTTTTTCCT GAATTTCGCC ATGTTCATCG TGGTGGTGGT GCAGATCTGT
    GGCAGGAACG GCAAGAGAAG CAACCGCACG CTGCGCGAAG AGGTCTTAAG GAACCTGCGC
    AGTGTGGTCA GCCTGACGTT TCTGCTGGGC ATGACGTGGG GTTTTGCTTT CTTCGCCTGG
    GGACCCTTAA ATGTCGCTTT CATGTACCTC TTCTCCATCT TCAATTCATT ACAAGGCTTG
    TTTATATTTG TCTTCCACTG CGCCATGAAG GAGAATGTCC AGAAGCAGTG GAGGCGGCAT
    CTCTGCTGCG GGAGGTTTCG GTTAGCGGAC AACTCAGACT GGAGTAAGAC AGCTACCAAT
    ATCATCAAGA AGAGTTCTGA CAATCTCGGA AAATCTTTGT CCTCAAGTTC CATTGGTTCC
    AACTCCACCT ACCTTACATC CAAATCGAAG TCCAGCTCCA CAACCTACTT CAAGAGGAAC
    AGCCACACTG ACAGTGCTTC CACGGACAAG CCCTCCTCCA AGCTGACCCA TGCTGACGGA
    GAGCAGACGT CAATCATTCC TGTCCATCAA GTCCTTGATA AGGTCAAGGG TTATTGCAAT
    GCTCATTCAG ACAACTTCTA TAAAAATATT ATCATGTCAG ACTCCTTCAG CCACAGCACA
    AAGTTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014710359.1
    CDS224..3892
    Translation

    Target ORF information:

    RefSeq Version XM_014854873.1
    Organism Equus asinus(ass)
    Definition Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014854873.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGAT
    GGAATTGCCT ATAGAATTTC CATAGTGATT CAAAACGTAC TTCGTCACCC AGAGGTCAAA
    GTACAGAGCA AGGTGGCAGA ATGGCTCAAT TCAACCTTCC AAAATTGGAA CTACACTGTT
    TATGTGGTTA ATATCAGTTT TCACCTGAGC ACGGGAGAGG ACAAGATTAA AGTCAAGAGA
    AGCCTTGTGA TTGATCAAAG GTTCGTGATT TGGGCACTTC TAATTTACAA TGCAACCAAC
    AACCCCAGTT TAGAAGGAGA AGTCATTCAG CAGAAGCTCT TAAAAAACAA CGAGTCCCTG
    GACGAGGGGT TGAGGCTGTA CACGGTGAAT GTGAGGCAGC TGGGTATATG TGCTGGTGAG
    GAGAACCCCA AAGGCTATCA GTGGCCGACC ATCTCCCCTT CGGAATACAA GCATCCCTGT
    CTAGAGAAGC AGGGGTTTTA TGCCTCACGG ACATGTCATC CTGCCCCTAA CAGCACCTCT
    TCAGCCTACT GGGGGACCCC TGACCTCTCC AATTGTTCAA AGGAGGCAAA TGAAGTTGCC
    AATCAGATTT TAAATTTAAC TGGTGATGGG CAGACCTTAA ACTCAGCCAA TATCACCAGC
    ATTGTGGAAC AGGTCAGGAG GATTGTAAAT AAAGAAGAAA ACATTGATAT AACGCTTGGC
    TCGACTTTAA TGAATATATT TTCTAATATC TTAACCAGTC CAGACAGTGA CTTGCTCGAG
    TCTTCTTCTG AAGCTTTAAA AACAATTGAT GAATTGGCCT TCAAGATAGA CCTAAGCAGC
    ACATCACATG TGAATATCAC AACGCGGAAT TTGGCTCTTG GAGTGTCATC CCTGTCCCCA
    GGGACCAATG AAATTTCGAA TTTTAGCATT GGTCTTCCAA GCAATAATGA ATCCTATTTC
    CAGATGGATT TTGCGAGTGA ACAGATGGAT CCATTGGCTT CTGTAATGTT GCCTCCAAAC
    TTACTTGAGA ATTTAAGTCA AGAAGATTCT GTGTTAGTTA AAAGAGTACA GTTTACTTTC
    TTCAATAAAA CTGGACTTTT TCAGGGTGTG GAAACCAAGA AAGGCACCTT AGTGAGTTAT
    GTAATGGCAT GCAGTATTGG AAACATTACT ATCCAGGGTC TGAAGGATCC TGTTCGAATT
    AAAATCAAGC ATGCGAGAAG CCAGGCTGTG CATCATCCCG TCTGTGCCTT CTGGGATCTG
    GACAATGGTG AAGCTTCTGG ATTTTGGAAC ACATCAGGAT GTGTTACACA AGGACATTCA
    GATGCAAGCG AGACGGTCTG CCTCTGTAAC CACCTCACAC ACTTCGGAGT TCTGATGGAC
    CTTCAAGGAA CCGCCTCACA GATGGATGCA AGAAACACCA GAATTCTCAC CTTCCTCACC
    TATATTGGGT GCGGAATATC TGCTATCTTT TCAGCAACTA CGCTCCTGAC GTATGTTGCT
    TTTGAAAAAT TGCGAAGGGA TTATCCCTCC AAAATCTTGA TGAACCTAAG TACGGCCCTG
    CTGTTCCTGA ATCTCATCTT CCTCTTGGAC GGCTGGATCA CCTCGTTTCA CGTAGATGGT
    CTTTGCACGG CAGTGGCTGC CCTGCTGCAT TTCTTCCTTC TGGCAACCTT TACCTGGATG
    GGGCTGGAAG CAATTCACAT GTACATTGCT CTTGTGAAAG TATTTAACAC TTACATCCGC
    CGATACATAC TGAAATTCTG CATCATTGGC TGGGGTTTGC CTGCCTTGGT CGTGTCAATT
    GTTCTAGCAA GCAGAAAGCA AAATGAAGTC TATGGAAAAG AAAGTTATGG AAAAGAACAA
    GGTGACGAAT TCTGTTGGAT TCAGGATCCA GTCGTGTTTT ATGTGACCTG TGCCGGGTAT
    TTTGGAGTCA TGTTTTTCCT GAATTTCGCC ATGTTCATCG TGGTGGTGGT GCAGATCTGT
    GGCAGGAACG GCAAGAGAAG CAACCGCACG CTGCGCGAAG AGGTCTTAAG GAACCTGCGC
    AGTGTGGTCA GCCTGACGTT TCTGCTGGGC ATGACGTGGG GTTTTGCTTT CTTCGCCTGG
    GGACCCTTAA ATGTCGCTTT CATGTACCTC TTCTCCATCT TCAATTCATT ACAAGGCTTG
    TTTATATTTG TCTTCCACTG CGCCATGAAG GAGAATGTCC AGAAGCAGTG GAGGCGGCAT
    CTCTGCTGCG GGAGGTTTCG GTTAGCGGAC AACTCAGACT GGAGTAAGAC AGCTACCAAT
    ATCATCAAGA AGAGTTCTGA CAATCTCGGA AAATCTTTGT CCTCAAGTTC CATTGGTTCC
    AACTCCACCT ACCTTACATC CAAATCGAAG TCCAGCTCCA CAACCTACTT CAAGAGGAAC
    AGCCACACTG ACAGTGCTTC CACGGACAAG CCCTCCTCCA AGCTGACCCA TGCTGACGGA
    GAGCAGACGT CAATCATTCC TGTCCATCAA GTCCTTGATA AGGTCAAGGG TTATTGCAAT
    GCTCATTCAG ACAACTTCTA TAAAAATATT ATCATGTCAG ACTCCTTCAG CCACAGCACA
    AAGTTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq17458
    Clone ID Related Accession (Same CDS sequence) XM_014854874.1
    Accession Version XM_014854874.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3588bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product G-protein coupled receptor 126 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638112.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGCT
    ACTGTAAACT CTCCTTGTAC TACACCACCC ACTGTCACCA CTAACATGCC TGTTACTAAT
    AGAATCGGTA AACAAAGCAA TGATGGAATT GCCTATAGAA TTTCCATAGT GATTCAAAAC
    GTACTTCGTC ACCCAGAGGT CAAAGTACAG AGCAAGGTGG CAGAATGGCT CAATTCAACC
    TTCCAAAATT GGAACTACAC TGTTTATGTG GTTAATATCA GTTTTCACCT GAGCACGGGA
    GAGGACAAGA TTAAAGTCAA GAGAAGCCTT GTGATTGATC AAAGGTTCGT GATTTGGGCA
    CTTCTAATTT ACAATGCAAC CAACAACCCC AGTTTAGAAG GAGAAGTCAT TCAGCAGAAG
    CTCTTAAAAA ACAACGAGTC CCTGGACGAG GGGTTGAGGC TGTACACGGT GAATGTGAGG
    CAGCTGGGTA TATGTGCTGG TGAGGAGAAC CCCAAAGGCT ATCAGTGGCC GACCATCTCC
    CCTTCGGAAT ACAAGCATCC CTGTCTAGAG AAGCAGGGGT TTTATGCCTC ACGGACATGT
    CATCCTGCCC CTAACAGCAC CTCTTCAGCC TACTGGGGGA CCCCTGACCT CTCCAATTGT
    TCAAAGGAGG CAAATGAAGT TGCCAATCAG ATTTTAAATT TAACTGGTGA TGGGCAGACC
    TTAAACTCAG CCAATATCAC CAGCATTGTG GAACAGGTCA GGAGGATTGT AAATAAAGAA
    GAAAACATTG ATATAACGCT TGGCTCGACT TTAATGAATA TATTTTCTAA TATCTTAACC
    AGTCCAGACA GTGACTTGCT CGAGTCTTCT TCTGAAGCTT TAAAAACAAT TGATGAATTG
    GCCTTCAAGA TAGACCTAAG CAGCACATCA CATGTGAATA TCACAACGCG GAATTTGGCT
    CTTGGAGTGT CATCCCTGTC CCCAGGGACC AATGAAATTT CGAATTTTAG CATTGGTCTT
    CCAAGCAATA ATGAATCCTA TTTCCAGATG GATTTTGCGA GTGAACAGAT GGATCCATTG
    GCTTCTGTAA TGTTGCCTCC AAACTTACTT GAGAATTTAA GTCAAGAAGA TTCTGTGTTA
    GTTAAAAGAG TACAGTTTAC TTTCTTCAAT AAAACTGGAC TTTTTCAGGG TGTGGAAACC
    AAGAAAGGCA CCTTAGTGAG TTATGTAATG GCATGCAGTA TTGGAAACAT TACTATCCAG
    GGTCTGAAGG ATCCTGTTCG AATTAAAATC AAGCATGCGA GAAGCCAGGC TGTGCATCAT
    CCCGTCTGTG CCTTCTGGGA TCTGGACAAT GGTGAAGCTT CTGGATTTTG GAACACATCA
    GGATGTGTTA CACAAGGACA TTCAGATGCA AGCGAGACGG TCTGCCTCTG TAACCACCTC
    ACACACTTCG GAGTTCTGAT GGACCTTCAA GGAACCGCCT CACAGATGGA TGCAAGAAAC
    ACCAGAATTC TCACCTTCCT CACCTATATT GGGTGCGGAA TATCTGCTAT CTTTTCAGCA
    ACTACGCTCC TGACGTATGT TGCTTTTGAA AAATTGCGAA GGGATTATCC CTCCAAAATC
    TTGATGAACC TAAGTACGGC CCTGCTGTTC CTGAATCTCA TCTTCCTCTT GGACGGCTGG
    ATCACCTCGT TTCACGTAGA TGGTCTTTGC ACGGCAGTGG CTGCCCTGCT GCATTTCTTC
    CTTCTGGCAA CCTTTACCTG GATGGGGCTG GAAGCAATTC ACATGTACAT TGCTCTTGTG
    AAAGTATTTA ACACTTACAT CCGCCGATAC ATACTGAAAT TCTGCATCAT TGGCTGGGGT
    TTGCCTGCCT TGGTCGTGTC AATTGTTCTA GCAAGCAGAA AGCAAAATGA AGTCTATGGA
    AAAGAAAGTT ATGGAAAAGA ACAAGGTGAC GAATTCTGTT GGATTCAGGA TCCAGTCGTG
    TTTTATGTGA CCTGTGCCGG GTATTTTGGA GTCATGTTTT TCCTGAATTT CGCCATGTTC
    ATCGTGGTGG TGGTGCAGAT CTGTGGCAGG AACGGCAAGA GAAGCAACCG CACGCTGCGC
    GAAGAGGTCT TAAGGAACCT GCGCAGTGTG GTCAGCCTGA CGTTTCTGCT GGGCATGACG
    TGGGGTTTTG CTTTCTTCGC CTGGGGACCC TTAAATGTCG CTTTCATGTA CCTCTTCTCC
    ATCTTCAATT CATTACAAGG CTTGTTTATA TTTGTCTTCC ACTGCGCCAT GAAGGAGAAT
    GTCCAGAAGC AGTGGAGGCG GCATCTCTGC TGCGGGAGGT TTCGGTTAGC GGACAACTCA
    GACTGGAGTA AGACAGCTAC CAATATCATC AAGAAGAGTT CTGACAATCT CGGAAAATCT
    TTGTCCTCAA GTTCCATTGG TTCCAACTCC ACCTACCTTA CATCCAAATC GAAGTCCAGC
    TCCACAACCT ACTTCAAGAG GAACAGCCAC ACTGATAATG TCTTCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014710360.1
    CDS224..3811
    Translation

    Target ORF information:

    RefSeq Version XM_014854874.1
    Organism Equus asinus(ass)
    Definition Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014854874.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGCT
    ACTGTAAACT CTCCTTGTAC TACACCACCC ACTGTCACCA CTAACATGCC TGTTACTAAT
    AGAATCGGTA AACAAAGCAA TGATGGAATT GCCTATAGAA TTTCCATAGT GATTCAAAAC
    GTACTTCGTC ACCCAGAGGT CAAAGTACAG AGCAAGGTGG CAGAATGGCT CAATTCAACC
    TTCCAAAATT GGAACTACAC TGTTTATGTG GTTAATATCA GTTTTCACCT GAGCACGGGA
    GAGGACAAGA TTAAAGTCAA GAGAAGCCTT GTGATTGATC AAAGGTTCGT GATTTGGGCA
    CTTCTAATTT ACAATGCAAC CAACAACCCC AGTTTAGAAG GAGAAGTCAT TCAGCAGAAG
    CTCTTAAAAA ACAACGAGTC CCTGGACGAG GGGTTGAGGC TGTACACGGT GAATGTGAGG
    CAGCTGGGTA TATGTGCTGG TGAGGAGAAC CCCAAAGGCT ATCAGTGGCC GACCATCTCC
    CCTTCGGAAT ACAAGCATCC CTGTCTAGAG AAGCAGGGGT TTTATGCCTC ACGGACATGT
    CATCCTGCCC CTAACAGCAC CTCTTCAGCC TACTGGGGGA CCCCTGACCT CTCCAATTGT
    TCAAAGGAGG CAAATGAAGT TGCCAATCAG ATTTTAAATT TAACTGGTGA TGGGCAGACC
    TTAAACTCAG CCAATATCAC CAGCATTGTG GAACAGGTCA GGAGGATTGT AAATAAAGAA
    GAAAACATTG ATATAACGCT TGGCTCGACT TTAATGAATA TATTTTCTAA TATCTTAACC
    AGTCCAGACA GTGACTTGCT CGAGTCTTCT TCTGAAGCTT TAAAAACAAT TGATGAATTG
    GCCTTCAAGA TAGACCTAAG CAGCACATCA CATGTGAATA TCACAACGCG GAATTTGGCT
    CTTGGAGTGT CATCCCTGTC CCCAGGGACC AATGAAATTT CGAATTTTAG CATTGGTCTT
    CCAAGCAATA ATGAATCCTA TTTCCAGATG GATTTTGCGA GTGAACAGAT GGATCCATTG
    GCTTCTGTAA TGTTGCCTCC AAACTTACTT GAGAATTTAA GTCAAGAAGA TTCTGTGTTA
    GTTAAAAGAG TACAGTTTAC TTTCTTCAAT AAAACTGGAC TTTTTCAGGG TGTGGAAACC
    AAGAAAGGCA CCTTAGTGAG TTATGTAATG GCATGCAGTA TTGGAAACAT TACTATCCAG
    GGTCTGAAGG ATCCTGTTCG AATTAAAATC AAGCATGCGA GAAGCCAGGC TGTGCATCAT
    CCCGTCTGTG CCTTCTGGGA TCTGGACAAT GGTGAAGCTT CTGGATTTTG GAACACATCA
    GGATGTGTTA CACAAGGACA TTCAGATGCA AGCGAGACGG TCTGCCTCTG TAACCACCTC
    ACACACTTCG GAGTTCTGAT GGACCTTCAA GGAACCGCCT CACAGATGGA TGCAAGAAAC
    ACCAGAATTC TCACCTTCCT CACCTATATT GGGTGCGGAA TATCTGCTAT CTTTTCAGCA
    ACTACGCTCC TGACGTATGT TGCTTTTGAA AAATTGCGAA GGGATTATCC CTCCAAAATC
    TTGATGAACC TAAGTACGGC CCTGCTGTTC CTGAATCTCA TCTTCCTCTT GGACGGCTGG
    ATCACCTCGT TTCACGTAGA TGGTCTTTGC ACGGCAGTGG CTGCCCTGCT GCATTTCTTC
    CTTCTGGCAA CCTTTACCTG GATGGGGCTG GAAGCAATTC ACATGTACAT TGCTCTTGTG
    AAAGTATTTA ACACTTACAT CCGCCGATAC ATACTGAAAT TCTGCATCAT TGGCTGGGGT
    TTGCCTGCCT TGGTCGTGTC AATTGTTCTA GCAAGCAGAA AGCAAAATGA AGTCTATGGA
    AAAGAAAGTT ATGGAAAAGA ACAAGGTGAC GAATTCTGTT GGATTCAGGA TCCAGTCGTG
    TTTTATGTGA CCTGTGCCGG GTATTTTGGA GTCATGTTTT TCCTGAATTT CGCCATGTTC
    ATCGTGGTGG TGGTGCAGAT CTGTGGCAGG AACGGCAAGA GAAGCAACCG CACGCTGCGC
    GAAGAGGTCT TAAGGAACCT GCGCAGTGTG GTCAGCCTGA CGTTTCTGCT GGGCATGACG
    TGGGGTTTTG CTTTCTTCGC CTGGGGACCC TTAAATGTCG CTTTCATGTA CCTCTTCTCC
    ATCTTCAATT CATTACAAGG CTTGTTTATA TTTGTCTTCC ACTGCGCCAT GAAGGAGAAT
    GTCCAGAAGC AGTGGAGGCG GCATCTCTGC TGCGGGAGGT TTCGGTTAGC GGACAACTCA
    GACTGGAGTA AGACAGCTAC CAATATCATC AAGAAGAGTT CTGACAATCT CGGAAAATCT
    TTGTCCTCAA GTTCCATTGG TTCCAACTCC ACCTACCTTA CATCCAAATC GAAGTCCAGC
    TCCACAACCT ACTTCAAGAG GAACAGCCAC ACTGATAATG TCTTCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq17459
    Clone ID Related Accession (Same CDS sequence) XM_014854875.1
    Accession Version XM_014854875.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3504bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product G-protein coupled receptor 126 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638112.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGAT
    GGAATTGCCT ATAGAATTTC CATAGTGATT CAAAACGTAC TTCGTCACCC AGAGGTCAAA
    GTACAGAGCA AGGTGGCAGA ATGGCTCAAT TCAACCTTCC AAAATTGGAA CTACACTGTT
    TATGTGGTTA ATATCAGTTT TCACCTGAGC ACGGGAGAGG ACAAGATTAA AGTCAAGAGA
    AGCCTTGTGA TTGATCAAAG GTTCGTGATT TGGGCACTTC TAATTTACAA TGCAACCAAC
    AACCCCAGTT TAGAAGGAGA AGTCATTCAG CAGAAGCTCT TAAAAAACAA CGAGTCCCTG
    GACGAGGGGT TGAGGCTGTA CACGGTGAAT GTGAGGCAGC TGGGTATATG TGCTGGTGAG
    GAGAACCCCA AAGGCTATCA GTGGCCGACC ATCTCCCCTT CGGAATACAA GCATCCCTGT
    CTAGAGAAGC AGGGGTTTTA TGCCTCACGG ACATGTCATC CTGCCCCTAA CAGCACCTCT
    TCAGCCTACT GGGGGACCCC TGACCTCTCC AATTGTTCAA AGGAGGCAAA TGAAGTTGCC
    AATCAGATTT TAAATTTAAC TGGTGATGGG CAGACCTTAA ACTCAGCCAA TATCACCAGC
    ATTGTGGAAC AGGTCAGGAG GATTGTAAAT AAAGAAGAAA ACATTGATAT AACGCTTGGC
    TCGACTTTAA TGAATATATT TTCTAATATC TTAACCAGTC CAGACAGTGA CTTGCTCGAG
    TCTTCTTCTG AAGCTTTAAA AACAATTGAT GAATTGGCCT TCAAGATAGA CCTAAGCAGC
    ACATCACATG TGAATATCAC AACGCGGAAT TTGGCTCTTG GAGTGTCATC CCTGTCCCCA
    GGGACCAATG AAATTTCGAA TTTTAGCATT GGTCTTCCAA GCAATAATGA ATCCTATTTC
    CAGATGGATT TTGCGAGTGA ACAGATGGAT CCATTGGCTT CTGTAATGTT GCCTCCAAAC
    TTACTTGAGA ATTTAAGTCA AGAAGATTCT GTGTTAGTTA AAAGAGTACA GTTTACTTTC
    TTCAATAAAA CTGGACTTTT TCAGGGTGTG GAAACCAAGA AAGGCACCTT AGTGAGTTAT
    GTAATGGCAT GCAGTATTGG AAACATTACT ATCCAGGGTC TGAAGGATCC TGTTCGAATT
    AAAATCAAGC ATGCGAGAAG CCAGGCTGTG CATCATCCCG TCTGTGCCTT CTGGGATCTG
    GACAATGGTG AAGCTTCTGG ATTTTGGAAC ACATCAGGAT GTGTTACACA AGGACATTCA
    GATGCAAGCG AGACGGTCTG CCTCTGTAAC CACCTCACAC ACTTCGGAGT TCTGATGGAC
    CTTCAAGGAA CCGCCTCACA GATGGATGCA AGAAACACCA GAATTCTCAC CTTCCTCACC
    TATATTGGGT GCGGAATATC TGCTATCTTT TCAGCAACTA CGCTCCTGAC GTATGTTGCT
    TTTGAAAAAT TGCGAAGGGA TTATCCCTCC AAAATCTTGA TGAACCTAAG TACGGCCCTG
    CTGTTCCTGA ATCTCATCTT CCTCTTGGAC GGCTGGATCA CCTCGTTTCA CGTAGATGGT
    CTTTGCACGG CAGTGGCTGC CCTGCTGCAT TTCTTCCTTC TGGCAACCTT TACCTGGATG
    GGGCTGGAAG CAATTCACAT GTACATTGCT CTTGTGAAAG TATTTAACAC TTACATCCGC
    CGATACATAC TGAAATTCTG CATCATTGGC TGGGGTTTGC CTGCCTTGGT CGTGTCAATT
    GTTCTAGCAA GCAGAAAGCA AAATGAAGTC TATGGAAAAG AAAGTTATGG AAAAGAACAA
    GGTGACGAAT TCTGTTGGAT TCAGGATCCA GTCGTGTTTT ATGTGACCTG TGCCGGGTAT
    TTTGGAGTCA TGTTTTTCCT GAATTTCGCC ATGTTCATCG TGGTGGTGGT GCAGATCTGT
    GGCAGGAACG GCAAGAGAAG CAACCGCACG CTGCGCGAAG AGGTCTTAAG GAACCTGCGC
    AGTGTGGTCA GCCTGACGTT TCTGCTGGGC ATGACGTGGG GTTTTGCTTT CTTCGCCTGG
    GGACCCTTAA ATGTCGCTTT CATGTACCTC TTCTCCATCT TCAATTCATT ACAAGGCTTG
    TTTATATTTG TCTTCCACTG CGCCATGAAG GAGAATGTCC AGAAGCAGTG GAGGCGGCAT
    CTCTGCTGCG GGAGGTTTCG GTTAGCGGAC AACTCAGACT GGAGTAAGAC AGCTACCAAT
    ATCATCAAGA AGAGTTCTGA CAATCTCGGA AAATCTTTGT CCTCAAGTTC CATTGGTTCC
    AACTCCACCT ACCTTACATC CAAATCGAAG TCCAGCTCCA CAACCTACTT CAAGAGGAAC
    AGCCACACTG ATAATGTCTT CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014710361.1
    CDS224..3727
    Translation

    Target ORF information:

    RefSeq Version XM_014854875.1
    Organism Equus asinus(ass)
    Definition Equus asinus adhesion G protein-coupled receptor G6 (ADGRG6), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014854875.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGATGCTAC CCTCAGGCCG AATGTGGAGC TGTCACTGGA AATGGAAGCC AAGTTCTCTT 
    TTGTTCTTCT TTGCTTTATA TATCGTCTGT GTTCCTCACT CAGTGTGGGG ATGTGCCAGC
    TGCAGGCTTA TCCTCTCCAA CCCTTCTGGG GCCTTCACTT CTCCCTGCTA CCCTAACGAC
    TACCCTAACA GCCAGGCTTG CATGTGGACC CTCCGAGCCC CCACCGGCTA TATCATTCAG
    ATAACGTTTA ATGACTTTGA CATCGAAGAA GCTCCCAATT GCATTTATGA TGCATTATCC
    CTTGATAATG GAGAGAGCCA GACTAAATTT TGTGGAGCAA CTGCCAAAGG CCTGTCATTT
    AACTCAAGTG CGAATGAGAT GCATGTGTCC TTTTCAAGTG ACTTCAGCAT CCAGAAGAAA
    GGTTTCAATG CCAGCTACAT CAGAGTTGCC GTGTCCTTAA GGAATCAAAA GGTCGTTTTA
    CCCCTGACGC TAGATGCTCA CCAGGTGTCT GTCGCAAAAA GCGTCTCTAT TCCAGAGCTC
    AGCGCTTTCA CACTCTGTTT TGAAGCAACC AAAATTGGCA AGGAAGACAC TGAATGGATA
    GCTTTCTCCT ACTCAAATGC ATCCTTCACA CAATTGCTCA GTTTTGGAAA GGCCAAGGAT
    GGCTATTTTC TATCTGTTTC TGACTCAAGA TGCTTCCTGA GCAACGTGTT ACCTGTAAAG
    GATAAAGAAG ACATTTTCAC AGAAAGCTTC GAGCAGCTCT GCGTCGTTTG GGATAATTCT
    CTGGGCTCCG TTGGTGTAAA TTTCAAAAGA AACTATGAAG CTGTTCCCTG CGATTCTACC
    ATTAGTAAAG TTATTCCAGG GAATGGGAGA TTGCTGTTGG GCTCCGATCA AAGTGAAATT
    GCCTCTCTAA AAGGGGACAT TTATAACTTT CGACTTTGGA ATTTTACCAT GAATTCCAAA
    ACCCTGGCCA ACCTCAGCTG CAGTGTGAAA GGGAATGTGG TCGACTGGCA GAATGACTTC
    TGGAACATCC CAACCGTAGC TCTGAAGGCT GAGAGCAACC TAAGCTGTGG TTCCTACCTG
    ATCCCGCTCC CGGCAGCAGA ACTGGCCAGC TGTGCAGACC TGGGGACCCT CTGCAGAGAT
    GGAATTGCCT ATAGAATTTC CATAGTGATT CAAAACGTAC TTCGTCACCC AGAGGTCAAA
    GTACAGAGCA AGGTGGCAGA ATGGCTCAAT TCAACCTTCC AAAATTGGAA CTACACTGTT
    TATGTGGTTA ATATCAGTTT TCACCTGAGC ACGGGAGAGG ACAAGATTAA AGTCAAGAGA
    AGCCTTGTGA TTGATCAAAG GTTCGTGATT TGGGCACTTC TAATTTACAA TGCAACCAAC
    AACCCCAGTT TAGAAGGAGA AGTCATTCAG CAGAAGCTCT TAAAAAACAA CGAGTCCCTG
    GACGAGGGGT TGAGGCTGTA CACGGTGAAT GTGAGGCAGC TGGGTATATG TGCTGGTGAG
    GAGAACCCCA AAGGCTATCA GTGGCCGACC ATCTCCCCTT CGGAATACAA GCATCCCTGT
    CTAGAGAAGC AGGGGTTTTA TGCCTCACGG ACATGTCATC CTGCCCCTAA CAGCACCTCT
    TCAGCCTACT GGGGGACCCC TGACCTCTCC AATTGTTCAA AGGAGGCAAA TGAAGTTGCC
    AATCAGATTT TAAATTTAAC TGGTGATGGG CAGACCTTAA ACTCAGCCAA TATCACCAGC
    ATTGTGGAAC AGGTCAGGAG GATTGTAAAT AAAGAAGAAA ACATTGATAT AACGCTTGGC
    TCGACTTTAA TGAATATATT TTCTAATATC TTAACCAGTC CAGACAGTGA CTTGCTCGAG
    TCTTCTTCTG AAGCTTTAAA AACAATTGAT GAATTGGCCT TCAAGATAGA CCTAAGCAGC
    ACATCACATG TGAATATCAC AACGCGGAAT TTGGCTCTTG GAGTGTCATC CCTGTCCCCA
    GGGACCAATG AAATTTCGAA TTTTAGCATT GGTCTTCCAA GCAATAATGA ATCCTATTTC
    CAGATGGATT TTGCGAGTGA ACAGATGGAT CCATTGGCTT CTGTAATGTT GCCTCCAAAC
    TTACTTGAGA ATTTAAGTCA AGAAGATTCT GTGTTAGTTA AAAGAGTACA GTTTACTTTC
    TTCAATAAAA CTGGACTTTT TCAGGGTGTG GAAACCAAGA AAGGCACCTT AGTGAGTTAT
    GTAATGGCAT GCAGTATTGG AAACATTACT ATCCAGGGTC TGAAGGATCC TGTTCGAATT
    AAAATCAAGC ATGCGAGAAG CCAGGCTGTG CATCATCCCG TCTGTGCCTT CTGGGATCTG
    GACAATGGTG AAGCTTCTGG ATTTTGGAAC ACATCAGGAT GTGTTACACA AGGACATTCA
    GATGCAAGCG AGACGGTCTG CCTCTGTAAC CACCTCACAC ACTTCGGAGT TCTGATGGAC
    CTTCAAGGAA CCGCCTCACA GATGGATGCA AGAAACACCA GAATTCTCAC CTTCCTCACC
    TATATTGGGT GCGGAATATC TGCTATCTTT TCAGCAACTA CGCTCCTGAC GTATGTTGCT
    TTTGAAAAAT TGCGAAGGGA TTATCCCTCC AAAATCTTGA TGAACCTAAG TACGGCCCTG
    CTGTTCCTGA ATCTCATCTT CCTCTTGGAC GGCTGGATCA CCTCGTTTCA CGTAGATGGT
    CTTTGCACGG CAGTGGCTGC CCTGCTGCAT TTCTTCCTTC TGGCAACCTT TACCTGGATG
    GGGCTGGAAG CAATTCACAT GTACATTGCT CTTGTGAAAG TATTTAACAC TTACATCCGC
    CGATACATAC TGAAATTCTG CATCATTGGC TGGGGTTTGC CTGCCTTGGT CGTGTCAATT
    GTTCTAGCAA GCAGAAAGCA AAATGAAGTC TATGGAAAAG AAAGTTATGG AAAAGAACAA
    GGTGACGAAT TCTGTTGGAT TCAGGATCCA GTCGTGTTTT ATGTGACCTG TGCCGGGTAT
    TTTGGAGTCA TGTTTTTCCT GAATTTCGCC ATGTTCATCG TGGTGGTGGT GCAGATCTGT
    GGCAGGAACG GCAAGAGAAG CAACCGCACG CTGCGCGAAG AGGTCTTAAG GAACCTGCGC
    AGTGTGGTCA GCCTGACGTT TCTGCTGGGC ATGACGTGGG GTTTTGCTTT CTTCGCCTGG
    GGACCCTTAA ATGTCGCTTT CATGTACCTC TTCTCCATCT TCAATTCATT ACAAGGCTTG
    TTTATATTTG TCTTCCACTG CGCCATGAAG GAGAATGTCC AGAAGCAGTG GAGGCGGCAT
    CTCTGCTGCG GGAGGTTTCG GTTAGCGGAC AACTCAGACT GGAGTAAGAC AGCTACCAAT
    ATCATCAAGA AGAGTTCTGA CAATCTCGGA AAATCTTTGT CCTCAAGTTC CATTGGTTCC
    AACTCCACCT ACCTTACATC CAAATCGAAG TCCAGCTCCA CAACCTACTT CAAGAGGAAC
    AGCCACACTG ATAATGTCTT CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.