LOC108657049 cDNA ORF clone, Drosophila navojoa

The following LOC108657049 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC108657049 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ODr337052 XM_030387491.1
Latest version!
Drosophila navojoa probable serine/threonine-protein kinase yakA (LOC108657049), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ODr337053 XM_030387492.1
Latest version!
Drosophila navojoa probable serine/threonine-protein kinase yakA (LOC108657049), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ODr253497 XM_018109501.1
Latest version!
Drosophila navojoa polyglutamine-repeat protein pqn-41 (LOC108657049), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ODr337052
    Clone ID Related Accession (Same CDS sequence) XM_030387491.1
    Accession Version XM_030387491.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3273bp)
    Protein sequence
    SNP
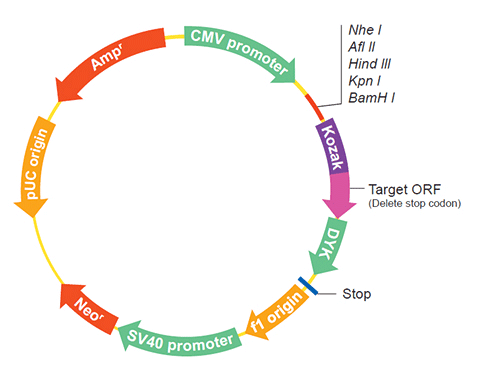
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
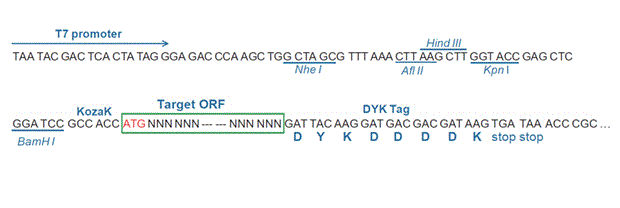
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product probable serine/threonine-protein kinase yakA isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046048.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGGAACCAG ATCCCAATGG GATAAAGATC GAACCAACAC TTGACCATCA CCAGCAGCAG 
    CAGCAACAGC AGCAACAGTA CGCAACACTT TTGGCAATAA ATGGCCCAAA TGCGCGCCTT
    CTTATCGAGC ATCCGTCAGC GCTGTTGGTA CCCCTATCGA CACATCAGCA ACAACAATTG
    CAATTGCAGC AGCACCAGCA ACAGCAGCAA CAGCAACAGC AGCAGCAGCA GCAACAACAG
    TTTCAGCAAC AGCAGCAACA GCAACAGCAT CATCTGCAGC AGCAACAATT TCATCAGCAA
    CAATTGCAAA TAACATTACC CGCTTACACA CAGCCGCTCT CGCTCAAGCA ACAGCCGCCA
    CCCACACCCC TGGGACCCAC CTCCTCGGTC AGCAACAGCA ATACGCAACA ACAGCAACAG
    CAGCCCCAAC AGCAACAACA ACAACAGCAG CAGCAACAAC CACACCATCA TCATCAACAT
    CAGCAGCGCT GGAACGAGAG TCCAGAGGCG AGACAACGGC GGTTGGCCCG CAATGCTGAG
    AGGATGCGCG AGAGACGTCA GCGTGAAAGT GAAGAAGAAT ATCGAAAACG TTTGATGCGT
    AACGCCGAAG CGAATCGCCA AAGGCGACAG AATGAATCAG ATTTGGAGCG GGCGATGCGA
    CTGGTGCGCA ATGCGGCCCG GCAGCGATTG CGACGGGCCA TGGAATCGCC GGATCAGCGA
    TCCAAACGTC TGGCCAAGCT GGCCGAACGG ATGCGCATGT ATCGGGCCAG TGAGACGGCC
    GATCAGCGCA AGGTACGGCT GGCTGAGATG GCCGCCCGGG CCAGGCAGCG CATTGCCAGC
    GAGTCGGCGG AGGAGCGGAA GGAAAGACTG AGAAAGCTGA ACGACTATGC GAAAAAGGTC
    AGAGAAAAGA AAAAGATATA CAAACAGGTG CAGGTGCATG TACAGAATTC GTCGTCGTCT
    TCATCGACCA ATTCGACCAA TTCCAATACA CTGACCGTTC AGCAGCAGCA GCAGCAACAG
    CAGCAGCAGC AACATCAACA GCAGCAGCAG GTGCTAGCAG TGGCAACTGC CGCTGCTGCC
    GCCGCCGCCG CCGCTGCAAA CGTAGCTGGC CAATCAGCCA ATTGTAATAA TGAGCATAAT
    ATTAATTTAA ATCAGGCAAA CGTCTCATCA GCGCCTGCCA ACAATGCCAC CACTACAAGC
    AGCAGCAGCA GCAACACCAC AACAGCGGCA GCAGCAACTG TTACCGCCGA CGATCAGCAT
    CTGGTGACAG CTGCACCGGC CTCGGCCTAT CAGCAGCATC AGGCCATCGA GTATATGGGC
    CAGAATATGT TTATAGCGCG ACCGACGATG CAGCTGAAAC AGGAGCCGCA ACAGCATCAG
    CAGCAGCAGC AGCAGCAGCA ACAACAGCAG CAACAGCAAC TGCAGCAGCA GCAGCAGCCG
    CGCTATTCGC TCGGCGCCCA GCAGCTGATC GATGGCGTTG CTGGTGGCAG TGGAGCCGCC
    GAGGCGGGAA GCATCTTTGT CCAACAGATC TATGGCGAGG AGCCGGGCAA AACCGGTAAA
    TTGCTGCAGG CGCATGTTCC GCACTTTAGC ATTGCCAATC AGCTCGAGTT CTATAAGCAG
    AAATACGCCA ATATGGTGGA ACTTCAGTCT GGCGAGGCGA ACGATAACAG CGGGTCTGTT
    ACACTGGGTC AGAACGAGGC CAAGGTGATT GTGGCCGCCG CCGAGCAGCA GCAGCAGCAG
    CAGCAGCAGA AGGTGCTCAA ACCTGGCTCA GCAGCGGCCG CTGCAGCCGC AGCCGCCGCA
    GCAGCAGCGG CAGCAACGAC CTCAACCACA ACCGGAACCC AGCTCTACAA TCAGCTGCCC
    TATTTGGCCA CATTTCCAGC GACGGCCAAT AGCAGCGGCG CCAGCGGCAC TGTGACGGTG
    GCGGGCGGCG GAGGTGGTGC GGCCGGTGCG GCCAATGGAT CGGCGGCAGC CAGTGCCACT
    GCTTACTATC CTATGTATCC GAATGGCTTC CAGCTGGGCA TCGGGCCGAA TACGGTGCCG
    CCGCCGTTTA CACCTGTGCA TTTCGCCAAT GCCAGCGGCG GGAGCAGTCC AACGGCGCCG
    GGACAATACA ATATACTGAC GACGCCCACC GGTGCGAATC CTACGCTAAC TGTCACCGGA
    CTGGGCCAGC AGCAGCAGCA GCAGGATCCG CAGCAGCAAC AGCAGCAGCA GCAGCAACAA
    CAGCAGCAGC AACAACAACA GCAACAGCAG CAGCAACAAC AGCAGCAGCA GCAGCAGCAA
    CAGCAACTGC TGCACGAATT CCCAAAAATG GGTCGAGGTC GTCCACGTAA GATTAGCCTG
    TTGACCAGCG AGGATCATCT GAAGGCGAAC ACGCTGCTGG AGCAGGAGTT GAATCAGATG
    CTCTCCGCAC CGCATTTGGG CTCGGGCATT GGAAGCGGAC GACGCGGACG TCCGCCGTTG
    CATCAAAGCC ATCATCATTT ACATCATGCA CATTCCACGG CAGATGGGGA TGGCTCTGCC
    ACGCCGCGAC GCAGCGGCGC CAACAAATAC GAGACGGAGG AGGAGAAGCG CATTCGGCTG
    GACAAAATGG CGGCGCATCA GCGTGCGGTG CGTGCGAATG AATCGCCCGA GCAACGGGCG
    GTGCGCCTGC AGAAGCTGAG CGAACGGGCG CGCCTCAAGC GTGCCCAGAT CCGTGCGACC
    GAGAACAATG AGGAGCGCAA GGAGCGGCTG TCCAAGCAGG CGGAATATGC TCGACTACGG
    CGCATGCGCA GCCATACGCC GCGCACCAGC AGCAGCGCCA GCGCCGAGTT CCATGGCAAG
    ACGGAGGATG ATACGGCGGA GCAGATGTAC GACAACGATA CAGATGGCGG AGATAGCTTT
    GTGCTGAAAT CGGACTCGCA GATGGATGAT GGCGATGCCG ATGATCAGGA CAAGCAGCTT
    CAACAATTGC AGCAGCAACA GCAGCAGCAG CAACAACAAC AGCAGCAACA GCAACAACAG
    CAGCAGCAAC ACGAGCTACA TCAGATGACG GGCAGCCTCC TGCAGCAGCC ACATCACGAG
    GCAATCGTCA TCAATCAGCA ACAGCAGCAG CAGCAGCAGC AGCGTCTGGT CAGCCTCAAT
    CAGCATCAGC AGAGCTACAG CAAGCTGCAG GCGGCAACGG CGACCAGTGC GAGCAGCGCT
    GCCGGCGGAG CAGGAGGCAA CGGAGCGGGC GCGCCTGAGA ATAATGATAT GCTAAAGATA
    CTCGAACCAA TAATTGTTAT GAAAACCAAA TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030243351.1
    CDS516..3788
    Translation

    Target ORF information:

    RefSeq Version XM_030387491.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa probable serine/threonine-protein kinase yakA (LOC108657049), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030387491.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGGAACCAG ATCCCAATGG GATAAAGATC GAACCAACAC TTGACCATCA CCAGCAGCAG 
    CAGCAACAGC AGCAACAGTA CGCAACACTT TTGGCAATAA ATGGCCCAAA TGCGCGCCTT
    CTTATCGAGC ATCCGTCAGC GCTGTTGGTA CCCCTATCGA CACATCAGCA ACAACAATTG
    CAATTGCAGC AGCACCAGCA ACAGCAGCAA CAGCAACAGC AGCAGCAGCA GCAACAACAG
    TTTCAGCAAC AGCAGCAACA GCAACAGCAT CATCTGCAGC AGCAACAATT TCATCAGCAA
    CAATTGCAAA TAACATTACC CGCTTACACA CAGCCGCTCT CGCTCAAGCA ACAGCCGCCA
    CCCACACCCC TGGGACCCAC CTCCTCGGTC AGCAACAGCA ATACGCAACA ACAGCAACAG
    CAGCCCCAAC AGCAACAACA ACAACAGCAG CAGCAACAAC CACACCATCA TCATCAACAT
    CAGCAGCGCT GGAACGAGAG TCCAGAGGCG AGACAACGGC GGTTGGCCCG CAATGCTGAG
    AGGATGCGCG AGAGACGTCA GCGTGAAAGT GAAGAAGAAT ATCGAAAACG TTTGATGCGT
    AACGCCGAAG CGAATCGCCA AAGGCGACAG AATGAATCAG ATTTGGAGCG GGCGATGCGA
    CTGGTGCGCA ATGCGGCCCG GCAGCGATTG CGACGGGCCA TGGAATCGCC GGATCAGCGA
    TCCAAACGTC TGGCCAAGCT GGCCGAACGG ATGCGCATGT ATCGGGCCAG TGAGACGGCC
    GATCAGCGCA AGGTACGGCT GGCTGAGATG GCCGCCCGGG CCAGGCAGCG CATTGCCAGC
    GAGTCGGCGG AGGAGCGGAA GGAAAGACTG AGAAAGCTGA ACGACTATGC GAAAAAGGTC
    AGAGAAAAGA AAAAGATATA CAAACAGGTG CAGGTGCATG TACAGAATTC GTCGTCGTCT
    TCATCGACCA ATTCGACCAA TTCCAATACA CTGACCGTTC AGCAGCAGCA GCAGCAACAG
    CAGCAGCAGC AACATCAACA GCAGCAGCAG GTGCTAGCAG TGGCAACTGC CGCTGCTGCC
    GCCGCCGCCG CCGCTGCAAA CGTAGCTGGC CAATCAGCCA ATTGTAATAA TGAGCATAAT
    ATTAATTTAA ATCAGGCAAA CGTCTCATCA GCGCCTGCCA ACAATGCCAC CACTACAAGC
    AGCAGCAGCA GCAACACCAC AACAGCGGCA GCAGCAACTG TTACCGCCGA CGATCAGCAT
    CTGGTGACAG CTGCACCGGC CTCGGCCTAT CAGCAGCATC AGGCCATCGA GTATATGGGC
    CAGAATATGT TTATAGCGCG ACCGACGATG CAGCTGAAAC AGGAGCCGCA ACAGCATCAG
    CAGCAGCAGC AGCAGCAGCA ACAACAGCAG CAACAGCAAC TGCAGCAGCA GCAGCAGCCG
    CGCTATTCGC TCGGCGCCCA GCAGCTGATC GATGGCGTTG CTGGTGGCAG TGGAGCCGCC
    GAGGCGGGAA GCATCTTTGT CCAACAGATC TATGGCGAGG AGCCGGGCAA AACCGGTAAA
    TTGCTGCAGG CGCATGTTCC GCACTTTAGC ATTGCCAATC AGCTCGAGTT CTATAAGCAG
    AAATACGCCA ATATGGTGGA ACTTCAGTCT GGCGAGGCGA ACGATAACAG CGGGTCTGTT
    ACACTGGGTC AGAACGAGGC CAAGGTGATT GTGGCCGCCG CCGAGCAGCA GCAGCAGCAG
    CAGCAGCAGA AGGTGCTCAA ACCTGGCTCA GCAGCGGCCG CTGCAGCCGC AGCCGCCGCA
    GCAGCAGCGG CAGCAACGAC CTCAACCACA ACCGGAACCC AGCTCTACAA TCAGCTGCCC
    TATTTGGCCA CATTTCCAGC GACGGCCAAT AGCAGCGGCG CCAGCGGCAC TGTGACGGTG
    GCGGGCGGCG GAGGTGGTGC GGCCGGTGCG GCCAATGGAT CGGCGGCAGC CAGTGCCACT
    GCTTACTATC CTATGTATCC GAATGGCTTC CAGCTGGGCA TCGGGCCGAA TACGGTGCCG
    CCGCCGTTTA CACCTGTGCA TTTCGCCAAT GCCAGCGGCG GGAGCAGTCC AACGGCGCCG
    GGACAATACA ATATACTGAC GACGCCCACC GGTGCGAATC CTACGCTAAC TGTCACCGGA
    CTGGGCCAGC AGCAGCAGCA GCAGGATCCG CAGCAGCAAC AGCAGCAGCA GCAGCAACAA
    CAGCAGCAGC AACAACAACA GCAACAGCAG CAGCAACAAC AGCAGCAGCA GCAGCAGCAA
    CAGCAACTGC TGCACGAATT CCCAAAAATG GGTCGAGGTC GTCCACGTAA GATTAGCCTG
    TTGACCAGCG AGGATCATCT GAAGGCGAAC ACGCTGCTGG AGCAGGAGTT GAATCAGATG
    CTCTCCGCAC CGCATTTGGG CTCGGGCATT GGAAGCGGAC GACGCGGACG TCCGCCGTTG
    CATCAAAGCC ATCATCATTT ACATCATGCA CATTCCACGG CAGATGGGGA TGGCTCTGCC
    ACGCCGCGAC GCAGCGGCGC CAACAAATAC GAGACGGAGG AGGAGAAGCG CATTCGGCTG
    GACAAAATGG CGGCGCATCA GCGTGCGGTG CGTGCGAATG AATCGCCCGA GCAACGGGCG
    GTGCGCCTGC AGAAGCTGAG CGAACGGGCG CGCCTCAAGC GTGCCCAGAT CCGTGCGACC
    GAGAACAATG AGGAGCGCAA GGAGCGGCTG TCCAAGCAGG CGGAATATGC TCGACTACGG
    CGCATGCGCA GCCATACGCC GCGCACCAGC AGCAGCGCCA GCGCCGAGTT CCATGGCAAG
    ACGGAGGATG ATACGGCGGA GCAGATGTAC GACAACGATA CAGATGGCGG AGATAGCTTT
    GTGCTGAAAT CGGACTCGCA GATGGATGAT GGCGATGCCG ATGATCAGGA CAAGCAGCTT
    CAACAATTGC AGCAGCAACA GCAGCAGCAG CAACAACAAC AGCAGCAACA GCAACAACAG
    CAGCAGCAAC ACGAGCTACA TCAGATGACG GGCAGCCTCC TGCAGCAGCC ACATCACGAG
    GCAATCGTCA TCAATCAGCA ACAGCAGCAG CAGCAGCAGC AGCGTCTGGT CAGCCTCAAT
    CAGCATCAGC AGAGCTACAG CAAGCTGCAG GCGGCAACGG CGACCAGTGC GAGCAGCGCT
    GCCGGCGGAG CAGGAGGCAA CGGAGCGGGC GCGCCTGAGA ATAATGATAT GCTAAAGATA
    CTCGAACCAA TAATTGTTAT GAAAACCAAA TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr337053
    Clone ID Related Accession (Same CDS sequence) XM_030387492.1
    Accession Version XM_030387492.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3015bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product probable serine/threonine-protein kinase yakA isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046048.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    ATGGAACCAG ATCCCAATGG GATAAAGATC GAACCAACAC TTGACCATCA CCAGCAGCAG 
    CAGCAACAGC AGCAACAGTA CGCAACACTT TTGGCAATAA ATGGCCCAAA TGCGCGCCTT
    CTTATCGAGC ATCCGTCAGC GCTGTTGGTA CCCCTATCGA CACATCAGCA ACAACAATTG
    CAATTGCAGC AGCACCAGCA ACAGCAGCAA CAGCAACAGC AGCAGCAGCA GCAACAACAG
    TTTCAGCAAC AGCAGCAACA GCAACAGCAT CATCTGCAGC AGCAACAATT TCATCAGCAA
    CAATTGCAAA TAACATTACC CGCTTACACA CAGCCGCTCT CGCTCAAGCA ACAGCCGCCA
    CCCACACCCC TGGGACCCAC CTCCTCGGTC AGCAACAGCA ATACGCAACA ACAGCAACAG
    CAGCCCCAAC AGCAACAACA ACAACAGCAG CAGCAACAAC CACACCATCA TCATCAACAT
    CAGCAGCGCT GGAACGAGAG TCCAGAGGCG AGACAACGGC GGTTGGCCCG CAATGCTGAG
    AGGATGCGCG AGAGACGTCA GCGTGAAAGT GAAGAAGAAT ATCGAAAACG TTTGATGCGT
    AACGCCGAAG CGAATCGCCA AAGGCGACAG AATGAATCAG ATTTGGAGCG GGCGATGCGA
    CTGGTGCGCA ATGCGGCCCG GCAGCGATTG CGACGGGCCA TGGAATCGCC GGATCAGCGA
    TCCAAACGTC TGGCCAAGCT GGCCGAACGG ATGCGCATGT ATCGGGCCAG TGAGACGGCC
    GATCAGCGCA AGGTACGGCT GGCTGAGATG GCCGCCCGGG CCAGGCAGCG CATTGCCAGC
    GAGTCGGCGG AGGAGCGGAA GGAAAGACTG AGAAAGCTGA ACGACTATGC GAAAAAGGCA
    AACGTCTCAT CAGCGCCTGC CAACAATGCC ACCACTACAA GCAGCAGCAG CAGCAACACC
    ACAACAGCGG CAGCAGCAAC TGTTACCGCC GACGATCAGC ATCTGGTGAC AGCTGCACCG
    GCCTCGGCCT ATCAGCAGCA TCAGGCCATC GAGTATATGG GCCAGAATAT GTTTATAGCG
    CGACCGACGA TGCAGCTGAA ACAGGAGCCG CAACAGCATC AGCAGCAGCA GCAGCAGCAG
    CAACAACAGC AGCAACAGCA ACTGCAGCAG CAGCAGCAGC CGCGCTATTC GCTCGGCGCC
    CAGCAGCTGA TCGATGGCGT TGCTGGTGGC AGTGGAGCCG CCGAGGCGGG AAGCATCTTT
    GTCCAACAGA TCTATGGCGA GGAGCCGGGC AAAACCGGTA AATTGCTGCA GGCGCATGTT
    CCGCACTTTA GCATTGCCAA TCAGCTCGAG TTCTATAAGC AGAAATACGC CAATATGGTG
    GAACTTCAGT CTGGCGAGGC GAACGATAAC AGCGGGTCTG TTACACTGGG TCAGAACGAG
    GCCAAGGTGA TTGTGGCCGC CGCCGAGCAG CAGCAGCAGC AGCAGCAGCA GAAGGTGCTC
    AAACCTGGCT CAGCAGCGGC CGCTGCAGCC GCAGCCGCCG CAGCAGCAGC GGCAGCAACG
    ACCTCAACCA CAACCGGAAC CCAGCTCTAC AATCAGCTGC CCTATTTGGC CACATTTCCA
    GCGACGGCCA ATAGCAGCGG CGCCAGCGGC ACTGTGACGG TGGCGGGCGG CGGAGGTGGT
    GCGGCCGGTG CGGCCAATGG ATCGGCGGCA GCCAGTGCCA CTGCTTACTA TCCTATGTAT
    CCGAATGGCT TCCAGCTGGG CATCGGGCCG AATACGGTGC CGCCGCCGTT TACACCTGTG
    CATTTCGCCA ATGCCAGCGG CGGGAGCAGT CCAACGGCGC CGGGACAATA CAATATACTG
    ACGACGCCCA CCGGTGCGAA TCCTACGCTA ACTGTCACCG GACTGGGCCA GCAGCAGCAG
    CAGCAGGATC CGCAGCAGCA ACAGCAGCAG CAGCAGCAAC AACAGCAGCA GCAACAACAA
    CAGCAACAGC AGCAGCAACA ACAGCAGCAG CAGCAGCAGC AACAGCAACT GCTGCACGAA
    TTCCCAAAAA TGGGTCGAGG TCGTCCACGT AAGATTAGCC TGTTGACCAG CGAGGATCAT
    CTGAAGGCGA ACACGCTGCT GGAGCAGGAG TTGAATCAGA TGCTCTCCGC ACCGCATTTG
    GGCTCGGGCA TTGGAAGCGG ACGACGCGGA CGTCCGCCGT TGCATCAAAG CCATCATCAT
    TTACATCATG CACATTCCAC GGCAGATGGG GATGGCTCTG CCACGCCGCG ACGCAGCGGC
    GCCAACAAAT ACGAGACGGA GGAGGAGAAG CGCATTCGGC TGGACAAAAT GGCGGCGCAT
    CAGCGTGCGG TGCGTGCGAA TGAATCGCCC GAGCAACGGG CGGTGCGCCT GCAGAAGCTG
    AGCGAACGGG CGCGCCTCAA GCGTGCCCAG ATCCGTGCGA CCGAGAACAA TGAGGAGCGC
    AAGGAGCGGC TGTCCAAGCA GGCGGAATAT GCTCGACTAC GGCGCATGCG CAGCCATACG
    CCGCGCACCA GCAGCAGCGC CAGCGCCGAG TTCCATGGCA AGACGGAGGA TGATACGGCG
    GAGCAGATGT ACGACAACGA TACAGATGGC GGAGATAGCT TTGTGCTGAA ATCGGACTCG
    CAGATGGATG ATGGCGATGC CGATGATCAG GACAAGCAGC TTCAACAATT GCAGCAGCAA
    CAGCAGCAGC AGCAACAACA ACAGCAGCAA CAGCAACAAC AGCAGCAGCA ACACGAGCTA
    CATCAGATGA CGGGCAGCCT CCTGCAGCAG CCACATCACG AGGCAATCGT CATCAATCAG
    CAACAGCAGC AGCAGCAGCA GCAGCGTCTG GTCAGCCTCA ATCAGCATCA GCAGAGCTAC
    AGCAAGCTGC AGGCGGCAAC GGCGACCAGT GCGAGCAGCG CTGCCGGCGG AGCAGGAGGC
    AACGGAGCGG GCGCGCCTGA GAATAATGAT ATGCTAAAGA TACTCGAACC AATAATTGTT
    ATGAAAACCA AATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030243352.1
    CDS516..3530
    Translation

    Target ORF information:

    RefSeq Version XM_030387492.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa probable serine/threonine-protein kinase yakA (LOC108657049), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030387492.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    ATGGAACCAG ATCCCAATGG GATAAAGATC GAACCAACAC TTGACCATCA CCAGCAGCAG 
    CAGCAACAGC AGCAACAGTA CGCAACACTT TTGGCAATAA ATGGCCCAAA TGCGCGCCTT
    CTTATCGAGC ATCCGTCAGC GCTGTTGGTA CCCCTATCGA CACATCAGCA ACAACAATTG
    CAATTGCAGC AGCACCAGCA ACAGCAGCAA CAGCAACAGC AGCAGCAGCA GCAACAACAG
    TTTCAGCAAC AGCAGCAACA GCAACAGCAT CATCTGCAGC AGCAACAATT TCATCAGCAA
    CAATTGCAAA TAACATTACC CGCTTACACA CAGCCGCTCT CGCTCAAGCA ACAGCCGCCA
    CCCACACCCC TGGGACCCAC CTCCTCGGTC AGCAACAGCA ATACGCAACA ACAGCAACAG
    CAGCCCCAAC AGCAACAACA ACAACAGCAG CAGCAACAAC CACACCATCA TCATCAACAT
    CAGCAGCGCT GGAACGAGAG TCCAGAGGCG AGACAACGGC GGTTGGCCCG CAATGCTGAG
    AGGATGCGCG AGAGACGTCA GCGTGAAAGT GAAGAAGAAT ATCGAAAACG TTTGATGCGT
    AACGCCGAAG CGAATCGCCA AAGGCGACAG AATGAATCAG ATTTGGAGCG GGCGATGCGA
    CTGGTGCGCA ATGCGGCCCG GCAGCGATTG CGACGGGCCA TGGAATCGCC GGATCAGCGA
    TCCAAACGTC TGGCCAAGCT GGCCGAACGG ATGCGCATGT ATCGGGCCAG TGAGACGGCC
    GATCAGCGCA AGGTACGGCT GGCTGAGATG GCCGCCCGGG CCAGGCAGCG CATTGCCAGC
    GAGTCGGCGG AGGAGCGGAA GGAAAGACTG AGAAAGCTGA ACGACTATGC GAAAAAGGCA
    AACGTCTCAT CAGCGCCTGC CAACAATGCC ACCACTACAA GCAGCAGCAG CAGCAACACC
    ACAACAGCGG CAGCAGCAAC TGTTACCGCC GACGATCAGC ATCTGGTGAC AGCTGCACCG
    GCCTCGGCCT ATCAGCAGCA TCAGGCCATC GAGTATATGG GCCAGAATAT GTTTATAGCG
    CGACCGACGA TGCAGCTGAA ACAGGAGCCG CAACAGCATC AGCAGCAGCA GCAGCAGCAG
    CAACAACAGC AGCAACAGCA ACTGCAGCAG CAGCAGCAGC CGCGCTATTC GCTCGGCGCC
    CAGCAGCTGA TCGATGGCGT TGCTGGTGGC AGTGGAGCCG CCGAGGCGGG AAGCATCTTT
    GTCCAACAGA TCTATGGCGA GGAGCCGGGC AAAACCGGTA AATTGCTGCA GGCGCATGTT
    CCGCACTTTA GCATTGCCAA TCAGCTCGAG TTCTATAAGC AGAAATACGC CAATATGGTG
    GAACTTCAGT CTGGCGAGGC GAACGATAAC AGCGGGTCTG TTACACTGGG TCAGAACGAG
    GCCAAGGTGA TTGTGGCCGC CGCCGAGCAG CAGCAGCAGC AGCAGCAGCA GAAGGTGCTC
    AAACCTGGCT CAGCAGCGGC CGCTGCAGCC GCAGCCGCCG CAGCAGCAGC GGCAGCAACG
    ACCTCAACCA CAACCGGAAC CCAGCTCTAC AATCAGCTGC CCTATTTGGC CACATTTCCA
    GCGACGGCCA ATAGCAGCGG CGCCAGCGGC ACTGTGACGG TGGCGGGCGG CGGAGGTGGT
    GCGGCCGGTG CGGCCAATGG ATCGGCGGCA GCCAGTGCCA CTGCTTACTA TCCTATGTAT
    CCGAATGGCT TCCAGCTGGG CATCGGGCCG AATACGGTGC CGCCGCCGTT TACACCTGTG
    CATTTCGCCA ATGCCAGCGG CGGGAGCAGT CCAACGGCGC CGGGACAATA CAATATACTG
    ACGACGCCCA CCGGTGCGAA TCCTACGCTA ACTGTCACCG GACTGGGCCA GCAGCAGCAG
    CAGCAGGATC CGCAGCAGCA ACAGCAGCAG CAGCAGCAAC AACAGCAGCA GCAACAACAA
    CAGCAACAGC AGCAGCAACA ACAGCAGCAG CAGCAGCAGC AACAGCAACT GCTGCACGAA
    TTCCCAAAAA TGGGTCGAGG TCGTCCACGT AAGATTAGCC TGTTGACCAG CGAGGATCAT
    CTGAAGGCGA ACACGCTGCT GGAGCAGGAG TTGAATCAGA TGCTCTCCGC ACCGCATTTG
    GGCTCGGGCA TTGGAAGCGG ACGACGCGGA CGTCCGCCGT TGCATCAAAG CCATCATCAT
    TTACATCATG CACATTCCAC GGCAGATGGG GATGGCTCTG CCACGCCGCG ACGCAGCGGC
    GCCAACAAAT ACGAGACGGA GGAGGAGAAG CGCATTCGGC TGGACAAAAT GGCGGCGCAT
    CAGCGTGCGG TGCGTGCGAA TGAATCGCCC GAGCAACGGG CGGTGCGCCT GCAGAAGCTG
    AGCGAACGGG CGCGCCTCAA GCGTGCCCAG ATCCGTGCGA CCGAGAACAA TGAGGAGCGC
    AAGGAGCGGC TGTCCAAGCA GGCGGAATAT GCTCGACTAC GGCGCATGCG CAGCCATACG
    CCGCGCACCA GCAGCAGCGC CAGCGCCGAG TTCCATGGCA AGACGGAGGA TGATACGGCG
    GAGCAGATGT ACGACAACGA TACAGATGGC GGAGATAGCT TTGTGCTGAA ATCGGACTCG
    CAGATGGATG ATGGCGATGC CGATGATCAG GACAAGCAGC TTCAACAATT GCAGCAGCAA
    CAGCAGCAGC AGCAACAACA ACAGCAGCAA CAGCAACAAC AGCAGCAGCA ACACGAGCTA
    CATCAGATGA CGGGCAGCCT CCTGCAGCAG CCACATCACG AGGCAATCGT CATCAATCAG
    CAACAGCAGC AGCAGCAGCA GCAGCGTCTG GTCAGCCTCA ATCAGCATCA GCAGAGCTAC
    AGCAAGCTGC AGGCGGCAAC GGCGACCAGT GCGAGCAGCG CTGCCGGCGG AGCAGGAGGC
    AACGGAGCGG GCGCGCCTGA GAATAATGAT ATGCTAAAGA TACTCGAACC AATAATTGTT
    ATGAAAACCA AATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253497
    Clone ID Related Accession (Same CDS sequence) XM_018109501.1
    Accession Version XM_018109501.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3201bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product LOW QUALITY PROTEIN: polyglutamine-repeat protein pqn-41
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGAACCAG ATCCCAATGG GATAAAGATC GAACCAACAC TTGACCATCA CCAGCAGCAG 
    CAGCAACAGC AGCAACARTA CGCAACACTT TTGGCAATAA ATGGCCCAAA TGCGCGCCTT
    CTTATCGAGC ATCCGTCAGC GCTGTTGGTA CCCCTATCGA CACATCAGCA ACAACAATTG
    CAATTGCAGC AGCACCAGCA ACAGCAGCAA CAGCAACAGC AGCAGCAGCA GCAACAACAG
    TTTCAGCAAC AGCAGCAACA GCAACAGCAT CATCTGCAGC AGCAACAATT TCATCAGCAA
    CAATTGCAAA TAACATTACC CGCTTACACA CAGCCGCTCT CGCTCAAGCA ACAGCCGCCA
    CCCACACCCC TGGGACCCAC CTCCTCGGTC AGCAACAGCA ATACGCAACA ACAGCAACAG
    CAGCCCCAAC AGCAACAACA ACAACAGCAG CAGCAACAAC CACACCATCA TCATCAACAT
    CAGCAGCGCT GGAACGAGAG TCCAGAGGCG AGACAACGGC GGTTGGCCCG CAATGCTGAG
    AGGATGCGCG AGAGACGTCA GCGTGAAAGT GAAGAAGAAT ATCGAAAACG TTTGATGCGT
    AACGCCGAAG CGAATCGCCA AAGGCGACAG AATGAATCAG ATTTGGAGCG GGCGATGCGA
    CTGGTGCGCA ATGCGGCCCG GCAGCGATTG CGACGGGCCA TGGAATCGCC GGATCAGCGA
    TCCAAACGTC TGGCCAAGCT GGCCGAACGG ATGCGCATGT ATCGGGCCAG TGAGACGGCC
    GATCAGCGCA AGGTACGGCT GGCTGAGATG GCCGCCCGGG CCAGGCAGCG CATTGCCAGC
    GAGTCGGCGG AGGAGCGGAA GGAAAGACTG AGAAAGCTGA ACGACTATGC GAAAAAGGTC
    AGAGAAAAGA AAAAGATATA CAAACAGGTG CAGGTGCATG TACAGAATTC GTCGTCGTCT
    TCATCGACCA ATTCGACCAA TTCCAATACA CTGACCGTTC AGCAGCAGCA GCAGCAACAG
    CAGCAGCAGC AACATCAACA GCAGCAGCAG GTGCTAGCAG TGGCAACTGC CGCTGCTGCC
    GCCGCCGCCG CCGCTGCAAA CGTAGCTGGC CAATCAGCCA ATTGTAATAA TGAGCATAAT
    ATTAATTTAA ATCAGGCAAA CGTCTCATCA GCGCCTGCCA ACAATGCCAC CACTACAAGC
    AGCAGCAGCA GCAACACCAC AACAGCGGCA GCAGCAACTG TTACCGCCGA CGATCAGCAT
    CTGGTGACAG CTGCACCGGC CTCGGCCTAT CAGCAGCATC AGGCCATCGA GTATATGGGC
    CAGAATATGT TTATAGCGCG ACCGACGATG CAGCTGAAAC AGGAGCCGCA ACAGCATCAG
    CAGCAGCAGC AGCAGCAGCA ACAACAGCAG CAACAGCAAC TGCAGCAGCA GCAGCAGCCG
    CGCTATTCGC TCGGCGCCCA GCAGCTGATC GATGGCGTTG CTGGTGGCAG TGGAGCCGCC
    GAGGCGGGAA GCATCTTTGT CCAACAGATC TATGGCGAGG AGCCGGGCAA AACCGGTAAA
    TTGCTGCAGG CGCATGTTCC GCACTTTAGC ATTGCCAATC AGCTCGAGTT CTATAAGCAG
    AAATACGCCA ATATGGTGGA ACTTCAGTCT GGCGAGGCGA ACGATAACAG CGGGTCTGTT
    ACACTGGGTC AGAACGAGGC CAAGGTGATT GTGGCCGCCG CCGAGCAGCA GCAGCAGCAG
    CAGCAGCAGA AGGTGCTCAA ACCTGGCTCA GCAGCGGCCG CTGCAGCCGC AGCCGCCGCA
    GCAGCAGCGG CAGCAACGAC CTCAACCACA ACCGGAACCC AGCTCTACAA TCAGCTGCCC
    TATTTGGCCA CATTTCCAGC GACGGCCAAT AGCAGCGGCG CCAGCGGCAC TGTGACGGTG
    GCGGGCGGCG GAGGTGGTGC GGCCGGTGCG GCCAATGGAT CGGCGGCAGC CAGTGCCACT
    GCTTACTATC CTATGTATCC GAATGGCTTC CAGCTGGGCA TCGGGCCGAA TACGGTGCCG
    CCGCCGTTTA CACCTGTGCA TTTCGCCAAT GCCAGCGGCG GGAGCAGTCC AACGGCGCCG
    GGACAATACA ATATACTGAC GACGCCCACC GGTGCGAATC CTACGCTAAC TGTCACCGGA
    CTGGGCCAGC AGCAGCAGCA GCAGTCCGCA GCAGCAACAG CAGCAGCAGC ACAACTGCTG
    CACGAATTCC CAAAAATGGG TCGAGGTCGT CCACGTAAGA TTAGCCTGTT GACCAGCGAG
    GATCATCTGA AGGCGAACAC GCTGCTGGAG CAGGAGTTGA ATCAGATGCT CTCCGCACCG
    CATTTGGGCT CGGGCATTGG AAGCGGACGA CGCGGACGTC CGCCGTTGCA TCAAAGCCAT
    CATCATTTAC ATCATGCACA TTCCACGGCA GATGGGGATG GCTCTGCCAC GCCGCGACGC
    AGCGGCGCCA ACAAATACGA GACGGAGGAG GAGAAGCGCA TTCGGCTGGA CAAAATGGCG
    GCGCATCAGC GTGCGGTGCG TGCGAATGAA TCGCCCGAGC AACGGGCGGT GCGCCTGCAG
    AAGCTGAGCG AACGGGCGCG CCTCAAGCGT GCCCAGATCC GTGCGACCGA GAACAATGAG
    GAGCGCAAGG AGCGGCTGTC CAAGCAGGCG GAATATGCTC GACTACGGCG CATGCGCAGC
    CATACGCCGC GCACCAGCAG CAGCGCCAGC GCCGAGTTCC ATGGCAAGAC GGAGGATGAT
    ACGGCGGAGC AGATGTACGA CAACGATACA GATGGCGGAG ATAGCTTTGT GCTGAAATCG
    GACTCGCAGA TGGATGATGG CGATGCCGAT GATCAGGACA AGCAGCTTCA ACAATTGCAG
    CAGCAACAGC AGCAGCAGCA ACAACAACAG CAGCAACAGC AACAACAGCA GCAGCAACAC
    GAGCTACATC AGATGACGGG CAGCCTCCTG CAGCAGCCAC ATCACGAGGC AATCGTCATC
    AATCAGCAAC AGCAGCAGCA GCAGCAGCAG CGTCTGGTCA GCCTCAATCA GCATCAGCAG
    AGCTACAGCA AGCTGCAGGC GGCAACGGCG ACCAGTGCGA GCAGCGCTGC CGGCGGAGCA
    GGAGGCAACG GAGCGGGCGC GCCTGAGAAT AATGATATGC TAAAGATACT CGAACCAATA
    ATTGTTATGA AAACCAAATG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_017964990.1
    CDS514..3714
    Translation

    Target ORF information:

    RefSeq Version XM_018109501.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa polyglutamine-repeat protein pqn-41 (LOC108657049), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018109501.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGAACCAG ATCCCAATGG GATAAAGATC GAACCAACAC TTGACCATCA CCAGCAGCAG 
    CAGCAACAGC AGCAACARTA CGCAACACTT TTGGCAATAA ATGGCCCAAA TGCGCGCCTT
    CTTATCGAGC ATCCGTCAGC GCTGTTGGTA CCCCTATCGA CACATCAGCA ACAACAATTG
    CAATTGCAGC AGCACCAGCA ACAGCAGCAA CAGCAACAGC AGCAGCAGCA GCAACAACAG
    TTTCAGCAAC AGCAGCAACA GCAACAGCAT CATCTGCAGC AGCAACAATT TCATCAGCAA
    CAATTGCAAA TAACATTACC CGCTTACACA CAGCCGCTCT CGCTCAAGCA ACAGCCGCCA
    CCCACACCCC TGGGACCCAC CTCCTCGGTC AGCAACAGCA ATACGCAACA ACAGCAACAG
    CAGCCCCAAC AGCAACAACA ACAACAGCAG CAGCAACAAC CACACCATCA TCATCAACAT
    CAGCAGCGCT GGAACGAGAG TCCAGAGGCG AGACAACGGC GGTTGGCCCG CAATGCTGAG
    AGGATGCGCG AGAGACGTCA GCGTGAAAGT GAAGAAGAAT ATCGAAAACG TTTGATGCGT
    AACGCCGAAG CGAATCGCCA AAGGCGACAG AATGAATCAG ATTTGGAGCG GGCGATGCGA
    CTGGTGCGCA ATGCGGCCCG GCAGCGATTG CGACGGGCCA TGGAATCGCC GGATCAGCGA
    TCCAAACGTC TGGCCAAGCT GGCCGAACGG ATGCGCATGT ATCGGGCCAG TGAGACGGCC
    GATCAGCGCA AGGTACGGCT GGCTGAGATG GCCGCCCGGG CCAGGCAGCG CATTGCCAGC
    GAGTCGGCGG AGGAGCGGAA GGAAAGACTG AGAAAGCTGA ACGACTATGC GAAAAAGGTC
    AGAGAAAAGA AAAAGATATA CAAACAGGTG CAGGTGCATG TACAGAATTC GTCGTCGTCT
    TCATCGACCA ATTCGACCAA TTCCAATACA CTGACCGTTC AGCAGCAGCA GCAGCAACAG
    CAGCAGCAGC AACATCAACA GCAGCAGCAG GTGCTAGCAG TGGCAACTGC CGCTGCTGCC
    GCCGCCGCCG CCGCTGCAAA CGTAGCTGGC CAATCAGCCA ATTGTAATAA TGAGCATAAT
    ATTAATTTAA ATCAGGCAAA CGTCTCATCA GCGCCTGCCA ACAATGCCAC CACTACAAGC
    AGCAGCAGCA GCAACACCAC AACAGCGGCA GCAGCAACTG TTACCGCCGA CGATCAGCAT
    CTGGTGACAG CTGCACCGGC CTCGGCCTAT CAGCAGCATC AGGCCATCGA GTATATGGGC
    CAGAATATGT TTATAGCGCG ACCGACGATG CAGCTGAAAC AGGAGCCGCA ACAGCATCAG
    CAGCAGCAGC AGCAGCAGCA ACAACAGCAG CAACAGCAAC TGCAGCAGCA GCAGCAGCCG
    CGCTATTCGC TCGGCGCCCA GCAGCTGATC GATGGCGTTG CTGGTGGCAG TGGAGCCGCC
    GAGGCGGGAA GCATCTTTGT CCAACAGATC TATGGCGAGG AGCCGGGCAA AACCGGTAAA
    TTGCTGCAGG CGCATGTTCC GCACTTTAGC ATTGCCAATC AGCTCGAGTT CTATAAGCAG
    AAATACGCCA ATATGGTGGA ACTTCAGTCT GGCGAGGCGA ACGATAACAG CGGGTCTGTT
    ACACTGGGTC AGAACGAGGC CAAGGTGATT GTGGCCGCCG CCGAGCAGCA GCAGCAGCAG
    CAGCAGCAGA AGGTGCTCAA ACCTGGCTCA GCAGCGGCCG CTGCAGCCGC AGCCGCCGCA
    GCAGCAGCGG CAGCAACGAC CTCAACCACA ACCGGAACCC AGCTCTACAA TCAGCTGCCC
    TATTTGGCCA CATTTCCAGC GACGGCCAAT AGCAGCGGCG CCAGCGGCAC TGTGACGGTG
    GCGGGCGGCG GAGGTGGTGC GGCCGGTGCG GCCAATGGAT CGGCGGCAGC CAGTGCCACT
    GCTTACTATC CTATGTATCC GAATGGCTTC CAGCTGGGCA TCGGGCCGAA TACGGTGCCG
    CCGCCGTTTA CACCTGTGCA TTTCGCCAAT GCCAGCGGCG GGAGCAGTCC AACGGCGCCG
    GGACAATACA ATATACTGAC GACGCCCACC GGTGCGAATC CTACGCTAAC TGTCACCGGA
    CTGGGCCAGC AGCAGCAGCA GCAGTCCGCA GCAGCAACAG CAGCAGCAGC ACAACTGCTG
    CACGAATTCC CAAAAATGGG TCGAGGTCGT CCACGTAAGA TTAGCCTGTT GACCAGCGAG
    GATCATCTGA AGGCGAACAC GCTGCTGGAG CAGGAGTTGA ATCAGATGCT CTCCGCACCG
    CATTTGGGCT CGGGCATTGG AAGCGGACGA CGCGGACGTC CGCCGTTGCA TCAAAGCCAT
    CATCATTTAC ATCATGCACA TTCCACGGCA GATGGGGATG GCTCTGCCAC GCCGCGACGC
    AGCGGCGCCA ACAAATACGA GACGGAGGAG GAGAAGCGCA TTCGGCTGGA CAAAATGGCG
    GCGCATCAGC GTGCGGTGCG TGCGAATGAA TCGCCCGAGC AACGGGCGGT GCGCCTGCAG
    AAGCTGAGCG AACGGGCGCG CCTCAAGCGT GCCCAGATCC GTGCGACCGA GAACAATGAG
    GAGCGCAAGG AGCGGCTGTC CAAGCAGGCG GAATATGCTC GACTACGGCG CATGCGCAGC
    CATACGCCGC GCACCAGCAG CAGCGCCAGC GCCGAGTTCC ATGGCAAGAC GGAGGATGAT
    ACGGCGGAGC AGATGTACGA CAACGATACA GATGGCGGAG ATAGCTTTGT GCTGAAATCG
    GACTCGCAGA TGGATGATGG CGATGCCGAT GATCAGGACA AGCAGCTTCA ACAATTGCAG
    CAGCAACAGC AGCAGCAGCA ACAACAACAG CAGCAACAGC AACAACAGCA GCAGCAACAC
    GAGCTACATC AGATGACGGG CAGCCTCCTG CAGCAGCCAC ATCACGAGGC AATCGTCATC
    AATCAGCAAC AGCAGCAGCA GCAGCAGCAG CGTCTGGTCA GCCTCAATCA GCATCAGCAG
    AGCTACAGCA AGCTGCAGGC GGCAACGGCG ACCAGTGCGA GCAGCGCTGC CGGCGGAGCA
    GGAGGCAACG GAGCGGGCGC GCCTGAGAAT AATGATATGC TAAAGATACT CGAACCAATA
    ATTGTTATGA AAACCAAATG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.