INTS13 cDNA ORF clone, Corvus cornix cornix

The following INTS13 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the INTS13 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCo91699 XM_010410333.2
Latest version!
Corvus cornix cornix integrator complex subunit 13 (INTS13), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OCo91700 XM_010410334.2
Latest version!
Corvus cornix cornix integrator complex subunit 13 (INTS13), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCo91699
    Clone ID Related Accession (Same CDS sequence) XM_010410333.2
    Accession Version XM_010410333.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2169bp)
    Protein sequence
    SNP
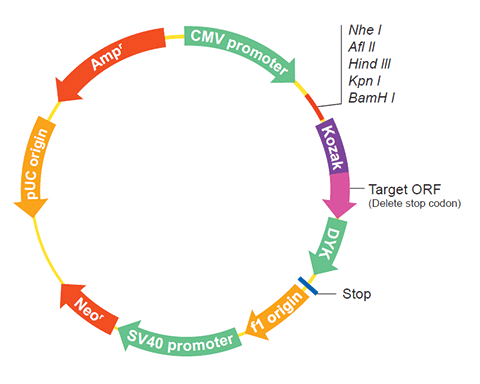
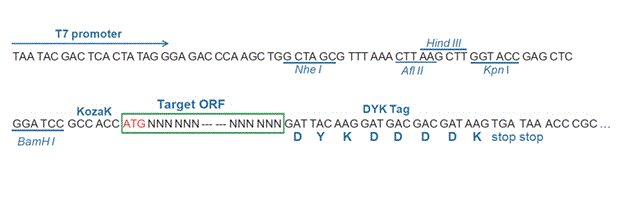
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product protein asunder homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113951.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Nov 29, 2016 this sequence version replaced XM_010410333.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGTCTGTTT CTTTCAGGAA GAAAATGAAA ATATTTTCTG AGTCTCACAA AACTGTTTTC 
    GTTGTGGATC ACTGCCCCTA CATGGCAGAA TCATGCAGGC AGCACGTGGA ATTCGATATG
    TTAGTGAAGA ACCGTACCCA GGGGATTATT CCTCTGGCAC CCATCTCCAA GTCCCTGTGG
    ACCTGCTCAG TGGAGTCATC CATGGAGTAC TGTAGAATAA TGTATGATAT TTTCCCTTTC
    AAGAAGCTGG TGAATTTCAT TGTCAGTGAC TCTGGGGCTC ATGTGTTGAA TTCTTGGACT
    CAAGAAGATC AGAATTTGCA GGAGCTGATG GCGGCGCTGG CGGGGGTGGG CCCGCCGAAC
    CCGCGGGCGG ACCCCGAGTG CTGCAGCATC CTGCACGGGC TGGTGGCGGC CGTCGAGGCG
    CTCTGCAAGA TCACCGAGTA CCAGCACGAG GCCCGCACCA CGCTCATGGA GAACGCCGAG
    CGCGTGGGCA ACCGGGGCAG GATCATCTGC ATCACCAACG CCAAAAGTGA CAGCCATGTT
    CGGATGCTGG AGGATTGTGT TCAGGAGACC ATTCATGAGC ACAACAAGCT TGCAGCTAAC
    TCTGACCATC TAATGCAGAT TCAGAAATGT GAACTGGTGT TAATCCACAC GTACCCAGTT
    GGTGAAGACA GCCTTGTTTC AGATCGTCCT AAAAAAGAGC TCTCCCCTGT TCTAACCAGT
    GAGGTGCACA GTGTCCGTGC GGGGAGGCAC CTGGCTACAA AACTGAATCT TCTGGTACAG
    CAACACTTTG ATCTGGCTTC AACCACAATA ACTAACATCC CTATGAAGCC CACATTCAAT
    GTCTGTGACC AGGAAGAACA ACATGCTAAC ACATCAGCCA ACTATGATGT GGAGCTGCTT
    CATCACAAAG AGGCACACGT GGATTTTTTA AAGAGTGGTG ATAATCACAT GGGTGGCAAT
    AGCAGAGAAG GCACATTTAA GGAAACTGTG ACACTGAAAT GGTGCACTCC ACGAACCAAC
    AGTGTGGAAC TGCACTATTG CACTGGCGCA TACAGAATTT CACCAGTAGA TGTAAATAGC
    AGACCTTCTT CCTGCCTTAC AAACTTTCTC CTTAATGGTC GTTCGGTGTT GTTGGAACAG
    CCACGCAAGT CTGGCTCAAA GGTCATCAGC CACATGCTCA GCAGCCACGG GGGAGAGATT
    TTCTTGCATG TGTTGAGCAG CTCCCGCTCG ATTCTGGAAG ATCCCCCCTC AATTAGCGAG
    GGGTGCGGCG GGAGGGTCAC TGACTACAGG ATCACAGATT TTGGTGAATT TATGAGGGAA
    AACCGATTAA CTCCTTTTCT AGAGCCCAGA TATAAGATCG ATGGAAGTCT TGAAATTCCA
    TTGGAACGTG CAAAAGATCA GTTAGAGAAA CATACTCGTT ACTGGCCTAT GATTATTTCT
    CAGACCACCA TCTTCAACAT GCAAGCTGTA GTGCCATTAG CCAGTGTGAT TGTAAAGGAA
    GCAATGACTG ATGAGGATGT GCTGAATTGT CAAAAAACAA TATACAATTT GGTAGACATG
    GAGAGGAAGA ACGATCCACT GCCAATTTCA ACAGTTGGTA CCAGAGGAAA GGGGCCAAAA
    AGAGATGAGC AGTACCGCAT TATGTGGAAT GAGCTGGAGA CCCTTGTCCG AGCACACATA
    AACAACTCTG ACAAACACCA GCGAGTCCTC GAGTGTCTCA TGGCGTGCAG GAGCAAACCC
    CCGGAGGAGG AGGAGCGCAA GAAACGAGGC AGAAAGAGAG AAGACAAAGA GGACAAGTCA
    GAGAAGTTGG GCAAAGACTA TGAATCAGAT AAGCCATGGC AGGAATCAGA GAGGTTAAAA
    GGTCTTTTGG ATCGGGAGAA AGAAGAACTG GCAGAAGCTG AAGTTATCAA AGACTCCCCT
    GATTCTCCTG AGCCCCCCAA CAAAAAGCCT CTCATTACAA TGGATGAAAT ACCCGCAGTT
    GAAAAGGCAA AAGGGCCAAT GTCCTTGCTG TCTTTATGGA GCAACAGAAT TAATACTGCC
    AACTCTAGGA AGCACCAGGA ATTTATTGGT CGGTTGAACT CTGTCAACAA CAAAGCTGAG
    CTGTATCAAC ATCTGAAAGA AGAAAATGGA ATGGAAACGA CAGAAAATGG AAAAGCAGGC
    CGGCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_010408635.1
    CDS17..2185
    Translation

    Target ORF information:

    RefSeq Version XM_010410333.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix integrator complex subunit 13 (INTS13), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010410333.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGTCTGTTT CTTTCAGGAA GAAAATGAAA ATATTTTCTG AGTCTCACAA AACTGTTTTC 
    GTTGTGGATC ACTGCCCCTA CATGGCAGAA TCATGCAGGC AGCACGTGGA ATTCGATATG
    TTAGTGAAGA ACCGTACCCA GGGGATTATT CCTCTGGCAC CCATCTCCAA GTCCCTGTGG
    ACCTGCTCAG TGGAGTCATC CATGGAGTAC TGTAGAATAA TGTATGATAT TTTCCCTTTC
    AAGAAGCTGG TGAATTTCAT TGTCAGTGAC TCTGGGGCTC ATGTGTTGAA TTCTTGGACT
    CAAGAAGATC AGAATTTGCA GGAGCTGATG GCGGCGCTGG CGGGGGTGGG CCCGCCGAAC
    CCGCGGGCGG ACCCCGAGTG CTGCAGCATC CTGCACGGGC TGGTGGCGGC CGTCGAGGCG
    CTCTGCAAGA TCACCGAGTA CCAGCACGAG GCCCGCACCA CGCTCATGGA GAACGCCGAG
    CGCGTGGGCA ACCGGGGCAG GATCATCTGC ATCACCAACG CCAAAAGTGA CAGCCATGTT
    CGGATGCTGG AGGATTGTGT TCAGGAGACC ATTCATGAGC ACAACAAGCT TGCAGCTAAC
    TCTGACCATC TAATGCAGAT TCAGAAATGT GAACTGGTGT TAATCCACAC GTACCCAGTT
    GGTGAAGACA GCCTTGTTTC AGATCGTCCT AAAAAAGAGC TCTCCCCTGT TCTAACCAGT
    GAGGTGCACA GTGTCCGTGC GGGGAGGCAC CTGGCTACAA AACTGAATCT TCTGGTACAG
    CAACACTTTG ATCTGGCTTC AACCACAATA ACTAACATCC CTATGAAGCC CACATTCAAT
    GTCTGTGACC AGGAAGAACA ACATGCTAAC ACATCAGCCA ACTATGATGT GGAGCTGCTT
    CATCACAAAG AGGCACACGT GGATTTTTTA AAGAGTGGTG ATAATCACAT GGGTGGCAAT
    AGCAGAGAAG GCACATTTAA GGAAACTGTG ACACTGAAAT GGTGCACTCC ACGAACCAAC
    AGTGTGGAAC TGCACTATTG CACTGGCGCA TACAGAATTT CACCAGTAGA TGTAAATAGC
    AGACCTTCTT CCTGCCTTAC AAACTTTCTC CTTAATGGTC GTTCGGTGTT GTTGGAACAG
    CCACGCAAGT CTGGCTCAAA GGTCATCAGC CACATGCTCA GCAGCCACGG GGGAGAGATT
    TTCTTGCATG TGTTGAGCAG CTCCCGCTCG ATTCTGGAAG ATCCCCCCTC AATTAGCGAG
    GGGTGCGGCG GGAGGGTCAC TGACTACAGG ATCACAGATT TTGGTGAATT TATGAGGGAA
    AACCGATTAA CTCCTTTTCT AGAGCCCAGA TATAAGATCG ATGGAAGTCT TGAAATTCCA
    TTGGAACGTG CAAAAGATCA GTTAGAGAAA CATACTCGTT ACTGGCCTAT GATTATTTCT
    CAGACCACCA TCTTCAACAT GCAAGCTGTA GTGCCATTAG CCAGTGTGAT TGTAAAGGAA
    GCAATGACTG ATGAGGATGT GCTGAATTGT CAAAAAACAA TATACAATTT GGTAGACATG
    GAGAGGAAGA ACGATCCACT GCCAATTTCA ACAGTTGGTA CCAGAGGAAA GGGGCCAAAA
    AGAGATGAGC AGTACCGCAT TATGTGGAAT GAGCTGGAGA CCCTTGTCCG AGCACACATA
    AACAACTCTG ACAAACACCA GCGAGTCCTC GAGTGTCTCA TGGCGTGCAG GAGCAAACCC
    CCGGAGGAGG AGGAGCGCAA GAAACGAGGC AGAAAGAGAG AAGACAAAGA GGACAAGTCA
    GAGAAGTTGG GCAAAGACTA TGAATCAGAT AAGCCATGGC AGGAATCAGA GAGGTTAAAA
    GGTCTTTTGG ATCGGGAGAA AGAAGAACTG GCAGAAGCTG AAGTTATCAA AGACTCCCCT
    GATTCTCCTG AGCCCCCCAA CAAAAAGCCT CTCATTACAA TGGATGAAAT ACCCGCAGTT
    GAAAAGGCAA AAGGGCCAAT GTCCTTGCTG TCTTTATGGA GCAACAGAAT TAATACTGCC
    AACTCTAGGA AGCACCAGGA ATTTATTGGT CGGTTGAACT CTGTCAACAA CAAAGCTGAG
    CTGTATCAAC ATCTGAAAGA AGAAAATGGA ATGGAAACGA CAGAAAATGG AAAAGCAGGC
    CGGCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo91700
    Clone ID Related Accession (Same CDS sequence) XM_010410334.2
    Accession Version XM_010410334.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2145bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product protein asunder homolog isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113951.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Nov 29, 2016 this sequence version replaced XM_010410334.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTCTGTTT CTTTCAGGAA GAAAATGAAA ATATTTTCTG AGTCTCACAA AACTGTTTTC 
    GTTGTGGATC ACTGCCCCTA CATGGCAGAA TCATGCAGGC AGCACGTGGA ATTCGATATG
    TTAGTGAAGA ACCGTACCCA GGGGATTATT CCTCTGGCAC CCATCTCCAA GTCCCTGTGG
    ACCTGCTCAG TGGAGTCATC CATGGAGTAC TGTAGAATAA TGTATGATAT TTTCCCTTTC
    AAGAAGCTGG TGAATTTCAT TGTCAGTGAC TCTGGGGCTC ATGTGTTGAA TTCTTGGACT
    CAAGAAGATC AGAATTTGCA GGAGCTGATG GCGGCGCTGG CGGGGGTGGG CCCGCCGAAC
    CCGCGGGCGG ACCCCGAGTG CTGCAGCATC CTGCACGGGC TGGTGGCGGC CGTCGAGGCG
    CTCTGCAAGA TCACCGAGTA CCAGCACGAG GCCCGCACCA CGCTCATGGA GAACGCCGAG
    CGCGTGGGCA ACCGGGGCAG GATCATCTGC ATCACCAACG CCAAAAGTGA CAGCCATGTT
    CGGATGCTGG AGGATTGTGT TCAGGAGACC ATTCATGAGC ACAACAAGCT TGCAGCTAAC
    TCTGACCATC TAATGCAGAT TCAGAAATGT GAACTGGTGT TAATCCACAC GTACCCAGTT
    GGTGAAGACA GCCTTGTTTC AGATCGTCCT AAAAAAGAGC TCTCCCCTGT TCTAACCAGT
    GAGGTGCACA GTGTCCGTGC GGGGAGGCAC CTGGCTACAA AACTGAATCT TCTGGTACAG
    CAACACTTTG ATCTGGCTTC AACCACAATA ACTAACATCC CTATGAAGGA AGAACAACAT
    GCTAACACAT CAGCCAACTA TGATGTGGAG CTGCTTCATC ACAAAGAGGC ACACGTGGAT
    TTTTTAAAGA GTGGTGATAA TCACATGGGT GGCAATAGCA GAGAAGGCAC ATTTAAGGAA
    ACTGTGACAC TGAAATGGTG CACTCCACGA ACCAACAGTG TGGAACTGCA CTATTGCACT
    GGCGCATACA GAATTTCACC AGTAGATGTA AATAGCAGAC CTTCTTCCTG CCTTACAAAC
    TTTCTCCTTA ATGGTCGTTC GGTGTTGTTG GAACAGCCAC GCAAGTCTGG CTCAAAGGTC
    ATCAGCCACA TGCTCAGCAG CCACGGGGGA GAGATTTTCT TGCATGTGTT GAGCAGCTCC
    CGCTCGATTC TGGAAGATCC CCCCTCAATT AGCGAGGGGT GCGGCGGGAG GGTCACTGAC
    TACAGGATCA CAGATTTTGG TGAATTTATG AGGGAAAACC GATTAACTCC TTTTCTAGAG
    CCCAGATATA AGATCGATGG AAGTCTTGAA ATTCCATTGG AACGTGCAAA AGATCAGTTA
    GAGAAACATA CTCGTTACTG GCCTATGATT ATTTCTCAGA CCACCATCTT CAACATGCAA
    GCTGTAGTGC CATTAGCCAG TGTGATTGTA AAGGAAGCAA TGACTGATGA GGATGTGCTG
    AATTGTCAAA AAACAATATA CAATTTGGTA GACATGGAGA GGAAGAACGA TCCACTGCCA
    ATTTCAACAG TTGGTACCAG AGGAAAGGGG CCAAAAAGAG ATGAGCAGTA CCGCATTATG
    TGGAATGAGC TGGAGACCCT TGTCCGAGCA CACATAAACA ACTCTGACAA ACACCAGCGA
    GTCCTCGAGT GTCTCATGGC GTGCAGGAGC AAACCCCCGG AGGAGGAGGA GCGCAAGAAA
    CGAGGCAGAA AGAGAGAAGA CAAAGAGGAC AAGTCAGAGA AGTTGGGCAA AGACTATGAA
    TCAGATAAGC CATGGCAGGA ATCAGAGAGG TTAAAAGGTC TTTTGGATCG GGAGAAAGAA
    GAACTGGCAG AAGCTGAAGT TATCAAAGAC TCCCCTGATT CTCCTGAGCC CCCCAACAAA
    AAGCCTCTCA TTACAATGGA TGAAATACCC GCAGTTGAAA AGGCAAAAGG GCCAATGTCC
    TTGCTGTCTT TATGGAGCAA CAGAATTAAT ACTGCCAACT CTAGGAAGCA CCAGGAATTT
    ATTGGTCGGT TGAACTCTGT CAACAACAAA GCTGAGCTGT ATCAACATCT GAAAGAAGAA
    AATGGAATGG AAACGACAGA AAATGGAAAA GCAGGCCGGC AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_010408636.1
    CDS17..2161
    Translation

    Target ORF information:

    RefSeq Version XM_010410334.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix integrator complex subunit 13 (INTS13), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010410334.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTCTGTTT CTTTCAGGAA GAAAATGAAA ATATTTTCTG AGTCTCACAA AACTGTTTTC 
    GTTGTGGATC ACTGCCCCTA CATGGCAGAA TCATGCAGGC AGCACGTGGA ATTCGATATG
    TTAGTGAAGA ACCGTACCCA GGGGATTATT CCTCTGGCAC CCATCTCCAA GTCCCTGTGG
    ACCTGCTCAG TGGAGTCATC CATGGAGTAC TGTAGAATAA TGTATGATAT TTTCCCTTTC
    AAGAAGCTGG TGAATTTCAT TGTCAGTGAC TCTGGGGCTC ATGTGTTGAA TTCTTGGACT
    CAAGAAGATC AGAATTTGCA GGAGCTGATG GCGGCGCTGG CGGGGGTGGG CCCGCCGAAC
    CCGCGGGCGG ACCCCGAGTG CTGCAGCATC CTGCACGGGC TGGTGGCGGC CGTCGAGGCG
    CTCTGCAAGA TCACCGAGTA CCAGCACGAG GCCCGCACCA CGCTCATGGA GAACGCCGAG
    CGCGTGGGCA ACCGGGGCAG GATCATCTGC ATCACCAACG CCAAAAGTGA CAGCCATGTT
    CGGATGCTGG AGGATTGTGT TCAGGAGACC ATTCATGAGC ACAACAAGCT TGCAGCTAAC
    TCTGACCATC TAATGCAGAT TCAGAAATGT GAACTGGTGT TAATCCACAC GTACCCAGTT
    GGTGAAGACA GCCTTGTTTC AGATCGTCCT AAAAAAGAGC TCTCCCCTGT TCTAACCAGT
    GAGGTGCACA GTGTCCGTGC GGGGAGGCAC CTGGCTACAA AACTGAATCT TCTGGTACAG
    CAACACTTTG ATCTGGCTTC AACCACAATA ACTAACATCC CTATGAAGGA AGAACAACAT
    GCTAACACAT CAGCCAACTA TGATGTGGAG CTGCTTCATC ACAAAGAGGC ACACGTGGAT
    TTTTTAAAGA GTGGTGATAA TCACATGGGT GGCAATAGCA GAGAAGGCAC ATTTAAGGAA
    ACTGTGACAC TGAAATGGTG CACTCCACGA ACCAACAGTG TGGAACTGCA CTATTGCACT
    GGCGCATACA GAATTTCACC AGTAGATGTA AATAGCAGAC CTTCTTCCTG CCTTACAAAC
    TTTCTCCTTA ATGGTCGTTC GGTGTTGTTG GAACAGCCAC GCAAGTCTGG CTCAAAGGTC
    ATCAGCCACA TGCTCAGCAG CCACGGGGGA GAGATTTTCT TGCATGTGTT GAGCAGCTCC
    CGCTCGATTC TGGAAGATCC CCCCTCAATT AGCGAGGGGT GCGGCGGGAG GGTCACTGAC
    TACAGGATCA CAGATTTTGG TGAATTTATG AGGGAAAACC GATTAACTCC TTTTCTAGAG
    CCCAGATATA AGATCGATGG AAGTCTTGAA ATTCCATTGG AACGTGCAAA AGATCAGTTA
    GAGAAACATA CTCGTTACTG GCCTATGATT ATTTCTCAGA CCACCATCTT CAACATGCAA
    GCTGTAGTGC CATTAGCCAG TGTGATTGTA AAGGAAGCAA TGACTGATGA GGATGTGCTG
    AATTGTCAAA AAACAATATA CAATTTGGTA GACATGGAGA GGAAGAACGA TCCACTGCCA
    ATTTCAACAG TTGGTACCAG AGGAAAGGGG CCAAAAAGAG ATGAGCAGTA CCGCATTATG
    TGGAATGAGC TGGAGACCCT TGTCCGAGCA CACATAAACA ACTCTGACAA ACACCAGCGA
    GTCCTCGAGT GTCTCATGGC GTGCAGGAGC AAACCCCCGG AGGAGGAGGA GCGCAAGAAA
    CGAGGCAGAA AGAGAGAAGA CAAAGAGGAC AAGTCAGAGA AGTTGGGCAA AGACTATGAA
    TCAGATAAGC CATGGCAGGA ATCAGAGAGG TTAAAAGGTC TTTTGGATCG GGAGAAAGAA
    GAACTGGCAG AAGCTGAAGT TATCAAAGAC TCCCCTGATT CTCCTGAGCC CCCCAACAAA
    AAGCCTCTCA TTACAATGGA TGAAATACCC GCAGTTGAAA AGGCAAAAGG GCCAATGTCC
    TTGCTGTCTT TATGGAGCAA CAGAATTAAT ACTGCCAACT CTAGGAAGCA CCAGGAATTT
    ATTGGTCGGT TGAACTCTGT CAACAACAAA GCTGAGCTGT ATCAACATCT GAAAGAAGAA
    AATGGAATGG AAACGACAGA AAATGGAAAA GCAGGCCGGC AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.