LOC105364247 cDNA ORF clone, Ceratosolen solmsi marchali

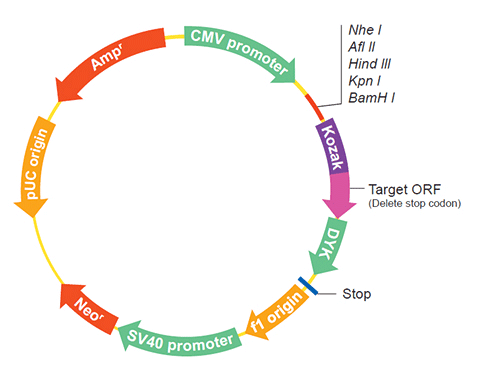
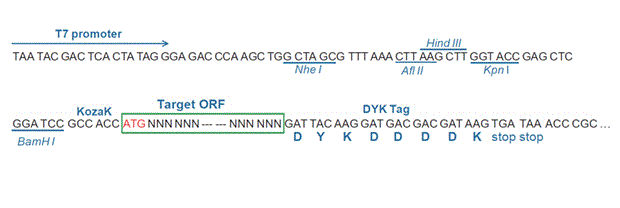
The following LOC105364247 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105364247 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe199963 XM_011502134.1
Latest version!
Ceratosolen solmsi marchali guanine nucleotide-releasing factor 2 (LOC105364247), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe199963
    Clone ID Related Accession (Same CDS sequence) XM_011502134.1
    Accession Version XM_011502134.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3792bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product guanine nucleotide-releasing factor 2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948431.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGCGCGAAC AGCACGCGCA CCGGACGCCT CGAGTCGCGA TATCTGCCGG CGACTTCGTA 
    CGGGAGGAGA GGATTCGTGG GCCAGTGAAG AGCGCCGAGA GAGAAGAGCC TTTTCCACTT
    AACCTGTCGG GTAAATTCGT AAATTTGGAG AAGCCCCCAC TGCCCAGACA TTGCCGGAAA
    GAGGTCGAGG AGCGACCGCC GGGGAAGGCG CGCGGGGGTA AGTTAGCGCG TCGTGCGCGC
    TCCTTCAAGG AGGACTTCTT GGAGAAGCTC TCGCAGATGC GGTCACCCGG GGGAGGTGGG
    GGCGGTAGTG CCGGCGGTAC GCGGGCCGTC TCGCCCTCGT CGCCGAGGAC ACCTCGGGAG
    CCACTAGGAG CCGGCGCTGC GACTACCACC ACCGCCGCCG TCTCCGCTGC TGGCGAGCAG
    CTCGACAAGA ACCCGCTGCG CGACCTCCAT GTCCATGTGC GCCAGGTGCA GCTGGCTCTC
    CTGCACTTTC GCGACGTCGT CTCCAAGAAC AAGCTAGAGA TGCTTCCGGG CAACGGGACC
    GTCGTACTTG ACACAGTCAC CACCATACAC ACCCTCCTCA AGTCGTATCT GCTTTATGAG
    AACAGCTCGA CGCTCGGCTC GGCGACGAAT CAGGTTTATC AGGCGCTGGC GCAGCTACTA
    AAGCTCTGCG ACGATGTGCT CCTGCACGGC GATCAGTCCT CGGCACTCGA CACGGCCAAC
    GTCACCCACG TCATTGGACT CGTCGAGGAC GCCGTGAAGA ATCTCGTGGA GCTCGCGCAG
    GAAAAGATCT CCAACAAGCA AAAGCCAGCA TTGCAGACCG CCAGCAATAG GACATCGGGC
    TACAGCTCCG AGTTGACGCC CCAACGCAGT TCCCTGCCGG ACATCCCGCT GACGCCGAGG
    GAGCGCCAGA TCCTCGAGCA GACCGCGGCC TCGAGCGCCC TCGTCAGGAG CTCCCACAGC
    TCCGAGTCCA TCCTCAGGGA TTCGAGTCCG CCGCCCCAGC CTCCGCTGCC CGATAGGACA
    CTCTGTCTTT CGGAGGACAA TAGCTCGTCG GGGACGACGC CCCCGCCACT GCCCCCGAAG
    AGGCGCACGC GCCACCAGCA GCAGCTCCAC CAGGAGGATC GGGAGTCGGA GACCGGCGCC
    TTGGCTACGT GCCTAGACCG GGTATCCTTA CGCAGTCGCT CGCCCGAGGA CTCGTCCTCG
    CTGCTCAGCG CCTCTGCCGG GAGTCTCGAC TCCGCGCTCA ACCATTCGCG CGACGAGGAC
    GAGATACGCG CCATTATGGG GCCAAACGAC GAGTCCTTCG GCGACAGCAT GGACCTCAGC
    CTCATGGCTA CCATTCAGGG AATGCAAGTT AACGGGAGCT CGCACTGCGG CTGCTGGGAC
    GGATCGGAAA CGAGTCTGCC GAGCACGATG CTGTTGGGTC AGCAGACCTC CCAGGAAATG
    CTCGGCCAGT TTACCGGCAT AGAGGCTAAA ATGGAACGCC TCTCGACGCA GACCCAGGAG
    TCCGGCTTCC TCTCCATGCA CTCGCAGCGC TCCTCCTCGC AGAGCTACAC CGCGACGACG
    GCTAACCTCG TGTCGAAGCG CCTCTCCCAG CAGAGTAGCG TCAGCTACAA CTCCCAGAAC
    GTGCAATCGT ACTCCCAGCA GAGGCTTTCA TCCGCCAGCG AGGCCAACAG CAACGGCTCG
    ACCACCGTAA GCCACAAGTC GACCACCACC ACCATGACCA GCTCCAGGAG CGTCCACAGT
    ACCACCAACC TCGGCGCCGA GCCCTCCTTC ATGGAAACAT TGGTAAACGA GATGGAGGCG
    CTGGCGAATT CGGACGCCAA CGGCGGAATG CCACCGGCGT TGCCGGAAAA ACGCTCGAAG
    CGCCGAAAAG AGCGGCTCCA CTCGCAGTAC GATAATGTGC CGGAGAACGA GCATTTATCG
    ACGTGCAGTT TGCACGCGAG CAACGGCAAC AGTCCCATCG ACAATAATAG GCCGCCCCCA
    CTGCCGATGA AGAAGAGACA TATAATGGCA TACATGGAGA TGTTCGGCAA TTGCTCGCAC
    AGTAATAGCG ACTTCATCCC GGGCCTCGGT GCCAGGCACT CCGTAGCCGC TTACAATTCC
    ATGCAATCCG AATGGCAACA GCACGAAATG GCACTGACGA CTACGCAGTC CTGCTCCTTC
    ATGACGCACA CACTCACGAG CTTGCACGAC GGTACCAGCC ACGCGTTCAC GATGGTACCG
    ACGATAAGAG AAATCGTAAA CGATTCCAGT GTACCCCCGG CATTACCACC AAAGAGGTCG
    CGCTCCGTTA AGGCGAGCGC GACGCCGCCC CCAGTGTCCC CGAAGCCGGC GGCTCCCGGG
    ATGCAGAGTC CCCACGTCGG CAGCCTCGAC CCCATCATCA CGTCGACACC AGTCAAAGCC
    GAGGAACCCA TCTCCTACTC GCCACTTTCA TTCGACAAGA AGGAGATCCT CAACGCTAAC
    AACGTATCAC TGAATAATAA TCTCAATTTG GACTCGTCGC CAAGATCATC GAGCAAAGCA
    CCTTCCTGCA TATCGATCGA CGAAAACTCC ATGGAATTAC GAGACGTCGA TCAAGATGAC
    AACATGTTAG ATGAATTAGA GATAAATAAG TATTTGGTTT TTAAGAAGCC GGAGGAGGAT
    GGTCCAGACA TACGTGGCGG TCATCCGGAT GCGTTATTAA TTCACGCGAC AAAAGCAAAC
    AAACATGATT TCCTGTATCA GGAAGCCTTC TTAACGACAT ATAGAACATT CATGTCACCG
    TTGGAGTTGA TAAAAAAATT ACACAGGCGG CATCAGCGAT TCTCATGTTC GTCAGATGTA
    GTGAAGCAGC GAGCAGCTAG AGAAGCGTTT TCTCTGCTAG TTCGAGTTGT TAGCGATTTG
    ACGATATCCG ATCTCGACGA CACCCTACTC CAGACCTTGA TGGAGTTCGT CCAGCAATTA
    GTCTGCAGCG GCGACCTAAC GATGGCCAAG GCCCTGCGCG TCAAGATCCT GGAAAAGCAT
    GCGTGCAAGC AGCTCCAGGC GGCGCAGCCG ATCCTCGCGT CCTTGAGCGT CTCGACCAAG
    CAAGCCTCGC TCTTGGACTT TAAAAGCGAG CAGATAGCCG AACAGATGAC GCTTCTCGAC
    GCCGAGCTCT TCATGAAGAT CGAAATACCG GAGGTGCTAA TCTGGGCCCA GGAACAAAAT
    GAGGAGCGCA GTCCGAATCT CACCAGATTC ACCGAACACT TCAACAAGAT GTCGTACTGG
    GCACGATCGA GAATCTTGGA GCACAGGTTG GAGAACGAGG CAAAAGACAG AGAGAAATAC
    GTTGTGAAGT TCATTAAAAT TATGAAGCAT TTGAGGAAGA TCAACAATTT TAATAGCTAC
    TTGGCACTAT TATCGGCTTT GGATAGTGCG CCCATTAGAA GGTTGGAGTG GCAGAAACAT
    ATTACCGAAG GATTGAAGGA GTATTGTGCA TTAATTGATA GCTCGAGTAG TTTCCGAGCT
    TACCGACAGG CACTGGCTGA GACGCAGCCG CCGTGTATTC CGTATATTGG TTTGGTTCTA
    CAAGATTTGA CGTTTGTACA TATCGGAAAC AGTGATCTGT TGCCTGACAA TAGCATTAAT
    TTCTCGAAAC GATGGCAACA GTTTAACATT GTAGAAAATA TGAAGCGATT TAAGAAAGGA
    ACATACAGTT TCAAGAAGAA CGAACGCATC ATTACTTTCT TCAACAACTT TAGCGATTTT
    CTTTGCGAAG AAGCAATGTG GCAGATCTCG GAGAGCATAA AGCCCCGTGG TGGCAAGAAA
    CCACAGACTT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011500436.1
    CDS1..3792
    Translation

    Target ORF information:

    RefSeq Version XM_011502134.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali guanine nucleotide-releasing factor 2 (LOC105364247), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502134.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGCGCGAAC AGCACGCGCA CCGGACGCCT CGAGTCGCGA TATCTGCCGG CGACTTCGTA 
    CGGGAGGAGA GGATTCGTGG GCCAGTGAAG AGCGCCGAGA GAGAAGAGCC TTTTCCACTT
    AACCTGTCGG GTAAATTCGT AAATTTGGAG AAGCCCCCAC TGCCCAGACA TTGCCGGAAA
    GAGGTCGAGG AGCGACCGCC GGGGAAGGCG CGCGGGGGTA AGTTAGCGCG TCGTGCGCGC
    TCCTTCAAGG AGGACTTCTT GGAGAAGCTC TCGCAGATGC GGTCACCCGG GGGAGGTGGG
    GGCGGTAGTG CCGGCGGTAC GCGGGCCGTC TCGCCCTCGT CGCCGAGGAC ACCTCGGGAG
    CCACTAGGAG CCGGCGCTGC GACTACCACC ACCGCCGCCG TCTCCGCTGC TGGCGAGCAG
    CTCGACAAGA ACCCGCTGCG CGACCTCCAT GTCCATGTGC GCCAGGTGCA GCTGGCTCTC
    CTGCACTTTC GCGACGTCGT CTCCAAGAAC AAGCTAGAGA TGCTTCCGGG CAACGGGACC
    GTCGTACTTG ACACAGTCAC CACCATACAC ACCCTCCTCA AGTCGTATCT GCTTTATGAG
    AACAGCTCGA CGCTCGGCTC GGCGACGAAT CAGGTTTATC AGGCGCTGGC GCAGCTACTA
    AAGCTCTGCG ACGATGTGCT CCTGCACGGC GATCAGTCCT CGGCACTCGA CACGGCCAAC
    GTCACCCACG TCATTGGACT CGTCGAGGAC GCCGTGAAGA ATCTCGTGGA GCTCGCGCAG
    GAAAAGATCT CCAACAAGCA AAAGCCAGCA TTGCAGACCG CCAGCAATAG GACATCGGGC
    TACAGCTCCG AGTTGACGCC CCAACGCAGT TCCCTGCCGG ACATCCCGCT GACGCCGAGG
    GAGCGCCAGA TCCTCGAGCA GACCGCGGCC TCGAGCGCCC TCGTCAGGAG CTCCCACAGC
    TCCGAGTCCA TCCTCAGGGA TTCGAGTCCG CCGCCCCAGC CTCCGCTGCC CGATAGGACA
    CTCTGTCTTT CGGAGGACAA TAGCTCGTCG GGGACGACGC CCCCGCCACT GCCCCCGAAG
    AGGCGCACGC GCCACCAGCA GCAGCTCCAC CAGGAGGATC GGGAGTCGGA GACCGGCGCC
    TTGGCTACGT GCCTAGACCG GGTATCCTTA CGCAGTCGCT CGCCCGAGGA CTCGTCCTCG
    CTGCTCAGCG CCTCTGCCGG GAGTCTCGAC TCCGCGCTCA ACCATTCGCG CGACGAGGAC
    GAGATACGCG CCATTATGGG GCCAAACGAC GAGTCCTTCG GCGACAGCAT GGACCTCAGC
    CTCATGGCTA CCATTCAGGG AATGCAAGTT AACGGGAGCT CGCACTGCGG CTGCTGGGAC
    GGATCGGAAA CGAGTCTGCC GAGCACGATG CTGTTGGGTC AGCAGACCTC CCAGGAAATG
    CTCGGCCAGT TTACCGGCAT AGAGGCTAAA ATGGAACGCC TCTCGACGCA GACCCAGGAG
    TCCGGCTTCC TCTCCATGCA CTCGCAGCGC TCCTCCTCGC AGAGCTACAC CGCGACGACG
    GCTAACCTCG TGTCGAAGCG CCTCTCCCAG CAGAGTAGCG TCAGCTACAA CTCCCAGAAC
    GTGCAATCGT ACTCCCAGCA GAGGCTTTCA TCCGCCAGCG AGGCCAACAG CAACGGCTCG
    ACCACCGTAA GCCACAAGTC GACCACCACC ACCATGACCA GCTCCAGGAG CGTCCACAGT
    ACCACCAACC TCGGCGCCGA GCCCTCCTTC ATGGAAACAT TGGTAAACGA GATGGAGGCG
    CTGGCGAATT CGGACGCCAA CGGCGGAATG CCACCGGCGT TGCCGGAAAA ACGCTCGAAG
    CGCCGAAAAG AGCGGCTCCA CTCGCAGTAC GATAATGTGC CGGAGAACGA GCATTTATCG
    ACGTGCAGTT TGCACGCGAG CAACGGCAAC AGTCCCATCG ACAATAATAG GCCGCCCCCA
    CTGCCGATGA AGAAGAGACA TATAATGGCA TACATGGAGA TGTTCGGCAA TTGCTCGCAC
    AGTAATAGCG ACTTCATCCC GGGCCTCGGT GCCAGGCACT CCGTAGCCGC TTACAATTCC
    ATGCAATCCG AATGGCAACA GCACGAAATG GCACTGACGA CTACGCAGTC CTGCTCCTTC
    ATGACGCACA CACTCACGAG CTTGCACGAC GGTACCAGCC ACGCGTTCAC GATGGTACCG
    ACGATAAGAG AAATCGTAAA CGATTCCAGT GTACCCCCGG CATTACCACC AAAGAGGTCG
    CGCTCCGTTA AGGCGAGCGC GACGCCGCCC CCAGTGTCCC CGAAGCCGGC GGCTCCCGGG
    ATGCAGAGTC CCCACGTCGG CAGCCTCGAC CCCATCATCA CGTCGACACC AGTCAAAGCC
    GAGGAACCCA TCTCCTACTC GCCACTTTCA TTCGACAAGA AGGAGATCCT CAACGCTAAC
    AACGTATCAC TGAATAATAA TCTCAATTTG GACTCGTCGC CAAGATCATC GAGCAAAGCA
    CCTTCCTGCA TATCGATCGA CGAAAACTCC ATGGAATTAC GAGACGTCGA TCAAGATGAC
    AACATGTTAG ATGAATTAGA GATAAATAAG TATTTGGTTT TTAAGAAGCC GGAGGAGGAT
    GGTCCAGACA TACGTGGCGG TCATCCGGAT GCGTTATTAA TTCACGCGAC AAAAGCAAAC
    AAACATGATT TCCTGTATCA GGAAGCCTTC TTAACGACAT ATAGAACATT CATGTCACCG
    TTGGAGTTGA TAAAAAAATT ACACAGGCGG CATCAGCGAT TCTCATGTTC GTCAGATGTA
    GTGAAGCAGC GAGCAGCTAG AGAAGCGTTT TCTCTGCTAG TTCGAGTTGT TAGCGATTTG
    ACGATATCCG ATCTCGACGA CACCCTACTC CAGACCTTGA TGGAGTTCGT CCAGCAATTA
    GTCTGCAGCG GCGACCTAAC GATGGCCAAG GCCCTGCGCG TCAAGATCCT GGAAAAGCAT
    GCGTGCAAGC AGCTCCAGGC GGCGCAGCCG ATCCTCGCGT CCTTGAGCGT CTCGACCAAG
    CAAGCCTCGC TCTTGGACTT TAAAAGCGAG CAGATAGCCG AACAGATGAC GCTTCTCGAC
    GCCGAGCTCT TCATGAAGAT CGAAATACCG GAGGTGCTAA TCTGGGCCCA GGAACAAAAT
    GAGGAGCGCA GTCCGAATCT CACCAGATTC ACCGAACACT TCAACAAGAT GTCGTACTGG
    GCACGATCGA GAATCTTGGA GCACAGGTTG GAGAACGAGG CAAAAGACAG AGAGAAATAC
    GTTGTGAAGT TCATTAAAAT TATGAAGCAT TTGAGGAAGA TCAACAATTT TAATAGCTAC
    TTGGCACTAT TATCGGCTTT GGATAGTGCG CCCATTAGAA GGTTGGAGTG GCAGAAACAT
    ATTACCGAAG GATTGAAGGA GTATTGTGCA TTAATTGATA GCTCGAGTAG TTTCCGAGCT
    TACCGACAGG CACTGGCTGA GACGCAGCCG CCGTGTATTC CGTATATTGG TTTGGTTCTA
    CAAGATTTGA CGTTTGTACA TATCGGAAAC AGTGATCTGT TGCCTGACAA TAGCATTAAT
    TTCTCGAAAC GATGGCAACA GTTTAACATT GTAGAAAATA TGAAGCGATT TAAGAAAGGA
    ACATACAGTT TCAAGAAGAA CGAACGCATC ATTACTTTCT TCAACAACTT TAGCGATTTT
    CTTTGCGAAG AAGCAATGTG GCAGATCTCG GAGAGCATAA AGCCCCGTGG TGGCAAGAAA
    CCACAGACTT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.