IRS4 cDNA ORF clone, Camelus ferus(Wild Bactrian camel)

The following IRS4 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the IRS4 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCa54940 XM_006195783.1
Latest version!
Camelus ferus insulin receptor substrate 4 (IRS4), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCa54940
    Clone ID Related Accession (Same CDS sequence) XM_006195783.1
    Accession Version XM_006195783.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2724bp)
    Protein sequence
    SNP
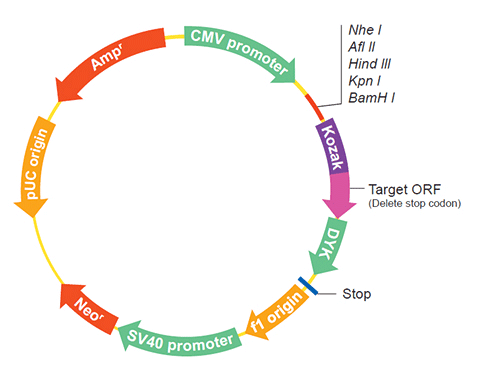
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
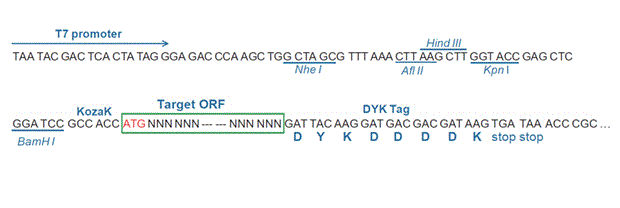
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-11-02
    Organism Camelus ferus(Wild Bactrian camel)
    Product LOW QUALITY PROTEIN: insulin receptor substrate 4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_006212166.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Camelus ferus Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 9% of CDS bases frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGGGCATGA ATCCTTTGAG GAAAAAGGGC ATTCCATCAG GCAGACATCA CCAAGCCTTG 
    CCATCAGTCA TGGAGCACCT GAGCACCATT AAAAGCAATC TGGAGGAGGA GGTAGTCGGC
    ATTGACTCGC GGGCTTTTGT CAGGGCTGGA GCGGGCTCGG GAGTGCCTGC AGCGCGATGG
    GCGGCAGGTC TGAGGGCCCT GGTCGTTAAC ACGTTTCTAG GGGGTGCCCA CACTTTCCCC
    AGAGACTCTC AGCTCGAGTT CTACAAAGAT GTGTGGCAGG TAATAGTCAA ACCCAGGGGG
    CTGGGGCACA GGAAAGAGCT GAGCGGCGTG TTCCGGCTAT GTCTTACCGA CGAGGAGGTT
    GTGTTTGTGA GGCTAAATAC CGAAGTGGCC AGCGTGGTCG TCCAGCTCCT GAGCATCCGT
    CGCTGCGGGC ACTCGGAGCA GTATTTCTTC TTGGAAGTCG GCAGGTCCAC CGTCATCGGC
    CCAGGAGAGC TCTGGATCTG GCTCAGAAGG TCCCGCTTTG AGCAGTTTTG CCACCTCAGA
    GCCATCGGTG ACGGGGAAGA CGAGATGCTC CTCACCAGGC GCTGCATAAC ACCCAGTGAG
    CCTGTGCCCC CTTCCAGGCG AGGAAGACTG CACCTGCCCA GAACGCGCAG GTCCAGGAGA
    GCAATTTCAG TGCCAGCTGG CTTTTTTCGG CGCTTAGCAC CCAGCCCTGT GCGTGCCCCG
    CACCCAGAAG CCCCCAACGA GGGAACTTGC CTGTCTTCTG AAGCATCTGG TTCCGGCTCT
    GGCAACTCTG GGGAAGAAGG CAGTCCTCAG GGCAAAGAGG ATCAGGAAGG AAACAGAGGC
    GACTATATGC CCATGAACAA CTGGGGCTCA GGAAATGGCC GAGGCTCAGG AGGTGGACAG
    GGTTCGAGTG GCCAAGGCTC CAGTAGCCAG AGCTCAGGAG GAAACCAGTG CTCAGGCAGG
    GGGCACGGCT CTGGAAGTGG CCAGGGCTCA AGTGGCAGCC AGGGCTCAAG TGGCCAGGGA
    TCCGGGGGCC AAGGTGCAGG AGGAAACCAG TGCTCAGGAG ATGGCCAGGG TACCACCGGT
    GGGCACGGCT CAGGCAGTGG TCAGGGAGCT GGAGGTGGAC ACGGCTCAGG CCGTGGCCAG
    GGGCCTGGAG ATGGTCATGG CTCAGGTGGT GGCAAGAACT CTGGTGGGGG CAAAGGCTCA
    GGAAGTGGCA AAGGCTCGGA TGGCGATGGT GAACGTGGGA AATCTCTGAA GAAAAGATCC
    TACTTTGGCA AATTAACTCA GAGCAAGCAA CAGCAAATGC CACCACCTCT ACCACCTCCC
    CCTCCACCCC CGCCAGTTGC AGCAACTGGT GGGAAAGGGA AGTCTGGAGG AAGGTTCCGA
    CTTTATTTCT GTGCCGACAG AGGAGCCACA AAAGAACGCA AAGAAGCCAA AGAAGTTAAA
    GACACAGAGA CCCCAGAAGG TGCAGCTCGG GGTCCTTACA GAGCCAGAGC TTTTGATGAA
    GATGAGGATG ACCCATATGT GCCAATGAGG CCAGGGGTGG CTGCCCCTCT CGCAAGCTCC
    AGTGATTATA TGCCAATGGC TCCTCAAAAT GTCTCTTCTT CGAAAAAGCG CCACTCTCGA
    TCACCTTTTG AAGATTCGAG GGGTTACATG ATGATGTTTC CCAGAGTGAG CCCACCACCT
    GCCCCAAGCC CTCCAAAAGT CCCTGATCCT GATAAAGAGG ATGACTCAAA GGACAATGAC
    AGTGACAGTG ACTACATGTT TATGGCTCCT GGAGCTGGTG CAATTCCAAA AAACCCCAGA
    AGTCCCCAGG GAGGCTCTTC CTCCAAAAGT TGGAGCTCCT ACTTCTCTCT GCCAAATCCT
    TTTCGGAGCT CCCCGCTGGG ACGGAGTGAC CACAGTGAGT ATGTACCAAT GTTACCTGGA
    AAATTCCTGG GGAAGGGCCT TGACAAAGAA GCCTCATCTA CCGGTGGCCC CGAAGATGTA
    GCTTCAAAGC CTTCAGTTGC GGGGTCATTC TCAAAGCCTA GAGACGGAGG ATCACCTTCA
    AAGCCTTCAG GTGATGGGCC CCCCAAGAAC AAGGCTAAGA GACCTAACCG ACTTTCTTTT
    ATTACAAAAG GAAATAAAAT CAAGCCAAAA CCACAAAAGC CCACACATGA GCAGAAAGAA
    GTTGACAGTG CTAGCGACTA CGTCAACATT GACTTCCCCA AGAGAGACAG GAATACGCCA
    GCTCCTCGTA TTCAAAGACT GCCAGATTTG TGGGGCATAA TTGCCGACCC CAGACAGTTC
    GCCTTTTCTA ATTACGTGAA TGTGAAGTTC GGAGTGCCAT TTCCAAATCC AGCAAACGAC
    CTCTCAGATC TTTTAAGAGC TATTCCAGGT GCCAACCCCT TCTCTCTGGA CGGTGCTAGG
    TGGCCACTTC CGCCTCTTCC TCCCAGTGCT ACAGGTAATG ATGCTAATGA GGAAGAAGGT
    GACTACATTG AAGTGATTTT CAACCCAGCG ATGACACCAG CCGTGCCTTT TGCTGACAGT
    GCCATTCGCT ACGATGCTGA AACAGGTCGA ATCTACGTGG TCGACCCATT TTCGGAGTGC
    TGTATGGACA TTTCTCTCTC CCCCAGCCGC TGCTCGGAGC CACCACCTGT AGCTAGGCTG
    CTGTTGGAAG GACAGCTAGA GAGAAGACGC CCTCAAAGCC GCTCGCAAAG TTTCTCTGCA
    TCCGCCAGAG CCGCTGATGA ATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_006195845.1
    CDS1..2724
    Translation

    Target ORF information:

    RefSeq Version XM_006195783.1
    Organism Camelus ferus(Wild Bactrian camel)
    Definition Camelus ferus insulin receptor substrate 4 (IRS4), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_006195783.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGGGCATGA ATCCTTTGAG GAAAAAGGGC ATTCCATCAG GCAGACATCA CCAAGCCTTG 
    CCATCAGTCA TGGAGCACCT GAGCACCATT AAAAGCAATC TGGAGGAGGA GGTAGTCGGC
    ATTGACTCGC GGGCTTTTGT CAGGGCTGGA GCGGGCTCGG GAGTGCCTGC AGCGCGATGG
    GCGGCAGGTC TGAGGGCCCT GGTCGTTAAC ACGTTTCTAG GGGGTGCCCA CACTTTCCCC
    AGAGACTCTC AGCTCGAGTT CTACAAAGAT GTGTGGCAGG TAATAGTCAA ACCCAGGGGG
    CTGGGGCACA GGAAAGAGCT GAGCGGCGTG TTCCGGCTAT GTCTTACCGA CGAGGAGGTT
    GTGTTTGTGA GGCTAAATAC CGAAGTGGCC AGCGTGGTCG TCCAGCTCCT GAGCATCCGT
    CGCTGCGGGC ACTCGGAGCA GTATTTCTTC TTGGAAGTCG GCAGGTCCAC CGTCATCGGC
    CCAGGAGAGC TCTGGATCTG GCTCAGAAGG TCCCGCTTTG AGCAGTTTTG CCACCTCAGA
    GCCATCGGTG ACGGGGAAGA CGAGATGCTC CTCACCAGGC GCTGCATAAC ACCCAGTGAG
    CCTGTGCCCC CTTCCAGGCG AGGAAGACTG CACCTGCCCA GAACGCGCAG GTCCAGGAGA
    GCAATTTCAG TGCCAGCTGG CTTTTTTCGG CGCTTAGCAC CCAGCCCTGT GCGTGCCCCG
    CACCCAGAAG CCCCCAACGA GGGAACTTGC CTGTCTTCTG AAGCATCTGG TTCCGGCTCT
    GGCAACTCTG GGGAAGAAGG CAGTCCTCAG GGCAAAGAGG ATCAGGAAGG AAACAGAGGC
    GACTATATGC CCATGAACAA CTGGGGCTCA GGAAATGGCC GAGGCTCAGG AGGTGGACAG
    GGTTCGAGTG GCCAAGGCTC CAGTAGCCAG AGCTCAGGAG GAAACCAGTG CTCAGGCAGG
    GGGCACGGCT CTGGAAGTGG CCAGGGCTCA AGTGGCAGCC AGGGCTCAAG TGGCCAGGGA
    TCCGGGGGCC AAGGTGCAGG AGGAAACCAG TGCTCAGGAG ATGGCCAGGG TACCACCGGT
    GGGCACGGCT CAGGCAGTGG TCAGGGAGCT GGAGGTGGAC ACGGCTCAGG CCGTGGCCAG
    GGGCCTGGAG ATGGTCATGG CTCAGGTGGT GGCAAGAACT CTGGTGGGGG CAAAGGCTCA
    GGAAGTGGCA AAGGCTCGGA TGGCGATGGT GAACGTGGGA AATCTCTGAA GAAAAGATCC
    TACTTTGGCA AATTAACTCA GAGCAAGCAA CAGCAAATGC CACCACCTCT ACCACCTCCC
    CCTCCACCCC CGCCAGTTGC AGCAACTGGT GGGAAAGGGA AGTCTGGAGG AAGGTTCCGA
    CTTTATTTCT GTGCCGACAG AGGAGCCACA AAAGAACGCA AAGAAGCCAA AGAAGTTAAA
    GACACAGAGA CCCCAGAAGG TGCAGCTCGG GGTCCTTACA GAGCCAGAGC TTTTGATGAA
    GATGAGGATG ACCCATATGT GCCAATGAGG CCAGGGGTGG CTGCCCCTCT CGCAAGCTCC
    AGTGATTATA TGCCAATGGC TCCTCAAAAT GTCTCTTCTT CGAAAAAGCG CCACTCTCGA
    TCACCTTTTG AAGATTCGAG GGGTTACATG ATGATGTTTC CCAGAGTGAG CCCACCACCT
    GCCCCAAGCC CTCCAAAAGT CCCTGATCCT GATAAAGAGG ATGACTCAAA GGACAATGAC
    AGTGACAGTG ACTACATGTT TATGGCTCCT GGAGCTGGTG CAATTCCAAA AAACCCCAGA
    AGTCCCCAGG GAGGCTCTTC CTCCAAAAGT TGGAGCTCCT ACTTCTCTCT GCCAAATCCT
    TTTCGGAGCT CCCCGCTGGG ACGGAGTGAC CACAGTGAGT ATGTACCAAT GTTACCTGGA
    AAATTCCTGG GGAAGGGCCT TGACAAAGAA GCCTCATCTA CCGGTGGCCC CGAAGATGTA
    GCTTCAAAGC CTTCAGTTGC GGGGTCATTC TCAAAGCCTA GAGACGGAGG ATCACCTTCA
    AAGCCTTCAG GTGATGGGCC CCCCAAGAAC AAGGCTAAGA GACCTAACCG ACTTTCTTTT
    ATTACAAAAG GAAATAAAAT CAAGCCAAAA CCACAAAAGC CCACACATGA GCAGAAAGAA
    GTTGACAGTG CTAGCGACTA CGTCAACATT GACTTCCCCA AGAGAGACAG GAATACGCCA
    GCTCCTCGTA TTCAAAGACT GCCAGATTTG TGGGGCATAA TTGCCGACCC CAGACAGTTC
    GCCTTTTCTA ATTACGTGAA TGTGAAGTTC GGAGTGCCAT TTCCAAATCC AGCAAACGAC
    CTCTCAGATC TTTTAAGAGC TATTCCAGGT GCCAACCCCT TCTCTCTGGA CGGTGCTAGG
    TGGCCACTTC CGCCTCTTCC TCCCAGTGCT ACAGGTAATG ATGCTAATGA GGAAGAAGGT
    GACTACATTG AAGTGATTTT CAACCCAGCG ATGACACCAG CCGTGCCTTT TGCTGACAGT
    GCCATTCGCT ACGATGCTGA AACAGGTCGA ATCTACGTGG TCGACCCATT TTCGGAGTGC
    TGTATGGACA TTTCTCTCTC CCCCAGCCGC TGCTCGGAGC CACCACCTGT AGCTAGGCTG
    CTGTTGGAAG GACAGCTAGA GAGAAGACGC CCTCAAAGCC GCTCGCAAAG TTTCTCTGCA
    TCCGCCAGAG CCGCTGATGA ATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.