PLA2G4E cDNA ORF clone, Camelus ferus(Wild Bactrian camel)

The following PLA2G4E gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the PLA2G4E cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCa38609 XM_006178854.2
Latest version!
Camelus ferus phospholipase A2, group IVE (PLA2G4E), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCa38609
    Clone ID Related Accession (Same CDS sequence) XM_006178854.2
    Accession Version XM_006178854.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2592bp)
    Protein sequence
    SNP
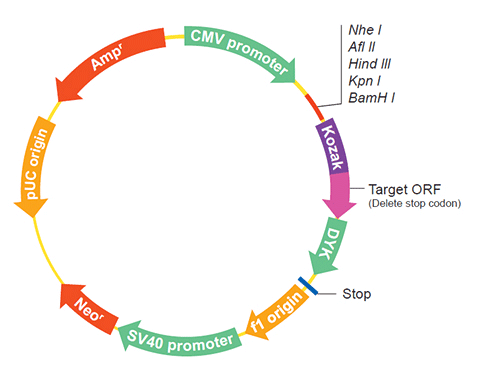
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
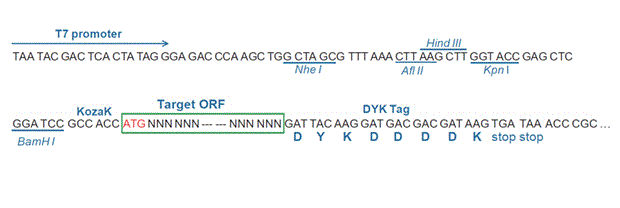
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-11-02
    Organism Camelus ferus(Wild Bactrian camel)
    Product cytosolic phospholipase A2 epsilon
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_006210562.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Nov 3, 2015 this sequence version replaced XM_006178854.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Camelus ferus Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTCTCC AGGCCTCGGA AGGCCAGCCA GGCCTGGAAA CTGATGTGTT TGTCCCGCAG 
    AGCCTGCAAG GGGATGAGGA AGACAGCATG TCAGGGAGAA CCGTCAGTGA GCTGGAGCAC
    ACACAGGTCC TGGAGACTCC CGATCTCCCA CCTCTACTTC CCGTGGCCCC TGGGGGCTCT
    CAGGAGGAGC TGTCTCCATG CCACCTGCTG ACAGTGAGGG TCGTCCGGAT GAAAAACGTC
    CGACAGGCTG ATTTGGTGAG CCAAACAGAC TGTTTTGTGA GCCTCTGGCT GCCCACCGCC
    TCTTGTAAGA GGCTGAGGAC TCGGACCATC TCCAACTGCC CAAATCCAGA GTGGAATGAG
    ACCTTCAACT TCCAGATCCA GAGCCGAGTG AAGAACGTGC TAGAGCTGAG CGTCTGTGAT
    GAAGACACAA TGACACCAGA TGACCATCTC TTGACAGTTC TCTATGACCT CACCAAGCTC
    TGCTTCCGAA AGAAAACCCA CCTGAAGTTC CCACTCAACC CAGAGGGCAT GGAGGAGCTG
    GAGGTGGAGT TCCTGCTAGA AGAGAGTCCC TCTCCACCTG AGAGCCTCAT CACCAACGGC
    GTGCTGGTGT CTCGACAAAT GTCCTGCCTG GAGGTTCATG CAGAATCCAG GAGGCAGAAG
    AAGAATAGGA AAAGGACGGA CTTCCTGGTG ACAGTGACGC AGTCCTTCGA GCACACCCAG
    CGCATCTCAT GCAGCCAGGA GCCCTGCTGC CCAAATCCTG CCTGCTTCCA CTACCCCAAG
    TACTTCCAGC CCCAGGTACA CGTGGAGGTG CCCAAGAGCC AGTGGAGCTG CAAGCTTTGC
    TGCTGCTGTG CGCACAAGAA CAGCCCTGTC TGCCAGCCCC TTGATTGCCT CCCCGATGGC
    CAGACAGTGA ACCTGCCTGT GAGCGAGAAC TGTGAATTGC ACATGAAGTC TACACCCTGC
    TCCCAGACTC TGGACGTGCG GCTGGGCTTC AGCCTGTGCC AGGCAGAGCA GGAGTTCCTG
    CAGAAGCGGA GGGTGGTGGT GGCCGAGGCA CTGAAGCAGG TGTTGCAGCT GGAGGAGGAC
    CTGCAGGTGG ACGAGGTACC ACTGATAGCC ATCATGGCCA CTGGGGGTGG AACGAGATCC
    ATGACCGCCA TGTACGGCCA CCTGCTCGGG CTGCAGAAGC TGAACATCCT CAACTGTGCC
    AGCTACATCA CTGGCCTGTC AGGGGCCACC TGGACCATGG CTACCTTGTA CCGTGACCCT
    GACTGGTCCT CCAAAAACCT GGAGCCTGCC ATCTTTGAGG CGCGGAGGCA CGTAGTCAAG
    GACAAGCTGC CTGCCCTGTA TCCAGACCAG CTCTTGAAAT TCCGGGAGGA GCTTCAGCAG
    CGCAGGCAGG AAGGCTACAA GGTCACCTTT ACAGACTTCT GGGGCCTGCT GATTGAGGCC
    TGTCTGGGGG ACGAGAGAAA TGAATGCAAA CTTTCAGAGC AGCGTGCTGC TTTGTGCCAG
    GGCCAGAACC CCCTCCCCAT CTACCTCACC ATCAATGTCA AGGATGATGT AAGCAACCAG
    GATTTCAGAG AGTGGTGCGA GTTCTCTCCC TACGAGGTGG GCCTGCAGAA GTACGGCGCC
    TTCATCCCCA CCGAGCTCTT TGGCTCCGAG TTCTTCATGG GGCGGCTGAT GAGGAGGATC
    CCAGAGTCCC GAATGTGCTA CATGCTAGGT TTGTGGAGCA GCATCTTCTC CCTGAACCTG
    CTTGATGCCT GGAATCTGTC CCATACCTCG GAGGAGTTTT TCTACAAGTG GACAAGGGAG
    AGAGTGCACG ATATTGAAGA TGAGCCGCTC CTGCCTGAAA TCCCTAAATG TGATGCCAAT
    GTCCTGGAAA CCACAGTGGT GACACCGGCA TCCTGGCTGT CCAATACTTT CCGCACCATC
    CTCACCTATC GATCCTTCGT GTCTGAGTTC CACAACTTCC TGCTGGGACT GCAGCTGCAC
    ACTGACTACC TCCAGAGCAG CGAGTTCTCC AAGTGGAAAG ACACGGTGCT GGACAGCTTC
    CCAAACCAGC TGACACCGTC CGTGAACCAT TTGTGCCTGC TGGACACTGC GTTCTTTGTC
    AACTCCAGCT ACCCACCCCT CCTCAGGCCT GAGAGAAAAG TTGACCTCAT CATCCACCTC
    AATTACTGTG CGGGGTCCCA GACAAAGCCC ATGAAACAAA CGTGCGAGTA CTCCACTGTG
    CAGAACATCC CCTTTCCCAA ATATGAGCTG CAGGAGGAGG ATGATAAGCT GAAGGAGTGC
    TACCTGATGG AGAACTCCCA GGAACCTGAT GCCCCCACTG TGGTTTTCTT CCCACTCATC
    AATGACACCT TCCAAAAGTA CAAGGCCCCA GGTGTGGAGC GAAGCCCCGA GGAGCTGGAG
    CAGGGCCAGG TTGACATCTA TGGTCCCAAA ACTCCCTACG CCACCAAGGA ACTGACATAC
    ACGGAGGCCG CCTTTGACAA GCTGGTGAAG CTCTCCGAGT ACAACATCCT GAATAACAAG
    GACAAGCTCC TTGAGGCCTT GAGACTGGCG ATGGAGAAGA AGAAACGCCT GAAGGGCCAG
    GGTCCTTCTT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_006178916.1
    CDS1..2592
    Translation

    Target ORF information:

    RefSeq Version XM_006178854.2
    Organism Camelus ferus(Wild Bactrian camel)
    Definition Camelus ferus phospholipase A2, group IVE (PLA2G4E), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_006178854.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTCTCC AGGCCTCGGA AGGCCAGCCA GGCCTGGAAA CTGATGTGTT TGTCCCGCAG 
    AGCCTGCAAG GGGATGAGGA AGACAGCATG TCAGGGAGAA CCGTCAGTGA GCTGGAGCAC
    ACACAGGTCC TGGAGACTCC CGATCTCCCA CCTCTACTTC CCGTGGCCCC TGGGGGCTCT
    CAGGAGGAGC TGTCTCCATG CCACCTGCTG ACAGTGAGGG TCGTCCGGAT GAAAAACGTC
    CGACAGGCTG ATTTGGTGAG CCAAACAGAC TGTTTTGTGA GCCTCTGGCT GCCCACCGCC
    TCTTGTAAGA GGCTGAGGAC TCGGACCATC TCCAACTGCC CAAATCCAGA GTGGAATGAG
    ACCTTCAACT TCCAGATCCA GAGCCGAGTG AAGAACGTGC TAGAGCTGAG CGTCTGTGAT
    GAAGACACAA TGACACCAGA TGACCATCTC TTGACAGTTC TCTATGACCT CACCAAGCTC
    TGCTTCCGAA AGAAAACCCA CCTGAAGTTC CCACTCAACC CAGAGGGCAT GGAGGAGCTG
    GAGGTGGAGT TCCTGCTAGA AGAGAGTCCC TCTCCACCTG AGAGCCTCAT CACCAACGGC
    GTGCTGGTGT CTCGACAAAT GTCCTGCCTG GAGGTTCATG CAGAATCCAG GAGGCAGAAG
    AAGAATAGGA AAAGGACGGA CTTCCTGGTG ACAGTGACGC AGTCCTTCGA GCACACCCAG
    CGCATCTCAT GCAGCCAGGA GCCCTGCTGC CCAAATCCTG CCTGCTTCCA CTACCCCAAG
    TACTTCCAGC CCCAGGTACA CGTGGAGGTG CCCAAGAGCC AGTGGAGCTG CAAGCTTTGC
    TGCTGCTGTG CGCACAAGAA CAGCCCTGTC TGCCAGCCCC TTGATTGCCT CCCCGATGGC
    CAGACAGTGA ACCTGCCTGT GAGCGAGAAC TGTGAATTGC ACATGAAGTC TACACCCTGC
    TCCCAGACTC TGGACGTGCG GCTGGGCTTC AGCCTGTGCC AGGCAGAGCA GGAGTTCCTG
    CAGAAGCGGA GGGTGGTGGT GGCCGAGGCA CTGAAGCAGG TGTTGCAGCT GGAGGAGGAC
    CTGCAGGTGG ACGAGGTACC ACTGATAGCC ATCATGGCCA CTGGGGGTGG AACGAGATCC
    ATGACCGCCA TGTACGGCCA CCTGCTCGGG CTGCAGAAGC TGAACATCCT CAACTGTGCC
    AGCTACATCA CTGGCCTGTC AGGGGCCACC TGGACCATGG CTACCTTGTA CCGTGACCCT
    GACTGGTCCT CCAAAAACCT GGAGCCTGCC ATCTTTGAGG CGCGGAGGCA CGTAGTCAAG
    GACAAGCTGC CTGCCCTGTA TCCAGACCAG CTCTTGAAAT TCCGGGAGGA GCTTCAGCAG
    CGCAGGCAGG AAGGCTACAA GGTCACCTTT ACAGACTTCT GGGGCCTGCT GATTGAGGCC
    TGTCTGGGGG ACGAGAGAAA TGAATGCAAA CTTTCAGAGC AGCGTGCTGC TTTGTGCCAG
    GGCCAGAACC CCCTCCCCAT CTACCTCACC ATCAATGTCA AGGATGATGT AAGCAACCAG
    GATTTCAGAG AGTGGTGCGA GTTCTCTCCC TACGAGGTGG GCCTGCAGAA GTACGGCGCC
    TTCATCCCCA CCGAGCTCTT TGGCTCCGAG TTCTTCATGG GGCGGCTGAT GAGGAGGATC
    CCAGAGTCCC GAATGTGCTA CATGCTAGGT TTGTGGAGCA GCATCTTCTC CCTGAACCTG
    CTTGATGCCT GGAATCTGTC CCATACCTCG GAGGAGTTTT TCTACAAGTG GACAAGGGAG
    AGAGTGCACG ATATTGAAGA TGAGCCGCTC CTGCCTGAAA TCCCTAAATG TGATGCCAAT
    GTCCTGGAAA CCACAGTGGT GACACCGGCA TCCTGGCTGT CCAATACTTT CCGCACCATC
    CTCACCTATC GATCCTTCGT GTCTGAGTTC CACAACTTCC TGCTGGGACT GCAGCTGCAC
    ACTGACTACC TCCAGAGCAG CGAGTTCTCC AAGTGGAAAG ACACGGTGCT GGACAGCTTC
    CCAAACCAGC TGACACCGTC CGTGAACCAT TTGTGCCTGC TGGACACTGC GTTCTTTGTC
    AACTCCAGCT ACCCACCCCT CCTCAGGCCT GAGAGAAAAG TTGACCTCAT CATCCACCTC
    AATTACTGTG CGGGGTCCCA GACAAAGCCC ATGAAACAAA CGTGCGAGTA CTCCACTGTG
    CAGAACATCC CCTTTCCCAA ATATGAGCTG CAGGAGGAGG ATGATAAGCT GAAGGAGTGC
    TACCTGATGG AGAACTCCCA GGAACCTGAT GCCCCCACTG TGGTTTTCTT CCCACTCATC
    AATGACACCT TCCAAAAGTA CAAGGCCCCA GGTGTGGAGC GAAGCCCCGA GGAGCTGGAG
    CAGGGCCAGG TTGACATCTA TGGTCCCAAA ACTCCCTACG CCACCAAGGA ACTGACATAC
    ACGGAGGCCG CCTTTGACAA GCTGGTGAAG CTCTCCGAGT ACAACATCCT GAATAACAAG
    GACAAGCTCC TTGAGGCCTT GAGACTGGCG ATGGAGAAGA AGAAACGCCT GAAGGGCCAG
    GGTCCTTCTT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.