DGKG cDNA ORF clone, Calidris pugnax(ruff)

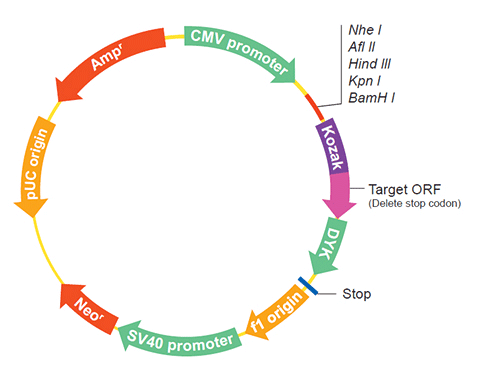
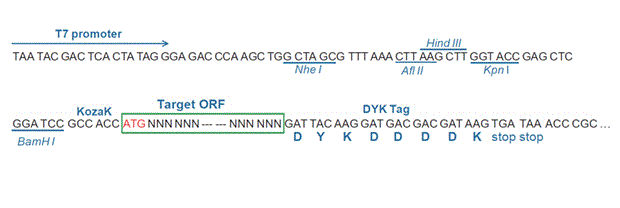
The following DGKG gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the DGKG cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCa80126 XM_014962954.1
Latest version!
Calidris pugnax diacylglycerol kinase gamma (DGKG), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OCa80127 XM_014962955.1
Latest version!
Calidris pugnax diacylglycerol kinase gamma (DGKG), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCa80126
    Clone ID Related Accession (Same CDS sequence) XM_014962954.1
    Accession Version XM_014962954.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2853bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-08
    Organism Calidris pugnax(ruff)
    Product diacylglycerol kinase gamma isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015094503.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Calidris pugnax Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    ATGCTGCCCT TTCCTCTGGG GCTGATTCAG GAGGAAGGTG CTGACCGGCT GCTCTGGCGC 
    TGGGGTTTGC TGCCCACGGG CTCAGCGGGA TGGTGCCAGC CAGCCAAGAG CCCCCCGTGC
    CCCTCACGGT GCCAATGTGA CCACGCTGGC TGGGACCTGC GGCACCGAGC CTGGCACGGG
    GAGCACAGTG ACTCGTGGTC CCCCTTTGGG GTGCACCGCC CCAAGATGAG CGATGGTGGG
    TGGATCTCGC TCAGCCCCAC TGAGTTTGCC CAGCTCCAGC AGTACACAGA CTATTCCACC
    AAGAAGCTCA AGGATGTCCT TGAGGAGTTC CACGGGGACG GTGTCCTCTC GAGGTACAAC
    CCGGAACAGC CCATCGACTA TGAGGGCTTT CGCCTCTTCA TGAAGACCTA CCTGGAGGCG
    GACGTGCCCG AGGAACTTTG CCAACACCTC TTCACCTCCT TCAAGCGTAA GATATGCCAA
    GCCTCCCCCG AGAGCCAGCG CCAGGGCCCC AGCGTCTCGC AGCTCAACAC CCTCGGGATC
    AACGGGAAAA TGCTCCTAAG TGCCCTGGGA CGACACACCC CTGAGCCCAA GAGCTGTCAC
    AGCAACGCAG CTGAGCCGCA GCCAGCGTCC CTTACCCCGG CGTCGATCCC CAACGCCTCC
    CCAAGCTGGT CCAGGTCCTC CTCCCAGAAG TCCACCACCG GCACCCCTTC TGCTCACAAC
    TCCTCGGGCT CTTCGAAGGT CTCCTCCGGG TCCCTGCTCA GCCCTCAGTC GCCAGGCACA
    CGGAGTGTGG AGAAGAGGTT GCCCTTCAGC CTGCGGAAGA GCCACAGCTC CCTGAAAGCC
    GCCCCGCCAC TGCCCACCGC CCCCCTGTCC CAGGTGGTCC ATCTGAAGGA CATCGTCTGC
    TACCTGTCCC TGCTGGAGAG GGGACGGGCA GAGGACAAGC TGGAGTTTAT GTTTCGCCTC
    TATGATACTG ATGGAAATGG CCTCCTGGAC AGCTCGGAGC TGGATCGTAT CATCAACCAG
    ATGGTGCATG TGGCTGAGTA CCTGGAGTGG GACTCCACCG AGCTGAAGCC TATCTTGAAG
    GCGATGATGG AGGAGATCGA CTATGACCAT GACGGGACCG TGACGCTTGA GGAGTGGATC
    CGGGGTGGCA TGACCACCAT CCCCTTACTG GTCCTCCTGG GGATGGAGAC AAACGTGAAG
    GACGACGGGC AGCACGCCTG GAGGCTGAAG CACTTCAAGA AACCTGCCTA CTGCAACTTC
    TGCCGCACCA TGCTGCTGGG GGTCCGCAAG CAAGGACTCT GCTGCTCCTT CTGCAAGTAC
    ACTGTCCACG AGAGGTGTGT GTCCAAAGAT ATCGCCTCCT GCATCAGCAC CTACATGAAA
    TCCAAGAGGA ACACAAGCGT GATGCAGCAC ACCTGGATTG AGGGCAATTC CCCCGTCAAG
    TGCGACAGAT GCCACAAGAG CATCAAGTGC TACCAGGGCA TCACCGGCCT GCACTGCGTC
    TGGTGCCAAG TCACACTCCA CAACAAATGT GCCTCCCACG TGAAGCCAGA GTGCGACGGG
    GGCCCGCTGC GGGACCACAT CTTGCTGCCT TCCTACATCT GCCCCGTCGT CCTGGACAGG
    CAGTCCCACT GCCGGAGGTC AGAGAGTGAC TCCCCTGCCA GCACCAGCCC CGAGGACAAC
    CAGGGCTTCA AGTTCAACTC CACCACGGTG GATGGGCAAG GTCTGCAGAT CAGCCCCCGG
    CCTGGCACAC ACCCCCTCCT GGTGCTCGTG AACCCCAAGA GCGGAGGAAG GCAAGGGGAG
    CGGGTCCTCC GGAAATTTCA CTACTTGCTC AACCCACGCC AAGTGTACAA CCTGGACCGT
    GGTGGGCCCG CACCAGGGCT GAGCTTCTTT CGAGACACTC CGGATTTCCG TGTCCTGGCC
    TGTGGGGGGG ATGGCACAGT GGGCTGGATC CTGGACTGCA TCGACAAAGC GAACTTGGTG
    AAGCACCCGC CGGTGGCCGT CCTGCCCCTG GGAACAGGCA ACGACCTGGC CCGGTGCCTG
    CGCTGGGGAG GAGGCTATGA AGGAGGAAAC CTGATGAAGG TCCTGAAAGA CATCGAGCAC
    AGCACGGAGG TGATGCTGGA CCGCTGGCAG ATAGATGTCA TTCCCAGTGA CAGAGAGGCC
    AACGGAGACC CTGTCCCATC CACCATCATC AACAACTACT TCTCCATTGG GGTGGACGCC
    TCCATCGCCC ACCGCTTCCA CGTCATGCGA GAAAAGCACC CCGAGAAATT CAACAGCAGG
    ATGAAGAACA AGCTGTGGTA CTTTGAGTTT GGGACATCGG AGACCTTTGC GGCCACCTGC
    AAGAAGCTCC ACGACTACGT TGAGGTGGAG TGCGACGGGA CCCTGCTGGA CCTGAGCAAC
    ACGTCCCTGG AGGGCATCGC CGTCCTCAAC ATCCCCAGCA TGTACGGCGG CTCCAACCTC
    TGGGGCGAGA CCAAGAAGCA GCGCAGTTAC AGCCGGCTGG GGAAGAAAGC CCCGGAGAAG
    CTGCAGGGCA CGGTGGTCAC CGATGCCAAG GAGCTCAAGT TCTGCGTGCA GGATCTCAGT
    GACCACCTCC TGGAGGTGGT GGGGCTGGAG GGCGCGATGG AGATGGGGCA GATCTACACG
    GGGCTGAAGA GCGCTGGGAA GAGACTGGCC CAGTGTTCAT CTGTCACCAT CAGGACCTCC
    AAGCTGCTGC CCATGCAGGT GGACGGGGAA CCCTGGATGC AGCCGTCCTG TACCGTCAAA
    ATTACACATA AAAGCCAAGT GCCGATGCTG CTGGGCCCCC CCCAGAAGAG CAGCTTCTTT
    TTCCTGAAGA GGAGAAACCG AACTCGAGAT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014818440.1
    CDS69..2921
    Translation

    Target ORF information:

    RefSeq Version XM_014962954.1
    Organism Calidris pugnax(ruff)
    Definition Calidris pugnax diacylglycerol kinase gamma (DGKG), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014962954.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    ATGCTGCCCT TTCCTCTGGG GCTGATTCAG GAGGAAGGTG CTGACCGGCT GCTCTGGCGC 
    TGGGGTTTGC TGCCCACGGG CTCAGCGGGA TGGTGCCAGC CAGCCAAGAG CCCCCCGTGC
    CCCTCACGGT GCCAATGTGA CCACGCTGGC TGGGACCTGC GGCACCGAGC CTGGCACGGG
    GAGCACAGTG ACTCGTGGTC CCCCTTTGGG GTGCACCGCC CCAAGATGAG CGATGGTGGG
    TGGATCTCGC TCAGCCCCAC TGAGTTTGCC CAGCTCCAGC AGTACACAGA CTATTCCACC
    AAGAAGCTCA AGGATGTCCT TGAGGAGTTC CACGGGGACG GTGTCCTCTC GAGGTACAAC
    CCGGAACAGC CCATCGACTA TGAGGGCTTT CGCCTCTTCA TGAAGACCTA CCTGGAGGCG
    GACGTGCCCG AGGAACTTTG CCAACACCTC TTCACCTCCT TCAAGCGTAA GATATGCCAA
    GCCTCCCCCG AGAGCCAGCG CCAGGGCCCC AGCGTCTCGC AGCTCAACAC CCTCGGGATC
    AACGGGAAAA TGCTCCTAAG TGCCCTGGGA CGACACACCC CTGAGCCCAA GAGCTGTCAC
    AGCAACGCAG CTGAGCCGCA GCCAGCGTCC CTTACCCCGG CGTCGATCCC CAACGCCTCC
    CCAAGCTGGT CCAGGTCCTC CTCCCAGAAG TCCACCACCG GCACCCCTTC TGCTCACAAC
    TCCTCGGGCT CTTCGAAGGT CTCCTCCGGG TCCCTGCTCA GCCCTCAGTC GCCAGGCACA
    CGGAGTGTGG AGAAGAGGTT GCCCTTCAGC CTGCGGAAGA GCCACAGCTC CCTGAAAGCC
    GCCCCGCCAC TGCCCACCGC CCCCCTGTCC CAGGTGGTCC ATCTGAAGGA CATCGTCTGC
    TACCTGTCCC TGCTGGAGAG GGGACGGGCA GAGGACAAGC TGGAGTTTAT GTTTCGCCTC
    TATGATACTG ATGGAAATGG CCTCCTGGAC AGCTCGGAGC TGGATCGTAT CATCAACCAG
    ATGGTGCATG TGGCTGAGTA CCTGGAGTGG GACTCCACCG AGCTGAAGCC TATCTTGAAG
    GCGATGATGG AGGAGATCGA CTATGACCAT GACGGGACCG TGACGCTTGA GGAGTGGATC
    CGGGGTGGCA TGACCACCAT CCCCTTACTG GTCCTCCTGG GGATGGAGAC AAACGTGAAG
    GACGACGGGC AGCACGCCTG GAGGCTGAAG CACTTCAAGA AACCTGCCTA CTGCAACTTC
    TGCCGCACCA TGCTGCTGGG GGTCCGCAAG CAAGGACTCT GCTGCTCCTT CTGCAAGTAC
    ACTGTCCACG AGAGGTGTGT GTCCAAAGAT ATCGCCTCCT GCATCAGCAC CTACATGAAA
    TCCAAGAGGA ACACAAGCGT GATGCAGCAC ACCTGGATTG AGGGCAATTC CCCCGTCAAG
    TGCGACAGAT GCCACAAGAG CATCAAGTGC TACCAGGGCA TCACCGGCCT GCACTGCGTC
    TGGTGCCAAG TCACACTCCA CAACAAATGT GCCTCCCACG TGAAGCCAGA GTGCGACGGG
    GGCCCGCTGC GGGACCACAT CTTGCTGCCT TCCTACATCT GCCCCGTCGT CCTGGACAGG
    CAGTCCCACT GCCGGAGGTC AGAGAGTGAC TCCCCTGCCA GCACCAGCCC CGAGGACAAC
    CAGGGCTTCA AGTTCAACTC CACCACGGTG GATGGGCAAG GTCTGCAGAT CAGCCCCCGG
    CCTGGCACAC ACCCCCTCCT GGTGCTCGTG AACCCCAAGA GCGGAGGAAG GCAAGGGGAG
    CGGGTCCTCC GGAAATTTCA CTACTTGCTC AACCCACGCC AAGTGTACAA CCTGGACCGT
    GGTGGGCCCG CACCAGGGCT GAGCTTCTTT CGAGACACTC CGGATTTCCG TGTCCTGGCC
    TGTGGGGGGG ATGGCACAGT GGGCTGGATC CTGGACTGCA TCGACAAAGC GAACTTGGTG
    AAGCACCCGC CGGTGGCCGT CCTGCCCCTG GGAACAGGCA ACGACCTGGC CCGGTGCCTG
    CGCTGGGGAG GAGGCTATGA AGGAGGAAAC CTGATGAAGG TCCTGAAAGA CATCGAGCAC
    AGCACGGAGG TGATGCTGGA CCGCTGGCAG ATAGATGTCA TTCCCAGTGA CAGAGAGGCC
    AACGGAGACC CTGTCCCATC CACCATCATC AACAACTACT TCTCCATTGG GGTGGACGCC
    TCCATCGCCC ACCGCTTCCA CGTCATGCGA GAAAAGCACC CCGAGAAATT CAACAGCAGG
    ATGAAGAACA AGCTGTGGTA CTTTGAGTTT GGGACATCGG AGACCTTTGC GGCCACCTGC
    AAGAAGCTCC ACGACTACGT TGAGGTGGAG TGCGACGGGA CCCTGCTGGA CCTGAGCAAC
    ACGTCCCTGG AGGGCATCGC CGTCCTCAAC ATCCCCAGCA TGTACGGCGG CTCCAACCTC
    TGGGGCGAGA CCAAGAAGCA GCGCAGTTAC AGCCGGCTGG GGAAGAAAGC CCCGGAGAAG
    CTGCAGGGCA CGGTGGTCAC CGATGCCAAG GAGCTCAAGT TCTGCGTGCA GGATCTCAGT
    GACCACCTCC TGGAGGTGGT GGGGCTGGAG GGCGCGATGG AGATGGGGCA GATCTACACG
    GGGCTGAAGA GCGCTGGGAA GAGACTGGCC CAGTGTTCAT CTGTCACCAT CAGGACCTCC
    AAGCTGCTGC CCATGCAGGT GGACGGGGAA CCCTGGATGC AGCCGTCCTG TACCGTCAAA
    ATTACACATA AAAGCCAAGT GCCGATGCTG CTGGGCCCCC CCCAGAAGAG CAGCTTCTTT
    TTCCTGAAGA GGAGAAACCG AACTCGAGAT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCa80127
    Clone ID Related Accession (Same CDS sequence) XM_014962955.1
    Accession Version XM_014962955.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2628bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-08
    Organism Calidris pugnax(ruff)
    Product diacylglycerol kinase gamma isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015094503.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Calidris pugnax Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGAGCGATG GTGGGTGGAT CTCGCTCAGC CCCACTGAGT TTGCCCAGCT CCAGCAGTAC 
    ACAGACTATT CCACCAAGAA GCTCAAGGAT GTCCTTGAGG AGTTCCACGG GGACGGTGTC
    CTCTCGAGGT ACAACCCGGA ACAGCCCATC GACTATGAGG GCTTTCGCCT CTTCATGAAG
    ACCTACCTGG AGGCGGACGT GCCCGAGGAA CTTTGCCAAC ACCTCTTCAC CTCCTTCAAG
    CGTAAGATAT GCCAAGCCTC CCCCGAGAGC CAGCGCCAGG GCCCCAGCGT CTCGCAGCTC
    AACACCCTCG GGATCAACGG GAAAATGCTC CTAAGTGCCC TGGGACGACA CACCCCTGAG
    CCCAAGAGCT GTCACAGCAA CGCAGCTGAG CCGCAGCCAG CGTCCCTTAC CCCGGCGTCG
    ATCCCCAACG CCTCCCCAAG CTGGTCCAGG TCCTCCTCCC AGAAGTCCAC CACCGGCACC
    CCTTCTGCTC ACAACTCCTC GGGCTCTTCG AAGGTCTCCT CCGGGTCCCT GCTCAGCCCT
    CAGTCGCCAG GCACACGGAG TGTGGAGAAG AGGTTGCCCT TCAGCCTGCG GAAGAGCCAC
    AGCTCCCTGA AAGCCGCCCC GCCACTGCCC ACCGCCCCCC TGTCCCAGGT GGTCCATCTG
    AAGGACATCG TCTGCTACCT GTCCCTGCTG GAGAGGGGAC GGGCAGAGGA CAAGCTGGAG
    TTTATGTTTC GCCTCTATGA TACTGATGGA AATGGCCTCC TGGACAGCTC GGAGCTGGAT
    CGTATCATCA ACCAGATGGT GCATGTGGCT GAGTACCTGG AGTGGGACTC CACCGAGCTG
    AAGCCTATCT TGAAGGCGAT GATGGAGGAG ATCGACTATG ACCATGACGG GACCGTGACG
    CTTGAGGAGT GGATCCGGGG TGGCATGACC ACCATCCCCT TACTGGTCCT CCTGGGGATG
    GAGACAAACG TGAAGGACGA CGGGCAGCAC GCCTGGAGGC TGAAGCACTT CAAGAAACCT
    GCCTACTGCA ACTTCTGCCG CACCATGCTG CTGGGGGTCC GCAAGCAAGG ACTCTGCTGC
    TCCTTCTGCA AGTACACTGT CCACGAGAGG TGTGTGTCCA AAGATATCGC CTCCTGCATC
    AGCACCTACA TGAAATCCAA GAGGAACACA AGCGTGATGC AGCACACCTG GATTGAGGGC
    AATTCCCCCG TCAAGTGCGA CAGATGCCAC AAGAGCATCA AGTGCTACCA GGGCATCACC
    GGCCTGCACT GCGTCTGGTG CCAAGTCACA CTCCACAACA AATGTGCCTC CCACGTGAAG
    CCAGAGTGCG ACGGGGGCCC GCTGCGGGAC CACATCTTGC TGCCTTCCTA CATCTGCCCC
    GTCGTCCTGG ACAGGCAGTC CCACTGCCGG AGGTCAGAGA GTGACTCCCC TGCCAGCACC
    AGCCCCGAGG ACAACCAGGG CTTCAAGTTC AACTCCACCA CGGTGGATGG GCAAGGTCTG
    CAGATCAGCC CCCGGCCTGG CACACACCCC CTCCTGGTGC TCGTGAACCC CAAGAGCGGA
    GGAAGGCAAG GGGAGCGGGT CCTCCGGAAA TTTCACTACT TGCTCAACCC ACGCCAAGTG
    TACAACCTGG ACCGTGGTGG GCCCGCACCA GGGCTGAGCT TCTTTCGAGA CACTCCGGAT
    TTCCGTGTCC TGGCCTGTGG GGGGGATGGC ACAGTGGGCT GGATCCTGGA CTGCATCGAC
    AAAGCGAACT TGGTGAAGCA CCCGCCGGTG GCCGTCCTGC CCCTGGGAAC AGGCAACGAC
    CTGGCCCGGT GCCTGCGCTG GGGAGGAGGC TATGAAGGAG GAAACCTGAT GAAGGTCCTG
    AAAGACATCG AGCACAGCAC GGAGGTGATG CTGGACCGCT GGCAGATAGA TGTCATTCCC
    AGTGACAGAG AGGCCAACGG AGACCCTGTC CCATCCACCA TCATCAACAA CTACTTCTCC
    ATTGGGGTGG ACGCCTCCAT CGCCCACCGC TTCCACGTCA TGCGAGAAAA GCACCCCGAG
    AAATTCAACA GCAGGATGAA GAACAAGCTG TGGTACTTTG AGTTTGGGAC ATCGGAGACC
    TTTGCGGCCA CCTGCAAGAA GCTCCACGAC TACGTTGAGG TGGAGTGCGA CGGGACCCTG
    CTGGACCTGA GCAACACGTC CCTGGAGGGC ATCGCCGTCC TCAACATCCC CAGCATGTAC
    GGCGGCTCCA ACCTCTGGGG CGAGACCAAG AAGCAGCGCA GTTACAGCCG GCTGGGGAAG
    AAAGCCCCGG AGAAGCTGCA GGGCACGGTG GTCACCGATG CCAAGGAGCT CAAGTTCTGC
    GTGCAGGATC TCAGTGACCA CCTCCTGGAG GTGGTGGGGC TGGAGGGCGC GATGGAGATG
    GGGCAGATCT ACACGGGGCT GAAGAGCGCT GGGAAGAGAC TGGCCCAGTG TTCATCTGTC
    ACCATCAGGA CCTCCAAGCT GCTGCCCATG CAGGTGGACG GGGAACCCTG GATGCAGCCG
    TCCTGTACCG TCAAAATTAC ACATAAAAGC CAAGTGCCGA TGCTGCTGGG CCCCCCCCAG
    AAGAGCAGCT TCTTTTTCCT GAAGAGGAGA AACCGAACTC GAGATTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014818441.1
    CDS223..2850
    Translation

    Target ORF information:

    RefSeq Version XM_014962955.1
    Organism Calidris pugnax(ruff)
    Definition Calidris pugnax diacylglycerol kinase gamma (DGKG), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014962955.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGAGCGATG GTGGGTGGAT CTCGCTCAGC CCCACTGAGT TTGCCCAGCT CCAGCAGTAC 
    ACAGACTATT CCACCAAGAA GCTCAAGGAT GTCCTTGAGG AGTTCCACGG GGACGGTGTC
    CTCTCGAGGT ACAACCCGGA ACAGCCCATC GACTATGAGG GCTTTCGCCT CTTCATGAAG
    ACCTACCTGG AGGCGGACGT GCCCGAGGAA CTTTGCCAAC ACCTCTTCAC CTCCTTCAAG
    CGTAAGATAT GCCAAGCCTC CCCCGAGAGC CAGCGCCAGG GCCCCAGCGT CTCGCAGCTC
    AACACCCTCG GGATCAACGG GAAAATGCTC CTAAGTGCCC TGGGACGACA CACCCCTGAG
    CCCAAGAGCT GTCACAGCAA CGCAGCTGAG CCGCAGCCAG CGTCCCTTAC CCCGGCGTCG
    ATCCCCAACG CCTCCCCAAG CTGGTCCAGG TCCTCCTCCC AGAAGTCCAC CACCGGCACC
    CCTTCTGCTC ACAACTCCTC GGGCTCTTCG AAGGTCTCCT CCGGGTCCCT GCTCAGCCCT
    CAGTCGCCAG GCACACGGAG TGTGGAGAAG AGGTTGCCCT TCAGCCTGCG GAAGAGCCAC
    AGCTCCCTGA AAGCCGCCCC GCCACTGCCC ACCGCCCCCC TGTCCCAGGT GGTCCATCTG
    AAGGACATCG TCTGCTACCT GTCCCTGCTG GAGAGGGGAC GGGCAGAGGA CAAGCTGGAG
    TTTATGTTTC GCCTCTATGA TACTGATGGA AATGGCCTCC TGGACAGCTC GGAGCTGGAT
    CGTATCATCA ACCAGATGGT GCATGTGGCT GAGTACCTGG AGTGGGACTC CACCGAGCTG
    AAGCCTATCT TGAAGGCGAT GATGGAGGAG ATCGACTATG ACCATGACGG GACCGTGACG
    CTTGAGGAGT GGATCCGGGG TGGCATGACC ACCATCCCCT TACTGGTCCT CCTGGGGATG
    GAGACAAACG TGAAGGACGA CGGGCAGCAC GCCTGGAGGC TGAAGCACTT CAAGAAACCT
    GCCTACTGCA ACTTCTGCCG CACCATGCTG CTGGGGGTCC GCAAGCAAGG ACTCTGCTGC
    TCCTTCTGCA AGTACACTGT CCACGAGAGG TGTGTGTCCA AAGATATCGC CTCCTGCATC
    AGCACCTACA TGAAATCCAA GAGGAACACA AGCGTGATGC AGCACACCTG GATTGAGGGC
    AATTCCCCCG TCAAGTGCGA CAGATGCCAC AAGAGCATCA AGTGCTACCA GGGCATCACC
    GGCCTGCACT GCGTCTGGTG CCAAGTCACA CTCCACAACA AATGTGCCTC CCACGTGAAG
    CCAGAGTGCG ACGGGGGCCC GCTGCGGGAC CACATCTTGC TGCCTTCCTA CATCTGCCCC
    GTCGTCCTGG ACAGGCAGTC CCACTGCCGG AGGTCAGAGA GTGACTCCCC TGCCAGCACC
    AGCCCCGAGG ACAACCAGGG CTTCAAGTTC AACTCCACCA CGGTGGATGG GCAAGGTCTG
    CAGATCAGCC CCCGGCCTGG CACACACCCC CTCCTGGTGC TCGTGAACCC CAAGAGCGGA
    GGAAGGCAAG GGGAGCGGGT CCTCCGGAAA TTTCACTACT TGCTCAACCC ACGCCAAGTG
    TACAACCTGG ACCGTGGTGG GCCCGCACCA GGGCTGAGCT TCTTTCGAGA CACTCCGGAT
    TTCCGTGTCC TGGCCTGTGG GGGGGATGGC ACAGTGGGCT GGATCCTGGA CTGCATCGAC
    AAAGCGAACT TGGTGAAGCA CCCGCCGGTG GCCGTCCTGC CCCTGGGAAC AGGCAACGAC
    CTGGCCCGGT GCCTGCGCTG GGGAGGAGGC TATGAAGGAG GAAACCTGAT GAAGGTCCTG
    AAAGACATCG AGCACAGCAC GGAGGTGATG CTGGACCGCT GGCAGATAGA TGTCATTCCC
    AGTGACAGAG AGGCCAACGG AGACCCTGTC CCATCCACCA TCATCAACAA CTACTTCTCC
    ATTGGGGTGG ACGCCTCCAT CGCCCACCGC TTCCACGTCA TGCGAGAAAA GCACCCCGAG
    AAATTCAACA GCAGGATGAA GAACAAGCTG TGGTACTTTG AGTTTGGGAC ATCGGAGACC
    TTTGCGGCCA CCTGCAAGAA GCTCCACGAC TACGTTGAGG TGGAGTGCGA CGGGACCCTG
    CTGGACCTGA GCAACACGTC CCTGGAGGGC ATCGCCGTCC TCAACATCCC CAGCATGTAC
    GGCGGCTCCA ACCTCTGGGG CGAGACCAAG AAGCAGCGCA GTTACAGCCG GCTGGGGAAG
    AAAGCCCCGG AGAAGCTGCA GGGCACGGTG GTCACCGATG CCAAGGAGCT CAAGTTCTGC
    GTGCAGGATC TCAGTGACCA CCTCCTGGAG GTGGTGGGGC TGGAGGGCGC GATGGAGATG
    GGGCAGATCT ACACGGGGCT GAAGAGCGCT GGGAAGAGAC TGGCCCAGTG TTCATCTGTC
    ACCATCAGGA CCTCCAAGCT GCTGCCCATG CAGGTGGACG GGGAACCCTG GATGCAGCCG
    TCCTGTACCG TCAAAATTAC ACATAAAAGC CAAGTGCCGA TGCTGCTGGG CCCCCCCCAG
    AAGAGCAGCT TCTTTTTCCT GAAGAGGAGA AACCGAACTC GAGATTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.