SETDB1 cDNA ORF clone, Taeniopygia guttata(zebra finch)

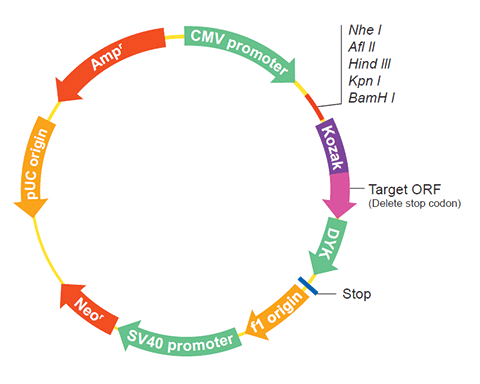
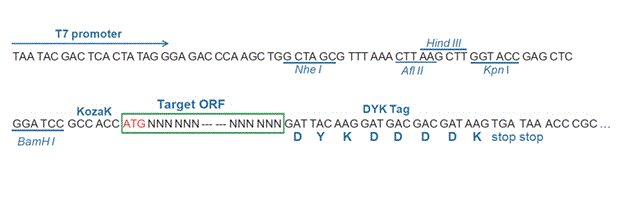
The following SETDB1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the SETDB1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OTd39152 XM_030291226.1
Latest version!
Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $307.30
$439.00
OTd39149 XM_030291221.1
Latest version!
Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
OTd39149 XM_030291222.1
Latest version!
Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
OTd39150 XM_030291224.1
Latest version!
Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
OTd39151 XM_030291225.1
Latest version!
Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
OTd20138 XM_012570892.1
Latest version!
Taeniopygia guttata SET domain, bifurcated 1 (SETDB1), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD Quote Price

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OTd39152
    Clone ID Related Accession (Same CDS sequence) XM_030291226.1
    Accession Version XM_030291226.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1902bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product histone-lysine N-methyltransferase SETDB1 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044237.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGATGCA CAACCCCCTC AGGAATCTCC TGGCACTGCC
    CAGCCCATCA GTGTCCCTGC AGCCCCTAGC AATGATCTCA ACACTGATGG GGACCTCAAA
    GTGGGCATGA GGATTTTGGG GAAAAAAAGA ACCAAGACGT GGCACAAGGG GACGTTGATT
    GCCATCCAGA CGGTCGGTGT TGGCAAGAAA TACAAAGTGA AATTTGATAA TAAAGGGAAG
    AGTTTGCTCT CGGGCAACCA CATTGCCTAC GATTACCACC CGTCTGCCGA GAGGCACCAC
    GTGGGCAGGA GGGTGGTGGC CAGGTACAAG GATGGCAATC AGATGTGGCT CTATGCTGGG
    ATCGTGGCTG AGACCCCCAA CGTGAAGAAT AAAGACAGGT TCCTGATCTT CTTTGACGAC
    GGCTACGCGT CGTACGTGAA GGAGTGGGAG CTGTACCCGG TCTGCCGGCC ACTGAAAAAG
    GCCTGGGAAG ACATTGAGGA TGTTTCCTGT CGGGATTTCA TTGAGGAATA CATCACTGCC
    TATCCCAACC GGCCCATGGT ACTGCTGAAG AATGGGCAGC TGATCAAAAC TGAGTGGGAA
    GGGACCTGGT GGAAATCCAG AGTGGAAGAA GTGGATGGAA GTCTGGTGAA AATCCTTTTC
    CTGGAAGCTC TTCCCATGGG AACTGCAAGT GTTTCCTTCT CGTTTCCACA AGAGGACAAA
    CGTTGTGAGT GGATTTACCG AGGTTCCACG CGCCTCGAGC CCATGTTCAG CATGAAAACT
    TCCACAGCTT CCACCCAGGA AAAGAAGCAA AGTGGACAAA CCAGGACTCG TCCCAACGTT
    GGTGCTGTGA GGAGCAAGGG CCCTGTGGTC CAGTACACCC AGGATTTAGC AGGAACTGGT
    CCCCAGTACA AGACTCCAGA GCCAGCTGCA CGTCCCACAT CTCCTCAGCC TGCGGAGATG
    GAGCGCTGGC CCCCGGCTGC CTTGTGTCCC TCCACTTGGA CTGACCTGCT CGCTGACCTC
    GCTGGGAATT CGGGATCAGT GGTCGGTCCC GGTGGGCACG GAGCAACCCA CGGCCAAGCC
    GCTGCCAGGG GCTCAAGGGG GACATTCCCG GAGCTGCAGG CTGAAGGAGG CCTGGAGGAA
    GGAGGAACTC GGCTTGGTGA TGAAGGGAGT GTGTTGGAGG ACACCAGGGA ACCTGGGAAT
    GTGCCTGGGG ACTTTTTAGG GGAGGGAGAG GCTCTCCCAG TTCATTTTTG CCAGCACTGT
    GGATTTCCCA TCCGGATTTA CGGCCGCCTG GCCCCGTGCC AGCACGTCTT GTGCTCTGAC
    TGTGCCCTGC TGGTGGGGCA CGAGGGAGGC AGGAGGTGTC CCAGGTGTGA GCAGCCTGTG
    CAGGAGGTCA ATCTCTACTC CCCACAGGCT CTCCAGGTGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030147086.1
    CDS308..2209
    Translation

    Target ORF information:

    RefSeq Version XM_030291226.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030291226.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGATGCA CAACCCCCTC AGGAATCTCC TGGCACTGCC
    CAGCCCATCA GTGTCCCTGC AGCCCCTAGC AATGATCTCA ACACTGATGG GGACCTCAAA
    GTGGGCATGA GGATTTTGGG GAAAAAAAGA ACCAAGACGT GGCACAAGGG GACGTTGATT
    GCCATCCAGA CGGTCGGTGT TGGCAAGAAA TACAAAGTGA AATTTGATAA TAAAGGGAAG
    AGTTTGCTCT CGGGCAACCA CATTGCCTAC GATTACCACC CGTCTGCCGA GAGGCACCAC
    GTGGGCAGGA GGGTGGTGGC CAGGTACAAG GATGGCAATC AGATGTGGCT CTATGCTGGG
    ATCGTGGCTG AGACCCCCAA CGTGAAGAAT AAAGACAGGT TCCTGATCTT CTTTGACGAC
    GGCTACGCGT CGTACGTGAA GGAGTGGGAG CTGTACCCGG TCTGCCGGCC ACTGAAAAAG
    GCCTGGGAAG ACATTGAGGA TGTTTCCTGT CGGGATTTCA TTGAGGAATA CATCACTGCC
    TATCCCAACC GGCCCATGGT ACTGCTGAAG AATGGGCAGC TGATCAAAAC TGAGTGGGAA
    GGGACCTGGT GGAAATCCAG AGTGGAAGAA GTGGATGGAA GTCTGGTGAA AATCCTTTTC
    CTGGAAGCTC TTCCCATGGG AACTGCAAGT GTTTCCTTCT CGTTTCCACA AGAGGACAAA
    CGTTGTGAGT GGATTTACCG AGGTTCCACG CGCCTCGAGC CCATGTTCAG CATGAAAACT
    TCCACAGCTT CCACCCAGGA AAAGAAGCAA AGTGGACAAA CCAGGACTCG TCCCAACGTT
    GGTGCTGTGA GGAGCAAGGG CCCTGTGGTC CAGTACACCC AGGATTTAGC AGGAACTGGT
    CCCCAGTACA AGACTCCAGA GCCAGCTGCA CGTCCCACAT CTCCTCAGCC TGCGGAGATG
    GAGCGCTGGC CCCCGGCTGC CTTGTGTCCC TCCACTTGGA CTGACCTGCT CGCTGACCTC
    GCTGGGAATT CGGGATCAGT GGTCGGTCCC GGTGGGCACG GAGCAACCCA CGGCCAAGCC
    GCTGCCAGGG GCTCAAGGGG GACATTCCCG GAGCTGCAGG CTGAAGGAGG CCTGGAGGAA
    GGAGGAACTC GGCTTGGTGA TGAAGGGAGT GTGTTGGAGG ACACCAGGGA ACCTGGGAAT
    GTGCCTGGGG ACTTTTTAGG GGAGGGAGAG GCTCTCCCAG TTCATTTTTG CCAGCACTGT
    GGATTTCCCA TCCGGATTTA CGGCCGCCTG GCCCCGTGCC AGCACGTCTT GTGCTCTGAC
    TGTGCCCTGC TGGTGGGGCA CGAGGGAGGC AGGAGGTGTC CCAGGTGTGA GCAGCCTGTG
    CAGGAGGTCA ATCTCTACTC CCCACAGGCT CTCCAGGTGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd39149
    Clone ID Related Accession (Same CDS sequence) XM_030291221.1 , XM_030291222.1
    Accession Version XM_030291221.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3840bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product histone-lysine N-methyltransferase SETDB1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044237.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGATGCA CAACCCCCTC AGGAATCTCC TGGCACTGCC
    CAGCCCATCA GTGTCCCTGC AGCCCCTAGC AATGATCTCA ACACTGATGG GGACCTCAAA
    GTGGGCATGA GGATTTTGGG GAAAAAAAGA ACCAAGACGT GGCACAAGGG GACGTTGATT
    GCCATCCAGA CGGTCGGTGT TGGCAAGAAA TACAAAGTGA AATTTGATAA TAAAGGGAAG
    AGTTTGCTCT CGGGCAACCA CATTGCCTAC GATTACCACC CGTCTGCCGA GAGGCACCAC
    GTGGGCAGGA GGGTGGTGGC CAGGTACAAG GATGGCAATC AGATGTGGCT CTATGCTGGG
    ATCGTGGCTG AGACCCCCAA CGTGAAGAAT AAAGACAGGT TCCTGATCTT CTTTGACGAC
    GGCTACGCGT CGTACGTGAA GGAGTGGGAG CTGTACCCGG TCTGCCGGCC ACTGAAAAAG
    GCCTGGGAAG ACATTGAGGA TGTTTCCTGT CGGGATTTCA TTGAGGAATA CATCACTGCC
    TATCCCAACC GGCCCATGGT ACTGCTGAAG AATGGGCAGC TGATCAAAAC TGAGTGGGAA
    GGGACCTGGT GGAAATCCAG AGTGGAAGAA GTGGATGGAA GTCTGGTGAA AATCCTTTTC
    CTGGAAGCTC TTCCCATGGG AACTGCAAGT GTTTCCTTCT CGTTTCCACA AGAGGACAAA
    CGTTGTGAGT GGATTTACCG AGGTTCCACG CGCCTCGAGC CCATGTTCAG CATGAAAACT
    TCCACAGCTT CCACCCAGGA AAAGAAGCAA AGTGGACAAA CCAGGACTCG TCCCAACGTT
    GGTGCTGTGA GGAGCAAGGG CCCTGTGGTC CAGTACACCC AGGATTTAGC AGGAACTGGT
    CCCCAGTACA AGACTCCAGA GCCAGCTGCA CGTCCCACAT CTCCTCAGCC TGCGGAGATG
    GAGTGCTCCG ACACCCAGCT GGCCCAGGGC AGAAAGCAGG TGGCCAAGAA AAGCACTTCC
    TTCCGTCCTG GCTCCGTGGG CTCCGGGCAC TCGTCCCCGT CCTCCCCTGT CCTCGGGGAC
    ACCCCGGTGG CCGGGAGGAC GCTCCCAGCC CCGCAGCACC GCGTCCCCAG CAGCGGCCCC
    TCTCAGCCCT TCCACGGGAT GATGGACCGC GTTCCCAACG AGCCGTCGTA CCGCGCCCCG
    CTGGAGAAGC TGTTCTACCT GCCGCACGTG TGCAGCTACG CCTGCCTGTC GCGGGTGCGG
    CCCATGCGCA GCGACCAGTA CCGCAGCCGG AACCCGCTGC TCATCCCGCT GCTCTACGAC
    TTCCGCCGCA TGACGGCGCG GCGCCGCGTC AACCGCAAGA TGGGCTTCCA CGTGCTCTAC
    AAAACGCCCT GCGGGCTCTG CCTGCGCTCC ATGCACGAGA TCGAGCGCTA CCTCTTCGAG
    ACGGACTGCG ACTTCCTCTT CCTGGAGATG TTCTGCCTGG ATCCCTACGT GCTGGTGGAC
    CGCAAGTTCC AGCCCTACAA GCCCTACTAC TACATCGCCG ACATCACCAA GGGCAAGGAG
    GACGTGCCCC TGTCGTGCGT CAACGAGATC GACAACACGC CGCCCCCGCA GGTGGCCTAC
    AGCAAGGAGC GGATCCCCGG GAAAGGGGTG TACATCAACA CCAGCTGGGA GTTCCTCGTG
    GGCTGTGACT GCAAGGACGG CTGCAGGGAC AAATCCAGGT GTGCCTGTCA CCAGCTGACC
    ATCCAGGCCA GCGGCTGCAC CCCTGGAGGG CAAATCAACC CCAACTCAGG CTACCAGCAC
    AAGCGGCTGG AGGAATGTCT CCCAACAGGT GTCTACGAGT GCAACAAGAG GTGCAAGTGC
    AACGTGAACA TGTGCACCAA CCGCCTGGTC CAGCACGGCC TCCAGGTGCG GCTGCAGCTC
    TTCAAGACCC AGAACAAAGG TTGGGGCATT CGCTGCCTCG ACGACATCGC CAAGGGCTCC
    TTTGTCTGCA TCTACGCAGG GAAAATCCTC ACGGACGACT TTGCTGACAA AGAGGGGCTG
    GAGATGGGTG ACGAGTACTT TGCCAACCTG GACCACATCG AGAGCGTGGA GAACTTCAAG
    GAGGGCTACG AGAGCGACGC CAAGTGCTCC TCGGACAACA GCGGCGTGGA CCTCAAGGAC
    GACGACGACG ACGACGAGAA CACGGGCACG GAGGAGCTGG AGGAATCCAA CGAGGACAGC
    TCCGACGACA ACTTCTGCAA GGACGAGAAC TTCAGCACGA GCTCGGTGCT GCGCAGCTAC
    GCCACGCGCC GGCAGACGCG CGGCCAGCGC GACCACGGCC CGTCCGAGAC GGCCTCCAAG
    GACTCGGGGC CAGCGCGGCC CCTCGGCCAC GACGAGCCCG CCACGGCCCC GCCCTGCAAG
    CTGCCCGTGT CCGAGGAGAT CGCCAAGAAC AAAGTGGCCT CGTGGCTGAG CTCCAACAGC
    GTGGCCGAGG GCTTCCAGGA CAGCGAATCC TCCTCCTTCA GGATGGGCGA AGGAGGAGAA
    GCCAAGGCTC TGAAGATGGA GATCCCTGCA GAGAGGGAGA AGGGCTGTGC TTCCACGTCG
    GGAGATCTGA ACGGAGAGAC AAAGGCAGCC AAGAAGGAGG AACCTGAAGA ACCAACCAAA
    ACTCCTGGGC TGAGCAGCTT GGGAAGGAGG TATGGCTACA ACCCCTGCCC GCCCAGGCTG
    GAGGGCATCC GCAGGCCGGT GAGTGGGACG GTGCTGCTGC AGAGCTGCCG GCGGTCCCTG
    GCCCTGCCGC CCTCCTCGGA GAATGTGCTG ATGGTGTCGA GCAGCACCGA CAGCGACGAG
    GAGCACAGGG CAGGGCAGGC CCCGGGCACA GCCAACGACA GCGACGACAT CCAGACCATT
    TCCTCAGGAT CCGAGGAGGA GGAAGGGGAG GACAAGAAGA ATCCATCATC TGGGTCAGGT
    CCCGTGAAGA GACAGGTGGC TGTGAAATCC ACCCGAGGCT TCGCCCTCAA GTCCACCCAC
    GGCATCGCCA TCAAATCCAC GCCGCTGGCG GCGGCCGACA AGGGCGAGAG CGCGGGGCCC
    GTGCGCCGCA GCACGCGGCA GTTCTACGAC GGGGAGGAGA ACTGCTACAT CATCGACGCC
    AAGCTCGAGG GCAACCTGGG CCGCTACCTC AACCACAGCT GCACCCCAAA CCTCTTCGTG
    CAGAACGTCT TCGTGGACAC CCATGACCTT CGCTTCCCCT GGGTCGCCTT CTTCGCCAGC
    AAGCGGATCC GAGCGGGCAC GGAGCTGACC TGGGATTACA ACTACGAGGT CGGCAGCGTG
    GAGGGCAAGG AGCTGCTGTG CTGCTGCGGG GCCATCGACT GCCGGGGCCG GCTGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030147081.1
    CDS304..4143
    Translation

    Target ORF information:

    RefSeq Version XM_030291221.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030291221.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGATGCA CAACCCCCTC AGGAATCTCC TGGCACTGCC
    CAGCCCATCA GTGTCCCTGC AGCCCCTAGC AATGATCTCA ACACTGATGG GGACCTCAAA
    GTGGGCATGA GGATTTTGGG GAAAAAAAGA ACCAAGACGT GGCACAAGGG GACGTTGATT
    GCCATCCAGA CGGTCGGTGT TGGCAAGAAA TACAAAGTGA AATTTGATAA TAAAGGGAAG
    AGTTTGCTCT CGGGCAACCA CATTGCCTAC GATTACCACC CGTCTGCCGA GAGGCACCAC
    GTGGGCAGGA GGGTGGTGGC CAGGTACAAG GATGGCAATC AGATGTGGCT CTATGCTGGG
    ATCGTGGCTG AGACCCCCAA CGTGAAGAAT AAAGACAGGT TCCTGATCTT CTTTGACGAC
    GGCTACGCGT CGTACGTGAA GGAGTGGGAG CTGTACCCGG TCTGCCGGCC ACTGAAAAAG
    GCCTGGGAAG ACATTGAGGA TGTTTCCTGT CGGGATTTCA TTGAGGAATA CATCACTGCC
    TATCCCAACC GGCCCATGGT ACTGCTGAAG AATGGGCAGC TGATCAAAAC TGAGTGGGAA
    GGGACCTGGT GGAAATCCAG AGTGGAAGAA GTGGATGGAA GTCTGGTGAA AATCCTTTTC
    CTGGAAGCTC TTCCCATGGG AACTGCAAGT GTTTCCTTCT CGTTTCCACA AGAGGACAAA
    CGTTGTGAGT GGATTTACCG AGGTTCCACG CGCCTCGAGC CCATGTTCAG CATGAAAACT
    TCCACAGCTT CCACCCAGGA AAAGAAGCAA AGTGGACAAA CCAGGACTCG TCCCAACGTT
    GGTGCTGTGA GGAGCAAGGG CCCTGTGGTC CAGTACACCC AGGATTTAGC AGGAACTGGT
    CCCCAGTACA AGACTCCAGA GCCAGCTGCA CGTCCCACAT CTCCTCAGCC TGCGGAGATG
    GAGTGCTCCG ACACCCAGCT GGCCCAGGGC AGAAAGCAGG TGGCCAAGAA AAGCACTTCC
    TTCCGTCCTG GCTCCGTGGG CTCCGGGCAC TCGTCCCCGT CCTCCCCTGT CCTCGGGGAC
    ACCCCGGTGG CCGGGAGGAC GCTCCCAGCC CCGCAGCACC GCGTCCCCAG CAGCGGCCCC
    TCTCAGCCCT TCCACGGGAT GATGGACCGC GTTCCCAACG AGCCGTCGTA CCGCGCCCCG
    CTGGAGAAGC TGTTCTACCT GCCGCACGTG TGCAGCTACG CCTGCCTGTC GCGGGTGCGG
    CCCATGCGCA GCGACCAGTA CCGCAGCCGG AACCCGCTGC TCATCCCGCT GCTCTACGAC
    TTCCGCCGCA TGACGGCGCG GCGCCGCGTC AACCGCAAGA TGGGCTTCCA CGTGCTCTAC
    AAAACGCCCT GCGGGCTCTG CCTGCGCTCC ATGCACGAGA TCGAGCGCTA CCTCTTCGAG
    ACGGACTGCG ACTTCCTCTT CCTGGAGATG TTCTGCCTGG ATCCCTACGT GCTGGTGGAC
    CGCAAGTTCC AGCCCTACAA GCCCTACTAC TACATCGCCG ACATCACCAA GGGCAAGGAG
    GACGTGCCCC TGTCGTGCGT CAACGAGATC GACAACACGC CGCCCCCGCA GGTGGCCTAC
    AGCAAGGAGC GGATCCCCGG GAAAGGGGTG TACATCAACA CCAGCTGGGA GTTCCTCGTG
    GGCTGTGACT GCAAGGACGG CTGCAGGGAC AAATCCAGGT GTGCCTGTCA CCAGCTGACC
    ATCCAGGCCA GCGGCTGCAC CCCTGGAGGG CAAATCAACC CCAACTCAGG CTACCAGCAC
    AAGCGGCTGG AGGAATGTCT CCCAACAGGT GTCTACGAGT GCAACAAGAG GTGCAAGTGC
    AACGTGAACA TGTGCACCAA CCGCCTGGTC CAGCACGGCC TCCAGGTGCG GCTGCAGCTC
    TTCAAGACCC AGAACAAAGG TTGGGGCATT CGCTGCCTCG ACGACATCGC CAAGGGCTCC
    TTTGTCTGCA TCTACGCAGG GAAAATCCTC ACGGACGACT TTGCTGACAA AGAGGGGCTG
    GAGATGGGTG ACGAGTACTT TGCCAACCTG GACCACATCG AGAGCGTGGA GAACTTCAAG
    GAGGGCTACG AGAGCGACGC CAAGTGCTCC TCGGACAACA GCGGCGTGGA CCTCAAGGAC
    GACGACGACG ACGACGAGAA CACGGGCACG GAGGAGCTGG AGGAATCCAA CGAGGACAGC
    TCCGACGACA ACTTCTGCAA GGACGAGAAC TTCAGCACGA GCTCGGTGCT GCGCAGCTAC
    GCCACGCGCC GGCAGACGCG CGGCCAGCGC GACCACGGCC CGTCCGAGAC GGCCTCCAAG
    GACTCGGGGC CAGCGCGGCC CCTCGGCCAC GACGAGCCCG CCACGGCCCC GCCCTGCAAG
    CTGCCCGTGT CCGAGGAGAT CGCCAAGAAC AAAGTGGCCT CGTGGCTGAG CTCCAACAGC
    GTGGCCGAGG GCTTCCAGGA CAGCGAATCC TCCTCCTTCA GGATGGGCGA AGGAGGAGAA
    GCCAAGGCTC TGAAGATGGA GATCCCTGCA GAGAGGGAGA AGGGCTGTGC TTCCACGTCG
    GGAGATCTGA ACGGAGAGAC AAAGGCAGCC AAGAAGGAGG AACCTGAAGA ACCAACCAAA
    ACTCCTGGGC TGAGCAGCTT GGGAAGGAGG TATGGCTACA ACCCCTGCCC GCCCAGGCTG
    GAGGGCATCC GCAGGCCGGT GAGTGGGACG GTGCTGCTGC AGAGCTGCCG GCGGTCCCTG
    GCCCTGCCGC CCTCCTCGGA GAATGTGCTG ATGGTGTCGA GCAGCACCGA CAGCGACGAG
    GAGCACAGGG CAGGGCAGGC CCCGGGCACA GCCAACGACA GCGACGACAT CCAGACCATT
    TCCTCAGGAT CCGAGGAGGA GGAAGGGGAG GACAAGAAGA ATCCATCATC TGGGTCAGGT
    CCCGTGAAGA GACAGGTGGC TGTGAAATCC ACCCGAGGCT TCGCCCTCAA GTCCACCCAC
    GGCATCGCCA TCAAATCCAC GCCGCTGGCG GCGGCCGACA AGGGCGAGAG CGCGGGGCCC
    GTGCGCCGCA GCACGCGGCA GTTCTACGAC GGGGAGGAGA ACTGCTACAT CATCGACGCC
    AAGCTCGAGG GCAACCTGGG CCGCTACCTC AACCACAGCT GCACCCCAAA CCTCTTCGTG
    CAGAACGTCT TCGTGGACAC CCATGACCTT CGCTTCCCCT GGGTCGCCTT CTTCGCCAGC
    AAGCGGATCC GAGCGGGCAC GGAGCTGACC TGGGATTACA ACTACGAGGT CGGCAGCGTG
    GAGGGCAAGG AGCTGCTGTG CTGCTGCGGG GCCATCGACT GCCGGGGCCG GCTGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd39149
    Clone ID Related Accession (Same CDS sequence) XM_030291221.1 , XM_030291222.1
    Accession Version XM_030291222.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3840bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product histone-lysine N-methyltransferase SETDB1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044237.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGATGCA CAACCCCCTC AGGAATCTCC TGGCACTGCC
    CAGCCCATCA GTGTCCCTGC AGCCCCTAGC AATGATCTCA ACACTGATGG GGACCTCAAA
    GTGGGCATGA GGATTTTGGG GAAAAAAAGA ACCAAGACGT GGCACAAGGG GACGTTGATT
    GCCATCCAGA CGGTCGGTGT TGGCAAGAAA TACAAAGTGA AATTTGATAA TAAAGGGAAG
    AGTTTGCTCT CGGGCAACCA CATTGCCTAC GATTACCACC CGTCTGCCGA GAGGCACCAC
    GTGGGCAGGA GGGTGGTGGC CAGGTACAAG GATGGCAATC AGATGTGGCT CTATGCTGGG
    ATCGTGGCTG AGACCCCCAA CGTGAAGAAT AAAGACAGGT TCCTGATCTT CTTTGACGAC
    GGCTACGCGT CGTACGTGAA GGAGTGGGAG CTGTACCCGG TCTGCCGGCC ACTGAAAAAG
    GCCTGGGAAG ACATTGAGGA TGTTTCCTGT CGGGATTTCA TTGAGGAATA CATCACTGCC
    TATCCCAACC GGCCCATGGT ACTGCTGAAG AATGGGCAGC TGATCAAAAC TGAGTGGGAA
    GGGACCTGGT GGAAATCCAG AGTGGAAGAA GTGGATGGAA GTCTGGTGAA AATCCTTTTC
    CTGGAAGCTC TTCCCATGGG AACTGCAAGT GTTTCCTTCT CGTTTCCACA AGAGGACAAA
    CGTTGTGAGT GGATTTACCG AGGTTCCACG CGCCTCGAGC CCATGTTCAG CATGAAAACT
    TCCACAGCTT CCACCCAGGA AAAGAAGCAA AGTGGACAAA CCAGGACTCG TCCCAACGTT
    GGTGCTGTGA GGAGCAAGGG CCCTGTGGTC CAGTACACCC AGGATTTAGC AGGAACTGGT
    CCCCAGTACA AGACTCCAGA GCCAGCTGCA CGTCCCACAT CTCCTCAGCC TGCGGAGATG
    GAGTGCTCCG ACACCCAGCT GGCCCAGGGC AGAAAGCAGG TGGCCAAGAA AAGCACTTCC
    TTCCGTCCTG GCTCCGTGGG CTCCGGGCAC TCGTCCCCGT CCTCCCCTGT CCTCGGGGAC
    ACCCCGGTGG CCGGGAGGAC GCTCCCAGCC CCGCAGCACC GCGTCCCCAG CAGCGGCCCC
    TCTCAGCCCT TCCACGGGAT GATGGACCGC GTTCCCAACG AGCCGTCGTA CCGCGCCCCG
    CTGGAGAAGC TGTTCTACCT GCCGCACGTG TGCAGCTACG CCTGCCTGTC GCGGGTGCGG
    CCCATGCGCA GCGACCAGTA CCGCAGCCGG AACCCGCTGC TCATCCCGCT GCTCTACGAC
    TTCCGCCGCA TGACGGCGCG GCGCCGCGTC AACCGCAAGA TGGGCTTCCA CGTGCTCTAC
    AAAACGCCCT GCGGGCTCTG CCTGCGCTCC ATGCACGAGA TCGAGCGCTA CCTCTTCGAG
    ACGGACTGCG ACTTCCTCTT CCTGGAGATG TTCTGCCTGG ATCCCTACGT GCTGGTGGAC
    CGCAAGTTCC AGCCCTACAA GCCCTACTAC TACATCGCCG ACATCACCAA GGGCAAGGAG
    GACGTGCCCC TGTCGTGCGT CAACGAGATC GACAACACGC CGCCCCCGCA GGTGGCCTAC
    AGCAAGGAGC GGATCCCCGG GAAAGGGGTG TACATCAACA CCAGCTGGGA GTTCCTCGTG
    GGCTGTGACT GCAAGGACGG CTGCAGGGAC AAATCCAGGT GTGCCTGTCA CCAGCTGACC
    ATCCAGGCCA GCGGCTGCAC CCCTGGAGGG CAAATCAACC CCAACTCAGG CTACCAGCAC
    AAGCGGCTGG AGGAATGTCT CCCAACAGGT GTCTACGAGT GCAACAAGAG GTGCAAGTGC
    AACGTGAACA TGTGCACCAA CCGCCTGGTC CAGCACGGCC TCCAGGTGCG GCTGCAGCTC
    TTCAAGACCC AGAACAAAGG TTGGGGCATT CGCTGCCTCG ACGACATCGC CAAGGGCTCC
    TTTGTCTGCA TCTACGCAGG GAAAATCCTC ACGGACGACT TTGCTGACAA AGAGGGGCTG
    GAGATGGGTG ACGAGTACTT TGCCAACCTG GACCACATCG AGAGCGTGGA GAACTTCAAG
    GAGGGCTACG AGAGCGACGC CAAGTGCTCC TCGGACAACA GCGGCGTGGA CCTCAAGGAC
    GACGACGACG ACGACGAGAA CACGGGCACG GAGGAGCTGG AGGAATCCAA CGAGGACAGC
    TCCGACGACA ACTTCTGCAA GGACGAGAAC TTCAGCACGA GCTCGGTGCT GCGCAGCTAC
    GCCACGCGCC GGCAGACGCG CGGCCAGCGC GACCACGGCC CGTCCGAGAC GGCCTCCAAG
    GACTCGGGGC CAGCGCGGCC CCTCGGCCAC GACGAGCCCG CCACGGCCCC GCCCTGCAAG
    CTGCCCGTGT CCGAGGAGAT CGCCAAGAAC AAAGTGGCCT CGTGGCTGAG CTCCAACAGC
    GTGGCCGAGG GCTTCCAGGA CAGCGAATCC TCCTCCTTCA GGATGGGCGA AGGAGGAGAA
    GCCAAGGCTC TGAAGATGGA GATCCCTGCA GAGAGGGAGA AGGGCTGTGC TTCCACGTCG
    GGAGATCTGA ACGGAGAGAC AAAGGCAGCC AAGAAGGAGG AACCTGAAGA ACCAACCAAA
    ACTCCTGGGC TGAGCAGCTT GGGAAGGAGG TATGGCTACA ACCCCTGCCC GCCCAGGCTG
    GAGGGCATCC GCAGGCCGGT GAGTGGGACG GTGCTGCTGC AGAGCTGCCG GCGGTCCCTG
    GCCCTGCCGC CCTCCTCGGA GAATGTGCTG ATGGTGTCGA GCAGCACCGA CAGCGACGAG
    GAGCACAGGG CAGGGCAGGC CCCGGGCACA GCCAACGACA GCGACGACAT CCAGACCATT
    TCCTCAGGAT CCGAGGAGGA GGAAGGGGAG GACAAGAAGA ATCCATCATC TGGGTCAGGT
    CCCGTGAAGA GACAGGTGGC TGTGAAATCC ACCCGAGGCT TCGCCCTCAA GTCCACCCAC
    GGCATCGCCA TCAAATCCAC GCCGCTGGCG GCGGCCGACA AGGGCGAGAG CGCGGGGCCC
    GTGCGCCGCA GCACGCGGCA GTTCTACGAC GGGGAGGAGA ACTGCTACAT CATCGACGCC
    AAGCTCGAGG GCAACCTGGG CCGCTACCTC AACCACAGCT GCACCCCAAA CCTCTTCGTG
    CAGAACGTCT TCGTGGACAC CCATGACCTT CGCTTCCCCT GGGTCGCCTT CTTCGCCAGC
    AAGCGGATCC GAGCGGGCAC GGAGCTGACC TGGGATTACA ACTACGAGGT CGGCAGCGTG
    GAGGGCAAGG AGCTGCTGTG CTGCTGCGGG GCCATCGACT GCCGGGGCCG GCTGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_030147082.1
    CDS36..3875
    Translation

    Target ORF information:

    RefSeq Version XM_030291222.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030291222.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGATGCA CAACCCCCTC AGGAATCTCC TGGCACTGCC
    CAGCCCATCA GTGTCCCTGC AGCCCCTAGC AATGATCTCA ACACTGATGG GGACCTCAAA
    GTGGGCATGA GGATTTTGGG GAAAAAAAGA ACCAAGACGT GGCACAAGGG GACGTTGATT
    GCCATCCAGA CGGTCGGTGT TGGCAAGAAA TACAAAGTGA AATTTGATAA TAAAGGGAAG
    AGTTTGCTCT CGGGCAACCA CATTGCCTAC GATTACCACC CGTCTGCCGA GAGGCACCAC
    GTGGGCAGGA GGGTGGTGGC CAGGTACAAG GATGGCAATC AGATGTGGCT CTATGCTGGG
    ATCGTGGCTG AGACCCCCAA CGTGAAGAAT AAAGACAGGT TCCTGATCTT CTTTGACGAC
    GGCTACGCGT CGTACGTGAA GGAGTGGGAG CTGTACCCGG TCTGCCGGCC ACTGAAAAAG
    GCCTGGGAAG ACATTGAGGA TGTTTCCTGT CGGGATTTCA TTGAGGAATA CATCACTGCC
    TATCCCAACC GGCCCATGGT ACTGCTGAAG AATGGGCAGC TGATCAAAAC TGAGTGGGAA
    GGGACCTGGT GGAAATCCAG AGTGGAAGAA GTGGATGGAA GTCTGGTGAA AATCCTTTTC
    CTGGAAGCTC TTCCCATGGG AACTGCAAGT GTTTCCTTCT CGTTTCCACA AGAGGACAAA
    CGTTGTGAGT GGATTTACCG AGGTTCCACG CGCCTCGAGC CCATGTTCAG CATGAAAACT
    TCCACAGCTT CCACCCAGGA AAAGAAGCAA AGTGGACAAA CCAGGACTCG TCCCAACGTT
    GGTGCTGTGA GGAGCAAGGG CCCTGTGGTC CAGTACACCC AGGATTTAGC AGGAACTGGT
    CCCCAGTACA AGACTCCAGA GCCAGCTGCA CGTCCCACAT CTCCTCAGCC TGCGGAGATG
    GAGTGCTCCG ACACCCAGCT GGCCCAGGGC AGAAAGCAGG TGGCCAAGAA AAGCACTTCC
    TTCCGTCCTG GCTCCGTGGG CTCCGGGCAC TCGTCCCCGT CCTCCCCTGT CCTCGGGGAC
    ACCCCGGTGG CCGGGAGGAC GCTCCCAGCC CCGCAGCACC GCGTCCCCAG CAGCGGCCCC
    TCTCAGCCCT TCCACGGGAT GATGGACCGC GTTCCCAACG AGCCGTCGTA CCGCGCCCCG
    CTGGAGAAGC TGTTCTACCT GCCGCACGTG TGCAGCTACG CCTGCCTGTC GCGGGTGCGG
    CCCATGCGCA GCGACCAGTA CCGCAGCCGG AACCCGCTGC TCATCCCGCT GCTCTACGAC
    TTCCGCCGCA TGACGGCGCG GCGCCGCGTC AACCGCAAGA TGGGCTTCCA CGTGCTCTAC
    AAAACGCCCT GCGGGCTCTG CCTGCGCTCC ATGCACGAGA TCGAGCGCTA CCTCTTCGAG
    ACGGACTGCG ACTTCCTCTT CCTGGAGATG TTCTGCCTGG ATCCCTACGT GCTGGTGGAC
    CGCAAGTTCC AGCCCTACAA GCCCTACTAC TACATCGCCG ACATCACCAA GGGCAAGGAG
    GACGTGCCCC TGTCGTGCGT CAACGAGATC GACAACACGC CGCCCCCGCA GGTGGCCTAC
    AGCAAGGAGC GGATCCCCGG GAAAGGGGTG TACATCAACA CCAGCTGGGA GTTCCTCGTG
    GGCTGTGACT GCAAGGACGG CTGCAGGGAC AAATCCAGGT GTGCCTGTCA CCAGCTGACC
    ATCCAGGCCA GCGGCTGCAC CCCTGGAGGG CAAATCAACC CCAACTCAGG CTACCAGCAC
    AAGCGGCTGG AGGAATGTCT CCCAACAGGT GTCTACGAGT GCAACAAGAG GTGCAAGTGC
    AACGTGAACA TGTGCACCAA CCGCCTGGTC CAGCACGGCC TCCAGGTGCG GCTGCAGCTC
    TTCAAGACCC AGAACAAAGG TTGGGGCATT CGCTGCCTCG ACGACATCGC CAAGGGCTCC
    TTTGTCTGCA TCTACGCAGG GAAAATCCTC ACGGACGACT TTGCTGACAA AGAGGGGCTG
    GAGATGGGTG ACGAGTACTT TGCCAACCTG GACCACATCG AGAGCGTGGA GAACTTCAAG
    GAGGGCTACG AGAGCGACGC CAAGTGCTCC TCGGACAACA GCGGCGTGGA CCTCAAGGAC
    GACGACGACG ACGACGAGAA CACGGGCACG GAGGAGCTGG AGGAATCCAA CGAGGACAGC
    TCCGACGACA ACTTCTGCAA GGACGAGAAC TTCAGCACGA GCTCGGTGCT GCGCAGCTAC
    GCCACGCGCC GGCAGACGCG CGGCCAGCGC GACCACGGCC CGTCCGAGAC GGCCTCCAAG
    GACTCGGGGC CAGCGCGGCC CCTCGGCCAC GACGAGCCCG CCACGGCCCC GCCCTGCAAG
    CTGCCCGTGT CCGAGGAGAT CGCCAAGAAC AAAGTGGCCT CGTGGCTGAG CTCCAACAGC
    GTGGCCGAGG GCTTCCAGGA CAGCGAATCC TCCTCCTTCA GGATGGGCGA AGGAGGAGAA
    GCCAAGGCTC TGAAGATGGA GATCCCTGCA GAGAGGGAGA AGGGCTGTGC TTCCACGTCG
    GGAGATCTGA ACGGAGAGAC AAAGGCAGCC AAGAAGGAGG AACCTGAAGA ACCAACCAAA
    ACTCCTGGGC TGAGCAGCTT GGGAAGGAGG TATGGCTACA ACCCCTGCCC GCCCAGGCTG
    GAGGGCATCC GCAGGCCGGT GAGTGGGACG GTGCTGCTGC AGAGCTGCCG GCGGTCCCTG
    GCCCTGCCGC CCTCCTCGGA GAATGTGCTG ATGGTGTCGA GCAGCACCGA CAGCGACGAG
    GAGCACAGGG CAGGGCAGGC CCCGGGCACA GCCAACGACA GCGACGACAT CCAGACCATT
    TCCTCAGGAT CCGAGGAGGA GGAAGGGGAG GACAAGAAGA ATCCATCATC TGGGTCAGGT
    CCCGTGAAGA GACAGGTGGC TGTGAAATCC ACCCGAGGCT TCGCCCTCAA GTCCACCCAC
    GGCATCGCCA TCAAATCCAC GCCGCTGGCG GCGGCCGACA AGGGCGAGAG CGCGGGGCCC
    GTGCGCCGCA GCACGCGGCA GTTCTACGAC GGGGAGGAGA ACTGCTACAT CATCGACGCC
    AAGCTCGAGG GCAACCTGGG CCGCTACCTC AACCACAGCT GCACCCCAAA CCTCTTCGTG
    CAGAACGTCT TCGTGGACAC CCATGACCTT CGCTTCCCCT GGGTCGCCTT CTTCGCCAGC
    AAGCGGATCC GAGCGGGCAC GGAGCTGACC TGGGATTACA ACTACGAGGT CGGCAGCGTG
    GAGGGCAAGG AGCTGCTGTG CTGCTGCGGG GCCATCGACT GCCGGGGCCG GCTGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd39150
    Clone ID Related Accession (Same CDS sequence) XM_030291224.1
    Accession Version XM_030291224.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3828bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product histone-lysine N-methyltransferase SETDB1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044237.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGCAGC
    AGCAGTCCCA GAATCTCCAG GGATCAGAGT CTGCTGCGGG AAGCAATGGC TGCCATGAGG
    AAATCTGCCC GGGATGTTGC AAAATTCATG GATGCTGTAA ACAAGAAAAC CAACTTGCAG
    GAAGCACAGA AAGATGCACA ACCCCCTCAG GAATCTCCTG GCACTGCCCA GCCCATCAGT
    GTCCCTGCAG CCCCTAGCAA TGATCTCAAC ACTGATGGGG ACCTCAAAGT GGGCATGAGG
    ATTTTGGGGA AAAAAAGAAC CAAGACGTGG CACAAGGGGA CGTTGATTGC CATCCAGACG
    GTCGGTGTTG GCAAGAAATA CAAAGTGAAA TTTGATAATA AAGGGAAGAG TTTGCTCTCG
    GGCAACCACA TTGCCTACGA TTACCACCCG TCTGCCGAGA GGCACCACGT GGGCAGGAGG
    GTGGTGGCCA GGTACAAGGA TGGCAATCAG ATGTGGCTCT ATGCTGGGAT CGTGGCTGAG
    ACCCCCAACG TGAAGAATAA AGACAGGTTC CTGATCTTCT TTGACGACGG CTACGCGTCG
    TACGTGAAGG AGTGGGAGCT GTACCCGGTC TGCCGGCCAC TGAAAAAGGC CTGGGAAGAC
    ATTGAGGATG TTTCCTGTCG GGATTTCATT GAGGAATACA TCACTGCCTA TCCCAACCGG
    CCCATGGTAC TGCTGAAGAA TGGGCAGCTG ATCAAAACTG AGTGGGAAGG GACCTGGTGG
    AAATCCAGAG TGGAAGAAGT GGATGGAAGT CTGGTGAAAA TCCTTTTCCT GGAAGCTCTT
    CCCATGGGAA CTGCAAGTGT TTCCTTCTCG TTTCCACAAG AGGACAAACG TTGTGAGTGG
    ATTTACCGAG GTTCCACGCG CCTCGAGCCC ATGTTCAGCA TGAAAACTTC CACAGCTTCC
    ACCCAGGAAA AGAAGCAAAG TGGACAAACC AGGACTCGTC CCAACGTTGG TGCTGTGAGG
    AGCAAGGGCC CTGTGGTCCA GTACACCCAG GATTTAGCAG GAACTGGTCC CCAGTACAAG
    ACTCCAGAGC CAGCTGCACG TCCCACATCT CCTCAGCCTG CGGAGATGGA GTGCTCCGAC
    ACCCAGCTGG CCCAGGGCAG AAAGCAGGTG GCCAAGAAAA GCACTTCCTT CCGTCCTGGC
    TCCGTGGGCT CCGGGCACTC GTCCCCGTCC TCCCCTGTCC TCGGGGACAC CCCGGTGGCC
    GGGAGGACGC TCCCAGCCCC GCAGCACCGC GTCCCCAGCA GCGGCCCCTC TCAGCCCTTC
    CACGGGATGA TGGACCGCGT TCCCAACGAG CCGTCGTACC GCGCCCCGCT GGAGAAGCTG
    TTCTACCTGC CGCACGTGTG CAGCTACGCC TGCCTGTCGC GGGTGCGGCC CATGCGCAGC
    GACCAGTACC GCAGCCGGAA CCCGCTGCTC ATCCCGCTGC TCTACGACTT CCGCCGCATG
    ACGGCGCGGC GCCGCGTCAA CCGCAAGATG GGCTTCCACG TGCTCTACAA AACGCCCTGC
    GGGCTCTGCC TGCGCTCCAT GCACGAGATC GAGCGCTACC TCTTCGAGAC GGACTGCGAC
    TTCCTCTTCC TGGAGATGTT CTGCCTGGAT CCCTACGTGC TGGTGGACCG CAAGTTCCAG
    CCCTACAAGC CCTACTACTA CATCGCCGAC ATCACCAAGG GCAAGGAGGA CGTGCCCCTG
    TCGTGCGTCA ACGAGATCGA CAACACGCCG CCCCCGCAGG TGGCCTACAG CAAGGAGCGG
    ATCCCCGGGA AAGGGGTGTA CATCAACACC AGCTGGGAGT TCCTCGTGGG CTGTGACTGC
    AAGGACGGCT GCAGGGACAA ATCCAGGTGT GCCTGTCACC AGCTGACCAT CCAGGCCAGC
    GGCTGCACCC CTGGAGGGCA AATCAACCCC AACTCAGGCT ACCAGCACAA GCGGCTGGAG
    GAATGTCTCC CAACAGGTGT CTACGAGTGC AACAAGAGGT GCAAGTGCAA CGTGAACATG
    TGCACCAACC GCCTGGTCCA GCACGGCCTC CAGGTGCGGC TGCAGCTCTT CAAGACCCAG
    AACAAAGGTT GGGGCATTCG CTGCCTCGAC GACATCGCCA AGGGCTCCTT TGTCTGCATC
    TACGCAGGGA AAATCCTCAC GGACGACTTT GCTGACAAAG AGGGGCTGGA GATGGGTGAC
    GAGTACTTTG CCAACCTGGA CCACATCGAG AGCGTGGAGA ACTTCAAGGA GGGCTACGAG
    AGCGACGCCA AGTGCTCCTC GGACAACAGC GGCGTGGACC TCAAGGACGA CGACGACGAC
    GACGAGAACA CGGGCACGGA GGAGCTGGAG GAATCCAACG AGGACAGCTC CGACGACAAC
    TTCTGCAAGG ACGAGAACTT CAGCACGAGC TCGGTGCTGC GCAGCTACGC CACGCGCCGG
    CAGACGCGCG GCCAGCGCGA CCACGGCCCG TCCGAGACGG CCTCCAAGGA CTCGGGGCCA
    GCGCGGCCCC TCGGCCACGA CGAGCCCGCC ACGGCCCCGC CCTGCAAGCT GCCCGTGTCC
    GAGGAGATCG CCAAGAACAA AGTGGCCTCG TGGCTGAGCT CCAACAGCGT GGCCGAGGGC
    TTCCAGGACA GCGAATCCTC CTCCTTCAGG ATGGGCGAAG GAGGAGAAGC CAAGGCTCTG
    AAGATGGAGA TCCCTGCAGA GAGGGAGAAG GGCTGTGCTT CCACGTCGGG AGATCTGAAC
    GGAGAGACAA AGGCAGCCAA GAAGGAGGAA CCTGAAGAAC CAACCAAAAC TCCTGGGCTG
    AGCAGCTTGG GAAGGAGGTA TGGCTACAAC CCCTGCCCGC CCAGGCTGGA GGGCATCCGC
    AGGCCGGTGA GTGGGACGGT GCTGCTGCAG AGCTGCCGGC GGTCCCTGGC CCTGCCGCCC
    TCCTCGGAGA ATGTGCTGAT GGTGTCGAGC AGCACCGACA GCGACGAGGA GCACAGGGCA
    GGGCAGGCCC CGGGCACAGC CAACGACAGC GACGACATCC AGACCATTTC CTCAGGATCC
    GAGGAGGAGG AAGGGGAGGA CAAGAAGAAT CCATCATCTG GGTCAGGTCC CGTGAAGAGA
    CAGGTGGCTG TGAAATCCAC CCGAGGCTTC GCCCTCAAGT CCACCCACGG CATCGCCATC
    AAATCCACGC CGCTGGCGGC GGCCGACAAG GGCGAGAGCG CGGGGCCCGT GCGCCGCAGC
    ACGCGGCAGT TCTACGACGG GGAGGAGAAC TGCTACATCA TCGACGCCAA GCTCGAGGGC
    AACCTGGGCC GCTACCTCAA CCACAGCTGC ACCCCAAACC TCTTCGTGCA GAACGTCTTC
    GTGGACACCC ATGACCTTCG CTTCCCCTGG GTCGCCTTCT TCGCCAGCAA GCGGATCCGA
    GCGGGCACGG AGCTGACCTG GGATTACAAC TACGAGGTCG GCAGCGTGGA GGGCAAGGAG
    CTGCTGTGCT GCTGCGGGGC CATCGACTGC CGGGGCCGGC TGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030147084.1
    CDS304..4131
    Translation

    Target ORF information:

    RefSeq Version XM_030291224.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030291224.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGCAGC
    AGCAGTCCCA GAATCTCCAG GGATCAGAGT CTGCTGCGGG AAGCAATGGC TGCCATGAGG
    AAATCTGCCC GGGATGTTGC AAAATTCATG GATGCTGTAA ACAAGAAAAC CAACTTGCAG
    GAAGCACAGA AAGATGCACA ACCCCCTCAG GAATCTCCTG GCACTGCCCA GCCCATCAGT
    GTCCCTGCAG CCCCTAGCAA TGATCTCAAC ACTGATGGGG ACCTCAAAGT GGGCATGAGG
    ATTTTGGGGA AAAAAAGAAC CAAGACGTGG CACAAGGGGA CGTTGATTGC CATCCAGACG
    GTCGGTGTTG GCAAGAAATA CAAAGTGAAA TTTGATAATA AAGGGAAGAG TTTGCTCTCG
    GGCAACCACA TTGCCTACGA TTACCACCCG TCTGCCGAGA GGCACCACGT GGGCAGGAGG
    GTGGTGGCCA GGTACAAGGA TGGCAATCAG ATGTGGCTCT ATGCTGGGAT CGTGGCTGAG
    ACCCCCAACG TGAAGAATAA AGACAGGTTC CTGATCTTCT TTGACGACGG CTACGCGTCG
    TACGTGAAGG AGTGGGAGCT GTACCCGGTC TGCCGGCCAC TGAAAAAGGC CTGGGAAGAC
    ATTGAGGATG TTTCCTGTCG GGATTTCATT GAGGAATACA TCACTGCCTA TCCCAACCGG
    CCCATGGTAC TGCTGAAGAA TGGGCAGCTG ATCAAAACTG AGTGGGAAGG GACCTGGTGG
    AAATCCAGAG TGGAAGAAGT GGATGGAAGT CTGGTGAAAA TCCTTTTCCT GGAAGCTCTT
    CCCATGGGAA CTGCAAGTGT TTCCTTCTCG TTTCCACAAG AGGACAAACG TTGTGAGTGG
    ATTTACCGAG GTTCCACGCG CCTCGAGCCC ATGTTCAGCA TGAAAACTTC CACAGCTTCC
    ACCCAGGAAA AGAAGCAAAG TGGACAAACC AGGACTCGTC CCAACGTTGG TGCTGTGAGG
    AGCAAGGGCC CTGTGGTCCA GTACACCCAG GATTTAGCAG GAACTGGTCC CCAGTACAAG
    ACTCCAGAGC CAGCTGCACG TCCCACATCT CCTCAGCCTG CGGAGATGGA GTGCTCCGAC
    ACCCAGCTGG CCCAGGGCAG AAAGCAGGTG GCCAAGAAAA GCACTTCCTT CCGTCCTGGC
    TCCGTGGGCT CCGGGCACTC GTCCCCGTCC TCCCCTGTCC TCGGGGACAC CCCGGTGGCC
    GGGAGGACGC TCCCAGCCCC GCAGCACCGC GTCCCCAGCA GCGGCCCCTC TCAGCCCTTC
    CACGGGATGA TGGACCGCGT TCCCAACGAG CCGTCGTACC GCGCCCCGCT GGAGAAGCTG
    TTCTACCTGC CGCACGTGTG CAGCTACGCC TGCCTGTCGC GGGTGCGGCC CATGCGCAGC
    GACCAGTACC GCAGCCGGAA CCCGCTGCTC ATCCCGCTGC TCTACGACTT CCGCCGCATG
    ACGGCGCGGC GCCGCGTCAA CCGCAAGATG GGCTTCCACG TGCTCTACAA AACGCCCTGC
    GGGCTCTGCC TGCGCTCCAT GCACGAGATC GAGCGCTACC TCTTCGAGAC GGACTGCGAC
    TTCCTCTTCC TGGAGATGTT CTGCCTGGAT CCCTACGTGC TGGTGGACCG CAAGTTCCAG
    CCCTACAAGC CCTACTACTA CATCGCCGAC ATCACCAAGG GCAAGGAGGA CGTGCCCCTG
    TCGTGCGTCA ACGAGATCGA CAACACGCCG CCCCCGCAGG TGGCCTACAG CAAGGAGCGG
    ATCCCCGGGA AAGGGGTGTA CATCAACACC AGCTGGGAGT TCCTCGTGGG CTGTGACTGC
    AAGGACGGCT GCAGGGACAA ATCCAGGTGT GCCTGTCACC AGCTGACCAT CCAGGCCAGC
    GGCTGCACCC CTGGAGGGCA AATCAACCCC AACTCAGGCT ACCAGCACAA GCGGCTGGAG
    GAATGTCTCC CAACAGGTGT CTACGAGTGC AACAAGAGGT GCAAGTGCAA CGTGAACATG
    TGCACCAACC GCCTGGTCCA GCACGGCCTC CAGGTGCGGC TGCAGCTCTT CAAGACCCAG
    AACAAAGGTT GGGGCATTCG CTGCCTCGAC GACATCGCCA AGGGCTCCTT TGTCTGCATC
    TACGCAGGGA AAATCCTCAC GGACGACTTT GCTGACAAAG AGGGGCTGGA GATGGGTGAC
    GAGTACTTTG CCAACCTGGA CCACATCGAG AGCGTGGAGA ACTTCAAGGA GGGCTACGAG
    AGCGACGCCA AGTGCTCCTC GGACAACAGC GGCGTGGACC TCAAGGACGA CGACGACGAC
    GACGAGAACA CGGGCACGGA GGAGCTGGAG GAATCCAACG AGGACAGCTC CGACGACAAC
    TTCTGCAAGG ACGAGAACTT CAGCACGAGC TCGGTGCTGC GCAGCTACGC CACGCGCCGG
    CAGACGCGCG GCCAGCGCGA CCACGGCCCG TCCGAGACGG CCTCCAAGGA CTCGGGGCCA
    GCGCGGCCCC TCGGCCACGA CGAGCCCGCC ACGGCCCCGC CCTGCAAGCT GCCCGTGTCC
    GAGGAGATCG CCAAGAACAA AGTGGCCTCG TGGCTGAGCT CCAACAGCGT GGCCGAGGGC
    TTCCAGGACA GCGAATCCTC CTCCTTCAGG ATGGGCGAAG GAGGAGAAGC CAAGGCTCTG
    AAGATGGAGA TCCCTGCAGA GAGGGAGAAG GGCTGTGCTT CCACGTCGGG AGATCTGAAC
    GGAGAGACAA AGGCAGCCAA GAAGGAGGAA CCTGAAGAAC CAACCAAAAC TCCTGGGCTG
    AGCAGCTTGG GAAGGAGGTA TGGCTACAAC CCCTGCCCGC CCAGGCTGGA GGGCATCCGC
    AGGCCGGTGA GTGGGACGGT GCTGCTGCAG AGCTGCCGGC GGTCCCTGGC CCTGCCGCCC
    TCCTCGGAGA ATGTGCTGAT GGTGTCGAGC AGCACCGACA GCGACGAGGA GCACAGGGCA
    GGGCAGGCCC CGGGCACAGC CAACGACAGC GACGACATCC AGACCATTTC CTCAGGATCC
    GAGGAGGAGG AAGGGGAGGA CAAGAAGAAT CCATCATCTG GGTCAGGTCC CGTGAAGAGA
    CAGGTGGCTG TGAAATCCAC CCGAGGCTTC GCCCTCAAGT CCACCCACGG CATCGCCATC
    AAATCCACGC CGCTGGCGGC GGCCGACAAG GGCGAGAGCG CGGGGCCCGT GCGCCGCAGC
    ACGCGGCAGT TCTACGACGG GGAGGAGAAC TGCTACATCA TCGACGCCAA GCTCGAGGGC
    AACCTGGGCC GCTACCTCAA CCACAGCTGC ACCCCAAACC TCTTCGTGCA GAACGTCTTC
    GTGGACACCC ATGACCTTCG CTTCCCCTGG GTCGCCTTCT TCGCCAGCAA GCGGATCCGA
    GCGGGCACGG AGCTGACCTG GGATTACAAC TACGAGGTCG GCAGCGTGGA GGGCAAGGAG
    CTGCTGTGCT GCTGCGGGGC CATCGACTGC CGGGGCCGGC TGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd39151
    Clone ID Related Accession (Same CDS sequence) XM_030291225.1
    Accession Version XM_030291225.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3669bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product histone-lysine N-methyltransferase SETDB1 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044237.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGGTGTT GGCAAGAAAT ACAAAGTGAA ATTTGATAAT
    AAAGGGAAGA GTTTGCTCTC GGGCAACCAC ATTGCCTACG ATTACCACCC GTCTGCCGAG
    AGGCACCACG TGGGCAGGAG GGTGGTGGCC AGGTACAAGG ATGGCAATCA GATGTGGCTC
    TATGCTGGGA TCGTGGCTGA GACCCCCAAC GTGAAGAATA AAGACAGGTT CCTGATCTTC
    TTTGACGACG GCTACGCGTC GTACGTGAAG GAGTGGGAGC TGTACCCGGT CTGCCGGCCA
    CTGAAAAAGG CCTGGGAAGA CATTGAGGAT GTTTCCTGTC GGGATTTCAT TGAGGAATAC
    ATCACTGCCT ATCCCAACCG GCCCATGGTA CTGCTGAAGA ATGGGCAGCT GATCAAAACT
    GAGTGGGAAG GGACCTGGTG GAAATCCAGA GTGGAAGAAG TGGATGGAAG TCTGGTGAAA
    ATCCTTTTCC TGGAAGCTCT TCCCATGGGA ACTGCAAGTG TTTCCTTCTC GTTTCCACAA
    GAGGACAAAC GTTGTGAGTG GATTTACCGA GGTTCCACGC GCCTCGAGCC CATGTTCAGC
    ATGAAAACTT CCACAGCTTC CACCCAGGAA AAGAAGCAAA GTGGACAAAC CAGGACTCGT
    CCCAACGTTG GTGCTGTGAG GAGCAAGGGC CCTGTGGTCC AGTACACCCA GGATTTAGCA
    GGAACTGGTC CCCAGTACAA GACTCCAGAG CCAGCTGCAC GTCCCACATC TCCTCAGCCT
    GCGGAGATGG AGTGCTCCGA CACCCAGCTG GCCCAGGGCA GAAAGCAGGT GGCCAAGAAA
    AGCACTTCCT TCCGTCCTGG CTCCGTGGGC TCCGGGCACT CGTCCCCGTC CTCCCCTGTC
    CTCGGGGACA CCCCGGTGGC CGGGAGGACG CTCCCAGCCC CGCAGCACCG CGTCCCCAGC
    AGCGGCCCCT CTCAGCCCTT CCACGGGATG ATGGACCGCG TTCCCAACGA GCCGTCGTAC
    CGCGCCCCGC TGGAGAAGCT GTTCTACCTG CCGCACGTGT GCAGCTACGC CTGCCTGTCG
    CGGGTGCGGC CCATGCGCAG CGACCAGTAC CGCAGCCGGA ACCCGCTGCT CATCCCGCTG
    CTCTACGACT TCCGCCGCAT GACGGCGCGG CGCCGCGTCA ACCGCAAGAT GGGCTTCCAC
    GTGCTCTACA AAACGCCCTG CGGGCTCTGC CTGCGCTCCA TGCACGAGAT CGAGCGCTAC
    CTCTTCGAGA CGGACTGCGA CTTCCTCTTC CTGGAGATGT TCTGCCTGGA TCCCTACGTG
    CTGGTGGACC GCAAGTTCCA GCCCTACAAG CCCTACTACT ACATCGCCGA CATCACCAAG
    GGCAAGGAGG ACGTGCCCCT GTCGTGCGTC AACGAGATCG ACAACACGCC GCCCCCGCAG
    GTGGCCTACA GCAAGGAGCG GATCCCCGGG AAAGGGGTGT ACATCAACAC CAGCTGGGAG
    TTCCTCGTGG GCTGTGACTG CAAGGACGGC TGCAGGGACA AATCCAGGTG TGCCTGTCAC
    CAGCTGACCA TCCAGGCCAG CGGCTGCACC CCTGGAGGGC AAATCAACCC CAACTCAGGC
    TACCAGCACA AGCGGCTGGA GGAATGTCTC CCAACAGGTG TCTACGAGTG CAACAAGAGG
    TGCAAGTGCA ACGTGAACAT GTGCACCAAC CGCCTGGTCC AGCACGGCCT CCAGGTGCGG
    CTGCAGCTCT TCAAGACCCA GAACAAAGGT TGGGGCATTC GCTGCCTCGA CGACATCGCC
    AAGGGCTCCT TTGTCTGCAT CTACGCAGGG AAAATCCTCA CGGACGACTT TGCTGACAAA
    GAGGGGCTGG AGATGGGTGA CGAGTACTTT GCCAACCTGG ACCACATCGA GAGCGTGGAG
    AACTTCAAGG AGGGCTACGA GAGCGACGCC AAGTGCTCCT CGGACAACAG CGGCGTGGAC
    CTCAAGGACG ACGACGACGA CGACGAGAAC ACGGGCACGG AGGAGCTGGA GGAATCCAAC
    GAGGACAGCT CCGACGACAA CTTCTGCAAG GACGAGAACT TCAGCACGAG CTCGGTGCTG
    CGCAGCTACG CCACGCGCCG GCAGACGCGC GGCCAGCGCG ACCACGGCCC GTCCGAGACG
    GCCTCCAAGG ACTCGGGGCC AGCGCGGCCC CTCGGCCACG ACGAGCCCGC CACGGCCCCG
    CCCTGCAAGC TGCCCGTGTC CGAGGAGATC GCCAAGAACA AAGTGGCCTC GTGGCTGAGC
    TCCAACAGCG TGGCCGAGGG CTTCCAGGAC AGCGAATCCT CCTCCTTCAG GATGGGCGAA
    GGAGGAGAAG CCAAGGCTCT GAAGATGGAG ATCCCTGCAG AGAGGGAGAA GGGCTGTGCT
    TCCACGTCGG GAGATCTGAA CGGAGAGACA AAGGCAGCCA AGAAGGAGGA ACCTGAAGAA
    CCAACCAAAA CTCCTGGGCT GAGCAGCTTG GGAAGGAGGT ATGGCTACAA CCCCTGCCCG
    CCCAGGCTGG AGGGCATCCG CAGGCCGGTG AGTGGGACGG TGCTGCTGCA GAGCTGCCGG
    CGGTCCCTGG CCCTGCCGCC CTCCTCGGAG AATGTGCTGA TGGTGTCGAG CAGCACCGAC
    AGCGACGAGG AGCACAGGGC AGGGCAGGCC CCGGGCACAG CCAACGACAG CGACGACATC
    CAGACCATTT CCTCAGGATC CGAGGAGGAG GAAGGGGAGG ACAAGAAGAA TCCATCATCT
    GGGTCAGGTC CCGTGAAGAG ACAGGTGGCT GTGAAATCCA CCCGAGGCTT CGCCCTCAAG
    TCCACCCACG GCATCGCCAT CAAATCCACG CCGCTGGCGG CGGCCGACAA GGGCGAGAGC
    GCGGGGCCCG TGCGCCGCAG CACGCGGCAG TTCTACGACG GGGAGGAGAA CTGCTACATC
    ATCGACGCCA AGCTCGAGGG CAACCTGGGC CGCTACCTCA ACCACAGCTG CACCCCAAAC
    CTCTTCGTGC AGAACGTCTT CGTGGACACC CATGACCTTC GCTTCCCCTG GGTCGCCTTC
    TTCGCCAGCA AGCGGATCCG AGCGGGCACG GAGCTGACCT GGGATTACAA CTACGAGGTC
    GGCAGCGTGG AGGGCAAGGA GCTGCTGTGC TGCTGCGGGG CCATCGACTG CCGGGGCCGG
    CTGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030147085.1
    CDS304..3972
    Translation

    Target ORF information:

    RefSeq Version XM_030291225.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata SET domain bifurcated histone lysine methyltransferase 1 (SETDB1), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030291225.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGGATTCCC AGGACATGCA GGAGGTGATG GAGGAGATGG GAATCTCCAT GGAGGAGCTC 
    CAGGAAATCA TCGACAAGGA GGTGGAGAAC TCGGAGTGGG TGAGGCAGTG GAAGCAGCAG
    CTGGAGGAGC TGGAGCAGTG CATGAGGCAC AAGGAGGAGG AGGTGGCCCA CGTTGACCAG
    CTCATTGACG ATGCCATGAG GGCCATGGAC AAGTGCGAGA CGCTGGCCAA GGAGCTGTAC
    TCCATGATGG GCCTGCGGTA CCGGGACAGC AGCTCGGAGG ACGAGGCGCC GGCGGCCACC
    GAAGTGATCG AGATCCCGGA CGAGGAGGAC GACGACGTCA TGAGCGTGGA CTCGGGTTGG
    AGGCGCAGCA GCAGCAGTCC CAGAATCTCC AGGGATCAGA GTCTGCTGCG GGAAGCAATG
    GCTGCCATGA GGAAATCTGC CCGGGATGTT GCAAAATTCA TGGATGCTGT AAACAAGAAA
    ACCAACTTGC AGGAAGCACA GAAAGGTGTT GGCAAGAAAT ACAAAGTGAA ATTTGATAAT
    AAAGGGAAGA GTTTGCTCTC GGGCAACCAC ATTGCCTACG ATTACCACCC GTCTGCCGAG
    AGGCACCACG TGGGCAGGAG GGTGGTGGCC AGGTACAAGG ATGGCAATCA GATGTGGCTC
    TATGCTGGGA TCGTGGCTGA GACCCCCAAC GTGAAGAATA AAGACAGGTT CCTGATCTTC
    TTTGACGACG GCTACGCGTC GTACGTGAAG GAGTGGGAGC TGTACCCGGT CTGCCGGCCA
    CTGAAAAAGG CCTGGGAAGA CATTGAGGAT GTTTCCTGTC GGGATTTCAT TGAGGAATAC
    ATCACTGCCT ATCCCAACCG GCCCATGGTA CTGCTGAAGA ATGGGCAGCT GATCAAAACT
    GAGTGGGAAG GGACCTGGTG GAAATCCAGA GTGGAAGAAG TGGATGGAAG TCTGGTGAAA
    ATCCTTTTCC TGGAAGCTCT TCCCATGGGA ACTGCAAGTG TTTCCTTCTC GTTTCCACAA
    GAGGACAAAC GTTGTGAGTG GATTTACCGA GGTTCCACGC GCCTCGAGCC CATGTTCAGC
    ATGAAAACTT CCACAGCTTC CACCCAGGAA AAGAAGCAAA GTGGACAAAC CAGGACTCGT
    CCCAACGTTG GTGCTGTGAG GAGCAAGGGC CCTGTGGTCC AGTACACCCA GGATTTAGCA
    GGAACTGGTC CCCAGTACAA GACTCCAGAG CCAGCTGCAC GTCCCACATC TCCTCAGCCT
    GCGGAGATGG AGTGCTCCGA CACCCAGCTG GCCCAGGGCA GAAAGCAGGT GGCCAAGAAA
    AGCACTTCCT TCCGTCCTGG CTCCGTGGGC TCCGGGCACT CGTCCCCGTC CTCCCCTGTC
    CTCGGGGACA CCCCGGTGGC CGGGAGGACG CTCCCAGCCC CGCAGCACCG CGTCCCCAGC
    AGCGGCCCCT CTCAGCCCTT CCACGGGATG ATGGACCGCG TTCCCAACGA GCCGTCGTAC
    CGCGCCCCGC TGGAGAAGCT GTTCTACCTG CCGCACGTGT GCAGCTACGC CTGCCTGTCG
    CGGGTGCGGC CCATGCGCAG CGACCAGTAC CGCAGCCGGA ACCCGCTGCT CATCCCGCTG
    CTCTACGACT TCCGCCGCAT GACGGCGCGG CGCCGCGTCA ACCGCAAGAT GGGCTTCCAC
    GTGCTCTACA AAACGCCCTG CGGGCTCTGC CTGCGCTCCA TGCACGAGAT CGAGCGCTAC
    CTCTTCGAGA CGGACTGCGA CTTCCTCTTC CTGGAGATGT TCTGCCTGGA TCCCTACGTG
    CTGGTGGACC GCAAGTTCCA GCCCTACAAG CCCTACTACT ACATCGCCGA CATCACCAAG
    GGCAAGGAGG ACGTGCCCCT GTCGTGCGTC AACGAGATCG ACAACACGCC GCCCCCGCAG
    GTGGCCTACA GCAAGGAGCG GATCCCCGGG AAAGGGGTGT ACATCAACAC CAGCTGGGAG
    TTCCTCGTGG GCTGTGACTG CAAGGACGGC TGCAGGGACA AATCCAGGTG TGCCTGTCAC
    CAGCTGACCA TCCAGGCCAG CGGCTGCACC CCTGGAGGGC AAATCAACCC CAACTCAGGC
    TACCAGCACA AGCGGCTGGA GGAATGTCTC CCAACAGGTG TCTACGAGTG CAACAAGAGG
    TGCAAGTGCA ACGTGAACAT GTGCACCAAC CGCCTGGTCC AGCACGGCCT CCAGGTGCGG
    CTGCAGCTCT TCAAGACCCA GAACAAAGGT TGGGGCATTC GCTGCCTCGA CGACATCGCC
    AAGGGCTCCT TTGTCTGCAT CTACGCAGGG AAAATCCTCA CGGACGACTT TGCTGACAAA
    GAGGGGCTGG AGATGGGTGA CGAGTACTTT GCCAACCTGG ACCACATCGA GAGCGTGGAG
    AACTTCAAGG AGGGCTACGA GAGCGACGCC AAGTGCTCCT CGGACAACAG CGGCGTGGAC
    CTCAAGGACG ACGACGACGA CGACGAGAAC ACGGGCACGG AGGAGCTGGA GGAATCCAAC
    GAGGACAGCT CCGACGACAA CTTCTGCAAG GACGAGAACT TCAGCACGAG CTCGGTGCTG
    CGCAGCTACG CCACGCGCCG GCAGACGCGC GGCCAGCGCG ACCACGGCCC GTCCGAGACG
    GCCTCCAAGG ACTCGGGGCC AGCGCGGCCC CTCGGCCACG ACGAGCCCGC CACGGCCCCG
    CCCTGCAAGC TGCCCGTGTC CGAGGAGATC GCCAAGAACA AAGTGGCCTC GTGGCTGAGC
    TCCAACAGCG TGGCCGAGGG CTTCCAGGAC AGCGAATCCT CCTCCTTCAG GATGGGCGAA
    GGAGGAGAAG CCAAGGCTCT GAAGATGGAG ATCCCTGCAG AGAGGGAGAA GGGCTGTGCT
    TCCACGTCGG GAGATCTGAA CGGAGAGACA AAGGCAGCCA AGAAGGAGGA ACCTGAAGAA
    CCAACCAAAA CTCCTGGGCT GAGCAGCTTG GGAAGGAGGT ATGGCTACAA CCCCTGCCCG
    CCCAGGCTGG AGGGCATCCG CAGGCCGGTG AGTGGGACGG TGCTGCTGCA GAGCTGCCGG
    CGGTCCCTGG CCCTGCCGCC CTCCTCGGAG AATGTGCTGA TGGTGTCGAG CAGCACCGAC
    AGCGACGAGG AGCACAGGGC AGGGCAGGCC CCGGGCACAG CCAACGACAG CGACGACATC
    CAGACCATTT CCTCAGGATC CGAGGAGGAG GAAGGGGAGG ACAAGAAGAA TCCATCATCT
    GGGTCAGGTC CCGTGAAGAG ACAGGTGGCT GTGAAATCCA CCCGAGGCTT CGCCCTCAAG
    TCCACCCACG GCATCGCCAT CAAATCCACG CCGCTGGCGG CGGCCGACAA GGGCGAGAGC
    GCGGGGCCCG TGCGCCGCAG CACGCGGCAG TTCTACGACG GGGAGGAGAA CTGCTACATC
    ATCGACGCCA AGCTCGAGGG CAACCTGGGC CGCTACCTCA ACCACAGCTG CACCCCAAAC
    CTCTTCGTGC AGAACGTCTT CGTGGACACC CATGACCTTC GCTTCCCCTG GGTCGCCTTC
    TTCGCCAGCA AGCGGATCCG AGCGGGCACG GAGCTGACCT GGGATTACAA CTACGAGGTC
    GGCAGCGTGG AGGGCAAGGA GCTGCTGTGC TGCTGCGGGG CCATCGACTG CCGGGGCCGG
    CTGCTCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd20138
    Clone ID Related Accession (Same CDS sequence) XM_012570892.1
    Accession Version XM_012570892.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3645bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-05-25
    Organism Taeniopygia guttata(zebra finch)
    Product LOW QUALITY PROTEIN: histone-lysine N-methyltransferase SETDB1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_002198055.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Taeniopygia guttata Annotation Release 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAGGGCCA TGGACAAGTG CGAGACGCTG GCCAAGGAGC TGTACTCCAT GATGGGCCTG 
    CGGTACCGGG ACAGCAGCTC GGAGGACGAG GCGCCGGCGG CCACCGAAGT GATCGAGATC
    CCGGACGAGG AGGACGACGA CGTCATGAGC GTGGACTCGG GTTGGAGGCG CAGCAGCAGC
    AGTCCCAGAA TCTCCAGGGA TCAGAGTCTG CTGCGGGAAG CAATGGCTGC CATGAGGAAA
    TCTGCCCGGG ATGTTGCAAA ATTCATGGAT GCTGTAAACA AGAAAACCAA CTTGCAGGAA
    GCACAGAAAG ATGCACAACC CCCTCAGGAA TCTCCTGGCA CTGCCCAGCC CATCAGTGTC
    CCTGCAGCCC CTAGCAATGA TCTCAACACT GATGGGGACC TCAAAGTGGG CATGAGGATT
    TTGGGGAAAA AAAGAACCAA GACGTGGCAC AAGGGGACGT TGATTGCCAT CCAGACGGTC
    GGTGTTGGCA AGAAATACAA AGTGAAATTT GATAATAAAG GGAAGAGTTT GCTCTCGGGC
    AACCACATTG CCTACGATTA CCACCCGTCT GCCGAGAGGC ACCACGTGGG CAGGAGGGTG
    GTGGCCAGGT ACAAGGATGG CAATCAGATG TGGCTCTATG CTGGGATCGT GGCTGAGACC
    CCCAACGTGA AGAATAAAGA CAGGTTCCTG ATCTTCTTTG ACGACGGCTA CGCGTCGTAC
    GTGAAGGAGT GGGAGCTGTA CCCGGTTTGC CGGCCACTGA AAAAGGCCTG GGAAGACATT
    GAGGATGTTT CCTGTCGGGA TTCCNATGAG GAATACATCA CTGCCTATCC CAACCGGCCC
    ATGGTACTGC TGAAGAATGG GCAGCTGATC AAAACTGAGT GGGAAGGGGA CTGGTGGAAA
    TCCAGAGTGG AAGAAGTGGA TGGAAGTCTG GTGAAAATCC TTTTCCTGGA AGCTCTTCCC
    ATGGGAACTG CAAGTGTTTC CTTCTCGTTT CCACAAGAGG ACAAACGTTG TGAGTGGATT
    TACCGAGGTT CCACGCGCCT CGAGCCCATG TTCAGCATGA AAACTTCCAC AGCTTCCACC
    CAGGAAAAGA AGCAAAGTGG ACAAACCAGG ACTCGTCCCA ACGTTGGTGC TGTGAGGAGC
    AAGGGCCCTG TGGTCCAGTA CACCCAGGAT TTAGCAGGAA CTGGTCCCCA GTACAAGACT
    CCAGAGCCAG CTGCACGTCC CACATCTCCT CAGCCTGCGG AGATGGAGTG CTCCGACACC
    CAGCTGGCCC AGGGCAGAAA GCAGGTGGCC AAGAAAAGCA CTTCCTTCCG TCCTGGCTCC
    GTGGGCTCCG GGCACTCGTC CCCGTCCTCC CCTGTCCTCG GGGACACCCC AGTGGCCGGG
    AGGACGCTCC CAGCCCCGCA GCACCGCGGC CCCAGCAGCG GCCCCTCTCA GCCCTTCCAC
    GGGATGATGG ACCGCGTTCC CAACGAGCCG TCTTACCGCG CCCCGCTGGA AAAGCTGTTC
    TACCTGCCGC ACGTGTGCTA CTACGCCTGC CTGTCGCGNN NNCGGCCCAT GCGCAGCGAC
    CAGTACCGCA GCCGGAACCC GCTGCTCATC CCGCTGCTCT ACGACTTCCG CCGCATGACG
    GCGCGGCGCC GCGTCAACCG CAAGATGGGC TTCCACGTGC TCTACAAAAC GCCCTGCGGG
    CTCTGCCTGC GCTCCATGCA CGAGATCGAG CGCTACCTCT TCGAGACGGA CTGCGACTTC
    CTCTTCCTGG AGATGTTCTG CCTGGATCCC TACGTGCTGG TGGACCGCAA GTTCCAGCCC
    TACAAGCCCT ACTACTACAT CGCCGACATC ACCAAGGGCA AGGAGGACGT GCCCCTGTCG
    TGCGTCAACG AGATCGACAA CACGCCGCCC CCGCAGGTGG CCTACAGCAA GGAGCGGATC
    CCCGGGAAAG GGGTGTACAT CAACACCAGC TGGGAGTTCC TCGTGGGCTG TGACTGCAAG
    GACGGCTGCA GGGACAAATC CAGGTGTGCC TGTCACCAGC TGACCATCCA GGCCAGCGGC
    TGCACCCCTG GAGGGCAAAT CAACCCCAAC TCAGGCTACC AGCACAAGCG GCTGGAGGAA
    TGTCTCCCAA CAGGTGTCTA CGAGTGCAAC AAGAGGTGCA AGTGCAACGT GAACATGTGC
    ACCAACCGCC TGGTCCAGCA CGGCCTCCAG GTGCGGCTGC AGCTCTTCAA GACCCAGAAC
    AAAGGTTGGG GCATTCGCTG CCTCGACGAC ATCGCCAAGG GCTCCTTTGT CTGCATCTAC
    GCAGGGAAAA TCCTCACGGA CGACTTTGCT GACAAAGAGG GGCTGGAGAT GGGTGACGAG
    TACTTTGCCA ACCTGGACCA CATCGAGAGC GTGGAGAACT TCAAGGAGGG CTACGAGAGC
    GACGCCAAGT GCTCCTCGGA CAACAGCGGC GTGGACCTCA AGGACGACGA CGACGACGAC
    GAGAACACGG GCACGGAGGA GCTGGAGGAA TCCAACGAGG ACAGCTCCGA CGACAACTTC
    TGCAAGGACG AGAACTTCAG CACGAGCTCG GTGCTGCGCA GCTACGCCAC GCGCCGGCAG
    ACGCGCGGCC AGCGCGACCA CGGCCCGTCC GAGACGGCCT CCAAGGACTC GGGGCCAGCG
    CGGCCCCTCG GCCACGACGA GCCCGCCACG GCCCCGCCCT GCAAGCTGCC CGTGTCCGAG
    GAGATCGCCA AGAACAAAGT GGCCTCGTGG CTGAGCTCCA ACAGCGTGGC CGAGGGCTTC
    CAGGACAGCG AATCCTCCTC CTTCAGGATG GGCGAAGGAG GAGAAGCCAA GGCTCTGAAG
    ATGGAGATCC CTGCAGAGAG GGAGAAGGGC TGTGCTTCCA CGTCGGGAGA TCTGAACGGA
    GAGACAAAGG CAACCAAGAA GGAGGAACCT GAAGAACCAA CCAAAACTCC TGGGCTGAGC
    AGCTTGGGAA GGAGGTATGG CTACAACCCC TGCCCGCCCA GGCTGGAGGG CATCCGCAGG
    CCGGTGAGTG GGACGGTGCT GCTGCAGAGC TGCCGGCGGT CCCTGGCCCT GCCGCCCTCC
    TCGGAGAATG TGCTGATGGT GTCGAGCAGC ACCGACAGCG ACGAGGAGCA CAGGGCAGGG
    CAGGCCCCGG GCACAGCCAA CGACAGCGAC GACATCCAGA CCATTTCCTC AGGATCCGAG
    GAGGAGGAAG GGGAGGACAA GAAGAATCCA TCATCTGGGT CAGGTCCCGT GAAGAGACAG
    GTGGCTGTGA AATCCACCCG AGGCTTCGCC CTCAAGTCCA CCCACGGCAT CGCCATCAAA
    TCCACGCCGC TGGCGGCGGC CGACAAGGGC GAGAGCGCGG GGCCCGTGCG CCGCAGCACG
    CGGCAGTTCT ACGACGGGGA GGAGAACTGC TACATCATCG ACGCCAAGCT CGAGGGCAAC
    CTGGGCCGCT ACCTCAACCA CAGCTGCACC CCAAACCTCT TCGTGCAGAA CGTCTTCGTG
    GACACCCATG ACCTTCGCTT CCCCTGGGTC GCCTTCTTCG CCAGCAAGCG GATCCGAGCG
    GGCACGGAGC TGACCTGGGA TTACAACTAC GAGGTCGGCA GCGTGGAGGG CAAGGAGCTG
    CTGTGCTGCT GCGGGGCCAT CGACTGCCGG GGCCGGCTGC TCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012426346.1
    CDS33..3677
    Translation

    Target ORF information:

    RefSeq Version XM_012570892.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata SET domain, bifurcated 1 (SETDB1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012570892.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAGGGCCA TGGACAAGTG CGAGACGCTG GCCAAGGAGC TGTACTCCAT GATGGGCCTG 
    CGGTACCGGG ACAGCAGCTC GGAGGACGAG GCGCCGGCGG CCACCGAAGT GATCGAGATC
    CCGGACGAGG AGGACGACGA CGTCATGAGC GTGGACTCGG GTTGGAGGCG CAGCAGCAGC
    AGTCCCAGAA TCTCCAGGGA TCAGAGTCTG CTGCGGGAAG CAATGGCTGC CATGAGGAAA
    TCTGCCCGGG ATGTTGCAAA ATTCATGGAT GCTGTAAACA AGAAAACCAA CTTGCAGGAA
    GCACAGAAAG ATGCACAACC CCCTCAGGAA TCTCCTGGCA CTGCCCAGCC CATCAGTGTC
    CCTGCAGCCC CTAGCAATGA TCTCAACACT GATGGGGACC TCAAAGTGGG CATGAGGATT
    TTGGGGAAAA AAAGAACCAA GACGTGGCAC AAGGGGACGT TGATTGCCAT CCAGACGGTC
    GGTGTTGGCA AGAAATACAA AGTGAAATTT GATAATAAAG GGAAGAGTTT GCTCTCGGGC
    AACCACATTG CCTACGATTA CCACCCGTCT GCCGAGAGGC ACCACGTGGG CAGGAGGGTG
    GTGGCCAGGT ACAAGGATGG CAATCAGATG TGGCTCTATG CTGGGATCGT GGCTGAGACC
    CCCAACGTGA AGAATAAAGA CAGGTTCCTG ATCTTCTTTG ACGACGGCTA CGCGTCGTAC
    GTGAAGGAGT GGGAGCTGTA CCCGGTTTGC CGGCCACTGA AAAAGGCCTG GGAAGACATT
    GAGGATGTTT CCTGTCGGGA TTCCNATGAG GAATACATCA CTGCCTATCC CAACCGGCCC
    ATGGTACTGC TGAAGAATGG GCAGCTGATC AAAACTGAGT GGGAAGGGGA CTGGTGGAAA
    TCCAGAGTGG AAGAAGTGGA TGGAAGTCTG GTGAAAATCC TTTTCCTGGA AGCTCTTCCC
    ATGGGAACTG CAAGTGTTTC CTTCTCGTTT CCACAAGAGG ACAAACGTTG TGAGTGGATT
    TACCGAGGTT CCACGCGCCT CGAGCCCATG TTCAGCATGA AAACTTCCAC AGCTTCCACC
    CAGGAAAAGA AGCAAAGTGG ACAAACCAGG ACTCGTCCCA ACGTTGGTGC TGTGAGGAGC
    AAGGGCCCTG TGGTCCAGTA CACCCAGGAT TTAGCAGGAA CTGGTCCCCA GTACAAGACT
    CCAGAGCCAG CTGCACGTCC CACATCTCCT CAGCCTGCGG AGATGGAGTG CTCCGACACC
    CAGCTGGCCC AGGGCAGAAA GCAGGTGGCC AAGAAAAGCA CTTCCTTCCG TCCTGGCTCC
    GTGGGCTCCG GGCACTCGTC CCCGTCCTCC CCTGTCCTCG GGGACACCCC AGTGGCCGGG
    AGGACGCTCC CAGCCCCGCA GCACCGCGGC CCCAGCAGCG GCCCCTCTCA GCCCTTCCAC
    GGGATGATGG ACCGCGTTCC CAACGAGCCG TCTTACCGCG CCCCGCTGGA AAAGCTGTTC
    TACCTGCCGC ACGTGTGCTA CTACGCCTGC CTGTCGCGNN NNCGGCCCAT GCGCAGCGAC
    CAGTACCGCA GCCGGAACCC GCTGCTCATC CCGCTGCTCT ACGACTTCCG CCGCATGACG
    GCGCGGCGCC GCGTCAACCG CAAGATGGGC TTCCACGTGC TCTACAAAAC GCCCTGCGGG
    CTCTGCCTGC GCTCCATGCA CGAGATCGAG CGCTACCTCT TCGAGACGGA CTGCGACTTC
    CTCTTCCTGG AGATGTTCTG CCTGGATCCC TACGTGCTGG TGGACCGCAA GTTCCAGCCC
    TACAAGCCCT ACTACTACAT CGCCGACATC ACCAAGGGCA AGGAGGACGT GCCCCTGTCG
    TGCGTCAACG AGATCGACAA CACGCCGCCC CCGCAGGTGG CCTACAGCAA GGAGCGGATC
    CCCGGGAAAG GGGTGTACAT CAACACCAGC TGGGAGTTCC TCGTGGGCTG TGACTGCAAG
    GACGGCTGCA GGGACAAATC CAGGTGTGCC TGTCACCAGC TGACCATCCA GGCCAGCGGC
    TGCACCCCTG GAGGGCAAAT CAACCCCAAC TCAGGCTACC AGCACAAGCG GCTGGAGGAA
    TGTCTCCCAA CAGGTGTCTA CGAGTGCAAC AAGAGGTGCA AGTGCAACGT GAACATGTGC
    ACCAACCGCC TGGTCCAGCA CGGCCTCCAG GTGCGGCTGC AGCTCTTCAA GACCCAGAAC
    AAAGGTTGGG GCATTCGCTG CCTCGACGAC ATCGCCAAGG GCTCCTTTGT CTGCATCTAC
    GCAGGGAAAA TCCTCACGGA CGACTTTGCT GACAAAGAGG GGCTGGAGAT GGGTGACGAG
    TACTTTGCCA ACCTGGACCA CATCGAGAGC GTGGAGAACT TCAAGGAGGG CTACGAGAGC
    GACGCCAAGT GCTCCTCGGA CAACAGCGGC GTGGACCTCA AGGACGACGA CGACGACGAC
    GAGAACACGG GCACGGAGGA GCTGGAGGAA TCCAACGAGG ACAGCTCCGA CGACAACTTC
    TGCAAGGACG AGAACTTCAG CACGAGCTCG GTGCTGCGCA GCTACGCCAC GCGCCGGCAG
    ACGCGCGGCC AGCGCGACCA CGGCCCGTCC GAGACGGCCT CCAAGGACTC GGGGCCAGCG
    CGGCCCCTCG GCCACGACGA GCCCGCCACG GCCCCGCCCT GCAAGCTGCC CGTGTCCGAG
    GAGATCGCCA AGAACAAAGT GGCCTCGTGG CTGAGCTCCA ACAGCGTGGC CGAGGGCTTC
    CAGGACAGCG AATCCTCCTC CTTCAGGATG GGCGAAGGAG GAGAAGCCAA GGCTCTGAAG
    ATGGAGATCC CTGCAGAGAG GGAGAAGGGC TGTGCTTCCA CGTCGGGAGA TCTGAACGGA
    GAGACAAAGG CAACCAAGAA GGAGGAACCT GAAGAACCAA CCAAAACTCC TGGGCTGAGC
    AGCTTGGGAA GGAGGTATGG CTACAACCCC TGCCCGCCCA GGCTGGAGGG CATCCGCAGG
    CCGGTGAGTG GGACGGTGCT GCTGCAGAGC TGCCGGCGGT CCCTGGCCCT GCCGCCCTCC
    TCGGAGAATG TGCTGATGGT GTCGAGCAGC ACCGACAGCG ACGAGGAGCA CAGGGCAGGG
    CAGGCCCCGG GCACAGCCAA CGACAGCGAC GACATCCAGA CCATTTCCTC AGGATCCGAG
    GAGGAGGAAG GGGAGGACAA GAAGAATCCA TCATCTGGGT CAGGTCCCGT GAAGAGACAG
    GTGGCTGTGA AATCCACCCG AGGCTTCGCC CTCAAGTCCA CCCACGGCAT CGCCATCAAA
    TCCACGCCGC TGGCGGCGGC CGACAAGGGC GAGAGCGCGG GGCCCGTGCG CCGCAGCACG
    CGGCAGTTCT ACGACGGGGA GGAGAACTGC TACATCATCG ACGCCAAGCT CGAGGGCAAC
    CTGGGCCGCT ACCTCAACCA CAGCTGCACC CCAAACCTCT TCGTGCAGAA CGTCTTCGTG
    GACACCCATG ACCTTCGCTT CCCCTGGGTC GCCTTCTTCG CCAGCAAGCG GATCCGAGCG
    GGCACGGAGC TGACCTGGGA TTACAACTAC GAGGTCGGCA GCGTGGAGGG CAAGGAGCTG
    CTGTGCTGCT GCGGGGCCAT CGACTGCCGG GGCCGGCTGC TCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.