CP cDNA ORF clone, Taeniopygia guttata(zebra finch)

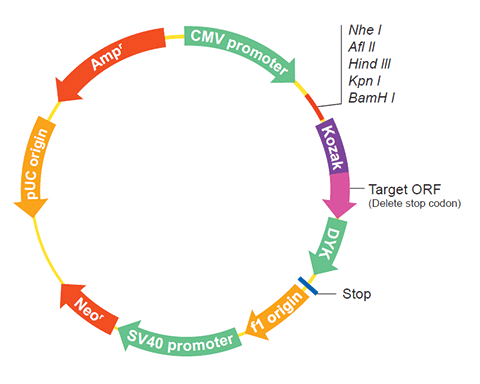
The following CP gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the CP cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OTd52032 XM_030280437.1
Latest version!
Taeniopygia guttata ceruloplasmin (CP), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd52030 XM_012575773.2
Latest version!
Taeniopygia guttata ceruloplasmin (CP), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OTd52031 XM_012575774.2
Latest version!
Taeniopygia guttata ceruloplasmin (CP), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OTd14591 XM_012575773.1
Latest version!
Taeniopygia guttata ceruloplasmin (ferroxidase) (CP), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 20 $629.30
$899.00
OTd14592 XM_012575774.1
Latest version!
Taeniopygia guttata ceruloplasmin (ferroxidase) (CP), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 20 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OTd52032
    Clone ID Related Accession (Same CDS sequence) XM_030280437.1
    Accession Version XM_030280437.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2586bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
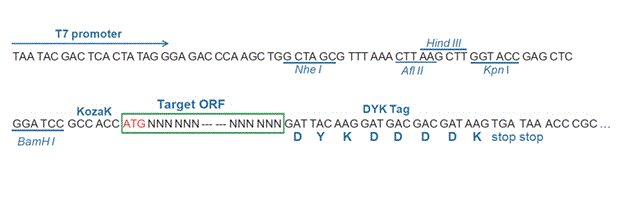
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product ceruloplasmin isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044221.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGAAGCTAT TTCTCCTAAT CTGCTTGCTG ATTTCTTGCT GTTTCCATGC TGGGGCAGTG 
    AACCGGGAGT ACTATATTGG CATTACAGAG ACTGTCTGGA ACTATGCACC TGGCAATGCC
    AGTGCCATCT CTGGGCAGCT TTTTGCAGAA GAAGAGCAGG CTGAAGTCTT TCTCAAAAGA
    GGACCACAGA GGATAGGAAA CACTTACAAG AAGGCTATCT ACGTTCAATA TACCAATCAT
    TTATATGATG AGATAATTGA CAAACCTTCC TGGCTGGGTT TTTTGGGTCC TGTAATTAAG
    GGAGAAGTTG GAGATTCCAT TACTATTCAC TTGAAAAACT TTGCTTCCAG AAACTACACG
    CTACATCCAC ACGGTGTAAG ATACACAAAA GAAAATGAAG GCGCTTTTTA TCCTGACACC
    ACCAAAGATT TGCAAAAGCG AGATGATGCT GTGGAGCCTG GAGGCCAGTA CACTTACACA
    TGGGATGTGA CAGAAGATCA AGGTCCCGCT GAAGCAGATG CAGACTGTAT AACCAGGGTT
    TACCACTCCC ACATAGATGC TCCAAGAGAT GTTGCCTCAG GGCTTGTTGG ACCTCTAATA
    ATTTGCAGGA AAGATACAAT GAATAGGGAT ACTGATCAAC ACTTTGATGC TGAATTTATC
    CTTATGTTTT CTGTGGTGGA TGAAAATCTC AGTTGGTATC TAGAGGACAA TATCAGAACA
    TACTGTTTTG AGCCTTCCAA AGTGGACAAA GATGATGAGG ACTTCCAGGA AAGCAATAAA
    ATGCACTCAA TCAATGGGTA CATGTATGGA TACCTCCCAA ACCTCACAAT GTGTGTGGAA
    GATAAGATAA AATGGTATCT TTTTGGCATG GGTAATGAAG CTGATATCCA TTCAGCCTAC
    TTTCATGGGC AGACCTTAAT AGAAAGGCAT CATCGAGTTG ACACCATCAG CCTCTTCCCA
    GCCACATTCG TTGATGCTGT CATGGTACCA AGGAGCCCTG GGGAATGGCT GCTCAGCTGC
    CAAGTGAATG ACCACATTGA AGGTGGTATG CAGGCCCTTT TTAAAGTAGA AGATTGTAAG
    AAACCCACAC CAAGTCACAG TGAGAGTACA AAGATAAGAC AGTACTTCCT TGCTGCTGAA
    GAGATTATCT GGAATTATGG CCCATCTGCA GTGAACAATT TTACAGGACA AGAATTAATT
    GTCGACAGTG AATCTCAGAT ATTTTTTGAA CAAAGTGAGA CAAGAATTGG TGGCTCCTAC
    AAAAAAGCAA TTTACAAGGA ATACACAGAT GGTTCTTTCA CTGAACATAA AAAAAGACTT
    GCAGAGGAAG CACATCTTGG ACTCCTAGGA CCTGTGATCA GGGCTGAAGT GGGTGAGCGC
    ATCAGGGTGA CCTTCCGGAA CAACGCCAGC CGCCCGTTCA GCATCCAGCC CCACGGCGTG
    AGCTACCGCA GGAGCGGGGC CGGGGCGCGC TTTGGCACCG CCGCCGCAGG TACCGAATCT
    CCAGCCTCTC ACGTGAGTCC CGGCACCACA TTTACATATG AATGGGACGT ACCAGAAGAT
    GTGGGTCCCA CAGAGCAAGA CCCAGACTGT TTAACCTGGC TTTATTACTC AGCTGTGGAT
    GCAGTCAGAG ACACCAGTTC TGGTCTTGTG GGTCCTCTCC TAGTGTGCAG GAAAGGAGCT
    CTGCTTTCTT CTGGGAAACA GAAAAATGTG AACATGGAGT TTTTTCTACT TGCCACGGTA
    TTTGATGAGA ATCTGAGCTG GTATTTGGAT GATAATATTT TGATGTTTAC ACTAAATCCT
    GGTAAAATTG ACAAAGATGA TGAAGACTTC CAAGAGTCTA ACAAAATGCA CTCCATTAAT
    GGTTATATGT ATGGAAATCA GCCTGGTCTT GAGATGTGTA AAGGAAGTGT TGTTTCCTGG
    CATTTGATGG GCTTGGGTTC AGAAGTTGAT GTCCATGGGA TATACTTCTC AGAAAACACA
    TTTGTAACTA AAGGAACAAG AAGGGATACA GCAAATCTGT TTCCACATGC AGTTCTTACA
    GCTATTATGA AGCCTGATTC TGAAGGAATT TTTGAAGTGT CCTGCCTGAC AGCAGACCAC
    TACACTGGGG GCATGAAACA GAACTACAAA GTGAAAAAAT GCCACAGGGG GAAAGGAGAT
    GTATCTACGT ATTTGCATGA AAAGATTTAC TACATTGCTG CAGTGGAAGT TGAATGGGAC
    TATTCTCCTA ACAGGACATG GGAATTCGAG CGGCATCAAT ACCATGAGGA AAGCCCTGGC
    AATCCATTTT TAAATAAAGA TGACAAATTC ATTGGCTCAA AGTACAAAAA GGTAGTATAT
    CGCGAGTACA CCGATCAGAC ATTCAGTACC CTCAAAAACA GAGCAAAGGA GCAGCAGCAC
    CTGGAAATTC AAGGACCACT GCTTGTGTCA AATACTGGAG ATAAAATTAC AATAGTTTTT
    AAGAACTTAG CATCAAGACC TTATTCTATC CACGCCCATG GAGTGAAAAC AGACAGTTCT
    GTTGTTGCTG TAACTAACCC AGGACACTTA CAGTGGATTA ATAGGCACAC TCGTTGTGTG
    TCATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030136297.1
    CDS241..2826
    Translation

    Target ORF information:

    RefSeq Version XM_030280437.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata ceruloplasmin (CP), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030280437.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGAAGCTAT TTCTCCTAAT CTGCTTGCTG ATTTCTTGCT GTTTCCATGC TGGGGCAGTG 
    AACCGGGAGT ACTATATTGG CATTACAGAG ACTGTCTGGA ACTATGCACC TGGCAATGCC
    AGTGCCATCT CTGGGCAGCT TTTTGCAGAA GAAGAGCAGG CTGAAGTCTT TCTCAAAAGA
    GGACCACAGA GGATAGGAAA CACTTACAAG AAGGCTATCT ACGTTCAATA TACCAATCAT
    TTATATGATG AGATAATTGA CAAACCTTCC TGGCTGGGTT TTTTGGGTCC TGTAATTAAG
    GGAGAAGTTG GAGATTCCAT TACTATTCAC TTGAAAAACT TTGCTTCCAG AAACTACACG
    CTACATCCAC ACGGTGTAAG ATACACAAAA GAAAATGAAG GCGCTTTTTA TCCTGACACC
    ACCAAAGATT TGCAAAAGCG AGATGATGCT GTGGAGCCTG GAGGCCAGTA CACTTACACA
    TGGGATGTGA CAGAAGATCA AGGTCCCGCT GAAGCAGATG CAGACTGTAT AACCAGGGTT
    TACCACTCCC ACATAGATGC TCCAAGAGAT GTTGCCTCAG GGCTTGTTGG ACCTCTAATA
    ATTTGCAGGA AAGATACAAT GAATAGGGAT ACTGATCAAC ACTTTGATGC TGAATTTATC
    CTTATGTTTT CTGTGGTGGA TGAAAATCTC AGTTGGTATC TAGAGGACAA TATCAGAACA
    TACTGTTTTG AGCCTTCCAA AGTGGACAAA GATGATGAGG ACTTCCAGGA AAGCAATAAA
    ATGCACTCAA TCAATGGGTA CATGTATGGA TACCTCCCAA ACCTCACAAT GTGTGTGGAA
    GATAAGATAA AATGGTATCT TTTTGGCATG GGTAATGAAG CTGATATCCA TTCAGCCTAC
    TTTCATGGGC AGACCTTAAT AGAAAGGCAT CATCGAGTTG ACACCATCAG CCTCTTCCCA
    GCCACATTCG TTGATGCTGT CATGGTACCA AGGAGCCCTG GGGAATGGCT GCTCAGCTGC
    CAAGTGAATG ACCACATTGA AGGTGGTATG CAGGCCCTTT TTAAAGTAGA AGATTGTAAG
    AAACCCACAC CAAGTCACAG TGAGAGTACA AAGATAAGAC AGTACTTCCT TGCTGCTGAA
    GAGATTATCT GGAATTATGG CCCATCTGCA GTGAACAATT TTACAGGACA AGAATTAATT
    GTCGACAGTG AATCTCAGAT ATTTTTTGAA CAAAGTGAGA CAAGAATTGG TGGCTCCTAC
    AAAAAAGCAA TTTACAAGGA ATACACAGAT GGTTCTTTCA CTGAACATAA AAAAAGACTT
    GCAGAGGAAG CACATCTTGG ACTCCTAGGA CCTGTGATCA GGGCTGAAGT GGGTGAGCGC
    ATCAGGGTGA CCTTCCGGAA CAACGCCAGC CGCCCGTTCA GCATCCAGCC CCACGGCGTG
    AGCTACCGCA GGAGCGGGGC CGGGGCGCGC TTTGGCACCG CCGCCGCAGG TACCGAATCT
    CCAGCCTCTC ACGTGAGTCC CGGCACCACA TTTACATATG AATGGGACGT ACCAGAAGAT
    GTGGGTCCCA CAGAGCAAGA CCCAGACTGT TTAACCTGGC TTTATTACTC AGCTGTGGAT
    GCAGTCAGAG ACACCAGTTC TGGTCTTGTG GGTCCTCTCC TAGTGTGCAG GAAAGGAGCT
    CTGCTTTCTT CTGGGAAACA GAAAAATGTG AACATGGAGT TTTTTCTACT TGCCACGGTA
    TTTGATGAGA ATCTGAGCTG GTATTTGGAT GATAATATTT TGATGTTTAC ACTAAATCCT
    GGTAAAATTG ACAAAGATGA TGAAGACTTC CAAGAGTCTA ACAAAATGCA CTCCATTAAT
    GGTTATATGT ATGGAAATCA GCCTGGTCTT GAGATGTGTA AAGGAAGTGT TGTTTCCTGG
    CATTTGATGG GCTTGGGTTC AGAAGTTGAT GTCCATGGGA TATACTTCTC AGAAAACACA
    TTTGTAACTA AAGGAACAAG AAGGGATACA GCAAATCTGT TTCCACATGC AGTTCTTACA
    GCTATTATGA AGCCTGATTC TGAAGGAATT TTTGAAGTGT CCTGCCTGAC AGCAGACCAC
    TACACTGGGG GCATGAAACA GAACTACAAA GTGAAAAAAT GCCACAGGGG GAAAGGAGAT
    GTATCTACGT ATTTGCATGA AAAGATTTAC TACATTGCTG CAGTGGAAGT TGAATGGGAC
    TATTCTCCTA ACAGGACATG GGAATTCGAG CGGCATCAAT ACCATGAGGA AAGCCCTGGC
    AATCCATTTT TAAATAAAGA TGACAAATTC ATTGGCTCAA AGTACAAAAA GGTAGTATAT
    CGCGAGTACA CCGATCAGAC ATTCAGTACC CTCAAAAACA GAGCAAAGGA GCAGCAGCAC
    CTGGAAATTC AAGGACCACT GCTTGTGTCA AATACTGGAG ATAAAATTAC AATAGTTTTT
    AAGAACTTAG CATCAAGACC TTATTCTATC CACGCCCATG GAGTGAAAAC AGACAGTTCT
    GTTGTTGCTG TAACTAACCC AGGACACTTA CAGTGGATTA ATAGGCACAC TCGTTGTGTG
    TCATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd52030
    Clone ID Related Accession (Same CDS sequence) XM_012575773.2
    Accession Version XM_012575773.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3183bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product ceruloplasmin isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044221.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Aug 9, 2019 this sequence version replaced XM_012575773.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGAAGCTAT TTCTCCTAAT CTGCTTGCTG ATTTCTTGCT GTTTCCATGC TGGGGCAGTG 
    AACCGGGAGT ACTATATTGG CATTACAGAG ACTGTCTGGA ACTATGCACC TGGCAATGCC
    AGTGCCATCT CTGGGCAGCT TTTTGCAGAA GAAGAGCAGG CTGAAGTCTT TCTCAAAAGA
    GGACCACAGA GGATAGGAAA CACTTACAAG AAGGCTATCT ACGTTCAATA TACCAATCAT
    TTATATGATG AGATAATTGA CAAACCTTCC TGGCTGGGTT TTTTGGGTCC TGTAATTAAG
    GGAGAAGTTG GAGATTCCAT TACTATTCAC TTGAAAAACT TTGCTTCCAG AAACTACACG
    CTACATCCAC ACGGTGTAAG ATACACAAAA GAAAATGAAG GCGCTTTTTA TCCTGACACC
    ACCAAAGATT TGCAAAAGCG AGATGATGCT GTGGAGCCTG GAGGCCAGTA CACTTACACA
    TGGGATGTGA CAGAAGATCA AGGTCCCGCT GAAGCAGATG CAGACTGTAT AACCAGGGTT
    TACCACTCCC ACATAGATGC TCCAAGAGAT GTTGCCTCAG GGCTTGTTGG ACCTCTAATA
    ATTTGCAGGA AAGATACAAT GAATAGGGAT ACTGATCAAC ACTTTGATGC TGAATTTATC
    CTTATGTTTT CTGTGGTGGA TGAAAATCTC AGTTGGTATC TAGAGGACAA TATCAGAACA
    TACTGTTTTG AGCCTTCCAA AGTGGACAAA GATGATGAGG ACTTCCAGGA AAGCAATAAA
    ATGCACTCAA TCAATGGGTA CATGTATGGA TACCTCCCAA ACCTCACAAT GTGTGTGGAA
    GATAAGATAA AATGGTATCT TTTTGGCATG GGTAATGAAG CTGATATCCA TTCAGCCTAC
    TTTCATGGGC AGACCTTAAT AGAAAGGCAT CATCGAGTTG ACACCATCAG CCTCTTCCCA
    GCCACATTCG TTGATGCTGT CATGGTACCA AGGAGCCCTG GGGAATGGCT GCTCAGCTGC
    CAAGTGAATG ACCACATTGA AGGTGGTATG CAGGCCCTTT TTAAAGTAGA AGATTGTAAG
    AAACCCACAC CAAGTCACAG TGAGAGTACA AAGATAAGAC AGTACTTCCT TGCTGCTGAA
    GAGATTATCT GGAATTATGG CCCATCTGCA GTGAACAATT TTACAGGACA AGAATTAATT
    GTCGACAGTG AATCTCAGAT ATTTTTTGAA CAAAGTGAGA CAAGAATTGG TGGCTCCTAC
    AAAAAAGCAA TTTACAAGGA ATACACAGAT GGTTCTTTCA CTGAACATAA AAAAAGACTT
    GCAGAGGAAG CACATCTTGG ACTCCTAGGA CCTGTGATCA GGGCTGAAGT GGGTGAGCGC
    ATCAGGGTGA CCTTCCGGAA CAACGCCAGC CGCCCGTTCA GCATCCAGCC CCACGGCGTG
    AGCTACCGCA GGAGCGGGGC CGGGGCGCGC TTTGGCACCG CCGCCGCAGG TACCGAATCT
    CCAGCCTCTC ACGTGAGTCC CGGCACCACA TTTACATATG AATGGGACGT ACCAGAAGAT
    GTGGGTCCCA CAGAGCAAGA CCCAGACTGT TTAACCTGGC TTTATTACTC AGCTGTGGAT
    GCAGTCAGAG ACACCAGTTC TGGTCTTGTG GGTCCTCTCC TAGTGTGCAG GAAAGGAGCT
    CTGCTTTCTT CTGGGAAACA GAAAAATGTG AACATGGAGT TTTTTCTACT TGCCACGGTA
    TTTGATGAGA ATCTGAGCTG GTATTTGGAT GATAATATTT TGATGTTTAC ACTAAATCCT
    GGTAAAATTG ACAAAGATGA TGAAGACTTC CAAGAGTCTA ACAAAATGCA CTCCATTAAT
    GGTTATATGT ATGGAAATCA GCCTGGTCTT GAGATGTGTA AAGGAAGTGT TGTTTCCTGG
    CATTTGATGG GCTTGGGTTC AGAAGTTGAT GTCCATGGGA TATACTTCTC AGAAAACACA
    TTTGTAACTA AAGGAACAAG AAGGGATACA GCAAATCTGT TTCCACATGC AGTTCTTACA
    GCTATTATGA AGCCTGATTC TGAAGGAATT TTTGAAGTGT CCTGCCTGAC AGCAGACCAC
    TACACTGGGG GCATGAAACA GAACTACAAA GTGAAAAAAT GCCACAGGGG GAAAGGAGAT
    GTATCTACGT ATTTGCATGA AAAGATTTAC TACATTGCTG CAGTGGAAGT TGAATGGGAC
    TATTCTCCTA ACAGGACATG GGAATTCGAG CGGCATCAAT ACCATGAGGA AAGCCCTGGC
    AATCCATTTT TAAATAAAGA TGACAAATTC ATTGGCTCAA AGTACAAAAA GGTAGTATAT
    CGCGAGTACA CCGATCAGAC ATTCAGTACC CTCAAAAACA GAGCAAAGGA GCAGCAGCAC
    CTGGAAATTC AAGGACCACT GCTTGTGTCA AATACTGGAG ATAAAATTAC AATAGTTTTT
    AAGAACTTAG CATCAAGACC TTATTCTATC CACGCCCATG GAGTGAAAAC AGACAGTTCT
    GTTGTTGCTG TAACTAACCC AGGTGATACA AAAATATATG TCTGGAAAGT CCCAGAGAGA
    TCTAGTCCTG GGAGAGGAGA TTCACATTGT ATTGCATGGG CATACCATTC AACAGTGGAC
    ATTGTTAAGG ACACTTACAG TGGATTAATA GGCACACTCG TTGTGTGTCA TAGACATTAC
    CTGCCATCAT TTCATACTAA AAAGAAAGTT CAGTTTGCTC TTCTCTTTAT GGTTTTTGAT
    GAAAATGAGT CATGGTACTT GGATGAAAAC ATTAAAACAT ATTCTACCAA CCCACACCTT
    GTTGACAAAG AAGATGAGGG ATTCCTTGAA AGTAATAAAA TGCATGCCAT TAATGGAAAG
    GTGTTTGGAA ATCTGCATGG CCTGACTATG CACGTTGGAG AAAATGTCAA CTGGTATCTG
    ATGGGAATGG GCAATGAGGT AGACATTCAC ACAGTACACT TCCATGGCCA CAGCTTTGAC
    TACAAGCAAA CAGGGGTTTA CCGGGCAGAT GTCTTTGATC TGTTCCCTGG GACATCTCAA
    ACTGTGGAAA TGACCCCAGA GAACCCTGGA ACCTGGCTGT TACACTGTCA CGTTACTGAC
    CACATCCACG CAGGCATGGA AGCAACCTAC ACTGTGCTCC CAAAGGAAGG TAAGAACACC
    TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012431227.2
    CDS235..3417
    Translation

    Target ORF information:

    RefSeq Version XM_012575773.2
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata ceruloplasmin (CP), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012575773.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGAAGCTAT TTCTCCTAAT CTGCTTGCTG ATTTCTTGCT GTTTCCATGC TGGGGCAGTG 
    AACCGGGAGT ACTATATTGG CATTACAGAG ACTGTCTGGA ACTATGCACC TGGCAATGCC
    AGTGCCATCT CTGGGCAGCT TTTTGCAGAA GAAGAGCAGG CTGAAGTCTT TCTCAAAAGA
    GGACCACAGA GGATAGGAAA CACTTACAAG AAGGCTATCT ACGTTCAATA TACCAATCAT
    TTATATGATG AGATAATTGA CAAACCTTCC TGGCTGGGTT TTTTGGGTCC TGTAATTAAG
    GGAGAAGTTG GAGATTCCAT TACTATTCAC TTGAAAAACT TTGCTTCCAG AAACTACACG
    CTACATCCAC ACGGTGTAAG ATACACAAAA GAAAATGAAG GCGCTTTTTA TCCTGACACC
    ACCAAAGATT TGCAAAAGCG AGATGATGCT GTGGAGCCTG GAGGCCAGTA CACTTACACA
    TGGGATGTGA CAGAAGATCA AGGTCCCGCT GAAGCAGATG CAGACTGTAT AACCAGGGTT
    TACCACTCCC ACATAGATGC TCCAAGAGAT GTTGCCTCAG GGCTTGTTGG ACCTCTAATA
    ATTTGCAGGA AAGATACAAT GAATAGGGAT ACTGATCAAC ACTTTGATGC TGAATTTATC
    CTTATGTTTT CTGTGGTGGA TGAAAATCTC AGTTGGTATC TAGAGGACAA TATCAGAACA
    TACTGTTTTG AGCCTTCCAA AGTGGACAAA GATGATGAGG ACTTCCAGGA AAGCAATAAA
    ATGCACTCAA TCAATGGGTA CATGTATGGA TACCTCCCAA ACCTCACAAT GTGTGTGGAA
    GATAAGATAA AATGGTATCT TTTTGGCATG GGTAATGAAG CTGATATCCA TTCAGCCTAC
    TTTCATGGGC AGACCTTAAT AGAAAGGCAT CATCGAGTTG ACACCATCAG CCTCTTCCCA
    GCCACATTCG TTGATGCTGT CATGGTACCA AGGAGCCCTG GGGAATGGCT GCTCAGCTGC
    CAAGTGAATG ACCACATTGA AGGTGGTATG CAGGCCCTTT TTAAAGTAGA AGATTGTAAG
    AAACCCACAC CAAGTCACAG TGAGAGTACA AAGATAAGAC AGTACTTCCT TGCTGCTGAA
    GAGATTATCT GGAATTATGG CCCATCTGCA GTGAACAATT TTACAGGACA AGAATTAATT
    GTCGACAGTG AATCTCAGAT ATTTTTTGAA CAAAGTGAGA CAAGAATTGG TGGCTCCTAC
    AAAAAAGCAA TTTACAAGGA ATACACAGAT GGTTCTTTCA CTGAACATAA AAAAAGACTT
    GCAGAGGAAG CACATCTTGG ACTCCTAGGA CCTGTGATCA GGGCTGAAGT GGGTGAGCGC
    ATCAGGGTGA CCTTCCGGAA CAACGCCAGC CGCCCGTTCA GCATCCAGCC CCACGGCGTG
    AGCTACCGCA GGAGCGGGGC CGGGGCGCGC TTTGGCACCG CCGCCGCAGG TACCGAATCT
    CCAGCCTCTC ACGTGAGTCC CGGCACCACA TTTACATATG AATGGGACGT ACCAGAAGAT
    GTGGGTCCCA CAGAGCAAGA CCCAGACTGT TTAACCTGGC TTTATTACTC AGCTGTGGAT
    GCAGTCAGAG ACACCAGTTC TGGTCTTGTG GGTCCTCTCC TAGTGTGCAG GAAAGGAGCT
    CTGCTTTCTT CTGGGAAACA GAAAAATGTG AACATGGAGT TTTTTCTACT TGCCACGGTA
    TTTGATGAGA ATCTGAGCTG GTATTTGGAT GATAATATTT TGATGTTTAC ACTAAATCCT
    GGTAAAATTG ACAAAGATGA TGAAGACTTC CAAGAGTCTA ACAAAATGCA CTCCATTAAT
    GGTTATATGT ATGGAAATCA GCCTGGTCTT GAGATGTGTA AAGGAAGTGT TGTTTCCTGG
    CATTTGATGG GCTTGGGTTC AGAAGTTGAT GTCCATGGGA TATACTTCTC AGAAAACACA
    TTTGTAACTA AAGGAACAAG AAGGGATACA GCAAATCTGT TTCCACATGC AGTTCTTACA
    GCTATTATGA AGCCTGATTC TGAAGGAATT TTTGAAGTGT CCTGCCTGAC AGCAGACCAC
    TACACTGGGG GCATGAAACA GAACTACAAA GTGAAAAAAT GCCACAGGGG GAAAGGAGAT
    GTATCTACGT ATTTGCATGA AAAGATTTAC TACATTGCTG CAGTGGAAGT TGAATGGGAC
    TATTCTCCTA ACAGGACATG GGAATTCGAG CGGCATCAAT ACCATGAGGA AAGCCCTGGC
    AATCCATTTT TAAATAAAGA TGACAAATTC ATTGGCTCAA AGTACAAAAA GGTAGTATAT
    CGCGAGTACA CCGATCAGAC ATTCAGTACC CTCAAAAACA GAGCAAAGGA GCAGCAGCAC
    CTGGAAATTC AAGGACCACT GCTTGTGTCA AATACTGGAG ATAAAATTAC AATAGTTTTT
    AAGAACTTAG CATCAAGACC TTATTCTATC CACGCCCATG GAGTGAAAAC AGACAGTTCT
    GTTGTTGCTG TAACTAACCC AGGTGATACA AAAATATATG TCTGGAAAGT CCCAGAGAGA
    TCTAGTCCTG GGAGAGGAGA TTCACATTGT ATTGCATGGG CATACCATTC AACAGTGGAC
    ATTGTTAAGG ACACTTACAG TGGATTAATA GGCACACTCG TTGTGTGTCA TAGACATTAC
    CTGCCATCAT TTCATACTAA AAAGAAAGTT CAGTTTGCTC TTCTCTTTAT GGTTTTTGAT
    GAAAATGAGT CATGGTACTT GGATGAAAAC ATTAAAACAT ATTCTACCAA CCCACACCTT
    GTTGACAAAG AAGATGAGGG ATTCCTTGAA AGTAATAAAA TGCATGCCAT TAATGGAAAG
    GTGTTTGGAA ATCTGCATGG CCTGACTATG CACGTTGGAG AAAATGTCAA CTGGTATCTG
    ATGGGAATGG GCAATGAGGT AGACATTCAC ACAGTACACT TCCATGGCCA CAGCTTTGAC
    TACAAGCAAA CAGGGGTTTA CCGGGCAGAT GTCTTTGATC TGTTCCCTGG GACATCTCAA
    ACTGTGGAAA TGACCCCAGA GAACCCTGGA ACCTGGCTGT TACACTGTCA CGTTACTGAC
    CACATCCACG CAGGCATGGA AGCAACCTAC ACTGTGCTCC CAAAGGAAGG TAAGAACACC
    TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd52031
    Clone ID Related Accession (Same CDS sequence) XM_012575774.2
    Accession Version XM_012575774.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3174bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product ceruloplasmin isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044221.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Aug 9, 2019 this sequence version replaced XM_012575774.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGAAGCTAT TTCTCCTAAT CTGCTTGCTG ATTTCTTGCT GTTTCCATGC TGGGGCAGTG 
    AACCGGGAGT ACTATATTGG CATTACAGAG ACTGTCTGGA ACTATGCACC TGGCAATGCC
    AGTGCCATCT CTGGGCAGCT TTTTGCAGAA GAAGAGCAGG CTGAAGTCTT TCTCAAAAGA
    GGACCACAGA GGATAGGAAA CACTTACAAG AAGGCTATCT ACGTTCAATA TACCAATCAT
    TTATATGATG AGATAATTGA CAAACCTTCC TGGCTGGGTT TTTTGGGTCC TGTAATTAAG
    GGAGAAGTTG GAGATTCCAT TACTATTCAC TTGAAAAACT TTGCTTCCAG AAACTACACG
    CTACATCCAC ACGGTGTAAG ATACACAAAA GAAAATGAAG GCGCTTTTTA TCCTGACACC
    ACCAAAGATT TGCAAAAGCG AGATGATGCT GTGGAGCCTG GAGGCCAGTA CACTTACACA
    TGGGATGTGA CAGAAGATCA AGGTCCCGCT GAAGCAGATG CAGACTGTAT AACCAGGGTT
    TACCACTCCC ACATAGATGC TCCAAGAGAT GTTGCCTCAG GGCTTGTTGG ACCTCTAATA
    ATTTGCAGGA AAGATACAAT GAATAGGGAT ACTGATCAAC ACTTTGATGC TGAATTTATC
    CTTATGTTTT CTGTGGTGGA TGAAAATCTC AGTTGGTATC TAGAGGACAA TATCAGAACA
    TACTGTTTTG AGCCTTCCAA AGTGGACAAA GATGATGAGG ACTTCCAGGA AAGCAATAAA
    ATGCACTCAA TCAATGGGTA CATGTATGGA TACCTCCCAA ACCTCACAAT GTGTGTGGAA
    GATAAGATAA AATGGTATCT TTTTGGCATG GGTAATGAAG CTGATATCCA TTCAGCCTAC
    TTTCATGGGC AGACCTTAAT AGAAAGGCAT CATCGAGTTG ACACCATCAG CCTCTTCCCA
    GCCACATTCG TTGATGCTGT CATGGTACCA AGGAGCCCTG GGGAATGGCT GCTCAGCTGC
    CAAGTGAATG ACCACATTGA AGGTGGTATG CAGGCCCTTT TTAAAGTAGA AGATTGTAAG
    AAACCCACAC CAAGTCACAG TGAGAGTACA AAGATAAGAC AGTACTTCCT TGCTGCTGAA
    GAGATTATCT GGAATTATGG CCCATCTGCA GTGAACAATT TTACAGGACA AGAATTAATT
    GTCGACAGTG AATCTCAGAT ATTTTTTGAA CAAAGTGAGA CAAGAATTGG TGGCTCCTAC
    AAAAAAGCAA TTTACAAGGA ATACACAGAT GGTTCTTTCA CTGAACATAA AAAAAGACTT
    GCAGAGGAAG CACATCTTGG ACTCCTAGGA CCTGTGATCA GGGCTGAAGT GGGTGAGCGC
    ATCAGGGTGA CCTTCCGGAA CAACGCCAGC CGCCCGTTCA GCATCCAGCC CCACGGCGTG
    AGCTACCGCA GGAGCGGGGC CGGGGCGCGC TTTGGCACCG CCGCCGCAGG TACCGAATCT
    CCAGCCTCTC ACGTGAGTCC CGGCACCACA TTTACATATG AATGGGACGT ACCAGAAGAT
    GTGGGTCCCA CAGAGCAAGA CCCAGACTGT TTAACCTGGC TTTATTACTC AGCTGTGGAT
    GCAGTCAGAG ACACCAGTTC TGGTCTTGTG GGTCCTCTCC TAGTGTGCAG GAAAGGAGCT
    CTGCTTTCTT CTGGGAAACA GAAAAATGTG AACATGGAGT TTTTTCTACT TGCCACGGTA
    TTTGATGAGA ATCTGAGCTG GTATTTGGAT GATAATATTT TGATGTTTAC ACTAAATCCT
    GGTAAAATTG ACAAAGATGA TGAAGACTTC CAAGAGTCTA ACAAAATGCA CTCCATTAAT
    GGTTATATGT ATGGAAATCA GCCTGGTCTT GAGATGTGTA AAGGAAGTGT TGTTTCCTGG
    CATTTGATGG GCTTGGGTTC AGAAGTTGAT GTCCATGGGA TATACTTCTC AGAAAACACA
    TTTGTAACTA AAGGAACAAG AAGGGATACA GCAAATCTGT TTCCACATGC AGTTCTTACA
    GCTATTATGA AGCCTGATTC TGAAGGAATT TTTGAAGTGT CCTGCCTGAC AGCAGACCAC
    TACACTGGGG GCATGAAACA GAACTACAAA GTGAAAAAAT GCCACAGGGG GAAAGGAGAT
    GTATCTACGT ATTTGCATGA AAAGATTTAC TACATTGCTG CAGTGGAAGT TGAATGGGAC
    TATTCTCCTA ACAGGACATG GGAATTCGAG CGGCATCAAT ACCATGAGGA AAGCCCTGGC
    AATCCATTTT TAAATAAAGA TGACAAATTC ATTGGCTCAA AGTACAAAAA GGTAGTATAT
    CGCGAGTACA CCGATCAGAC ATTCAGTACC CTCAAAAACA GAGCAAAGGA GCAGCAGCAC
    CTGGAAATTC AAGGACCACT GCTTGTGTCA AATACTGGAG ATAAAATTAC AATAGTTTTT
    AAGAACTTAG CATCAAGACC TTATTCTATC CACGCCCATG GAGTGAAAAC AGACAGTTCT
    GTTGTTGCTG TAACTAACCC AGGTGATACA AAAATATATG TCTGGAAAGT CCCAGAGAGA
    TCTAGTCCTG GGAGAGGAGA TTCACATTGT ATTGCATGGG CATACCATTC AACAGTGGAC
    ATTGTTAAGG ACACTTACAG TGGATTAATA GGCACACTCG TTGTGTGTCA TAGACATTAC
    CTGCCATCAT TTCATACTAA AAAGAAAGTT CAGTTTGCTC TTCTCTTTAT GGTTTTTGAT
    GAAAATGAGT CATGGTACTT GGATGAAAAC ATTAAAACAT ATTCTACCAA CCCACACCTT
    GTTGACAAAG AAGATGAGGG ATTCCTTGAA AGTAATAAAA TGCATGCCAT TAATGGAAAG
    GTGTTTGGAA ATCTGCATGG CCTGACTATG CACGTTGGAG AAAATGTCAA CTGGTATCTG
    ATGGGAATGG GCAATGAGGT AGACATTCAC ACAGTACACT TCCATGGCCA CAGCTTTGAC
    TACAAGCAAA CAGGGGTTTA CCGGGCAGAT GTCTTTGATC TGTTCCCTGG GACATCTCAA
    ACTGTGGAAA TGACCCCAGA GAACCCTGGA ACCTGGCTGT TACACTGTCA CGTTACTGAC
    CACATCCACG CAGGCATGGA AGCAACCTAC ACTGTGCTCC CAAAGGAAGA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_012431228.2
    CDS233..3406
    Translation

    Target ORF information:

    RefSeq Version XM_012575774.2
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata ceruloplasmin (CP), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012575774.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGAAGCTAT TTCTCCTAAT CTGCTTGCTG ATTTCTTGCT GTTTCCATGC TGGGGCAGTG 
    AACCGGGAGT ACTATATTGG CATTACAGAG ACTGTCTGGA ACTATGCACC TGGCAATGCC
    AGTGCCATCT CTGGGCAGCT TTTTGCAGAA GAAGAGCAGG CTGAAGTCTT TCTCAAAAGA
    GGACCACAGA GGATAGGAAA CACTTACAAG AAGGCTATCT ACGTTCAATA TACCAATCAT
    TTATATGATG AGATAATTGA CAAACCTTCC TGGCTGGGTT TTTTGGGTCC TGTAATTAAG
    GGAGAAGTTG GAGATTCCAT TACTATTCAC TTGAAAAACT TTGCTTCCAG AAACTACACG
    CTACATCCAC ACGGTGTAAG ATACACAAAA GAAAATGAAG GCGCTTTTTA TCCTGACACC
    ACCAAAGATT TGCAAAAGCG AGATGATGCT GTGGAGCCTG GAGGCCAGTA CACTTACACA
    TGGGATGTGA CAGAAGATCA AGGTCCCGCT GAAGCAGATG CAGACTGTAT AACCAGGGTT
    TACCACTCCC ACATAGATGC TCCAAGAGAT GTTGCCTCAG GGCTTGTTGG ACCTCTAATA
    ATTTGCAGGA AAGATACAAT GAATAGGGAT ACTGATCAAC ACTTTGATGC TGAATTTATC
    CTTATGTTTT CTGTGGTGGA TGAAAATCTC AGTTGGTATC TAGAGGACAA TATCAGAACA
    TACTGTTTTG AGCCTTCCAA AGTGGACAAA GATGATGAGG ACTTCCAGGA AAGCAATAAA
    ATGCACTCAA TCAATGGGTA CATGTATGGA TACCTCCCAA ACCTCACAAT GTGTGTGGAA
    GATAAGATAA AATGGTATCT TTTTGGCATG GGTAATGAAG CTGATATCCA TTCAGCCTAC
    TTTCATGGGC AGACCTTAAT AGAAAGGCAT CATCGAGTTG ACACCATCAG CCTCTTCCCA
    GCCACATTCG TTGATGCTGT CATGGTACCA AGGAGCCCTG GGGAATGGCT GCTCAGCTGC
    CAAGTGAATG ACCACATTGA AGGTGGTATG CAGGCCCTTT TTAAAGTAGA AGATTGTAAG
    AAACCCACAC CAAGTCACAG TGAGAGTACA AAGATAAGAC AGTACTTCCT TGCTGCTGAA
    GAGATTATCT GGAATTATGG CCCATCTGCA GTGAACAATT TTACAGGACA AGAATTAATT
    GTCGACAGTG AATCTCAGAT ATTTTTTGAA CAAAGTGAGA CAAGAATTGG TGGCTCCTAC
    AAAAAAGCAA TTTACAAGGA ATACACAGAT GGTTCTTTCA CTGAACATAA AAAAAGACTT
    GCAGAGGAAG CACATCTTGG ACTCCTAGGA CCTGTGATCA GGGCTGAAGT GGGTGAGCGC
    ATCAGGGTGA CCTTCCGGAA CAACGCCAGC CGCCCGTTCA GCATCCAGCC CCACGGCGTG
    AGCTACCGCA GGAGCGGGGC CGGGGCGCGC TTTGGCACCG CCGCCGCAGG TACCGAATCT
    CCAGCCTCTC ACGTGAGTCC CGGCACCACA TTTACATATG AATGGGACGT ACCAGAAGAT
    GTGGGTCCCA CAGAGCAAGA CCCAGACTGT TTAACCTGGC TTTATTACTC AGCTGTGGAT
    GCAGTCAGAG ACACCAGTTC TGGTCTTGTG GGTCCTCTCC TAGTGTGCAG GAAAGGAGCT
    CTGCTTTCTT CTGGGAAACA GAAAAATGTG AACATGGAGT TTTTTCTACT TGCCACGGTA
    TTTGATGAGA ATCTGAGCTG GTATTTGGAT GATAATATTT TGATGTTTAC ACTAAATCCT
    GGTAAAATTG ACAAAGATGA TGAAGACTTC CAAGAGTCTA ACAAAATGCA CTCCATTAAT
    GGTTATATGT ATGGAAATCA GCCTGGTCTT GAGATGTGTA AAGGAAGTGT TGTTTCCTGG
    CATTTGATGG GCTTGGGTTC AGAAGTTGAT GTCCATGGGA TATACTTCTC AGAAAACACA
    TTTGTAACTA AAGGAACAAG AAGGGATACA GCAAATCTGT TTCCACATGC AGTTCTTACA
    GCTATTATGA AGCCTGATTC TGAAGGAATT TTTGAAGTGT CCTGCCTGAC AGCAGACCAC
    TACACTGGGG GCATGAAACA GAACTACAAA GTGAAAAAAT GCCACAGGGG GAAAGGAGAT
    GTATCTACGT ATTTGCATGA AAAGATTTAC TACATTGCTG CAGTGGAAGT TGAATGGGAC
    TATTCTCCTA ACAGGACATG GGAATTCGAG CGGCATCAAT ACCATGAGGA AAGCCCTGGC
    AATCCATTTT TAAATAAAGA TGACAAATTC ATTGGCTCAA AGTACAAAAA GGTAGTATAT
    CGCGAGTACA CCGATCAGAC ATTCAGTACC CTCAAAAACA GAGCAAAGGA GCAGCAGCAC
    CTGGAAATTC AAGGACCACT GCTTGTGTCA AATACTGGAG ATAAAATTAC AATAGTTTTT
    AAGAACTTAG CATCAAGACC TTATTCTATC CACGCCCATG GAGTGAAAAC AGACAGTTCT
    GTTGTTGCTG TAACTAACCC AGGTGATACA AAAATATATG TCTGGAAAGT CCCAGAGAGA
    TCTAGTCCTG GGAGAGGAGA TTCACATTGT ATTGCATGGG CATACCATTC AACAGTGGAC
    ATTGTTAAGG ACACTTACAG TGGATTAATA GGCACACTCG TTGTGTGTCA TAGACATTAC
    CTGCCATCAT TTCATACTAA AAAGAAAGTT CAGTTTGCTC TTCTCTTTAT GGTTTTTGAT
    GAAAATGAGT CATGGTACTT GGATGAAAAC ATTAAAACAT ATTCTACCAA CCCACACCTT
    GTTGACAAAG AAGATGAGGG ATTCCTTGAA AGTAATAAAA TGCATGCCAT TAATGGAAAG
    GTGTTTGGAA ATCTGCATGG CCTGACTATG CACGTTGGAG AAAATGTCAA CTGGTATCTG
    ATGGGAATGG GCAATGAGGT AGACATTCAC ACAGTACACT TCCATGGCCA CAGCTTTGAC
    TACAAGCAAA CAGGGGTTTA CCGGGCAGAT GTCTTTGATC TGTTCCCTGG GACATCTCAA
    ACTGTGGAAA TGACCCCAGA GAACCCTGGA ACCTGGCTGT TACACTGTCA CGTTACTGAC
    CACATCCACG CAGGCATGGA AGCAACCTAC ACTGTGCTCC CAAAGGAAGA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd14591
    Clone ID Related Accession (Same CDS sequence) XM_012575773.1
    Accession Version XM_012575773.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3060bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-05-25
    Organism Taeniopygia guttata(zebra finch)
    Product ceruloplasmin isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_002199041.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Taeniopygia guttata Annotation Release 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    ATGACAGATG CATTTGTGTA TTTTCTTTAC AGGCAGGCTG AAGTCTTTCT CAAAAGAGGA 
    CCACAGAGGA TAGGAAACAC TTACAAGAAG GCTATCTACG TTCAATATAC CAATCATTTA
    TATGATGAGA TAATTGACAA ACCTTCCTGG CTGGGTTTTT TGGGTCCTGT AATTAAGGGA
    GAAGTTGGAG ATTCCATTAC TATTCACTTG AAAAACTTTG CTTCCAGAAA CTACACGCTA
    CATCCACACG GTGTAAGATA CACAAAAGAA AATGAAGGCG CTTTTTATCC TGACACCACC
    AAAGATTTGC AAAAGCGAGA TGATGCTGTG GAGCCTGGAG GCCAGTACAC TTACACATGG
    GATGTGACAG AAGATCAAGG TCCCGCTGAA GCAGATGCAG ACTGTATAAC CAGGGTTTAC
    CACTCCCACA TAGATGCTCC AAGAGATGTT GCCTCAGGGC TTGTTGGACC TCTAATAATT
    TGCAGGAAAG ATACAATGAA TAGGGATACT GATCAACACT TTGATGCTGA ATTTATCCTT
    ATGTTTTCTG TGGTGGATGA AAATCTCAGT TGGTATCTAG AGGACAATAT CAGAACATAC
    TGTTTTGAGC CTTCCAAAGT GGACAAAGAT GATGAGGACT TCCAGGAAAG CAATAAAATG
    CACTCAATCA ATGGGTACAT GTATGGATAC CTCCCAAACC TCACAATGTG TGTGGAAGAT
    AAGATAAAAT GGTATCTTTT TGGCATGGGT AATGAAGCTG ATATCCATTC AGCCTACTTT
    CATGGGCAGA CCTTAATAGA AAGGCATCAT CGAGTTGACA CCATCAGCCT CTTCCCAGCC
    ACATTCGTTG ATGCTGTCAT GGTACCAAGG AGCCCTGGGG AATGGCTGCT CAGCTGCCAA
    GTGAATGACC ACATTGAAGG TGGTATGCAG GCCCTTTTTA AAGTAGAAGA TTGTAAGAAA
    CCCACACCAA GTCACAGTGA GAGTACAAAG ATAAGACAGT ACTTCCTTGC TGCTGAAGAG
    ATTATCTGGA ATTATGGCCC ATCTGCAGTG AACAATTTTA CAGGACAAGA ATTAATTGTC
    GACAGTGAAT CTCAGATATT TTTTGAACAA AGTGAGACAA GAATTGGTGG CTCCTACAAA
    AAAGCAATTT ACAAGGAATA CACAGATGGT TCTTTCACTG AACATAAAAA AAGACTTGCA
    GAGGAAGCAC ATCTTGGACT CCTAGGACCT GTGATCAGGG CTGAAGTGGG TGAGCGCATC
    AGGGTGACCT TCCGGAACAA CGCCAGCCGC CCGTTCAGCA TCCAGCCCCA CGGCGTGAGC
    TACCGCAGGA GCGGGGCCGG GGCGCGCTTT GGCACCGCCG CCGCAGGTAC CGAATCTCCA
    GCCTCTCACG TGAGTCCCGG CACCACATTT ACATATGAAT GGGACGTACC AGAAGATGTG
    GGTCCCACAG AGCAAGACCC AGACTGTTTA ACCTGGCTTT ATTACTCAGC TGTGGATGCA
    GTCAGAGACA CCAGTTCTGG TCTTGTGGGT CCTCTCCTAG TGTGCAGGAA AGGAGCTCTG
    CTTTCTTCTG GGAAACAGAA AAATGTGAAC ATGGAGTTTT TTCTACTTGC CACGGTATTT
    GATGAGAATC TGAGCTGGTA TTTGGATGAT AATATTTTGA TGTTTACACT AAATCCTGGT
    AAAATTGACA AAGATGATGA AGACTTCCAA GAGTCTAACA AAATGCACTC CATTAATGGT
    TATATGTATG GAAATCAGCC TGGTCTTGAG ATGTGTAAAG GAAGTGTTGT TTCCTGGCAT
    TTGATGGGCT TGGGTTCAGA AGTTGATGTC CATGGGATAT ACTTCTCAGA AAACACATTT
    GTAACTAAAG GAACAAGAAG GGATACAGCA AATCTGTTTC CACATGCAGT TCTTACAGCT
    ATTATGAAGC CTGATTCTGA AGGAATTTTT GAAGTGTCCT GCCTGACAGC AGACCACTAC
    ACTGGGGGCA TGAAACAGAA CTACAAAGTG AAAAAATGCC ACAGGGGGAA AGGAGATGTA
    TCTACGTATT TGCATGAAAA GATTTACTAC ATTGCTGCAG TGGAAGTTGA ATGGGACTAT
    TCTCCTAACA GGACATGGGA ATTCGAGCGG CATCAATACC ATGAGGAAAG CCCTGGCAAT
    CCATTTTTAA ATAAAGATGA CAAATTCATT GGCTCAAAGT ACAAAAAGGT AGTATATCGC
    GAGTACACCG ATCAGACATT CAGTACCCTC AAAAACAGAG CAAAGGAGCA GCAGCACCTG
    GAAATTCAAG GACCACTGCT TGTGTCAAAT ACTGGAGATA AAATTACAAT AGTTTTTAAG
    AACTTAGCAT CAAGACCTTA TTCTATCCAC GCCCATGGAG TGAAAACAGA CAGTTCTGTT
    GTTGCTGTAA CTAACCCAGG TGATACAAAA ATATATGTCT GGAAAGTCCC AGAGAGATCT
    AGTCCTGGGA GAGGAGATTC ACATTGTATT GCATGGGCAT ACCATTCAAC AGTGGACATT
    GTTAAGGACA CTTACAGTGG ATTAATAGGC ACACTCGTTG TGTGTCATAG ACATTACCTG
    CCATCATTTC ATACTAAAAA GAAAGTTCAG TTTGCTCTTC TCTTTATGGT TTTTGATGAA
    AATGAGTCAT GGTACTTGGA TGAAAACATT AAAACATATT CTACCAACCC ACACCTTGTT
    GACAAAGAAG ATGAGGGATT CCTTGAAAGT AATAAAATGC ATGCCATTAA TGGAAAGGTG
    TTTGGAAATC TGCATGGCCT GACTATGCAC GTTGGAGAAA ATGTCAACTG GTATCTGATG
    GGAATGGGCA ATGAGGTAGA CATTCACACA GTACACTTCC ATGGCCACAG CTTTGACTAC
    AAGCAAACAG GGGTTTACCG GGCAGATGTC TTTGATCTGT TCCCTGGGAC ATCTCAAACT
    GTGGAAATGA CCCCAGAGAA CCCTGGAACC TGGCTGTTAC ACTGTCACGT TACTGACCAC
    ATCCACGCAG GCATGGAAGC AACCTACACT GTGCTCCCAA AGGAAGGTAA GAACACCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012431227.1
    CDS50..3109
    Translation

    Target ORF information:

    RefSeq Version XM_012575773.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata ceruloplasmin (ferroxidase) (CP), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012575773.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    ATGACAGATG CATTTGTGTA TTTTCTTTAC AGGCAGGCTG AAGTCTTTCT CAAAAGAGGA 
    CCACAGAGGA TAGGAAACAC TTACAAGAAG GCTATCTACG TTCAATATAC CAATCATTTA
    TATGATGAGA TAATTGACAA ACCTTCCTGG CTGGGTTTTT TGGGTCCTGT AATTAAGGGA
    GAAGTTGGAG ATTCCATTAC TATTCACTTG AAAAACTTTG CTTCCAGAAA CTACACGCTA
    CATCCACACG GTGTAAGATA CACAAAAGAA AATGAAGGCG CTTTTTATCC TGACACCACC
    AAAGATTTGC AAAAGCGAGA TGATGCTGTG GAGCCTGGAG GCCAGTACAC TTACACATGG
    GATGTGACAG AAGATCAAGG TCCCGCTGAA GCAGATGCAG ACTGTATAAC CAGGGTTTAC
    CACTCCCACA TAGATGCTCC AAGAGATGTT GCCTCAGGGC TTGTTGGACC TCTAATAATT
    TGCAGGAAAG ATACAATGAA TAGGGATACT GATCAACACT TTGATGCTGA ATTTATCCTT
    ATGTTTTCTG TGGTGGATGA AAATCTCAGT TGGTATCTAG AGGACAATAT CAGAACATAC
    TGTTTTGAGC CTTCCAAAGT GGACAAAGAT GATGAGGACT TCCAGGAAAG CAATAAAATG
    CACTCAATCA ATGGGTACAT GTATGGATAC CTCCCAAACC TCACAATGTG TGTGGAAGAT
    AAGATAAAAT GGTATCTTTT TGGCATGGGT AATGAAGCTG ATATCCATTC AGCCTACTTT
    CATGGGCAGA CCTTAATAGA AAGGCATCAT CGAGTTGACA CCATCAGCCT CTTCCCAGCC
    ACATTCGTTG ATGCTGTCAT GGTACCAAGG AGCCCTGGGG AATGGCTGCT CAGCTGCCAA
    GTGAATGACC ACATTGAAGG TGGTATGCAG GCCCTTTTTA AAGTAGAAGA TTGTAAGAAA
    CCCACACCAA GTCACAGTGA GAGTACAAAG ATAAGACAGT ACTTCCTTGC TGCTGAAGAG
    ATTATCTGGA ATTATGGCCC ATCTGCAGTG AACAATTTTA CAGGACAAGA ATTAATTGTC
    GACAGTGAAT CTCAGATATT TTTTGAACAA AGTGAGACAA GAATTGGTGG CTCCTACAAA
    AAAGCAATTT ACAAGGAATA CACAGATGGT TCTTTCACTG AACATAAAAA AAGACTTGCA
    GAGGAAGCAC ATCTTGGACT CCTAGGACCT GTGATCAGGG CTGAAGTGGG TGAGCGCATC
    AGGGTGACCT TCCGGAACAA CGCCAGCCGC CCGTTCAGCA TCCAGCCCCA CGGCGTGAGC
    TACCGCAGGA GCGGGGCCGG GGCGCGCTTT GGCACCGCCG CCGCAGGTAC CGAATCTCCA
    GCCTCTCACG TGAGTCCCGG CACCACATTT ACATATGAAT GGGACGTACC AGAAGATGTG
    GGTCCCACAG AGCAAGACCC AGACTGTTTA ACCTGGCTTT ATTACTCAGC TGTGGATGCA
    GTCAGAGACA CCAGTTCTGG TCTTGTGGGT CCTCTCCTAG TGTGCAGGAA AGGAGCTCTG
    CTTTCTTCTG GGAAACAGAA AAATGTGAAC ATGGAGTTTT TTCTACTTGC CACGGTATTT
    GATGAGAATC TGAGCTGGTA TTTGGATGAT AATATTTTGA TGTTTACACT AAATCCTGGT
    AAAATTGACA AAGATGATGA AGACTTCCAA GAGTCTAACA AAATGCACTC CATTAATGGT
    TATATGTATG GAAATCAGCC TGGTCTTGAG ATGTGTAAAG GAAGTGTTGT TTCCTGGCAT
    TTGATGGGCT TGGGTTCAGA AGTTGATGTC CATGGGATAT ACTTCTCAGA AAACACATTT
    GTAACTAAAG GAACAAGAAG GGATACAGCA AATCTGTTTC CACATGCAGT TCTTACAGCT
    ATTATGAAGC CTGATTCTGA AGGAATTTTT GAAGTGTCCT GCCTGACAGC AGACCACTAC
    ACTGGGGGCA TGAAACAGAA CTACAAAGTG AAAAAATGCC ACAGGGGGAA AGGAGATGTA
    TCTACGTATT TGCATGAAAA GATTTACTAC ATTGCTGCAG TGGAAGTTGA ATGGGACTAT
    TCTCCTAACA GGACATGGGA ATTCGAGCGG CATCAATACC ATGAGGAAAG CCCTGGCAAT
    CCATTTTTAA ATAAAGATGA CAAATTCATT GGCTCAAAGT ACAAAAAGGT AGTATATCGC
    GAGTACACCG ATCAGACATT CAGTACCCTC AAAAACAGAG CAAAGGAGCA GCAGCACCTG
    GAAATTCAAG GACCACTGCT TGTGTCAAAT ACTGGAGATA AAATTACAAT AGTTTTTAAG
    AACTTAGCAT CAAGACCTTA TTCTATCCAC GCCCATGGAG TGAAAACAGA CAGTTCTGTT
    GTTGCTGTAA CTAACCCAGG TGATACAAAA ATATATGTCT GGAAAGTCCC AGAGAGATCT
    AGTCCTGGGA GAGGAGATTC ACATTGTATT GCATGGGCAT ACCATTCAAC AGTGGACATT
    GTTAAGGACA CTTACAGTGG ATTAATAGGC ACACTCGTTG TGTGTCATAG ACATTACCTG
    CCATCATTTC ATACTAAAAA GAAAGTTCAG TTTGCTCTTC TCTTTATGGT TTTTGATGAA
    AATGAGTCAT GGTACTTGGA TGAAAACATT AAAACATATT CTACCAACCC ACACCTTGTT
    GACAAAGAAG ATGAGGGATT CCTTGAAAGT AATAAAATGC ATGCCATTAA TGGAAAGGTG
    TTTGGAAATC TGCATGGCCT GACTATGCAC GTTGGAGAAA ATGTCAACTG GTATCTGATG
    GGAATGGGCA ATGAGGTAGA CATTCACACA GTACACTTCC ATGGCCACAG CTTTGACTAC
    AAGCAAACAG GGGTTTACCG GGCAGATGTC TTTGATCTGT TCCCTGGGAC ATCTCAAACT
    GTGGAAATGA CCCCAGAGAA CCCTGGAACC TGGCTGTTAC ACTGTCACGT TACTGACCAC
    ATCCACGCAG GCATGGAAGC AACCTACACT GTGCTCCCAA AGGAAGGTAA GAACACCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd14592
    Clone ID Related Accession (Same CDS sequence) XM_012575774.1
    Accession Version XM_012575774.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3051bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-05-25
    Organism Taeniopygia guttata(zebra finch)
    Product ceruloplasmin isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_002199041.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Taeniopygia guttata Annotation Release 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    ATGACAGATG CATTTGTGTA TTTTCTTTAC AGGCAGGCTG AAGTCTTTCT CAAAAGAGGA 
    CCACAGAGGA TAGGAAACAC TTACAAGAAG GCTATCTACG TTCAATATAC CAATCATTTA
    TATGATGAGA TAATTGACAA ACCTTCCTGG CTGGGTTTTT TGGGTCCTGT AATTAAGGGA
    GAAGTTGGAG ATTCCATTAC TATTCACTTG AAAAACTTTG CTTCCAGAAA CTACACGCTA
    CATCCACACG GTGTAAGATA CACAAAAGAA AATGAAGGCG CTTTTTATCC TGACACCACC
    AAAGATTTGC AAAAGCGAGA TGATGCTGTG GAGCCTGGAG GCCAGTACAC TTACACATGG
    GATGTGACAG AAGATCAAGG TCCCGCTGAA GCAGATGCAG ACTGTATAAC CAGGGTTTAC
    CACTCCCACA TAGATGCTCC AAGAGATGTT GCCTCAGGGC TTGTTGGACC TCTAATAATT
    TGCAGGAAAG ATACAATGAA TAGGGATACT GATCAACACT TTGATGCTGA ATTTATCCTT
    ATGTTTTCTG TGGTGGATGA AAATCTCAGT TGGTATCTAG AGGACAATAT CAGAACATAC
    TGTTTTGAGC CTTCCAAAGT GGACAAAGAT GATGAGGACT TCCAGGAAAG CAATAAAATG
    CACTCAATCA ATGGGTACAT GTATGGATAC CTCCCAAACC TCACAATGTG TGTGGAAGAT
    AAGATAAAAT GGTATCTTTT TGGCATGGGT AATGAAGCTG ATATCCATTC AGCCTACTTT
    CATGGGCAGA CCTTAATAGA AAGGCATCAT CGAGTTGACA CCATCAGCCT CTTCCCAGCC
    ACATTCGTTG ATGCTGTCAT GGTACCAAGG AGCCCTGGGG AATGGCTGCT CAGCTGCCAA
    GTGAATGACC ACATTGAAGG TGGTATGCAG GCCCTTTTTA AAGTAGAAGA TTGTAAGAAA
    CCCACACCAA GTCACAGTGA GAGTACAAAG ATAAGACAGT ACTTCCTTGC TGCTGAAGAG
    ATTATCTGGA ATTATGGCCC ATCTGCAGTG AACAATTTTA CAGGACAAGA ATTAATTGTC
    GACAGTGAAT CTCAGATATT TTTTGAACAA AGTGAGACAA GAATTGGTGG CTCCTACAAA
    AAAGCAATTT ACAAGGAATA CACAGATGGT TCTTTCACTG AACATAAAAA AAGACTTGCA
    GAGGAAGCAC ATCTTGGACT CCTAGGACCT GTGATCAGGG CTGAAGTGGG TGAGCGCATC
    AGGGTGACCT TCCGGAACAA CGCCAGCCGC CCGTTCAGCA TCCAGCCCCA CGGCGTGAGC
    TACCGCAGGA GCGGGGCCGG GGCGCGCTTT GGCACCGCCG CCGCAGGTAC CGAATCTCCA
    GCCTCTCACG TGAGTCCCGG CACCACATTT ACATATGAAT GGGACGTACC AGAAGATGTG
    GGTCCCACAG AGCAAGACCC AGACTGTTTA ACCTGGCTTT ATTACTCAGC TGTGGATGCA
    GTCAGAGACA CCAGTTCTGG TCTTGTGGGT CCTCTCCTAG TGTGCAGGAA AGGAGCTCTG
    CTTTCTTCTG GGAAACAGAA AAATGTGAAC ATGGAGTTTT TTCTACTTGC CACGGTATTT
    GATGAGAATC TGAGCTGGTA TTTGGATGAT AATATTTTGA TGTTTACACT AAATCCTGGT
    AAAATTGACA AAGATGATGA AGACTTCCAA GAGTCTAACA AAATGCACTC CATTAATGGT
    TATATGTATG GAAATCAGCC TGGTCTTGAG ATGTGTAAAG GAAGTGTTGT TTCCTGGCAT
    TTGATGGGCT TGGGTTCAGA AGTTGATGTC CATGGGATAT ACTTCTCAGA AAACACATTT
    GTAACTAAAG GAACAAGAAG GGATACAGCA AATCTGTTTC CACATGCAGT TCTTACAGCT
    ATTATGAAGC CTGATTCTGA AGGAATTTTT GAAGTGTCCT GCCTGACAGC AGACCACTAC
    ACTGGGGGCA TGAAACAGAA CTACAAAGTG AAAAAATGCC ACAGGGGGAA AGGAGATGTA
    TCTACGTATT TGCATGAAAA GATTTACTAC ATTGCTGCAG TGGAAGTTGA ATGGGACTAT
    TCTCCTAACA GGACATGGGA ATTCGAGCGG CATCAATACC ATGAGGAAAG CCCTGGCAAT
    CCATTTTTAA ATAAAGATGA CAAATTCATT GGCTCAAAGT ACAAAAAGGT AGTATATCGC
    GAGTACACCG ATCAGACATT CAGTACCCTC AAAAACAGAG CAAAGGAGCA GCAGCACCTG
    GAAATTCAAG GACCACTGCT TGTGTCAAAT ACTGGAGATA AAATTACAAT AGTTTTTAAG
    AACTTAGCAT CAAGACCTTA TTCTATCCAC GCCCATGGAG TGAAAACAGA CAGTTCTGTT
    GTTGCTGTAA CTAACCCAGG TGATACAAAA ATATATGTCT GGAAAGTCCC AGAGAGATCT
    AGTCCTGGGA GAGGAGATTC ACATTGTATT GCATGGGCAT ACCATTCAAC AGTGGACATT
    GTTAAGGACA CTTACAGTGG ATTAATAGGC ACACTCGTTG TGTGTCATAG ACATTACCTG
    CCATCATTTC ATACTAAAAA GAAAGTTCAG TTTGCTCTTC TCTTTATGGT TTTTGATGAA
    AATGAGTCAT GGTACTTGGA TGAAAACATT AAAACATATT CTACCAACCC ACACCTTGTT
    GACAAAGAAG ATGAGGGATT CCTTGAAAGT AATAAAATGC ATGCCATTAA TGGAAAGGTG
    TTTGGAAATC TGCATGGCCT GACTATGCAC GTTGGAGAAA ATGTCAACTG GTATCTGATG
    GGAATGGGCA ATGAGGTAGA CATTCACACA GTACACTTCC ATGGCCACAG CTTTGACTAC
    AAGCAAACAG GGGTTTACCG GGCAGATGTC TTTGATCTGT TCCCTGGGAC ATCTCAAACT
    GTGGAAATGA CCCCAGAGAA CCCTGGAACC TGGCTGTTAC ACTGTCACGT TACTGACCAC
    ATCCACGCAG GCATGGAAGC AACCTACACT GTGCTCCCAA AGGAAGACTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012431228.1
    CDS50..3100
    Translation

    Target ORF information:

    RefSeq Version XM_012575774.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata ceruloplasmin (ferroxidase) (CP), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012575774.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    ATGACAGATG CATTTGTGTA TTTTCTTTAC AGGCAGGCTG AAGTCTTTCT CAAAAGAGGA 
    CCACAGAGGA TAGGAAACAC TTACAAGAAG GCTATCTACG TTCAATATAC CAATCATTTA
    TATGATGAGA TAATTGACAA ACCTTCCTGG CTGGGTTTTT TGGGTCCTGT AATTAAGGGA
    GAAGTTGGAG ATTCCATTAC TATTCACTTG AAAAACTTTG CTTCCAGAAA CTACACGCTA
    CATCCACACG GTGTAAGATA CACAAAAGAA AATGAAGGCG CTTTTTATCC TGACACCACC
    AAAGATTTGC AAAAGCGAGA TGATGCTGTG GAGCCTGGAG GCCAGTACAC TTACACATGG
    GATGTGACAG AAGATCAAGG TCCCGCTGAA GCAGATGCAG ACTGTATAAC CAGGGTTTAC
    CACTCCCACA TAGATGCTCC AAGAGATGTT GCCTCAGGGC TTGTTGGACC TCTAATAATT
    TGCAGGAAAG ATACAATGAA TAGGGATACT GATCAACACT TTGATGCTGA ATTTATCCTT
    ATGTTTTCTG TGGTGGATGA AAATCTCAGT TGGTATCTAG AGGACAATAT CAGAACATAC
    TGTTTTGAGC CTTCCAAAGT GGACAAAGAT GATGAGGACT TCCAGGAAAG CAATAAAATG
    CACTCAATCA ATGGGTACAT GTATGGATAC CTCCCAAACC TCACAATGTG TGTGGAAGAT
    AAGATAAAAT GGTATCTTTT TGGCATGGGT AATGAAGCTG ATATCCATTC AGCCTACTTT
    CATGGGCAGA CCTTAATAGA AAGGCATCAT CGAGTTGACA CCATCAGCCT CTTCCCAGCC
    ACATTCGTTG ATGCTGTCAT GGTACCAAGG AGCCCTGGGG AATGGCTGCT CAGCTGCCAA
    GTGAATGACC ACATTGAAGG TGGTATGCAG GCCCTTTTTA AAGTAGAAGA TTGTAAGAAA
    CCCACACCAA GTCACAGTGA GAGTACAAAG ATAAGACAGT ACTTCCTTGC TGCTGAAGAG
    ATTATCTGGA ATTATGGCCC ATCTGCAGTG AACAATTTTA CAGGACAAGA ATTAATTGTC
    GACAGTGAAT CTCAGATATT TTTTGAACAA AGTGAGACAA GAATTGGTGG CTCCTACAAA
    AAAGCAATTT ACAAGGAATA CACAGATGGT TCTTTCACTG AACATAAAAA AAGACTTGCA
    GAGGAAGCAC ATCTTGGACT CCTAGGACCT GTGATCAGGG CTGAAGTGGG TGAGCGCATC
    AGGGTGACCT TCCGGAACAA CGCCAGCCGC CCGTTCAGCA TCCAGCCCCA CGGCGTGAGC
    TACCGCAGGA GCGGGGCCGG GGCGCGCTTT GGCACCGCCG CCGCAGGTAC CGAATCTCCA
    GCCTCTCACG TGAGTCCCGG CACCACATTT ACATATGAAT GGGACGTACC AGAAGATGTG
    GGTCCCACAG AGCAAGACCC AGACTGTTTA ACCTGGCTTT ATTACTCAGC TGTGGATGCA
    GTCAGAGACA CCAGTTCTGG TCTTGTGGGT CCTCTCCTAG TGTGCAGGAA AGGAGCTCTG
    CTTTCTTCTG GGAAACAGAA AAATGTGAAC ATGGAGTTTT TTCTACTTGC CACGGTATTT
    GATGAGAATC TGAGCTGGTA TTTGGATGAT AATATTTTGA TGTTTACACT AAATCCTGGT
    AAAATTGACA AAGATGATGA AGACTTCCAA GAGTCTAACA AAATGCACTC CATTAATGGT
    TATATGTATG GAAATCAGCC TGGTCTTGAG ATGTGTAAAG GAAGTGTTGT TTCCTGGCAT
    TTGATGGGCT TGGGTTCAGA AGTTGATGTC CATGGGATAT ACTTCTCAGA AAACACATTT
    GTAACTAAAG GAACAAGAAG GGATACAGCA AATCTGTTTC CACATGCAGT TCTTACAGCT
    ATTATGAAGC CTGATTCTGA AGGAATTTTT GAAGTGTCCT GCCTGACAGC AGACCACTAC
    ACTGGGGGCA TGAAACAGAA CTACAAAGTG AAAAAATGCC ACAGGGGGAA AGGAGATGTA
    TCTACGTATT TGCATGAAAA GATTTACTAC ATTGCTGCAG TGGAAGTTGA ATGGGACTAT
    TCTCCTAACA GGACATGGGA ATTCGAGCGG CATCAATACC ATGAGGAAAG CCCTGGCAAT
    CCATTTTTAA ATAAAGATGA CAAATTCATT GGCTCAAAGT ACAAAAAGGT AGTATATCGC
    GAGTACACCG ATCAGACATT CAGTACCCTC AAAAACAGAG CAAAGGAGCA GCAGCACCTG
    GAAATTCAAG GACCACTGCT TGTGTCAAAT ACTGGAGATA AAATTACAAT AGTTTTTAAG
    AACTTAGCAT CAAGACCTTA TTCTATCCAC GCCCATGGAG TGAAAACAGA CAGTTCTGTT
    GTTGCTGTAA CTAACCCAGG TGATACAAAA ATATATGTCT GGAAAGTCCC AGAGAGATCT
    AGTCCTGGGA GAGGAGATTC ACATTGTATT GCATGGGCAT ACCATTCAAC AGTGGACATT
    GTTAAGGACA CTTACAGTGG ATTAATAGGC ACACTCGTTG TGTGTCATAG ACATTACCTG
    CCATCATTTC ATACTAAAAA GAAAGTTCAG TTTGCTCTTC TCTTTATGGT TTTTGATGAA
    AATGAGTCAT GGTACTTGGA TGAAAACATT AAAACATATT CTACCAACCC ACACCTTGTT
    GACAAAGAAG ATGAGGGATT CCTTGAAAGT AATAAAATGC ATGCCATTAA TGGAAAGGTG
    TTTGGAAATC TGCATGGCCT GACTATGCAC GTTGGAGAAA ATGTCAACTG GTATCTGATG
    GGAATGGGCA ATGAGGTAGA CATTCACACA GTACACTTCC ATGGCCACAG CTTTGACTAC
    AAGCAAACAG GGGTTTACCG GGCAGATGTC TTTGATCTGT TCCCTGGGAC ATCTCAAACT
    GTGGAAATGA CCCCAGAGAA CCCTGGAACC TGGCTGTTAC ACTGTCACGT TACTGACCAC
    ATCCACGCAG GCATGGAAGC AACCTACACT GTGCTCCCAA AGGAAGACTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.