TCF3 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

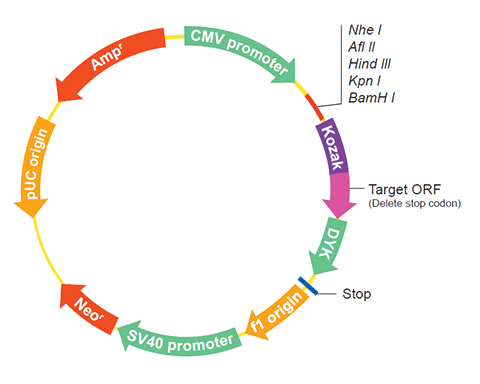
The following TCF3 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the TCF3 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs24524 XM_005531339.2
Latest version!
Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OPs24524 XM_014260082.1
Latest version!
Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OPs24525 XM_014260083.1
Latest version!
Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPs24526 XM_014260084.1
Latest version!
Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPs24527 XM_014260085.1
Latest version!
Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPs24528 XM_014260086.1
Latest version!
Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs24524
    Clone ID Related Accession (Same CDS sequence) XM_005531339.2 , XM_014260082.1
    Accession Version XM_005531339.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2007bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
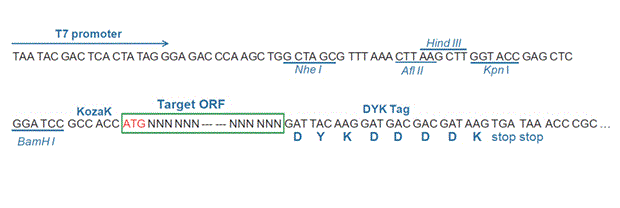
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product transcription factor E2-alpha isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087647.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 21, 2015 this sequence version replaced XM_005531339.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGAGCGCA ATCTGAACCC AAAAGCGGCC TGCTTGAAGC GTCGGGAAGA GGAGAAAGTG
    TCCGGAGTGG TAGGAGACCC CCAGATGACA CTGTCAGCTT CACATCCTGG TCTAGGAGAC
    GGTCACAACC CTGTTGGACA CATGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005531396.1
    CDS96..2102
    Translation

    Target ORF information:

    RefSeq Version XM_005531339.2
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005531339.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGAGCGCA ATCTGAACCC AAAAGCGGCC TGCTTGAAGC GTCGGGAAGA GGAGAAAGTG
    TCCGGAGTGG TAGGAGACCC CCAGATGACA CTGTCAGCTT CACATCCTGG TCTAGGAGAC
    GGTCACAACC CTGTTGGACA CATGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs24524
    Clone ID Related Accession (Same CDS sequence) XM_005531339.2 , XM_014260082.1
    Accession Version XM_014260082.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2007bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product transcription factor E2-alpha isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087647.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGAGCGCA ATCTGAACCC AAAAGCGGCC TGCTTGAAGC GTCGGGAAGA GGAGAAAGTG
    TCCGGAGTGG TAGGAGACCC CCAGATGACA CTGTCAGCTT CACATCCTGG TCTAGGAGAC
    GGTCACAACC CTGTTGGACA CATGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014115557.1
    CDS120..2126
    Translation

    Target ORF information:

    RefSeq Version XM_014260082.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014260082.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGAGCGCA ATCTGAACCC AAAAGCGGCC TGCTTGAAGC GTCGGGAAGA GGAGAAAGTG
    TCCGGAGTGG TAGGAGACCC CCAGATGACA CTGTCAGCTT CACATCCTGG TCTAGGAGAC
    GGTCACAACC CTGTTGGACA CATGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs24525
    Clone ID Related Accession (Same CDS sequence) XM_014260083.1
    Accession Version XM_014260083.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1995bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product transcription factor E2-alpha isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087647.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGCAGTA CAGACGAGGC CTTGTCACTG GAGGACAAAG ATCTGAGGGA CCGGGAGAGG
    AGAATGGCCA ATAACGCCAG GGAAAGGGTG CGTGTGCGGG ACATTAACGA GGCCTTTAAA
    GAACTGGGAC GCATGTGCCA GATGCACTTA AAAACGGACA AAGCACAGAC CAAACTGATC
    ATCCTACAGC AAGCGGTGCA GGTCATTCTG GGCCTGGAGC AGCAAGTACG AGAGCGCAAT
    CTGAACCCAA AAGCGGCCTG CTTGAAGCGT CGGGAAGAGG AGAAAGTGTC CGGAGTGGTA
    GGAGACCCCC AGATGACACT GTCAGCTTCA CATCCTGGTC TAGGAGACGG TCACAACCCT
    GTTGGACACA TGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014115558.1
    CDS96..2090
    Translation

    Target ORF information:

    RefSeq Version XM_014260083.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014260083.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGCAGTA CAGACGAGGC CTTGTCACTG GAGGACAAAG ATCTGAGGGA CCGGGAGAGG
    AGAATGGCCA ATAACGCCAG GGAAAGGGTG CGTGTGCGGG ACATTAACGA GGCCTTTAAA
    GAACTGGGAC GCATGTGCCA GATGCACTTA AAAACGGACA AAGCACAGAC CAAACTGATC
    ATCCTACAGC AAGCGGTGCA GGTCATTCTG GGCCTGGAGC AGCAAGTACG AGAGCGCAAT
    CTGAACCCAA AAGCGGCCTG CTTGAAGCGT CGGGAAGAGG AGAAAGTGTC CGGAGTGGTA
    GGAGACCCCC AGATGACACT GTCAGCTTCA CATCCTGGTC TAGGAGACGG TCACAACCCT
    GTTGGACACA TGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs24526
    Clone ID Related Accession (Same CDS sequence) XM_014260084.1
    Accession Version XM_014260084.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1992bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product transcription factor E2-alpha isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087647.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTACAG ACGAGGCCTT GTCACTGGAG GACAAAGATC TGAGGGACCG GGAGAGGAGA
    ATGGCCAATA ACGCCAGGGA AAGGGTGCGT GTGCGGGACA TTAACGAGGC CTTTAAAGAA
    CTGGGACGCA TGTGCCAGAT GCACTTAAAA ACGGACAAAG CACAGACCAA ACTGATCATC
    CTACAGCAAG CGGTGCAGGT CATTCTGGGC CTGGAGCAGC AAGTACGAGA GCGCAATCTG
    AACCCAAAAG CGGCCTGCTT GAAGCGTCGG GAAGAGGAGA AAGTGTCCGG AGTGGTAGGA
    GACCCCCAGA TGACACTGTC AGCTTCACAT CCTGGTCTAG GAGACGGTCA CAACCCTGTT
    GGACACATGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014115559.1
    CDS96..2087
    Translation

    Target ORF information:

    RefSeq Version XM_014260084.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014260084.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTACAG ACGAGGCCTT GTCACTGGAG GACAAAGATC TGAGGGACCG GGAGAGGAGA
    ATGGCCAATA ACGCCAGGGA AAGGGTGCGT GTGCGGGACA TTAACGAGGC CTTTAAAGAA
    CTGGGACGCA TGTGCCAGAT GCACTTAAAA ACGGACAAAG CACAGACCAA ACTGATCATC
    CTACAGCAAG CGGTGCAGGT CATTCTGGGC CTGGAGCAGC AAGTACGAGA GCGCAATCTG
    AACCCAAAAG CGGCCTGCTT GAAGCGTCGG GAAGAGGAGA AAGTGTCCGG AGTGGTAGGA
    GACCCCCAGA TGACACTGTC AGCTTCACAT CCTGGTCTAG GAGACGGTCA CAACCCTGTT
    GGACACATGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs24527
    Clone ID Related Accession (Same CDS sequence) XM_014260085.1
    Accession Version XM_014260085.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1887bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product transcription factor E2-alpha isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087647.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGGCAGCCC AGAACAAGCT GTCCGGGGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG 
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGAGCGCA ATCTGAACCC AAAAGCGGCC TGCTTGAAGC GTCGGGAAGA GGAGAAAGTG
    TCCGGAGTGG TAGGAGACCC CCAGATGACA CTGTCAGCTT CACATCCTGG TCTAGGAGAC
    GGTCACAACC CTGTTGGACA CATGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014115560.1
    CDS2..1888
    Translation

    Target ORF information:

    RefSeq Version XM_014260085.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014260085.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGGCAGCCC AGAACAAGCT GTCCGGGGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG 
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGAGCGCA ATCTGAACCC AAAAGCGGCC TGCTTGAAGC GTCGGGAAGA GGAGAAAGTG
    TCCGGAGTGG TAGGAGACCC CCAGATGACA CTGTCAGCTT CACATCCTGG TCTAGGAGAC
    GGTCACAACC CTGTTGGACA CATGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs24528
    Clone ID Related Accession (Same CDS sequence) XM_014260086.1
    Accession Version XM_014260086.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1881bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product transcription factor E2-alpha isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087647.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGACATGC CCCAGCCGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014115561.1
    CDS96..1976
    Translation

    Target ORF information:

    RefSeq Version XM_014260086.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis transcription factor 3 (TCF3), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014260086.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAATCAGC AGCAGCAGAG AATGGCTGCA GTTGGGACAG ACAAAGAGCT CAGTGACCTG 
    CTGGACTTCA GTATGATGTT TCCCCTGCCA GTGGCTAATG GAAAAAACAG ACCCACGACC
    CTTGCAAGCA CTCAGTTTGG AGGATCAGGC TTGGATGAAA GACCGGGATC AGGTTCCTGG
    GGAACGGCAG ATCAAAACAG CTCCACGTTT GACCAAGGAA GGCAGAGCTA TGGCGAAGGC
    CCCCACTACG GTGAGCACCG GGAGCTGCCA TCCCACAACA GCATCTCCTC GTCACCATTC
    CTGGGAGCTG GACTCGTGGG GAAGAGCAGT GAAAGAGCCT CATACTCCAC GTTTGGAAGA
    GACACAGGGA TGCCAGGACT AAACCAGCCT GGTTTCCTGC CCAGCGAGAT GGGAATCGCC
    AGCCCGAGCA CGCTTTCCCC CACTGGGGGC AAAGGGGGGT CTCAGTATTT TTCTTACCCC
    AACAATCCTC GCAGGAGAGG TGCTGAGAGC AGCATAGATG GACAGCCCAA AAAGGTTCGG
    AAGGTGCCTC CTGGACTCCC CTCCTCGGTG TATCCATCCA ACTCAGGTGA TGACTACAGC
    AGGGATCCAG CTGGATATAC TCCCTCGAAA CCTCCCAGCA CTGTGTATCC TGGAGCCTTT
    TACATGACAG ATGGACTCCA TAACTCGCCA GACCTGTGGA GTTCCCCGGG TGCCATGAGC
    CAGTCCAGTT ACGGTGCCAT GCTGGGCAGC TCCTCGTCCC CGCTCCCGCA GTCCAGTGGC
    TTCAATAGTT TACATCAGCA TGAACGCATG AACTACCAGC TGCATTCAGG AGAGGTGAAT
    GGTGGACTCC CCTCGGTGTC CGGCTTCTCC TCGGCCTCCA CAGCGTACGG AGTGTCCAGT
    CACACCCCCC CGATCAGCGG CACGGACAAC ATGATGGGTA ACAGAGGAAC CACAGCCGGG
    AGCTCTGGAG ACGCGCTTGG GAAGGCTCTG GCCTCGATTT ACTCCCCCGA CCACTCTAGC
    AATAACTTCT CCTCCAACCC CTCCACCCCG GTCGGGTCCC CACAGGGCCT TGCAGGCTCG
    TCGCAGTGGC CGCGGGCGGG TGGAGCGGGT GCCTTATCTC CCAGCTACGA AGGGAGCCTC
    CACACTTTGC AAAACAAAAT GGAAGACAGG TTGGATGAAG CCATCCACGT GCTGAGGAAC
    CACGCTGTGG GCCAGACCTC TGCCATGCCC AGCAACCACG GGGACATGCA CGGGCTGCTG
    GGCTCAGCAC CAGCACACAG TGCCACTGTG GGCAGCCTGG GCCAGGCCTT CCCTGCCTCA
    GTCATGGCCC TGGGGAACAG GCACCCCAGT CTGGTGGGAG GAGGCCACCC TGAAGATGGG
    TTGTCCAGCA ACCCCAGCTT GCTCCACAAC CATGTCACTC TTCCATCACA GCCCAGCTCA
    CTCCCAGACC TCAGCAGGCA GCAGGACACG TACAGTGGCT TGTCCGGGGG GCTGGGGCGC
    AGCAGCGTCT CCTCAGGAAC GAGCGAAATA AAGAGGGAAG AGAAGGAGGA TGAAGAGAAC
    ACGTCAGTGG CAGATAACTC AGAAGAGGAG AAGAAGGAGC TGAAACCCTC CCGGAACAGA
    ACAAGTCAAG ATGAGGATGA GGAGGACGAT CTTCTTCCCC CAGAGCAAAA AGCCGAGAGA
    GAGAGAGAAA GGAGGGTCGC CAATAATGCC CGTGAGCGCC TGCGGGTTCG TGACATCAAC
    GAGGCCTTTA AAGAGCTCGG ACGCATGTGC CAACTGCACC TAAACAGCGA AAAACCGCAG
    ACCAAACTGC TAATCCTACA CCAGGCCGTA TCAGTCATAC TGAACCTGGA GCAACAAGTT
    AGAGACATGC CCCAGCCGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.