LOC103456779 cDNA ORF clone, Poecilia reticulata(guppy)

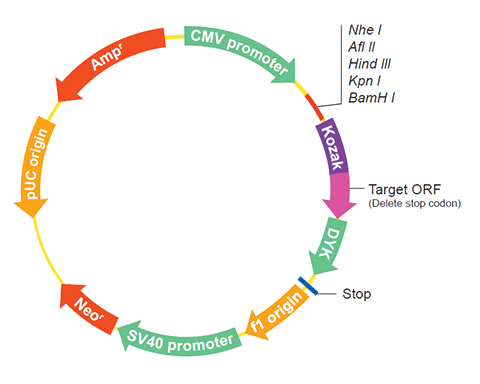
The following LOC103456779 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC103456779 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPo185155 XM_017302802.1
Latest version!
Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OPo185152 XM_008396515.2
Latest version!
Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OPo185153 XM_008396526.2
Latest version!
Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OPo185154 XM_008396535.2
Latest version!
Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPo185155
    Clone ID Related Accession (Same CDS sequence) XM_017302802.1
    Accession Version XM_017302802.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2715bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
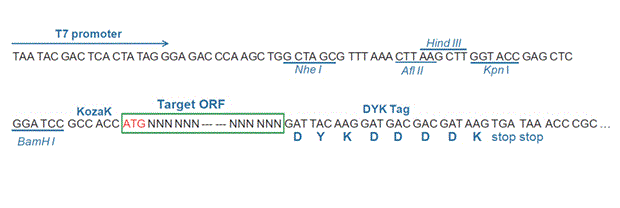
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024332.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGGCGCTAC GCCGTGGGGG GGCGACCGGC GGCTTGGACG CTTCTTCAGC GGGTTCTTCT 
    CCAGGCCCGG CCCAGTCCGG AGCCCCGGGG TCAGCAGGTC GCTGCGGCGC AGCGGAGCGC
    CGTCCAGCAC GGAGAGCATG GACGGGGGCG GAGCCAACGG TAACCACGGT GTGTTACCTG
    TCAGACAGGT TGACCTGCAA ACAGACGGCC TTTGTTCTGC AGAACCAGAC GGTTCCGGAG
    GGGAACCCCA GCAGAACTCG TCTACCAGAG CTGGTCAGAA CAAACGCCTT CGTCAACAGC
    CAGGAGTGGA CCCTCAGCCG GACCGTACCA GAACTCAAAG TGGGCATTGT GGGTAATCTG
    GCCAGCGGGA AGTCGGCGCT GGTCCACCGA TACCTGACAG GAACGTACGT CCAGGAAGAG
    TCTCCTGAAG CTGACGTGGA TGCAGGAGGG CGCTTTAAGA AGGAGATCGT GGTGGACGGC
    CAGAGTCACC TGTTACTCAT CAGGGATGAA GGAGGCCCCC CAGAGGCGCA GTTTGCTCTG
    TGGGTGGACG CCGTGGTGTT CGTCTTCAGC CTGGAGGATG AGATCAGCTT CCAGACGGTT
    TATCACTATT ACAGCCGCCT GGCGTCCTAC AGGAACACCG CCGACCTGCC GCTGGTGTTG
    GTGGGAACCC AAGACGCCAT CAGCTCGTCC AACCCGCGGG TGATCGACGA CAGCCGCGCC
    AGGAAGCTTT CTAACGAGCT GAAGCGCTGC ACCTACTATG AGACGTGCGC CACCTACGGG
    CTGAACGTGG AGCGCGTCTT CCAGGACGTT GCCCAGAAGG TCGTTGCCGT CAGGAAGAAG
    CAGCAGCTCT CCATCGGACC CTGCAAGTCG CTCCCCAACT CTCCGAGTCA CACGTCCGTC
    TGCGCCGCTC AGGTCTCAGC CGTCCACGTC AGCCAGACCA GTAACGGCGG TGGGAGTCTG
    AGCGACTACT CTTCATCGGT TCCGTCCACG CCGAGCACCA GCCAGAAGGA GCTTCGCATC
    GACGCACCGC AGGCCGCCAA CACGCCCACG CCAGTCAGGA AGCAGTCCAA ACGCCGCTCC
    AACCTCTTCA CCTCAAGGAA GGCCAGCGAT CCGGACAAAG AGAAGAAAGG TCTGGAGAAT
    CGGGCCGACA GCATCGGCAG CGGGCGCGCC ATCCCCATCA AACAGGGCAT GCTGATGAAG
    AGGAGCGGCA AATCCCTCAA CAAGGAGTGG AAGAAGAAGT ACGTGACGCT GTGCGATAAC
    GGACTGCTCA CCTACCACCC CAGCCTCCAT GACTACATGC AGAACGTTCA CGGTAAGGAG
    ATCGATCTTC TGCGAACCAC CGTTAAGGTT CCGGGAAAGA GGCCACCGCG GGCCGTCTCA
    GCCTGCGGCG CCGGGCCCAA CCAGAACGCC AACGGCCTGG TGAAGGACAT GAGCAACGTC
    CAGCTGGGAC CGACCTCAGG CTCGGTGTCC AGCAGCTCGT CTGTGTCCCA GATGGCAAGT
    GGCGTCAGCC TGGTGTCCTT CAACAGCCGC GGCCTGGAGG GCCTCCACCA GCGCTCCTAC
    TCCGTCTCCA GCGCCGACCA GTGGGCCGAC GCCACTGTCA TCGCCAACTC TGGAGTCAGC
    ACAGACACTG GTTTGGGCGA CTCGGTCTGC TCCAGTCCCA GTATCTCCAG TACCACCAGT
    CCAAAGATGG AGCCGCCCCC ATCGCCGCAC GCCAACCGCA AGAAGCACCG GCGGAAGAAG
    AGYACCAGCA ACTTCAAGGC AGACRGCCTC TCTGGTACTG CGGAAGAACA AGAGGAGAAC
    TTTGAGTTCA CCATTGTGTC GCTGACGGGT CAGACGTGGA ACTTCGAGGC CACGTCGTAC
    GAAGAGCGGG ACGCCTGGGT CCAGGTCATC GAGAGCCAGA TCCTAGCCAG CCTGCAGTCC
    TGCGAGAGCA GCAAGAACAA GTCTCGCCTG ACCAGCCAGT CGGAGGCGCT GGCACTGCAG
    TCCATCCGGA GCATCCGGGG CAACGGCCGC TGCGCCGACT GCGACGTACC GAATCCGGAC
    TGGGCTAGCC TGAACCTGGG CGCTCTGATC TGCATCGAGT GCTCTGGGAT CCACCGGAAC
    CTGGGGACCC ATCTGTCCCG GGTCAGGTCC CTGGACCTGG ACGAGTGGCC ACTGGAGCTC
    ATCAAGGTGA TGTCGGCCAT CGGCAACGAG CTGGCCAACA GCGTGTGGGA GGCCAACGCC
    CAGGGCCGCC TCAAACCGGG GCCGGACGCC AGCAGGGAGG AGCGTGAGCG TTGGATCCGG
    GCCAAGTATG AGCAGCGTCT GTTTGTGGCG GCGCTGCCCG GCGCCGACCC GCCTCTGGGC
    CAGCAGCTGC TGCGTGCAGC GGCAGAGGAG GACCTGCGCG GCGTGGTGCT GCTGCTGGCC
    CACGCGTCCC GCCAGCAGGT CAACGACACA TTCAGCGACG GCTGCTCCCC ACTGCACCTG
    GCCGCACACA AGGGCAACGT GGTTCTGCTG CAGCTGCTGG TCTGGTACGG CGCTGACCTG
    ATGGCGAGGG ACGCCCACGG GAACAGCGCC ATGGCGTACG CGCGGCAGTC CGGCAGCCAG
    GAGTGCGTAG AGGTTCTGGC CCAGTACGGC GGCGCCGACG AGCGCTACGC CCTGATGACC
    ACGCCCAACC TGCCGCGCCG CAACGCCAAC CGCAACAACA GCTGCAGCAG CCTGGGCAGC
    GCCGCGCTCA TCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017158291.1
    CDS92..2806
    Translation

    Target ORF information:

    RefSeq Version XM_017302802.1
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017302802.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGGCGCTAC GCCGTGGGGG GGCGACCGGC GGCTTGGACG CTTCTTCAGC GGGTTCTTCT 
    CCAGGCCCGG CCCAGTCCGG AGCCCCGGGG TCAGCAGGTC GCTGCGGCGC AGCGGAGCGC
    CGTCCAGCAC GGAGAGCATG GACGGGGGCG GAGCCAACGG TAACCACGGT GTGTTACCTG
    TCAGACAGGT TGACCTGCAA ACAGACGGCC TTTGTTCTGC AGAACCAGAC GGTTCCGGAG
    GGGAACCCCA GCAGAACTCG TCTACCAGAG CTGGTCAGAA CAAACGCCTT CGTCAACAGC
    CAGGAGTGGA CCCTCAGCCG GACCGTACCA GAACTCAAAG TGGGCATTGT GGGTAATCTG
    GCCAGCGGGA AGTCGGCGCT GGTCCACCGA TACCTGACAG GAACGTACGT CCAGGAAGAG
    TCTCCTGAAG CTGACGTGGA TGCAGGAGGG CGCTTTAAGA AGGAGATCGT GGTGGACGGC
    CAGAGTCACC TGTTACTCAT CAGGGATGAA GGAGGCCCCC CAGAGGCGCA GTTTGCTCTG
    TGGGTGGACG CCGTGGTGTT CGTCTTCAGC CTGGAGGATG AGATCAGCTT CCAGACGGTT
    TATCACTATT ACAGCCGCCT GGCGTCCTAC AGGAACACCG CCGACCTGCC GCTGGTGTTG
    GTGGGAACCC AAGACGCCAT CAGCTCGTCC AACCCGCGGG TGATCGACGA CAGCCGCGCC
    AGGAAGCTTT CTAACGAGCT GAAGCGCTGC ACCTACTATG AGACGTGCGC CACCTACGGG
    CTGAACGTGG AGCGCGTCTT CCAGGACGTT GCCCAGAAGG TCGTTGCCGT CAGGAAGAAG
    CAGCAGCTCT CCATCGGACC CTGCAAGTCG CTCCCCAACT CTCCGAGTCA CACGTCCGTC
    TGCGCCGCTC AGGTCTCAGC CGTCCACGTC AGCCAGACCA GTAACGGCGG TGGGAGTCTG
    AGCGACTACT CTTCATCGGT TCCGTCCACG CCGAGCACCA GCCAGAAGGA GCTTCGCATC
    GACGCACCGC AGGCCGCCAA CACGCCCACG CCAGTCAGGA AGCAGTCCAA ACGCCGCTCC
    AACCTCTTCA CCTCAAGGAA GGCCAGCGAT CCGGACAAAG AGAAGAAAGG TCTGGAGAAT
    CGGGCCGACA GCATCGGCAG CGGGCGCGCC ATCCCCATCA AACAGGGCAT GCTGATGAAG
    AGGAGCGGCA AATCCCTCAA CAAGGAGTGG AAGAAGAAGT ACGTGACGCT GTGCGATAAC
    GGACTGCTCA CCTACCACCC CAGCCTCCAT GACTACATGC AGAACGTTCA CGGTAAGGAG
    ATCGATCTTC TGCGAACCAC CGTTAAGGTT CCGGGAAAGA GGCCACCGCG GGCCGTCTCA
    GCCTGCGGCG CCGGGCCCAA CCAGAACGCC AACGGCCTGG TGAAGGACAT GAGCAACGTC
    CAGCTGGGAC CGACCTCAGG CTCGGTGTCC AGCAGCTCGT CTGTGTCCCA GATGGCAAGT
    GGCGTCAGCC TGGTGTCCTT CAACAGCCGC GGCCTGGAGG GCCTCCACCA GCGCTCCTAC
    TCCGTCTCCA GCGCCGACCA GTGGGCCGAC GCCACTGTCA TCGCCAACTC TGGAGTCAGC
    ACAGACACTG GTTTGGGCGA CTCGGTCTGC TCCAGTCCCA GTATCTCCAG TACCACCAGT
    CCAAAGATGG AGCCGCCCCC ATCGCCGCAC GCCAACCGCA AGAAGCACCG GCGGAAGAAG
    AGYACCAGCA ACTTCAAGGC AGACRGCCTC TCTGGTACTG CGGAAGAACA AGAGGAGAAC
    TTTGAGTTCA CCATTGTGTC GCTGACGGGT CAGACGTGGA ACTTCGAGGC CACGTCGTAC
    GAAGAGCGGG ACGCCTGGGT CCAGGTCATC GAGAGCCAGA TCCTAGCCAG CCTGCAGTCC
    TGCGAGAGCA GCAAGAACAA GTCTCGCCTG ACCAGCCAGT CGGAGGCGCT GGCACTGCAG
    TCCATCCGGA GCATCCGGGG CAACGGCCGC TGCGCCGACT GCGACGTACC GAATCCGGAC
    TGGGCTAGCC TGAACCTGGG CGCTCTGATC TGCATCGAGT GCTCTGGGAT CCACCGGAAC
    CTGGGGACCC ATCTGTCCCG GGTCAGGTCC CTGGACCTGG ACGAGTGGCC ACTGGAGCTC
    ATCAAGGTGA TGTCGGCCAT CGGCAACGAG CTGGCCAACA GCGTGTGGGA GGCCAACGCC
    CAGGGCCGCC TCAAACCGGG GCCGGACGCC AGCAGGGAGG AGCGTGAGCG TTGGATCCGG
    GCCAAGTATG AGCAGCGTCT GTTTGTGGCG GCGCTGCCCG GCGCCGACCC GCCTCTGGGC
    CAGCAGCTGC TGCGTGCAGC GGCAGAGGAG GACCTGCGCG GCGTGGTGCT GCTGCTGGCC
    CACGCGTCCC GCCAGCAGGT CAACGACACA TTCAGCGACG GCTGCTCCCC ACTGCACCTG
    GCCGCACACA AGGGCAACGT GGTTCTGCTG CAGCTGCTGG TCTGGTACGG CGCTGACCTG
    ATGGCGAGGG ACGCCCACGG GAACAGCGCC ATGGCGTACG CGCGGCAGTC CGGCAGCCAG
    GAGTGCGTAG AGGTTCTGGC CCAGTACGGC GGCGCCGACG AGCGCTACGC CCTGATGACC
    ACGCCCAACC TGCCGCGCCG CAACGCCAAC CGCAACAACA GCTGCAGCAG CCTGGGCAGC
    GCCGCGCTCA TCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPo185152
    Clone ID Related Accession (Same CDS sequence) XM_008396515.2
    Accession Version XM_008396515.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3258bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024332.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 21, 2016 this sequence version replaced XM_008396515.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGATGG AGAGAGGAGC GCCTCAGAGG AAGACCGTGT ACCGGATCTC CCTGACACTG 
    GTGAAGAGGG TGAACCTGGG GGGGGATGAG GAAGAGGGGG CGCGGGTAGG TGAGGTGCTG
    GAGGAGGAGG AGGAGGAGCT GGAGCCGGCG GCGGCTCAGG GTGGCATCAT GAGGAGGTTC
    AGGACTTTCA GCACTGGTCA GCTGGAGCTG GGCCGGCTCA GGGCGTCCCG CAGGGCGCAG
    CGTGACGAAT CGCGGCCCGA AACCGCTGCT GCCAAGGTGA GGAGGCTCCT GAAGGCCCGC
    AGCATGGAGG AGCGGGACCC GCCAAAACCC GTGGCCCTCC CAAAGCCCAG CCTGCTGAAG
    CGCAGCTTCA GCTTCAGCGT CCGGACCCGG ATCAGTGGAG AGCTGCTGCG GCTCCGTGCC
    TCGTCCAGAG ACGGGCCGCC ACAGGCCCCG CCCCCTGACC AGGCCCCGCC CTTTGAGCAG
    GCGCCACCCA TCGCACAGGC CCCACCCCCC AGGACCCGGG AGAAGAGCCG CACCCTGGAG
    GTGGGGGCCG TCCTCAACAG GACCGACTCC CTGACCGAGC TGAGCCGCCA GAGGGCCGGC
    GCCGCCAGGA ACCGCACGCT GGACAACAGC GACCTGCAGC GGCGGGACGC ACAGGTCGAT
    GGCGCTACGC CGTGGGGGGG CGACCGGCGG CTTGGACGCT TCTTCAGCGG GTTCTTCTCC
    AGGCCCGGCC CAGTCCGGAG CCCCGGGGTC AGCAGGTCGC TGCGGCGCAG CGGAGCGCCG
    TCCAGCACGG AGAGCATGGA CGGGGGCGGA GCCAACGGTA ACCACGACGC CTTCGTCAAC
    AGCCAGGAGT GGACCCTCAG CCGGACCGTA CCAGAACTCA AAGTGGGCAT TGTGGGTAAT
    CTGGCCAGCG GGAAGTCGGC GCTGGTCCAC CGATACCTGA CAGGAACGTA CGTCCAGGAA
    GAGTCTCCTG AAGCTGACGT GGATGCAGGA GGGCGCTTTA AGAAGGAGAT CGTGGTGGAC
    GGCCAGAGTC ACCTGTTACT CATCAGGGAT GAAGGAGGCC CCCCAGAGGC GCAGTTTGCT
    CTGTGGGTGG ACGCCGTGGT GTTCGTCTTC AGCCTGGAGG ATGAGATCAG CTTCCAGACG
    GTTTATCACT ATTACAGCCG CCTGGCGTCC TACAGGAACA CCGCCGACCT GCCGCTGGTG
    TTGGTGGGAA CCCAAGACGC CATCAGCTCG TCCAACCCGC GGGTGATCGA CGACAGCCGC
    GCCAGGAAGC TTTCTAACGA GCTGAAGCGC TGCACCTACT ATGAGACGTG CGCCACCTAC
    GGGCTGAACG TGGAGCGCGT CTTCCAGGAC GTTGCCCAGA AGGTCGTTGC CGTCAGGAAG
    AAGCAGCAGC TCTCCATCGG ACCCTGCAAG TCGCTCCCCA ACTCTCCGAG TCACACGTCC
    GTCTGCGCCG CTCAGGTCTC AGCCGTCCAC GTCAGCCAGA CCAGTAACGG CGGTGGGAGT
    CTGAGCGACT ACTCTTCATC GGTTCCGTCC ACGCCGAGCA CCAGCCAGAA GGAGCTTCGC
    ATCGACGCAC CGCAGGCCGC CAACACGCCC ACGCCAGTCA GGAAGCAGTC CAAACGCCGC
    TCCAACCTCT TCACCTCAAG GAAGGCCAGC GATCCGGACA AAGAGAAGAA AGGTCTGGAG
    AATCGGGCCG ACAGCATCGG CAGCGGGCGC GCCATCCCCA TCAAACAGGG CATGCTGATG
    AAGAGGAGCG GCAAATCCCT CAACAAGGAG TGGAAGAAGA AGTACGTGAC GCTGTGCGAT
    AACGGACTGC TCACCTACCA CCCCAGCCTC CATGACTACA TGCAGAACGT TCACGGTAAG
    GAGATCGATC TTCTGCGAAC CACCGTTAAG GTTCCGGGAA AGAGGCCACC GCGGGCCGTC
    TCAGCCTGCG GCGCCGGGCC CAACCAGAAC GCCAACGGCC TGGTGAAGGA CATGAGCAAC
    GTCCAGCTGG GACCGACCTC AGGCTCGGTG TCCAGCAGCT CGTCTGTGTC CCAGATGGCA
    AGTGGCGTCA GCCTGGTGTC CTTCAACAGC CGCGGCCTGG AGGGCCTCCA CCAGCGCTCC
    TACTCCGTCT CCAGCGCCGA CCAGTGGGCC GACGCCACTG TCATCGCCAA CTCTGGAGTC
    AGCACAGACA CTGGTTTGGG CGACTCGGTC TGCTCCAGTC CCAGTATCTC CAGTACCACC
    AGTCCAAAGA TGGAGCCGCC CCCATCGCCG CACGCCAACC GCAAGAAGCA CCGGCGGAAG
    AAGAGYACCA GCAACTTCAA GGCAGACRGC CTCTCTGGTA CTGCGGAAGA ACAAGAGGAG
    AACTTTGAGT TCACCATTGT GTCGCTGACG GGTCAGACGT GGAACTTCGA GGCCACGTCG
    TACGAAGAGC GGGACGCCTG GGTCCAGGTC ATCGAGAGCC AGATCCTAGC CAGCCTGCAG
    TCCTGCGAGA GCAGCAAGAA CAAGTCTCGC CTGACCAGCC AGTCGGAGGC GCTGGCACTG
    CAGTCCATCC GGAGCATCCG GGGCAACGGC CGCTGCGCCG ACTGCGACGT ACCGAATCCG
    GACTGGGCTA GCCTGAACCT GGGCGCTCTG ATCTGCATCG AGTGCTCTGG GATCCACCGG
    AACCTGGGGA CCCATCTGTC CCGGGTCAGG TCCCTGGACC TGGACGAGTG GCCACTGGAG
    CTCATCAAGG TGATGTCGGC CATCGGCAAC GAGCTGGCCA ACAGCGTGTG GGAGGCCAAC
    GCCCAGGGCC GCCTCAAACC GGGGCCGGAC GCCAGCAGGG AGGAGCGTGA GCGTTGGATC
    CGGGCCAAGT ATGAGCAGCG TCTGTTTGTG GCGGCGCTGC CCGGCGCCGA CCCGCCTCTG
    GGCCAGCAGC TGCTGCGTGC AGCGGCAGAG GAGGACCTGC GCGGCGTGGT GCTGCTGCTG
    GCCCACGCGT CCCGCCAGCA GGTCAACGAC ACATTCAGCG ACGGCTGCTC CCCACTGCAC
    CTGGCCGCAC ACAAGGGCAA CGTGGTTCTG CTGCAGCTGC TGGTCTGGTA CGGCGCTGAC
    CTGATGGCGA GGGACGCCCA CGGGAACAGC GCCATGGCGT ACGCGCGGCA GTCCGGCAGC
    CAGGAGTGCG TAGAGGTTCT GGCCCAGTAC GGCGGCGCCG ACGAGCGCTA CGCCCTGATG
    ACCACGCCCA ACCTGCCGCG CCGCAACGCC AACCGCAACA ACAGCTGCAG CAGCCTGGGC
    AGCGCCGCGC TCATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008394737.1
    CDS533..3790
    Translation

    Target ORF information:

    RefSeq Version XM_008396515.2
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008396515.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGATGG AGAGAGGAGC GCCTCAGAGG AAGACCGTGT ACCGGATCTC CCTGACACTG 
    GTGAAGAGGG TGAACCTGGG GGGGGATGAG GAAGAGGGGG CGCGGGTAGG TGAGGTGCTG
    GAGGAGGAGG AGGAGGAGCT GGAGCCGGCG GCGGCTCAGG GTGGCATCAT GAGGAGGTTC
    AGGACTTTCA GCACTGGTCA GCTGGAGCTG GGCCGGCTCA GGGCGTCCCG CAGGGCGCAG
    CGTGACGAAT CGCGGCCCGA AACCGCTGCT GCCAAGGTGA GGAGGCTCCT GAAGGCCCGC
    AGCATGGAGG AGCGGGACCC GCCAAAACCC GTGGCCCTCC CAAAGCCCAG CCTGCTGAAG
    CGCAGCTTCA GCTTCAGCGT CCGGACCCGG ATCAGTGGAG AGCTGCTGCG GCTCCGTGCC
    TCGTCCAGAG ACGGGCCGCC ACAGGCCCCG CCCCCTGACC AGGCCCCGCC CTTTGAGCAG
    GCGCCACCCA TCGCACAGGC CCCACCCCCC AGGACCCGGG AGAAGAGCCG CACCCTGGAG
    GTGGGGGCCG TCCTCAACAG GACCGACTCC CTGACCGAGC TGAGCCGCCA GAGGGCCGGC
    GCCGCCAGGA ACCGCACGCT GGACAACAGC GACCTGCAGC GGCGGGACGC ACAGGTCGAT
    GGCGCTACGC CGTGGGGGGG CGACCGGCGG CTTGGACGCT TCTTCAGCGG GTTCTTCTCC
    AGGCCCGGCC CAGTCCGGAG CCCCGGGGTC AGCAGGTCGC TGCGGCGCAG CGGAGCGCCG
    TCCAGCACGG AGAGCATGGA CGGGGGCGGA GCCAACGGTA ACCACGACGC CTTCGTCAAC
    AGCCAGGAGT GGACCCTCAG CCGGACCGTA CCAGAACTCA AAGTGGGCAT TGTGGGTAAT
    CTGGCCAGCG GGAAGTCGGC GCTGGTCCAC CGATACCTGA CAGGAACGTA CGTCCAGGAA
    GAGTCTCCTG AAGCTGACGT GGATGCAGGA GGGCGCTTTA AGAAGGAGAT CGTGGTGGAC
    GGCCAGAGTC ACCTGTTACT CATCAGGGAT GAAGGAGGCC CCCCAGAGGC GCAGTTTGCT
    CTGTGGGTGG ACGCCGTGGT GTTCGTCTTC AGCCTGGAGG ATGAGATCAG CTTCCAGACG
    GTTTATCACT ATTACAGCCG CCTGGCGTCC TACAGGAACA CCGCCGACCT GCCGCTGGTG
    TTGGTGGGAA CCCAAGACGC CATCAGCTCG TCCAACCCGC GGGTGATCGA CGACAGCCGC
    GCCAGGAAGC TTTCTAACGA GCTGAAGCGC TGCACCTACT ATGAGACGTG CGCCACCTAC
    GGGCTGAACG TGGAGCGCGT CTTCCAGGAC GTTGCCCAGA AGGTCGTTGC CGTCAGGAAG
    AAGCAGCAGC TCTCCATCGG ACCCTGCAAG TCGCTCCCCA ACTCTCCGAG TCACACGTCC
    GTCTGCGCCG CTCAGGTCTC AGCCGTCCAC GTCAGCCAGA CCAGTAACGG CGGTGGGAGT
    CTGAGCGACT ACTCTTCATC GGTTCCGTCC ACGCCGAGCA CCAGCCAGAA GGAGCTTCGC
    ATCGACGCAC CGCAGGCCGC CAACACGCCC ACGCCAGTCA GGAAGCAGTC CAAACGCCGC
    TCCAACCTCT TCACCTCAAG GAAGGCCAGC GATCCGGACA AAGAGAAGAA AGGTCTGGAG
    AATCGGGCCG ACAGCATCGG CAGCGGGCGC GCCATCCCCA TCAAACAGGG CATGCTGATG
    AAGAGGAGCG GCAAATCCCT CAACAAGGAG TGGAAGAAGA AGTACGTGAC GCTGTGCGAT
    AACGGACTGC TCACCTACCA CCCCAGCCTC CATGACTACA TGCAGAACGT TCACGGTAAG
    GAGATCGATC TTCTGCGAAC CACCGTTAAG GTTCCGGGAA AGAGGCCACC GCGGGCCGTC
    TCAGCCTGCG GCGCCGGGCC CAACCAGAAC GCCAACGGCC TGGTGAAGGA CATGAGCAAC
    GTCCAGCTGG GACCGACCTC AGGCTCGGTG TCCAGCAGCT CGTCTGTGTC CCAGATGGCA
    AGTGGCGTCA GCCTGGTGTC CTTCAACAGC CGCGGCCTGG AGGGCCTCCA CCAGCGCTCC
    TACTCCGTCT CCAGCGCCGA CCAGTGGGCC GACGCCACTG TCATCGCCAA CTCTGGAGTC
    AGCACAGACA CTGGTTTGGG CGACTCGGTC TGCTCCAGTC CCAGTATCTC CAGTACCACC
    AGTCCAAAGA TGGAGCCGCC CCCATCGCCG CACGCCAACC GCAAGAAGCA CCGGCGGAAG
    AAGAGYACCA GCAACTTCAA GGCAGACRGC CTCTCTGGTA CTGCGGAAGA ACAAGAGGAG
    AACTTTGAGT TCACCATTGT GTCGCTGACG GGTCAGACGT GGAACTTCGA GGCCACGTCG
    TACGAAGAGC GGGACGCCTG GGTCCAGGTC ATCGAGAGCC AGATCCTAGC CAGCCTGCAG
    TCCTGCGAGA GCAGCAAGAA CAAGTCTCGC CTGACCAGCC AGTCGGAGGC GCTGGCACTG
    CAGTCCATCC GGAGCATCCG GGGCAACGGC CGCTGCGCCG ACTGCGACGT ACCGAATCCG
    GACTGGGCTA GCCTGAACCT GGGCGCTCTG ATCTGCATCG AGTGCTCTGG GATCCACCGG
    AACCTGGGGA CCCATCTGTC CCGGGTCAGG TCCCTGGACC TGGACGAGTG GCCACTGGAG
    CTCATCAAGG TGATGTCGGC CATCGGCAAC GAGCTGGCCA ACAGCGTGTG GGAGGCCAAC
    GCCCAGGGCC GCCTCAAACC GGGGCCGGAC GCCAGCAGGG AGGAGCGTGA GCGTTGGATC
    CGGGCCAAGT ATGAGCAGCG TCTGTTTGTG GCGGCGCTGC CCGGCGCCGA CCCGCCTCTG
    GGCCAGCAGC TGCTGCGTGC AGCGGCAGAG GAGGACCTGC GCGGCGTGGT GCTGCTGCTG
    GCCCACGCGT CCCGCCAGCA GGTCAACGAC ACATTCAGCG ACGGCTGCTC CCCACTGCAC
    CTGGCCGCAC ACAAGGGCAA CGTGGTTCTG CTGCAGCTGC TGGTCTGGTA CGGCGCTGAC
    CTGATGGCGA GGGACGCCCA CGGGAACAGC GCCATGGCGT ACGCGCGGCA GTCCGGCAGC
    CAGGAGTGCG TAGAGGTTCT GGCCCAGTAC GGCGGCGCCG ACGAGCGCTA CGCCCTGATG
    ACCACGCCCA ACCTGCCGCG CCGCAACGCC AACCGCAACA ACAGCTGCAG CAGCCTGGGC
    AGCGCCGCGC TCATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPo185153
    Clone ID Related Accession (Same CDS sequence) XM_008396526.2
    Accession Version XM_008396526.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3249bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024332.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 21, 2016 this sequence version replaced XM_008396526.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGATGG AGAGAGGAGC GCCTCAGAGG AAGACCGTGT ACCGGATCTC CCTGACACTG 
    GTGAAGAGGG TGAACCTGGG GGGGGATGAG GAAGAGGGGG CGCGGGTAGG TGAGGTGCTG
    GAGGAGGAGG AGGAGGAGCT GGAGCCGGCG GCGGCTCAGG GTGGCATCAT GAGGAGGTTC
    AGGACTTTCA GCACTGGTCA GCTGGAGCTG GGCCGGCTCA GGGCGTCCCG CAGGGCGCAG
    CGTGACGAAT CGCGGCCCGA AACCGCTGCT GCCAAGGTGA GGAGGCTCCT GAAGGCCCGC
    AGCATGGAGG AGCGGGACCC GCCAAAACCC GTGGCCCTCC CAAAGCCCAG CCTGCTGAAG
    CGCAGCTTCA GCTTCAGCGT CCGGACCCGG ATCAGTGGAG AGCTGCTGCG GCTCCGTGCC
    TCGTCCAGAG ACGGGCCGCC ACAGGCCCCG CCCCCTGACC AGGCCCCGCC CTTTGAGCAG
    GCGCCACCCA TCGCACAGGC CCCACCCCCC AGGACCCGGG AGAAGAGCCG CACCCTGGAG
    GTGGGGGCCG TCCTCAACAG GACCGACTCC CTGACCGAGC TGAGCCGCCA GAGGGCCGGC
    GCCGCCAGGA ACCGCACGCT GGACAACAGC GACCTGCAGC GGCGGGACGC ACAGGTCGAT
    GGCGCTACGC CGTGGGGGGG CGACCGGCGG CTTGGACGCT TCTTCAGCGG GTTCTTCTCC
    AGGCCCGGCC CAGTCCGGAG CCCCGGGGTC AGCAGGTCGC TGCGGCGCAG CGGAGCGCCG
    TCCAGCACGG AGAGCATGGA CGGGGGCGGA GCCAACGACG CCTTCGTCAA CAGCCAGGAG
    TGGACCCTCA GCCGGACCGT ACCAGAACTC AAAGTGGGCA TTGTGGGTAA TCTGGCCAGC
    GGGAAGTCGG CGCTGGTCCA CCGATACCTG ACAGGAACGT ACGTCCAGGA AGAGTCTCCT
    GAAGCTGACG TGGATGCAGG AGGGCGCTTT AAGAAGGAGA TCGTGGTGGA CGGCCAGAGT
    CACCTGTTAC TCATCAGGGA TGAAGGAGGC CCCCCAGAGG CGCAGTTTGC TCTGTGGGTG
    GACGCCGTGG TGTTCGTCTT CAGCCTGGAG GATGAGATCA GCTTCCAGAC GGTTTATCAC
    TATTACAGCC GCCTGGCGTC CTACAGGAAC ACCGCCGACC TGCCGCTGGT GTTGGTGGGA
    ACCCAAGACG CCATCAGCTC GTCCAACCCG CGGGTGATCG ACGACAGCCG CGCCAGGAAG
    CTTTCTAACG AGCTGAAGCG CTGCACCTAC TATGAGACGT GCGCCACCTA CGGGCTGAAC
    GTGGAGCGCG TCTTCCAGGA CGTTGCCCAG AAGGTCGTTG CCGTCAGGAA GAAGCAGCAG
    CTCTCCATCG GACCCTGCAA GTCGCTCCCC AACTCTCCGA GTCACACGTC CGTCTGCGCC
    GCTCAGGTCT CAGCCGTCCA CGTCAGCCAG ACCAGTAACG GCGGTGGGAG TCTGAGCGAC
    TACTCTTCAT CGGTTCCGTC CACGCCGAGC ACCAGCCAGA AGGAGCTTCG CATCGACGCA
    CCGCAGGCCG CCAACACGCC CACGCCAGTC AGGAAGCAGT CCAAACGCCG CTCCAACCTC
    TTCACCTCAA GGAAGGCCAG CGATCCGGAC AAAGAGAAGA AAGGTCTGGA GAATCGGGCC
    GACAGCATCG GCAGCGGGCG CGCCATCCCC ATCAAACAGG GCATGCTGAT GAAGAGGAGC
    GGCAAATCCC TCAACAAGGA GTGGAAGAAG AAGTACGTGA CGCTGTGCGA TAACGGACTG
    CTCACCTACC ACCCCAGCCT CCATGACTAC ATGCAGAACG TTCACGGTAA GGAGATCGAT
    CTTCTGCGAA CCACCGTTAA GGTTCCGGGA AAGAGGCCAC CGCGGGCCGT CTCAGCCTGC
    GGCGCCGGGC CCAACCAGAA CGCCAACGGC CTGGTGAAGG ACATGAGCAA CGTCCAGCTG
    GGACCGACCT CAGGCTCGGT GTCCAGCAGC TCGTCTGTGT CCCAGATGGC AAGTGGCGTC
    AGCCTGGTGT CCTTCAACAG CCGCGGCCTG GAGGGCCTCC ACCAGCGCTC CTACTCCGTC
    TCCAGCGCCG ACCAGTGGGC CGACGCCACT GTCATCGCCA ACTCTGGAGT CAGCACAGAC
    ACTGGTTTGG GCGACTCGGT CTGCTCCAGT CCCAGTATCT CCAGTACCAC CAGTCCAAAG
    ATGGAGCCGC CCCCATCGCC GCACGCCAAC CGCAAGAAGC ACCGGCGGAA GAAGAGYACC
    AGCAACTTCA AGGCAGACRG CCTCTCTGGT ACTGCGGAAG AACAAGAGGA GAACTTTGAG
    TTCACCATTG TGTCGCTGAC GGGTCAGACG TGGAACTTCG AGGCCACGTC GTACGAAGAG
    CGGGACGCCT GGGTCCAGGT CATCGAGAGC CAGATCCTAG CCAGCCTGCA GTCCTGCGAG
    AGCAGCAAGA ACAAGTCTCG CCTGACCAGC CAGTCGGAGG CGCTGGCACT GCAGTCCATC
    CGGAGCATCC GGGGCAACGG CCGCTGCGCC GACTGCGACG TACCGAATCC GGACTGGGCT
    AGCCTGAACC TGGGCGCTCT GATCTGCATC GAGTGCTCTG GGATCCACCG GAACCTGGGG
    ACCCATCTGT CCCGGGTCAG GTCCCTGGAC CTGGACGAGT GGCCACTGGA GCTCATCAAG
    GTGATGTCGG CCATCGGCAA CGAGCTGGCC AACAGCGTGT GGGAGGCCAA CGCCCAGGGC
    CGCCTCAAAC CGGGGCCGGA CGCCAGCAGG GAGGAGCGTG AGCGTTGGAT CCGGGCCAAG
    TATGAGCAGC GTCTGTTTGT GGCGGCGCTG CCCGGCGCCG ACCCGCCTCT GGGCCAGCAG
    CTGCTGCGTG CAGCGGCAGA GGAGGACCTG CGCGGCGTGG TGCTGCTGCT GGCCCACGCG
    TCCCGCCAGC AGGTCAACGA CACATTCAGC GACGGCTGCT CCCCACTGCA CCTGGCCGCA
    CACAAGGGCA ACGTGGTTCT GCTGCAGCTG CTGGTCTGGT ACGGCGCTGA CCTGATGGCG
    AGGGACGCCC ACGGGAACAG CGCCATGGCG TACGCGCGGC AGTCCGGCAG CCAGGAGTGC
    GTAGAGGTTC TGGCCCAGTA CGGCGGCGCC GACGAGCGCT ACGCCCTGAT GACCACGCCC
    AACCTGCCGC GCCGCAACGC CAACCGCAAC AACAGCTGCA GCAGCCTGGG CAGCGCCGCG
    CTCATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008394748.1
    CDS533..3781
    Translation

    Target ORF information:

    RefSeq Version XM_008396526.2
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008396526.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGATGG AGAGAGGAGC GCCTCAGAGG AAGACCGTGT ACCGGATCTC CCTGACACTG 
    GTGAAGAGGG TGAACCTGGG GGGGGATGAG GAAGAGGGGG CGCGGGTAGG TGAGGTGCTG
    GAGGAGGAGG AGGAGGAGCT GGAGCCGGCG GCGGCTCAGG GTGGCATCAT GAGGAGGTTC
    AGGACTTTCA GCACTGGTCA GCTGGAGCTG GGCCGGCTCA GGGCGTCCCG CAGGGCGCAG
    CGTGACGAAT CGCGGCCCGA AACCGCTGCT GCCAAGGTGA GGAGGCTCCT GAAGGCCCGC
    AGCATGGAGG AGCGGGACCC GCCAAAACCC GTGGCCCTCC CAAAGCCCAG CCTGCTGAAG
    CGCAGCTTCA GCTTCAGCGT CCGGACCCGG ATCAGTGGAG AGCTGCTGCG GCTCCGTGCC
    TCGTCCAGAG ACGGGCCGCC ACAGGCCCCG CCCCCTGACC AGGCCCCGCC CTTTGAGCAG
    GCGCCACCCA TCGCACAGGC CCCACCCCCC AGGACCCGGG AGAAGAGCCG CACCCTGGAG
    GTGGGGGCCG TCCTCAACAG GACCGACTCC CTGACCGAGC TGAGCCGCCA GAGGGCCGGC
    GCCGCCAGGA ACCGCACGCT GGACAACAGC GACCTGCAGC GGCGGGACGC ACAGGTCGAT
    GGCGCTACGC CGTGGGGGGG CGACCGGCGG CTTGGACGCT TCTTCAGCGG GTTCTTCTCC
    AGGCCCGGCC CAGTCCGGAG CCCCGGGGTC AGCAGGTCGC TGCGGCGCAG CGGAGCGCCG
    TCCAGCACGG AGAGCATGGA CGGGGGCGGA GCCAACGACG CCTTCGTCAA CAGCCAGGAG
    TGGACCCTCA GCCGGACCGT ACCAGAACTC AAAGTGGGCA TTGTGGGTAA TCTGGCCAGC
    GGGAAGTCGG CGCTGGTCCA CCGATACCTG ACAGGAACGT ACGTCCAGGA AGAGTCTCCT
    GAAGCTGACG TGGATGCAGG AGGGCGCTTT AAGAAGGAGA TCGTGGTGGA CGGCCAGAGT
    CACCTGTTAC TCATCAGGGA TGAAGGAGGC CCCCCAGAGG CGCAGTTTGC TCTGTGGGTG
    GACGCCGTGG TGTTCGTCTT CAGCCTGGAG GATGAGATCA GCTTCCAGAC GGTTTATCAC
    TATTACAGCC GCCTGGCGTC CTACAGGAAC ACCGCCGACC TGCCGCTGGT GTTGGTGGGA
    ACCCAAGACG CCATCAGCTC GTCCAACCCG CGGGTGATCG ACGACAGCCG CGCCAGGAAG
    CTTTCTAACG AGCTGAAGCG CTGCACCTAC TATGAGACGT GCGCCACCTA CGGGCTGAAC
    GTGGAGCGCG TCTTCCAGGA CGTTGCCCAG AAGGTCGTTG CCGTCAGGAA GAAGCAGCAG
    CTCTCCATCG GACCCTGCAA GTCGCTCCCC AACTCTCCGA GTCACACGTC CGTCTGCGCC
    GCTCAGGTCT CAGCCGTCCA CGTCAGCCAG ACCAGTAACG GCGGTGGGAG TCTGAGCGAC
    TACTCTTCAT CGGTTCCGTC CACGCCGAGC ACCAGCCAGA AGGAGCTTCG CATCGACGCA
    CCGCAGGCCG CCAACACGCC CACGCCAGTC AGGAAGCAGT CCAAACGCCG CTCCAACCTC
    TTCACCTCAA GGAAGGCCAG CGATCCGGAC AAAGAGAAGA AAGGTCTGGA GAATCGGGCC
    GACAGCATCG GCAGCGGGCG CGCCATCCCC ATCAAACAGG GCATGCTGAT GAAGAGGAGC
    GGCAAATCCC TCAACAAGGA GTGGAAGAAG AAGTACGTGA CGCTGTGCGA TAACGGACTG
    CTCACCTACC ACCCCAGCCT CCATGACTAC ATGCAGAACG TTCACGGTAA GGAGATCGAT
    CTTCTGCGAA CCACCGTTAA GGTTCCGGGA AAGAGGCCAC CGCGGGCCGT CTCAGCCTGC
    GGCGCCGGGC CCAACCAGAA CGCCAACGGC CTGGTGAAGG ACATGAGCAA CGTCCAGCTG
    GGACCGACCT CAGGCTCGGT GTCCAGCAGC TCGTCTGTGT CCCAGATGGC AAGTGGCGTC
    AGCCTGGTGT CCTTCAACAG CCGCGGCCTG GAGGGCCTCC ACCAGCGCTC CTACTCCGTC
    TCCAGCGCCG ACCAGTGGGC CGACGCCACT GTCATCGCCA ACTCTGGAGT CAGCACAGAC
    ACTGGTTTGG GCGACTCGGT CTGCTCCAGT CCCAGTATCT CCAGTACCAC CAGTCCAAAG
    ATGGAGCCGC CCCCATCGCC GCACGCCAAC CGCAAGAAGC ACCGGCGGAA GAAGAGYACC
    AGCAACTTCA AGGCAGACRG CCTCTCTGGT ACTGCGGAAG AACAAGAGGA GAACTTTGAG
    TTCACCATTG TGTCGCTGAC GGGTCAGACG TGGAACTTCG AGGCCACGTC GTACGAAGAG
    CGGGACGCCT GGGTCCAGGT CATCGAGAGC CAGATCCTAG CCAGCCTGCA GTCCTGCGAG
    AGCAGCAAGA ACAAGTCTCG CCTGACCAGC CAGTCGGAGG CGCTGGCACT GCAGTCCATC
    CGGAGCATCC GGGGCAACGG CCGCTGCGCC GACTGCGACG TACCGAATCC GGACTGGGCT
    AGCCTGAACC TGGGCGCTCT GATCTGCATC GAGTGCTCTG GGATCCACCG GAACCTGGGG
    ACCCATCTGT CCCGGGTCAG GTCCCTGGAC CTGGACGAGT GGCCACTGGA GCTCATCAAG
    GTGATGTCGG CCATCGGCAA CGAGCTGGCC AACAGCGTGT GGGAGGCCAA CGCCCAGGGC
    CGCCTCAAAC CGGGGCCGGA CGCCAGCAGG GAGGAGCGTG AGCGTTGGAT CCGGGCCAAG
    TATGAGCAGC GTCTGTTTGT GGCGGCGCTG CCCGGCGCCG ACCCGCCTCT GGGCCAGCAG
    CTGCTGCGTG CAGCGGCAGA GGAGGACCTG CGCGGCGTGG TGCTGCTGCT GGCCCACGCG
    TCCCGCCAGC AGGTCAACGA CACATTCAGC GACGGCTGCT CCCCACTGCA CCTGGCCGCA
    CACAAGGGCA ACGTGGTTCT GCTGCAGCTG CTGGTCTGGT ACGGCGCTGA CCTGATGGCG
    AGGGACGCCC ACGGGAACAG CGCCATGGCG TACGCGCGGC AGTCCGGCAG CCAGGAGTGC
    GTAGAGGTTC TGGCCCAGTA CGGCGGCGCC GACGAGCGCT ACGCCCTGAT GACCACGCCC
    AACCTGCCGC GCCGCAACGC CAACCGCAAC AACAGCTGCA GCAGCCTGGG CAGCGCCGCG
    CTCATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPo185154
    Clone ID Related Accession (Same CDS sequence) XM_008396535.2
    Accession Version XM_008396535.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3243bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024332.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 21, 2016 this sequence version replaced XM_008396535.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGATGG AGAGAGGAGC GCCTCAGAGG AAGACCGTGT ACCGGATCTC CCTGACACTG 
    GTGAAGAGGG TGAACCTGGG GGGGGATGAG GAAGAGGGGG CGCGGGTAGG TGAGGTGCTG
    GAGGAGGAGG AGGAGGAGCT GGAGCCGGCG GCGGCTCAGG GTGGCATCAT GAGGAGGTTC
    AGGACTTTCA GCACTGGTCA GCTGGAGCTG GGCCGGCTCA GGGCGTCCCG CAGGGCGCAG
    CGTGACGAAT CGCGGCCCGA AACCGCTGCT GCCAAGGTGA GGAGGCTCCT GAAGGCCCGC
    AGCATGGAGG AGCGGGACCC GCCAAAACCC GTGGCCCTCC CAAAGCCCAG CCTGCTGAAG
    CGCAGCTTCA GCTTCAGCGT CCGGACCCGG ATCAGTGGAG AGCTGCTGCG GCTCCGTGCC
    TCGTCCAGAG ACGGGCCGCC ACAGGCCCCG CCCCCTGACC AGGCCCCGCC CTTTGAGCAG
    GCGCCACCCA TCGCACAGGC CCCACCCCCC AGGACCCGGG AGAAGAGCCG CACCCTGGAG
    GTGGGGGCCG TCCTCAACAG GACCGACTCC CTGACCGAGC TGAGCCGCCA GAGGGCCGGC
    GCCGCCAGGA ACCGCACGCT GGACAACAGC GACCTGCAGC GGCGGGACGC ACAGGTCGAT
    GGCGCTACGC CGTGGGGGGG CGACCGGCGG CTTGGACGCT TCTTCAGCGG GTTCTTCTCC
    AGGCCCGGCC CAGTCCGGAG CCCCGGGGTC AGCAGGTCGC TGCGGCGCAG CGGAGCGCCG
    TCCAGCACGG AGAGCATGGA CGGGGGCGGA GCCAACGGTA ACCACGACGC CTTCGTCAAC
    AGCCAGGAGT GGACCCTCAG CCGGACCGTA CCAGAACTCA AAGTGGGCAT TGTGGGTAAT
    CTGGCCAGCG GGAAGTCGGC GCTGGTCCAC CGATACCTGA CAGGAACGTA CGTCCAGGAA
    GAGTCTCCTG AAGGAGGGCG CTTTAAGAAG GAGATCGTGG TGGACGGCCA GAGTCACCTG
    TTACTCATCA GGGATGAAGG AGGCCCCCCA GAGGCGCAGT TTGCTCTGTG GGTGGACGCC
    GTGGTGTTCG TCTTCAGCCT GGAGGATGAG ATCAGCTTCC AGACGGTTTA TCACTATTAC
    AGCCGCCTGG CGTCCTACAG GAACACCGCC GACCTGCCGC TGGTGTTGGT GGGAACCCAA
    GACGCCATCA GCTCGTCCAA CCCGCGGGTG ATCGACGACA GCCGCGCCAG GAAGCTTTCT
    AACGAGCTGA AGCGCTGCAC CTACTATGAG ACGTGCGCCA CCTACGGGCT GAACGTGGAG
    CGCGTCTTCC AGGACGTTGC CCAGAAGGTC GTTGCCGTCA GGAAGAAGCA GCAGCTCTCC
    ATCGGACCCT GCAAGTCGCT CCCCAACTCT CCGAGTCACA CGTCCGTCTG CGCCGCTCAG
    GTCTCAGCCG TCCACGTCAG CCAGACCAGT AACGGCGGTG GGAGTCTGAG CGACTACTCT
    TCATCGGTTC CGTCCACGCC GAGCACCAGC CAGAAGGAGC TTCGCATCGA CGCACCGCAG
    GCCGCCAACA CGCCCACGCC AGTCAGGAAG CAGTCCAAAC GCCGCTCCAA CCTCTTCACC
    TCAAGGAAGG CCAGCGATCC GGACAAAGAG AAGAAAGGTC TGGAGAATCG GGCCGACAGC
    ATCGGCAGCG GGCGCGCCAT CCCCATCAAA CAGGGCATGC TGATGAAGAG GAGCGGCAAA
    TCCCTCAACA AGGAGTGGAA GAAGAAGTAC GTGACGCTGT GCGATAACGG ACTGCTCACC
    TACCACCCCA GCCTCCATGA CTACATGCAG AACGTTCACG GTAAGGAGAT CGATCTTCTG
    CGAACCACCG TTAAGGTTCC GGGAAAGAGG CCACCGCGGG CCGTCTCAGC CTGCGGCGCC
    GGGCCCAACC AGAACGCCAA CGGCCTGGTG AAGGACATGA GCAACGTCCA GCTGGGACCG
    ACCTCAGGCT CGGTGTCCAG CAGCTCGTCT GTGTCCCAGA TGGCAAGTGG CGTCAGCCTG
    GTGTCCTTCA ACAGCCGCGG CCTGGAGGGC CTCCACCAGC GCTCCTACTC CGTCTCCAGC
    GCCGACCAGT GGGCCGACGC CACTGTCATC GCCAACTCTG GAGTCAGCAC AGACACTGGT
    TTGGGCGACT CGGTCTGCTC CAGTCCCAGT ATCTCCAGTA CCACCAGTCC AAAGATGGAG
    CCGCCCCCAT CGCCGCACGC CAACCGCAAG AAGCACCGGC GGAAGAAGAG YACCAGCAAC
    TTCAAGGCAG ACRGCCTCTC TGGTACTGCG GAAGAACAAG AGGAGAACTT TGAGTTCACC
    ATTGTGTCGC TGACGGGTCA GACGTGGAAC TTCGAGGCCA CGTCGTACGA AGAGCGGGAC
    GCCTGGGTCC AGGTCATCGA GAGCCAGATC CTAGCCAGCC TGCAGTCCTG CGAGAGCAGC
    AAGAACAAGT CTCGCCTGAC CAGCCAGTCG GAGGCGCTGG CACTGCAGTC CATCCGGAGC
    ATCCGGGGCA ACGGCCGCTG CGCCGACTGC GACGTACCGA ATCCGGACTG GGCTAGCCTG
    AACCTGGGCG CTCTGATCTG CATCGAGTGC TCTGGGATCC ACCGGAACCT GGGGACCCAT
    CTGTCCCGGG TCAGGTCCCT GGACCTGGAC GAGTGGCCAC TGGAGCTCAT CAAGGTGATG
    TCGGCCATCG GCAACGAGCT GGCCAACAGC GTGTGGGAGG CCAACGCCCA GGGCCGCCTC
    AAACCGGGGC CGGACGCCAG CAGGGAGGAG CGTGAGCGTT GGATCCGGGC CAAGTATGAG
    CAGCGTCTGT TTGTGGCGGC GCTGCCCGGC GCCGACCCGC CTCTGGGCCA GCAGCTGCTG
    CGTGCAGCGG CAGAGGAGGA CCTGCGCGGC GTGGTGCTGC TGCTGGCCCA CGCGTCCCGC
    CAGCAGGTCA ACGACACATT CAGCGACGGC TGCTCCCCAC TGCACCTGGC CGCACACAAG
    GGCAACGTGG TTCTGCTGCA GCTGCTGGTC TGGTACGGCG CTGACCTGAT GGCGAGGGAC
    GCCCACGGGA ACAGCGCCAT GGCGTACGCG CGGCAGTCCG GCAGCCAGGA GTGCGTAGAG
    GTTCTGGCCC AGTACGGCGG CGCCGACGAG CGCTACGCCC TGATGACCAC GCCCAACCTG
    CCGCGCCGCA ACGCCAACCG CAACAACAGC TGCAGCAGCC TGGGCAGCGC CGCGCTCATC
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008394757.1
    CDS534..3776
    Translation

    Target ORF information:

    RefSeq Version XM_008396535.2
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata arf-GAP with GTPase, ANK repeat and PH domain-containing protein 1-like (LOC103456779), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008396535.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCTGATGG AGAGAGGAGC GCCTCAGAGG AAGACCGTGT ACCGGATCTC CCTGACACTG 
    GTGAAGAGGG TGAACCTGGG GGGGGATGAG GAAGAGGGGG CGCGGGTAGG TGAGGTGCTG
    GAGGAGGAGG AGGAGGAGCT GGAGCCGGCG GCGGCTCAGG GTGGCATCAT GAGGAGGTTC
    AGGACTTTCA GCACTGGTCA GCTGGAGCTG GGCCGGCTCA GGGCGTCCCG CAGGGCGCAG
    CGTGACGAAT CGCGGCCCGA AACCGCTGCT GCCAAGGTGA GGAGGCTCCT GAAGGCCCGC
    AGCATGGAGG AGCGGGACCC GCCAAAACCC GTGGCCCTCC CAAAGCCCAG CCTGCTGAAG
    CGCAGCTTCA GCTTCAGCGT CCGGACCCGG ATCAGTGGAG AGCTGCTGCG GCTCCGTGCC
    TCGTCCAGAG ACGGGCCGCC ACAGGCCCCG CCCCCTGACC AGGCCCCGCC CTTTGAGCAG
    GCGCCACCCA TCGCACAGGC CCCACCCCCC AGGACCCGGG AGAAGAGCCG CACCCTGGAG
    GTGGGGGCCG TCCTCAACAG GACCGACTCC CTGACCGAGC TGAGCCGCCA GAGGGCCGGC
    GCCGCCAGGA ACCGCACGCT GGACAACAGC GACCTGCAGC GGCGGGACGC ACAGGTCGAT
    GGCGCTACGC CGTGGGGGGG CGACCGGCGG CTTGGACGCT TCTTCAGCGG GTTCTTCTCC
    AGGCCCGGCC CAGTCCGGAG CCCCGGGGTC AGCAGGTCGC TGCGGCGCAG CGGAGCGCCG
    TCCAGCACGG AGAGCATGGA CGGGGGCGGA GCCAACGGTA ACCACGACGC CTTCGTCAAC
    AGCCAGGAGT GGACCCTCAG CCGGACCGTA CCAGAACTCA AAGTGGGCAT TGTGGGTAAT
    CTGGCCAGCG GGAAGTCGGC GCTGGTCCAC CGATACCTGA CAGGAACGTA CGTCCAGGAA
    GAGTCTCCTG AAGGAGGGCG CTTTAAGAAG GAGATCGTGG TGGACGGCCA GAGTCACCTG
    TTACTCATCA GGGATGAAGG AGGCCCCCCA GAGGCGCAGT TTGCTCTGTG GGTGGACGCC
    GTGGTGTTCG TCTTCAGCCT GGAGGATGAG ATCAGCTTCC AGACGGTTTA TCACTATTAC
    AGCCGCCTGG CGTCCTACAG GAACACCGCC GACCTGCCGC TGGTGTTGGT GGGAACCCAA
    GACGCCATCA GCTCGTCCAA CCCGCGGGTG ATCGACGACA GCCGCGCCAG GAAGCTTTCT
    AACGAGCTGA AGCGCTGCAC CTACTATGAG ACGTGCGCCA CCTACGGGCT GAACGTGGAG
    CGCGTCTTCC AGGACGTTGC CCAGAAGGTC GTTGCCGTCA GGAAGAAGCA GCAGCTCTCC
    ATCGGACCCT GCAAGTCGCT CCCCAACTCT CCGAGTCACA CGTCCGTCTG CGCCGCTCAG
    GTCTCAGCCG TCCACGTCAG CCAGACCAGT AACGGCGGTG GGAGTCTGAG CGACTACTCT
    TCATCGGTTC CGTCCACGCC GAGCACCAGC CAGAAGGAGC TTCGCATCGA CGCACCGCAG
    GCCGCCAACA CGCCCACGCC AGTCAGGAAG CAGTCCAAAC GCCGCTCCAA CCTCTTCACC
    TCAAGGAAGG CCAGCGATCC GGACAAAGAG AAGAAAGGTC TGGAGAATCG GGCCGACAGC
    ATCGGCAGCG GGCGCGCCAT CCCCATCAAA CAGGGCATGC TGATGAAGAG GAGCGGCAAA
    TCCCTCAACA AGGAGTGGAA GAAGAAGTAC GTGACGCTGT GCGATAACGG ACTGCTCACC
    TACCACCCCA GCCTCCATGA CTACATGCAG AACGTTCACG GTAAGGAGAT CGATCTTCTG
    CGAACCACCG TTAAGGTTCC GGGAAAGAGG CCACCGCGGG CCGTCTCAGC CTGCGGCGCC
    GGGCCCAACC AGAACGCCAA CGGCCTGGTG AAGGACATGA GCAACGTCCA GCTGGGACCG
    ACCTCAGGCT CGGTGTCCAG CAGCTCGTCT GTGTCCCAGA TGGCAAGTGG CGTCAGCCTG
    GTGTCCTTCA ACAGCCGCGG CCTGGAGGGC CTCCACCAGC GCTCCTACTC CGTCTCCAGC
    GCCGACCAGT GGGCCGACGC CACTGTCATC GCCAACTCTG GAGTCAGCAC AGACACTGGT
    TTGGGCGACT CGGTCTGCTC CAGTCCCAGT ATCTCCAGTA CCACCAGTCC AAAGATGGAG
    CCGCCCCCAT CGCCGCACGC CAACCGCAAG AAGCACCGGC GGAAGAAGAG YACCAGCAAC
    TTCAAGGCAG ACRGCCTCTC TGGTACTGCG GAAGAACAAG AGGAGAACTT TGAGTTCACC
    ATTGTGTCGC TGACGGGTCA GACGTGGAAC TTCGAGGCCA CGTCGTACGA AGAGCGGGAC
    GCCTGGGTCC AGGTCATCGA GAGCCAGATC CTAGCCAGCC TGCAGTCCTG CGAGAGCAGC
    AAGAACAAGT CTCGCCTGAC CAGCCAGTCG GAGGCGCTGG CACTGCAGTC CATCCGGAGC
    ATCCGGGGCA ACGGCCGCTG CGCCGACTGC GACGTACCGA ATCCGGACTG GGCTAGCCTG
    AACCTGGGCG CTCTGATCTG CATCGAGTGC TCTGGGATCC ACCGGAACCT GGGGACCCAT
    CTGTCCCGGG TCAGGTCCCT GGACCTGGAC GAGTGGCCAC TGGAGCTCAT CAAGGTGATG
    TCGGCCATCG GCAACGAGCT GGCCAACAGC GTGTGGGAGG CCAACGCCCA GGGCCGCCTC
    AAACCGGGGC CGGACGCCAG CAGGGAGGAG CGTGAGCGTT GGATCCGGGC CAAGTATGAG
    CAGCGTCTGT TTGTGGCGGC GCTGCCCGGC GCCGACCCGC CTCTGGGCCA GCAGCTGCTG
    CGTGCAGCGG CAGAGGAGGA CCTGCGCGGC GTGGTGCTGC TGCTGGCCCA CGCGTCCCGC
    CAGCAGGTCA ACGACACATT CAGCGACGGC TGCTCCCCAC TGCACCTGGC CGCACACAAG
    GGCAACGTGG TTCTGCTGCA GCTGCTGGTC TGGTACGGCG CTGACCTGAT GGCGAGGGAC
    GCCCACGGGA ACAGCGCCAT GGCGTACGCG CGGCAGTCCG GCAGCCAGGA GTGCGTAGAG
    GTTCTGGCCC AGTACGGCGG CGCCGACGAG CGCTACGCCC TGATGACCAC GCCCAACCTG
    CCGCGCCGCA ACGCCAACCG CAACAACAGC TGCAGCAGCC TGGGCAGCGC CGCGCTCATC
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.