TM9SF4 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

The following TM9SF4 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the TM9SF4 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa73447 XM_003814745.2
Latest version!
Pan paniscus transmembrane 9 superfamily member 4 (TM9SF4), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPa73448 XM_003814746.3
Latest version!
Pan paniscus transmembrane 9 superfamily member 4 (TM9SF4), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa73447
    Clone ID Related Accession (Same CDS sequence) XM_003814745.2
    Accession Version XM_003814745.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1929bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
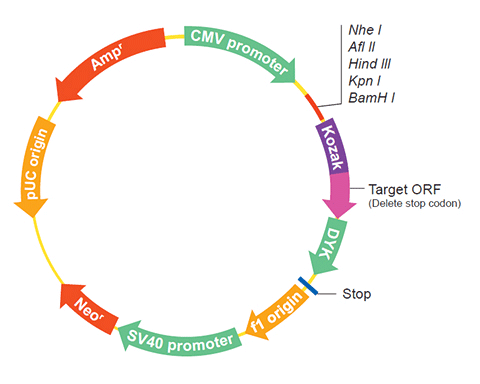
    Clone information Clone Map MSDS
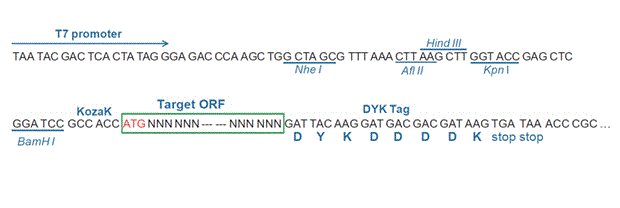
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product transmembrane 9 superfamily member 4 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027888.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 2, 2014 this sequence version replaced XM_003814745.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGGCGACGG CGATGGATTG GTTGCCGTGG TCTTTACTGC TTTTCTCCCT GATGTGTGAA 
    ACAAGCGCCT TCTATGTGCC TGGGGTCGCG CCTATCAACT TCCACCAGAA CGATCCCGTA
    GAAATCAAGG CTGTGAAGCT CACCAGCTCT CGAACCCAGC TACCTTATGA ATACTATTCA
    CTGCCCTTCT GCCAGCCCAG CAAGATAACC TACAAGGCAG AGAATCTGGG AGAGGTGCTG
    AGAGGGGACC GGATTGTCAA CACCCCTTTC CAGGTTCTCA TGAACAGCGA GAAGAAGTGT
    GAAGTTCTGT GCAGCCAGTC CAACAAGCCA GTGACCCTGA CAGTGGAGCA GAGCCGACTC
    GTGGCTGAGC GGATCACAGA AGACTACTAC GTCCACCTCA TTGCTGACAA CCTGCCTGTG
    GCCACCCGGC TGGAGCTCTA CTCCAACCGA GACAGCGATG ACAAGAAGAA GGAAAAAGAT
    GTGCAGTTTG AACACGGCTA CCGGCTCGGC TTCACAGATG TCAACAAGAT CTACCTGCAC
    AACCACCTCT CATTCATCCT TTACTATCAT CGGGAGGACA TGGAAGAGGA CCAGGAGCAC
    ACGTACCGTG TCGTCCGCTT CGAGGTGATT CCCCAGAGCA TCAGGCTGGA GGACCTCAAA
    GCAGATGAGA AGAGTTCGTG CACTCTGCCT GAGGGTACCA ACTCCTCGCC CCAAGAAATT
    GACCCCACCA AGGAGAATCA GCTGTACTTC ACCTACTCTG TCCACTGGGA GGAAAGTGAT
    ATCAAATGGG CCTCTCGCTG GGACACTTAC CTGACCATGA GTGACGTCCA GATCCACTGG
    TTTTCTATCA TTAACTCCGT TGTTGTGGTC TTCTTCCTGT CAGGTATCCT GAGCATGATT
    ATCATTCGGA CCCTCCGGAA GGACATTGCC AACTACAACA AGGAGGATGA CATTGAAGAC
    ACCATGGAGG AGTCTGGGTG GAAGTTGGTG CATGGCGACG TCTTCAGGCC CCCCCAGTAC
    CCCATGATCC TCAGCTCCCT GCTGGGCTCA GGCATTCAGC TGTTCTGTAT GATCCTCATC
    GTCATCTTTG TAGCCATGCT TGGGATGCTG TCGCCCTCCA GCCGGGGAGC TCTCATGACC
    ACAGCCTGCT TCCTCTTCAT GTTCATGGGG GTGTTTGGCG GATTTTCTGC TGGCCGTCTG
    TACCGCACTT TAAAAGGCCA TCGGTGGAAG AAAGGAGCCT TCTGTACGGC AACTCTGTAC
    CCTGGTGTGG TTTTTGGCAT CTGCTTCGTA TTGAATTGCT TCATTTGGGG AAAGCACTCA
    TCAGGAGCGG TGCCCTTTCC CACCATGGTG GCTCTGCTGT GCATGTGGTT CGGGATCTCC
    CTGCCCCTCG TCTACTTGGG CTACTACTTC GGCTTCCGAA AGCAGCCATA TGACAACCCT
    GTGCGCACCA ACCAGATTCC CCGGCAGATC CCCGAGCAGC GGTGGTACAT GAACCGATTT
    GTGGGCATCC TCATGGCTGG GATCTTGCCC TTCGGCGCCA TGTTCATCGA GCTCTTCTTC
    ATCTTCAGTG CTATCTGGGA GAATCAGTTC TATTACCTCT TTGGCTTCCT GTTCCTTGTT
    TTCATCATCC TGGTGGTATC CTGTTCACAA ATCAGCATCG TCATGGTGTA CTTCCAGCTG
    TGTGCAGAGG ATTACCGCTG GTGGTGGAGA AATTTCCTAG TCTCCGGGGG CTCTGCATTC
    TACGTCCTGG TTTATGCCAT CTTTTATTTC GTTAACAAGC TGGACATCGT GGAGTTCATC
    CCCTCTCTCC TCTACTTTGG CTACACGGCC CTCATGGTCT TGTCCTTCTG GCTGCTAACG
    GGTACCATCG GCTTCTATGC AGCCTACATG TTTGTTCGCA AGATCTATGC TGCCGTGAAG
    ATAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003814793.1
    CDS236..2164
    Translation

    Target ORF information:

    RefSeq Version XM_003814745.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus transmembrane 9 superfamily member 4 (TM9SF4), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003814745.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGGCGACGG CGATGGATTG GTTGCCGTGG TCTTTACTGC TTTTCTCCCT GATGTGTGAA 
    ACAAGCGCCT TCTATGTGCC TGGGGTCGCG CCTATCAACT TCCACCAGAA CGATCCCGTA
    GAAATCAAGG CTGTGAAGCT CACCAGCTCT CGAACCCAGC TACCTTATGA ATACTATTCA
    CTGCCCTTCT GCCAGCCCAG CAAGATAACC TACAAGGCAG AGAATCTGGG AGAGGTGCTG
    AGAGGGGACC GGATTGTCAA CACCCCTTTC CAGGTTCTCA TGAACAGCGA GAAGAAGTGT
    GAAGTTCTGT GCAGCCAGTC CAACAAGCCA GTGACCCTGA CAGTGGAGCA GAGCCGACTC
    GTGGCTGAGC GGATCACAGA AGACTACTAC GTCCACCTCA TTGCTGACAA CCTGCCTGTG
    GCCACCCGGC TGGAGCTCTA CTCCAACCGA GACAGCGATG ACAAGAAGAA GGAAAAAGAT
    GTGCAGTTTG AACACGGCTA CCGGCTCGGC TTCACAGATG TCAACAAGAT CTACCTGCAC
    AACCACCTCT CATTCATCCT TTACTATCAT CGGGAGGACA TGGAAGAGGA CCAGGAGCAC
    ACGTACCGTG TCGTCCGCTT CGAGGTGATT CCCCAGAGCA TCAGGCTGGA GGACCTCAAA
    GCAGATGAGA AGAGTTCGTG CACTCTGCCT GAGGGTACCA ACTCCTCGCC CCAAGAAATT
    GACCCCACCA AGGAGAATCA GCTGTACTTC ACCTACTCTG TCCACTGGGA GGAAAGTGAT
    ATCAAATGGG CCTCTCGCTG GGACACTTAC CTGACCATGA GTGACGTCCA GATCCACTGG
    TTTTCTATCA TTAACTCCGT TGTTGTGGTC TTCTTCCTGT CAGGTATCCT GAGCATGATT
    ATCATTCGGA CCCTCCGGAA GGACATTGCC AACTACAACA AGGAGGATGA CATTGAAGAC
    ACCATGGAGG AGTCTGGGTG GAAGTTGGTG CATGGCGACG TCTTCAGGCC CCCCCAGTAC
    CCCATGATCC TCAGCTCCCT GCTGGGCTCA GGCATTCAGC TGTTCTGTAT GATCCTCATC
    GTCATCTTTG TAGCCATGCT TGGGATGCTG TCGCCCTCCA GCCGGGGAGC TCTCATGACC
    ACAGCCTGCT TCCTCTTCAT GTTCATGGGG GTGTTTGGCG GATTTTCTGC TGGCCGTCTG
    TACCGCACTT TAAAAGGCCA TCGGTGGAAG AAAGGAGCCT TCTGTACGGC AACTCTGTAC
    CCTGGTGTGG TTTTTGGCAT CTGCTTCGTA TTGAATTGCT TCATTTGGGG AAAGCACTCA
    TCAGGAGCGG TGCCCTTTCC CACCATGGTG GCTCTGCTGT GCATGTGGTT CGGGATCTCC
    CTGCCCCTCG TCTACTTGGG CTACTACTTC GGCTTCCGAA AGCAGCCATA TGACAACCCT
    GTGCGCACCA ACCAGATTCC CCGGCAGATC CCCGAGCAGC GGTGGTACAT GAACCGATTT
    GTGGGCATCC TCATGGCTGG GATCTTGCCC TTCGGCGCCA TGTTCATCGA GCTCTTCTTC
    ATCTTCAGTG CTATCTGGGA GAATCAGTTC TATTACCTCT TTGGCTTCCT GTTCCTTGTT
    TTCATCATCC TGGTGGTATC CTGTTCACAA ATCAGCATCG TCATGGTGTA CTTCCAGCTG
    TGTGCAGAGG ATTACCGCTG GTGGTGGAGA AATTTCCTAG TCTCCGGGGG CTCTGCATTC
    TACGTCCTGG TTTATGCCAT CTTTTATTTC GTTAACAAGC TGGACATCGT GGAGTTCATC
    CCCTCTCTCC TCTACTTTGG CTACACGGCC CTCATGGTCT TGTCCTTCTG GCTGCTAACG
    GGTACCATCG GCTTCTATGC AGCCTACATG TTTGTTCGCA AGATCTATGC TGCCGTGAAG
    ATAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa73448
    Clone ID Related Accession (Same CDS sequence) XM_003814746.3
    Accession Version XM_003814746.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1878bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product transmembrane 9 superfamily member 4 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027888.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_003814746.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGTGTGAAA CAAGCGCCTT CTATGTGCCT GGGGTCGCGC CTATCAACTT CCACCAGAAC 
    GATCCCGTAG AAATCAAGGC TGTGAAGCTC ACCAGCTCTC GAACCCAGCT ACCTTATGAA
    TACTATTCAC TGCCCTTCTG CCAGCCCAGC AAGATAACCT ACAAGGCAGA GAATCTGGGA
    GAGGTGCTGA GAGGGGACCG GATTGTCAAC ACCCCTTTCC AGGTTCTCAT GAACAGCGAG
    AAGAAGTGTG AAGTTCTGTG CAGCCAGTCC AACAAGCCAG TGACCCTGAC AGTGGAGCAG
    AGCCGACTCG TGGCTGAGCG GATCACAGAA GACTACTACG TCCACCTCAT TGCTGACAAC
    CTGCCTGTGG CCACCCGGCT GGAGCTCTAC TCCAACCGAG ACAGCGATGA CAAGAAGAAG
    GAAAAAGATG TGCAGTTTGA ACACGGCTAC CGGCTCGGCT TCACAGATGT CAACAAGATC
    TACCTGCACA ACCACCTCTC ATTCATCCTT TACTATCATC GGGAGGACAT GGAAGAGGAC
    CAGGAGCACA CGTACCGTGT CGTCCGCTTC GAGGTGATTC CCCAGAGCAT CAGGCTGGAG
    GACCTCAAAG CAGATGAGAA GAGTTCGTGC ACTCTGCCTG AGGGTACCAA CTCCTCGCCC
    CAAGAAATTG ACCCCACCAA GGAGAATCAG CTGTACTTCA CCTACTCTGT CCACTGGGAG
    GAAAGTGATA TCAAATGGGC CTCTCGCTGG GACACTTACC TGACCATGAG TGACGTCCAG
    ATCCACTGGT TTTCTATCAT TAACTCCGTT GTTGTGGTCT TCTTCCTGTC AGGTATCCTG
    AGCATGATTA TCATTCGGAC CCTCCGGAAG GACATTGCCA ACTACAACAA GGAGGATGAC
    ATTGAAGACA CCATGGAGGA GTCTGGGTGG AAGTTGGTGC ATGGCGACGT CTTCAGGCCC
    CCCCAGTACC CCATGATCCT CAGCTCCCTG CTGGGCTCAG GCATTCAGCT GTTCTGTATG
    ATCCTCATCG TCATCTTTGT AGCCATGCTT GGGATGCTGT CGCCCTCCAG CCGGGGAGCT
    CTCATGACCA CAGCCTGCTT CCTCTTCATG TTCATGGGGG TGTTTGGCGG ATTTTCTGCT
    GGCCGTCTGT ACCGCACTTT AAAAGGCCAT CGGTGGAAGA AAGGAGCCTT CTGTACGGCA
    ACTCTGTACC CTGGTGTGGT TTTTGGCATC TGCTTCGTAT TGAATTGCTT CATTTGGGGA
    AAGCACTCAT CAGGAGCGGT GCCCTTTCCC ACCATGGTGG CTCTGCTGTG CATGTGGTTC
    GGGATCTCCC TGCCCCTCGT CTACTTGGGC TACTACTTCG GCTTCCGAAA GCAGCCATAT
    GACAACCCTG TGCGCACCAA CCAGATTCCC CGGCAGATCC CCGAGCAGCG GTGGTACATG
    AACCGATTTG TGGGCATCCT CATGGCTGGG ATCTTGCCCT TCGGCGCCAT GTTCATCGAG
    CTCTTCTTCA TCTTCAGTGC TATCTGGGAG AATCAGTTCT ATTACCTCTT TGGCTTCCTG
    TTCCTTGTTT TCATCATCCT GGTGGTATCC TGTTCACAAA TCAGCATCGT CATGGTGTAC
    TTCCAGCTGT GTGCAGAGGA TTACCGCTGG TGGTGGAGAA ATTTCCTAGT CTCCGGGGGC
    TCTGCATTCT ACGTCCTGGT TTATGCCATC TTTTATTTCG TTAACAAGCT GGACATCGTG
    GAGTTCATCC CCTCTCTCCT CTACTTTGGC TACACGGCCC TCATGGTCTT GTCCTTCTGG
    CTGCTAACGG GTACCATCGG CTTCTATGCA GCCTACATGT TTGTTCGCAA GATCTATGCT
    GCCGTGAAGA TAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003814794.2
    CDS344..2221
    Translation

    Target ORF information:

    RefSeq Version XM_003814746.3
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus transmembrane 9 superfamily member 4 (TM9SF4), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003814746.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGTGTGAAA CAAGCGCCTT CTATGTGCCT GGGGTCGCGC CTATCAACTT CCACCAGAAC 
    GATCCCGTAG AAATCAAGGC TGTGAAGCTC ACCAGCTCTC GAACCCAGCT ACCTTATGAA
    TACTATTCAC TGCCCTTCTG CCAGCCCAGC AAGATAACCT ACAAGGCAGA GAATCTGGGA
    GAGGTGCTGA GAGGGGACCG GATTGTCAAC ACCCCTTTCC AGGTTCTCAT GAACAGCGAG
    AAGAAGTGTG AAGTTCTGTG CAGCCAGTCC AACAAGCCAG TGACCCTGAC AGTGGAGCAG
    AGCCGACTCG TGGCTGAGCG GATCACAGAA GACTACTACG TCCACCTCAT TGCTGACAAC
    CTGCCTGTGG CCACCCGGCT GGAGCTCTAC TCCAACCGAG ACAGCGATGA CAAGAAGAAG
    GAAAAAGATG TGCAGTTTGA ACACGGCTAC CGGCTCGGCT TCACAGATGT CAACAAGATC
    TACCTGCACA ACCACCTCTC ATTCATCCTT TACTATCATC GGGAGGACAT GGAAGAGGAC
    CAGGAGCACA CGTACCGTGT CGTCCGCTTC GAGGTGATTC CCCAGAGCAT CAGGCTGGAG
    GACCTCAAAG CAGATGAGAA GAGTTCGTGC ACTCTGCCTG AGGGTACCAA CTCCTCGCCC
    CAAGAAATTG ACCCCACCAA GGAGAATCAG CTGTACTTCA CCTACTCTGT CCACTGGGAG
    GAAAGTGATA TCAAATGGGC CTCTCGCTGG GACACTTACC TGACCATGAG TGACGTCCAG
    ATCCACTGGT TTTCTATCAT TAACTCCGTT GTTGTGGTCT TCTTCCTGTC AGGTATCCTG
    AGCATGATTA TCATTCGGAC CCTCCGGAAG GACATTGCCA ACTACAACAA GGAGGATGAC
    ATTGAAGACA CCATGGAGGA GTCTGGGTGG AAGTTGGTGC ATGGCGACGT CTTCAGGCCC
    CCCCAGTACC CCATGATCCT CAGCTCCCTG CTGGGCTCAG GCATTCAGCT GTTCTGTATG
    ATCCTCATCG TCATCTTTGT AGCCATGCTT GGGATGCTGT CGCCCTCCAG CCGGGGAGCT
    CTCATGACCA CAGCCTGCTT CCTCTTCATG TTCATGGGGG TGTTTGGCGG ATTTTCTGCT
    GGCCGTCTGT ACCGCACTTT AAAAGGCCAT CGGTGGAAGA AAGGAGCCTT CTGTACGGCA
    ACTCTGTACC CTGGTGTGGT TTTTGGCATC TGCTTCGTAT TGAATTGCTT CATTTGGGGA
    AAGCACTCAT CAGGAGCGGT GCCCTTTCCC ACCATGGTGG CTCTGCTGTG CATGTGGTTC
    GGGATCTCCC TGCCCCTCGT CTACTTGGGC TACTACTTCG GCTTCCGAAA GCAGCCATAT
    GACAACCCTG TGCGCACCAA CCAGATTCCC CGGCAGATCC CCGAGCAGCG GTGGTACATG
    AACCGATTTG TGGGCATCCT CATGGCTGGG ATCTTGCCCT TCGGCGCCAT GTTCATCGAG
    CTCTTCTTCA TCTTCAGTGC TATCTGGGAG AATCAGTTCT ATTACCTCTT TGGCTTCCTG
    TTCCTTGTTT TCATCATCCT GGTGGTATCC TGTTCACAAA TCAGCATCGT CATGGTGTAC
    TTCCAGCTGT GTGCAGAGGA TTACCGCTGG TGGTGGAGAA ATTTCCTAGT CTCCGGGGGC
    TCTGCATTCT ACGTCCTGGT TTATGCCATC TTTTATTTCG TTAACAAGCT GGACATCGTG
    GAGTTCATCC CCTCTCTCCT CTACTTTGGC TACACGGCCC TCATGGTCTT GTCCTTCTGG
    CTGCTAACGG GTACCATCGG CTTCTATGCA GCCTACATGT TTGTTCGCAA GATCTATGCT
    GCCGTGAAGA TAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.