LOC105277893 cDNA ORF clone, Ooceraea biroi(clonal raider ant)

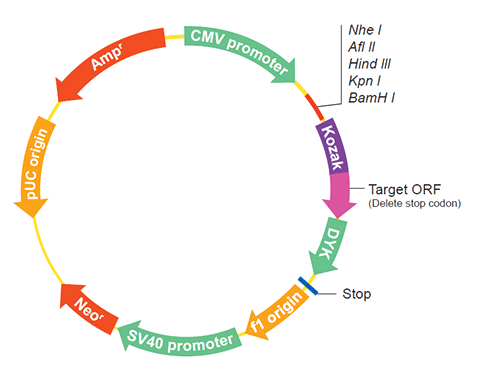
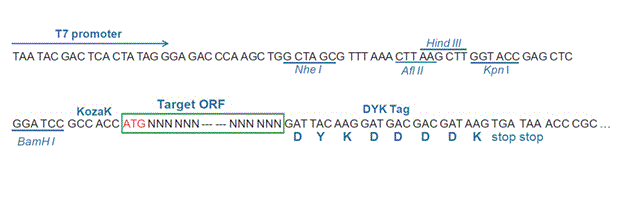
The following LOC105277893 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105277893 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OOo07007 XM_011336597.3
Latest version!
Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07008 XM_011336598.3
Latest version!
Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07009 XM_011336599.3
Latest version!
Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07010 XM_011336600.3
Latest version!
Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07011 XM_011336601.3
Latest version!
Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07012 XM_011336603.3
Latest version!
Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
View Old Accession Versions >>
OOo07010 XM_011336600.2 Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07012 XM_011336603.2 Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07007 XM_011336597.2 Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07008 XM_011336598.2 Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07011 XM_011336601.2 Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OOo07009 XM_011336599.2 Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OOo07007
    Clone ID Related Accession (Same CDS sequence) XM_011336597.3 , XM_011336597.2
    Accession Version XM_011336597.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3456bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-06
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_039506.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Nov 7, 2018 this sequence version replaced XM_011336597.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Ooceraea biroi Annotation Release 100 Annotation Version :: 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGTAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334899.1
    CDS80..3535
    Translation

    Target ORF information:

    RefSeq Version XM_011336597.3
    Organism Ooceraea biroi(clonal raider ant)
    Definition Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336597.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGTAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07007
    Clone ID Related Accession (Same CDS sequence) XM_011336597.3 , XM_011336597.2
    Accession Version XM_011336597.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3456bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-01-23
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011925022.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jan 24, 2017 this sequence version replaced XM_011336597.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Cerapachys biroi Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGTAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334899.1
    CDS81..3536
    Translation

    Target ORF information:

    RefSeq Version XM_011336597.2
    Organism Ooceraea biroi(clonal raider ant)
    Definition Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336597.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGTAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07008
    Clone ID Related Accession (Same CDS sequence) XM_011336598.3 , XM_011336598.2
    Accession Version XM_011336598.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3453bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-06
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_039506.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Nov 7, 2018 this sequence version replaced XM_011336598.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Ooceraea biroi Annotation Release 100 Annotation Version :: 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGCAGAC GGTGAAAGCG ACGAGCAGCG CTTGCTTTCC
    GAACGCACTG GTTACGCGAC CACGTCCAGT CAAGCAGACA CCCCGACTTT GGCCTCGACC
    ACCCATACAC CCAGTGGCCC AACGACACCT AGTGCCGCAG CGGTGCCGAG GATCGCGGAG
    ACACCACCCA TGGCCGTGAC ACCAGGCAGC GGCGGGAGCA GCAGCGAAAC CAGCCCATTC
    CTACCCGAGA ACAATCTCAA TGTCACCCGA GATATCCGCA ATTCGCCGAG ATGTTCCATA
    CCTGGTGGTG AACGAGTTGG AAGACGCTCG AAGGAGCGAT TGGTCAACGA ACCGGAAGCA
    TCCGGTACCT CTGACCAGTA CAGCCATCAT CTGACAATTG GTCCACACGG CGGCGTGGAC
    TGGGTACGTC GATTAGGTTT AGAGCCTGGT GGACGAAAAT CCAGCGATTC CGAGATCACT
    GGTGCCAGTG CCGTGAGTGG ACGAGAAGAG GAGCTGACGT TGCACAGATC GACCGATTGC
    ATCGTCTCCA AAGAACTCGC TTCTTCCTCG GATAGCGATC TCCTCAGGTC AGCACCGCCG
    TGGACGGTGG CTAACAGGAA CCAGAAGTTT CGTTTCTCGC CGGAAAAGGA GAAATGTCAT
    CAACAGCCTC GAGAGACGCA TCGAGAGGAA CATCGCGAGT CGCGACAGCC GCATCTTCCC
    GAGAAGGAGA AGGATTCGAG CGGTCTATCA GACTCCAGCA AGACAATCTC AAGTCAGGAG
    GAGGAGAAAC CATCGAAAGA AGAACGAGAG GCAAAGAAGA CGCGCGTCAA GCAGAGCCTG
    ATGAAACGGG CGCGCTCGGT GGCGATCTTC TCGCTGAAGC TGAAAGAACG TCGCGCCCGA
    GAGGCCGAGC TGAAGGCCAA GGAGGCGGAA AGGGAGGCGA GGTGGCAACA ACCGCAGTCT
    TGTGTTGGTG GCGAGCTCTC ATGCATACCC ATAGAAAAGC TTATCTCAGT GGACGACATT
    GCGGCCATGG ATATACGACG AATGAACCAT TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_011334900.1
    CDS80..3532
    Translation

    Target ORF information:

    RefSeq Version XM_011336598.3
    Organism Ooceraea biroi(clonal raider ant)
    Definition Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336598.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGCAGAC GGTGAAAGCG ACGAGCAGCG CTTGCTTTCC
    GAACGCACTG GTTACGCGAC CACGTCCAGT CAAGCAGACA CCCCGACTTT GGCCTCGACC
    ACCCATACAC CCAGTGGCCC AACGACACCT AGTGCCGCAG CGGTGCCGAG GATCGCGGAG
    ACACCACCCA TGGCCGTGAC ACCAGGCAGC GGCGGGAGCA GCAGCGAAAC CAGCCCATTC
    CTACCCGAGA ACAATCTCAA TGTCACCCGA GATATCCGCA ATTCGCCGAG ATGTTCCATA
    CCTGGTGGTG AACGAGTTGG AAGACGCTCG AAGGAGCGAT TGGTCAACGA ACCGGAAGCA
    TCCGGTACCT CTGACCAGTA CAGCCATCAT CTGACAATTG GTCCACACGG CGGCGTGGAC
    TGGGTACGTC GATTAGGTTT AGAGCCTGGT GGACGAAAAT CCAGCGATTC CGAGATCACT
    GGTGCCAGTG CCGTGAGTGG ACGAGAAGAG GAGCTGACGT TGCACAGATC GACCGATTGC
    ATCGTCTCCA AAGAACTCGC TTCTTCCTCG GATAGCGATC TCCTCAGGTC AGCACCGCCG
    TGGACGGTGG CTAACAGGAA CCAGAAGTTT CGTTTCTCGC CGGAAAAGGA GAAATGTCAT
    CAACAGCCTC GAGAGACGCA TCGAGAGGAA CATCGCGAGT CGCGACAGCC GCATCTTCCC
    GAGAAGGAGA AGGATTCGAG CGGTCTATCA GACTCCAGCA AGACAATCTC AAGTCAGGAG
    GAGGAGAAAC CATCGAAAGA AGAACGAGAG GCAAAGAAGA CGCGCGTCAA GCAGAGCCTG
    ATGAAACGGG CGCGCTCGGT GGCGATCTTC TCGCTGAAGC TGAAAGAACG TCGCGCCCGA
    GAGGCCGAGC TGAAGGCCAA GGAGGCGGAA AGGGAGGCGA GGTGGCAACA ACCGCAGTCT
    TGTGTTGGTG GCGAGCTCTC ATGCATACCC ATAGAAAAGC TTATCTCAGT GGACGACATT
    GCGGCCATGG ATATACGACG AATGAACCAT TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07008
    Clone ID Related Accession (Same CDS sequence) XM_011336598.3 , XM_011336598.2
    Accession Version XM_011336598.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3453bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-01-23
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011925022.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jan 24, 2017 this sequence version replaced XM_011336598.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Cerapachys biroi Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGCAGAC GGTGAAAGCG ACGAGCAGCG CTTGCTTTCC
    GAACGCACTG GTTACGCGAC CACGTCCAGT CAAGCAGACA CCCCGACTTT GGCCTCGACC
    ACCCATACAC CCAGTGGCCC AACGACACCT AGTGCCGCAG CGGTGCCGAG GATCGCGGAG
    ACACCACCCA TGGCCGTGAC ACCAGGCAGC GGCGGGAGCA GCAGCGAAAC CAGCCCATTC
    CTACCCGAGA ACAATCTCAA TGTCACCCGA GATATCCGCA ATTCGCCGAG ATGTTCCATA
    CCTGGTGGTG AACGAGTTGG AAGACGCTCG AAGGAGCGAT TGGTCAACGA ACCGGAAGCA
    TCCGGTACCT CTGACCAGTA CAGCCATCAT CTGACAATTG GTCCACACGG CGGCGTGGAC
    TGGGTACGTC GATTAGGTTT AGAGCCTGGT GGACGAAAAT CCAGCGATTC CGAGATCACT
    GGTGCCAGTG CCGTGAGTGG ACGAGAAGAG GAGCTGACGT TGCACAGATC GACCGATTGC
    ATCGTCTCCA AAGAACTCGC TTCTTCCTCG GATAGCGATC TCCTCAGGTC AGCACCGCCG
    TGGACGGTGG CTAACAGGAA CCAGAAGTTT CGTTTCTCGC CGGAAAAGGA GAAATGTCAT
    CAACAGCCTC GAGAGACGCA TCGAGAGGAA CATCGCGAGT CGCGACAGCC GCATCTTCCC
    GAGAAGGAGA AGGATTCGAG CGGTCTATCA GACTCCAGCA AGACAATCTC AAGTCAGGAG
    GAGGAGAAAC CATCGAAAGA AGAACGAGAG GCAAAGAAGA CGCGCGTCAA GCAGAGCCTG
    ATGAAACGGG CGCGCTCGGT GGCGATCTTC TCGCTGAAGC TGAAAGAACG TCGCGCCCGA
    GAGGCCGAGC TGAAGGCCAA GGAGGCGGAA AGGGAGGCGA GGTGGCAACA ACCGCAGTCT
    TGTGTTGGTG GCGAGCTCTC ATGCATACCC ATAGAAAAGC TTATCTCAGT GGACGACATT
    GCGGCCATGG ATATACGACG AATGAACCAT TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334900.1
    CDS81..3533
    Translation

    Target ORF information:

    RefSeq Version XM_011336598.2
    Organism Ooceraea biroi(clonal raider ant)
    Definition Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336598.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGCAGAC GGTGAAAGCG ACGAGCAGCG CTTGCTTTCC
    GAACGCACTG GTTACGCGAC CACGTCCAGT CAAGCAGACA CCCCGACTTT GGCCTCGACC
    ACCCATACAC CCAGTGGCCC AACGACACCT AGTGCCGCAG CGGTGCCGAG GATCGCGGAG
    ACACCACCCA TGGCCGTGAC ACCAGGCAGC GGCGGGAGCA GCAGCGAAAC CAGCCCATTC
    CTACCCGAGA ACAATCTCAA TGTCACCCGA GATATCCGCA ATTCGCCGAG ATGTTCCATA
    CCTGGTGGTG AACGAGTTGG AAGACGCTCG AAGGAGCGAT TGGTCAACGA ACCGGAAGCA
    TCCGGTACCT CTGACCAGTA CAGCCATCAT CTGACAATTG GTCCACACGG CGGCGTGGAC
    TGGGTACGTC GATTAGGTTT AGAGCCTGGT GGACGAAAAT CCAGCGATTC CGAGATCACT
    GGTGCCAGTG CCGTGAGTGG ACGAGAAGAG GAGCTGACGT TGCACAGATC GACCGATTGC
    ATCGTCTCCA AAGAACTCGC TTCTTCCTCG GATAGCGATC TCCTCAGGTC AGCACCGCCG
    TGGACGGTGG CTAACAGGAA CCAGAAGTTT CGTTTCTCGC CGGAAAAGGA GAAATGTCAT
    CAACAGCCTC GAGAGACGCA TCGAGAGGAA CATCGCGAGT CGCGACAGCC GCATCTTCCC
    GAGAAGGAGA AGGATTCGAG CGGTCTATCA GACTCCAGCA AGACAATCTC AAGTCAGGAG
    GAGGAGAAAC CATCGAAAGA AGAACGAGAG GCAAAGAAGA CGCGCGTCAA GCAGAGCCTG
    ATGAAACGGG CGCGCTCGGT GGCGATCTTC TCGCTGAAGC TGAAAGAACG TCGCGCCCGA
    GAGGCCGAGC TGAAGGCCAA GGAGGCGGAA AGGGAGGCGA GGTGGCAACA ACCGCAGTCT
    TGTGTTGGTG GCGAGCTCTC ATGCATACCC ATAGAAAAGC TTATCTCAGT GGACGACATT
    GCGGCCATGG ATATACGACG AATGAACCAT TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07009
    Clone ID Related Accession (Same CDS sequence) XM_011336599.2 , XM_011336599.3
    Accession Version XM_011336599.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3450bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-01-23
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011925022.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jan 24, 2017 this sequence version replaced XM_011336599.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Cerapachys biroi Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGACGGT GAAAGCGACG AGCAGCGCTT GCTTTCCGAA
    CGCACTGGTT ACGCGACCAC GTCCAGTCAA GCAGACACCC CGACTTTGGC CTCGACCACC
    CATACACCCA GTGGCCCAAC GACACCTAGT GCCGCAGCGG TGCCGAGGAT CGCGGAGACA
    CCACCCATGG CCGTGACACC AGGCAGCGGC GGGAGCAGCA GCGAAACCAG CCCATTCCTA
    CCCGAGAACA ATCTCAATGT CACCCGAGAT ATCCGCAATT CGCCGAGATG TTCCATACCT
    GGTGGTGAAC GAGTTGGAAG ACGCTCGAAG GAGCGATTGG TCAACGAACC GGAAGCATCC
    GGTACCTCTG ACCAGTACAG CCATCATCTG ACAATTGGTC CACACGGCGG CGTGGACTGG
    GTACGTCGAT TAGGTTTAGA GCCTGGTGGA CGAAAATCCA GCGATTCCGA GATCACTGGT
    GCCAGTGCCG TGAGTGGACG AGAAGAGGAG CTGACGTTGC ACAGATCGAC CGATTGCATC
    GTCTCCAAAG AACTCGCTTC TTCCTCGGAT AGCGATCTCC TCAGGTCAGC ACCGCCGTGG
    ACGGTGGCTA ACAGGAACCA GAAGTTTCGT TTCTCGCCGG AAAAGGAGAA ATGTCATCAA
    CAGCCTCGAG AGACGCATCG AGAGGAACAT CGCGAGTCGC GACAGCCGCA TCTTCCCGAG
    AAGGAGAAGG ATTCGAGCGG TCTATCAGAC TCCAGCAAGA CAATCTCAAG TCAGGAGGAG
    GAGAAACCAT CGAAAGAAGA ACGAGAGGCA AAGAAGACGC GCGTCAAGCA GAGCCTGATG
    AAACGGGCGC GCTCGGTGGC GATCTTCTCG CTGAAGCTGA AAGAACGTCG CGCCCGAGAG
    GCCGAGCTGA AGGCCAAGGA GGCGGAAAGG GAGGCGAGGT GGCAACAACC GCAGTCTTGT
    GTTGGTGGCG AGCTCTCATG CATACCCATA GAAAAGCTTA TCTCAGTGGA CGACATTGCG
    GCCATGGATA TACGACGAAT GAACCATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334901.1
    CDS81..3530
    Translation

    Target ORF information:

    RefSeq Version XM_011336599.2
    Organism Ooceraea biroi(clonal raider ant)
    Definition Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336599.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGACGGT GAAAGCGACG AGCAGCGCTT GCTTTCCGAA
    CGCACTGGTT ACGCGACCAC GTCCAGTCAA GCAGACACCC CGACTTTGGC CTCGACCACC
    CATACACCCA GTGGCCCAAC GACACCTAGT GCCGCAGCGG TGCCGAGGAT CGCGGAGACA
    CCACCCATGG CCGTGACACC AGGCAGCGGC GGGAGCAGCA GCGAAACCAG CCCATTCCTA
    CCCGAGAACA ATCTCAATGT CACCCGAGAT ATCCGCAATT CGCCGAGATG TTCCATACCT
    GGTGGTGAAC GAGTTGGAAG ACGCTCGAAG GAGCGATTGG TCAACGAACC GGAAGCATCC
    GGTACCTCTG ACCAGTACAG CCATCATCTG ACAATTGGTC CACACGGCGG CGTGGACTGG
    GTACGTCGAT TAGGTTTAGA GCCTGGTGGA CGAAAATCCA GCGATTCCGA GATCACTGGT
    GCCAGTGCCG TGAGTGGACG AGAAGAGGAG CTGACGTTGC ACAGATCGAC CGATTGCATC
    GTCTCCAAAG AACTCGCTTC TTCCTCGGAT AGCGATCTCC TCAGGTCAGC ACCGCCGTGG
    ACGGTGGCTA ACAGGAACCA GAAGTTTCGT TTCTCGCCGG AAAAGGAGAA ATGTCATCAA
    CAGCCTCGAG AGACGCATCG AGAGGAACAT CGCGAGTCGC GACAGCCGCA TCTTCCCGAG
    AAGGAGAAGG ATTCGAGCGG TCTATCAGAC TCCAGCAAGA CAATCTCAAG TCAGGAGGAG
    GAGAAACCAT CGAAAGAAGA ACGAGAGGCA AAGAAGACGC GCGTCAAGCA GAGCCTGATG
    AAACGGGCGC GCTCGGTGGC GATCTTCTCG CTGAAGCTGA AAGAACGTCG CGCCCGAGAG
    GCCGAGCTGA AGGCCAAGGA GGCGGAAAGG GAGGCGAGGT GGCAACAACC GCAGTCTTGT
    GTTGGTGGCG AGCTCTCATG CATACCCATA GAAAAGCTTA TCTCAGTGGA CGACATTGCG
    GCCATGGATA TACGACGAAT GAACCATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07009
    Clone ID Related Accession (Same CDS sequence) XM_011336599.2 , XM_011336599.3
    Accession Version XM_011336599.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3450bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-06
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_039506.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Nov 7, 2018 this sequence version replaced XM_011336599.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Ooceraea biroi Annotation Release 100 Annotation Version :: 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGACGGT GAAAGCGACG AGCAGCGCTT GCTTTCCGAA
    CGCACTGGTT ACGCGACCAC GTCCAGTCAA GCAGACACCC CGACTTTGGC CTCGACCACC
    CATACACCCA GTGGCCCAAC GACACCTAGT GCCGCAGCGG TGCCGAGGAT CGCGGAGACA
    CCACCCATGG CCGTGACACC AGGCAGCGGC GGGAGCAGCA GCGAAACCAG CCCATTCCTA
    CCCGAGAACA ATCTCAATGT CACCCGAGAT ATCCGCAATT CGCCGAGATG TTCCATACCT
    GGTGGTGAAC GAGTTGGAAG ACGCTCGAAG GAGCGATTGG TCAACGAACC GGAAGCATCC
    GGTACCTCTG ACCAGTACAG CCATCATCTG ACAATTGGTC CACACGGCGG CGTGGACTGG
    GTACGTCGAT TAGGTTTAGA GCCTGGTGGA CGAAAATCCA GCGATTCCGA GATCACTGGT
    GCCAGTGCCG TGAGTGGACG AGAAGAGGAG CTGACGTTGC ACAGATCGAC CGATTGCATC
    GTCTCCAAAG AACTCGCTTC TTCCTCGGAT AGCGATCTCC TCAGGTCAGC ACCGCCGTGG
    ACGGTGGCTA ACAGGAACCA GAAGTTTCGT TTCTCGCCGG AAAAGGAGAA ATGTCATCAA
    CAGCCTCGAG AGACGCATCG AGAGGAACAT CGCGAGTCGC GACAGCCGCA TCTTCCCGAG
    AAGGAGAAGG ATTCGAGCGG TCTATCAGAC TCCAGCAAGA CAATCTCAAG TCAGGAGGAG
    GAGAAACCAT CGAAAGAAGA ACGAGAGGCA AAGAAGACGC GCGTCAAGCA GAGCCTGATG
    AAACGGGCGC GCTCGGTGGC GATCTTCTCG CTGAAGCTGA AAGAACGTCG CGCCCGAGAG
    GCCGAGCTGA AGGCCAAGGA GGCGGAAAGG GAGGCGAGGT GGCAACAACC GCAGTCTTGT
    GTTGGTGGCG AGCTCTCATG CATACCCATA GAAAAGCTTA TCTCAGTGGA CGACATTGCG
    GCCATGGATA TACGACGAAT GAACCATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334901.1
    CDS80..3529
    Translation

    Target ORF information:

    RefSeq Version XM_011336599.3
    Organism Ooceraea biroi(clonal raider ant)
    Definition Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336599.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGACGGT GAAAGCGACG AGCAGCGCTT GCTTTCCGAA
    CGCACTGGTT ACGCGACCAC GTCCAGTCAA GCAGACACCC CGACTTTGGC CTCGACCACC
    CATACACCCA GTGGCCCAAC GACACCTAGT GCCGCAGCGG TGCCGAGGAT CGCGGAGACA
    CCACCCATGG CCGTGACACC AGGCAGCGGC GGGAGCAGCA GCGAAACCAG CCCATTCCTA
    CCCGAGAACA ATCTCAATGT CACCCGAGAT ATCCGCAATT CGCCGAGATG TTCCATACCT
    GGTGGTGAAC GAGTTGGAAG ACGCTCGAAG GAGCGATTGG TCAACGAACC GGAAGCATCC
    GGTACCTCTG ACCAGTACAG CCATCATCTG ACAATTGGTC CACACGGCGG CGTGGACTGG
    GTACGTCGAT TAGGTTTAGA GCCTGGTGGA CGAAAATCCA GCGATTCCGA GATCACTGGT
    GCCAGTGCCG TGAGTGGACG AGAAGAGGAG CTGACGTTGC ACAGATCGAC CGATTGCATC
    GTCTCCAAAG AACTCGCTTC TTCCTCGGAT AGCGATCTCC TCAGGTCAGC ACCGCCGTGG
    ACGGTGGCTA ACAGGAACCA GAAGTTTCGT TTCTCGCCGG AAAAGGAGAA ATGTCATCAA
    CAGCCTCGAG AGACGCATCG AGAGGAACAT CGCGAGTCGC GACAGCCGCA TCTTCCCGAG
    AAGGAGAAGG ATTCGAGCGG TCTATCAGAC TCCAGCAAGA CAATCTCAAG TCAGGAGGAG
    GAGAAACCAT CGAAAGAAGA ACGAGAGGCA AAGAAGACGC GCGTCAAGCA GAGCCTGATG
    AAACGGGCGC GCTCGGTGGC GATCTTCTCG CTGAAGCTGA AAGAACGTCG CGCCCGAGAG
    GCCGAGCTGA AGGCCAAGGA GGCGGAAAGG GAGGCGAGGT GGCAACAACC GCAGTCTTGT
    GTTGGTGGCG AGCTCTCATG CATACCCATA GAAAAGCTTA TCTCAGTGGA CGACATTGCG
    GCCATGGATA TACGACGAAT GAACCATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07010
    Clone ID Related Accession (Same CDS sequence) XM_011336600.2 , XM_011336600.3
    Accession Version XM_011336600.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3441bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-01-23
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011925022.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jan 24, 2017 this sequence version replaced XM_011336600.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Cerapachys biroi Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGTATGACGG GGCATTTTCG
    GAACACTTGG AGATGCTGTC GCAACTGGGA TATGTCTGTC TCTTCTCTTC AGCATTTCCG
    TTGGCAGCGA TGGCAGCTTT ACTTGGGAAT CTGCTTGAGC TACGCGGTGA CGCGTTCAAA
    TTGTGTTTCG TGCTTCAACG ACCTTTCGGG CGCAGGGTCT CGAATATCGG CACCTGGCAA
    AACGCTATGG AGGCGATGGG TCTCGTCGCT ATTTTAGTAA ACTGCGCTCT GATCGGACTG
    AGTGGACAGG TGCAACGAAT GTTTCCTGAG ATGTCGGCGA CGCAAACAAT CTTGTTAATT
    GTAGTGCTAG AACATATAAT GCTAGCAATA CGATTCGTGA TTATTTGCGC GATTCCCGAC
    ATACCACATT GGGTCGCCAC GGAGATGGCT AAAGTAGAAT TCTTGAGACG TGAAGCAGTC
    CGAAGATTGT CATCGACCCC GTCACCAGAA CAACAGCCAA CGACAGTGAT AGGGAGATTC
    GTGGTGAGTC CAGCAGACGG TGAAAGCGAC GAGCAGCGCT TGCTTTCCGA ACGCACTGGT
    TACGCGACCA CGTCCAGTCA AGCAGACACC CCGACTTTGG CCTCGACCAC CCATACACCC
    AGTGGCCCAA CGACACCTAG TGCCGCAGCG GTGCCGAGGA TCGCGGAGAC ACCACCCATG
    GCCGTGACAC CAGGCAGCGG CGGGAGCAGC AGCGAAACCA GCCCATTCCT ACCCGAGAAC
    AATCTCAATG TCACCCGAGA TATCCGCAAT TCGCCGAGAT GTTCCATACC TGGTGGTGAA
    CGAGTTGGAA GACGCTCGAA GGAGCGATTG GTCAACGAAC CGGAAGCATC CGGTACCTCT
    GACCAGTACA GCCATCATCT GACAATTGGT CCACACGGCG GCGTGGACTG GGTACGTCGA
    TTAGGTTTAG AGCCTGGTGG ACGAAAATCC AGCGATTCCG AGATCACTGG TGCCAGTGCC
    GTGAGTGGAC GAGAAGAGGA GCTGACGTTG CACAGATCGA CCGATTGCAT CGTCTCCAAA
    GAACTCGCTT CTTCCTCGGA TAGCGATCTC CTCAGGTCAG CACCGCCGTG GACGGTGGCT
    AACAGGAACC AGAAGTTTCG TTTCTCGCCG GAAAAGGAGA AATGTCATCA ACAGCCTCGA
    GAGACGCATC GAGAGGAACA TCGCGAGTCG CGACAGCCGC ATCTTCCCGA GAAGGAGAAG
    GATTCGAGCG GTCTATCAGA CTCCAGCAAG ACAATCTCAA GTCAGGAGGA GGAGAAACCA
    TCGAAAGAAG AACGAGAGGC AAAGAAGACG CGCGTCAAGC AGAGCCTGAT GAAACGGGCG
    CGCTCGGTGG CGATCTTCTC GCTGAAGCTG AAAGAACGTC GCGCCCGAGA GGCCGAGCTG
    AAGGCCAAGG AGGCGGAAAG GGAGGCGAGG TGGCAACAAC CGCAGTCTTG TGTTGGTGGC
    GAGCTCTCAT GCATACCCAT AGAAAAGCTT ATCTCAGTGG ACGACATTGC GGCCATGGAT
    ATACGACGAA TGAACCATTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334902.1
    CDS80..3520
    Translation

    Target ORF information:

    RefSeq Version XM_011336600.2
    Organism Ooceraea biroi(clonal raider ant)
    Definition Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336600.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGTATGACGG GGCATTTTCG
    GAACACTTGG AGATGCTGTC GCAACTGGGA TATGTCTGTC TCTTCTCTTC AGCATTTCCG
    TTGGCAGCGA TGGCAGCTTT ACTTGGGAAT CTGCTTGAGC TACGCGGTGA CGCGTTCAAA
    TTGTGTTTCG TGCTTCAACG ACCTTTCGGG CGCAGGGTCT CGAATATCGG CACCTGGCAA
    AACGCTATGG AGGCGATGGG TCTCGTCGCT ATTTTAGTAA ACTGCGCTCT GATCGGACTG
    AGTGGACAGG TGCAACGAAT GTTTCCTGAG ATGTCGGCGA CGCAAACAAT CTTGTTAATT
    GTAGTGCTAG AACATATAAT GCTAGCAATA CGATTCGTGA TTATTTGCGC GATTCCCGAC
    ATACCACATT GGGTCGCCAC GGAGATGGCT AAAGTAGAAT TCTTGAGACG TGAAGCAGTC
    CGAAGATTGT CATCGACCCC GTCACCAGAA CAACAGCCAA CGACAGTGAT AGGGAGATTC
    GTGGTGAGTC CAGCAGACGG TGAAAGCGAC GAGCAGCGCT TGCTTTCCGA ACGCACTGGT
    TACGCGACCA CGTCCAGTCA AGCAGACACC CCGACTTTGG CCTCGACCAC CCATACACCC
    AGTGGCCCAA CGACACCTAG TGCCGCAGCG GTGCCGAGGA TCGCGGAGAC ACCACCCATG
    GCCGTGACAC CAGGCAGCGG CGGGAGCAGC AGCGAAACCA GCCCATTCCT ACCCGAGAAC
    AATCTCAATG TCACCCGAGA TATCCGCAAT TCGCCGAGAT GTTCCATACC TGGTGGTGAA
    CGAGTTGGAA GACGCTCGAA GGAGCGATTG GTCAACGAAC CGGAAGCATC CGGTACCTCT
    GACCAGTACA GCCATCATCT GACAATTGGT CCACACGGCG GCGTGGACTG GGTACGTCGA
    TTAGGTTTAG AGCCTGGTGG ACGAAAATCC AGCGATTCCG AGATCACTGG TGCCAGTGCC
    GTGAGTGGAC GAGAAGAGGA GCTGACGTTG CACAGATCGA CCGATTGCAT CGTCTCCAAA
    GAACTCGCTT CTTCCTCGGA TAGCGATCTC CTCAGGTCAG CACCGCCGTG GACGGTGGCT
    AACAGGAACC AGAAGTTTCG TTTCTCGCCG GAAAAGGAGA AATGTCATCA ACAGCCTCGA
    GAGACGCATC GAGAGGAACA TCGCGAGTCG CGACAGCCGC ATCTTCCCGA GAAGGAGAAG
    GATTCGAGCG GTCTATCAGA CTCCAGCAAG ACAATCTCAA GTCAGGAGGA GGAGAAACCA
    TCGAAAGAAG AACGAGAGGC AAAGAAGACG CGCGTCAAGC AGAGCCTGAT GAAACGGGCG
    CGCTCGGTGG CGATCTTCTC GCTGAAGCTG AAAGAACGTC GCGCCCGAGA GGCCGAGCTG
    AAGGCCAAGG AGGCGGAAAG GGAGGCGAGG TGGCAACAAC CGCAGTCTTG TGTTGGTGGC
    GAGCTCTCAT GCATACCCAT AGAAAAGCTT ATCTCAGTGG ACGACATTGC GGCCATGGAT
    ATACGACGAA TGAACCATTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07010
    Clone ID Related Accession (Same CDS sequence) XM_011336600.2 , XM_011336600.3
    Accession Version XM_011336600.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3441bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-06
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_039506.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Nov 7, 2018 this sequence version replaced XM_011336600.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Ooceraea biroi Annotation Release 100 Annotation Version :: 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGTATGACGG GGCATTTTCG
    GAACACTTGG AGATGCTGTC GCAACTGGGA TATGTCTGTC TCTTCTCTTC AGCATTTCCG
    TTGGCAGCGA TGGCAGCTTT ACTTGGGAAT CTGCTTGAGC TACGCGGTGA CGCGTTCAAA
    TTGTGTTTCG TGCTTCAACG ACCTTTCGGG CGCAGGGTCT CGAATATCGG CACCTGGCAA
    AACGCTATGG AGGCGATGGG TCTCGTCGCT ATTTTAGTAA ACTGCGCTCT GATCGGACTG
    AGTGGACAGG TGCAACGAAT GTTTCCTGAG ATGTCGGCGA CGCAAACAAT CTTGTTAATT
    GTAGTGCTAG AACATATAAT GCTAGCAATA CGATTCGTGA TTATTTGCGC GATTCCCGAC
    ATACCACATT GGGTCGCCAC GGAGATGGCT AAAGTAGAAT TCTTGAGACG TGAAGCAGTC
    CGAAGATTGT CATCGACCCC GTCACCAGAA CAACAGCCAA CGACAGTGAT AGGGAGATTC
    GTGGTGAGTC CAGCAGACGG TGAAAGCGAC GAGCAGCGCT TGCTTTCCGA ACGCACTGGT
    TACGCGACCA CGTCCAGTCA AGCAGACACC CCGACTTTGG CCTCGACCAC CCATACACCC
    AGTGGCCCAA CGACACCTAG TGCCGCAGCG GTGCCGAGGA TCGCGGAGAC ACCACCCATG
    GCCGTGACAC CAGGCAGCGG CGGGAGCAGC AGCGAAACCA GCCCATTCCT ACCCGAGAAC
    AATCTCAATG TCACCCGAGA TATCCGCAAT TCGCCGAGAT GTTCCATACC TGGTGGTGAA
    CGAGTTGGAA GACGCTCGAA GGAGCGATTG GTCAACGAAC CGGAAGCATC CGGTACCTCT
    GACCAGTACA GCCATCATCT GACAATTGGT CCACACGGCG GCGTGGACTG GGTACGTCGA
    TTAGGTTTAG AGCCTGGTGG ACGAAAATCC AGCGATTCCG AGATCACTGG TGCCAGTGCC
    GTGAGTGGAC GAGAAGAGGA GCTGACGTTG CACAGATCGA CCGATTGCAT CGTCTCCAAA
    GAACTCGCTT CTTCCTCGGA TAGCGATCTC CTCAGGTCAG CACCGCCGTG GACGGTGGCT
    AACAGGAACC AGAAGTTTCG TTTCTCGCCG GAAAAGGAGA AATGTCATCA ACAGCCTCGA
    GAGACGCATC GAGAGGAACA TCGCGAGTCG CGACAGCCGC ATCTTCCCGA GAAGGAGAAG
    GATTCGAGCG GTCTATCAGA CTCCAGCAAG ACAATCTCAA GTCAGGAGGA GGAGAAACCA
    TCGAAAGAAG AACGAGAGGC AAAGAAGACG CGCGTCAAGC AGAGCCTGAT GAAACGGGCG
    CGCTCGGTGG CGATCTTCTC GCTGAAGCTG AAAGAACGTC GCGCCCGAGA GGCCGAGCTG
    AAGGCCAAGG AGGCGGAAAG GGAGGCGAGG TGGCAACAAC CGCAGTCTTG TGTTGGTGGC
    GAGCTCTCAT GCATACCCAT AGAAAAGCTT ATCTCAGTGG ACGACATTGC GGCCATGGAT
    ATACGACGAA TGAACCATTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334902.1
    CDS79..3519
    Translation

    Target ORF information:

    RefSeq Version XM_011336600.3
    Organism Ooceraea biroi(clonal raider ant)
    Definition Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336600.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGTATGACGG GGCATTTTCG
    GAACACTTGG AGATGCTGTC GCAACTGGGA TATGTCTGTC TCTTCTCTTC AGCATTTCCG
    TTGGCAGCGA TGGCAGCTTT ACTTGGGAAT CTGCTTGAGC TACGCGGTGA CGCGTTCAAA
    TTGTGTTTCG TGCTTCAACG ACCTTTCGGG CGCAGGGTCT CGAATATCGG CACCTGGCAA
    AACGCTATGG AGGCGATGGG TCTCGTCGCT ATTTTAGTAA ACTGCGCTCT GATCGGACTG
    AGTGGACAGG TGCAACGAAT GTTTCCTGAG ATGTCGGCGA CGCAAACAAT CTTGTTAATT
    GTAGTGCTAG AACATATAAT GCTAGCAATA CGATTCGTGA TTATTTGCGC GATTCCCGAC
    ATACCACATT GGGTCGCCAC GGAGATGGCT AAAGTAGAAT TCTTGAGACG TGAAGCAGTC
    CGAAGATTGT CATCGACCCC GTCACCAGAA CAACAGCCAA CGACAGTGAT AGGGAGATTC
    GTGGTGAGTC CAGCAGACGG TGAAAGCGAC GAGCAGCGCT TGCTTTCCGA ACGCACTGGT
    TACGCGACCA CGTCCAGTCA AGCAGACACC CCGACTTTGG CCTCGACCAC CCATACACCC
    AGTGGCCCAA CGACACCTAG TGCCGCAGCG GTGCCGAGGA TCGCGGAGAC ACCACCCATG
    GCCGTGACAC CAGGCAGCGG CGGGAGCAGC AGCGAAACCA GCCCATTCCT ACCCGAGAAC
    AATCTCAATG TCACCCGAGA TATCCGCAAT TCGCCGAGAT GTTCCATACC TGGTGGTGAA
    CGAGTTGGAA GACGCTCGAA GGAGCGATTG GTCAACGAAC CGGAAGCATC CGGTACCTCT
    GACCAGTACA GCCATCATCT GACAATTGGT CCACACGGCG GCGTGGACTG GGTACGTCGA
    TTAGGTTTAG AGCCTGGTGG ACGAAAATCC AGCGATTCCG AGATCACTGG TGCCAGTGCC
    GTGAGTGGAC GAGAAGAGGA GCTGACGTTG CACAGATCGA CCGATTGCAT CGTCTCCAAA
    GAACTCGCTT CTTCCTCGGA TAGCGATCTC CTCAGGTCAG CACCGCCGTG GACGGTGGCT
    AACAGGAACC AGAAGTTTCG TTTCTCGCCG GAAAAGGAGA AATGTCATCA ACAGCCTCGA
    GAGACGCATC GAGAGGAACA TCGCGAGTCG CGACAGCCGC ATCTTCCCGA GAAGGAGAAG
    GATTCGAGCG GTCTATCAGA CTCCAGCAAG ACAATCTCAA GTCAGGAGGA GGAGAAACCA
    TCGAAAGAAG AACGAGAGGC AAAGAAGACG CGCGTCAAGC AGAGCCTGAT GAAACGGGCG
    CGCTCGGTGG CGATCTTCTC GCTGAAGCTG AAAGAACGTC GCGCCCGAGA GGCCGAGCTG
    AAGGCCAAGG AGGCGGAAAG GGAGGCGAGG TGGCAACAAC CGCAGTCTTG TGTTGGTGGC
    GAGCTCTCAT GCATACCCAT AGAAAAGCTT ATCTCAGTGG ACGACATTGC GGCCATGGAT
    ATACGACGAA TGAACCATTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07011
    Clone ID Related Accession (Same CDS sequence) XM_011336601.3 , XM_011336601.2
    Accession Version XM_011336601.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3396bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-06
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_039506.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Nov 7, 2018 this sequence version replaced XM_011336601.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Ooceraea biroi Annotation Release 100 Annotation Version :: 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGATAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334903.1
    CDS79..3474
    Translation

    Target ORF information:

    RefSeq Version XM_011336601.3
    Organism Ooceraea biroi(clonal raider ant)
    Definition Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336601.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGATAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07011
    Clone ID Related Accession (Same CDS sequence) XM_011336601.3 , XM_011336601.2
    Accession Version XM_011336601.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3396bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-01-23
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011925022.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jan 24, 2017 this sequence version replaced XM_011336601.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Cerapachys biroi Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGATAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334903.1
    CDS80..3475
    Translation

    Target ORF information:

    RefSeq Version XM_011336601.2
    Organism Ooceraea biroi(clonal raider ant)
    Definition Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336601.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGATAT
    GACGGGGCAT TTTCGGAACA CTTGGAGATG CTGTCGCAAC TGGGATATGT CTGTCTCTTC
    TCTTCAGCAT TTCCGTTGGC AGCGATGGCA GCTTTACTTG GGAATCTGCT TGAGCTACGC
    GGTGACGCGT TCAAATTGTG TTTCGTGCTT CAACGACCTT TCGGGCGCAG GGTCTCGAAT
    ATCGGCACCT GGCAAAACGC TATGGAGGCG ATGGGTCTCG TCGCTATTTT AGTAAACTGC
    GCTCTGATCG GACTGAGTGG ACAGGTGCAA CGAATGTTTC CTGAGATGTC GGCGACGCAA
    ACAATCTTGT TAATTGTAGT GCTAGAACAT ATAATGCTAG CAATACGATT CGTGATTATT
    TGCGCGATTC CCGACATACC ACATTGGGTC GCCACGGAGA TGGCTAAAGT AGAATTCTTG
    AGACGTGAAG CAGTCCGAAG ATTGTCATCG ACCCCGTCAC CAGAACAACA GCCAACGACA
    GTGATAGGGA GATTCGTGGT GAGTCCAGCA GACGGTGAAA GCGACGAGCA GCGCTTGCTT
    TCCGAACGCA CTGGTTACGC GACCACGTCC AGTCAAGCAG ACACCCCGAC TTTGGCCTCG
    ACCACCCATA CACCCAGTGG CCCAACGACA CCTAGTGCCG CAGCGGTGCC GAGGATCGCG
    GAGACACCAC CCATGGCCGT GACACCAGGC AGCGGCGGGA GCAGCAGCGA AACCAGCCCA
    TTCCTACCCG AGAACAATCT CAATGTCACC CGAGATATCC GCAATTCGCC GAGATGTTCC
    ATACCTGGTG GTGAACGAGT TGGAAGACGC TCGAAGGAGC GATTGGTCAA CGAACCGGAA
    GCATCCGGTA CCTCTGACCA GTACAGCCAT CATCTGACAA TTGGTCCACA CGGCGGCGTG
    GACTGGGTAC GTCGATTAGG TTTAGAGCCT GGTGGACGAA AATCCAGCGA TTCCGAGATC
    ACTGGTGCCA GTGCCGTGAG TGGACGAGAA GAGGAGCTGA CGTTGCACAG ATCGACCGAT
    TGCATCGTCT CCAAAGAACT CGCTTCTTCC TCGGATAGCG ATCTCCTCAG GTCAGCACCG
    CCGTGGACGG TGGCTAACAG GAACCAGAAG TTTCGTTTCT CGCCGGAAAA GGAGAAATGT
    CATCAACAGC CTCGAGAGAC GCATCGAGAG GAACATCGCG AGTCGCGACA GCCGCATCTT
    CCCGAGAAGG AGAAGGATTC GAGCGGTCTA TCAGACTCCA GCAAGACAAT CTCAAGTCAG
    GAGGAGGAGA AACCATCGAA AGAAGAACGA GAGGCAAAGA AGACGCGCGT CAAGCAGAGC
    CTGATGAAAC GGGCGCGCTC GGTGGCGATC TTCTCGCTGA AGCTGAAAGA ACGTCGCGCC
    CGAGAGGCCG AGCTGAAGGC CAAGGAGGCG GAAAGGGAGG CGAGGTGGCA ACAACCGCAG
    TCTTGTGTTG GTGGCGAGCT CTCATGCATA CCCATAGAAA AGCTTATCTC AGTGGACGAC
    ATTGCGGCCA TGGATATACG ACGAATGAAC CATTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07012
    Clone ID Related Accession (Same CDS sequence) XM_011336603.3 , XM_011336603.2
    Accession Version XM_011336603.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3474bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-06
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_039506.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Nov 7, 2018 this sequence version replaced XM_011336603.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Ooceraea biroi Annotation Release 100 Annotation Version :: 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGGGAGA TTCGTGGTGA GTCCAGCAGA CGGTGAAAGC
    GACGAGCAGC GCTTGCTTTC CGAACGCACT GGTTACGCGA CCACGTCCAG TCAAGCAGAC
    ACCCCGACTT TGGCCTCGAC CACCCATACA CCCAGTGGCC CAACGACACC TAGTGCCGCA
    GCGGTGCCGA GGATCGCGGA GACACCACCC ATGGCCGTGA CACCAGGCAG CGGCGGGAGC
    AGCAGCGAAA CCAGCCCATT CCTACCCGAG AACAATCTCA ATGTCACCCG AGATATCCGC
    AATTCGCCGA GATGTTCCAT ACCTGGTGGT GAACGAGTTG GAAGACGCTC GAAGGAGCGA
    TTGGTCAACG AACCGGAAGC ATCCGGTACC TCTGACCAGT ACAGCCATCA TCTGACAATT
    GGTCCACACG GCGGCGTGGA CTGGGTACGT CGATTAGGTT TAGAGCCTGG TGGACGAAAA
    TCCAGCGATT CCGAGATCAC TGGTGCCAGT GCCGTGAGTG GACGAGAAGA GGAGCTGACG
    TTGCACAGAT CGACCGATTG CATCGTCTCC AAAGAACTCG CTTCTTCCTC GGATAGCGAT
    CTCCTCAGGT CAGCACCGCC GTGGACGGTG GCTAACAGGA ACCAGAAGTT TCGTTTCTCG
    CCGGAAAAGG AGAAATGTCA TCAACAGCCT CGAGAGACGC ATCGAGAGGA ACATCGCGAG
    TCGCGACAGC CGCATCTTCC CGAGAAGGAG AAGGATTCGA GCGGTCTATC AGACTCCAGC
    AAGACAATCT CAAGTCAGGA GGAGGAGAAA CCATCGAAAG AAGAACGAGA GGCAAAGAAG
    ACGCGCGTCA AGCAGAGCCT GATGAAACGG GCGCGCTCGG TGGCGATCTT CTCGCTGAAG
    CTGAAAGAAC GTCGCGCCCG AGAGGCCGAG CTGAAGGCCA AGGAGGCGGA AAGGGAGGCG
    AGGTGGCAAC AACCGCAGTC TTGTGTTGGT GGCGAGCTCT CATGCATACC CATAGAAAAG
    CTTATCTCAG TGGACGACAT TGCGGCCATG GATATACGAC GAATGAACCA TTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334905.1
    CDS173..3646
    Translation

    Target ORF information:

    RefSeq Version XM_011336603.3
    Organism Ooceraea biroi(clonal raider ant)
    Definition Ooceraea biroi anoctamin-8 (LOC105277893), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336603.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGGGAGA TTCGTGGTGA GTCCAGCAGA CGGTGAAAGC
    GACGAGCAGC GCTTGCTTTC CGAACGCACT GGTTACGCGA CCACGTCCAG TCAAGCAGAC
    ACCCCGACTT TGGCCTCGAC CACCCATACA CCCAGTGGCC CAACGACACC TAGTGCCGCA
    GCGGTGCCGA GGATCGCGGA GACACCACCC ATGGCCGTGA CACCAGGCAG CGGCGGGAGC
    AGCAGCGAAA CCAGCCCATT CCTACCCGAG AACAATCTCA ATGTCACCCG AGATATCCGC
    AATTCGCCGA GATGTTCCAT ACCTGGTGGT GAACGAGTTG GAAGACGCTC GAAGGAGCGA
    TTGGTCAACG AACCGGAAGC ATCCGGTACC TCTGACCAGT ACAGCCATCA TCTGACAATT
    GGTCCACACG GCGGCGTGGA CTGGGTACGT CGATTAGGTT TAGAGCCTGG TGGACGAAAA
    TCCAGCGATT CCGAGATCAC TGGTGCCAGT GCCGTGAGTG GACGAGAAGA GGAGCTGACG
    TTGCACAGAT CGACCGATTG CATCGTCTCC AAAGAACTCG CTTCTTCCTC GGATAGCGAT
    CTCCTCAGGT CAGCACCGCC GTGGACGGTG GCTAACAGGA ACCAGAAGTT TCGTTTCTCG
    CCGGAAAAGG AGAAATGTCA TCAACAGCCT CGAGAGACGC ATCGAGAGGA ACATCGCGAG
    TCGCGACAGC CGCATCTTCC CGAGAAGGAG AAGGATTCGA GCGGTCTATC AGACTCCAGC
    AAGACAATCT CAAGTCAGGA GGAGGAGAAA CCATCGAAAG AAGAACGAGA GGCAAAGAAG
    ACGCGCGTCA AGCAGAGCCT GATGAAACGG GCGCGCTCGG TGGCGATCTT CTCGCTGAAG
    CTGAAAGAAC GTCGCGCCCG AGAGGCCGAG CTGAAGGCCA AGGAGGCGGA AAGGGAGGCG
    AGGTGGCAAC AACCGCAGTC TTGTGTTGGT GGCGAGCTCT CATGCATACC CATAGAAAAG
    CTTATCTCAG TGGACGACAT TGCGGCCATG GATATACGAC GAATGAACCA TTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OOo07012
    Clone ID Related Accession (Same CDS sequence) XM_011336603.3 , XM_011336603.2
    Accession Version XM_011336603.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3474bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-01-23
    Organism Ooceraea biroi(clonal raider ant)
    Product anoctamin-8 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011925022.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jan 24, 2017 this sequence version replaced XM_011336603.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Cerapachys biroi Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGGGAGA TTCGTGGTGA GTCCAGCAGA CGGTGAAAGC
    GACGAGCAGC GCTTGCTTTC CGAACGCACT GGTTACGCGA CCACGTCCAG TCAAGCAGAC
    ACCCCGACTT TGGCCTCGAC CACCCATACA CCCAGTGGCC CAACGACACC TAGTGCCGCA
    GCGGTGCCGA GGATCGCGGA GACACCACCC ATGGCCGTGA CACCAGGCAG CGGCGGGAGC
    AGCAGCGAAA CCAGCCCATT CCTACCCGAG AACAATCTCA ATGTCACCCG AGATATCCGC
    AATTCGCCGA GATGTTCCAT ACCTGGTGGT GAACGAGTTG GAAGACGCTC GAAGGAGCGA
    TTGGTCAACG AACCGGAAGC ATCCGGTACC TCTGACCAGT ACAGCCATCA TCTGACAATT
    GGTCCACACG GCGGCGTGGA CTGGGTACGT CGATTAGGTT TAGAGCCTGG TGGACGAAAA
    TCCAGCGATT CCGAGATCAC TGGTGCCAGT GCCGTGAGTG GACGAGAAGA GGAGCTGACG
    TTGCACAGAT CGACCGATTG CATCGTCTCC AAAGAACTCG CTTCTTCCTC GGATAGCGAT
    CTCCTCAGGT CAGCACCGCC GTGGACGGTG GCTAACAGGA ACCAGAAGTT TCGTTTCTCG
    CCGGAAAAGG AGAAATGTCA TCAACAGCCT CGAGAGACGC ATCGAGAGGA ACATCGCGAG
    TCGCGACAGC CGCATCTTCC CGAGAAGGAG AAGGATTCGA GCGGTCTATC AGACTCCAGC
    AAGACAATCT CAAGTCAGGA GGAGGAGAAA CCATCGAAAG AAGAACGAGA GGCAAAGAAG
    ACGCGCGTCA AGCAGAGCCT GATGAAACGG GCGCGCTCGG TGGCGATCTT CTCGCTGAAG
    CTGAAAGAAC GTCGCGCCCG AGAGGCCGAG CTGAAGGCCA AGGAGGCGGA AAGGGAGGCG
    AGGTGGCAAC AACCGCAGTC TTGTGTTGGT GGCGAGCTCT CATGCATACC CATAGAAAAG
    CTTATCTCAG TGGACGACAT TGCGGCCATG GATATACGAC GAATGAACCA TTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011334905.1
    CDS152..3625
    Translation

    Target ORF information:

    RefSeq Version XM_011336603.2
    Organism Ooceraea biroi(clonal raider ant)
    Definition Cerapachys biroi anoctamin-8 (LOC105277893), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011336603.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCAGGCG GCGAGGGGTC CCCGATCAAT CTCCTCGACC ACCACCACCA TCAGCAGCAC 
    CGTCGATCGT CGACCGCCAC CGCCGCCGCC GCCGCCACGT CCACGTCCAC GACGGACGAG
    TGCGCGAACG GCGACGATGT CAGGACCGCG GCATCGACGA CCACTGGCGC GACCTTCAGC
    AGCACGATGG CGAGCGCCCT GGCGGGCGAC GGTCTCCGGC GCAGAAAGGT CATACACGCG
    GCCAAGGAGA CTCTTGACAA GGCGTCCCGT CTTCTGAGAC GAAAAATACC ATGTACAGGC
    CATTTAATGA CCCCCCGCCG CCTATGGATA CAAAAGGTTC CTACTCAGGA ATGCGACGTA
    GTCATGATGT TCCCCAGCGG GGCGAACGAC GAGACCCTGA TGTGGCTCCT AGGACGGCTT
    CGGGCTGGAA CCCCGGGGCT GATAGTTCAC GTGCGACATC ACACTTCGTC GGACAGTTAC
    GGGTTTTACA TTACGGCACC ATTTGGCGTT TTGCTCAAAG CTGCCGAGGA AGTGCATCTA
    CCCAAGGCTC TGCGACAGGA ATTAGGCGGC GGACTCAAGG AGTTCGTCGG TTCCGAAGCG
    AATTGCTTCG AAGGGTGCGA CGACGAGATC CGATTCTTCA CCACCCAGGA AAAGCAATCC
    CTGGTTTTGC ACCTGCTTCA CACCTTGAGG GCTGGCCCCC ACGATCTTCA CAGTCTGCCT
    GGTCTTAAGT TAGTCGAGGG TCAGGCAATC GTTCCAAAGT GCATTTCGTC CGGTATTATT
    TCTCAGGTCT TCCCTCTTCA TGAATTACCT GCGTTAGAGA AACTGCAACG GACTTGGGTT
    CGCGCATTTC TCAGCCCTCA GCCCTTGGAC GACATTTGTA AATATTTCGG AGTGAAAATC
    ACCATGTACT TCGCCTGGCT CGGTCACTAC ACCACCGCTT TGATCGTTCC AGCTGCAGTG
    GGTGCCATAT ACTGGGTCGG CATCATCGGC AGGAACCAAG CGGTGGAAGA CGTGGCGTAT
    GTTCTGTTTT CGGTGTTCAA CGTGATATGG GCTACCGTAT ACTTGGAGAC ATGGAAAAGG
    AGGGGCGCGG AATTGGCGTA CAGGTGGGGC ACTTTGGATC AGAGGGACGA TTTATTGGTC
    GAGCCTAGAC CTCTGTTTAC AGGAACTCTG GAAGTTTCAC CGGTAACGGG TAGGCTGGAA
    CCAACGTATC CCAGGTGGCG ACGGAATATG TTTCGATACT TCGTGAGCGT GCCTATCATC
    GCAGTCTGTC TATTCTTCGT CTTCATCGTT ATGATTCTTA GCTTACAAAT ACAGGACTGG
    TGGGACGCGC ATCTTGAATC TGGGGGCTAC GGATTTTGGC TTAGTTACGT GCCAAAGGTG
    TTGCTCGCGG TGGTTATTGC GTTGATGGAT GAGGCGTACT TCAAGGTTGC GGTCTGGTTG
    AATGATTTGG AAAACTATCG ACTAGACACC GAGTACGAGA ATCATCTGAT CTACAAAGTG
    GCACTGTTTC AGTTTGTGAA CTCCTTCCTA TCGCTGTTTT ACATCGCCTT CTATCTTCAA
    GATCACGAGA GACTCAAGGA GCAATTGGCG GCTTTGCTCA TAGCTCGACA AGTGATTGGC
    AACCTGAAGG AATCCGCGGT GCCGTATCTA ATCGAACAAT TGCGGCTGGC GCGGTTGAGC
    TTCGAGCTGT TCGGCGCCCT GAGTCCCAGC GAGGCGAGGC CACCCCCGGG TCAGGAGAGC
    GATGAAGCGC AAGCTGGTAA GGACAACGAG GAGAAGGAGG ATCAGCGGGC AGACAGCGGC
    AAATCGAAGC AACCGCGCAA CGTCAGCCAA GCAGAACTTG AGAGTTCCCT CTACAGAGTA
    GGGCATCCCA CTAATTCTCT ACTTAGTGAC GTTACGTTCA AGGTATCGAC CACAAAGGAA
    TGTATAACGA TCAAGTATGA CGGGGCATTT TCGGAACACT TGGAGATGCT GTCGCAACTG
    GGATATGTCT GTCTCTTCTC TTCAGCATTT CCGTTGGCAG CGATGGCAGC TTTACTTGGG
    AATCTGCTTG AGCTACGCGG TGACGCGTTC AAATTGTGTT TCGTGCTTCA ACGACCTTTC
    GGGCGCAGGG TCTCGAATAT CGGCACCTGG CAAAACGCTA TGGAGGCGAT GGGTCTCGTC
    GCTATTTTAG TAAACTGCGC TCTGATCGGA CTGAGTGGAC AGGTGCAACG AATGTTTCCT
    GAGATGTCGG CGACGCAAAC AATCTTGTTA ATTGTAGTGC TAGAACATAT AATGCTAGCA
    ATACGATTCG TGATTATTTG CGCGATTCCC GACATACCAC ATTGGGTCGC CACGGAGATG
    GCTAAAGTAG AATTCTTGAG ACGTGAAGCA GTCCGAAGAT TGTCATCGAC CCCGTCACCA
    GAACAACAGC CAACGACAGT GATAGGGAGA TTCGTGGTGA GTCCAGCAGA CGGTGAAAGC
    GACGAGCAGC GCTTGCTTTC CGAACGCACT GGTTACGCGA CCACGTCCAG TCAAGCAGAC
    ACCCCGACTT TGGCCTCGAC CACCCATACA CCCAGTGGCC CAACGACACC TAGTGCCGCA
    GCGGTGCCGA GGATCGCGGA GACACCACCC ATGGCCGTGA CACCAGGCAG CGGCGGGAGC
    AGCAGCGAAA CCAGCCCATT CCTACCCGAG AACAATCTCA ATGTCACCCG AGATATCCGC
    AATTCGCCGA GATGTTCCAT ACCTGGTGGT GAACGAGTTG GAAGACGCTC GAAGGAGCGA
    TTGGTCAACG AACCGGAAGC ATCCGGTACC TCTGACCAGT ACAGCCATCA TCTGACAATT
    GGTCCACACG GCGGCGTGGA CTGGGTACGT CGATTAGGTT TAGAGCCTGG TGGACGAAAA
    TCCAGCGATT CCGAGATCAC TGGTGCCAGT GCCGTGAGTG GACGAGAAGA GGAGCTGACG
    TTGCACAGAT CGACCGATTG CATCGTCTCC AAAGAACTCG CTTCTTCCTC GGATAGCGAT
    CTCCTCAGGT CAGCACCGCC GTGGACGGTG GCTAACAGGA ACCAGAAGTT TCGTTTCTCG
    CCGGAAAAGG AGAAATGTCA TCAACAGCCT CGAGAGACGC ATCGAGAGGA ACATCGCGAG
    TCGCGACAGC CGCATCTTCC CGAGAAGGAG AAGGATTCGA GCGGTCTATC AGACTCCAGC
    AAGACAATCT CAAGTCAGGA GGAGGAGAAA CCATCGAAAG AAGAACGAGA GGCAAAGAAG
    ACGCGCGTCA AGCAGAGCCT GATGAAACGG GCGCGCTCGG TGGCGATCTT CTCGCTGAAG
    CTGAAAGAAC GTCGCGCCCG AGAGGCCGAG CTGAAGGCCA AGGAGGCGGA AAGGGAGGCG
    AGGTGGCAAC AACCGCAGTC TTGTGTTGGT GGCGAGCTCT CATGCATACC CATAGAAAAG
    CTTATCTCAG TGGACGACAT TGCGGCCATG GATATACGAC GAATGAACCA TTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.