Itga9 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

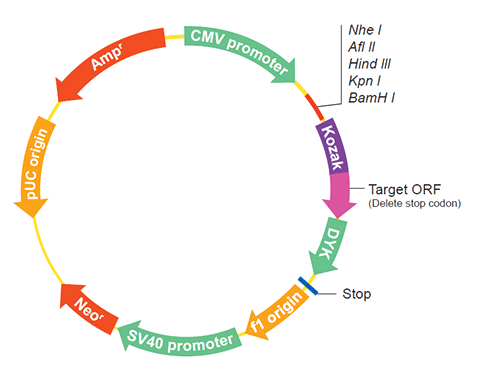
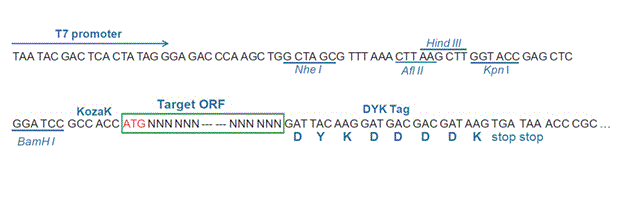
The following Itga9 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Itga9 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa129660 XM_029555637.1
Latest version!
Nannospalax galili integrin subunit alpha 9 (Itga9), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
ONa16331 XM_008855995.3
Latest version!
Nannospalax galili integrin subunit alpha 9 (Itga9), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00
View Old Accession Versions >>
ONa16331 XM_008855995.2 Nannospalax galili integrin subunit alpha 9 (Itga9), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa129660
    Clone ID Related Accession (Same CDS sequence) XM_029555637.1
    Accession Version XM_029555637.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2211bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product integrin alpha-9 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008328216.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGGGCTCTT ACTTCGGCTC CTCCTTATGT GCAGTTGACC TGAACATGGA TGGCCTCTCT 
    GACCTGCTGG TGGGGGCCCC CATGTTTTCT GAGATCAGAG ATGAGGGCCA GGTCACCGTC
    TACCTCAGCA AAGGAAATGG AGCCCTCGAG GAACAGCTGG CCCTCACGGG AGATGGCGCC
    TACAATGCGC ACTTTGGGGA GAGCATCGCT AGCCTGGGTG ATCTTGATGA TGATGGGTTC
    CCAGATGTGG CTGTTGGTGC ACCCAAGGAG GATGACTTTG CTGGAGCAGT CTATATCTAT
    CATGGGGATG TCAGTGGGAT AGTCCCCCAG TACTCAATGA AACTGTCTGG GAGGAAGATA
    AACCCAGTCC TGCGGATGTT TGGGCAGTCC ATATCAGGAG GCATTGATAT GGATGGAAAT
    GGCTATCCTG ATGTCACTGT TGGAGCCTTC CTGTCTGACA GCGTGGTTCT TCTCAGGGCC
    AGACCTGTCA TCACAGTGGA TGTCTCCATC TTCCTCCCAG TCTCCATCAA CATCACTGCG
    CCTCAGTGTC ATGATGGCCA GCAGCCTGTG AACTGCCTGA ATGTCATTGC CTGCTTTCGG
    TTCCATGGCA AACATGTGCC AGGAGAAATC GGTCTGAACT ACGTTCTGAC GGCTGATGTG
    GCCCAAAAGG AGAAGGGCCA GCTGCCTAGG GTCTATTTTG TGTTGCTGGG AGAGACTGTA
    GGCCAGGTCT CAGAGAAGCT GCAGCTGACC CACATGGAGG AGACGTGTCG TCACTACGTG
    GCCCATGTCA AGCGGAGGGT CCAGGATGTC ATCAGCCCCA TCGTGTTTGA AGCTGCCTAC
    AGCCTCGGTG TACATGTCAC TGGTGAGGAG GAGCGGGAGC TGCCGGCTCT GACTCCAGTG
    CTCCGCTGGA AGAAAGGACA AAAGATCGCC CAGAAGAATC AGACGATTTT TGAAAGGAAT
    TGCCAATCTG AGGACTGCGC TGCTGACCTG CAGCTTCAGG GTAAACTGTT GCTCTCCAGT
    ATTGATGAGA AAACCCCCTA TCTAGCTTTG GGAGCTGTGA AGAATATCTC TCTGAACATC
    TCCATCTCCA ACCTTGGGGA TGATGCCTAT GATGCCAATG TGTCCTTCAA TGTTTCCCGG
    GAACTCTTCT TCATCAACAT GTGGCAGAAG GAGGAAATGG GCATTTCCTG TGAGCTTCTA
    GAATCAGACT TCCTCAAATG CAGCGTGGGG TTTCCCTTCA TGCGGTCAAA GTCAAAGTAT
    GAATTCAGCG TAATCTTTGA TACCAGCCAC CTGTCTGGGG AGGAGGATGT TCTCAGCTTC
    ATTGTTTCTG CTCAGAGTGG CAACGTGGAA CGCTCTGAAG CCCTACATGA CAACACTCTC
    ACGCTGATGA TGCCCCTGGT GCACGAAGTG GACACGTCCA TCACTGGAAT CGTGTCCCCA
    ACCTCCTTCG TGTACGGCGA GTCTGTGGAT GCATCCAACT TCATTCAGCT GGATGATCAG
    GAGTGTCACT TCCAACCCCT CAACATCACC CTTCAGGTCT ACAACATGGG CCCGAGTACT
    CTCCCTGGGT CAGCCGTCAG TATCTCCTTC CCCAGTCGAC TGTCACCAGG TGGTGCAGAG
    ATGTTTCAGG TCCAGGAGAT GGTGGTGAAC CAAGAGAAAG GAAACTGCTC TTTCCAGAGA
    AACCCAACCC CCTGCATCAT CCCTCAGGAA CAAGAAAATA TCTTCCACAC AATATTTGCT
    TTTTTTACAA AGTCGGGAAG AAAAGTATTG GACTGTGAAA AACCAGGAAG TCCCTGCCTA
    ACCATGCACT GTAACCTTAG CGCTCTTCCT AAAGAAGAAA GCCGTGCCAT CGACATTTAC
    ATGCTGCTGA ACACAGAGAT ACTGAAGAAG GACAGTTCCT CTGTCATCCA GTTCATGGCT
    CGAGCCAAGG TGAAAGTGGA CCCTGCCCTG AAGGTGGTGG AGATAGCTAA TGGGAACCCA
    GAACAGATGC TGGTGGTCTT CGAGGCCTTG CACAATCTGG AACCCCGTGG CTACGTTGTG
    GGGTGGATCA TTGCCATCAG CTTGCTGGTA GGAATCCTCA TCTTTCTGCT GCTGGCTGTG
    TTGCTCTGGA AGATGGGCTT CTTTCGCCGA AGGTACAAAG AAATCATTGA AGCCGAGAAG
    AACCGAAAAG AGAATGAAGA GAGTTGGGAC TGGGTCCAGA AAAACCAGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029411497.1
    CDS66..2276
    Translation

    Target ORF information:

    RefSeq Version XM_029555637.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili integrin subunit alpha 9 (Itga9), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029555637.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGGGCTCTT ACTTCGGCTC CTCCTTATGT GCAGTTGACC TGAACATGGA TGGCCTCTCT 
    GACCTGCTGG TGGGGGCCCC CATGTTTTCT GAGATCAGAG ATGAGGGCCA GGTCACCGTC
    TACCTCAGCA AAGGAAATGG AGCCCTCGAG GAACAGCTGG CCCTCACGGG AGATGGCGCC
    TACAATGCGC ACTTTGGGGA GAGCATCGCT AGCCTGGGTG ATCTTGATGA TGATGGGTTC
    CCAGATGTGG CTGTTGGTGC ACCCAAGGAG GATGACTTTG CTGGAGCAGT CTATATCTAT
    CATGGGGATG TCAGTGGGAT AGTCCCCCAG TACTCAATGA AACTGTCTGG GAGGAAGATA
    AACCCAGTCC TGCGGATGTT TGGGCAGTCC ATATCAGGAG GCATTGATAT GGATGGAAAT
    GGCTATCCTG ATGTCACTGT TGGAGCCTTC CTGTCTGACA GCGTGGTTCT TCTCAGGGCC
    AGACCTGTCA TCACAGTGGA TGTCTCCATC TTCCTCCCAG TCTCCATCAA CATCACTGCG
    CCTCAGTGTC ATGATGGCCA GCAGCCTGTG AACTGCCTGA ATGTCATTGC CTGCTTTCGG
    TTCCATGGCA AACATGTGCC AGGAGAAATC GGTCTGAACT ACGTTCTGAC GGCTGATGTG
    GCCCAAAAGG AGAAGGGCCA GCTGCCTAGG GTCTATTTTG TGTTGCTGGG AGAGACTGTA
    GGCCAGGTCT CAGAGAAGCT GCAGCTGACC CACATGGAGG AGACGTGTCG TCACTACGTG
    GCCCATGTCA AGCGGAGGGT CCAGGATGTC ATCAGCCCCA TCGTGTTTGA AGCTGCCTAC
    AGCCTCGGTG TACATGTCAC TGGTGAGGAG GAGCGGGAGC TGCCGGCTCT GACTCCAGTG
    CTCCGCTGGA AGAAAGGACA AAAGATCGCC CAGAAGAATC AGACGATTTT TGAAAGGAAT
    TGCCAATCTG AGGACTGCGC TGCTGACCTG CAGCTTCAGG GTAAACTGTT GCTCTCCAGT
    ATTGATGAGA AAACCCCCTA TCTAGCTTTG GGAGCTGTGA AGAATATCTC TCTGAACATC
    TCCATCTCCA ACCTTGGGGA TGATGCCTAT GATGCCAATG TGTCCTTCAA TGTTTCCCGG
    GAACTCTTCT TCATCAACAT GTGGCAGAAG GAGGAAATGG GCATTTCCTG TGAGCTTCTA
    GAATCAGACT TCCTCAAATG CAGCGTGGGG TTTCCCTTCA TGCGGTCAAA GTCAAAGTAT
    GAATTCAGCG TAATCTTTGA TACCAGCCAC CTGTCTGGGG AGGAGGATGT TCTCAGCTTC
    ATTGTTTCTG CTCAGAGTGG CAACGTGGAA CGCTCTGAAG CCCTACATGA CAACACTCTC
    ACGCTGATGA TGCCCCTGGT GCACGAAGTG GACACGTCCA TCACTGGAAT CGTGTCCCCA
    ACCTCCTTCG TGTACGGCGA GTCTGTGGAT GCATCCAACT TCATTCAGCT GGATGATCAG
    GAGTGTCACT TCCAACCCCT CAACATCACC CTTCAGGTCT ACAACATGGG CCCGAGTACT
    CTCCCTGGGT CAGCCGTCAG TATCTCCTTC CCCAGTCGAC TGTCACCAGG TGGTGCAGAG
    ATGTTTCAGG TCCAGGAGAT GGTGGTGAAC CAAGAGAAAG GAAACTGCTC TTTCCAGAGA
    AACCCAACCC CCTGCATCAT CCCTCAGGAA CAAGAAAATA TCTTCCACAC AATATTTGCT
    TTTTTTACAA AGTCGGGAAG AAAAGTATTG GACTGTGAAA AACCAGGAAG TCCCTGCCTA
    ACCATGCACT GTAACCTTAG CGCTCTTCCT AAAGAAGAAA GCCGTGCCAT CGACATTTAC
    ATGCTGCTGA ACACAGAGAT ACTGAAGAAG GACAGTTCCT CTGTCATCCA GTTCATGGCT
    CGAGCCAAGG TGAAAGTGGA CCCTGCCCTG AAGGTGGTGG AGATAGCTAA TGGGAACCCA
    GAACAGATGC TGGTGGTCTT CGAGGCCTTG CACAATCTGG AACCCCGTGG CTACGTTGTG
    GGGTGGATCA TTGCCATCAG CTTGCTGGTA GGAATCCTCA TCTTTCTGCT GCTGGCTGTG
    TTGCTCTGGA AGATGGGCTT CTTTCGCCGA AGGTACAAAG AAATCATTGA AGCCGAGAAG
    AACCGAAAAG AGAATGAAGA GAGTTGGGAC TGGGTCCAGA AAAACCAGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa16331
    Clone ID Related Accession (Same CDS sequence) XM_008855995.3 , XM_008855995.2
    Accession Version XM_008855995.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3087bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product integrin alpha-9 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008328216.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008855995.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGGCGCCG GGGGGCTCCG AGCGCTGCTG CTGGCGCTGG TGGCCGCGGG GGTCCCCGCC 
    GACGCCTACA ACCTCGACAC GCAGCACCCG GTGCGCTTCC AGGGCCCCGC GGGCTCCTTC
    TTCGGCTACG CGGTGCTGGA GCACTTCCAC GACAACACGC GCTGGGTCCT TGTGGGTGCA
    CCCAAGGCAG ATTCCAAATA CAGCCCTTCA GTGAAGTCCC CTGGAGCTGT GTTTAAGTGT
    CGTGTCCACA CCAACCCTGA CCGGAGATGC ACCGAACTGG ACATGGCTCG AGGGAGGAGT
    CGTGGCACGC CCTGTGGGAA GACCTGCCGG GAAGACCGTG ATGAAGAGTG GATGGGAGTC
    AGCCTGGCCC GGCAGCCCAA GGCAGATGGC CGTGTTCTGG CCTGTGCCCA TCGCTGGAAG
    AACATTTACT ATGAAACGGA TCACATCCTG CCCCACGGGT TCTGCTACCT CATCCCGTCC
    AACCTCCAGG CCAAAGGCAA GGTGCTGATC CCCTGCTACG AAGAGTATAA GAAGAAATAC
    GGGGAAGAGC ATGGCTCCTG CCAGGCCGGG ATAGCAGGCT TCTTCACCGA GGAACTGGTG
    ATAATGGGAG CCCCAGGCTC ATTTTATTGG GCTGGGACAG TCAAGGTGCT GAACCTCACG
    GACAACACGT ATTTTAAACT GAATGATGAA GCGATCATGA ACAGGCGGTA TACCTACCTG
    GGCTATGCAG TGACTGCTGG CCACTTCTCT CACCCATCTA CCACTGATGT GGTAGGAGGT
    GCTCCACAGG ATGAAGGCAT TGGAAAGGTT TATATTTTTA GAGCTGACCG AAGATCAGGT
    ACCTTAATAA AGATTTTTCA GGCATCAGGT AAAAAGATGG GCTCTTACTT CGGCTCCTCC
    TTATGTGCAG TTGACCTGAA CATGGATGGC CTCTCTGACC TGCTGGTGGG GGCCCCCATG
    TTTTCTGAGA TCAGAGATGA GGGCCAGGTC ACCGTCTACC TCAGCAAAGG AAATGGAGCC
    CTCGAGGAAC AGCTGGCCCT CACGGGAGAT GGCGCCTACA ATGCGCACTT TGGGGAGAGC
    ATCGCTAGCC TGGGTGATCT TGATGATGAT GGGTTCCCAG ATGTGGCTGT TGGTGCACCC
    AAGGAGGATG ACTTTGCTGG AGCAGTCTAT ATCTATCATG GGGATGTCAG TGGGATAGTC
    CCCCAGTACT CAATGAAACT GTCTGGGAGG AAGATAAACC CAGTCCTGCG GATGTTTGGG
    CAGTCCATAT CAGGAGGCAT TGATATGGAT GGAAATGGCT ATCCTGATGT CACTGTTGGA
    GCCTTCCTGT CTGACAGCGT GGTTCTTCTC AGGGCCAGAC CTGTCATCAC AGTGGATGTC
    TCCATCTTCC TCCCAGTCTC CATCAACATC ACTGCGCCTC AGTGTCATGA TGGCCAGCAG
    CCTGTGAACT GCCTGAATGT CATTGCCTGC TTTCGGTTCC ATGGCAAACA TGTGCCAGGA
    GAAATCGGTC TGAACTACGT TCTGACGGCT GATGTGGCCC AAAAGGAGAA GGGCCAGCTG
    CCTAGGGTCT ATTTTGTGTT GCTGGGAGAG ACTGTAGGCC AGGTCTCAGA GAAGCTGCAG
    CTGACCCACA TGGAGGAGAC GTGTCGTCAC TACGTGGCCC ATGTCAAGCG GAGGGTCCAG
    GATGTCATCA GCCCCATCGT GTTTGAAGCT GCCTACAGCC TCGGTGTACA TGTCACTGGT
    GAGGAGGAGC GGGAGCTGCC GGCTCTGACT CCAGTGCTCC GCTGGAAGAA AGGACAAAAG
    ATCGCCCAGA AGAATCAGAC GATTTTTGAA AGGAATTGCC AATCTGAGGA CTGCGCTGCT
    GACCTGCAGC TTCAGGGTAA ACTGTTGCTC TCCAGTATTG ATGAGAAAAC CCCCTATCTA
    GCTTTGGGAG CTGTGAAGAA TATCTCTCTG AACATCTCCA TCTCCAACCT TGGGGATGAT
    GCCTATGATG CCAATGTGTC CTTCAATGTT TCCCGGGAAC TCTTCTTCAT CAACATGTGG
    CAGAAGGAGG AAATGGGCAT TTCCTGTGAG CTTCTAGAAT CAGACTTCCT CAAATGCAGC
    GTGGGGTTTC CCTTCATGCG GTCAAAGTCA AAGTATGAAT TCAGCGTAAT CTTTGATACC
    AGCCACCTGT CTGGGGAGGA GGATGTTCTC AGCTTCATTG TTTCTGCTCA GAGTGGCAAC
    GTGGAACGCT CTGAAGCCCT ACATGACAAC ACTCTCACGC TGATGATGCC CCTGGTGCAC
    GAAGTGGACA CGTCCATCAC TGGAATCGTG TCCCCAACCT CCTTCGTGTA CGGCGAGTCT
    GTGGATGCAT CCAACTTCAT TCAGCTGGAT GATCAGGAGT GTCACTTCCA ACCCCTCAAC
    ATCACCCTTC AGGTCTACAA CATGGGCCCG AGTACTCTCC CTGGGTCAGC CGTCAGTATC
    TCCTTCCCCA GTCGACTGTC ACCAGGTGGT GCAGAGATGT TTCAGGTCCA GGAGATGGTG
    GTGAACCAAG AGAAAGGAAA CTGCTCTTTC CAGAGAAACC CAACCCCCTG CATCATCCCT
    CAGGAACAAG AAAATATCTT CCACACAATA TTTGCTTTTT TTACAAAGTC GGGAAGAAAA
    GTATTGGACT GTGAAAAACC AGGAAGTCCC TGCCTAACCA TGCACTGTAA CCTTAGCGCT
    CTTCCTAAAG AAGAAAGCCG TGCCATCGAC ATTTACATGC TGCTGAACAC AGAGATACTG
    AAGAAGGACA GTTCCTCTGT CATCCAGTTC ATGGCTCGAG CCAAGGTGAA AGTGGACCCT
    GCCCTGAAGG TGGTGGAGAT AGCTAATGGG AACCCAGAAC AGATGCTGGT GGTCTTCGAG
    GCCTTGCACA ATCTGGAACC CCGTGGCTAC GTTGTGGGGT GGATCATTGC CATCAGCTTG
    CTGGTAGGAA TCCTCATCTT TCTGCTGCTG GCTGTGTTGC TCTGGAAGAT GGGCTTCTTT
    CGCCGAAGGT ACAAAGAAAT CATTGAAGCC GAGAAGAACC GAAAAGAGAA TGAAGAGAGT
    TGGGACTGGG TCCAGAAAAA CCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008854217.1
    CDS264..3350
    Translation

    Target ORF information:

    RefSeq Version XM_008855995.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili integrin subunit alpha 9 (Itga9), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008855995.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGGCGCCG GGGGGCTCCG AGCGCTGCTG CTGGCGCTGG TGGCCGCGGG GGTCCCCGCC 
    GACGCCTACA ACCTCGACAC GCAGCACCCG GTGCGCTTCC AGGGCCCCGC GGGCTCCTTC
    TTCGGCTACG CGGTGCTGGA GCACTTCCAC GACAACACGC GCTGGGTCCT TGTGGGTGCA
    CCCAAGGCAG ATTCCAAATA CAGCCCTTCA GTGAAGTCCC CTGGAGCTGT GTTTAAGTGT
    CGTGTCCACA CCAACCCTGA CCGGAGATGC ACCGAACTGG ACATGGCTCG AGGGAGGAGT
    CGTGGCACGC CCTGTGGGAA GACCTGCCGG GAAGACCGTG ATGAAGAGTG GATGGGAGTC
    AGCCTGGCCC GGCAGCCCAA GGCAGATGGC CGTGTTCTGG CCTGTGCCCA TCGCTGGAAG
    AACATTTACT ATGAAACGGA TCACATCCTG CCCCACGGGT TCTGCTACCT CATCCCGTCC
    AACCTCCAGG CCAAAGGCAA GGTGCTGATC CCCTGCTACG AAGAGTATAA GAAGAAATAC
    GGGGAAGAGC ATGGCTCCTG CCAGGCCGGG ATAGCAGGCT TCTTCACCGA GGAACTGGTG
    ATAATGGGAG CCCCAGGCTC ATTTTATTGG GCTGGGACAG TCAAGGTGCT GAACCTCACG
    GACAACACGT ATTTTAAACT GAATGATGAA GCGATCATGA ACAGGCGGTA TACCTACCTG
    GGCTATGCAG TGACTGCTGG CCACTTCTCT CACCCATCTA CCACTGATGT GGTAGGAGGT
    GCTCCACAGG ATGAAGGCAT TGGAAAGGTT TATATTTTTA GAGCTGACCG AAGATCAGGT
    ACCTTAATAA AGATTTTTCA GGCATCAGGT AAAAAGATGG GCTCTTACTT CGGCTCCTCC
    TTATGTGCAG TTGACCTGAA CATGGATGGC CTCTCTGACC TGCTGGTGGG GGCCCCCATG
    TTTTCTGAGA TCAGAGATGA GGGCCAGGTC ACCGTCTACC TCAGCAAAGG AAATGGAGCC
    CTCGAGGAAC AGCTGGCCCT CACGGGAGAT GGCGCCTACA ATGCGCACTT TGGGGAGAGC
    ATCGCTAGCC TGGGTGATCT TGATGATGAT GGGTTCCCAG ATGTGGCTGT TGGTGCACCC
    AAGGAGGATG ACTTTGCTGG AGCAGTCTAT ATCTATCATG GGGATGTCAG TGGGATAGTC
    CCCCAGTACT CAATGAAACT GTCTGGGAGG AAGATAAACC CAGTCCTGCG GATGTTTGGG
    CAGTCCATAT CAGGAGGCAT TGATATGGAT GGAAATGGCT ATCCTGATGT CACTGTTGGA
    GCCTTCCTGT CTGACAGCGT GGTTCTTCTC AGGGCCAGAC CTGTCATCAC AGTGGATGTC
    TCCATCTTCC TCCCAGTCTC CATCAACATC ACTGCGCCTC AGTGTCATGA TGGCCAGCAG
    CCTGTGAACT GCCTGAATGT CATTGCCTGC TTTCGGTTCC ATGGCAAACA TGTGCCAGGA
    GAAATCGGTC TGAACTACGT TCTGACGGCT GATGTGGCCC AAAAGGAGAA GGGCCAGCTG
    CCTAGGGTCT ATTTTGTGTT GCTGGGAGAG ACTGTAGGCC AGGTCTCAGA GAAGCTGCAG
    CTGACCCACA TGGAGGAGAC GTGTCGTCAC TACGTGGCCC ATGTCAAGCG GAGGGTCCAG
    GATGTCATCA GCCCCATCGT GTTTGAAGCT GCCTACAGCC TCGGTGTACA TGTCACTGGT
    GAGGAGGAGC GGGAGCTGCC GGCTCTGACT CCAGTGCTCC GCTGGAAGAA AGGACAAAAG
    ATCGCCCAGA AGAATCAGAC GATTTTTGAA AGGAATTGCC AATCTGAGGA CTGCGCTGCT
    GACCTGCAGC TTCAGGGTAA ACTGTTGCTC TCCAGTATTG ATGAGAAAAC CCCCTATCTA
    GCTTTGGGAG CTGTGAAGAA TATCTCTCTG AACATCTCCA TCTCCAACCT TGGGGATGAT
    GCCTATGATG CCAATGTGTC CTTCAATGTT TCCCGGGAAC TCTTCTTCAT CAACATGTGG
    CAGAAGGAGG AAATGGGCAT TTCCTGTGAG CTTCTAGAAT CAGACTTCCT CAAATGCAGC
    GTGGGGTTTC CCTTCATGCG GTCAAAGTCA AAGTATGAAT TCAGCGTAAT CTTTGATACC
    AGCCACCTGT CTGGGGAGGA GGATGTTCTC AGCTTCATTG TTTCTGCTCA GAGTGGCAAC
    GTGGAACGCT CTGAAGCCCT ACATGACAAC ACTCTCACGC TGATGATGCC CCTGGTGCAC
    GAAGTGGACA CGTCCATCAC TGGAATCGTG TCCCCAACCT CCTTCGTGTA CGGCGAGTCT
    GTGGATGCAT CCAACTTCAT TCAGCTGGAT GATCAGGAGT GTCACTTCCA ACCCCTCAAC
    ATCACCCTTC AGGTCTACAA CATGGGCCCG AGTACTCTCC CTGGGTCAGC CGTCAGTATC
    TCCTTCCCCA GTCGACTGTC ACCAGGTGGT GCAGAGATGT TTCAGGTCCA GGAGATGGTG
    GTGAACCAAG AGAAAGGAAA CTGCTCTTTC CAGAGAAACC CAACCCCCTG CATCATCCCT
    CAGGAACAAG AAAATATCTT CCACACAATA TTTGCTTTTT TTACAAAGTC GGGAAGAAAA
    GTATTGGACT GTGAAAAACC AGGAAGTCCC TGCCTAACCA TGCACTGTAA CCTTAGCGCT
    CTTCCTAAAG AAGAAAGCCG TGCCATCGAC ATTTACATGC TGCTGAACAC AGAGATACTG
    AAGAAGGACA GTTCCTCTGT CATCCAGTTC ATGGCTCGAG CCAAGGTGAA AGTGGACCCT
    GCCCTGAAGG TGGTGGAGAT AGCTAATGGG AACCCAGAAC AGATGCTGGT GGTCTTCGAG
    GCCTTGCACA ATCTGGAACC CCGTGGCTAC GTTGTGGGGT GGATCATTGC CATCAGCTTG
    CTGGTAGGAA TCCTCATCTT TCTGCTGCTG GCTGTGTTGC TCTGGAAGAT GGGCTTCTTT
    CGCCGAAGGT ACAAAGAAAT CATTGAAGCC GAGAAGAACC GAAAAGAGAA TGAAGAGAGT
    TGGGACTGGG TCCAGAAAAA CCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa16331
    Clone ID Related Accession (Same CDS sequence) XM_008855995.3 , XM_008855995.2
    Accession Version XM_008855995.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3087bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product integrin alpha-9
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008328216.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008855995.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGGCGCCG GGGGGCTCCG AGCGCTGCTG CTGGCGCTGG TGGCCGCGGG GGTCCCCGCC 
    GACGCCTACA ACCTCGACAC GCAGCACCCG GTGCGCTTCC AGGGCCCCGC GGGCTCCTTC
    TTCGGCTACG CGGTGCTGGA GCACTTCCAC GACAACACGC GCTGGGTCCT TGTGGGTGCA
    CCCAAGGCAG ATTCCAAATA CAGCCCTTCA GTGAAGTCCC CTGGAGCTGT GTTTAAGTGT
    CGTGTCCACA CCAACCCTGA CCGGAGATGC ACCGAACTGG ACATGGCTCG AGGGAGGAGT
    CGTGGCACGC CCTGTGGGAA GACCTGCCGG GAAGACCGTG ATGAAGAGTG GATGGGAGTC
    AGCCTGGCCC GGCAGCCCAA GGCAGATGGC CGTGTTCTGG CCTGTGCCCA TCGCTGGAAG
    AACATTTACT ATGAAACGGA TCACATCCTG CCCCACGGGT TCTGCTACCT CATCCCGTCC
    AACCTCCAGG CCAAAGGCAA GGTGCTGATC CCCTGCTACG AAGAGTATAA GAAGAAATAC
    GGGGAAGAGC ATGGCTCCTG CCAGGCCGGG ATAGCAGGCT TCTTCACCGA GGAACTGGTG
    ATAATGGGAG CCCCAGGCTC ATTTTATTGG GCTGGGACAG TCAAGGTGCT GAACCTCACG
    GACAACACGT ATTTTAAACT GAATGATGAA GCGATCATGA ACAGGCGGTA TACCTACCTG
    GGCTATGCAG TGACTGCTGG CCACTTCTCT CACCCATCTA CCACTGATGT GGTAGGAGGT
    GCTCCACAGG ATGAAGGCAT TGGAAAGGTT TATATTTTTA GAGCTGACCG AAGATCAGGT
    ACCTTAATAA AGATTTTTCA GGCATCAGGT AAAAAGATGG GCTCTTACTT CGGCTCCTCC
    TTATGTGCAG TTGACCTGAA CATGGATGGC CTCTCTGACC TGCTGGTGGG GGCCCCCATG
    TTTTCTGAGA TCAGAGATGA GGGCCAGGTC ACCGTCTACC TCAGCAAAGG AAATGGAGCC
    CTCGAGGAAC AGCTGGCCCT CACGGGAGAT GGCGCCTACA ATGCGCACTT TGGGGAGAGC
    ATCGCTAGCC TGGGTGATCT TGATGATGAT GGGTTCCCAG ATGTGGCTGT TGGTGCACCC
    AAGGAGGATG ACTTTGCTGG AGCAGTCTAT ATCTATCATG GGGATGTCAG TGGGATAGTC
    CCCCAGTACT CAATGAAACT GTCTGGGAGG AAGATAAACC CAGTCCTGCG GATGTTTGGG
    CAGTCCATAT CAGGAGGCAT TGATATGGAT GGAAATGGCT ATCCTGATGT CACTGTTGGA
    GCCTTCCTGT CTGACAGCGT GGTTCTTCTC AGGGCCAGAC CTGTCATCAC AGTGGATGTC
    TCCATCTTCC TCCCAGTCTC CATCAACATC ACTGCGCCTC AGTGTCATGA TGGCCAGCAG
    CCTGTGAACT GCCTGAATGT CATTGCCTGC TTTCGGTTCC ATGGCAAACA TGTGCCAGGA
    GAAATCGGTC TGAACTACGT TCTGACGGCT GATGTGGCCC AAAAGGAGAA GGGCCAGCTG
    CCTAGGGTCT ATTTTGTGTT GCTGGGAGAG ACTGTAGGCC AGGTCTCAGA GAAGCTGCAG
    CTGACCCACA TGGAGGAGAC GTGTCGTCAC TACGTGGCCC ATGTCAAGCG GAGGGTCCAG
    GATGTCATCA GCCCCATCGT GTTTGAAGCT GCCTACAGCC TCGGTGTACA TGTCACTGGT
    GAGGAGGAGC GGGAGCTGCC GGCTCTGACT CCAGTGCTCC GCTGGAAGAA AGGACAAAAG
    ATCGCCCAGA AGAATCAGAC GATTTTTGAA AGGAATTGCC AATCTGAGGA CTGCGCTGCT
    GACCTGCAGC TTCAGGGTAA ACTGTTGCTC TCCAGTATTG ATGAGAAAAC CCCCTATCTA
    GCTTTGGGAG CTGTGAAGAA TATCTCTCTG AACATCTCCA TCTCCAACCT TGGGGATGAT
    GCCTATGATG CCAATGTGTC CTTCAATGTT TCCCGGGAAC TCTTCTTCAT CAACATGTGG
    CAGAAGGAGG AAATGGGCAT TTCCTGTGAG CTTCTAGAAT CAGACTTCCT CAAATGCAGC
    GTGGGGTTTC CCTTCATGCG GTCAAAGTCA AAGTATGAAT TCAGCGTAAT CTTTGATACC
    AGCCACCTGT CTGGGGAGGA GGATGTTCTC AGCTTCATTG TTTCTGCTCA GAGTGGCAAC
    GTGGAACGCT CTGAAGCCCT ACATGACAAC ACTCTCACGC TGATGATGCC CCTGGTGCAC
    GAAGTGGACA CGTCCATCAC TGGAATCGTG TCCCCAACCT CCTTCGTGTA CGGCGAGTCT
    GTGGATGCAT CCAACTTCAT TCAGCTGGAT GATCAGGAGT GTCACTTCCA ACCCCTCAAC
    ATCACCCTTC AGGTCTACAA CATGGGCCCG AGTACTCTCC CTGGGTCAGC CGTCAGTATC
    TCCTTCCCCA GTCGACTGTC ACCAGGTGGT GCAGAGATGT TTCAGGTCCA GGAGATGGTG
    GTGAACCAAG AGAAAGGAAA CTGCTCTTTC CAGAGAAACC CAACCCCCTG CATCATCCCT
    CAGGAACAAG AAAATATCTT CCACACAATA TTTGCTTTTT TTACAAAGTC GGGAAGAAAA
    GTATTGGACT GTGAAAAACC AGGAAGTCCC TGCCTAACCA TGCACTGTAA CCTTAGCGCT
    CTTCCTAAAG AAGAAAGCCG TGCCATCGAC ATTTACATGC TGCTGAACAC AGAGATACTG
    AAGAAGGACA GTTCCTCTGT CATCCAGTTC ATGGCTCGAG CCAAGGTGAA AGTGGACCCT
    GCCCTGAAGG TGGTGGAGAT AGCTAATGGG AACCCAGAAC AGATGCTGGT GGTCTTCGAG
    GCCTTGCACA ATCTGGAACC CCGTGGCTAC GTTGTGGGGT GGATCATTGC CATCAGCTTG
    CTGGTAGGAA TCCTCATCTT TCTGCTGCTG GCTGTGTTGC TCTGGAAGAT GGGCTTCTTT
    CGCCGAAGGT ACAAAGAAAT CATTGAAGCC GAGAAGAACC GAAAAGAGAA TGAAGAGAGT
    TGGGACTGGG TCCAGAAAAA CCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008854217.1
    CDS84..3170
    Translation

    Target ORF information:

    RefSeq Version XM_008855995.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili integrin subunit alpha 9 (Itga9), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008855995.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGGCGCCG GGGGGCTCCG AGCGCTGCTG CTGGCGCTGG TGGCCGCGGG GGTCCCCGCC 
    GACGCCTACA ACCTCGACAC GCAGCACCCG GTGCGCTTCC AGGGCCCCGC GGGCTCCTTC
    TTCGGCTACG CGGTGCTGGA GCACTTCCAC GACAACACGC GCTGGGTCCT TGTGGGTGCA
    CCCAAGGCAG ATTCCAAATA CAGCCCTTCA GTGAAGTCCC CTGGAGCTGT GTTTAAGTGT
    CGTGTCCACA CCAACCCTGA CCGGAGATGC ACCGAACTGG ACATGGCTCG AGGGAGGAGT
    CGTGGCACGC CCTGTGGGAA GACCTGCCGG GAAGACCGTG ATGAAGAGTG GATGGGAGTC
    AGCCTGGCCC GGCAGCCCAA GGCAGATGGC CGTGTTCTGG CCTGTGCCCA TCGCTGGAAG
    AACATTTACT ATGAAACGGA TCACATCCTG CCCCACGGGT TCTGCTACCT CATCCCGTCC
    AACCTCCAGG CCAAAGGCAA GGTGCTGATC CCCTGCTACG AAGAGTATAA GAAGAAATAC
    GGGGAAGAGC ATGGCTCCTG CCAGGCCGGG ATAGCAGGCT TCTTCACCGA GGAACTGGTG
    ATAATGGGAG CCCCAGGCTC ATTTTATTGG GCTGGGACAG TCAAGGTGCT GAACCTCACG
    GACAACACGT ATTTTAAACT GAATGATGAA GCGATCATGA ACAGGCGGTA TACCTACCTG
    GGCTATGCAG TGACTGCTGG CCACTTCTCT CACCCATCTA CCACTGATGT GGTAGGAGGT
    GCTCCACAGG ATGAAGGCAT TGGAAAGGTT TATATTTTTA GAGCTGACCG AAGATCAGGT
    ACCTTAATAA AGATTTTTCA GGCATCAGGT AAAAAGATGG GCTCTTACTT CGGCTCCTCC
    TTATGTGCAG TTGACCTGAA CATGGATGGC CTCTCTGACC TGCTGGTGGG GGCCCCCATG
    TTTTCTGAGA TCAGAGATGA GGGCCAGGTC ACCGTCTACC TCAGCAAAGG AAATGGAGCC
    CTCGAGGAAC AGCTGGCCCT CACGGGAGAT GGCGCCTACA ATGCGCACTT TGGGGAGAGC
    ATCGCTAGCC TGGGTGATCT TGATGATGAT GGGTTCCCAG ATGTGGCTGT TGGTGCACCC
    AAGGAGGATG ACTTTGCTGG AGCAGTCTAT ATCTATCATG GGGATGTCAG TGGGATAGTC
    CCCCAGTACT CAATGAAACT GTCTGGGAGG AAGATAAACC CAGTCCTGCG GATGTTTGGG
    CAGTCCATAT CAGGAGGCAT TGATATGGAT GGAAATGGCT ATCCTGATGT CACTGTTGGA
    GCCTTCCTGT CTGACAGCGT GGTTCTTCTC AGGGCCAGAC CTGTCATCAC AGTGGATGTC
    TCCATCTTCC TCCCAGTCTC CATCAACATC ACTGCGCCTC AGTGTCATGA TGGCCAGCAG
    CCTGTGAACT GCCTGAATGT CATTGCCTGC TTTCGGTTCC ATGGCAAACA TGTGCCAGGA
    GAAATCGGTC TGAACTACGT TCTGACGGCT GATGTGGCCC AAAAGGAGAA GGGCCAGCTG
    CCTAGGGTCT ATTTTGTGTT GCTGGGAGAG ACTGTAGGCC AGGTCTCAGA GAAGCTGCAG
    CTGACCCACA TGGAGGAGAC GTGTCGTCAC TACGTGGCCC ATGTCAAGCG GAGGGTCCAG
    GATGTCATCA GCCCCATCGT GTTTGAAGCT GCCTACAGCC TCGGTGTACA TGTCACTGGT
    GAGGAGGAGC GGGAGCTGCC GGCTCTGACT CCAGTGCTCC GCTGGAAGAA AGGACAAAAG
    ATCGCCCAGA AGAATCAGAC GATTTTTGAA AGGAATTGCC AATCTGAGGA CTGCGCTGCT
    GACCTGCAGC TTCAGGGTAA ACTGTTGCTC TCCAGTATTG ATGAGAAAAC CCCCTATCTA
    GCTTTGGGAG CTGTGAAGAA TATCTCTCTG AACATCTCCA TCTCCAACCT TGGGGATGAT
    GCCTATGATG CCAATGTGTC CTTCAATGTT TCCCGGGAAC TCTTCTTCAT CAACATGTGG
    CAGAAGGAGG AAATGGGCAT TTCCTGTGAG CTTCTAGAAT CAGACTTCCT CAAATGCAGC
    GTGGGGTTTC CCTTCATGCG GTCAAAGTCA AAGTATGAAT TCAGCGTAAT CTTTGATACC
    AGCCACCTGT CTGGGGAGGA GGATGTTCTC AGCTTCATTG TTTCTGCTCA GAGTGGCAAC
    GTGGAACGCT CTGAAGCCCT ACATGACAAC ACTCTCACGC TGATGATGCC CCTGGTGCAC
    GAAGTGGACA CGTCCATCAC TGGAATCGTG TCCCCAACCT CCTTCGTGTA CGGCGAGTCT
    GTGGATGCAT CCAACTTCAT TCAGCTGGAT GATCAGGAGT GTCACTTCCA ACCCCTCAAC
    ATCACCCTTC AGGTCTACAA CATGGGCCCG AGTACTCTCC CTGGGTCAGC CGTCAGTATC
    TCCTTCCCCA GTCGACTGTC ACCAGGTGGT GCAGAGATGT TTCAGGTCCA GGAGATGGTG
    GTGAACCAAG AGAAAGGAAA CTGCTCTTTC CAGAGAAACC CAACCCCCTG CATCATCCCT
    CAGGAACAAG AAAATATCTT CCACACAATA TTTGCTTTTT TTACAAAGTC GGGAAGAAAA
    GTATTGGACT GTGAAAAACC AGGAAGTCCC TGCCTAACCA TGCACTGTAA CCTTAGCGCT
    CTTCCTAAAG AAGAAAGCCG TGCCATCGAC ATTTACATGC TGCTGAACAC AGAGATACTG
    AAGAAGGACA GTTCCTCTGT CATCCAGTTC ATGGCTCGAG CCAAGGTGAA AGTGGACCCT
    GCCCTGAAGG TGGTGGAGAT AGCTAATGGG AACCCAGAAC AGATGCTGGT GGTCTTCGAG
    GCCTTGCACA ATCTGGAACC CCGTGGCTAC GTTGTGGGGT GGATCATTGC CATCAGCTTG
    CTGGTAGGAA TCCTCATCTT TCTGCTGCTG GCTGTGTTGC TCTGGAAGAT GGGCTTCTTT
    CGCCGAAGGT ACAAAGAAAT CATTGAAGCC GAGAAGAACC GAAAAGAGAA TGAAGAGAGT
    TGGGACTGGG TCCAGAAAAA CCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.