Diaph1 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

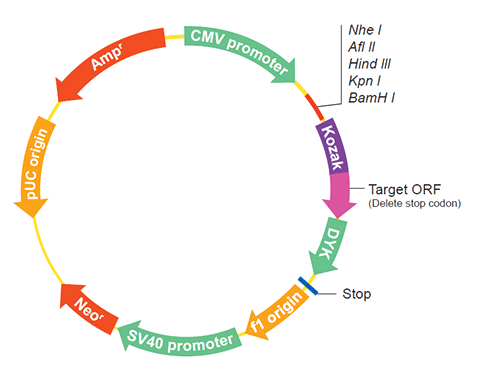
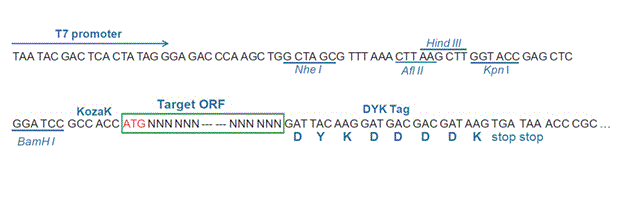
The following Diaph1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Diaph1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa19097 XM_017798805.2
Latest version!
Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
ONa19098 XM_017798806.2
Latest version!
Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
ONa19099 XM_008835505.3
Latest version!
Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
View Old Accession Versions >>
ONa19099 XM_008835505.2 Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
ONa19097 XM_017798805.1 Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
ONa19098 XM_017798806.1 Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa19097
    Clone ID Related Accession (Same CDS sequence) XM_017798805.1 , XM_017798805.2
    Accession Version XM_017798805.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3798bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein diaphanous homolog 1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008340429.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGCTA CGATAGCCGG AATCAGCATG AGATTATTCG CTGCTTGAAA
    GCTTTCATGA ACAACAAGTT TGGAATCAAA ACCATGTTGG AGACAGAAGA AGGAATCCTA
    CTGCTGGTCA GAGCCATGGA TCCTGCTGTT CCCAATATGA TGATTGACGC AGCTAAGCTG
    CTTTCTGCGC TTTGTATCCT TCCACAGCCA GAGGACATGA ATGAAAGAGT TTTGGAGGCA
    ATGACAGAGA GAGCTGAAAT GGATGAGGTG GAACGTTTCC AGCCACTACT GGATGGATTA
    AAAAGTGGCA CCTCTATTGC ACTCAAGGTG GGATGCCTAC AACTGATCAA TGCTCTCATC
    ACTCCAGCTG AAGAACTTGA CTTCCGAATT CACATCCGAA GTGAACTGAT GCGCTTGGGA
    CTGCATCAAG TGTTGCAGGA GCTTCGAGAG ATTGACAATG ATGATATGAG AGTGCAACTA
    ACTGTATTTG ATGAACAAGG GGATGAGGAT ATCTTTGATT TGAAAGGACG GCTGGATGAC
    ATTCGCATGG AGATGGATGA CTTTGGTGAA GTCTTCCAGA TTCTTTTAAA CACAGTGAAA
    GATTCAAAGG CAGAGCCACA TTTCCTGTCC ATCCTGCAAC ATCTGCTGTT GGTCCGAAAT
    GACTATGAGG CTAGGCCACA GTACTATAAA TTGATTGAAG AATGTATTTC TCAAATAGTT
    CTACACAGGA ATGGTACTGA TCCTGACTTC AAGTGCCGGC ATCTCCAGAT TGATATTGAG
    GGACTGATTG ATCAAATGAT TGATAAAACA AAAGTGGAAA AATCAGAGGC CAAAGCTACA
    GAACTGGAGA AAAAGCTGGA CTCAGAGCTA ACAGCCCGTC ATGAGTTACA AGTAGAAATG
    AAAAAGATAG AAAATGACTT TGAGCAGAAG CTTCAGGATC TTCAAGGAGA AAAGGAGGCA
    CTGAATTCTG AGAAGCAGCA GATTGCTACA GAAAAACAAG ACCTAGAAGC TGAGGTGTCC
    AAGCTGACAG GAGAGGTTGC CAAGCTGTCA AAAGAGCTAG AAGATGCTAA GAAAGAAATG
    GCTTCTCTAG CCGCTGAGGC TGTTGCTCCT TCTGTTCCTA GTAGTGCTGC TGTTCCCCCT
    GCCCCTCCTG GACACTCTGG CACTGCTATT CCACCTCCAC CTCCACCACC CCCACCCCCA
    CCTCCTCTTC CTGGAGTTAG TACCACTTTC CCACCCCCTC CCCCTCCTTT GCCTGGAAGT
    GTTGGCCTTC CTATATCCTC TTCTTCACCT GCAGGCACTA GCATCCCTCC ACCTCCTCCT
    TTGCCTGGGA GTGCCAATAT CCCCCCACCC CCTCCTTTGC CCGGGGTTGC TAGCATCCTT
    CTTCCCCCTC CATTGCCTGA AGATACTGCT ATTCCCCCAC CTCCTCCTTT GCCTGGAGGT
    GCTAGTATCC CCCCAGCACC TCCTTTGCTT GGGAGTGCTT GCATCCCCCC ACCGCCTCCC
    TTGCCTGGAG GATCAGGACT GCCTCCTCCT CCTCCCCCTC TTCCTGGTGG TTCTGGAATC
    CCTCCACCAC CTCCATTTCC CGGAGGCCCT GGCATTCCCC CACCTCCACC TGGAATGGGT
    GTGCCTCCAC CTCCCCCCTT TGGATTTGGA ATTCCTGCAG CCCCAGTTCT GCCATTTGGA
    TTAACCCCCA AAAAAGTTTA TAAGCCAGAG GTGCAGCTGC GGAGACCAAA CTGGTCTAAG
    TTTGTTGCTG AAGACCTTTC CCAGGACTGC TTCTGGACAA AGGTGAAGGA AGACCGCTTT
    GAGAACAGTG AACTTTTTGC CAAACTTACC CTTACCTTCT CTGCTCAGAC CAAGACTTCC
    AAAGCCAAGA AGGATCAAGA AGGTGGAGAA GAAAAATCTG TGCAAAAGAA AAAAGTAAAA
    GAGCTAAAAG TGTTGGATTC AAAGACAGCA CAAAACCTCT CAATCTTTTT GGGTTCCTTC
    CGCATGCCCT ACCAGGAGAT TAAGAATGTC ATCCTGGAGG TGAATGAGGC TGTTTTGACT
    GAGTCTATGA TCCAGAACCT CATTAAACAG ATGCCAGAGC CAGAGCAGTT AAAAATGCTT
    TCTGAACTGA AGGATGAGTA TGATGATCTG GCTGAGTCAG AACAGTTCGG CGTGGTGATG
    GGCACAGTGC CCCGCCTACG GCCTCGCCTC AATGCTATCC TCTTCAAGCT ACAATTTGGT
    GAGCAAGTGG AGAATATCAA GCCAGAGATT GTGTCTGTCA CAGCAGCATG TGAGGAGTTA
    CGCAAGAGTG AGAGCTTCTC CAGCCTCCTG GAGATTACGC TGCTTGTTGG AAACTATATG
    AATGCGGGTT CCAGGAATGC TGGTGCTTTT GGCTTCAATA TCAGCTTCCT CTGTAAGCTT
    CGAGACACCA AGTCTACAGA TCAGAAGATG ACATTGTTGC ACTTCTTGGC TGAGTTATGT
    GAGAATGACT ATCCTGATGT CCTCAAGTTT CCTGATGAGC TTGCCCATGT GGAGAAAGCC
    AGCCGAGTTT CTGCTGAAAA CTTGCAGAAG AACTTAGATC AGATGAAGAA ACAGATTGCT
    GATGTGGAAC GTGATATTCA GAATTTCCCA GCTGCCACTG ATGAAAAGGA CAAGTTTGTG
    GAGAAAATGA CCATCTTTAT GAAGGATGCA CAGGAACAAT ATAACAAACT GCGAATGATG
    CACTCTAACA TGGAGACTCT GTATAAGGAG CTAGGTGACT ACTTCGTCTT TGACCCCAAG
    AAGTTGTCTG TGGAAGAATT CTTTATGGAT CTGCACAACT TTAGGAATAT GTTCTTGCAA
    GCAGTCAAGG AGAACCAGAA ACGCCGGGAA ACAGAAGAAA AGATGCGGCG AGCAAAACTA
    GCCAAGGAGA AGGCAGAAAA AGAGCGGCTG GAGAAACAGC AGAAGAGAGA GCAACTCATA
    GACATGAATG CAGAGGGTGA TGAGACAGGT GTGATGGATA GTCTTCTAGA AGCTCTGCAA
    TCAGGGGCAG CATTCCGAAG GAAGAGAGGA CCCCGTCAGG TCAACAGGAA GGCCGGGTGT
    GCAGTCACAT CTCTGCTAGC TTCAGAGCTG ACCAAGGATG ATGCCATGGC TGCTGGTCCT
    GCTAAAGTGT CCAAGAAAAG TGAAGGAGTA CCCACAATCC TTGAAGAAGC CAAGGAGCTG
    GTTGGCCGGG CAAGCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017654294.1
    CDS56..3853
    Translation

    Target ORF information:

    RefSeq Version XM_017798805.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017798805.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGCTA CGATAGCCGG AATCAGCATG AGATTATTCG CTGCTTGAAA
    GCTTTCATGA ACAACAAGTT TGGAATCAAA ACCATGTTGG AGACAGAAGA AGGAATCCTA
    CTGCTGGTCA GAGCCATGGA TCCTGCTGTT CCCAATATGA TGATTGACGC AGCTAAGCTG
    CTTTCTGCGC TTTGTATCCT TCCACAGCCA GAGGACATGA ATGAAAGAGT TTTGGAGGCA
    ATGACAGAGA GAGCTGAAAT GGATGAGGTG GAACGTTTCC AGCCACTACT GGATGGATTA
    AAAAGTGGCA CCTCTATTGC ACTCAAGGTG GGATGCCTAC AACTGATCAA TGCTCTCATC
    ACTCCAGCTG AAGAACTTGA CTTCCGAATT CACATCCGAA GTGAACTGAT GCGCTTGGGA
    CTGCATCAAG TGTTGCAGGA GCTTCGAGAG ATTGACAATG ATGATATGAG AGTGCAACTA
    ACTGTATTTG ATGAACAAGG GGATGAGGAT ATCTTTGATT TGAAAGGACG GCTGGATGAC
    ATTCGCATGG AGATGGATGA CTTTGGTGAA GTCTTCCAGA TTCTTTTAAA CACAGTGAAA
    GATTCAAAGG CAGAGCCACA TTTCCTGTCC ATCCTGCAAC ATCTGCTGTT GGTCCGAAAT
    GACTATGAGG CTAGGCCACA GTACTATAAA TTGATTGAAG AATGTATTTC TCAAATAGTT
    CTACACAGGA ATGGTACTGA TCCTGACTTC AAGTGCCGGC ATCTCCAGAT TGATATTGAG
    GGACTGATTG ATCAAATGAT TGATAAAACA AAAGTGGAAA AATCAGAGGC CAAAGCTACA
    GAACTGGAGA AAAAGCTGGA CTCAGAGCTA ACAGCCCGTC ATGAGTTACA AGTAGAAATG
    AAAAAGATAG AAAATGACTT TGAGCAGAAG CTTCAGGATC TTCAAGGAGA AAAGGAGGCA
    CTGAATTCTG AGAAGCAGCA GATTGCTACA GAAAAACAAG ACCTAGAAGC TGAGGTGTCC
    AAGCTGACAG GAGAGGTTGC CAAGCTGTCA AAAGAGCTAG AAGATGCTAA GAAAGAAATG
    GCTTCTCTAG CCGCTGAGGC TGTTGCTCCT TCTGTTCCTA GTAGTGCTGC TGTTCCCCCT
    GCCCCTCCTG GACACTCTGG CACTGCTATT CCACCTCCAC CTCCACCACC CCCACCCCCA
    CCTCCTCTTC CTGGAGTTAG TACCACTTTC CCACCCCCTC CCCCTCCTTT GCCTGGAAGT
    GTTGGCCTTC CTATATCCTC TTCTTCACCT GCAGGCACTA GCATCCCTCC ACCTCCTCCT
    TTGCCTGGGA GTGCCAATAT CCCCCCACCC CCTCCTTTGC CCGGGGTTGC TAGCATCCTT
    CTTCCCCCTC CATTGCCTGA AGATACTGCT ATTCCCCCAC CTCCTCCTTT GCCTGGAGGT
    GCTAGTATCC CCCCAGCACC TCCTTTGCTT GGGAGTGCTT GCATCCCCCC ACCGCCTCCC
    TTGCCTGGAG GATCAGGACT GCCTCCTCCT CCTCCCCCTC TTCCTGGTGG TTCTGGAATC
    CCTCCACCAC CTCCATTTCC CGGAGGCCCT GGCATTCCCC CACCTCCACC TGGAATGGGT
    GTGCCTCCAC CTCCCCCCTT TGGATTTGGA ATTCCTGCAG CCCCAGTTCT GCCATTTGGA
    TTAACCCCCA AAAAAGTTTA TAAGCCAGAG GTGCAGCTGC GGAGACCAAA CTGGTCTAAG
    TTTGTTGCTG AAGACCTTTC CCAGGACTGC TTCTGGACAA AGGTGAAGGA AGACCGCTTT
    GAGAACAGTG AACTTTTTGC CAAACTTACC CTTACCTTCT CTGCTCAGAC CAAGACTTCC
    AAAGCCAAGA AGGATCAAGA AGGTGGAGAA GAAAAATCTG TGCAAAAGAA AAAAGTAAAA
    GAGCTAAAAG TGTTGGATTC AAAGACAGCA CAAAACCTCT CAATCTTTTT GGGTTCCTTC
    CGCATGCCCT ACCAGGAGAT TAAGAATGTC ATCCTGGAGG TGAATGAGGC TGTTTTGACT
    GAGTCTATGA TCCAGAACCT CATTAAACAG ATGCCAGAGC CAGAGCAGTT AAAAATGCTT
    TCTGAACTGA AGGATGAGTA TGATGATCTG GCTGAGTCAG AACAGTTCGG CGTGGTGATG
    GGCACAGTGC CCCGCCTACG GCCTCGCCTC AATGCTATCC TCTTCAAGCT ACAATTTGGT
    GAGCAAGTGG AGAATATCAA GCCAGAGATT GTGTCTGTCA CAGCAGCATG TGAGGAGTTA
    CGCAAGAGTG AGAGCTTCTC CAGCCTCCTG GAGATTACGC TGCTTGTTGG AAACTATATG
    AATGCGGGTT CCAGGAATGC TGGTGCTTTT GGCTTCAATA TCAGCTTCCT CTGTAAGCTT
    CGAGACACCA AGTCTACAGA TCAGAAGATG ACATTGTTGC ACTTCTTGGC TGAGTTATGT
    GAGAATGACT ATCCTGATGT CCTCAAGTTT CCTGATGAGC TTGCCCATGT GGAGAAAGCC
    AGCCGAGTTT CTGCTGAAAA CTTGCAGAAG AACTTAGATC AGATGAAGAA ACAGATTGCT
    GATGTGGAAC GTGATATTCA GAATTTCCCA GCTGCCACTG ATGAAAAGGA CAAGTTTGTG
    GAGAAAATGA CCATCTTTAT GAAGGATGCA CAGGAACAAT ATAACAAACT GCGAATGATG
    CACTCTAACA TGGAGACTCT GTATAAGGAG CTAGGTGACT ACTTCGTCTT TGACCCCAAG
    AAGTTGTCTG TGGAAGAATT CTTTATGGAT CTGCACAACT TTAGGAATAT GTTCTTGCAA
    GCAGTCAAGG AGAACCAGAA ACGCCGGGAA ACAGAAGAAA AGATGCGGCG AGCAAAACTA
    GCCAAGGAGA AGGCAGAAAA AGAGCGGCTG GAGAAACAGC AGAAGAGAGA GCAACTCATA
    GACATGAATG CAGAGGGTGA TGAGACAGGT GTGATGGATA GTCTTCTAGA AGCTCTGCAA
    TCAGGGGCAG CATTCCGAAG GAAGAGAGGA CCCCGTCAGG TCAACAGGAA GGCCGGGTGT
    GCAGTCACAT CTCTGCTAGC TTCAGAGCTG ACCAAGGATG ATGCCATGGC TGCTGGTCCT
    GCTAAAGTGT CCAAGAAAAG TGAAGGAGTA CCCACAATCC TTGAAGAAGC CAAGGAGCTG
    GTTGGCCGGG CAAGCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa19097
    Clone ID Related Accession (Same CDS sequence) XM_017798805.1 , XM_017798805.2
    Accession Version XM_017798805.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3798bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein diaphanous homolog 1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008340429.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017798805.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGCTA CGATAGCCGG AATCAGCATG AGATTATTCG CTGCTTGAAA
    GCTTTCATGA ACAACAAGTT TGGAATCAAA ACCATGTTGG AGACAGAAGA AGGAATCCTA
    CTGCTGGTCA GAGCCATGGA TCCTGCTGTT CCCAATATGA TGATTGACGC AGCTAAGCTG
    CTTTCTGCGC TTTGTATCCT TCCACAGCCA GAGGACATGA ATGAAAGAGT TTTGGAGGCA
    ATGACAGAGA GAGCTGAAAT GGATGAGGTG GAACGTTTCC AGCCACTACT GGATGGATTA
    AAAAGTGGCA CCTCTATTGC ACTCAAGGTG GGATGCCTAC AACTGATCAA TGCTCTCATC
    ACTCCAGCTG AAGAACTTGA CTTCCGAATT CACATCCGAA GTGAACTGAT GCGCTTGGGA
    CTGCATCAAG TGTTGCAGGA GCTTCGAGAG ATTGACAATG ATGATATGAG AGTGCAACTA
    ACTGTATTTG ATGAACAAGG GGATGAGGAT ATCTTTGATT TGAAAGGACG GCTGGATGAC
    ATTCGCATGG AGATGGATGA CTTTGGTGAA GTCTTCCAGA TTCTTTTAAA CACAGTGAAA
    GATTCAAAGG CAGAGCCACA TTTCCTGTCC ATCCTGCAAC ATCTGCTGTT GGTCCGAAAT
    GACTATGAGG CTAGGCCACA GTACTATAAA TTGATTGAAG AATGTATTTC TCAAATAGTT
    CTACACAGGA ATGGTACTGA TCCTGACTTC AAGTGCCGGC ATCTCCAGAT TGATATTGAG
    GGACTGATTG ATCAAATGAT TGATAAAACA AAAGTGGAAA AATCAGAGGC CAAAGCTACA
    GAACTGGAGA AAAAGCTGGA CTCAGAGCTA ACAGCCCGTC ATGAGTTACA AGTAGAAATG
    AAAAAGATAG AAAATGACTT TGAGCAGAAG CTTCAGGATC TTCAAGGAGA AAAGGAGGCA
    CTGAATTCTG AGAAGCAGCA GATTGCTACA GAAAAACAAG ACCTAGAAGC TGAGGTGTCC
    AAGCTGACAG GAGAGGTTGC CAAGCTGTCA AAAGAGCTAG AAGATGCTAA GAAAGAAATG
    GCTTCTCTAG CCGCTGAGGC TGTTGCTCCT TCTGTTCCTA GTAGTGCTGC TGTTCCCCCT
    GCCCCTCCTG GACACTCTGG CACTGCTATT CCACCTCCAC CTCCACCACC CCCACCCCCA
    CCTCCTCTTC CTGGAGTTAG TACCACTTTC CCACCCCCTC CCCCTCCTTT GCCTGGAAGT
    GTTGGCCTTC CTATATCCTC TTCTTCACCT GCAGGCACTA GCATCCCTCC ACCTCCTCCT
    TTGCCTGGGA GTGCCAATAT CCCCCCACCC CCTCCTTTGC CCGGGGTTGC TAGCATCCTT
    CTTCCCCCTC CATTGCCTGA AGATACTGCT ATTCCCCCAC CTCCTCCTTT GCCTGGAGGT
    GCTAGTATCC CCCCAGCACC TCCTTTGCTT GGGAGTGCTT GCATCCCCCC ACCGCCTCCC
    TTGCCTGGAG GATCAGGACT GCCTCCTCCT CCTCCCCCTC TTCCTGGTGG TTCTGGAATC
    CCTCCACCAC CTCCATTTCC CGGAGGCCCT GGCATTCCCC CACCTCCACC TGGAATGGGT
    GTGCCTCCAC CTCCCCCCTT TGGATTTGGA ATTCCTGCAG CCCCAGTTCT GCCATTTGGA
    TTAACCCCCA AAAAAGTTTA TAAGCCAGAG GTGCAGCTGC GGAGACCAAA CTGGTCTAAG
    TTTGTTGCTG AAGACCTTTC CCAGGACTGC TTCTGGACAA AGGTGAAGGA AGACCGCTTT
    GAGAACAGTG AACTTTTTGC CAAACTTACC CTTACCTTCT CTGCTCAGAC CAAGACTTCC
    AAAGCCAAGA AGGATCAAGA AGGTGGAGAA GAAAAATCTG TGCAAAAGAA AAAAGTAAAA
    GAGCTAAAAG TGTTGGATTC AAAGACAGCA CAAAACCTCT CAATCTTTTT GGGTTCCTTC
    CGCATGCCCT ACCAGGAGAT TAAGAATGTC ATCCTGGAGG TGAATGAGGC TGTTTTGACT
    GAGTCTATGA TCCAGAACCT CATTAAACAG ATGCCAGAGC CAGAGCAGTT AAAAATGCTT
    TCTGAACTGA AGGATGAGTA TGATGATCTG GCTGAGTCAG AACAGTTCGG CGTGGTGATG
    GGCACAGTGC CCCGCCTACG GCCTCGCCTC AATGCTATCC TCTTCAAGCT ACAATTTGGT
    GAGCAAGTGG AGAATATCAA GCCAGAGATT GTGTCTGTCA CAGCAGCATG TGAGGAGTTA
    CGCAAGAGTG AGAGCTTCTC CAGCCTCCTG GAGATTACGC TGCTTGTTGG AAACTATATG
    AATGCGGGTT CCAGGAATGC TGGTGCTTTT GGCTTCAATA TCAGCTTCCT CTGTAAGCTT
    CGAGACACCA AGTCTACAGA TCAGAAGATG ACATTGTTGC ACTTCTTGGC TGAGTTATGT
    GAGAATGACT ATCCTGATGT CCTCAAGTTT CCTGATGAGC TTGCCCATGT GGAGAAAGCC
    AGCCGAGTTT CTGCTGAAAA CTTGCAGAAG AACTTAGATC AGATGAAGAA ACAGATTGCT
    GATGTGGAAC GTGATATTCA GAATTTCCCA GCTGCCACTG ATGAAAAGGA CAAGTTTGTG
    GAGAAAATGA CCATCTTTAT GAAGGATGCA CAGGAACAAT ATAACAAACT GCGAATGATG
    CACTCTAACA TGGAGACTCT GTATAAGGAG CTAGGTGACT ACTTCGTCTT TGACCCCAAG
    AAGTTGTCTG TGGAAGAATT CTTTATGGAT CTGCACAACT TTAGGAATAT GTTCTTGCAA
    GCAGTCAAGG AGAACCAGAA ACGCCGGGAA ACAGAAGAAA AGATGCGGCG AGCAAAACTA
    GCCAAGGAGA AGGCAGAAAA AGAGCGGCTG GAGAAACAGC AGAAGAGAGA GCAACTCATA
    GACATGAATG CAGAGGGTGA TGAGACAGGT GTGATGGATA GTCTTCTAGA AGCTCTGCAA
    TCAGGGGCAG CATTCCGAAG GAAGAGAGGA CCCCGTCAGG TCAACAGGAA GGCCGGGTGT
    GCAGTCACAT CTCTGCTAGC TTCAGAGCTG ACCAAGGATG ATGCCATGGC TGCTGGTCCT
    GCTAAAGTGT CCAAGAAAAG TGAAGGAGTA CCCACAATCC TTGAAGAAGC CAAGGAGCTG
    GTTGGCCGGG CAAGCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017654294.1
    CDS278..4075
    Translation

    Target ORF information:

    RefSeq Version XM_017798805.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017798805.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGCTA CGATAGCCGG AATCAGCATG AGATTATTCG CTGCTTGAAA
    GCTTTCATGA ACAACAAGTT TGGAATCAAA ACCATGTTGG AGACAGAAGA AGGAATCCTA
    CTGCTGGTCA GAGCCATGGA TCCTGCTGTT CCCAATATGA TGATTGACGC AGCTAAGCTG
    CTTTCTGCGC TTTGTATCCT TCCACAGCCA GAGGACATGA ATGAAAGAGT TTTGGAGGCA
    ATGACAGAGA GAGCTGAAAT GGATGAGGTG GAACGTTTCC AGCCACTACT GGATGGATTA
    AAAAGTGGCA CCTCTATTGC ACTCAAGGTG GGATGCCTAC AACTGATCAA TGCTCTCATC
    ACTCCAGCTG AAGAACTTGA CTTCCGAATT CACATCCGAA GTGAACTGAT GCGCTTGGGA
    CTGCATCAAG TGTTGCAGGA GCTTCGAGAG ATTGACAATG ATGATATGAG AGTGCAACTA
    ACTGTATTTG ATGAACAAGG GGATGAGGAT ATCTTTGATT TGAAAGGACG GCTGGATGAC
    ATTCGCATGG AGATGGATGA CTTTGGTGAA GTCTTCCAGA TTCTTTTAAA CACAGTGAAA
    GATTCAAAGG CAGAGCCACA TTTCCTGTCC ATCCTGCAAC ATCTGCTGTT GGTCCGAAAT
    GACTATGAGG CTAGGCCACA GTACTATAAA TTGATTGAAG AATGTATTTC TCAAATAGTT
    CTACACAGGA ATGGTACTGA TCCTGACTTC AAGTGCCGGC ATCTCCAGAT TGATATTGAG
    GGACTGATTG ATCAAATGAT TGATAAAACA AAAGTGGAAA AATCAGAGGC CAAAGCTACA
    GAACTGGAGA AAAAGCTGGA CTCAGAGCTA ACAGCCCGTC ATGAGTTACA AGTAGAAATG
    AAAAAGATAG AAAATGACTT TGAGCAGAAG CTTCAGGATC TTCAAGGAGA AAAGGAGGCA
    CTGAATTCTG AGAAGCAGCA GATTGCTACA GAAAAACAAG ACCTAGAAGC TGAGGTGTCC
    AAGCTGACAG GAGAGGTTGC CAAGCTGTCA AAAGAGCTAG AAGATGCTAA GAAAGAAATG
    GCTTCTCTAG CCGCTGAGGC TGTTGCTCCT TCTGTTCCTA GTAGTGCTGC TGTTCCCCCT
    GCCCCTCCTG GACACTCTGG CACTGCTATT CCACCTCCAC CTCCACCACC CCCACCCCCA
    CCTCCTCTTC CTGGAGTTAG TACCACTTTC CCACCCCCTC CCCCTCCTTT GCCTGGAAGT
    GTTGGCCTTC CTATATCCTC TTCTTCACCT GCAGGCACTA GCATCCCTCC ACCTCCTCCT
    TTGCCTGGGA GTGCCAATAT CCCCCCACCC CCTCCTTTGC CCGGGGTTGC TAGCATCCTT
    CTTCCCCCTC CATTGCCTGA AGATACTGCT ATTCCCCCAC CTCCTCCTTT GCCTGGAGGT
    GCTAGTATCC CCCCAGCACC TCCTTTGCTT GGGAGTGCTT GCATCCCCCC ACCGCCTCCC
    TTGCCTGGAG GATCAGGACT GCCTCCTCCT CCTCCCCCTC TTCCTGGTGG TTCTGGAATC
    CCTCCACCAC CTCCATTTCC CGGAGGCCCT GGCATTCCCC CACCTCCACC TGGAATGGGT
    GTGCCTCCAC CTCCCCCCTT TGGATTTGGA ATTCCTGCAG CCCCAGTTCT GCCATTTGGA
    TTAACCCCCA AAAAAGTTTA TAAGCCAGAG GTGCAGCTGC GGAGACCAAA CTGGTCTAAG
    TTTGTTGCTG AAGACCTTTC CCAGGACTGC TTCTGGACAA AGGTGAAGGA AGACCGCTTT
    GAGAACAGTG AACTTTTTGC CAAACTTACC CTTACCTTCT CTGCTCAGAC CAAGACTTCC
    AAAGCCAAGA AGGATCAAGA AGGTGGAGAA GAAAAATCTG TGCAAAAGAA AAAAGTAAAA
    GAGCTAAAAG TGTTGGATTC AAAGACAGCA CAAAACCTCT CAATCTTTTT GGGTTCCTTC
    CGCATGCCCT ACCAGGAGAT TAAGAATGTC ATCCTGGAGG TGAATGAGGC TGTTTTGACT
    GAGTCTATGA TCCAGAACCT CATTAAACAG ATGCCAGAGC CAGAGCAGTT AAAAATGCTT
    TCTGAACTGA AGGATGAGTA TGATGATCTG GCTGAGTCAG AACAGTTCGG CGTGGTGATG
    GGCACAGTGC CCCGCCTACG GCCTCGCCTC AATGCTATCC TCTTCAAGCT ACAATTTGGT
    GAGCAAGTGG AGAATATCAA GCCAGAGATT GTGTCTGTCA CAGCAGCATG TGAGGAGTTA
    CGCAAGAGTG AGAGCTTCTC CAGCCTCCTG GAGATTACGC TGCTTGTTGG AAACTATATG
    AATGCGGGTT CCAGGAATGC TGGTGCTTTT GGCTTCAATA TCAGCTTCCT CTGTAAGCTT
    CGAGACACCA AGTCTACAGA TCAGAAGATG ACATTGTTGC ACTTCTTGGC TGAGTTATGT
    GAGAATGACT ATCCTGATGT CCTCAAGTTT CCTGATGAGC TTGCCCATGT GGAGAAAGCC
    AGCCGAGTTT CTGCTGAAAA CTTGCAGAAG AACTTAGATC AGATGAAGAA ACAGATTGCT
    GATGTGGAAC GTGATATTCA GAATTTCCCA GCTGCCACTG ATGAAAAGGA CAAGTTTGTG
    GAGAAAATGA CCATCTTTAT GAAGGATGCA CAGGAACAAT ATAACAAACT GCGAATGATG
    CACTCTAACA TGGAGACTCT GTATAAGGAG CTAGGTGACT ACTTCGTCTT TGACCCCAAG
    AAGTTGTCTG TGGAAGAATT CTTTATGGAT CTGCACAACT TTAGGAATAT GTTCTTGCAA
    GCAGTCAAGG AGAACCAGAA ACGCCGGGAA ACAGAAGAAA AGATGCGGCG AGCAAAACTA
    GCCAAGGAGA AGGCAGAAAA AGAGCGGCTG GAGAAACAGC AGAAGAGAGA GCAACTCATA
    GACATGAATG CAGAGGGTGA TGAGACAGGT GTGATGGATA GTCTTCTAGA AGCTCTGCAA
    TCAGGGGCAG CATTCCGAAG GAAGAGAGGA CCCCGTCAGG TCAACAGGAA GGCCGGGTGT
    GCAGTCACAT CTCTGCTAGC TTCAGAGCTG ACCAAGGATG ATGCCATGGC TGCTGGTCCT
    GCTAAAGTGT CCAAGAAAAG TGAAGGAGTA CCCACAATCC TTGAAGAAGC CAAGGAGCTG
    GTTGGCCGGG CAAGCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa19098
    Clone ID Related Accession (Same CDS sequence) XM_017798806.1 , XM_017798806.2
    Accession Version XM_017798806.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3774bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein diaphanous homolog 1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008340429.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTCTG
    GAGAGATTTA CTAGCATAAG AATTAAGAAG GAGAAAGAAA AGCCCAATTC TGCTCACCGA
    AATTCTTCCT CTTACGGGGA TGATTCCACA GCACAGTCAC TGCAAGATAT TACAGATGAG
    CAGGTTCTGG TTCTCTTTGA ACAGATGCTG GTGGATATGA ACCTGAATGA GGAGAAACAG
    CAGCCTTTGA GAGAGAAGGA CATTGTCATC AAGAGGGAGA TGGTGTCCCA GTACTTGCAT
    ACTTCCACAG CTGGAATGAA CCAAAAAGAG AGCTCTAGGT CTGCCATGAT GTACATTCAG
    GAGCTAAGGT CAGGCTTGCG GGATATGCAT CTGCTTAGCT GCCTGGAGTC CCTTCGAGTC
    TCTCTCAACA ATAACCCTGT GAGTTGGGTG CAAACATTTG GTGCTGAAGG CCTAGCCTCC
    TTATTAGACA TCCTCAAACG ACTCCAGGAT GAGAAAGAAG AGACTTCTGG AAGCTACGAT
    AGCCGGAATC AGCATGAGAT TATTCGCTGC TTGAAAGCTT TCATGAACAA CAAGTTTGGA
    ATCAAAACCA TGTTGGAGAC AGAAGAAGGA ATCCTACTGC TGGTCAGAGC CATGGATCCT
    GCTGTTCCCA ATATGATGAT TGACGCAGCT AAGCTGCTTT CTGCGCTTTG TATCCTTCCA
    CAGCCAGAGG ACATGAATGA AAGAGTTTTG GAGGCAATGA CAGAGAGAGC TGAAATGGAT
    GAGGTGGAAC GTTTCCAGCC ACTACTGGAT GGATTAAAAA GTGGCACCTC TATTGCACTC
    AAGGTGGGAT GCCTACAACT GATCAATGCT CTCATCACTC CAGCTGAAGA ACTTGACTTC
    CGAATTCACA TCCGAAGTGA ACTGATGCGC TTGGGACTGC ATCAAGTGTT GCAGGAGCTT
    CGAGAGATTG ACAATGATGA TATGAGAGTG CAACTAACTG TATTTGATGA ACAAGGGGAT
    GAGGATATCT TTGATTTGAA AGGACGGCTG GATGACATTC GCATGGAGAT GGATGACTTT
    GGTGAAGTCT TCCAGATTCT TTTAAACACA GTGAAAGATT CAAAGGCAGA GCCACATTTC
    CTGTCCATCC TGCAACATCT GCTGTTGGTC CGAAATGACT ATGAGGCTAG GCCACAGTAC
    TATAAATTGA TTGAAGAATG TATTTCTCAA ATAGTTCTAC ACAGGAATGG TACTGATCCT
    GACTTCAAGT GCCGGCATCT CCAGATTGAT ATTGAGGGAC TGATTGATCA AATGATTGAT
    AAAACAAAAG TGGAAAAATC AGAGGCCAAA GCTACAGAAC TGGAGAAAAA GCTGGACTCA
    GAGCTAACAG CCCGTCATGA GTTACAAGTA GAAATGAAAA AGATAGAAAA TGACTTTGAG
    CAGAAGCTTC AGGATCTTCA AGGAGAAAAG GAGGCACTGA ATTCTGAGAA GCAGCAGATT
    GCTACAGAAA AACAAGACCT AGAAGCTGAG GTGTCCAAGC TGACAGGAGA GGTTGCCAAG
    CTGTCAAAAG AGCTAGAAGA TGCTAAGAAA GAAATGGCTT CTCTAGCCGC TGAGGCTGTT
    GCTCCTTCTG TTCCTAGTAG TGCTGCTGTT CCCCCTGCCC CTCCTGGACA CTCTGGCACT
    GCTATTCCAC CTCCACCTCC ACCACCCCCA CCCCCACCTC CTCTTCCTGG AGTTAGTACC
    ACTTTCCCAC CCCCTCCCCC TCCTTTGCCT GGAAGTGTTG GCCTTCCTAT ATCCTCTTCT
    TCACCTGCAG GCACTAGCAT CCCTCCACCT CCTCCTTTGC CTGGGAGTGC CAATATCCCC
    CCACCCCCTC CTTTGCCCGG GGTTGCTAGC ATCCTTCTTC CCCCTCCATT GCCTGAAGAT
    ACTGCTATTC CCCCACCTCC TCCTTTGCCT GGAGGTGCTA GTATCCCCCC AGCACCTCCT
    TTGCTTGGGA GTGCTTGCAT CCCCCCACCG CCTCCCTTGC CTGGAGGATC AGGACTGCCT
    CCTCCTCCTC CCCCTCTTCC TGGTGGTTCT GGAATCCCTC CACCACCTCC ATTTCCCGGA
    GGCCCTGGCA TTCCCCCACC TCCACCTGGA ATGGGTGTGC CTCCACCTCC CCCCTTTGGA
    TTTGGAATTC CTGCAGCCCC AGTTCTGCCA TTTGGATTAA CCCCCAAAAA AGTTTATAAG
    CCAGAGGTGC AGCTGCGGAG ACCAAACTGG TCTAAGTTTG TTGCTGAAGA CCTTTCCCAG
    GACTGCTTCT GGACAAAGGT GAAGGAAGAC CGCTTTGAGA ACAGTGAACT TTTTGCCAAA
    CTTACCCTTA CCTTCTCTGC TCAGACCAAG ACTTCCAAAG CCAAGAAGGA TCAAGAAGGT
    GGAGAAGAAA AATCTGTGCA AAAGAAAAAA GTAAAAGAGC TAAAAGTGTT GGATTCAAAG
    ACAGCACAAA ACCTCTCAAT CTTTTTGGGT TCCTTCCGCA TGCCCTACCA GGAGATTAAG
    AATGTCATCC TGGAGGTGAA TGAGGCTGTT TTGACTGAGT CTATGATCCA GAACCTCATT
    AAACAGATGC CAGAGCCAGA GCAGTTAAAA ATGCTTTCTG AACTGAAGGA TGAGTATGAT
    GATCTGGCTG AGTCAGAACA GTTCGGCGTG GTGATGGGCA CAGTGCCCCG CCTACGGCCT
    CGCCTCAATG CTATCCTCTT CAAGCTACAA TTTGGTGAGC AAGTGGAGAA TATCAAGCCA
    GAGATTGTGT CTGTCACAGC AGCATGTGAG GAGTTACGCA AGAGTGAGAG CTTCTCCAGC
    CTCCTGGAGA TTACGCTGCT TGTTGGAAAC TATATGAATG CGGGTTCCAG GAATGCTGGT
    GCTTTTGGCT TCAATATCAG CTTCCTCTGT AAGCTTCGAG ACACCAAGTC TACAGATCAG
    AAGATGACAT TGTTGCACTT CTTGGCTGAG TTATGTGAGA ATGACTATCC TGATGTCCTC
    AAGTTTCCTG ATGAGCTTGC CCATGTGGAG AAAGCCAGCC GAGTTTCTGC TGAAAACTTG
    CAGAAGAACT TAGATCAGAT GAAGAAACAG ATTGCTGATG TGGAACGTGA TATTCAGAAT
    TTCCCAGCTG CCACTGATGA AAAGGACAAG TTTGTGGAGA AAATGACCAT CTTTATGAAG
    GATGCACAGG AACAATATAA CAAACTGCGA ATGATGCACT CTAACATGGA GACTCTGTAT
    AAGGAGCTAG GTGACTACTT CGTCTTTGAC CCCAAGAAGT TGTCTGTGGA AGAATTCTTT
    ATGGATCTGC ACAACTTTAG GAATATGTTC TTGCAAGCAG TCAAGGAGAA CCAGAAACGC
    CGGGAAACAG AAGAAAAGAT GCGGCGAGCA AAACTAGCCA AGGAGAAGGC AGAAAAAGAG
    CGGCTGGAGA AACAGCAGAA GAGAGAGCAA CTCATAGACA TGAATGCAGA GGGTGATGAG
    ACAGGTGTGA TGGATAGTCT TCTAGAAGCT CTGCAATCAG GGGCAGCATT CCGAAGGAAG
    AGAGGACCCC GTCAGGTCAA CAGGAAGGCC GGGTGTGCAG TCACATCTCT GCTAGCTTCA
    GAGCTGACCA AGGATGATGC CATGGCTGCT GGTCCTGCTA AAGTGTCCAA GAAAAGTGAA
    GGAGTACCCA CAATCCTTGA AGAAGCCAAG GAGCTGGTTG GCCGGGCAAG CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_017654295.1
    CDS156..3929
    Translation

    Target ORF information:

    RefSeq Version XM_017798806.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017798806.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTCTG
    GAGAGATTTA CTAGCATAAG AATTAAGAAG GAGAAAGAAA AGCCCAATTC TGCTCACCGA
    AATTCTTCCT CTTACGGGGA TGATTCCACA GCACAGTCAC TGCAAGATAT TACAGATGAG
    CAGGTTCTGG TTCTCTTTGA ACAGATGCTG GTGGATATGA ACCTGAATGA GGAGAAACAG
    CAGCCTTTGA GAGAGAAGGA CATTGTCATC AAGAGGGAGA TGGTGTCCCA GTACTTGCAT
    ACTTCCACAG CTGGAATGAA CCAAAAAGAG AGCTCTAGGT CTGCCATGAT GTACATTCAG
    GAGCTAAGGT CAGGCTTGCG GGATATGCAT CTGCTTAGCT GCCTGGAGTC CCTTCGAGTC
    TCTCTCAACA ATAACCCTGT GAGTTGGGTG CAAACATTTG GTGCTGAAGG CCTAGCCTCC
    TTATTAGACA TCCTCAAACG ACTCCAGGAT GAGAAAGAAG AGACTTCTGG AAGCTACGAT
    AGCCGGAATC AGCATGAGAT TATTCGCTGC TTGAAAGCTT TCATGAACAA CAAGTTTGGA
    ATCAAAACCA TGTTGGAGAC AGAAGAAGGA ATCCTACTGC TGGTCAGAGC CATGGATCCT
    GCTGTTCCCA ATATGATGAT TGACGCAGCT AAGCTGCTTT CTGCGCTTTG TATCCTTCCA
    CAGCCAGAGG ACATGAATGA AAGAGTTTTG GAGGCAATGA CAGAGAGAGC TGAAATGGAT
    GAGGTGGAAC GTTTCCAGCC ACTACTGGAT GGATTAAAAA GTGGCACCTC TATTGCACTC
    AAGGTGGGAT GCCTACAACT GATCAATGCT CTCATCACTC CAGCTGAAGA ACTTGACTTC
    CGAATTCACA TCCGAAGTGA ACTGATGCGC TTGGGACTGC ATCAAGTGTT GCAGGAGCTT
    CGAGAGATTG ACAATGATGA TATGAGAGTG CAACTAACTG TATTTGATGA ACAAGGGGAT
    GAGGATATCT TTGATTTGAA AGGACGGCTG GATGACATTC GCATGGAGAT GGATGACTTT
    GGTGAAGTCT TCCAGATTCT TTTAAACACA GTGAAAGATT CAAAGGCAGA GCCACATTTC
    CTGTCCATCC TGCAACATCT GCTGTTGGTC CGAAATGACT ATGAGGCTAG GCCACAGTAC
    TATAAATTGA TTGAAGAATG TATTTCTCAA ATAGTTCTAC ACAGGAATGG TACTGATCCT
    GACTTCAAGT GCCGGCATCT CCAGATTGAT ATTGAGGGAC TGATTGATCA AATGATTGAT
    AAAACAAAAG TGGAAAAATC AGAGGCCAAA GCTACAGAAC TGGAGAAAAA GCTGGACTCA
    GAGCTAACAG CCCGTCATGA GTTACAAGTA GAAATGAAAA AGATAGAAAA TGACTTTGAG
    CAGAAGCTTC AGGATCTTCA AGGAGAAAAG GAGGCACTGA ATTCTGAGAA GCAGCAGATT
    GCTACAGAAA AACAAGACCT AGAAGCTGAG GTGTCCAAGC TGACAGGAGA GGTTGCCAAG
    CTGTCAAAAG AGCTAGAAGA TGCTAAGAAA GAAATGGCTT CTCTAGCCGC TGAGGCTGTT
    GCTCCTTCTG TTCCTAGTAG TGCTGCTGTT CCCCCTGCCC CTCCTGGACA CTCTGGCACT
    GCTATTCCAC CTCCACCTCC ACCACCCCCA CCCCCACCTC CTCTTCCTGG AGTTAGTACC
    ACTTTCCCAC CCCCTCCCCC TCCTTTGCCT GGAAGTGTTG GCCTTCCTAT ATCCTCTTCT
    TCACCTGCAG GCACTAGCAT CCCTCCACCT CCTCCTTTGC CTGGGAGTGC CAATATCCCC
    CCACCCCCTC CTTTGCCCGG GGTTGCTAGC ATCCTTCTTC CCCCTCCATT GCCTGAAGAT
    ACTGCTATTC CCCCACCTCC TCCTTTGCCT GGAGGTGCTA GTATCCCCCC AGCACCTCCT
    TTGCTTGGGA GTGCTTGCAT CCCCCCACCG CCTCCCTTGC CTGGAGGATC AGGACTGCCT
    CCTCCTCCTC CCCCTCTTCC TGGTGGTTCT GGAATCCCTC CACCACCTCC ATTTCCCGGA
    GGCCCTGGCA TTCCCCCACC TCCACCTGGA ATGGGTGTGC CTCCACCTCC CCCCTTTGGA
    TTTGGAATTC CTGCAGCCCC AGTTCTGCCA TTTGGATTAA CCCCCAAAAA AGTTTATAAG
    CCAGAGGTGC AGCTGCGGAG ACCAAACTGG TCTAAGTTTG TTGCTGAAGA CCTTTCCCAG
    GACTGCTTCT GGACAAAGGT GAAGGAAGAC CGCTTTGAGA ACAGTGAACT TTTTGCCAAA
    CTTACCCTTA CCTTCTCTGC TCAGACCAAG ACTTCCAAAG CCAAGAAGGA TCAAGAAGGT
    GGAGAAGAAA AATCTGTGCA AAAGAAAAAA GTAAAAGAGC TAAAAGTGTT GGATTCAAAG
    ACAGCACAAA ACCTCTCAAT CTTTTTGGGT TCCTTCCGCA TGCCCTACCA GGAGATTAAG
    AATGTCATCC TGGAGGTGAA TGAGGCTGTT TTGACTGAGT CTATGATCCA GAACCTCATT
    AAACAGATGC CAGAGCCAGA GCAGTTAAAA ATGCTTTCTG AACTGAAGGA TGAGTATGAT
    GATCTGGCTG AGTCAGAACA GTTCGGCGTG GTGATGGGCA CAGTGCCCCG CCTACGGCCT
    CGCCTCAATG CTATCCTCTT CAAGCTACAA TTTGGTGAGC AAGTGGAGAA TATCAAGCCA
    GAGATTGTGT CTGTCACAGC AGCATGTGAG GAGTTACGCA AGAGTGAGAG CTTCTCCAGC
    CTCCTGGAGA TTACGCTGCT TGTTGGAAAC TATATGAATG CGGGTTCCAG GAATGCTGGT
    GCTTTTGGCT TCAATATCAG CTTCCTCTGT AAGCTTCGAG ACACCAAGTC TACAGATCAG
    AAGATGACAT TGTTGCACTT CTTGGCTGAG TTATGTGAGA ATGACTATCC TGATGTCCTC
    AAGTTTCCTG ATGAGCTTGC CCATGTGGAG AAAGCCAGCC GAGTTTCTGC TGAAAACTTG
    CAGAAGAACT TAGATCAGAT GAAGAAACAG ATTGCTGATG TGGAACGTGA TATTCAGAAT
    TTCCCAGCTG CCACTGATGA AAAGGACAAG TTTGTGGAGA AAATGACCAT CTTTATGAAG
    GATGCACAGG AACAATATAA CAAACTGCGA ATGATGCACT CTAACATGGA GACTCTGTAT
    AAGGAGCTAG GTGACTACTT CGTCTTTGAC CCCAAGAAGT TGTCTGTGGA AGAATTCTTT
    ATGGATCTGC ACAACTTTAG GAATATGTTC TTGCAAGCAG TCAAGGAGAA CCAGAAACGC
    CGGGAAACAG AAGAAAAGAT GCGGCGAGCA AAACTAGCCA AGGAGAAGGC AGAAAAAGAG
    CGGCTGGAGA AACAGCAGAA GAGAGAGCAA CTCATAGACA TGAATGCAGA GGGTGATGAG
    ACAGGTGTGA TGGATAGTCT TCTAGAAGCT CTGCAATCAG GGGCAGCATT CCGAAGGAAG
    AGAGGACCCC GTCAGGTCAA CAGGAAGGCC GGGTGTGCAG TCACATCTCT GCTAGCTTCA
    GAGCTGACCA AGGATGATGC CATGGCTGCT GGTCCTGCTA AAGTGTCCAA GAAAAGTGAA
    GGAGTACCCA CAATCCTTGA AGAAGCCAAG GAGCTGGTTG GCCGGGCAAG CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa19098
    Clone ID Related Accession (Same CDS sequence) XM_017798806.1 , XM_017798806.2
    Accession Version XM_017798806.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3774bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein diaphanous homolog 1 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008340429.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017798806.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTCTG
    GAGAGATTTA CTAGCATAAG AATTAAGAAG GAGAAAGAAA AGCCCAATTC TGCTCACCGA
    AATTCTTCCT CTTACGGGGA TGATTCCACA GCACAGTCAC TGCAAGATAT TACAGATGAG
    CAGGTTCTGG TTCTCTTTGA ACAGATGCTG GTGGATATGA ACCTGAATGA GGAGAAACAG
    CAGCCTTTGA GAGAGAAGGA CATTGTCATC AAGAGGGAGA TGGTGTCCCA GTACTTGCAT
    ACTTCCACAG CTGGAATGAA CCAAAAAGAG AGCTCTAGGT CTGCCATGAT GTACATTCAG
    GAGCTAAGGT CAGGCTTGCG GGATATGCAT CTGCTTAGCT GCCTGGAGTC CCTTCGAGTC
    TCTCTCAACA ATAACCCTGT GAGTTGGGTG CAAACATTTG GTGCTGAAGG CCTAGCCTCC
    TTATTAGACA TCCTCAAACG ACTCCAGGAT GAGAAAGAAG AGACTTCTGG AAGCTACGAT
    AGCCGGAATC AGCATGAGAT TATTCGCTGC TTGAAAGCTT TCATGAACAA CAAGTTTGGA
    ATCAAAACCA TGTTGGAGAC AGAAGAAGGA ATCCTACTGC TGGTCAGAGC CATGGATCCT
    GCTGTTCCCA ATATGATGAT TGACGCAGCT AAGCTGCTTT CTGCGCTTTG TATCCTTCCA
    CAGCCAGAGG ACATGAATGA AAGAGTTTTG GAGGCAATGA CAGAGAGAGC TGAAATGGAT
    GAGGTGGAAC GTTTCCAGCC ACTACTGGAT GGATTAAAAA GTGGCACCTC TATTGCACTC
    AAGGTGGGAT GCCTACAACT GATCAATGCT CTCATCACTC CAGCTGAAGA ACTTGACTTC
    CGAATTCACA TCCGAAGTGA ACTGATGCGC TTGGGACTGC ATCAAGTGTT GCAGGAGCTT
    CGAGAGATTG ACAATGATGA TATGAGAGTG CAACTAACTG TATTTGATGA ACAAGGGGAT
    GAGGATATCT TTGATTTGAA AGGACGGCTG GATGACATTC GCATGGAGAT GGATGACTTT
    GGTGAAGTCT TCCAGATTCT TTTAAACACA GTGAAAGATT CAAAGGCAGA GCCACATTTC
    CTGTCCATCC TGCAACATCT GCTGTTGGTC CGAAATGACT ATGAGGCTAG GCCACAGTAC
    TATAAATTGA TTGAAGAATG TATTTCTCAA ATAGTTCTAC ACAGGAATGG TACTGATCCT
    GACTTCAAGT GCCGGCATCT CCAGATTGAT ATTGAGGGAC TGATTGATCA AATGATTGAT
    AAAACAAAAG TGGAAAAATC AGAGGCCAAA GCTACAGAAC TGGAGAAAAA GCTGGACTCA
    GAGCTAACAG CCCGTCATGA GTTACAAGTA GAAATGAAAA AGATAGAAAA TGACTTTGAG
    CAGAAGCTTC AGGATCTTCA AGGAGAAAAG GAGGCACTGA ATTCTGAGAA GCAGCAGATT
    GCTACAGAAA AACAAGACCT AGAAGCTGAG GTGTCCAAGC TGACAGGAGA GGTTGCCAAG
    CTGTCAAAAG AGCTAGAAGA TGCTAAGAAA GAAATGGCTT CTCTAGCCGC TGAGGCTGTT
    GCTCCTTCTG TTCCTAGTAG TGCTGCTGTT CCCCCTGCCC CTCCTGGACA CTCTGGCACT
    GCTATTCCAC CTCCACCTCC ACCACCCCCA CCCCCACCTC CTCTTCCTGG AGTTAGTACC
    ACTTTCCCAC CCCCTCCCCC TCCTTTGCCT GGAAGTGTTG GCCTTCCTAT ATCCTCTTCT
    TCACCTGCAG GCACTAGCAT CCCTCCACCT CCTCCTTTGC CTGGGAGTGC CAATATCCCC
    CCACCCCCTC CTTTGCCCGG GGTTGCTAGC ATCCTTCTTC CCCCTCCATT GCCTGAAGAT
    ACTGCTATTC CCCCACCTCC TCCTTTGCCT GGAGGTGCTA GTATCCCCCC AGCACCTCCT
    TTGCTTGGGA GTGCTTGCAT CCCCCCACCG CCTCCCTTGC CTGGAGGATC AGGACTGCCT
    CCTCCTCCTC CCCCTCTTCC TGGTGGTTCT GGAATCCCTC CACCACCTCC ATTTCCCGGA
    GGCCCTGGCA TTCCCCCACC TCCACCTGGA ATGGGTGTGC CTCCACCTCC CCCCTTTGGA
    TTTGGAATTC CTGCAGCCCC AGTTCTGCCA TTTGGATTAA CCCCCAAAAA AGTTTATAAG
    CCAGAGGTGC AGCTGCGGAG ACCAAACTGG TCTAAGTTTG TTGCTGAAGA CCTTTCCCAG
    GACTGCTTCT GGACAAAGGT GAAGGAAGAC CGCTTTGAGA ACAGTGAACT TTTTGCCAAA
    CTTACCCTTA CCTTCTCTGC TCAGACCAAG ACTTCCAAAG CCAAGAAGGA TCAAGAAGGT
    GGAGAAGAAA AATCTGTGCA AAAGAAAAAA GTAAAAGAGC TAAAAGTGTT GGATTCAAAG
    ACAGCACAAA ACCTCTCAAT CTTTTTGGGT TCCTTCCGCA TGCCCTACCA GGAGATTAAG
    AATGTCATCC TGGAGGTGAA TGAGGCTGTT TTGACTGAGT CTATGATCCA GAACCTCATT
    AAACAGATGC CAGAGCCAGA GCAGTTAAAA ATGCTTTCTG AACTGAAGGA TGAGTATGAT
    GATCTGGCTG AGTCAGAACA GTTCGGCGTG GTGATGGGCA CAGTGCCCCG CCTACGGCCT
    CGCCTCAATG CTATCCTCTT CAAGCTACAA TTTGGTGAGC AAGTGGAGAA TATCAAGCCA
    GAGATTGTGT CTGTCACAGC AGCATGTGAG GAGTTACGCA AGAGTGAGAG CTTCTCCAGC
    CTCCTGGAGA TTACGCTGCT TGTTGGAAAC TATATGAATG CGGGTTCCAG GAATGCTGGT
    GCTTTTGGCT TCAATATCAG CTTCCTCTGT AAGCTTCGAG ACACCAAGTC TACAGATCAG
    AAGATGACAT TGTTGCACTT CTTGGCTGAG TTATGTGAGA ATGACTATCC TGATGTCCTC
    AAGTTTCCTG ATGAGCTTGC CCATGTGGAG AAAGCCAGCC GAGTTTCTGC TGAAAACTTG
    CAGAAGAACT TAGATCAGAT GAAGAAACAG ATTGCTGATG TGGAACGTGA TATTCAGAAT
    TTCCCAGCTG CCACTGATGA AAAGGACAAG TTTGTGGAGA AAATGACCAT CTTTATGAAG
    GATGCACAGG AACAATATAA CAAACTGCGA ATGATGCACT CTAACATGGA GACTCTGTAT
    AAGGAGCTAG GTGACTACTT CGTCTTTGAC CCCAAGAAGT TGTCTGTGGA AGAATTCTTT
    ATGGATCTGC ACAACTTTAG GAATATGTTC TTGCAAGCAG TCAAGGAGAA CCAGAAACGC
    CGGGAAACAG AAGAAAAGAT GCGGCGAGCA AAACTAGCCA AGGAGAAGGC AGAAAAAGAG
    CGGCTGGAGA AACAGCAGAA GAGAGAGCAA CTCATAGACA TGAATGCAGA GGGTGATGAG
    ACAGGTGTGA TGGATAGTCT TCTAGAAGCT CTGCAATCAG GGGCAGCATT CCGAAGGAAG
    AGAGGACCCC GTCAGGTCAA CAGGAAGGCC GGGTGTGCAG TCACATCTCT GCTAGCTTCA
    GAGCTGACCA AGGATGATGC CATGGCTGCT GGTCCTGCTA AAGTGTCCAA GAAAAGTGAA
    GGAGTACCCA CAATCCTTGA AGAAGCCAAG GAGCTGGTTG GCCGGGCAAG CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017654295.1
    CDS278..4051
    Translation

    Target ORF information:

    RefSeq Version XM_017798806.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017798806.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTCTG
    GAGAGATTTA CTAGCATAAG AATTAAGAAG GAGAAAGAAA AGCCCAATTC TGCTCACCGA
    AATTCTTCCT CTTACGGGGA TGATTCCACA GCACAGTCAC TGCAAGATAT TACAGATGAG
    CAGGTTCTGG TTCTCTTTGA ACAGATGCTG GTGGATATGA ACCTGAATGA GGAGAAACAG
    CAGCCTTTGA GAGAGAAGGA CATTGTCATC AAGAGGGAGA TGGTGTCCCA GTACTTGCAT
    ACTTCCACAG CTGGAATGAA CCAAAAAGAG AGCTCTAGGT CTGCCATGAT GTACATTCAG
    GAGCTAAGGT CAGGCTTGCG GGATATGCAT CTGCTTAGCT GCCTGGAGTC CCTTCGAGTC
    TCTCTCAACA ATAACCCTGT GAGTTGGGTG CAAACATTTG GTGCTGAAGG CCTAGCCTCC
    TTATTAGACA TCCTCAAACG ACTCCAGGAT GAGAAAGAAG AGACTTCTGG AAGCTACGAT
    AGCCGGAATC AGCATGAGAT TATTCGCTGC TTGAAAGCTT TCATGAACAA CAAGTTTGGA
    ATCAAAACCA TGTTGGAGAC AGAAGAAGGA ATCCTACTGC TGGTCAGAGC CATGGATCCT
    GCTGTTCCCA ATATGATGAT TGACGCAGCT AAGCTGCTTT CTGCGCTTTG TATCCTTCCA
    CAGCCAGAGG ACATGAATGA AAGAGTTTTG GAGGCAATGA CAGAGAGAGC TGAAATGGAT
    GAGGTGGAAC GTTTCCAGCC ACTACTGGAT GGATTAAAAA GTGGCACCTC TATTGCACTC
    AAGGTGGGAT GCCTACAACT GATCAATGCT CTCATCACTC CAGCTGAAGA ACTTGACTTC
    CGAATTCACA TCCGAAGTGA ACTGATGCGC TTGGGACTGC ATCAAGTGTT GCAGGAGCTT
    CGAGAGATTG ACAATGATGA TATGAGAGTG CAACTAACTG TATTTGATGA ACAAGGGGAT
    GAGGATATCT TTGATTTGAA AGGACGGCTG GATGACATTC GCATGGAGAT GGATGACTTT
    GGTGAAGTCT TCCAGATTCT TTTAAACACA GTGAAAGATT CAAAGGCAGA GCCACATTTC
    CTGTCCATCC TGCAACATCT GCTGTTGGTC CGAAATGACT ATGAGGCTAG GCCACAGTAC
    TATAAATTGA TTGAAGAATG TATTTCTCAA ATAGTTCTAC ACAGGAATGG TACTGATCCT
    GACTTCAAGT GCCGGCATCT CCAGATTGAT ATTGAGGGAC TGATTGATCA AATGATTGAT
    AAAACAAAAG TGGAAAAATC AGAGGCCAAA GCTACAGAAC TGGAGAAAAA GCTGGACTCA
    GAGCTAACAG CCCGTCATGA GTTACAAGTA GAAATGAAAA AGATAGAAAA TGACTTTGAG
    CAGAAGCTTC AGGATCTTCA AGGAGAAAAG GAGGCACTGA ATTCTGAGAA GCAGCAGATT
    GCTACAGAAA AACAAGACCT AGAAGCTGAG GTGTCCAAGC TGACAGGAGA GGTTGCCAAG
    CTGTCAAAAG AGCTAGAAGA TGCTAAGAAA GAAATGGCTT CTCTAGCCGC TGAGGCTGTT
    GCTCCTTCTG TTCCTAGTAG TGCTGCTGTT CCCCCTGCCC CTCCTGGACA CTCTGGCACT
    GCTATTCCAC CTCCACCTCC ACCACCCCCA CCCCCACCTC CTCTTCCTGG AGTTAGTACC
    ACTTTCCCAC CCCCTCCCCC TCCTTTGCCT GGAAGTGTTG GCCTTCCTAT ATCCTCTTCT
    TCACCTGCAG GCACTAGCAT CCCTCCACCT CCTCCTTTGC CTGGGAGTGC CAATATCCCC
    CCACCCCCTC CTTTGCCCGG GGTTGCTAGC ATCCTTCTTC CCCCTCCATT GCCTGAAGAT
    ACTGCTATTC CCCCACCTCC TCCTTTGCCT GGAGGTGCTA GTATCCCCCC AGCACCTCCT
    TTGCTTGGGA GTGCTTGCAT CCCCCCACCG CCTCCCTTGC CTGGAGGATC AGGACTGCCT
    CCTCCTCCTC CCCCTCTTCC TGGTGGTTCT GGAATCCCTC CACCACCTCC ATTTCCCGGA
    GGCCCTGGCA TTCCCCCACC TCCACCTGGA ATGGGTGTGC CTCCACCTCC CCCCTTTGGA
    TTTGGAATTC CTGCAGCCCC AGTTCTGCCA TTTGGATTAA CCCCCAAAAA AGTTTATAAG
    CCAGAGGTGC AGCTGCGGAG ACCAAACTGG TCTAAGTTTG TTGCTGAAGA CCTTTCCCAG
    GACTGCTTCT GGACAAAGGT GAAGGAAGAC CGCTTTGAGA ACAGTGAACT TTTTGCCAAA
    CTTACCCTTA CCTTCTCTGC TCAGACCAAG ACTTCCAAAG CCAAGAAGGA TCAAGAAGGT
    GGAGAAGAAA AATCTGTGCA AAAGAAAAAA GTAAAAGAGC TAAAAGTGTT GGATTCAAAG
    ACAGCACAAA ACCTCTCAAT CTTTTTGGGT TCCTTCCGCA TGCCCTACCA GGAGATTAAG
    AATGTCATCC TGGAGGTGAA TGAGGCTGTT TTGACTGAGT CTATGATCCA GAACCTCATT
    AAACAGATGC CAGAGCCAGA GCAGTTAAAA ATGCTTTCTG AACTGAAGGA TGAGTATGAT
    GATCTGGCTG AGTCAGAACA GTTCGGCGTG GTGATGGGCA CAGTGCCCCG CCTACGGCCT
    CGCCTCAATG CTATCCTCTT CAAGCTACAA TTTGGTGAGC AAGTGGAGAA TATCAAGCCA
    GAGATTGTGT CTGTCACAGC AGCATGTGAG GAGTTACGCA AGAGTGAGAG CTTCTCCAGC
    CTCCTGGAGA TTACGCTGCT TGTTGGAAAC TATATGAATG CGGGTTCCAG GAATGCTGGT
    GCTTTTGGCT TCAATATCAG CTTCCTCTGT AAGCTTCGAG ACACCAAGTC TACAGATCAG
    AAGATGACAT TGTTGCACTT CTTGGCTGAG TTATGTGAGA ATGACTATCC TGATGTCCTC
    AAGTTTCCTG ATGAGCTTGC CCATGTGGAG AAAGCCAGCC GAGTTTCTGC TGAAAACTTG
    CAGAAGAACT TAGATCAGAT GAAGAAACAG ATTGCTGATG TGGAACGTGA TATTCAGAAT
    TTCCCAGCTG CCACTGATGA AAAGGACAAG TTTGTGGAGA AAATGACCAT CTTTATGAAG
    GATGCACAGG AACAATATAA CAAACTGCGA ATGATGCACT CTAACATGGA GACTCTGTAT
    AAGGAGCTAG GTGACTACTT CGTCTTTGAC CCCAAGAAGT TGTCTGTGGA AGAATTCTTT
    ATGGATCTGC ACAACTTTAG GAATATGTTC TTGCAAGCAG TCAAGGAGAA CCAGAAACGC
    CGGGAAACAG AAGAAAAGAT GCGGCGAGCA AAACTAGCCA AGGAGAAGGC AGAAAAAGAG
    CGGCTGGAGA AACAGCAGAA GAGAGAGCAA CTCATAGACA TGAATGCAGA GGGTGATGAG
    ACAGGTGTGA TGGATAGTCT TCTAGAAGCT CTGCAATCAG GGGCAGCATT CCGAAGGAAG
    AGAGGACCCC GTCAGGTCAA CAGGAAGGCC GGGTGTGCAG TCACATCTCT GCTAGCTTCA
    GAGCTGACCA AGGATGATGC CATGGCTGCT GGTCCTGCTA AAGTGTCCAA GAAAAGTGAA
    GGAGTACCCA CAATCCTTGA AGAAGCCAAG GAGCTGGTTG GCCGGGCAAG CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa19099
    Clone ID Related Accession (Same CDS sequence) XM_008835505.2 , XM_008835505.3
    Accession Version XM_008835505.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3801bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein diaphanous homolog 1 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008340429.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008835505.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGAAG CTACGATAGC CGGAATCAGC ATGAGATTAT TCGCTGCTTG
    AAAGCTTTCA TGAACAACAA GTTTGGAATC AAAACCATGT TGGAGACAGA AGAAGGAATC
    CTACTGCTGG TCAGAGCCAT GGATCCTGCT GTTCCCAATA TGATGATTGA CGCAGCTAAG
    CTGCTTTCTG CGCTTTGTAT CCTTCCACAG CCAGAGGACA TGAATGAAAG AGTTTTGGAG
    GCAATGACAG AGAGAGCTGA AATGGATGAG GTGGAACGTT TCCAGCCACT ACTGGATGGA
    TTAAAAAGTG GCACCTCTAT TGCACTCAAG GTGGGATGCC TACAACTGAT CAATGCTCTC
    ATCACTCCAG CTGAAGAACT TGACTTCCGA ATTCACATCC GAAGTGAACT GATGCGCTTG
    GGACTGCATC AAGTGTTGCA GGAGCTTCGA GAGATTGACA ATGATGATAT GAGAGTGCAA
    CTAACTGTAT TTGATGAACA AGGGGATGAG GATATCTTTG ATTTGAAAGG ACGGCTGGAT
    GACATTCGCA TGGAGATGGA TGACTTTGGT GAAGTCTTCC AGATTCTTTT AAACACAGTG
    AAAGATTCAA AGGCAGAGCC ACATTTCCTG TCCATCCTGC AACATCTGCT GTTGGTCCGA
    AATGACTATG AGGCTAGGCC ACAGTACTAT AAATTGATTG AAGAATGTAT TTCTCAAATA
    GTTCTACACA GGAATGGTAC TGATCCTGAC TTCAAGTGCC GGCATCTCCA GATTGATATT
    GAGGGACTGA TTGATCAAAT GATTGATAAA ACAAAAGTGG AAAAATCAGA GGCCAAAGCT
    ACAGAACTGG AGAAAAAGCT GGACTCAGAG CTAACAGCCC GTCATGAGTT ACAAGTAGAA
    ATGAAAAAGA TAGAAAATGA CTTTGAGCAG AAGCTTCAGG ATCTTCAAGG AGAAAAGGAG
    GCACTGAATT CTGAGAAGCA GCAGATTGCT ACAGAAAAAC AAGACCTAGA AGCTGAGGTG
    TCCAAGCTGA CAGGAGAGGT TGCCAAGCTG TCAAAAGAGC TAGAAGATGC TAAGAAAGAA
    ATGGCTTCTC TAGCCGCTGA GGCTGTTGCT CCTTCTGTTC CTAGTAGTGC TGCTGTTCCC
    CCTGCCCCTC CTGGACACTC TGGCACTGCT ATTCCACCTC CACCTCCACC ACCCCCACCC
    CCACCTCCTC TTCCTGGAGT TAGTACCACT TTCCCACCCC CTCCCCCTCC TTTGCCTGGA
    AGTGTTGGCC TTCCTATATC CTCTTCTTCA CCTGCAGGCA CTAGCATCCC TCCACCTCCT
    CCTTTGCCTG GGAGTGCCAA TATCCCCCCA CCCCCTCCTT TGCCCGGGGT TGCTAGCATC
    CTTCTTCCCC CTCCATTGCC TGAAGATACT GCTATTCCCC CACCTCCTCC TTTGCCTGGA
    GGTGCTAGTA TCCCCCCAGC ACCTCCTTTG CTTGGGAGTG CTTGCATCCC CCCACCGCCT
    CCCTTGCCTG GAGGATCAGG ACTGCCTCCT CCTCCTCCCC CTCTTCCTGG TGGTTCTGGA
    ATCCCTCCAC CACCTCCATT TCCCGGAGGC CCTGGCATTC CCCCACCTCC ACCTGGAATG
    GGTGTGCCTC CACCTCCCCC CTTTGGATTT GGAATTCCTG CAGCCCCAGT TCTGCCATTT
    GGATTAACCC CCAAAAAAGT TTATAAGCCA GAGGTGCAGC TGCGGAGACC AAACTGGTCT
    AAGTTTGTTG CTGAAGACCT TTCCCAGGAC TGCTTCTGGA CAAAGGTGAA GGAAGACCGC
    TTTGAGAACA GTGAACTTTT TGCCAAACTT ACCCTTACCT TCTCTGCTCA GACCAAGACT
    TCCAAAGCCA AGAAGGATCA AGAAGGTGGA GAAGAAAAAT CTGTGCAAAA GAAAAAAGTA
    AAAGAGCTAA AAGTGTTGGA TTCAAAGACA GCACAAAACC TCTCAATCTT TTTGGGTTCC
    TTCCGCATGC CCTACCAGGA GATTAAGAAT GTCATCCTGG AGGTGAATGA GGCTGTTTTG
    ACTGAGTCTA TGATCCAGAA CCTCATTAAA CAGATGCCAG AGCCAGAGCA GTTAAAAATG
    CTTTCTGAAC TGAAGGATGA GTATGATGAT CTGGCTGAGT CAGAACAGTT CGGCGTGGTG
    ATGGGCACAG TGCCCCGCCT ACGGCCTCGC CTCAATGCTA TCCTCTTCAA GCTACAATTT
    GGTGAGCAAG TGGAGAATAT CAAGCCAGAG ATTGTGTCTG TCACAGCAGC ATGTGAGGAG
    TTACGCAAGA GTGAGAGCTT CTCCAGCCTC CTGGAGATTA CGCTGCTTGT TGGAAACTAT
    ATGAATGCGG GTTCCAGGAA TGCTGGTGCT TTTGGCTTCA ATATCAGCTT CCTCTGTAAG
    CTTCGAGACA CCAAGTCTAC AGATCAGAAG ATGACATTGT TGCACTTCTT GGCTGAGTTA
    TGTGAGAATG ACTATCCTGA TGTCCTCAAG TTTCCTGATG AGCTTGCCCA TGTGGAGAAA
    GCCAGCCGAG TTTCTGCTGA AAACTTGCAG AAGAACTTAG ATCAGATGAA GAAACAGATT
    GCTGATGTGG AACGTGATAT TCAGAATTTC CCAGCTGCCA CTGATGAAAA GGACAAGTTT
    GTGGAGAAAA TGACCATCTT TATGAAGGAT GCACAGGAAC AATATAACAA ACTGCGAATG
    ATGCACTCTA ACATGGAGAC TCTGTATAAG GAGCTAGGTG ACTACTTCGT CTTTGACCCC
    AAGAAGTTGT CTGTGGAAGA ATTCTTTATG GATCTGCACA ACTTTAGGAA TATGTTCTTG
    CAAGCAGTCA AGGAGAACCA GAAACGCCGG GAAACAGAAG AAAAGATGCG GCGAGCAAAA
    CTAGCCAAGG AGAAGGCAGA AAAAGAGCGG CTGGAGAAAC AGCAGAAGAG AGAGCAACTC
    ATAGACATGA ATGCAGAGGG TGATGAGACA GGTGTGATGG ATAGTCTTCT AGAAGCTCTG
    CAATCAGGGG CAGCATTCCG AAGGAAGAGA GGACCCCGTC AGGTCAACAG GAAGGCCGGG
    TGTGCAGTCA CATCTCTGCT AGCTTCAGAG CTGACCAAGG ATGATGCCAT GGCTGCTGGT
    CCTGCTAAAG TGTCCAAGAA AAGTGAAGGA GTACCCACAA TCCTTGAAGA AGCCAAGGAG
    CTGGTTGGCC GGGCAAGCTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008833727.1
    CDS67..3867
    Translation

    Target ORF information:

    RefSeq Version XM_008835505.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008835505.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGAAG CTACGATAGC CGGAATCAGC ATGAGATTAT TCGCTGCTTG
    AAAGCTTTCA TGAACAACAA GTTTGGAATC AAAACCATGT TGGAGACAGA AGAAGGAATC
    CTACTGCTGG TCAGAGCCAT GGATCCTGCT GTTCCCAATA TGATGATTGA CGCAGCTAAG
    CTGCTTTCTG CGCTTTGTAT CCTTCCACAG CCAGAGGACA TGAATGAAAG AGTTTTGGAG
    GCAATGACAG AGAGAGCTGA AATGGATGAG GTGGAACGTT TCCAGCCACT ACTGGATGGA
    TTAAAAAGTG GCACCTCTAT TGCACTCAAG GTGGGATGCC TACAACTGAT CAATGCTCTC
    ATCACTCCAG CTGAAGAACT TGACTTCCGA ATTCACATCC GAAGTGAACT GATGCGCTTG
    GGACTGCATC AAGTGTTGCA GGAGCTTCGA GAGATTGACA ATGATGATAT GAGAGTGCAA
    CTAACTGTAT TTGATGAACA AGGGGATGAG GATATCTTTG ATTTGAAAGG ACGGCTGGAT
    GACATTCGCA TGGAGATGGA TGACTTTGGT GAAGTCTTCC AGATTCTTTT AAACACAGTG
    AAAGATTCAA AGGCAGAGCC ACATTTCCTG TCCATCCTGC AACATCTGCT GTTGGTCCGA
    AATGACTATG AGGCTAGGCC ACAGTACTAT AAATTGATTG AAGAATGTAT TTCTCAAATA
    GTTCTACACA GGAATGGTAC TGATCCTGAC TTCAAGTGCC GGCATCTCCA GATTGATATT
    GAGGGACTGA TTGATCAAAT GATTGATAAA ACAAAAGTGG AAAAATCAGA GGCCAAAGCT
    ACAGAACTGG AGAAAAAGCT GGACTCAGAG CTAACAGCCC GTCATGAGTT ACAAGTAGAA
    ATGAAAAAGA TAGAAAATGA CTTTGAGCAG AAGCTTCAGG ATCTTCAAGG AGAAAAGGAG
    GCACTGAATT CTGAGAAGCA GCAGATTGCT ACAGAAAAAC AAGACCTAGA AGCTGAGGTG
    TCCAAGCTGA CAGGAGAGGT TGCCAAGCTG TCAAAAGAGC TAGAAGATGC TAAGAAAGAA
    ATGGCTTCTC TAGCCGCTGA GGCTGTTGCT CCTTCTGTTC CTAGTAGTGC TGCTGTTCCC
    CCTGCCCCTC CTGGACACTC TGGCACTGCT ATTCCACCTC CACCTCCACC ACCCCCACCC
    CCACCTCCTC TTCCTGGAGT TAGTACCACT TTCCCACCCC CTCCCCCTCC TTTGCCTGGA
    AGTGTTGGCC TTCCTATATC CTCTTCTTCA CCTGCAGGCA CTAGCATCCC TCCACCTCCT
    CCTTTGCCTG GGAGTGCCAA TATCCCCCCA CCCCCTCCTT TGCCCGGGGT TGCTAGCATC
    CTTCTTCCCC CTCCATTGCC TGAAGATACT GCTATTCCCC CACCTCCTCC TTTGCCTGGA
    GGTGCTAGTA TCCCCCCAGC ACCTCCTTTG CTTGGGAGTG CTTGCATCCC CCCACCGCCT
    CCCTTGCCTG GAGGATCAGG ACTGCCTCCT CCTCCTCCCC CTCTTCCTGG TGGTTCTGGA
    ATCCCTCCAC CACCTCCATT TCCCGGAGGC CCTGGCATTC CCCCACCTCC ACCTGGAATG
    GGTGTGCCTC CACCTCCCCC CTTTGGATTT GGAATTCCTG CAGCCCCAGT TCTGCCATTT
    GGATTAACCC CCAAAAAAGT TTATAAGCCA GAGGTGCAGC TGCGGAGACC AAACTGGTCT
    AAGTTTGTTG CTGAAGACCT TTCCCAGGAC TGCTTCTGGA CAAAGGTGAA GGAAGACCGC
    TTTGAGAACA GTGAACTTTT TGCCAAACTT ACCCTTACCT TCTCTGCTCA GACCAAGACT
    TCCAAAGCCA AGAAGGATCA AGAAGGTGGA GAAGAAAAAT CTGTGCAAAA GAAAAAAGTA
    AAAGAGCTAA AAGTGTTGGA TTCAAAGACA GCACAAAACC TCTCAATCTT TTTGGGTTCC
    TTCCGCATGC CCTACCAGGA GATTAAGAAT GTCATCCTGG AGGTGAATGA GGCTGTTTTG
    ACTGAGTCTA TGATCCAGAA CCTCATTAAA CAGATGCCAG AGCCAGAGCA GTTAAAAATG
    CTTTCTGAAC TGAAGGATGA GTATGATGAT CTGGCTGAGT CAGAACAGTT CGGCGTGGTG
    ATGGGCACAG TGCCCCGCCT ACGGCCTCGC CTCAATGCTA TCCTCTTCAA GCTACAATTT
    GGTGAGCAAG TGGAGAATAT CAAGCCAGAG ATTGTGTCTG TCACAGCAGC ATGTGAGGAG
    TTACGCAAGA GTGAGAGCTT CTCCAGCCTC CTGGAGATTA CGCTGCTTGT TGGAAACTAT
    ATGAATGCGG GTTCCAGGAA TGCTGGTGCT TTTGGCTTCA ATATCAGCTT CCTCTGTAAG
    CTTCGAGACA CCAAGTCTAC AGATCAGAAG ATGACATTGT TGCACTTCTT GGCTGAGTTA
    TGTGAGAATG ACTATCCTGA TGTCCTCAAG TTTCCTGATG AGCTTGCCCA TGTGGAGAAA
    GCCAGCCGAG TTTCTGCTGA AAACTTGCAG AAGAACTTAG ATCAGATGAA GAAACAGATT
    GCTGATGTGG AACGTGATAT TCAGAATTTC CCAGCTGCCA CTGATGAAAA GGACAAGTTT
    GTGGAGAAAA TGACCATCTT TATGAAGGAT GCACAGGAAC AATATAACAA ACTGCGAATG
    ATGCACTCTA ACATGGAGAC TCTGTATAAG GAGCTAGGTG ACTACTTCGT CTTTGACCCC
    AAGAAGTTGT CTGTGGAAGA ATTCTTTATG GATCTGCACA ACTTTAGGAA TATGTTCTTG
    CAAGCAGTCA AGGAGAACCA GAAACGCCGG GAAACAGAAG AAAAGATGCG GCGAGCAAAA
    CTAGCCAAGG AGAAGGCAGA AAAAGAGCGG CTGGAGAAAC AGCAGAAGAG AGAGCAACTC
    ATAGACATGA ATGCAGAGGG TGATGAGACA GGTGTGATGG ATAGTCTTCT AGAAGCTCTG
    CAATCAGGGG CAGCATTCCG AAGGAAGAGA GGACCCCGTC AGGTCAACAG GAAGGCCGGG
    TGTGCAGTCA CATCTCTGCT AGCTTCAGAG CTGACCAAGG ATGATGCCAT GGCTGCTGGT
    CCTGCTAAAG TGTCCAAGAA AAGTGAAGGA GTACCCACAA TCCTTGAAGA AGCCAAGGAG
    CTGGTTGGCC GGGCAAGCTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa19099
    Clone ID Related Accession (Same CDS sequence) XM_008835505.2 , XM_008835505.3
    Accession Version XM_008835505.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3801bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein diaphanous homolog 1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008340429.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008835505.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGAAG CTACGATAGC CGGAATCAGC ATGAGATTAT TCGCTGCTTG
    AAAGCTTTCA TGAACAACAA GTTTGGAATC AAAACCATGT TGGAGACAGA AGAAGGAATC
    CTACTGCTGG TCAGAGCCAT GGATCCTGCT GTTCCCAATA TGATGATTGA CGCAGCTAAG
    CTGCTTTCTG CGCTTTGTAT CCTTCCACAG CCAGAGGACA TGAATGAAAG AGTTTTGGAG
    GCAATGACAG AGAGAGCTGA AATGGATGAG GTGGAACGTT TCCAGCCACT ACTGGATGGA
    TTAAAAAGTG GCACCTCTAT TGCACTCAAG GTGGGATGCC TACAACTGAT CAATGCTCTC
    ATCACTCCAG CTGAAGAACT TGACTTCCGA ATTCACATCC GAAGTGAACT GATGCGCTTG
    GGACTGCATC AAGTGTTGCA GGAGCTTCGA GAGATTGACA ATGATGATAT GAGAGTGCAA
    CTAACTGTAT TTGATGAACA AGGGGATGAG GATATCTTTG ATTTGAAAGG ACGGCTGGAT
    GACATTCGCA TGGAGATGGA TGACTTTGGT GAAGTCTTCC AGATTCTTTT AAACACAGTG
    AAAGATTCAA AGGCAGAGCC ACATTTCCTG TCCATCCTGC AACATCTGCT GTTGGTCCGA
    AATGACTATG AGGCTAGGCC ACAGTACTAT AAATTGATTG AAGAATGTAT TTCTCAAATA
    GTTCTACACA GGAATGGTAC TGATCCTGAC TTCAAGTGCC GGCATCTCCA GATTGATATT
    GAGGGACTGA TTGATCAAAT GATTGATAAA ACAAAAGTGG AAAAATCAGA GGCCAAAGCT
    ACAGAACTGG AGAAAAAGCT GGACTCAGAG CTAACAGCCC GTCATGAGTT ACAAGTAGAA
    ATGAAAAAGA TAGAAAATGA CTTTGAGCAG AAGCTTCAGG ATCTTCAAGG AGAAAAGGAG
    GCACTGAATT CTGAGAAGCA GCAGATTGCT ACAGAAAAAC AAGACCTAGA AGCTGAGGTG
    TCCAAGCTGA CAGGAGAGGT TGCCAAGCTG TCAAAAGAGC TAGAAGATGC TAAGAAAGAA
    ATGGCTTCTC TAGCCGCTGA GGCTGTTGCT CCTTCTGTTC CTAGTAGTGC TGCTGTTCCC
    CCTGCCCCTC CTGGACACTC TGGCACTGCT ATTCCACCTC CACCTCCACC ACCCCCACCC
    CCACCTCCTC TTCCTGGAGT TAGTACCACT TTCCCACCCC CTCCCCCTCC TTTGCCTGGA
    AGTGTTGGCC TTCCTATATC CTCTTCTTCA CCTGCAGGCA CTAGCATCCC TCCACCTCCT
    CCTTTGCCTG GGAGTGCCAA TATCCCCCCA CCCCCTCCTT TGCCCGGGGT TGCTAGCATC
    CTTCTTCCCC CTCCATTGCC TGAAGATACT GCTATTCCCC CACCTCCTCC TTTGCCTGGA
    GGTGCTAGTA TCCCCCCAGC ACCTCCTTTG CTTGGGAGTG CTTGCATCCC CCCACCGCCT
    CCCTTGCCTG GAGGATCAGG ACTGCCTCCT CCTCCTCCCC CTCTTCCTGG TGGTTCTGGA
    ATCCCTCCAC CACCTCCATT TCCCGGAGGC CCTGGCATTC CCCCACCTCC ACCTGGAATG
    GGTGTGCCTC CACCTCCCCC CTTTGGATTT GGAATTCCTG CAGCCCCAGT TCTGCCATTT
    GGATTAACCC CCAAAAAAGT TTATAAGCCA GAGGTGCAGC TGCGGAGACC AAACTGGTCT
    AAGTTTGTTG CTGAAGACCT TTCCCAGGAC TGCTTCTGGA CAAAGGTGAA GGAAGACCGC
    TTTGAGAACA GTGAACTTTT TGCCAAACTT ACCCTTACCT TCTCTGCTCA GACCAAGACT
    TCCAAAGCCA AGAAGGATCA AGAAGGTGGA GAAGAAAAAT CTGTGCAAAA GAAAAAAGTA
    AAAGAGCTAA AAGTGTTGGA TTCAAAGACA GCACAAAACC TCTCAATCTT TTTGGGTTCC
    TTCCGCATGC CCTACCAGGA GATTAAGAAT GTCATCCTGG AGGTGAATGA GGCTGTTTTG
    ACTGAGTCTA TGATCCAGAA CCTCATTAAA CAGATGCCAG AGCCAGAGCA GTTAAAAATG
    CTTTCTGAAC TGAAGGATGA GTATGATGAT CTGGCTGAGT CAGAACAGTT CGGCGTGGTG
    ATGGGCACAG TGCCCCGCCT ACGGCCTCGC CTCAATGCTA TCCTCTTCAA GCTACAATTT
    GGTGAGCAAG TGGAGAATAT CAAGCCAGAG ATTGTGTCTG TCACAGCAGC ATGTGAGGAG
    TTACGCAAGA GTGAGAGCTT CTCCAGCCTC CTGGAGATTA CGCTGCTTGT TGGAAACTAT
    ATGAATGCGG GTTCCAGGAA TGCTGGTGCT TTTGGCTTCA ATATCAGCTT CCTCTGTAAG
    CTTCGAGACA CCAAGTCTAC AGATCAGAAG ATGACATTGT TGCACTTCTT GGCTGAGTTA
    TGTGAGAATG ACTATCCTGA TGTCCTCAAG TTTCCTGATG AGCTTGCCCA TGTGGAGAAA
    GCCAGCCGAG TTTCTGCTGA AAACTTGCAG AAGAACTTAG ATCAGATGAA GAAACAGATT
    GCTGATGTGG AACGTGATAT TCAGAATTTC CCAGCTGCCA CTGATGAAAA GGACAAGTTT
    GTGGAGAAAA TGACCATCTT TATGAAGGAT GCACAGGAAC AATATAACAA ACTGCGAATG
    ATGCACTCTA ACATGGAGAC TCTGTATAAG GAGCTAGGTG ACTACTTCGT CTTTGACCCC
    AAGAAGTTGT CTGTGGAAGA ATTCTTTATG GATCTGCACA ACTTTAGGAA TATGTTCTTG
    CAAGCAGTCA AGGAGAACCA GAAACGCCGG GAAACAGAAG AAAAGATGCG GCGAGCAAAA
    CTAGCCAAGG AGAAGGCAGA AAAAGAGCGG CTGGAGAAAC AGCAGAAGAG AGAGCAACTC
    ATAGACATGA ATGCAGAGGG TGATGAGACA GGTGTGATGG ATAGTCTTCT AGAAGCTCTG
    CAATCAGGGG CAGCATTCCG AAGGAAGAGA GGACCCCGTC AGGTCAACAG GAAGGCCGGG
    TGTGCAGTCA CATCTCTGCT AGCTTCAGAG CTGACCAAGG ATGATGCCAT GGCTGCTGGT
    CCTGCTAAAG TGTCCAAGAA AAGTGAAGGA GTACCCACAA TCCTTGAAGA AGCCAAGGAG
    CTGGTTGGCC GGGCAAGCTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008833727.1
    CDS277..4077
    Translation

    Target ORF information:

    RefSeq Version XM_008835505.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili diaphanous related formin 1 (Diaph1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008835505.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGGACCCTT CCGGCGGGGG CCTGGGGCCC GGCCGCGGGA CCCGAGACAA GAAGAAGGGT 
    CGGAGCCCGG ATGAGCTACC TACGACGGGC GGCGACGGCG GCAAACCGAA GAAATTTACT
    TTGAAGCGAC TCATGGCAGA TGAGCTGGAG AGATTTACTA GCATAAGAAT TAAGAAGGAG
    AAAGAAAAGC CCAATTCTGC TCACCGAAAT TCTTCCTCTT ACGGGGATGA TTCCACAGCA
    CAGTCACTGC AAGATATTAC AGATGAGCAG GTTCTGGTTC TCTTTGAACA GATGCTGGTG
    GATATGAACC TGAATGAGGA GAAACAGCAG CCTTTGAGAG AGAAGGACAT TGTCATCAAG
    AGGGAGATGG TGTCCCAGTA CTTGCATACT TCCACAGCTG GAATGAACCA AAAAGAGAGC
    TCTAGGTCTG CCATGATGTA CATTCAGGAG CTAAGGTCAG GCTTGCGGGA TATGCATCTG
    CTTAGCTGCC TGGAGTCCCT TCGAGTCTCT CTCAACAATA ACCCTGTGAG TTGGGTGCAA
    ACATTTGGTG CTGAAGGCCT AGCCTCCTTA TTAGACATCC TCAAACGACT CCAGGATGAG
    AAAGAAGAGA CTTCTGGAAG CTACGATAGC CGGAATCAGC ATGAGATTAT TCGCTGCTTG
    AAAGCTTTCA TGAACAACAA GTTTGGAATC AAAACCATGT TGGAGACAGA AGAAGGAATC
    CTACTGCTGG TCAGAGCCAT GGATCCTGCT GTTCCCAATA TGATGATTGA CGCAGCTAAG
    CTGCTTTCTG CGCTTTGTAT CCTTCCACAG CCAGAGGACA TGAATGAAAG AGTTTTGGAG
    GCAATGACAG AGAGAGCTGA AATGGATGAG GTGGAACGTT TCCAGCCACT ACTGGATGGA
    TTAAAAAGTG GCACCTCTAT TGCACTCAAG GTGGGATGCC TACAACTGAT CAATGCTCTC
    ATCACTCCAG CTGAAGAACT TGACTTCCGA ATTCACATCC GAAGTGAACT GATGCGCTTG
    GGACTGCATC AAGTGTTGCA GGAGCTTCGA GAGATTGACA ATGATGATAT GAGAGTGCAA
    CTAACTGTAT TTGATGAACA AGGGGATGAG GATATCTTTG ATTTGAAAGG ACGGCTGGAT
    GACATTCGCA TGGAGATGGA TGACTTTGGT GAAGTCTTCC AGATTCTTTT AAACACAGTG
    AAAGATTCAA AGGCAGAGCC ACATTTCCTG TCCATCCTGC AACATCTGCT GTTGGTCCGA
    AATGACTATG AGGCTAGGCC ACAGTACTAT AAATTGATTG AAGAATGTAT TTCTCAAATA
    GTTCTACACA GGAATGGTAC TGATCCTGAC TTCAAGTGCC GGCATCTCCA GATTGATATT
    GAGGGACTGA TTGATCAAAT GATTGATAAA ACAAAAGTGG AAAAATCAGA GGCCAAAGCT
    ACAGAACTGG AGAAAAAGCT GGACTCAGAG CTAACAGCCC GTCATGAGTT ACAAGTAGAA
    ATGAAAAAGA TAGAAAATGA CTTTGAGCAG AAGCTTCAGG ATCTTCAAGG AGAAAAGGAG
    GCACTGAATT CTGAGAAGCA GCAGATTGCT ACAGAAAAAC AAGACCTAGA AGCTGAGGTG
    TCCAAGCTGA CAGGAGAGGT TGCCAAGCTG TCAAAAGAGC TAGAAGATGC TAAGAAAGAA
    ATGGCTTCTC TAGCCGCTGA GGCTGTTGCT CCTTCTGTTC CTAGTAGTGC TGCTGTTCCC
    CCTGCCCCTC CTGGACACTC TGGCACTGCT ATTCCACCTC CACCTCCACC ACCCCCACCC
    CCACCTCCTC TTCCTGGAGT TAGTACCACT TTCCCACCCC CTCCCCCTCC TTTGCCTGGA
    AGTGTTGGCC TTCCTATATC CTCTTCTTCA CCTGCAGGCA CTAGCATCCC TCCACCTCCT
    CCTTTGCCTG GGAGTGCCAA TATCCCCCCA CCCCCTCCTT TGCCCGGGGT TGCTAGCATC
    CTTCTTCCCC CTCCATTGCC TGAAGATACT GCTATTCCCC CACCTCCTCC TTTGCCTGGA
    GGTGCTAGTA TCCCCCCAGC ACCTCCTTTG CTTGGGAGTG CTTGCATCCC CCCACCGCCT
    CCCTTGCCTG GAGGATCAGG ACTGCCTCCT CCTCCTCCCC CTCTTCCTGG TGGTTCTGGA
    ATCCCTCCAC CACCTCCATT TCCCGGAGGC CCTGGCATTC CCCCACCTCC ACCTGGAATG
    GGTGTGCCTC CACCTCCCCC CTTTGGATTT GGAATTCCTG CAGCCCCAGT TCTGCCATTT
    GGATTAACCC CCAAAAAAGT TTATAAGCCA GAGGTGCAGC TGCGGAGACC AAACTGGTCT
    AAGTTTGTTG CTGAAGACCT TTCCCAGGAC TGCTTCTGGA CAAAGGTGAA GGAAGACCGC
    TTTGAGAACA GTGAACTTTT TGCCAAACTT ACCCTTACCT TCTCTGCTCA GACCAAGACT
    TCCAAAGCCA AGAAGGATCA AGAAGGTGGA GAAGAAAAAT CTGTGCAAAA GAAAAAAGTA
    AAAGAGCTAA AAGTGTTGGA TTCAAAGACA GCACAAAACC TCTCAATCTT TTTGGGTTCC
    TTCCGCATGC CCTACCAGGA GATTAAGAAT GTCATCCTGG AGGTGAATGA GGCTGTTTTG
    ACTGAGTCTA TGATCCAGAA CCTCATTAAA CAGATGCCAG AGCCAGAGCA GTTAAAAATG
    CTTTCTGAAC TGAAGGATGA GTATGATGAT CTGGCTGAGT CAGAACAGTT CGGCGTGGTG
    ATGGGCACAG TGCCCCGCCT ACGGCCTCGC CTCAATGCTA TCCTCTTCAA GCTACAATTT
    GGTGAGCAAG TGGAGAATAT CAAGCCAGAG ATTGTGTCTG TCACAGCAGC ATGTGAGGAG
    TTACGCAAGA GTGAGAGCTT CTCCAGCCTC CTGGAGATTA CGCTGCTTGT TGGAAACTAT
    ATGAATGCGG GTTCCAGGAA TGCTGGTGCT TTTGGCTTCA ATATCAGCTT CCTCTGTAAG
    CTTCGAGACA CCAAGTCTAC AGATCAGAAG ATGACATTGT TGCACTTCTT GGCTGAGTTA
    TGTGAGAATG ACTATCCTGA TGTCCTCAAG TTTCCTGATG AGCTTGCCCA TGTGGAGAAA
    GCCAGCCGAG TTTCTGCTGA AAACTTGCAG AAGAACTTAG ATCAGATGAA GAAACAGATT
    GCTGATGTGG AACGTGATAT TCAGAATTTC CCAGCTGCCA CTGATGAAAA GGACAAGTTT
    GTGGAGAAAA TGACCATCTT TATGAAGGAT GCACAGGAAC AATATAACAA ACTGCGAATG
    ATGCACTCTA ACATGGAGAC TCTGTATAAG GAGCTAGGTG ACTACTTCGT CTTTGACCCC
    AAGAAGTTGT CTGTGGAAGA ATTCTTTATG GATCTGCACA ACTTTAGGAA TATGTTCTTG
    CAAGCAGTCA AGGAGAACCA GAAACGCCGG GAAACAGAAG AAAAGATGCG GCGAGCAAAA
    CTAGCCAAGG AGAAGGCAGA AAAAGAGCGG CTGGAGAAAC AGCAGAAGAG AGAGCAACTC
    ATAGACATGA ATGCAGAGGG TGATGAGACA GGTGTGATGG ATAGTCTTCT AGAAGCTCTG
    CAATCAGGGG CAGCATTCCG AAGGAAGAGA GGACCCCGTC AGGTCAACAG GAAGGCCGGG
    TGTGCAGTCA CATCTCTGCT AGCTTCAGAG CTGACCAAGG ATGATGCCAT GGCTGCTGGT
    CCTGCTAAAG TGTCCAAGAA AAGTGAAGGA GTACCCACAA TCCTTGAAGA AGCCAAGGAG
    CTGGTTGGCC GGGCAAGCTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.