Trim33 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

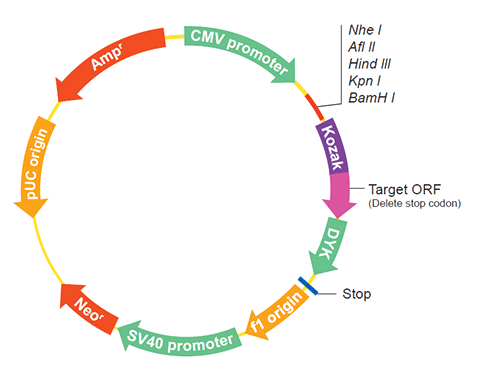
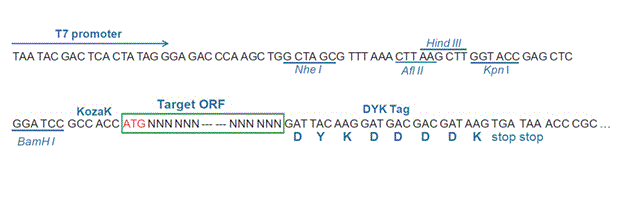
The following Trim33 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Trim33 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa130251 XM_029563995.1
Latest version!
Nannospalax galili tripartite motif containing 33 (Trim33), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa130252 XM_029563996.1
Latest version!
Nannospalax galili tripartite motif containing 33 (Trim33), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa17742 XM_008834036.2
Latest version!
Nannospalax galili tripartite motif containing 33 (Trim33), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa130251
    Clone ID Related Accession (Same CDS sequence) XM_029563995.1
    Accession Version XM_029563995.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3387bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product E3 ubiquitin-protein ligase TRIM33 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008339435.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGGCGGAAA ACAAAGGCGG CGGCGAGGCA GAGAGTGGCG GCGGGGGCAG CGGCAGCGCG 
    CCGGTAACCG CAGGGGCGGC CGGGCCCGCG GCGCAGGAGG CNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNTCGGGCT CGGCTCCTGC CGCATCGGCC
    CCTGCGCCCT CCGTGGGCCC TGCGGTCCCC GGGGGCGCGG CATCCACGCC GGCCCCGTCG
    CCAGCGTCCG CCCCGGCTCC GGGTCCCTCG TCGGGGCCGC CTCTCGGGCC GCCAGCCTCG
    CTCCTGGACA CCTGCGCGGT GTGTCAGCAG AGCCTGCAGA GCCGGCGTGA GGCGGAGCCC
    AAGCTGCTGC CCTGCCTGCA CTCCTTCTGC CTGCGCTGCC TGCCGGAGCC CGAGCGCCAG
    CTCAGCGTGC CCATCCCCGG GGGCAGCAAC GGCGACATCC AGCAAGTTGG TGTAATACGG
    TGTCCAGTAT GCCGTCAGGA ATGCAGACAG ATAGATCTTG TGGATAATTA TTTTGTGAAA
    GACACAACTG AAGCCCCTAG CAGTTCTGAT GAGAAATCAG AACAGGTATG TACTAGTTGT
    GAAGACAATG CCAGTGCAGT AGGTTTTTGT GTAGAGTGTG GAGAGTGGCT TTGTAAGACA
    TGCATTGAAG CACATCAGAG AGTGAAGTTC ACTAAAGATC ATTTGATCAG GAAAAAAGAA
    GATGTCTCAG AGTCTGTCGG AGCATCTGGT CAGCGTCCTG TTTTTTGCCC TGTACACAAA
    CAAGAGCAAT TGAAACTTTT CTGTGAAACA TGTGATAGAC TGACATGTAG AGACTGTCAG
    CTATTGGAGC ACAAAGAACA TAGGTATCAG TTTTTGGAAG AAGCTTTTCA AAATCAAAAA
    GGTGCCATTG AGAATCTGTT GGCTAAACTT CTTGAAAAGA AGAATTATGT TCATTTTGCA
    GCTACACAGG TGCAGAATAG GATAAAAGAA GTAAATGAGA CTAACAAACG AGTAGAACAG
    GAAATTAAAG TGGCCATTTT CACCCTTATC AATGAAATTA ATAAGAAAGG AAAATCTCTC
    TTACAGCAGC TAGAGAATGT TACAAAAGAA AGACAGATGA AACTACTACA GCAGCAGAAT
    GACATCACAG GCCTCTCCCG GCAGGTGAAG CATGTTATGA ACTTTACAAA CTGGGCAATT
    GCAAGTGGCA GCAGCACAGC ACTACTGTAT AGCAAACGTC TGATTACTTT TCAGTTACGT
    CATATTTTGA AAGCACGATG TGATCCTGTT CCTGCTGCCA ATGGAGCAAT TCGTTTCCAT
    TGTGATCCCA CCTTCTGGGC CAAAAATGTA GTGAACTTAG GTAATCTAGT AATAGAGAGC
    AAACCAGCTC CTGGTTATAC TCCTAATGTT GTAGTTGGGC AAGTTCCTCC AGGGACAAAC
    CACATCAGTA AAACCCCTGG ACAGATTAAT TTAGCGCAGC TTCGACTCCA GCACATGCAA
    CAACAAGTGT ATGCACAGAA GCATCAACAG TTACAGCAGA TGAGAATGCA GCAACCACCT
    GCTCCTGTAC CAACAACAAC AACAACAACA CAGCAACATC CTAGACAAGC AGCCCCACAG
    ATGTTACAAC AACAGCCTCC AAGATTGATC AGTGTGCAAA CAATGCAAAG AGGCAACATG
    AACTGTGGAG CATTTCAAGC CCATCAAATG AGACTGGCTC AGAATGCTGC CAGAATACCA
    GGGATACCCA GGCACAGTGG CCCTCAGTAT TCCATGATGC AGCCACACCT CCAAAGACAA
    CACTCAAACC CAGGGCATGC TGGACCCTTT CCTGTCGTAT CTGTACACAA TAATAACACA
    ATCAATCCAA CAAGCCCTAC CACAGCAACT ATGGCAAATG CAAACCGAGG GCCCACTAGC
    CCATCTGTTA CAGCGATAGA GCTAATTCCC TCAGTCACCA ATCCAGAAAA CCTTCCATCG
    TTACCAGATA TTCCACCTAT ACAGTTGGAA GATGCTGGCT CAAGTAGTTT AGATAATCTA
    CTAAGTAGAT ATATCTCAGG CAGTCACCTA CCCCCACAGC CTACAAGTAC CATGAATCCT
    TCCCCAGGAC CCTCTGCTTT ATCACCAGGA TCTTCAGGTT TATCCAATTC TCACACACCT
    GTGAGACCCC CTAGTACTTC CAGTACTGGC AGTCGAGGCA GCTGTGGATC ATCAGGAAGA
    ACTGCTGAGA AGGCAGGTCT TAGTTTCAAA TCTGATCAGG TGAAGGTCAA GCAAGAACCT
    GGGACTGAAG ATGAAATATG TAGCTTTTCG GGAGCTGTGA AGCAAGAAAA GACTGAGGAT
    GGCAGGAGGA GTGCGTGCAT GTTGAGCAGT CCTGAGAGTA GTTTGACACC ACCTCTCTCA
    ACCAACCTAC ATCTAGAGAG TGAGTTGGAT ACATTAACAA GCCTGGAGAA CCATGTGAAA
    GCTGAACCTA CAGATACGAA TGAAAGCTGC AAACAGTCAG GGCTCAGTAG CCTAGTTAAT
    GGGAAATCTC CAATTCGAAG CCTCATGCAC AGATCGGCAA GGATTGGAGG AGATGGCAGT
    AGCAAAGATG AGGACCCAAA TGAAGACTGG TGTGCTGTCT GCCAAAATGG AGGGGATCTT
    TTGTGCTGTG AAAAATGTCC AAAGGTCTTT CATCTAACTT GTCATGTTCC AACACTTCTT
    AGCTTTCCAA GTGGGGACTG GATATGCACA TTTTGCAGAG ATATTGGGAA ACCAGAAGTT
    GAATATGATT GTGATAATTT GCAACACAGT AAGAAGGGGA AAACTGCACA GGGCTTAAGC
    CCCGTGGACC AAAGGAAATG TGAACGTCTT CTACTTTATC TCTATTGCCA TGAATTAAGT
    ATTGAATTCC AGGAGCCTGT TCCTGTTTCG ATACCAAACT ACTATAAAAT TATAAAGAAA
    CCAATGGATT TATCTACCGT GAAAAAGAAG CTTCAGAAAA AACATTCCCA ACATTACCAA
    GTCCCAGATG ATTTTGTGGC TGATGTCCGC TTGATCTTCA AGAACTGTGA AAGGTTTAAT
    GAAATGATGA AAGTTGTTCA AGTTTATGCA GACACACAAG AGATTAATTT GAAGGCTGAT
    TCAGAAGTAG CTCAGGCAGG GAAAGCAGTT GCATTGTACT TTGAAGATAA ACTCTCAGAG
    ATCTACTCAG ACAGGACCTT CGCTCCTTTG CCAGAGTTTG AACAGGAAGA GGATGATGGT
    GATGTTACGG AGGACTCTGA TGAAGACTTT ATACAACCCC GTAGAAAACG CCTAAAGTCA
    GATGAGAGAC CAGTACATAT AAAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029419855.1
    CDS155..3541
    Translation

    Target ORF information:

    RefSeq Version XM_029563995.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili tripartite motif containing 33 (Trim33), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029563995.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGGCGGAAA ACAAAGGCGG CGGCGAGGCA GAGAGTGGCG GCGGGGGCAG CGGCAGCGCG 
    CCGGTAACCG CAGGGGCGGC CGGGCCCGCG GCGCAGGAGG CNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNTCGGGCT CGGCTCCTGC CGCATCGGCC
    CCTGCGCCCT CCGTGGGCCC TGCGGTCCCC GGGGGCGCGG CATCCACGCC GGCCCCGTCG
    CCAGCGTCCG CCCCGGCTCC GGGTCCCTCG TCGGGGCCGC CTCTCGGGCC GCCAGCCTCG
    CTCCTGGACA CCTGCGCGGT GTGTCAGCAG AGCCTGCAGA GCCGGCGTGA GGCGGAGCCC
    AAGCTGCTGC CCTGCCTGCA CTCCTTCTGC CTGCGCTGCC TGCCGGAGCC CGAGCGCCAG
    CTCAGCGTGC CCATCCCCGG GGGCAGCAAC GGCGACATCC AGCAAGTTGG TGTAATACGG
    TGTCCAGTAT GCCGTCAGGA ATGCAGACAG ATAGATCTTG TGGATAATTA TTTTGTGAAA
    GACACAACTG AAGCCCCTAG CAGTTCTGAT GAGAAATCAG AACAGGTATG TACTAGTTGT
    GAAGACAATG CCAGTGCAGT AGGTTTTTGT GTAGAGTGTG GAGAGTGGCT TTGTAAGACA
    TGCATTGAAG CACATCAGAG AGTGAAGTTC ACTAAAGATC ATTTGATCAG GAAAAAAGAA
    GATGTCTCAG AGTCTGTCGG AGCATCTGGT CAGCGTCCTG TTTTTTGCCC TGTACACAAA
    CAAGAGCAAT TGAAACTTTT CTGTGAAACA TGTGATAGAC TGACATGTAG AGACTGTCAG
    CTATTGGAGC ACAAAGAACA TAGGTATCAG TTTTTGGAAG AAGCTTTTCA AAATCAAAAA
    GGTGCCATTG AGAATCTGTT GGCTAAACTT CTTGAAAAGA AGAATTATGT TCATTTTGCA
    GCTACACAGG TGCAGAATAG GATAAAAGAA GTAAATGAGA CTAACAAACG AGTAGAACAG
    GAAATTAAAG TGGCCATTTT CACCCTTATC AATGAAATTA ATAAGAAAGG AAAATCTCTC
    TTACAGCAGC TAGAGAATGT TACAAAAGAA AGACAGATGA AACTACTACA GCAGCAGAAT
    GACATCACAG GCCTCTCCCG GCAGGTGAAG CATGTTATGA ACTTTACAAA CTGGGCAATT
    GCAAGTGGCA GCAGCACAGC ACTACTGTAT AGCAAACGTC TGATTACTTT TCAGTTACGT
    CATATTTTGA AAGCACGATG TGATCCTGTT CCTGCTGCCA ATGGAGCAAT TCGTTTCCAT
    TGTGATCCCA CCTTCTGGGC CAAAAATGTA GTGAACTTAG GTAATCTAGT AATAGAGAGC
    AAACCAGCTC CTGGTTATAC TCCTAATGTT GTAGTTGGGC AAGTTCCTCC AGGGACAAAC
    CACATCAGTA AAACCCCTGG ACAGATTAAT TTAGCGCAGC TTCGACTCCA GCACATGCAA
    CAACAAGTGT ATGCACAGAA GCATCAACAG TTACAGCAGA TGAGAATGCA GCAACCACCT
    GCTCCTGTAC CAACAACAAC AACAACAACA CAGCAACATC CTAGACAAGC AGCCCCACAG
    ATGTTACAAC AACAGCCTCC AAGATTGATC AGTGTGCAAA CAATGCAAAG AGGCAACATG
    AACTGTGGAG CATTTCAAGC CCATCAAATG AGACTGGCTC AGAATGCTGC CAGAATACCA
    GGGATACCCA GGCACAGTGG CCCTCAGTAT TCCATGATGC AGCCACACCT CCAAAGACAA
    CACTCAAACC CAGGGCATGC TGGACCCTTT CCTGTCGTAT CTGTACACAA TAATAACACA
    ATCAATCCAA CAAGCCCTAC CACAGCAACT ATGGCAAATG CAAACCGAGG GCCCACTAGC
    CCATCTGTTA CAGCGATAGA GCTAATTCCC TCAGTCACCA ATCCAGAAAA CCTTCCATCG
    TTACCAGATA TTCCACCTAT ACAGTTGGAA GATGCTGGCT CAAGTAGTTT AGATAATCTA
    CTAAGTAGAT ATATCTCAGG CAGTCACCTA CCCCCACAGC CTACAAGTAC CATGAATCCT
    TCCCCAGGAC CCTCTGCTTT ATCACCAGGA TCTTCAGGTT TATCCAATTC TCACACACCT
    GTGAGACCCC CTAGTACTTC CAGTACTGGC AGTCGAGGCA GCTGTGGATC ATCAGGAAGA
    ACTGCTGAGA AGGCAGGTCT TAGTTTCAAA TCTGATCAGG TGAAGGTCAA GCAAGAACCT
    GGGACTGAAG ATGAAATATG TAGCTTTTCG GGAGCTGTGA AGCAAGAAAA GACTGAGGAT
    GGCAGGAGGA GTGCGTGCAT GTTGAGCAGT CCTGAGAGTA GTTTGACACC ACCTCTCTCA
    ACCAACCTAC ATCTAGAGAG TGAGTTGGAT ACATTAACAA GCCTGGAGAA CCATGTGAAA
    GCTGAACCTA CAGATACGAA TGAAAGCTGC AAACAGTCAG GGCTCAGTAG CCTAGTTAAT
    GGGAAATCTC CAATTCGAAG CCTCATGCAC AGATCGGCAA GGATTGGAGG AGATGGCAGT
    AGCAAAGATG AGGACCCAAA TGAAGACTGG TGTGCTGTCT GCCAAAATGG AGGGGATCTT
    TTGTGCTGTG AAAAATGTCC AAAGGTCTTT CATCTAACTT GTCATGTTCC AACACTTCTT
    AGCTTTCCAA GTGGGGACTG GATATGCACA TTTTGCAGAG ATATTGGGAA ACCAGAAGTT
    GAATATGATT GTGATAATTT GCAACACAGT AAGAAGGGGA AAACTGCACA GGGCTTAAGC
    CCCGTGGACC AAAGGAAATG TGAACGTCTT CTACTTTATC TCTATTGCCA TGAATTAAGT
    ATTGAATTCC AGGAGCCTGT TCCTGTTTCG ATACCAAACT ACTATAAAAT TATAAAGAAA
    CCAATGGATT TATCTACCGT GAAAAAGAAG CTTCAGAAAA AACATTCCCA ACATTACCAA
    GTCCCAGATG ATTTTGTGGC TGATGTCCGC TTGATCTTCA AGAACTGTGA AAGGTTTAAT
    GAAATGATGA AAGTTGTTCA AGTTTATGCA GACACACAAG AGATTAATTT GAAGGCTGAT
    TCAGAAGTAG CTCAGGCAGG GAAAGCAGTT GCATTGTACT TTGAAGATAA ACTCTCAGAG
    ATCTACTCAG ACAGGACCTT CGCTCCTTTG CCAGAGTTTG AACAGGAAGA GGATGATGGT
    GATGTTACGG AGGACTCTGA TGAAGACTTT ATACAACCCC GTAGAAAACG CCTAAAGTCA
    GATGAGAGAC CAGTACATAT AAAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa130252
    Clone ID Related Accession (Same CDS sequence) XM_029563996.1
    Accession Version XM_029563996.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3336bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product E3 ubiquitin-protein ligase TRIM33 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008339435.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGCGGAAA ACAAAGGCGG CGGCGAGGCA GAGAGTGGCG GCGGGGGCAG CGGCAGCGCG 
    CCGGTAACCG CAGGGGCGGC CGGGCCCGCG GCGCAGGAGG CNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNTCGGGCT CGGCTCCTGC CGCATCGGCC
    CCTGCGCCCT CCGTGGGCCC TGCGGTCCCC GGGGGCGCGG CATCCACGCC GGCCCCGTCG
    CCAGCGTCCG CCCCGGCTCC GGGTCCCTCG TCGGGGCCGC CTCTCGGGCC GCCAGCCTCG
    CTCCTGGACA CCTGCGCGGT GTGTCAGCAG AGCCTGCAGA GCCGGCGTGA GGCGGAGCCC
    AAGCTGCTGC CCTGCCTGCA CTCCTTCTGC CTGCGCTGCC TGCCGGAGCC CGAGCGCCAG
    CTCAGCGTGC CCATCCCCGG GGGCAGCAAC GGCGACATCC AGCAAGTTGG TGTAATACGG
    TGTCCAGTAT GCCGTCAGGA ATGCAGACAG ATAGATCTTG TGGATAATTA TTTTGTGAAA
    GACACAACTG AAGCCCCTAG CAGTTCTGAT GAGAAATCAG AACAGGTATG TACTAGTTGT
    GAAGACAATG CCAGTGCAGT AGGTTTTTGT GTAGAGTGTG GAGAGTGGCT TTGTAAGACA
    TGCATTGAAG CACATCAGAG AGTGAAGTTC ACTAAAGATC ATTTGATCAG GAAAAAAGAA
    GATGTCTCAG AGTCTGTCGG AGCATCTGGT CAGCGTCCTG TTTTTTGCCC TGTACACAAA
    CAAGAGCAAT TGAAACTTTT CTGTGAAACA TGTGATAGAC TGACATGTAG AGACTGTCAG
    CTATTGGAGC ACAAAGAACA TAGGTATCAG TTTTTGGAAG AAGCTTTTCA AAATCAAAAA
    GGTGCCATTG AGAATCTGTT GGCTAAACTT CTTGAAAAGA AGAATTATGT TCATTTTGCA
    GCTACACAGG TGCAGAATAG GATAAAAGAA GTAAATGAGA CTAACAAACG AGTAGAACAG
    GAAATTAAAG TGGCCATTTT CACCCTTATC AATGAAATTA ATAAGAAAGG AAAATCTCTC
    TTACAGCAGC TAGAGAATGT TACAAAAGAA AGACAGATGA AACTACTACA GCAGCAGAAT
    GACATCACAG GCCTCTCCCG GCAGGTGAAG CATGTTATGA ACTTTACAAA CTGGGCAATT
    GCAAGTGGCA GCAGCACAGC ACTACTGTAT AGCAAACGTC TGATTACTTT TCAGTTACGT
    CATATTTTGA AAGCACGATG TGATCCTGTT CCTGCTGCCA ATGGAGCAAT TCGTTTCCAT
    TGTGATCCCA CCTTCTGGGC CAAAAATGTA GTGAACTTAG GTAATCTAGT AATAGAGAGC
    AAACCAGCTC CTGGTTATAC TCCTAATGTT GTAGTTGGGC AAGTTCCTCC AGGGACAAAC
    CACATCAGTA AAACCCCTGG ACAGATTAAT TTAGCGCAGC TTCGACTCCA GCACATGCAA
    CAACAAGTGT ATGCACAGAA GCATCAACAG TTACAGCAGA TGAGAATGCA GCAACCACCT
    GCTCCTGTAC CAACAACAAC AACAACAACA CAGCAACATC CTAGACAAGC AGCCCCACAG
    ATGTTACAAC AACAGCCTCC AAGATTGATC AGTGTGCAAA CAATGCAAAG AGGCAACATG
    AACTGTGGAG CATTTCAAGC CCATCAAATG AGACTGGCTC AGAATGCTGC CAGAATACCA
    GGGATACCCA GGCACAGTGG CCCTCAGTAT TCCATGATGC AGCCACACCT CCAAAGACAA
    CACTCAAACC CAGGGCATGC TGGACCCTTT CCTGTCGTAT CTGTACACAA TAATAACACA
    ATCAATCCAA CAAGCCCTAC CACAGCAACT ATGGCAAATG CAAACCGAGG GCCCACTAGC
    CCATCTGTTA CAGCGATAGA GCTAATTCCC TCAGTCACCA ATCCAGAAAA CCTTCCATCG
    TTACCAGATA TTCCACCTAT ACAGTTGGAA GATGCTGGCT CAAGTAGTTT AGATAATCTA
    CTAAGTAGAT ATATCTCAGG CAGTCACCTA CCCCCACAGC CTACAAGTAC CATGAATCCT
    TCCCCAGGAC CCTCTGCTTT ATCACCAGGA TCTTCAGGTT TATCCAATTC TCACACACCT
    GTGAGACCCC CTAGTACTTC CAGTACTGGC AGTCGAGGCA GCTGTGGATC ATCAGGAAGA
    ACTGCTGAGA AGGCAGGTCT TAGTTTCAAA TCTGATCAGG TGAAGGTCAA GCAAGAACCT
    GGGACTGAAG ATGAAATATG TAGCTTTTCG GGAGCTGTGA AGCAAGAAAA GACTGAGGAT
    GGCAGGAGGA GTGCGTGCAT GTTGAGCAGT CCTGAGAGTA GTTTGACACC ACCTCTCTCA
    ACCAACCTAC ATCTAGAGAG TGAGTTGGAT ACATTAACAA GCCTGGAGAA CCATGTGAAA
    GCTGAACCTA CAGATACGAA TGAAAGCTGC AAACAGTCAG GGCTCAGTAG CCTAGTTAAT
    GGGAAATCTC CAATTCGAAG CCTCATGCAC AGATCGGCAA GGATTGGAGG AGATGGCAGT
    AGCAAAGATG AGGACCCAAA TGAAGACTGG TGTGCTGTCT GCCAAAATGG AGGGGATCTT
    TTGTGCTGTG AAAAATGTCC AAAGGTCTTT CATCTAACTT GTCATGTTCC AACACTTCTT
    AGCTTTCCAA GTGGGGACTG GATATGCACA TTTTGCAGAG ATATTGGGAA ACCAGAAGTT
    GAATATGATT GTGATAATTT GCAACACAGT AAGAAGGGGA AAACTGCACA GGGCTTAAGC
    CCCGTGGACC AAAGGAAATG TGAACGTCTT CTACTTTATC TCTATTGCCA TGAATTAAGT
    ATTGAATTCC AGGAGCCTGT TCCTGTTTCG ATACCAAACT ACTATAAAAT TATAAAGAAA
    CCAATGGATT TATCTACCGT GAAAAAGAAG CTTCAGAAAA AACATTCCCA ACATTACCAA
    GTCCCAGATG ATTTTGTGGC TGATGTCCGC TTGATCTTCA AGAACTGTGA AAGGTTTAAT
    GAAGCTGATT CAGAAGTAGC TCAGGCAGGG AAAGCAGTTG CATTGTACTT TGAAGATAAA
    CTCTCAGAGA TCTACTCAGA CAGGACCTTC GCTCCTTTGC CAGAGTTTGA ACAGGAAGAG
    GATGATGGTG ATGTTACGGA GGACTCTGAT GAAGACTTTA TACAACCCCG TAGAAAACGC
    CTAAAGTCAG ATGAGAGACC AGTACATATA AAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029419856.1
    CDS156..3491
    Translation

    Target ORF information:

    RefSeq Version XM_029563996.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili tripartite motif containing 33 (Trim33), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029563996.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGCGGAAA ACAAAGGCGG CGGCGAGGCA GAGAGTGGCG GCGGGGGCAG CGGCAGCGCG 
    CCGGTAACCG CAGGGGCGGC CGGGCCCGCG GCGCAGGAGG CNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN
    NNNNNNNNNN NNNNNNNNNN NNNNNNNNNN NNNTCGGGCT CGGCTCCTGC CGCATCGGCC
    CCTGCGCCCT CCGTGGGCCC TGCGGTCCCC GGGGGCGCGG CATCCACGCC GGCCCCGTCG
    CCAGCGTCCG CCCCGGCTCC GGGTCCCTCG TCGGGGCCGC CTCTCGGGCC GCCAGCCTCG
    CTCCTGGACA CCTGCGCGGT GTGTCAGCAG AGCCTGCAGA GCCGGCGTGA GGCGGAGCCC
    AAGCTGCTGC CCTGCCTGCA CTCCTTCTGC CTGCGCTGCC TGCCGGAGCC CGAGCGCCAG
    CTCAGCGTGC CCATCCCCGG GGGCAGCAAC GGCGACATCC AGCAAGTTGG TGTAATACGG
    TGTCCAGTAT GCCGTCAGGA ATGCAGACAG ATAGATCTTG TGGATAATTA TTTTGTGAAA
    GACACAACTG AAGCCCCTAG CAGTTCTGAT GAGAAATCAG AACAGGTATG TACTAGTTGT
    GAAGACAATG CCAGTGCAGT AGGTTTTTGT GTAGAGTGTG GAGAGTGGCT TTGTAAGACA
    TGCATTGAAG CACATCAGAG AGTGAAGTTC ACTAAAGATC ATTTGATCAG GAAAAAAGAA
    GATGTCTCAG AGTCTGTCGG AGCATCTGGT CAGCGTCCTG TTTTTTGCCC TGTACACAAA
    CAAGAGCAAT TGAAACTTTT CTGTGAAACA TGTGATAGAC TGACATGTAG AGACTGTCAG
    CTATTGGAGC ACAAAGAACA TAGGTATCAG TTTTTGGAAG AAGCTTTTCA AAATCAAAAA
    GGTGCCATTG AGAATCTGTT GGCTAAACTT CTTGAAAAGA AGAATTATGT TCATTTTGCA
    GCTACACAGG TGCAGAATAG GATAAAAGAA GTAAATGAGA CTAACAAACG AGTAGAACAG
    GAAATTAAAG TGGCCATTTT CACCCTTATC AATGAAATTA ATAAGAAAGG AAAATCTCTC
    TTACAGCAGC TAGAGAATGT TACAAAAGAA AGACAGATGA AACTACTACA GCAGCAGAAT
    GACATCACAG GCCTCTCCCG GCAGGTGAAG CATGTTATGA ACTTTACAAA CTGGGCAATT
    GCAAGTGGCA GCAGCACAGC ACTACTGTAT AGCAAACGTC TGATTACTTT TCAGTTACGT
    CATATTTTGA AAGCACGATG TGATCCTGTT CCTGCTGCCA ATGGAGCAAT TCGTTTCCAT
    TGTGATCCCA CCTTCTGGGC CAAAAATGTA GTGAACTTAG GTAATCTAGT AATAGAGAGC
    AAACCAGCTC CTGGTTATAC TCCTAATGTT GTAGTTGGGC AAGTTCCTCC AGGGACAAAC
    CACATCAGTA AAACCCCTGG ACAGATTAAT TTAGCGCAGC TTCGACTCCA GCACATGCAA
    CAACAAGTGT ATGCACAGAA GCATCAACAG TTACAGCAGA TGAGAATGCA GCAACCACCT
    GCTCCTGTAC CAACAACAAC AACAACAACA CAGCAACATC CTAGACAAGC AGCCCCACAG
    ATGTTACAAC AACAGCCTCC AAGATTGATC AGTGTGCAAA CAATGCAAAG AGGCAACATG
    AACTGTGGAG CATTTCAAGC CCATCAAATG AGACTGGCTC AGAATGCTGC CAGAATACCA
    GGGATACCCA GGCACAGTGG CCCTCAGTAT TCCATGATGC AGCCACACCT CCAAAGACAA
    CACTCAAACC CAGGGCATGC TGGACCCTTT CCTGTCGTAT CTGTACACAA TAATAACACA
    ATCAATCCAA CAAGCCCTAC CACAGCAACT ATGGCAAATG CAAACCGAGG GCCCACTAGC
    CCATCTGTTA CAGCGATAGA GCTAATTCCC TCAGTCACCA ATCCAGAAAA CCTTCCATCG
    TTACCAGATA TTCCACCTAT ACAGTTGGAA GATGCTGGCT CAAGTAGTTT AGATAATCTA
    CTAAGTAGAT ATATCTCAGG CAGTCACCTA CCCCCACAGC CTACAAGTAC CATGAATCCT
    TCCCCAGGAC CCTCTGCTTT ATCACCAGGA TCTTCAGGTT TATCCAATTC TCACACACCT
    GTGAGACCCC CTAGTACTTC CAGTACTGGC AGTCGAGGCA GCTGTGGATC ATCAGGAAGA
    ACTGCTGAGA AGGCAGGTCT TAGTTTCAAA TCTGATCAGG TGAAGGTCAA GCAAGAACCT
    GGGACTGAAG ATGAAATATG TAGCTTTTCG GGAGCTGTGA AGCAAGAAAA GACTGAGGAT
    GGCAGGAGGA GTGCGTGCAT GTTGAGCAGT CCTGAGAGTA GTTTGACACC ACCTCTCTCA
    ACCAACCTAC ATCTAGAGAG TGAGTTGGAT ACATTAACAA GCCTGGAGAA CCATGTGAAA
    GCTGAACCTA CAGATACGAA TGAAAGCTGC AAACAGTCAG GGCTCAGTAG CCTAGTTAAT
    GGGAAATCTC CAATTCGAAG CCTCATGCAC AGATCGGCAA GGATTGGAGG AGATGGCAGT
    AGCAAAGATG AGGACCCAAA TGAAGACTGG TGTGCTGTCT GCCAAAATGG AGGGGATCTT
    TTGTGCTGTG AAAAATGTCC AAAGGTCTTT CATCTAACTT GTCATGTTCC AACACTTCTT
    AGCTTTCCAA GTGGGGACTG GATATGCACA TTTTGCAGAG ATATTGGGAA ACCAGAAGTT
    GAATATGATT GTGATAATTT GCAACACAGT AAGAAGGGGA AAACTGCACA GGGCTTAAGC
    CCCGTGGACC AAAGGAAATG TGAACGTCTT CTACTTTATC TCTATTGCCA TGAATTAAGT
    ATTGAATTCC AGGAGCCTGT TCCTGTTTCG ATACCAAACT ACTATAAAAT TATAAAGAAA
    CCAATGGATT TATCTACCGT GAAAAAGAAG CTTCAGAAAA AACATTCCCA ACATTACCAA
    GTCCCAGATG ATTTTGTGGC TGATGTCCGC TTGATCTTCA AGAACTGTGA AAGGTTTAAT
    GAAGCTGATT CAGAAGTAGC TCAGGCAGGG AAAGCAGTTG CATTGTACTT TGAAGATAAA
    CTCTCAGAGA TCTACTCAGA CAGGACCTTC GCTCCTTTGC CAGAGTTTGA ACAGGAAGAG
    GATGATGGTG ATGTTACGGA GGACTCTGAT GAAGACTTTA TACAACCCCG TAGAAAACGC
    CTAAAGTCAG ATGAGAGACC AGTACATATA AAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa17742
    Clone ID Related Accession (Same CDS sequence) XM_008834036.2
    Accession Version XM_008834036.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3789bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product E3 ubiquitin-protein ligase TRIM33
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008339435.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008834036.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 14% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGTCGAAGG TGGAGAAAGA AGGCATTGGC AGACTCAGGT GGTCTGCGAC CCTGGAGGAG 
    GCCTCTGCGT CCGAGCGCGC GACAGGTGAA GCATCCCCGG AGGCGCGCCC GTCGCTGGGG
    ACGGCGCCGC CGCGGAGACG TGCGCTCGGA AGGAACGCGG AACGGCCATG CCCCCCCTCT
    CCACATCTTC CCGCCCTTCT CCTCGTACTC GCGGCGGCGC CCGCAGCCCA GCCCCCACCA
    CAGGCTACGC AGCGCCACCG GCTGCGGGCT TTAAACGCGC CTTCTGAGCT CCAGAGCCGC
    TGCGCTGACA GTTCCCGCCT CCCTTCGGAG GACGTCAGCG CGTACGTGCG CGACCCCGCC
    TGCCCTCCTC CTACCGCGCG ACGCGAGGGC GGGGGCACCG CGTGCGCGCG CGCTCTCGCA
    GGTTCGCTCG CTCGTTCTCT CGCTCGCGCT CGGCGTCAGC TCTCGCTGTG GCTGCGGCTG
    AGGCTGGGGG CGGCGGCGGC GGCGCGAGCG GCGGGCGGCG CGGGGCGGTC CGGCGGGTTC
    AAAGAGGAAA ACATGGCGGA AAACAAAGGC GGCGGCGAGG CAGAGAGTGG CGGCGGGGGC
    AGCGGCAGCG CGCCGTCGGG CTCGGCTCCT GCCGCATCGG CCCCTGCGCC CTCCGTGGGC
    CCTGCGGTCC CCGGGGGCGC GGCATCCACG CCGGCCCCGT CGCCAGCGTC CGCCCCGGCT
    CCGGGTCCCT CGTCGGGGCC GCCTCTCGGG CCGCCAGCCT CGCTCCTGGA CACCTGCGCG
    GTGTGTCAGC AGAGCCTGCA GAGCCGGCGT GAGGCGGAGC CCAAGCTGCT GCCCTGCCTG
    CACTCCTTCT GCCTGCGCTG CCTGCCGGAG CCCGAGCGCC AGCTCAGCGT GCCCATCCCC
    GGGGGCAGCA ACGGCGACAT CCAGCAAGTT GGTGTAATAC GGTGTCCAGT ATGCCGTCAG
    GAATGCAGAC AGATAGATCT TGTGGATAAT TATTTTGTGA AAGACACAAC TGAAGCCCCT
    AGCAGTTCTG ATGAGAAATC AGAACAGGTA TGTACTAGTT GTGAAGACAA TGCCAGTGCA
    GTAGGTTTTT GTGTAGAGTG TGGAGAGTGG CTTTGTAAGA CATGCATTGA AGCACATCAG
    AGAGTGAAGT TCACTAAAGA TCATTTGATC AGGAAAAAAG AAGATGTCTC AGAGTCTGTC
    GGAGCATCTG GTCAGCGTCC TGTTTTTTGC CCTGTACACA AACAAGAGCA ATTGAAACTT
    TTCTGTGAAA CATGTGATAG ACTGACATGT AGAGACTGTC AGCTATTGGA GCACAAAGAA
    CATAGGTATC AGTTTTTGGA AGAAGCTTTT CAAAATCAAA AAGGTGCCAT TGAGAATCTG
    TTGGCTAAAC TTCTTGAAAA GAAGAATTAT GTTCATTTTG CAGCTACACA GGTGCAGAAT
    AGGATAAAAG AAGTAAATGA GACTAACAAA CGAGTAGAAC AGGAAATTAA AGTGGCCATT
    TTCACCCTTA TCAATGAAAT TAATAAGAAA GGAAAATCTC TCTTACAGCA GCTAGAGAAT
    GTTACAAAAG AAAGACAGAT GAAACTACTA CAGCAGCAGA ATGACATCAC AGGCCTCTCC
    CGGCAGGTGA AGCATGTTAT GAACTTTACA AACTGGGCAA TTGCAAGTGG CAGCAGCACA
    GCACTACTGT ATAGCAAACG TCTGATTACT TTTCAGTTAC GTCATATTTT GAAAGCACGA
    TGTGATCCTG TTCCTGCTGC CAATGGAGCA ATTCGTTTCC ATTGTGATCC CACCTTCTGG
    GCCAAAAATG TAGTGAACTT AGGTAATCTA GTAATAGAGA GCAAACCAGC TCCTGGTTAT
    ACTCCTAATG TTGTAGTTGG GCAAGTTCCT CCAGGGACAA ACCACATCAG TAAAACCCCT
    GGACAGATTA ATTTAGCGCA GCTTCGACTC CAGCACATGC AACAACAAGT GTATGCACAG
    AAGCATCAAC AGTTACAGCA GATGAGAATG CAGCAACCAC CTGCTCCTGT ACCAACAACA
    ACAACAACAA CACAGCAACA TCCTAGACAA GCAGCCCCAC AGATGTTACA ACAACAGCCT
    CCAAGATTGA TCAGTGTGCA AACAATGCAA AGAGGCAACA TGAACTGTGG AGCATTTCAA
    GCCCATCAAA TGAGACTGGC TCAGAATGCT GCCAGAATAC CAGGGATACC CAGGCACAGT
    GGCCCTCAGT ATTCCATGAT GCAGCCACAC CTCCAAAGAC AACACTCAAA CCCAGGGCAT
    GCTGGACCCT TTCCTGTCGT ATCTGTACAC AATAATAACA CAATCAATCC AACAAGCCCT
    ACCACAGCAA CTATGGCAAA TGCAAACCGA GGGCCCACTA GCCCATCTGT TACAGCGATA
    GAGCTAATTC CCTCAGTCAC CAATCCAGAA AACCTTCCAT CGTTACCAGA TATTCCACCT
    ATACAGTTGG AAGATGCTGG CTCAAGTAGT TTAGATAATC TACTAAGTAG ATATATCTCA
    GGCAGTCACC TACCCCCACA GCCTACAAGT ACCATGAATC CTTCCCCAGG ACCCTCTGCT
    TTATCACCAG GATCTTCAGG TTTATCCAAT TCTCACACAC CTGTGAGACC CCCTAGTACT
    TCCAGTACTG GCAGTCGAGG CAGCTGTGGA TCATCAGGAA GAACTGCTGA GAAGGCAGGT
    CTTAGTTTCA AATCTGATCA GGTGAAGGTC AAGCAAGAAC CTGGGACTGA AGATGAAATA
    TGTAGCTTTT CGGGAGCTGT GAAGCAAGAA AAGACTGAGG ATGGCAGGAG GAGTGCGTGC
    ATGTTGAGCA GTCCTGAGAG TAGTTTGACA CCACCTCTCT CAACCAACCT ACATCTAGAG
    AGTGAGTTGG ATACATTAAC AAGCCTGGAG AACCATGTGA AAGCTGAACC TACAGATACG
    AATGAAAGCT GCAAACAGTC AGGGCTCAGT AGCCTAGTTA ATGGGAAATC TCCAATTCGA
    AGCCTCATGC ACAGATCGGC AAGGATTGGA GGAGATGGCA GTAGCAAAGA TGAGGACCCA
    AATGAAGACT GGTGTGCTGT CTGCCAAAAT GGAGGGGATC TTTTGTGCTG TGAAAAATGT
    CCAAAGGTCT TTCATCTAAC TTGTCATGTT CCAACACTTC TTAGCTTTCC AAGTGGGGAC
    TGGATATGCA CATTTTGCAG AGATATTGGG AAACCAGAAG TTGAATATGA TTGTGATAAT
    TTGCAACACA GTAAGAAGGG GAAAACTGCA CAGGGCTTAA GCCCCGTGGA CCAAAGGAAA
    TGTGAACGTC TTCTACTTTA TCTCTATTGC CATGAATTAA GTATTGAATT CCAGGAGCCT
    GTTCCTGTTT CGATACCAAA CTACTATAAA ATTATAAAGA AACCAATGGA TTTATCTACC
    GTGAAAAAGA AGCTTCAGAA AAAACATTCC CAACATTACC AAGTCCCAGA TGATTTTGTG
    GCTGATGTCC GCTTGATCTT CAAGAACTGT GAAAGGTTTA ATGAAATGAT GAAAGTTGTT
    CAAGTTTATG CAGACACACA AGAGATTAAT TTGAAGGCTG ATTCAGAAGT AGCTCAGGCA
    GGGAAAGCAG TTGCATTGTA CTTTGAAGAT AAACTCTCAG AGATCTACTC AGACAGGACC
    TTCGCTCCTT TGCCAGAGTT TGAACAGGAA GAGGATGATG GTGATGTTAC GGAGGACTCT
    GATGAAGACT TTATACAACC CCGTAGAAAA CGCCTAAAGT CAGATGAGAG ACCAGTACAT
    ATAAAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008832258.1
    CDS1..3789
    Translation

    Target ORF information:

    RefSeq Version XM_008834036.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili tripartite motif containing 33 (Trim33), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008834036.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGTCGAAGG TGGAGAAAGA AGGCATTGGC AGACTCAGGT GGTCTGCGAC CCTGGAGGAG 
    GCCTCTGCGT CCGAGCGCGC GACAGGTGAA GCATCCCCGG AGGCGCGCCC GTCGCTGGGG
    ACGGCGCCGC CGCGGAGACG TGCGCTCGGA AGGAACGCGG AACGGCCATG CCCCCCCTCT
    CCACATCTTC CCGCCCTTCT CCTCGTACTC GCGGCGGCGC CCGCAGCCCA GCCCCCACCA
    CAGGCTACGC AGCGCCACCG GCTGCGGGCT TTAAACGCGC CTTCTGAGCT CCAGAGCCGC
    TGCGCTGACA GTTCCCGCCT CCCTTCGGAG GACGTCAGCG CGTACGTGCG CGACCCCGCC
    TGCCCTCCTC CTACCGCGCG ACGCGAGGGC GGGGGCACCG CGTGCGCGCG CGCTCTCGCA
    GGTTCGCTCG CTCGTTCTCT CGCTCGCGCT CGGCGTCAGC TCTCGCTGTG GCTGCGGCTG
    AGGCTGGGGG CGGCGGCGGC GGCGCGAGCG GCGGGCGGCG CGGGGCGGTC CGGCGGGTTC
    AAAGAGGAAA ACATGGCGGA AAACAAAGGC GGCGGCGAGG CAGAGAGTGG CGGCGGGGGC
    AGCGGCAGCG CGCCGTCGGG CTCGGCTCCT GCCGCATCGG CCCCTGCGCC CTCCGTGGGC
    CCTGCGGTCC CCGGGGGCGC GGCATCCACG CCGGCCCCGT CGCCAGCGTC CGCCCCGGCT
    CCGGGTCCCT CGTCGGGGCC GCCTCTCGGG CCGCCAGCCT CGCTCCTGGA CACCTGCGCG
    GTGTGTCAGC AGAGCCTGCA GAGCCGGCGT GAGGCGGAGC CCAAGCTGCT GCCCTGCCTG
    CACTCCTTCT GCCTGCGCTG CCTGCCGGAG CCCGAGCGCC AGCTCAGCGT GCCCATCCCC
    GGGGGCAGCA ACGGCGACAT CCAGCAAGTT GGTGTAATAC GGTGTCCAGT ATGCCGTCAG
    GAATGCAGAC AGATAGATCT TGTGGATAAT TATTTTGTGA AAGACACAAC TGAAGCCCCT
    AGCAGTTCTG ATGAGAAATC AGAACAGGTA TGTACTAGTT GTGAAGACAA TGCCAGTGCA
    GTAGGTTTTT GTGTAGAGTG TGGAGAGTGG CTTTGTAAGA CATGCATTGA AGCACATCAG
    AGAGTGAAGT TCACTAAAGA TCATTTGATC AGGAAAAAAG AAGATGTCTC AGAGTCTGTC
    GGAGCATCTG GTCAGCGTCC TGTTTTTTGC CCTGTACACA AACAAGAGCA ATTGAAACTT
    TTCTGTGAAA CATGTGATAG ACTGACATGT AGAGACTGTC AGCTATTGGA GCACAAAGAA
    CATAGGTATC AGTTTTTGGA AGAAGCTTTT CAAAATCAAA AAGGTGCCAT TGAGAATCTG
    TTGGCTAAAC TTCTTGAAAA GAAGAATTAT GTTCATTTTG CAGCTACACA GGTGCAGAAT
    AGGATAAAAG AAGTAAATGA GACTAACAAA CGAGTAGAAC AGGAAATTAA AGTGGCCATT
    TTCACCCTTA TCAATGAAAT TAATAAGAAA GGAAAATCTC TCTTACAGCA GCTAGAGAAT
    GTTACAAAAG AAAGACAGAT GAAACTACTA CAGCAGCAGA ATGACATCAC AGGCCTCTCC
    CGGCAGGTGA AGCATGTTAT GAACTTTACA AACTGGGCAA TTGCAAGTGG CAGCAGCACA
    GCACTACTGT ATAGCAAACG TCTGATTACT TTTCAGTTAC GTCATATTTT GAAAGCACGA
    TGTGATCCTG TTCCTGCTGC CAATGGAGCA ATTCGTTTCC ATTGTGATCC CACCTTCTGG
    GCCAAAAATG TAGTGAACTT AGGTAATCTA GTAATAGAGA GCAAACCAGC TCCTGGTTAT
    ACTCCTAATG TTGTAGTTGG GCAAGTTCCT CCAGGGACAA ACCACATCAG TAAAACCCCT
    GGACAGATTA ATTTAGCGCA GCTTCGACTC CAGCACATGC AACAACAAGT GTATGCACAG
    AAGCATCAAC AGTTACAGCA GATGAGAATG CAGCAACCAC CTGCTCCTGT ACCAACAACA
    ACAACAACAA CACAGCAACA TCCTAGACAA GCAGCCCCAC AGATGTTACA ACAACAGCCT
    CCAAGATTGA TCAGTGTGCA AACAATGCAA AGAGGCAACA TGAACTGTGG AGCATTTCAA
    GCCCATCAAA TGAGACTGGC TCAGAATGCT GCCAGAATAC CAGGGATACC CAGGCACAGT
    GGCCCTCAGT ATTCCATGAT GCAGCCACAC CTCCAAAGAC AACACTCAAA CCCAGGGCAT
    GCTGGACCCT TTCCTGTCGT ATCTGTACAC AATAATAACA CAATCAATCC AACAAGCCCT
    ACCACAGCAA CTATGGCAAA TGCAAACCGA GGGCCCACTA GCCCATCTGT TACAGCGATA
    GAGCTAATTC CCTCAGTCAC CAATCCAGAA AACCTTCCAT CGTTACCAGA TATTCCACCT
    ATACAGTTGG AAGATGCTGG CTCAAGTAGT TTAGATAATC TACTAAGTAG ATATATCTCA
    GGCAGTCACC TACCCCCACA GCCTACAAGT ACCATGAATC CTTCCCCAGG ACCCTCTGCT
    TTATCACCAG GATCTTCAGG TTTATCCAAT TCTCACACAC CTGTGAGACC CCCTAGTACT
    TCCAGTACTG GCAGTCGAGG CAGCTGTGGA TCATCAGGAA GAACTGCTGA GAAGGCAGGT
    CTTAGTTTCA AATCTGATCA GGTGAAGGTC AAGCAAGAAC CTGGGACTGA AGATGAAATA
    TGTAGCTTTT CGGGAGCTGT GAAGCAAGAA AAGACTGAGG ATGGCAGGAG GAGTGCGTGC
    ATGTTGAGCA GTCCTGAGAG TAGTTTGACA CCACCTCTCT CAACCAACCT ACATCTAGAG
    AGTGAGTTGG ATACATTAAC AAGCCTGGAG AACCATGTGA AAGCTGAACC TACAGATACG
    AATGAAAGCT GCAAACAGTC AGGGCTCAGT AGCCTAGTTA ATGGGAAATC TCCAATTCGA
    AGCCTCATGC ACAGATCGGC AAGGATTGGA GGAGATGGCA GTAGCAAAGA TGAGGACCCA
    AATGAAGACT GGTGTGCTGT CTGCCAAAAT GGAGGGGATC TTTTGTGCTG TGAAAAATGT
    CCAAAGGTCT TTCATCTAAC TTGTCATGTT CCAACACTTC TTAGCTTTCC AAGTGGGGAC
    TGGATATGCA CATTTTGCAG AGATATTGGG AAACCAGAAG TTGAATATGA TTGTGATAAT
    TTGCAACACA GTAAGAAGGG GAAAACTGCA CAGGGCTTAA GCCCCGTGGA CCAAAGGAAA
    TGTGAACGTC TTCTACTTTA TCTCTATTGC CATGAATTAA GTATTGAATT CCAGGAGCCT
    GTTCCTGTTT CGATACCAAA CTACTATAAA ATTATAAAGA AACCAATGGA TTTATCTACC
    GTGAAAAAGA AGCTTCAGAA AAAACATTCC CAACATTACC AAGTCCCAGA TGATTTTGTG
    GCTGATGTCC GCTTGATCTT CAAGAACTGT GAAAGGTTTA ATGAAATGAT GAAAGTTGTT
    CAAGTTTATG CAGACACACA AGAGATTAAT TTGAAGGCTG ATTCAGAAGT AGCTCAGGCA
    GGGAAAGCAG TTGCATTGTA CTTTGAAGAT AAACTCTCAG AGATCTACTC AGACAGGACC
    TTCGCTCCTT TGCCAGAGTT TGAACAGGAA GAGGATGATG GTGATGTTAC GGAGGACTCT
    GATGAAGACT TTATACAACC CCGTAGAAAA CGCCTAAAGT CAGATGAGAG ACCAGTACAT
    ATAAAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.