Mms19 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

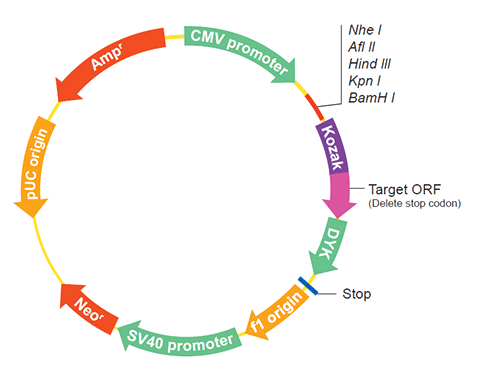
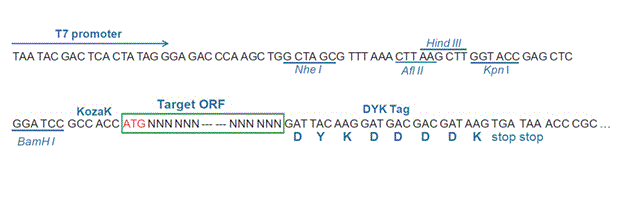
The following Mms19 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Mms19 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa15553 XM_017797860.2
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
ONa15554 XM_008831977.2
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
ONa129390 XM_029563037.1
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa129391 XM_029563038.1
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa129392 XM_029563039.1
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa129393 XM_029563040.1
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa15551 XM_008831975.3
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa15552 XM_008831976.2
Latest version!
Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
View Old Accession Versions >>
ONa15553 XM_017797860.1 Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
ONa15551 XM_008831975.2 Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa15553
    Clone ID Related Accession (Same CDS sequence) XM_017797860.1 , XM_017797860.2
    Accession Version XM_017797860.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2997bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGCACCACC ACGCCCGGCC CAGTTTTTGC TCTTTAAGAG GGTGTGGCTC TGCTTCTTTG 
    CCTGGGTGGT CCTCTCTAGA GAACCCAGAA CCTCGAACTC GGGCACGAGG GATTCAGCTT
    TTGTCGCAGG TGCTACTCCA GTGCCACTCC TTGCTCCTGG AGAAGGAAGT GGTACACCTG
    ATCCTATTCT ATGAGAACCG ACTAAAGGAC CATCATCTTG TGATTCCATC TGTCCTTCAG
    GGCTTGAGAG CACTTAGCCT GTGTGTGGCC CTGCCCCCAG GGCTGGCTGT CTCAGTGCTC
    AAAGCCATTT TCCAGGAGGT TCATGTTCAG TCCCTGCTAC AAGTGGATCG CCACACAGTG
    TTCAGTATCA TCACCAACTT CATGCAATCC CGAGAAGAAG AGTTAAAAGA CCTAGGAGCT
    GACTTCACAT TTGGCTTCAT CCAGGTGATG GATGGAGAAA AGGATCCCCG TAATCTTCTG
    GTTGCTTTCC ACATCGTCCA TGACCTCATT TCCAGGGACT ATAGCCTGGG ACCTTTTGTG
    GAAGAGTTAT TTGAAGTGAC ATCTTGTTAT TTCCCTATTG ATTTTACCCC TCCACCAAAT
    GATCCCTATG GCATCCAGAG AGATGATCTC ATCCTGAGTC TTCGTGCTGT GCTGGCTTCT
    ACACCACGAT TTGCTGAGTT CCTGCTTCCC CTGCTGATTG AGAAAGTAGA TTCTGAAATT
    CTAAGTGCCA AATTGGATTC TCTGCAAACC TTGAATGCTT GCTGTGCTGT GTATGGACAG
    AAGGAACTAA AGGACTTCCT CCCCAGCCTT TGGGCTTCCA TCCGCAGAGA GGTGTTCCAG
    ACAGCAAGTG AACGAGTGGA GGCAGAGGGG CTGGCAGCCC TCCATTCCCT GACTGCGTGT
    TTGTCTCGAT CTGTGCTGAG GGCTGATGCT GAGGACCTCC TTAATTCCTT TCTTAGCAAC
    ATTCTACAGG ACTGCAGGCA CCATCTATGT GAACCAGACA TGAAGCTGGT ATGGCCTAGT
    GCCAAGCTGC TGCAGACAGC TGCAGGTGCA TCTGCCCGGG CCTGTGACCA CATCACCAGC
    AATGTACTTC CCTTGCTGCT GGAACAGTTC CATAAGCACA GTCAGAGCAA CCAGCGGCGG
    ACAATCCTTG AAATGATCCT GGGTTTCTTA AAGCTGCAGC AGAAATGGAG CTATGAAGAC
    AAAGATGAAA GACCTCTGAG TGGCTTCAAG GACCAGCTGT GCTCATTGGT ATTCATGGCC
    ATAACAGACC CCAGCACCCA GCTTCAGCTT GTTGGCATCC GGACGCTCAC AGTCTTGGGT
    GCCCAGCCAG ATCTCCTATC TTCTGGGGAC TTGGAGCTGG CAATAGGTCA CCTGTACAGA
    CTGAGCTTCC TGGAGGAAGA CTCCCAGAGT TGTAGGATGG CAGCACTGGA GGCATCAGGA
    GCCCTTGCCT CTTTCTATCC TGGAGCCTTC AGCAGCTACC TCCTACCTAA GCTTGCTAAA
    GAGCTGCAGA GAGGGGAGTT AGATGTGACT AGAGAGCATG GTCCCAACAA ATGTTCCCGG
    CATCTCCTCT GTCTGCAAGC TTTGTCAGCT GTTTCAACAC ATCCTAGCAT TGTCAAGGAG
    ACACTGCCTC TGCTGCTGCA GCATCTCTGG CAGGCAAACA AAGGAAATGT GGTTATAGGA
    TTCAATGACA TTATTGCTAT CTGCCAGAGT CTCCAGCAGG TGGCAGAAAA ATGCCACCGG
    GACCCTGACA GCTGCTGGTA TTTCCATGAG ACTGCTCTAC CCTGCCTGTT TGCTTTGGCT
    GTACAGGCTT CCATGCCAGA GGACTCCTCA GTTCTGAGAA AAGTACTATT GGAAGATGAG
    GTCTTAGCTG CCTTGGCATC TGTCATCAGC ACTGCCACTA TCCACCTGAG CTCTGAGTTA
    GCTGCCCAGA GTGTCACCCG CATTGTGCCC CTCTTCTTAG ATGGCAACAT CTCCTTTCTT
    CCTGAAAACA GCTTCCCAAG CCGGTTCCAG CCATTCCAGG ATGGCTGCTC CAGGCAGAGG
    CGGCTGGTTG TACTTCTTAT GGCTTTTGTC TGCTCCCTGC CACGAAATGT GGAAATCCCT
    CAACTGACCC AACTCATGAG GGAGCTTTTG GAACTGAGCT GCTGTCCTGG CTGTCCCTTC
    TCCTCCACTG CTGCCGCCAA GTGCTTTGCA GGACTTCTCA ACAAGCACCC TGCAGGGCAG
    CAATTGGATG AATTCCTCCA GCTTGCTGTA GACACAGTGG AGGCCGGCTT AGGCGCTGGG
    TCCTCTCGTA GTCAGGCTTT TACACTACTA CTCTGGGTGA CCAAGGCTTT AGTACTCAGA
    TACCATCCTC TCAGCTCCTG CCTTACAGCC CGGCTCATGG GCCTTCTGAG TGATCCAGAA
    CTAGGCCCTG CAGCAGCTGA TGGCTTCTCT CTGCTTATGT CTGACTGCAC TGATGTGCTG
    ACCCGAGCCT GCCATGCTGA CGTGCGGATC ATGTTCCGTC AGCGGTTCTT CACGGATAAC
    GTACCTGATT TAGTCCAAGG TTTCCATGCT GCTCCCCAAG ATGTGAAGCC AAACTACTTG
    AAGGGTCTGT CTCATGTACT GAACAGGCTG CCCAAGCCTG TGCTCTTACC AGAGCTGCCC
    ACACTCCTTT CCTTGCTGCT GGAGGCGCTA TCCTGCACTG ACTCTGTGGT CCAGCTTTCT
    ACCCTCAGCT GCCTTCAGCC TCTTCTACTG GAAGCACCAC AAATTATGAG TCTTCACATT
    GATACTCTGG TTACCAAATT TCTGAACCTC AGCTCCAGCC CTTCCATGGC TGTCCGGATT
    GCTGCACTGC AGTGCATGAA TGCTCTCACT CACCTACCCA CTCCTGTGCT ACTGCCATAT
    AAACCACAGG TGATCCGGGC CTTAGCCAAG CCTCTAGATG ACAAGAAGAG ATTAGTACGC
    AAGGAAGCCG TGTCAGCTAG GGGAGAATGG TTCCTATTGG GAAGCCCAGG CAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653349.1
    CDS23..3019
    Translation

    Target ORF information:

    RefSeq Version XM_017797860.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797860.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGCACCACC ACGCCCGGCC CAGTTTTTGC TCTTTAAGAG GGTGTGGCTC TGCTTCTTTG 
    CCTGGGTGGT CCTCTCTAGA GAACCCAGAA CCTCGAACTC GGGCACGAGG GATTCAGCTT
    TTGTCGCAGG TGCTACTCCA GTGCCACTCC TTGCTCCTGG AGAAGGAAGT GGTACACCTG
    ATCCTATTCT ATGAGAACCG ACTAAAGGAC CATCATCTTG TGATTCCATC TGTCCTTCAG
    GGCTTGAGAG CACTTAGCCT GTGTGTGGCC CTGCCCCCAG GGCTGGCTGT CTCAGTGCTC
    AAAGCCATTT TCCAGGAGGT TCATGTTCAG TCCCTGCTAC AAGTGGATCG CCACACAGTG
    TTCAGTATCA TCACCAACTT CATGCAATCC CGAGAAGAAG AGTTAAAAGA CCTAGGAGCT
    GACTTCACAT TTGGCTTCAT CCAGGTGATG GATGGAGAAA AGGATCCCCG TAATCTTCTG
    GTTGCTTTCC ACATCGTCCA TGACCTCATT TCCAGGGACT ATAGCCTGGG ACCTTTTGTG
    GAAGAGTTAT TTGAAGTGAC ATCTTGTTAT TTCCCTATTG ATTTTACCCC TCCACCAAAT
    GATCCCTATG GCATCCAGAG AGATGATCTC ATCCTGAGTC TTCGTGCTGT GCTGGCTTCT
    ACACCACGAT TTGCTGAGTT CCTGCTTCCC CTGCTGATTG AGAAAGTAGA TTCTGAAATT
    CTAAGTGCCA AATTGGATTC TCTGCAAACC TTGAATGCTT GCTGTGCTGT GTATGGACAG
    AAGGAACTAA AGGACTTCCT CCCCAGCCTT TGGGCTTCCA TCCGCAGAGA GGTGTTCCAG
    ACAGCAAGTG AACGAGTGGA GGCAGAGGGG CTGGCAGCCC TCCATTCCCT GACTGCGTGT
    TTGTCTCGAT CTGTGCTGAG GGCTGATGCT GAGGACCTCC TTAATTCCTT TCTTAGCAAC
    ATTCTACAGG ACTGCAGGCA CCATCTATGT GAACCAGACA TGAAGCTGGT ATGGCCTAGT
    GCCAAGCTGC TGCAGACAGC TGCAGGTGCA TCTGCCCGGG CCTGTGACCA CATCACCAGC
    AATGTACTTC CCTTGCTGCT GGAACAGTTC CATAAGCACA GTCAGAGCAA CCAGCGGCGG
    ACAATCCTTG AAATGATCCT GGGTTTCTTA AAGCTGCAGC AGAAATGGAG CTATGAAGAC
    AAAGATGAAA GACCTCTGAG TGGCTTCAAG GACCAGCTGT GCTCATTGGT ATTCATGGCC
    ATAACAGACC CCAGCACCCA GCTTCAGCTT GTTGGCATCC GGACGCTCAC AGTCTTGGGT
    GCCCAGCCAG ATCTCCTATC TTCTGGGGAC TTGGAGCTGG CAATAGGTCA CCTGTACAGA
    CTGAGCTTCC TGGAGGAAGA CTCCCAGAGT TGTAGGATGG CAGCACTGGA GGCATCAGGA
    GCCCTTGCCT CTTTCTATCC TGGAGCCTTC AGCAGCTACC TCCTACCTAA GCTTGCTAAA
    GAGCTGCAGA GAGGGGAGTT AGATGTGACT AGAGAGCATG GTCCCAACAA ATGTTCCCGG
    CATCTCCTCT GTCTGCAAGC TTTGTCAGCT GTTTCAACAC ATCCTAGCAT TGTCAAGGAG
    ACACTGCCTC TGCTGCTGCA GCATCTCTGG CAGGCAAACA AAGGAAATGT GGTTATAGGA
    TTCAATGACA TTATTGCTAT CTGCCAGAGT CTCCAGCAGG TGGCAGAAAA ATGCCACCGG
    GACCCTGACA GCTGCTGGTA TTTCCATGAG ACTGCTCTAC CCTGCCTGTT TGCTTTGGCT
    GTACAGGCTT CCATGCCAGA GGACTCCTCA GTTCTGAGAA AAGTACTATT GGAAGATGAG
    GTCTTAGCTG CCTTGGCATC TGTCATCAGC ACTGCCACTA TCCACCTGAG CTCTGAGTTA
    GCTGCCCAGA GTGTCACCCG CATTGTGCCC CTCTTCTTAG ATGGCAACAT CTCCTTTCTT
    CCTGAAAACA GCTTCCCAAG CCGGTTCCAG CCATTCCAGG ATGGCTGCTC CAGGCAGAGG
    CGGCTGGTTG TACTTCTTAT GGCTTTTGTC TGCTCCCTGC CACGAAATGT GGAAATCCCT
    CAACTGACCC AACTCATGAG GGAGCTTTTG GAACTGAGCT GCTGTCCTGG CTGTCCCTTC
    TCCTCCACTG CTGCCGCCAA GTGCTTTGCA GGACTTCTCA ACAAGCACCC TGCAGGGCAG
    CAATTGGATG AATTCCTCCA GCTTGCTGTA GACACAGTGG AGGCCGGCTT AGGCGCTGGG
    TCCTCTCGTA GTCAGGCTTT TACACTACTA CTCTGGGTGA CCAAGGCTTT AGTACTCAGA
    TACCATCCTC TCAGCTCCTG CCTTACAGCC CGGCTCATGG GCCTTCTGAG TGATCCAGAA
    CTAGGCCCTG CAGCAGCTGA TGGCTTCTCT CTGCTTATGT CTGACTGCAC TGATGTGCTG
    ACCCGAGCCT GCCATGCTGA CGTGCGGATC ATGTTCCGTC AGCGGTTCTT CACGGATAAC
    GTACCTGATT TAGTCCAAGG TTTCCATGCT GCTCCCCAAG ATGTGAAGCC AAACTACTTG
    AAGGGTCTGT CTCATGTACT GAACAGGCTG CCCAAGCCTG TGCTCTTACC AGAGCTGCCC
    ACACTCCTTT CCTTGCTGCT GGAGGCGCTA TCCTGCACTG ACTCTGTGGT CCAGCTTTCT
    ACCCTCAGCT GCCTTCAGCC TCTTCTACTG GAAGCACCAC AAATTATGAG TCTTCACATT
    GATACTCTGG TTACCAAATT TCTGAACCTC AGCTCCAGCC CTTCCATGGC TGTCCGGATT
    GCTGCACTGC AGTGCATGAA TGCTCTCACT CACCTACCCA CTCCTGTGCT ACTGCCATAT
    AAACCACAGG TGATCCGGGC CTTAGCCAAG CCTCTAGATG ACAAGAAGAG ATTAGTACGC
    AAGGAAGCCG TGTCAGCTAG GGGAGAATGG TTCCTATTGG GAAGCCCAGG CAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa15553
    Clone ID Related Accession (Same CDS sequence) XM_017797860.1 , XM_017797860.2
    Accession Version XM_017797860.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2997bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017797860.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGCACCACC ACGCCCGGCC CAGTTTTTGC TCTTTAAGAG GGTGTGGCTC TGCTTCTTTG 
    CCTGGGTGGT CCTCTCTAGA GAACCCAGAA CCTCGAACTC GGGCACGAGG GATTCAGCTT
    TTGTCGCAGG TGCTACTCCA GTGCCACTCC TTGCTCCTGG AGAAGGAAGT GGTACACCTG
    ATCCTATTCT ATGAGAACCG ACTAAAGGAC CATCATCTTG TGATTCCATC TGTCCTTCAG
    GGCTTGAGAG CACTTAGCCT GTGTGTGGCC CTGCCCCCAG GGCTGGCTGT CTCAGTGCTC
    AAAGCCATTT TCCAGGAGGT TCATGTTCAG TCCCTGCTAC AAGTGGATCG CCACACAGTG
    TTCAGTATCA TCACCAACTT CATGCAATCC CGAGAAGAAG AGTTAAAAGA CCTAGGAGCT
    GACTTCACAT TTGGCTTCAT CCAGGTGATG GATGGAGAAA AGGATCCCCG TAATCTTCTG
    GTTGCTTTCC ACATCGTCCA TGACCTCATT TCCAGGGACT ATAGCCTGGG ACCTTTTGTG
    GAAGAGTTAT TTGAAGTGAC ATCTTGTTAT TTCCCTATTG ATTTTACCCC TCCACCAAAT
    GATCCCTATG GCATCCAGAG AGATGATCTC ATCCTGAGTC TTCGTGCTGT GCTGGCTTCT
    ACACCACGAT TTGCTGAGTT CCTGCTTCCC CTGCTGATTG AGAAAGTAGA TTCTGAAATT
    CTAAGTGCCA AATTGGATTC TCTGCAAACC TTGAATGCTT GCTGTGCTGT GTATGGACAG
    AAGGAACTAA AGGACTTCCT CCCCAGCCTT TGGGCTTCCA TCCGCAGAGA GGTGTTCCAG
    ACAGCAAGTG AACGAGTGGA GGCAGAGGGG CTGGCAGCCC TCCATTCCCT GACTGCGTGT
    TTGTCTCGAT CTGTGCTGAG GGCTGATGCT GAGGACCTCC TTAATTCCTT TCTTAGCAAC
    ATTCTACAGG ACTGCAGGCA CCATCTATGT GAACCAGACA TGAAGCTGGT ATGGCCTAGT
    GCCAAGCTGC TGCAGACAGC TGCAGGTGCA TCTGCCCGGG CCTGTGACCA CATCACCAGC
    AATGTACTTC CCTTGCTGCT GGAACAGTTC CATAAGCACA GTCAGAGCAA CCAGCGGCGG
    ACAATCCTTG AAATGATCCT GGGTTTCTTA AAGCTGCAGC AGAAATGGAG CTATGAAGAC
    AAAGATGAAA GACCTCTGAG TGGCTTCAAG GACCAGCTGT GCTCATTGGT ATTCATGGCC
    ATAACAGACC CCAGCACCCA GCTTCAGCTT GTTGGCATCC GGACGCTCAC AGTCTTGGGT
    GCCCAGCCAG ATCTCCTATC TTCTGGGGAC TTGGAGCTGG CAATAGGTCA CCTGTACAGA
    CTGAGCTTCC TGGAGGAAGA CTCCCAGAGT TGTAGGATGG CAGCACTGGA GGCATCAGGA
    GCCCTTGCCT CTTTCTATCC TGGAGCCTTC AGCAGCTACC TCCTACCTAA GCTTGCTAAA
    GAGCTGCAGA GAGGGGAGTT AGATGTGACT AGAGAGCATG GTCCCAACAA ATGTTCCCGG
    CATCTCCTCT GTCTGCAAGC TTTGTCAGCT GTTTCAACAC ATCCTAGCAT TGTCAAGGAG
    ACACTGCCTC TGCTGCTGCA GCATCTCTGG CAGGCAAACA AAGGAAATGT GGTTATAGGA
    TTCAATGACA TTATTGCTAT CTGCCAGAGT CTCCAGCAGG TGGCAGAAAA ATGCCACCGG
    GACCCTGACA GCTGCTGGTA TTTCCATGAG ACTGCTCTAC CCTGCCTGTT TGCTTTGGCT
    GTACAGGCTT CCATGCCAGA GGACTCCTCA GTTCTGAGAA AAGTACTATT GGAAGATGAG
    GTCTTAGCTG CCTTGGCATC TGTCATCAGC ACTGCCACTA TCCACCTGAG CTCTGAGTTA
    GCTGCCCAGA GTGTCACCCG CATTGTGCCC CTCTTCTTAG ATGGCAACAT CTCCTTTCTT
    CCTGAAAACA GCTTCCCAAG CCGGTTCCAG CCATTCCAGG ATGGCTGCTC CAGGCAGAGG
    CGGCTGGTTG TACTTCTTAT GGCTTTTGTC TGCTCCCTGC CACGAAATGT GGAAATCCCT
    CAACTGACCC AACTCATGAG GGAGCTTTTG GAACTGAGCT GCTGTCCTGG CTGTCCCTTC
    TCCTCCACTG CTGCCGCCAA GTGCTTTGCA GGACTTCTCA ACAAGCACCC TGCAGGGCAG
    CAATTGGATG AATTCCTCCA GCTTGCTGTA GACACAGTGG AGGCCGGCTT AGGCGCTGGG
    TCCTCTCGTA GTCAGGCTTT TACACTACTA CTCTGGGTGA CCAAGGCTTT AGTACTCAGA
    TACCATCCTC TCAGCTCCTG CCTTACAGCC CGGCTCATGG GCCTTCTGAG TGATCCAGAA
    CTAGGCCCTG CAGCAGCTGA TGGCTTCTCT CTGCTTATGT CTGACTGCAC TGATGTGCTG
    ACCCGAGCCT GCCATGCTGA CGTGCGGATC ATGTTCCGTC AGCGGTTCTT CACGGATAAC
    GTACCTGATT TAGTCCAAGG TTTCCATGCT GCTCCCCAAG ATGTGAAGCC AAACTACTTG
    AAGGGTCTGT CTCATGTACT GAACAGGCTG CCCAAGCCTG TGCTCTTACC AGAGCTGCCC
    ACACTCCTTT CCTTGCTGCT GGAGGCGCTA TCCTGCACTG ACTCTGTGGT CCAGCTTTCT
    ACCCTCAGCT GCCTTCAGCC TCTTCTACTG GAAGCACCAC AAATTATGAG TCTTCACATT
    GATACTCTGG TTACCAAATT TCTGAACCTC AGCTCCAGCC CTTCCATGGC TGTCCGGATT
    GCTGCACTGC AGTGCATGAA TGCTCTCACT CACCTACCCA CTCCTGTGCT ACTGCCATAT
    AAACCACAGG TGATCCGGGC CTTAGCCAAG CCTCTAGATG ACAAGAAGAG ATTAGTACGC
    AAGGAAGCCG TGTCAGCTAG GGGAGAATGG TTCCTATTGG GAAGCCCAGG CAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653349.1
    CDS58..3054
    Translation

    Target ORF information:

    RefSeq Version XM_017797860.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797860.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGCACCACC ACGCCCGGCC CAGTTTTTGC TCTTTAAGAG GGTGTGGCTC TGCTTCTTTG 
    CCTGGGTGGT CCTCTCTAGA GAACCCAGAA CCTCGAACTC GGGCACGAGG GATTCAGCTT
    TTGTCGCAGG TGCTACTCCA GTGCCACTCC TTGCTCCTGG AGAAGGAAGT GGTACACCTG
    ATCCTATTCT ATGAGAACCG ACTAAAGGAC CATCATCTTG TGATTCCATC TGTCCTTCAG
    GGCTTGAGAG CACTTAGCCT GTGTGTGGCC CTGCCCCCAG GGCTGGCTGT CTCAGTGCTC
    AAAGCCATTT TCCAGGAGGT TCATGTTCAG TCCCTGCTAC AAGTGGATCG CCACACAGTG
    TTCAGTATCA TCACCAACTT CATGCAATCC CGAGAAGAAG AGTTAAAAGA CCTAGGAGCT
    GACTTCACAT TTGGCTTCAT CCAGGTGATG GATGGAGAAA AGGATCCCCG TAATCTTCTG
    GTTGCTTTCC ACATCGTCCA TGACCTCATT TCCAGGGACT ATAGCCTGGG ACCTTTTGTG
    GAAGAGTTAT TTGAAGTGAC ATCTTGTTAT TTCCCTATTG ATTTTACCCC TCCACCAAAT
    GATCCCTATG GCATCCAGAG AGATGATCTC ATCCTGAGTC TTCGTGCTGT GCTGGCTTCT
    ACACCACGAT TTGCTGAGTT CCTGCTTCCC CTGCTGATTG AGAAAGTAGA TTCTGAAATT
    CTAAGTGCCA AATTGGATTC TCTGCAAACC TTGAATGCTT GCTGTGCTGT GTATGGACAG
    AAGGAACTAA AGGACTTCCT CCCCAGCCTT TGGGCTTCCA TCCGCAGAGA GGTGTTCCAG
    ACAGCAAGTG AACGAGTGGA GGCAGAGGGG CTGGCAGCCC TCCATTCCCT GACTGCGTGT
    TTGTCTCGAT CTGTGCTGAG GGCTGATGCT GAGGACCTCC TTAATTCCTT TCTTAGCAAC
    ATTCTACAGG ACTGCAGGCA CCATCTATGT GAACCAGACA TGAAGCTGGT ATGGCCTAGT
    GCCAAGCTGC TGCAGACAGC TGCAGGTGCA TCTGCCCGGG CCTGTGACCA CATCACCAGC
    AATGTACTTC CCTTGCTGCT GGAACAGTTC CATAAGCACA GTCAGAGCAA CCAGCGGCGG
    ACAATCCTTG AAATGATCCT GGGTTTCTTA AAGCTGCAGC AGAAATGGAG CTATGAAGAC
    AAAGATGAAA GACCTCTGAG TGGCTTCAAG GACCAGCTGT GCTCATTGGT ATTCATGGCC
    ATAACAGACC CCAGCACCCA GCTTCAGCTT GTTGGCATCC GGACGCTCAC AGTCTTGGGT
    GCCCAGCCAG ATCTCCTATC TTCTGGGGAC TTGGAGCTGG CAATAGGTCA CCTGTACAGA
    CTGAGCTTCC TGGAGGAAGA CTCCCAGAGT TGTAGGATGG CAGCACTGGA GGCATCAGGA
    GCCCTTGCCT CTTTCTATCC TGGAGCCTTC AGCAGCTACC TCCTACCTAA GCTTGCTAAA
    GAGCTGCAGA GAGGGGAGTT AGATGTGACT AGAGAGCATG GTCCCAACAA ATGTTCCCGG
    CATCTCCTCT GTCTGCAAGC TTTGTCAGCT GTTTCAACAC ATCCTAGCAT TGTCAAGGAG
    ACACTGCCTC TGCTGCTGCA GCATCTCTGG CAGGCAAACA AAGGAAATGT GGTTATAGGA
    TTCAATGACA TTATTGCTAT CTGCCAGAGT CTCCAGCAGG TGGCAGAAAA ATGCCACCGG
    GACCCTGACA GCTGCTGGTA TTTCCATGAG ACTGCTCTAC CCTGCCTGTT TGCTTTGGCT
    GTACAGGCTT CCATGCCAGA GGACTCCTCA GTTCTGAGAA AAGTACTATT GGAAGATGAG
    GTCTTAGCTG CCTTGGCATC TGTCATCAGC ACTGCCACTA TCCACCTGAG CTCTGAGTTA
    GCTGCCCAGA GTGTCACCCG CATTGTGCCC CTCTTCTTAG ATGGCAACAT CTCCTTTCTT
    CCTGAAAACA GCTTCCCAAG CCGGTTCCAG CCATTCCAGG ATGGCTGCTC CAGGCAGAGG
    CGGCTGGTTG TACTTCTTAT GGCTTTTGTC TGCTCCCTGC CACGAAATGT GGAAATCCCT
    CAACTGACCC AACTCATGAG GGAGCTTTTG GAACTGAGCT GCTGTCCTGG CTGTCCCTTC
    TCCTCCACTG CTGCCGCCAA GTGCTTTGCA GGACTTCTCA ACAAGCACCC TGCAGGGCAG
    CAATTGGATG AATTCCTCCA GCTTGCTGTA GACACAGTGG AGGCCGGCTT AGGCGCTGGG
    TCCTCTCGTA GTCAGGCTTT TACACTACTA CTCTGGGTGA CCAAGGCTTT AGTACTCAGA
    TACCATCCTC TCAGCTCCTG CCTTACAGCC CGGCTCATGG GCCTTCTGAG TGATCCAGAA
    CTAGGCCCTG CAGCAGCTGA TGGCTTCTCT CTGCTTATGT CTGACTGCAC TGATGTGCTG
    ACCCGAGCCT GCCATGCTGA CGTGCGGATC ATGTTCCGTC AGCGGTTCTT CACGGATAAC
    GTACCTGATT TAGTCCAAGG TTTCCATGCT GCTCCCCAAG ATGTGAAGCC AAACTACTTG
    AAGGGTCTGT CTCATGTACT GAACAGGCTG CCCAAGCCTG TGCTCTTACC AGAGCTGCCC
    ACACTCCTTT CCTTGCTGCT GGAGGCGCTA TCCTGCACTG ACTCTGTGGT CCAGCTTTCT
    ACCCTCAGCT GCCTTCAGCC TCTTCTACTG GAAGCACCAC AAATTATGAG TCTTCACATT
    GATACTCTGG TTACCAAATT TCTGAACCTC AGCTCCAGCC CTTCCATGGC TGTCCGGATT
    GCTGCACTGC AGTGCATGAA TGCTCTCACT CACCTACCCA CTCCTGTGCT ACTGCCATAT
    AAACCACAGG TGATCCGGGC CTTAGCCAAG CCTCTAGATG ACAAGAAGAG ATTAGTACGC
    AAGGAAGCCG TGTCAGCTAG GGGAGAATGG TTCCTATTGG GAAGCCCAGG CAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa15554
    Clone ID Related Accession (Same CDS sequence) XM_008831977.2
    Accession Version XM_008831977.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2616bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008831977.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGCAATCCC GAGAAGAAGA GTTAAAAGAC CTAGGAGCTG ACTTCACATT TGGCTTCATC 
    CAGGTGATGG ATGGAGAAAA GGATCCCCGT AATCTTCTGG TTGCTTTCCA CATCGTCCAT
    GACCTCATTT CCAGGGACTA TAGCCTGGGA CCTTTTGTGG AAGAGTTATT TGAAGTGACA
    TCTTGTTATT TCCCTATTGA TTTTACCCCT CCACCAAATG ATCCCTATGG CATCCAGAGA
    GATGATCTCA TCCTGAGTCT TCGTGCTGTG CTGGCTTCTA CACCACGATT TGCTGAGTTC
    CTGCTTCCCC TGCTGATTGA GAAAGTAGAT TCTGAAATTC TAAGTGCCAA ATTGGATTCT
    CTGCAAACCT TGAATGCTTG CTGTGCTGTG TATGGACAGA AGGAACTAAA GGACTTCCTC
    CCCAGCCTTT GGGCTTCCAT CCGCAGAGAG GTGTTCCAGA CAGCAAGTGA ACGAGTGGAG
    GCAGAGGGGC TGGCAGCCCT CCATTCCCTG ACTGCGTGTT TGTCTCGATC TGTGCTGAGG
    GCTGATGCTG AGGACCTCCT TAATTCCTTT CTTAGCAACA TTCTACAGGA CTGCAGGCAC
    CATCTATGTG AACCAGACAT GAAGCTGGTA TGGCCTAGTG CCAAGCTGCT GCAGACAGCT
    GCAGGTGCAT CTGCCCGGGC CTGTGACCAC ATCACCAGCA ATGTACTTCC CTTGCTGCTG
    GAACAGTTCC ATAAGCACAG TCAGAGCAAC CAGCGGCGGA CAATCCTTGA AATGATCCTG
    GGTTTCTTAA AGCTGCAGCA GAAATGGAGC TATGAAGACA AAGATGAAAG ACCTCTGAGT
    GGCTTCAAGG ACCAGCTGTG CTCATTGGTA TTCATGGCCA TAACAGACCC CAGCACCCAG
    CTTCAGCTTG TTGGCATCCG GACGCTCACA GTCTTGGGTG CCCAGCCAGA TCTCCTATCT
    TCTGGGGACT TGGAGCTGGC AATAGGTCAC CTGTACAGAC TGAGCTTCCT GGAGGAAGAC
    TCCCAGAGTT GTAGGATGGC AGCACTGGAG GCATCAGGAG CCCTTGCCTC TTTCTATCCT
    GGAGCCTTCA GCAGCTACCT CCTACCTAAG CTTGCTAAAG AGCTGCAGAG AGGGGAGTTA
    GATGTGACTA GAGAGCATGG TCCCAACAAA TGTTCCCGGC ATCTCCTCTG TCTGCAAGCT
    TTGTCAGCTG TTTCAACACA TCCTAGCATT GTCAAGGAGA CACTGCCTCT GCTGCTGCAG
    CATCTCTGGC AGGCAAACAA AGGAAATGTG GTTATAGGAT TCAATGACAT TATTGCTATC
    TGCCAGAGTC TCCAGCAGGT GGCAGAAAAA TGCCACCGGG ACCCTGACAG CTGCTGGTAT
    TTCCATGAGA CTGCTCTACC CTGCCTGTTT GCTTTGGCTG TACAGGCTTC CATGCCAGAG
    GACTCCTCAG TTCTGAGAAA AGTACTATTG GAAGATGAGG TCTTAGCTGC CTTGGCATCT
    GTCATCAGCA CTGCCACTAT CCACCTGAGC TCTGAGTTAG CTGCCCAGAG TGTCACCCGC
    ATTGTGCCCC TCTTCTTAGA TGGCAACATC TCCTTTCTTC CTGAAAACAG CTTCCCAAGC
    CGGTTCCAGC CATTCCAGGA TGGCTGCTCC AGGCAGAGGC GGCTGGTTGT ACTTCTTATG
    GCTTTTGTCT GCTCCCTGCC ACGAAATGTG GAAATCCCTC AACTGACCCA ACTCATGAGG
    GAGCTTTTGG AACTGAGCTG CTGTCCTGGC TGTCCCTTCT CCTCCACTGC TGCCGCCAAG
    TGCTTTGCAG GACTTCTCAA CAAGCACCCT GCAGGGCAGC AATTGGATGA ATTCCTCCAG
    CTTGCTGTAG ACACAGTGGA GGCCGGCTTA GGCGCTGGGT CCTCTCGTAG TCAGGCTTTT
    ACACTACTAC TCTGGGTGAC CAAGGCTTTA GTACTCAGAT ACCATCCTCT CAGCTCCTGC
    CTTACAGCCC GGCTCATGGG CCTTCTGAGT GATCCAGAAC TAGGCCCTGC AGCAGCTGAT
    GGCTTCTCTC TGCTTATGTC TGACTGCACT GATGTGCTGA CCCGAGCCTG CCATGCTGAC
    GTGCGGATCA TGTTCCGTCA GCGGTTCTTC ACGGATAACG TACCTGATTT AGTCCAAGGT
    TTCCATGCTG CTCCCCAAGA TGTGAAGCCA AACTACTTGA AGGGTCTGTC TCATGTACTG
    AACAGGCTGC CCAAGCCTGT GCTCTTACCA GAGCTGCCCA CACTCCTTTC CTTGCTGCTG
    GAGGCGCTAT CCTGCACTGA CTCTGTGGTC CAGCTTTCTA CCCTCAGCTG CCTTCAGCCT
    CTTCTACTGG AAGCACCACA AATTATGAGT CTTCACATTG ATACTCTGGT TACCAAATTT
    CTGAACCTCA GCTCCAGCCC TTCCATGGCT GTCCGGATTG CTGCACTGCA GTGCATGAAT
    GCTCTCACTC ACCTACCCAC TCCTGTGCTA CTGCCATATA AACCACAGGT GATCCGGGCC
    TTAGCCAAGC CTCTAGATGA CAAGAAGAGA TTAGTACGCA AGGAAGCCGT GTCAGCTAGG
    GGAGAATGGT TCCTATTGGG AAGCCCAGGC AGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008830199.1
    CDS380..2995
    Translation

    Target ORF information:

    RefSeq Version XM_008831977.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008831977.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGCAATCCC GAGAAGAAGA GTTAAAAGAC CTAGGAGCTG ACTTCACATT TGGCTTCATC 
    CAGGTGATGG ATGGAGAAAA GGATCCCCGT AATCTTCTGG TTGCTTTCCA CATCGTCCAT
    GACCTCATTT CCAGGGACTA TAGCCTGGGA CCTTTTGTGG AAGAGTTATT TGAAGTGACA
    TCTTGTTATT TCCCTATTGA TTTTACCCCT CCACCAAATG ATCCCTATGG CATCCAGAGA
    GATGATCTCA TCCTGAGTCT TCGTGCTGTG CTGGCTTCTA CACCACGATT TGCTGAGTTC
    CTGCTTCCCC TGCTGATTGA GAAAGTAGAT TCTGAAATTC TAAGTGCCAA ATTGGATTCT
    CTGCAAACCT TGAATGCTTG CTGTGCTGTG TATGGACAGA AGGAACTAAA GGACTTCCTC
    CCCAGCCTTT GGGCTTCCAT CCGCAGAGAG GTGTTCCAGA CAGCAAGTGA ACGAGTGGAG
    GCAGAGGGGC TGGCAGCCCT CCATTCCCTG ACTGCGTGTT TGTCTCGATC TGTGCTGAGG
    GCTGATGCTG AGGACCTCCT TAATTCCTTT CTTAGCAACA TTCTACAGGA CTGCAGGCAC
    CATCTATGTG AACCAGACAT GAAGCTGGTA TGGCCTAGTG CCAAGCTGCT GCAGACAGCT
    GCAGGTGCAT CTGCCCGGGC CTGTGACCAC ATCACCAGCA ATGTACTTCC CTTGCTGCTG
    GAACAGTTCC ATAAGCACAG TCAGAGCAAC CAGCGGCGGA CAATCCTTGA AATGATCCTG
    GGTTTCTTAA AGCTGCAGCA GAAATGGAGC TATGAAGACA AAGATGAAAG ACCTCTGAGT
    GGCTTCAAGG ACCAGCTGTG CTCATTGGTA TTCATGGCCA TAACAGACCC CAGCACCCAG
    CTTCAGCTTG TTGGCATCCG GACGCTCACA GTCTTGGGTG CCCAGCCAGA TCTCCTATCT
    TCTGGGGACT TGGAGCTGGC AATAGGTCAC CTGTACAGAC TGAGCTTCCT GGAGGAAGAC
    TCCCAGAGTT GTAGGATGGC AGCACTGGAG GCATCAGGAG CCCTTGCCTC TTTCTATCCT
    GGAGCCTTCA GCAGCTACCT CCTACCTAAG CTTGCTAAAG AGCTGCAGAG AGGGGAGTTA
    GATGTGACTA GAGAGCATGG TCCCAACAAA TGTTCCCGGC ATCTCCTCTG TCTGCAAGCT
    TTGTCAGCTG TTTCAACACA TCCTAGCATT GTCAAGGAGA CACTGCCTCT GCTGCTGCAG
    CATCTCTGGC AGGCAAACAA AGGAAATGTG GTTATAGGAT TCAATGACAT TATTGCTATC
    TGCCAGAGTC TCCAGCAGGT GGCAGAAAAA TGCCACCGGG ACCCTGACAG CTGCTGGTAT
    TTCCATGAGA CTGCTCTACC CTGCCTGTTT GCTTTGGCTG TACAGGCTTC CATGCCAGAG
    GACTCCTCAG TTCTGAGAAA AGTACTATTG GAAGATGAGG TCTTAGCTGC CTTGGCATCT
    GTCATCAGCA CTGCCACTAT CCACCTGAGC TCTGAGTTAG CTGCCCAGAG TGTCACCCGC
    ATTGTGCCCC TCTTCTTAGA TGGCAACATC TCCTTTCTTC CTGAAAACAG CTTCCCAAGC
    CGGTTCCAGC CATTCCAGGA TGGCTGCTCC AGGCAGAGGC GGCTGGTTGT ACTTCTTATG
    GCTTTTGTCT GCTCCCTGCC ACGAAATGTG GAAATCCCTC AACTGACCCA ACTCATGAGG
    GAGCTTTTGG AACTGAGCTG CTGTCCTGGC TGTCCCTTCT CCTCCACTGC TGCCGCCAAG
    TGCTTTGCAG GACTTCTCAA CAAGCACCCT GCAGGGCAGC AATTGGATGA ATTCCTCCAG
    CTTGCTGTAG ACACAGTGGA GGCCGGCTTA GGCGCTGGGT CCTCTCGTAG TCAGGCTTTT
    ACACTACTAC TCTGGGTGAC CAAGGCTTTA GTACTCAGAT ACCATCCTCT CAGCTCCTGC
    CTTACAGCCC GGCTCATGGG CCTTCTGAGT GATCCAGAAC TAGGCCCTGC AGCAGCTGAT
    GGCTTCTCTC TGCTTATGTC TGACTGCACT GATGTGCTGA CCCGAGCCTG CCATGCTGAC
    GTGCGGATCA TGTTCCGTCA GCGGTTCTTC ACGGATAACG TACCTGATTT AGTCCAAGGT
    TTCCATGCTG CTCCCCAAGA TGTGAAGCCA AACTACTTGA AGGGTCTGTC TCATGTACTG
    AACAGGCTGC CCAAGCCTGT GCTCTTACCA GAGCTGCCCA CACTCCTTTC CTTGCTGCTG
    GAGGCGCTAT CCTGCACTGA CTCTGTGGTC CAGCTTTCTA CCCTCAGCTG CCTTCAGCCT
    CTTCTACTGG AAGCACCACA AATTATGAGT CTTCACATTG ATACTCTGGT TACCAAATTT
    CTGAACCTCA GCTCCAGCCC TTCCATGGCT GTCCGGATTG CTGCACTGCA GTGCATGAAT
    GCTCTCACTC ACCTACCCAC TCCTGTGCTA CTGCCATATA AACCACAGGT GATCCGGGCC
    TTAGCCAAGC CTCTAGATGA CAAGAAGAGA TTAGTACGCA AGGAAGCCGT GTCAGCTAGG
    GGAGAATGGT TCCTATTGGG AAGCCCAGGC AGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa129390
    Clone ID Related Accession (Same CDS sequence) XM_029563037.1
    Accession Version XM_029563037.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3189bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGTAGGAT GGCAGCACTG
    GAGGCATCAG GAGCCCTTGC CTCTTTCTAT CCTGGAGCCT TCAGCAGCTA CCTCCTACCT
    AAGCTTGCTA AAGAGCTGCA GAGAGGGGAG TTAGATGTGA CTAGAGAGCA TGGTCCCAAC
    AAATGTTCCC GGCATCTCCT CTGTCTGCAA GCTTTGTCAG CTGTTTCAAC ACATCCTAGC
    ATTGTCAAGG AGACACTGCC TCTGCTGCTG CAGCATCTCT GGCAGGCAAA CAAAGGAAAT
    GTGGTTATAG GATTCAATGA CATTATTGCT ATCTGCCAGA GTCTCCAGCA GGTGGCAGAA
    AAATGCCACC GGGACCCTGA CAGCTGCTGG TATTTCCATG AGACTGCTCT ACCCTGCCTG
    TTTGCTTTGG CTGTACAGGC TTCCATGCCA GAGGACTCCT CAGTTCTGAG AAAAGTACTA
    TTGGAAGATG AGGTCTTAGC TGCCTTGGCA TCTGTCATCA GCACTGCCAC TATCCACCTG
    AGCTCTGAGT TAGCTGCCCA GAGTGTCACC CGCATTGTGC CCCTCTTCTT AGATGGCAAC
    ATCTCCTTTC TTCCTGAAAA CAGCTTCCCA AGCCGGTTCC AGCCATTCCA GGATGGCTGC
    TCCAGGCAGA GGCGGCTGGT TGTACTTCTT ATGGCTTTTG TCTGCTCCCT GCCACGAAAT
    GTGGAAATCC CTCAACTGAC CCAACTCATG AGGGAGCTTT TGGAACTGAG CTGCTGTCCT
    GGCTGTCCCT TCTCCTCCAC TGCTGCCGCC AAGTGCTTTG CAGGACTTCT CAACAAGCAC
    CCTGCAGGGC AGCAATTGGA TGAATTCCTC CAGCTTGCTG TAGACACAGT GGAGGCCGGC
    TTAGGCGCTG GGTCCTCTCG TAGTCAGGCT TTTACACTAC TACTCTGGGT GACCAAGGCT
    TTAGTACTCA GATACCATCC TCTCAGCTCC TGCCTTACAG CCCGGCTCAT GGGCCTTCTG
    AGTGATCCAG AACTAGGCCC TGCAGCAGCT GATGGCTTCT CTCTGCTTAT GTCTGACTGC
    ACTGATGTGC TGACCCGAGC CTGCCATGCT GACGTGCGGA TCATGTTCCG TCAGCGGTTC
    TTCACGGATA ACGTACCTGA TTTAGTCCAA GGTTTCCATG CTGCTCCCCA AGATGTGAAG
    CCAAACTACT TGAAGGGTCT GTCTCATGTA CTGAACAGGC TGCCCAAGCC TGTGCTCTTA
    CCAGAGCTGC CCACACTCCT TTCCTTGCTG CTGGAGGCGC TATCCTGCAC TGACTCTGTG
    GTCCAGCTTT CTACCCTCAG CTGCCTTCAG CCTCTTCTAC TGGAAGCACC ACAAATTATG
    AGTCTTCACA TTGATACTCT GGTTACCAAA TTTCTGAACC TCAGCTCCAG CCCTTCCATG
    GCTGTCCGGA TTGCTGCACT GCAGTGCATG AATGCTCTCA CTCACCTACC CACTCCTGTG
    CTACTGCCAT ATAAACCACA GGTGATCCGG GCCTTAGCCA AGCCTCTAGA TGACAAGAAG
    AGATTAGTAC GCAAGGAAGC CGTGTCAGCT AGGGGAGAAT GGTTCCTATT GGGAAGCCCA
    GGCAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418897.1
    CDS21..3209
    Translation

    Target ORF information:

    RefSeq Version XM_029563037.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029563037.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGTAGGAT GGCAGCACTG
    GAGGCATCAG GAGCCCTTGC CTCTTTCTAT CCTGGAGCCT TCAGCAGCTA CCTCCTACCT
    AAGCTTGCTA AAGAGCTGCA GAGAGGGGAG TTAGATGTGA CTAGAGAGCA TGGTCCCAAC
    AAATGTTCCC GGCATCTCCT CTGTCTGCAA GCTTTGTCAG CTGTTTCAAC ACATCCTAGC
    ATTGTCAAGG AGACACTGCC TCTGCTGCTG CAGCATCTCT GGCAGGCAAA CAAAGGAAAT
    GTGGTTATAG GATTCAATGA CATTATTGCT ATCTGCCAGA GTCTCCAGCA GGTGGCAGAA
    AAATGCCACC GGGACCCTGA CAGCTGCTGG TATTTCCATG AGACTGCTCT ACCCTGCCTG
    TTTGCTTTGG CTGTACAGGC TTCCATGCCA GAGGACTCCT CAGTTCTGAG AAAAGTACTA
    TTGGAAGATG AGGTCTTAGC TGCCTTGGCA TCTGTCATCA GCACTGCCAC TATCCACCTG
    AGCTCTGAGT TAGCTGCCCA GAGTGTCACC CGCATTGTGC CCCTCTTCTT AGATGGCAAC
    ATCTCCTTTC TTCCTGAAAA CAGCTTCCCA AGCCGGTTCC AGCCATTCCA GGATGGCTGC
    TCCAGGCAGA GGCGGCTGGT TGTACTTCTT ATGGCTTTTG TCTGCTCCCT GCCACGAAAT
    GTGGAAATCC CTCAACTGAC CCAACTCATG AGGGAGCTTT TGGAACTGAG CTGCTGTCCT
    GGCTGTCCCT TCTCCTCCAC TGCTGCCGCC AAGTGCTTTG CAGGACTTCT CAACAAGCAC
    CCTGCAGGGC AGCAATTGGA TGAATTCCTC CAGCTTGCTG TAGACACAGT GGAGGCCGGC
    TTAGGCGCTG GGTCCTCTCG TAGTCAGGCT TTTACACTAC TACTCTGGGT GACCAAGGCT
    TTAGTACTCA GATACCATCC TCTCAGCTCC TGCCTTACAG CCCGGCTCAT GGGCCTTCTG
    AGTGATCCAG AACTAGGCCC TGCAGCAGCT GATGGCTTCT CTCTGCTTAT GTCTGACTGC
    ACTGATGTGC TGACCCGAGC CTGCCATGCT GACGTGCGGA TCATGTTCCG TCAGCGGTTC
    TTCACGGATA ACGTACCTGA TTTAGTCCAA GGTTTCCATG CTGCTCCCCA AGATGTGAAG
    CCAAACTACT TGAAGGGTCT GTCTCATGTA CTGAACAGGC TGCCCAAGCC TGTGCTCTTA
    CCAGAGCTGC CCACACTCCT TTCCTTGCTG CTGGAGGCGC TATCCTGCAC TGACTCTGTG
    GTCCAGCTTT CTACCCTCAG CTGCCTTCAG CCTCTTCTAC TGGAAGCACC ACAAATTATG
    AGTCTTCACA TTGATACTCT GGTTACCAAA TTTCTGAACC TCAGCTCCAG CCCTTCCATG
    GCTGTCCGGA TTGCTGCACT GCAGTGCATG AATGCTCTCA CTCACCTACC CACTCCTGTG
    CTACTGCCAT ATAAACCACA GGTGATCCGG GCCTTAGCCA AGCCTCTAGA TGACAAGAAG
    AGATTAGTAC GCAAGGAAGC CGTGTCAGCT AGGGGAGAAT GGTTCCTATT GGGAAGCCCA
    GGCAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa129391
    Clone ID Related Accession (Same CDS sequence) XM_029563038.1
    Accession Version XM_029563038.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3186bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGGATGGC AGCACTGGAG
    GCATCAGGAG CCCTTGCCTC TTTCTATCCT GGAGCCTTCA GCAGCTACCT CCTACCTAAG
    CTTGCTAAAG AGCTGCAGAG AGGGGAGTTA GATGTGACTA GAGAGCATGG TCCCAACAAA
    TGTTCCCGGC ATCTCCTCTG TCTGCAAGCT TTGTCAGCTG TTTCAACACA TCCTAGCATT
    GTCAAGGAGA CACTGCCTCT GCTGCTGCAG CATCTCTGGC AGGCAAACAA AGGAAATGTG
    GTTATAGGAT TCAATGACAT TATTGCTATC TGCCAGAGTC TCCAGCAGGT GGCAGAAAAA
    TGCCACCGGG ACCCTGACAG CTGCTGGTAT TTCCATGAGA CTGCTCTACC CTGCCTGTTT
    GCTTTGGCTG TACAGGCTTC CATGCCAGAG GACTCCTCAG TTCTGAGAAA AGTACTATTG
    GAAGATGAGG TCTTAGCTGC CTTGGCATCT GTCATCAGCA CTGCCACTAT CCACCTGAGC
    TCTGAGTTAG CTGCCCAGAG TGTCACCCGC ATTGTGCCCC TCTTCTTAGA TGGCAACATC
    TCCTTTCTTC CTGAAAACAG CTTCCCAAGC CGGTTCCAGC CATTCCAGGA TGGCTGCTCC
    AGGCAGAGGC GGCTGGTTGT ACTTCTTATG GCTTTTGTCT GCTCCCTGCC ACGAAATGTG
    GAAATCCCTC AACTGACCCA ACTCATGAGG GAGCTTTTGG AACTGAGCTG CTGTCCTGGC
    TGTCCCTTCT CCTCCACTGC TGCCGCCAAG TGCTTTGCAG GACTTCTCAA CAAGCACCCT
    GCAGGGCAGC AATTGGATGA ATTCCTCCAG CTTGCTGTAG ACACAGTGGA GGCCGGCTTA
    GGCGCTGGGT CCTCTCGTAG TCAGGCTTTT ACACTACTAC TCTGGGTGAC CAAGGCTTTA
    GTACTCAGAT ACCATCCTCT CAGCTCCTGC CTTACAGCCC GGCTCATGGG CCTTCTGAGT
    GATCCAGAAC TAGGCCCTGC AGCAGCTGAT GGCTTCTCTC TGCTTATGTC TGACTGCACT
    GATGTGCTGA CCCGAGCCTG CCATGCTGAC GTGCGGATCA TGTTCCGTCA GCGGTTCTTC
    ACGGATAACG TACCTGATTT AGTCCAAGGT TTCCATGCTG CTCCCCAAGA TGTGAAGCCA
    AACTACTTGA AGGGTCTGTC TCATGTACTG AACAGGCTGC CCAAGCCTGT GCTCTTACCA
    GAGCTGCCCA CACTCCTTTC CTTGCTGCTG GAGGCGCTAT CCTGCACTGA CTCTGTGGTC
    CAGCTTTCTA CCCTCAGCTG CCTTCAGCCT CTTCTACTGG AAGCACCACA AATTATGAGT
    CTTCACATTG ATACTCTGGT TACCAAATTT CTGAACCTCA GCTCCAGCCC TTCCATGGCT
    GTCCGGATTG CTGCACTGCA GTGCATGAAT GCTCTCACTC ACCTACCCAC TCCTGTGCTA
    CTGCCATATA AACCACAGGT GATCCGGGCC TTAGCCAAGC CTCTAGATGA CAAGAAGAGA
    TTAGTACGCA AGGAAGCCGT GTCAGCTAGG GGAGAATGGT TCCTATTGGG AAGCCCAGGC
    AGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418898.1
    CDS21..3206
    Translation

    Target ORF information:

    RefSeq Version XM_029563038.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029563038.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGGATGGC AGCACTGGAG
    GCATCAGGAG CCCTTGCCTC TTTCTATCCT GGAGCCTTCA GCAGCTACCT CCTACCTAAG
    CTTGCTAAAG AGCTGCAGAG AGGGGAGTTA GATGTGACTA GAGAGCATGG TCCCAACAAA
    TGTTCCCGGC ATCTCCTCTG TCTGCAAGCT TTGTCAGCTG TTTCAACACA TCCTAGCATT
    GTCAAGGAGA CACTGCCTCT GCTGCTGCAG CATCTCTGGC AGGCAAACAA AGGAAATGTG
    GTTATAGGAT TCAATGACAT TATTGCTATC TGCCAGAGTC TCCAGCAGGT GGCAGAAAAA
    TGCCACCGGG ACCCTGACAG CTGCTGGTAT TTCCATGAGA CTGCTCTACC CTGCCTGTTT
    GCTTTGGCTG TACAGGCTTC CATGCCAGAG GACTCCTCAG TTCTGAGAAA AGTACTATTG
    GAAGATGAGG TCTTAGCTGC CTTGGCATCT GTCATCAGCA CTGCCACTAT CCACCTGAGC
    TCTGAGTTAG CTGCCCAGAG TGTCACCCGC ATTGTGCCCC TCTTCTTAGA TGGCAACATC
    TCCTTTCTTC CTGAAAACAG CTTCCCAAGC CGGTTCCAGC CATTCCAGGA TGGCTGCTCC
    AGGCAGAGGC GGCTGGTTGT ACTTCTTATG GCTTTTGTCT GCTCCCTGCC ACGAAATGTG
    GAAATCCCTC AACTGACCCA ACTCATGAGG GAGCTTTTGG AACTGAGCTG CTGTCCTGGC
    TGTCCCTTCT CCTCCACTGC TGCCGCCAAG TGCTTTGCAG GACTTCTCAA CAAGCACCCT
    GCAGGGCAGC AATTGGATGA ATTCCTCCAG CTTGCTGTAG ACACAGTGGA GGCCGGCTTA
    GGCGCTGGGT CCTCTCGTAG TCAGGCTTTT ACACTACTAC TCTGGGTGAC CAAGGCTTTA
    GTACTCAGAT ACCATCCTCT CAGCTCCTGC CTTACAGCCC GGCTCATGGG CCTTCTGAGT
    GATCCAGAAC TAGGCCCTGC AGCAGCTGAT GGCTTCTCTC TGCTTATGTC TGACTGCACT
    GATGTGCTGA CCCGAGCCTG CCATGCTGAC GTGCGGATCA TGTTCCGTCA GCGGTTCTTC
    ACGGATAACG TACCTGATTT AGTCCAAGGT TTCCATGCTG CTCCCCAAGA TGTGAAGCCA
    AACTACTTGA AGGGTCTGTC TCATGTACTG AACAGGCTGC CCAAGCCTGT GCTCTTACCA
    GAGCTGCCCA CACTCCTTTC CTTGCTGCTG GAGGCGCTAT CCTGCACTGA CTCTGTGGTC
    CAGCTTTCTA CCCTCAGCTG CCTTCAGCCT CTTCTACTGG AAGCACCACA AATTATGAGT
    CTTCACATTG ATACTCTGGT TACCAAATTT CTGAACCTCA GCTCCAGCCC TTCCATGGCT
    GTCCGGATTG CTGCACTGCA GTGCATGAAT GCTCTCACTC ACCTACCCAC TCCTGTGCTA
    CTGCCATATA AACCACAGGT GATCCGGGCC TTAGCCAAGC CTCTAGATGA CAAGAAGAGA
    TTAGTACGCA AGGAAGCCGT GTCAGCTAGG GGAGAATGGT TCCTATTGGG AAGCCCAGGC
    AGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa129392
    Clone ID Related Accession (Same CDS sequence) XM_029563039.1
    Accession Version XM_029563039.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3180bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGTAGGAT GGCAGCACTG
    GAGGCATCAG GAGCCCTTGC CTCTTTCTAT CCTGGAGCCT TCAGCAGCTA CCTCCTACCT
    AAGCTTGCTA AAGAGCTGCA GAGAGATGTG ACTAGAGAGC ATGGTCCCAA CAAATGTTCC
    CGGCATCTCC TCTGTCTGCA AGCTTTGTCA GCTGTTTCAA CACATCCTAG CATTGTCAAG
    GAGACACTGC CTCTGCTGCT GCAGCATCTC TGGCAGGCAA ACAAAGGAAA TGTGGTTATA
    GGATTCAATG ACATTATTGC TATCTGCCAG AGTCTCCAGC AGGTGGCAGA AAAATGCCAC
    CGGGACCCTG ACAGCTGCTG GTATTTCCAT GAGACTGCTC TACCCTGCCT GTTTGCTTTG
    GCTGTACAGG CTTCCATGCC AGAGGACTCC TCAGTTCTGA GAAAAGTACT ATTGGAAGAT
    GAGGTCTTAG CTGCCTTGGC ATCTGTCATC AGCACTGCCA CTATCCACCT GAGCTCTGAG
    TTAGCTGCCC AGAGTGTCAC CCGCATTGTG CCCCTCTTCT TAGATGGCAA CATCTCCTTT
    CTTCCTGAAA ACAGCTTCCC AAGCCGGTTC CAGCCATTCC AGGATGGCTG CTCCAGGCAG
    AGGCGGCTGG TTGTACTTCT TATGGCTTTT GTCTGCTCCC TGCCACGAAA TGTGGAAATC
    CCTCAACTGA CCCAACTCAT GAGGGAGCTT TTGGAACTGA GCTGCTGTCC TGGCTGTCCC
    TTCTCCTCCA CTGCTGCCGC CAAGTGCTTT GCAGGACTTC TCAACAAGCA CCCTGCAGGG
    CAGCAATTGG ATGAATTCCT CCAGCTTGCT GTAGACACAG TGGAGGCCGG CTTAGGCGCT
    GGGTCCTCTC GTAGTCAGGC TTTTACACTA CTACTCTGGG TGACCAAGGC TTTAGTACTC
    AGATACCATC CTCTCAGCTC CTGCCTTACA GCCCGGCTCA TGGGCCTTCT GAGTGATCCA
    GAACTAGGCC CTGCAGCAGC TGATGGCTTC TCTCTGCTTA TGTCTGACTG CACTGATGTG
    CTGACCCGAG CCTGCCATGC TGACGTGCGG ATCATGTTCC GTCAGCGGTT CTTCACGGAT
    AACGTACCTG ATTTAGTCCA AGGTTTCCAT GCTGCTCCCC AAGATGTGAA GCCAAACTAC
    TTGAAGGGTC TGTCTCATGT ACTGAACAGG CTGCCCAAGC CTGTGCTCTT ACCAGAGCTG
    CCCACACTCC TTTCCTTGCT GCTGGAGGCG CTATCCTGCA CTGACTCTGT GGTCCAGCTT
    TCTACCCTCA GCTGCCTTCA GCCTCTTCTA CTGGAAGCAC CACAAATTAT GAGTCTTCAC
    ATTGATACTC TGGTTACCAA ATTTCTGAAC CTCAGCTCCA GCCCTTCCAT GGCTGTCCGG
    ATTGCTGCAC TGCAGTGCAT GAATGCTCTC ACTCACCTAC CCACTCCTGT GCTACTGCCA
    TATAAACCAC AGGTGATCCG GGCCTTAGCC AAGCCTCTAG ATGACAAGAA GAGATTAGTA
    CGCAAGGAAG CCGTGTCAGC TAGGGGAGAA TGGTTCCTAT TGGGAAGCCC AGGCAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418899.1
    CDS21..3200
    Translation

    Target ORF information:

    RefSeq Version XM_029563039.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029563039.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGTAGGAT GGCAGCACTG
    GAGGCATCAG GAGCCCTTGC CTCTTTCTAT CCTGGAGCCT TCAGCAGCTA CCTCCTACCT
    AAGCTTGCTA AAGAGCTGCA GAGAGATGTG ACTAGAGAGC ATGGTCCCAA CAAATGTTCC
    CGGCATCTCC TCTGTCTGCA AGCTTTGTCA GCTGTTTCAA CACATCCTAG CATTGTCAAG
    GAGACACTGC CTCTGCTGCT GCAGCATCTC TGGCAGGCAA ACAAAGGAAA TGTGGTTATA
    GGATTCAATG ACATTATTGC TATCTGCCAG AGTCTCCAGC AGGTGGCAGA AAAATGCCAC
    CGGGACCCTG ACAGCTGCTG GTATTTCCAT GAGACTGCTC TACCCTGCCT GTTTGCTTTG
    GCTGTACAGG CTTCCATGCC AGAGGACTCC TCAGTTCTGA GAAAAGTACT ATTGGAAGAT
    GAGGTCTTAG CTGCCTTGGC ATCTGTCATC AGCACTGCCA CTATCCACCT GAGCTCTGAG
    TTAGCTGCCC AGAGTGTCAC CCGCATTGTG CCCCTCTTCT TAGATGGCAA CATCTCCTTT
    CTTCCTGAAA ACAGCTTCCC AAGCCGGTTC CAGCCATTCC AGGATGGCTG CTCCAGGCAG
    AGGCGGCTGG TTGTACTTCT TATGGCTTTT GTCTGCTCCC TGCCACGAAA TGTGGAAATC
    CCTCAACTGA CCCAACTCAT GAGGGAGCTT TTGGAACTGA GCTGCTGTCC TGGCTGTCCC
    TTCTCCTCCA CTGCTGCCGC CAAGTGCTTT GCAGGACTTC TCAACAAGCA CCCTGCAGGG
    CAGCAATTGG ATGAATTCCT CCAGCTTGCT GTAGACACAG TGGAGGCCGG CTTAGGCGCT
    GGGTCCTCTC GTAGTCAGGC TTTTACACTA CTACTCTGGG TGACCAAGGC TTTAGTACTC
    AGATACCATC CTCTCAGCTC CTGCCTTACA GCCCGGCTCA TGGGCCTTCT GAGTGATCCA
    GAACTAGGCC CTGCAGCAGC TGATGGCTTC TCTCTGCTTA TGTCTGACTG CACTGATGTG
    CTGACCCGAG CCTGCCATGC TGACGTGCGG ATCATGTTCC GTCAGCGGTT CTTCACGGAT
    AACGTACCTG ATTTAGTCCA AGGTTTCCAT GCTGCTCCCC AAGATGTGAA GCCAAACTAC
    TTGAAGGGTC TGTCTCATGT ACTGAACAGG CTGCCCAAGC CTGTGCTCTT ACCAGAGCTG
    CCCACACTCC TTTCCTTGCT GCTGGAGGCG CTATCCTGCA CTGACTCTGT GGTCCAGCTT
    TCTACCCTCA GCTGCCTTCA GCCTCTTCTA CTGGAAGCAC CACAAATTAT GAGTCTTCAC
    ATTGATACTC TGGTTACCAA ATTTCTGAAC CTCAGCTCCA GCCCTTCCAT GGCTGTCCGG
    ATTGCTGCAC TGCAGTGCAT GAATGCTCTC ACTCACCTAC CCACTCCTGT GCTACTGCCA
    TATAAACCAC AGGTGATCCG GGCCTTAGCC AAGCCTCTAG ATGACAAGAA GAGATTAGTA
    CGCAAGGAAG CCGTGTCAGC TAGGGGAGAA TGGTTCCTAT TGGGAAGCCC AGGCAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa129393
    Clone ID Related Accession (Same CDS sequence) XM_029563040.1
    Accession Version XM_029563040.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3177bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGGATGGC AGCACTGGAG
    GCATCAGGAG CCCTTGCCTC TTTCTATCCT GGAGCCTTCA GCAGCTACCT CCTACCTAAG
    CTTGCTAAAG AGCTGCAGAG AGATGTGACT AGAGAGCATG GTCCCAACAA ATGTTCCCGG
    CATCTCCTCT GTCTGCAAGC TTTGTCAGCT GTTTCAACAC ATCCTAGCAT TGTCAAGGAG
    ACACTGCCTC TGCTGCTGCA GCATCTCTGG CAGGCAAACA AAGGAAATGT GGTTATAGGA
    TTCAATGACA TTATTGCTAT CTGCCAGAGT CTCCAGCAGG TGGCAGAAAA ATGCCACCGG
    GACCCTGACA GCTGCTGGTA TTTCCATGAG ACTGCTCTAC CCTGCCTGTT TGCTTTGGCT
    GTACAGGCTT CCATGCCAGA GGACTCCTCA GTTCTGAGAA AAGTACTATT GGAAGATGAG
    GTCTTAGCTG CCTTGGCATC TGTCATCAGC ACTGCCACTA TCCACCTGAG CTCTGAGTTA
    GCTGCCCAGA GTGTCACCCG CATTGTGCCC CTCTTCTTAG ATGGCAACAT CTCCTTTCTT
    CCTGAAAACA GCTTCCCAAG CCGGTTCCAG CCATTCCAGG ATGGCTGCTC CAGGCAGAGG
    CGGCTGGTTG TACTTCTTAT GGCTTTTGTC TGCTCCCTGC CACGAAATGT GGAAATCCCT
    CAACTGACCC AACTCATGAG GGAGCTTTTG GAACTGAGCT GCTGTCCTGG CTGTCCCTTC
    TCCTCCACTG CTGCCGCCAA GTGCTTTGCA GGACTTCTCA ACAAGCACCC TGCAGGGCAG
    CAATTGGATG AATTCCTCCA GCTTGCTGTA GACACAGTGG AGGCCGGCTT AGGCGCTGGG
    TCCTCTCGTA GTCAGGCTTT TACACTACTA CTCTGGGTGA CCAAGGCTTT AGTACTCAGA
    TACCATCCTC TCAGCTCCTG CCTTACAGCC CGGCTCATGG GCCTTCTGAG TGATCCAGAA
    CTAGGCCCTG CAGCAGCTGA TGGCTTCTCT CTGCTTATGT CTGACTGCAC TGATGTGCTG
    ACCCGAGCCT GCCATGCTGA CGTGCGGATC ATGTTCCGTC AGCGGTTCTT CACGGATAAC
    GTACCTGATT TAGTCCAAGG TTTCCATGCT GCTCCCCAAG ATGTGAAGCC AAACTACTTG
    AAGGGTCTGT CTCATGTACT GAACAGGCTG CCCAAGCCTG TGCTCTTACC AGAGCTGCCC
    ACACTCCTTT CCTTGCTGCT GGAGGCGCTA TCCTGCACTG ACTCTGTGGT CCAGCTTTCT
    ACCCTCAGCT GCCTTCAGCC TCTTCTACTG GAAGCACCAC AAATTATGAG TCTTCACATT
    GATACTCTGG TTACCAAATT TCTGAACCTC AGCTCCAGCC CTTCCATGGC TGTCCGGATT
    GCTGCACTGC AGTGCATGAA TGCTCTCACT CACCTACCCA CTCCTGTGCT ACTGCCATAT
    AAACCACAGG TGATCCGGGC CTTAGCCAAG CCTCTAGATG ACAAGAAGAG ATTAGTACGC
    AAGGAAGCCG TGTCAGCTAG GGGAGAATGG TTCCTATTGG GAAGCCCAGG CAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418900.1
    CDS22..3198
    Translation

    Target ORF information:

    RefSeq Version XM_029563040.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029563040.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGGTACG
    GCAGGCAGCG CCGCGAAGCT TCTGCAGGGG TCCGGCCGGA GGGAGCGGCC TTCGCACCCG
    CGCACGGCGG GAAGGGAGTT GCGGGGCAGA GATGTGAAAT CTGGAAACTA TACAGTGTTG
    AAAGTCGTGG AAGCCCTTGG GTCCTCTCTA GAGAACCCAG AACCTCGAAC TCGGGCACGA
    GGGATTCAGC TTTTGTCGCA GGTGCTACTC CAGTGCCACT CCTTGCTCCT GGAGAAGGAA
    GTGGTACACC TGATCCTATT CTATGAGAAC CGACTAAAGG ACCATCATCT TGTGATTCCA
    TCTGTCCTTC AGGGCTTGAG AGCACTTAGC CTGTGTGTGG CCCTGCCCCC AGGGCTGGCT
    GTCTCAGTGC TCAAAGCCAT TTTCCAGGAG GTTCATGTTC AGTCCCTGCT ACAAGTGGAT
    CGCCACACAG TGTTCAGTAT CATCACCAAC TTCATGCAAT CCCGAGAAGA AGAGTTAAAA
    GACCTAGGAG CTGACTTCAC ATTTGGCTTC ATCCAGGTGA TGGATGGAGA AAAGGATCCC
    CGTAATCTTC TGGTTGCTTT CCACATCGTC CATGACCTCA TTTCCAGGGA CTATAGCCTG
    GGACCTTTTG TGGAAGAGTT ATTTGAAGTG ACATCTTGTT ATTTCCCTAT TGATTTTACC
    CCTCCACCAA ATGATCCCTA TGGCATCCAG AGAGATGATC TCATCCTGAG TCTTCGTGCT
    GTGCTGGCTT CTACACCACG ATTTGCTGAG TTCCTGCTTC CCCTGCTGAT TGAGAAAGTA
    GATTCTGAAA TTCTAAGTGC CAAATTGGAT TCTCTGCAAA CCTTGAATGC TTGCTGTGCT
    GTGTATGGAC AGAAGGAACT AAAGGACTTC CTCCCCAGCC TTTGGGCTTC CATCCGCAGA
    GAGGTGTTCC AGACAGCAAG TGAACGAGTG GAGGCAGAGG GGCTGGCAGC CCTCCATTCC
    CTGACTGCGT GTTTGTCTCG ATCTGTGCTG AGGGCTGATG CTGAGGACCT CCTTAATTCC
    TTTCTTAGCA ACATTCTACA GGACTGCAGG CACCATCTAT GTGAACCAGA CATGAAGCTG
    GTATGGCCTA GTGCCAAGCT GCTGCAGACA GCTGCAGGTG CATCTGCCCG GGCCTGTGAC
    CACATCACCA GCAATGTACT TCCCTTGCTG CTGGAACAGT TCCATAAGCA CAGTCAGAGC
    AACCAGCGGC GGACAATCCT TGAAATGATC CTGGGTTTCT TAAAGCTGCA GCAGAAATGG
    AGCTATGAAG ACAAAGATGA AAGACCTCTG AGTGGCTTCA AGGACCAGCT GTGCTCATTG
    GTATTCATGG CCATAACAGA CCCCAGCACC CAGCTTCAGC TTGTTGGCAT CCGGACGCTC
    ACAGTCTTGG GTGCCCAGCC AGATCTCCTA TCTTCTGGGG ACTTGGAGCT GGCAATAGGT
    CACCTGTACA GACTGAGCTT CCTGGAGGAA GACTCCCAGA GTTGGATGGC AGCACTGGAG
    GCATCAGGAG CCCTTGCCTC TTTCTATCCT GGAGCCTTCA GCAGCTACCT CCTACCTAAG
    CTTGCTAAAG AGCTGCAGAG AGATGTGACT AGAGAGCATG GTCCCAACAA ATGTTCCCGG
    CATCTCCTCT GTCTGCAAGC TTTGTCAGCT GTTTCAACAC ATCCTAGCAT TGTCAAGGAG
    ACACTGCCTC TGCTGCTGCA GCATCTCTGG CAGGCAAACA AAGGAAATGT GGTTATAGGA
    TTCAATGACA TTATTGCTAT CTGCCAGAGT CTCCAGCAGG TGGCAGAAAA ATGCCACCGG
    GACCCTGACA GCTGCTGGTA TTTCCATGAG ACTGCTCTAC CCTGCCTGTT TGCTTTGGCT
    GTACAGGCTT CCATGCCAGA GGACTCCTCA GTTCTGAGAA AAGTACTATT GGAAGATGAG
    GTCTTAGCTG CCTTGGCATC TGTCATCAGC ACTGCCACTA TCCACCTGAG CTCTGAGTTA
    GCTGCCCAGA GTGTCACCCG CATTGTGCCC CTCTTCTTAG ATGGCAACAT CTCCTTTCTT
    CCTGAAAACA GCTTCCCAAG CCGGTTCCAG CCATTCCAGG ATGGCTGCTC CAGGCAGAGG
    CGGCTGGTTG TACTTCTTAT GGCTTTTGTC TGCTCCCTGC CACGAAATGT GGAAATCCCT
    CAACTGACCC AACTCATGAG GGAGCTTTTG GAACTGAGCT GCTGTCCTGG CTGTCCCTTC
    TCCTCCACTG CTGCCGCCAA GTGCTTTGCA GGACTTCTCA ACAAGCACCC TGCAGGGCAG
    CAATTGGATG AATTCCTCCA GCTTGCTGTA GACACAGTGG AGGCCGGCTT AGGCGCTGGG
    TCCTCTCGTA GTCAGGCTTT TACACTACTA CTCTGGGTGA CCAAGGCTTT AGTACTCAGA
    TACCATCCTC TCAGCTCCTG CCTTACAGCC CGGCTCATGG GCCTTCTGAG TGATCCAGAA
    CTAGGCCCTG CAGCAGCTGA TGGCTTCTCT CTGCTTATGT CTGACTGCAC TGATGTGCTG
    ACCCGAGCCT GCCATGCTGA CGTGCGGATC ATGTTCCGTC AGCGGTTCTT CACGGATAAC
    GTACCTGATT TAGTCCAAGG TTTCCATGCT GCTCCCCAAG ATGTGAAGCC AAACTACTTG
    AAGGGTCTGT CTCATGTACT GAACAGGCTG CCCAAGCCTG TGCTCTTACC AGAGCTGCCC
    ACACTCCTTT CCTTGCTGCT GGAGGCGCTA TCCTGCACTG ACTCTGTGGT CCAGCTTTCT
    ACCCTCAGCT GCCTTCAGCC TCTTCTACTG GAAGCACCAC AAATTATGAG TCTTCACATT
    GATACTCTGG TTACCAAATT TCTGAACCTC AGCTCCAGCC CTTCCATGGC TGTCCGGATT
    GCTGCACTGC AGTGCATGAA TGCTCTCACT CACCTACCCA CTCCTGTGCT ACTGCCATAT
    AAACCACAGG TGATCCGGGC CTTAGCCAAG CCTCTAGATG ACAAGAAGAG ATTAGTACGC
    AAGGAAGCCG TGTCAGCTAG GGGAGAATGG TTCCTATTGG GAAGCCCAGG CAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa15551
    Clone ID Related Accession (Same CDS sequence) XM_008831975.2 , XM_008831975.3
    Accession Version XM_008831975.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3093bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008831975.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGATGTG
    AAATCTGGAA ACTATACAGT GTTGAAAGTC GTGGAAGCCC TTGGGTCCTC TCTAGAGAAC
    CCAGAACCTC GAACTCGGGC ACGAGGGATT CAGCTTTTGT CGCAGGTGCT ACTCCAGTGC
    CACTCCTTGC TCCTGGAGAA GGAAGTGGTA CACCTGATCC TATTCTATGA GAACCGACTA
    AAGGACCATC ATCTTGTGAT TCCATCTGTC CTTCAGGGCT TGAGAGCACT TAGCCTGTGT
    GTGGCCCTGC CCCCAGGGCT GGCTGTCTCA GTGCTCAAAG CCATTTTCCA GGAGGTTCAT
    GTTCAGTCCC TGCTACAAGT GGATCGCCAC ACAGTGTTCA GTATCATCAC CAACTTCATG
    CAATCCCGAG AAGAAGAGTT AAAAGACCTA GGAGCTGACT TCACATTTGG CTTCATCCAG
    GTGATGGATG GAGAAAAGGA TCCCCGTAAT CTTCTGGTTG CTTTCCACAT CGTCCATGAC
    CTCATTTCCA GGGACTATAG CCTGGGACCT TTTGTGGAAG AGTTATTTGA AGTGACATCT
    TGTTATTTCC CTATTGATTT TACCCCTCCA CCAAATGATC CCTATGGCAT CCAGAGAGAT
    GATCTCATCC TGAGTCTTCG TGCTGTGCTG GCTTCTACAC CACGATTTGC TGAGTTCCTG
    CTTCCCCTGC TGATTGAGAA AGTAGATTCT GAAATTCTAA GTGCCAAATT GGATTCTCTG
    CAAACCTTGA ATGCTTGCTG TGCTGTGTAT GGACAGAAGG AACTAAAGGA CTTCCTCCCC
    AGCCTTTGGG CTTCCATCCG CAGAGAGGTG TTCCAGACAG CAAGTGAACG AGTGGAGGCA
    GAGGGGCTGG CAGCCCTCCA TTCCCTGACT GCGTGTTTGT CTCGATCTGT GCTGAGGGCT
    GATGCTGAGG ACCTCCTTAA TTCCTTTCTT AGCAACATTC TACAGGACTG CAGGCACCAT
    CTATGTGAAC CAGACATGAA GCTGGTATGG CCTAGTGCCA AGCTGCTGCA GACAGCTGCA
    GGTGCATCTG CCCGGGCCTG TGACCACATC ACCAGCAATG TACTTCCCTT GCTGCTGGAA
    CAGTTCCATA AGCACAGTCA GAGCAACCAG CGGCGGACAA TCCTTGAAAT GATCCTGGGT
    TTCTTAAAGC TGCAGCAGAA ATGGAGCTAT GAAGACAAAG ATGAAAGACC TCTGAGTGGC
    TTCAAGGACC AGCTGTGCTC ATTGGTATTC ATGGCCATAA CAGACCCCAG CACCCAGCTT
    CAGCTTGTTG GCATCCGGAC GCTCACAGTC TTGGGTGCCC AGCCAGATCT CCTATCTTCT
    GGGGACTTGG AGCTGGCAAT AGGTCACCTG TACAGACTGA GCTTCCTGGA GGAAGACTCC
    CAGAGTTGTA GGATGGCAGC ACTGGAGGCA TCAGGAGCCC TTGCCTCTTT CTATCCTGGA
    GCCTTCAGCA GCTACCTCCT ACCTAAGCTT GCTAAAGAGC TGCAGAGAGG GGAGTTAGAT
    GTGACTAGAG AGCATGGTCC CAACAAATGT TCCCGGCATC TCCTCTGTCT GCAAGCTTTG
    TCAGCTGTTT CAACACATCC TAGCATTGTC AAGGAGACAC TGCCTCTGCT GCTGCAGCAT
    CTCTGGCAGG CAAACAAAGG AAATGTGGTT ATAGGATTCA ATGACATTAT TGCTATCTGC
    CAGAGTCTCC AGCAGGTGGC AGAAAAATGC CACCGGGACC CTGACAGCTG CTGGTATTTC
    CATGAGACTG CTCTACCCTG CCTGTTTGCT TTGGCTGTAC AGGCTTCCAT GCCAGAGGAC
    TCCTCAGTTC TGAGAAAAGT ACTATTGGAA GATGAGGTCT TAGCTGCCTT GGCATCTGTC
    ATCAGCACTG CCACTATCCA CCTGAGCTCT GAGTTAGCTG CCCAGAGTGT CACCCGCATT
    GTGCCCCTCT TCTTAGATGG CAACATCTCC TTTCTTCCTG AAAACAGCTT CCCAAGCCGG
    TTCCAGCCAT TCCAGGATGG CTGCTCCAGG CAGAGGCGGC TGGTTGTACT TCTTATGGCT
    TTTGTCTGCT CCCTGCCACG AAATGTGGAA ATCCCTCAAC TGACCCAACT CATGAGGGAG
    CTTTTGGAAC TGAGCTGCTG TCCTGGCTGT CCCTTCTCCT CCACTGCTGC CGCCAAGTGC
    TTTGCAGGAC TTCTCAACAA GCACCCTGCA GGGCAGCAAT TGGATGAATT CCTCCAGCTT
    GCTGTAGACA CAGTGGAGGC CGGCTTAGGC GCTGGGTCCT CTCGTAGTCA GGCTTTTACA
    CTACTACTCT GGGTGACCAA GGCTTTAGTA CTCAGATACC ATCCTCTCAG CTCCTGCCTT
    ACAGCCCGGC TCATGGGCCT TCTGAGTGAT CCAGAACTAG GCCCTGCAGC AGCTGATGGC
    TTCTCTCTGC TTATGTCTGA CTGCACTGAT GTGCTGACCC GAGCCTGCCA TGCTGACGTG
    CGGATCATGT TCCGTCAGCG GTTCTTCACG GATAACGTAC CTGATTTAGT CCAAGGTTTC
    CATGCTGCTC CCCAAGATGT GAAGCCAAAC TACTTGAAGG GTCTGTCTCA TGTACTGAAC
    AGGCTGCCCA AGCCTGTGCT CTTACCAGAG CTGCCCACAC TCCTTTCCTT GCTGCTGGAG
    GCGCTATCCT GCACTGACTC TGTGGTCCAG CTTTCTACCC TCAGCTGCCT TCAGCCTCTT
    CTACTGGAAG CACCACAAAT TATGAGTCTT CACATTGATA CTCTGGTTAC CAAATTTCTG
    AACCTCAGCT CCAGCCCTTC CATGGCTGTC CGGATTGCTG CACTGCAGTG CATGAATGCT
    CTCACTCACC TACCCACTCC TGTGCTACTG CCATATAAAC CACAGGTGAT CCGGGCCTTA
    GCCAAGCCTC TAGATGACAA GAAGAGATTA GTACGCAAGG AAGCCGTGTC AGCTAGGGGA
    GAATGGTTCC TATTGGGAAG CCCAGGCAGT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008830197.1
    CDS13..3105
    Translation

    Target ORF information:

    RefSeq Version XM_008831975.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008831975.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGATGTG
    AAATCTGGAA ACTATACAGT GTTGAAAGTC GTGGAAGCCC TTGGGTCCTC TCTAGAGAAC
    CCAGAACCTC GAACTCGGGC ACGAGGGATT CAGCTTTTGT CGCAGGTGCT ACTCCAGTGC
    CACTCCTTGC TCCTGGAGAA GGAAGTGGTA CACCTGATCC TATTCTATGA GAACCGACTA
    AAGGACCATC ATCTTGTGAT TCCATCTGTC CTTCAGGGCT TGAGAGCACT TAGCCTGTGT
    GTGGCCCTGC CCCCAGGGCT GGCTGTCTCA GTGCTCAAAG CCATTTTCCA GGAGGTTCAT
    GTTCAGTCCC TGCTACAAGT GGATCGCCAC ACAGTGTTCA GTATCATCAC CAACTTCATG
    CAATCCCGAG AAGAAGAGTT AAAAGACCTA GGAGCTGACT TCACATTTGG CTTCATCCAG
    GTGATGGATG GAGAAAAGGA TCCCCGTAAT CTTCTGGTTG CTTTCCACAT CGTCCATGAC
    CTCATTTCCA GGGACTATAG CCTGGGACCT TTTGTGGAAG AGTTATTTGA AGTGACATCT
    TGTTATTTCC CTATTGATTT TACCCCTCCA CCAAATGATC CCTATGGCAT CCAGAGAGAT
    GATCTCATCC TGAGTCTTCG TGCTGTGCTG GCTTCTACAC CACGATTTGC TGAGTTCCTG
    CTTCCCCTGC TGATTGAGAA AGTAGATTCT GAAATTCTAA GTGCCAAATT GGATTCTCTG
    CAAACCTTGA ATGCTTGCTG TGCTGTGTAT GGACAGAAGG AACTAAAGGA CTTCCTCCCC
    AGCCTTTGGG CTTCCATCCG CAGAGAGGTG TTCCAGACAG CAAGTGAACG AGTGGAGGCA
    GAGGGGCTGG CAGCCCTCCA TTCCCTGACT GCGTGTTTGT CTCGATCTGT GCTGAGGGCT
    GATGCTGAGG ACCTCCTTAA TTCCTTTCTT AGCAACATTC TACAGGACTG CAGGCACCAT
    CTATGTGAAC CAGACATGAA GCTGGTATGG CCTAGTGCCA AGCTGCTGCA GACAGCTGCA
    GGTGCATCTG CCCGGGCCTG TGACCACATC ACCAGCAATG TACTTCCCTT GCTGCTGGAA
    CAGTTCCATA AGCACAGTCA GAGCAACCAG CGGCGGACAA TCCTTGAAAT GATCCTGGGT
    TTCTTAAAGC TGCAGCAGAA ATGGAGCTAT GAAGACAAAG ATGAAAGACC TCTGAGTGGC
    TTCAAGGACC AGCTGTGCTC ATTGGTATTC ATGGCCATAA CAGACCCCAG CACCCAGCTT
    CAGCTTGTTG GCATCCGGAC GCTCACAGTC TTGGGTGCCC AGCCAGATCT CCTATCTTCT
    GGGGACTTGG AGCTGGCAAT AGGTCACCTG TACAGACTGA GCTTCCTGGA GGAAGACTCC
    CAGAGTTGTA GGATGGCAGC ACTGGAGGCA TCAGGAGCCC TTGCCTCTTT CTATCCTGGA
    GCCTTCAGCA GCTACCTCCT ACCTAAGCTT GCTAAAGAGC TGCAGAGAGG GGAGTTAGAT
    GTGACTAGAG AGCATGGTCC CAACAAATGT TCCCGGCATC TCCTCTGTCT GCAAGCTTTG
    TCAGCTGTTT CAACACATCC TAGCATTGTC AAGGAGACAC TGCCTCTGCT GCTGCAGCAT
    CTCTGGCAGG CAAACAAAGG AAATGTGGTT ATAGGATTCA ATGACATTAT TGCTATCTGC
    CAGAGTCTCC AGCAGGTGGC AGAAAAATGC CACCGGGACC CTGACAGCTG CTGGTATTTC
    CATGAGACTG CTCTACCCTG CCTGTTTGCT TTGGCTGTAC AGGCTTCCAT GCCAGAGGAC
    TCCTCAGTTC TGAGAAAAGT ACTATTGGAA GATGAGGTCT TAGCTGCCTT GGCATCTGTC
    ATCAGCACTG CCACTATCCA CCTGAGCTCT GAGTTAGCTG CCCAGAGTGT CACCCGCATT
    GTGCCCCTCT TCTTAGATGG CAACATCTCC TTTCTTCCTG AAAACAGCTT CCCAAGCCGG
    TTCCAGCCAT TCCAGGATGG CTGCTCCAGG CAGAGGCGGC TGGTTGTACT TCTTATGGCT
    TTTGTCTGCT CCCTGCCACG AAATGTGGAA ATCCCTCAAC TGACCCAACT CATGAGGGAG
    CTTTTGGAAC TGAGCTGCTG TCCTGGCTGT CCCTTCTCCT CCACTGCTGC CGCCAAGTGC
    TTTGCAGGAC TTCTCAACAA GCACCCTGCA GGGCAGCAAT TGGATGAATT CCTCCAGCTT
    GCTGTAGACA CAGTGGAGGC CGGCTTAGGC GCTGGGTCCT CTCGTAGTCA GGCTTTTACA
    CTACTACTCT GGGTGACCAA GGCTTTAGTA CTCAGATACC ATCCTCTCAG CTCCTGCCTT
    ACAGCCCGGC TCATGGGCCT TCTGAGTGAT CCAGAACTAG GCCCTGCAGC AGCTGATGGC
    TTCTCTCTGC TTATGTCTGA CTGCACTGAT GTGCTGACCC GAGCCTGCCA TGCTGACGTG
    CGGATCATGT TCCGTCAGCG GTTCTTCACG GATAACGTAC CTGATTTAGT CCAAGGTTTC
    CATGCTGCTC CCCAAGATGT GAAGCCAAAC TACTTGAAGG GTCTGTCTCA TGTACTGAAC
    AGGCTGCCCA AGCCTGTGCT CTTACCAGAG CTGCCCACAC TCCTTTCCTT GCTGCTGGAG
    GCGCTATCCT GCACTGACTC TGTGGTCCAG CTTTCTACCC TCAGCTGCCT TCAGCCTCTT
    CTACTGGAAG CACCACAAAT TATGAGTCTT CACATTGATA CTCTGGTTAC CAAATTTCTG
    AACCTCAGCT CCAGCCCTTC CATGGCTGTC CGGATTGCTG CACTGCAGTG CATGAATGCT
    CTCACTCACC TACCCACTCC TGTGCTACTG CCATATAAAC CACAGGTGAT CCGGGCCTTA
    GCCAAGCCTC TAGATGACAA GAAGAGATTA GTACGCAAGG AAGCCGTGTC AGCTAGGGGA
    GAATGGTTCC TATTGGGAAG CCCAGGCAGT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa15551
    Clone ID Related Accession (Same CDS sequence) XM_008831975.2 , XM_008831975.3
    Accession Version XM_008831975.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3093bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008831975.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGATGTG
    AAATCTGGAA ACTATACAGT GTTGAAAGTC GTGGAAGCCC TTGGGTCCTC TCTAGAGAAC
    CCAGAACCTC GAACTCGGGC ACGAGGGATT CAGCTTTTGT CGCAGGTGCT ACTCCAGTGC
    CACTCCTTGC TCCTGGAGAA GGAAGTGGTA CACCTGATCC TATTCTATGA GAACCGACTA
    AAGGACCATC ATCTTGTGAT TCCATCTGTC CTTCAGGGCT TGAGAGCACT TAGCCTGTGT
    GTGGCCCTGC CCCCAGGGCT GGCTGTCTCA GTGCTCAAAG CCATTTTCCA GGAGGTTCAT
    GTTCAGTCCC TGCTACAAGT GGATCGCCAC ACAGTGTTCA GTATCATCAC CAACTTCATG
    CAATCCCGAG AAGAAGAGTT AAAAGACCTA GGAGCTGACT TCACATTTGG CTTCATCCAG
    GTGATGGATG GAGAAAAGGA TCCCCGTAAT CTTCTGGTTG CTTTCCACAT CGTCCATGAC
    CTCATTTCCA GGGACTATAG CCTGGGACCT TTTGTGGAAG AGTTATTTGA AGTGACATCT
    TGTTATTTCC CTATTGATTT TACCCCTCCA CCAAATGATC CCTATGGCAT CCAGAGAGAT
    GATCTCATCC TGAGTCTTCG TGCTGTGCTG GCTTCTACAC CACGATTTGC TGAGTTCCTG
    CTTCCCCTGC TGATTGAGAA AGTAGATTCT GAAATTCTAA GTGCCAAATT GGATTCTCTG
    CAAACCTTGA ATGCTTGCTG TGCTGTGTAT GGACAGAAGG AACTAAAGGA CTTCCTCCCC
    AGCCTTTGGG CTTCCATCCG CAGAGAGGTG TTCCAGACAG CAAGTGAACG AGTGGAGGCA
    GAGGGGCTGG CAGCCCTCCA TTCCCTGACT GCGTGTTTGT CTCGATCTGT GCTGAGGGCT
    GATGCTGAGG ACCTCCTTAA TTCCTTTCTT AGCAACATTC TACAGGACTG CAGGCACCAT
    CTATGTGAAC CAGACATGAA GCTGGTATGG CCTAGTGCCA AGCTGCTGCA GACAGCTGCA
    GGTGCATCTG CCCGGGCCTG TGACCACATC ACCAGCAATG TACTTCCCTT GCTGCTGGAA
    CAGTTCCATA AGCACAGTCA GAGCAACCAG CGGCGGACAA TCCTTGAAAT GATCCTGGGT
    TTCTTAAAGC TGCAGCAGAA ATGGAGCTAT GAAGACAAAG ATGAAAGACC TCTGAGTGGC
    TTCAAGGACC AGCTGTGCTC ATTGGTATTC ATGGCCATAA CAGACCCCAG CACCCAGCTT
    CAGCTTGTTG GCATCCGGAC GCTCACAGTC TTGGGTGCCC AGCCAGATCT CCTATCTTCT
    GGGGACTTGG AGCTGGCAAT AGGTCACCTG TACAGACTGA GCTTCCTGGA GGAAGACTCC
    CAGAGTTGTA GGATGGCAGC ACTGGAGGCA TCAGGAGCCC TTGCCTCTTT CTATCCTGGA
    GCCTTCAGCA GCTACCTCCT ACCTAAGCTT GCTAAAGAGC TGCAGAGAGG GGAGTTAGAT
    GTGACTAGAG AGCATGGTCC CAACAAATGT TCCCGGCATC TCCTCTGTCT GCAAGCTTTG
    TCAGCTGTTT CAACACATCC TAGCATTGTC AAGGAGACAC TGCCTCTGCT GCTGCAGCAT
    CTCTGGCAGG CAAACAAAGG AAATGTGGTT ATAGGATTCA ATGACATTAT TGCTATCTGC
    CAGAGTCTCC AGCAGGTGGC AGAAAAATGC CACCGGGACC CTGACAGCTG CTGGTATTTC
    CATGAGACTG CTCTACCCTG CCTGTTTGCT TTGGCTGTAC AGGCTTCCAT GCCAGAGGAC
    TCCTCAGTTC TGAGAAAAGT ACTATTGGAA GATGAGGTCT TAGCTGCCTT GGCATCTGTC
    ATCAGCACTG CCACTATCCA CCTGAGCTCT GAGTTAGCTG CCCAGAGTGT CACCCGCATT
    GTGCCCCTCT TCTTAGATGG CAACATCTCC TTTCTTCCTG AAAACAGCTT CCCAAGCCGG
    TTCCAGCCAT TCCAGGATGG CTGCTCCAGG CAGAGGCGGC TGGTTGTACT TCTTATGGCT
    TTTGTCTGCT CCCTGCCACG AAATGTGGAA ATCCCTCAAC TGACCCAACT CATGAGGGAG
    CTTTTGGAAC TGAGCTGCTG TCCTGGCTGT CCCTTCTCCT CCACTGCTGC CGCCAAGTGC
    TTTGCAGGAC TTCTCAACAA GCACCCTGCA GGGCAGCAAT TGGATGAATT CCTCCAGCTT
    GCTGTAGACA CAGTGGAGGC CGGCTTAGGC GCTGGGTCCT CTCGTAGTCA GGCTTTTACA
    CTACTACTCT GGGTGACCAA GGCTTTAGTA CTCAGATACC ATCCTCTCAG CTCCTGCCTT
    ACAGCCCGGC TCATGGGCCT TCTGAGTGAT CCAGAACTAG GCCCTGCAGC AGCTGATGGC
    TTCTCTCTGC TTATGTCTGA CTGCACTGAT GTGCTGACCC GAGCCTGCCA TGCTGACGTG
    CGGATCATGT TCCGTCAGCG GTTCTTCACG GATAACGTAC CTGATTTAGT CCAAGGTTTC
    CATGCTGCTC CCCAAGATGT GAAGCCAAAC TACTTGAAGG GTCTGTCTCA TGTACTGAAC
    AGGCTGCCCA AGCCTGTGCT CTTACCAGAG CTGCCCACAC TCCTTTCCTT GCTGCTGGAG
    GCGCTATCCT GCACTGACTC TGTGGTCCAG CTTTCTACCC TCAGCTGCCT TCAGCCTCTT
    CTACTGGAAG CACCACAAAT TATGAGTCTT CACATTGATA CTCTGGTTAC CAAATTTCTG
    AACCTCAGCT CCAGCCCTTC CATGGCTGTC CGGATTGCTG CACTGCAGTG CATGAATGCT
    CTCACTCACC TACCCACTCC TGTGCTACTG CCATATAAAC CACAGGTGAT CCGGGCCTTA
    GCCAAGCCTC TAGATGACAA GAAGAGATTA GTACGCAAGG AAGCCGTGTC AGCTAGGGGA
    GAATGGTTCC TATTGGGAAG CCCAGGCAGT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008830197.1
    CDS40..3132
    Translation

    Target ORF information:

    RefSeq Version XM_008831975.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008831975.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGATGTG
    AAATCTGGAA ACTATACAGT GTTGAAAGTC GTGGAAGCCC TTGGGTCCTC TCTAGAGAAC
    CCAGAACCTC GAACTCGGGC ACGAGGGATT CAGCTTTTGT CGCAGGTGCT ACTCCAGTGC
    CACTCCTTGC TCCTGGAGAA GGAAGTGGTA CACCTGATCC TATTCTATGA GAACCGACTA
    AAGGACCATC ATCTTGTGAT TCCATCTGTC CTTCAGGGCT TGAGAGCACT TAGCCTGTGT
    GTGGCCCTGC CCCCAGGGCT GGCTGTCTCA GTGCTCAAAG CCATTTTCCA GGAGGTTCAT
    GTTCAGTCCC TGCTACAAGT GGATCGCCAC ACAGTGTTCA GTATCATCAC CAACTTCATG
    CAATCCCGAG AAGAAGAGTT AAAAGACCTA GGAGCTGACT TCACATTTGG CTTCATCCAG
    GTGATGGATG GAGAAAAGGA TCCCCGTAAT CTTCTGGTTG CTTTCCACAT CGTCCATGAC
    CTCATTTCCA GGGACTATAG CCTGGGACCT TTTGTGGAAG AGTTATTTGA AGTGACATCT
    TGTTATTTCC CTATTGATTT TACCCCTCCA CCAAATGATC CCTATGGCAT CCAGAGAGAT
    GATCTCATCC TGAGTCTTCG TGCTGTGCTG GCTTCTACAC CACGATTTGC TGAGTTCCTG
    CTTCCCCTGC TGATTGAGAA AGTAGATTCT GAAATTCTAA GTGCCAAATT GGATTCTCTG
    CAAACCTTGA ATGCTTGCTG TGCTGTGTAT GGACAGAAGG AACTAAAGGA CTTCCTCCCC
    AGCCTTTGGG CTTCCATCCG CAGAGAGGTG TTCCAGACAG CAAGTGAACG AGTGGAGGCA
    GAGGGGCTGG CAGCCCTCCA TTCCCTGACT GCGTGTTTGT CTCGATCTGT GCTGAGGGCT
    GATGCTGAGG ACCTCCTTAA TTCCTTTCTT AGCAACATTC TACAGGACTG CAGGCACCAT
    CTATGTGAAC CAGACATGAA GCTGGTATGG CCTAGTGCCA AGCTGCTGCA GACAGCTGCA
    GGTGCATCTG CCCGGGCCTG TGACCACATC ACCAGCAATG TACTTCCCTT GCTGCTGGAA
    CAGTTCCATA AGCACAGTCA GAGCAACCAG CGGCGGACAA TCCTTGAAAT GATCCTGGGT
    TTCTTAAAGC TGCAGCAGAA ATGGAGCTAT GAAGACAAAG ATGAAAGACC TCTGAGTGGC
    TTCAAGGACC AGCTGTGCTC ATTGGTATTC ATGGCCATAA CAGACCCCAG CACCCAGCTT
    CAGCTTGTTG GCATCCGGAC GCTCACAGTC TTGGGTGCCC AGCCAGATCT CCTATCTTCT
    GGGGACTTGG AGCTGGCAAT AGGTCACCTG TACAGACTGA GCTTCCTGGA GGAAGACTCC
    CAGAGTTGTA GGATGGCAGC ACTGGAGGCA TCAGGAGCCC TTGCCTCTTT CTATCCTGGA
    GCCTTCAGCA GCTACCTCCT ACCTAAGCTT GCTAAAGAGC TGCAGAGAGG GGAGTTAGAT
    GTGACTAGAG AGCATGGTCC CAACAAATGT TCCCGGCATC TCCTCTGTCT GCAAGCTTTG
    TCAGCTGTTT CAACACATCC TAGCATTGTC AAGGAGACAC TGCCTCTGCT GCTGCAGCAT
    CTCTGGCAGG CAAACAAAGG AAATGTGGTT ATAGGATTCA ATGACATTAT TGCTATCTGC
    CAGAGTCTCC AGCAGGTGGC AGAAAAATGC CACCGGGACC CTGACAGCTG CTGGTATTTC
    CATGAGACTG CTCTACCCTG CCTGTTTGCT TTGGCTGTAC AGGCTTCCAT GCCAGAGGAC
    TCCTCAGTTC TGAGAAAAGT ACTATTGGAA GATGAGGTCT TAGCTGCCTT GGCATCTGTC
    ATCAGCACTG CCACTATCCA CCTGAGCTCT GAGTTAGCTG CCCAGAGTGT CACCCGCATT
    GTGCCCCTCT TCTTAGATGG CAACATCTCC TTTCTTCCTG AAAACAGCTT CCCAAGCCGG
    TTCCAGCCAT TCCAGGATGG CTGCTCCAGG CAGAGGCGGC TGGTTGTACT TCTTATGGCT
    TTTGTCTGCT CCCTGCCACG AAATGTGGAA ATCCCTCAAC TGACCCAACT CATGAGGGAG
    CTTTTGGAAC TGAGCTGCTG TCCTGGCTGT CCCTTCTCCT CCACTGCTGC CGCCAAGTGC
    TTTGCAGGAC TTCTCAACAA GCACCCTGCA GGGCAGCAAT TGGATGAATT CCTCCAGCTT
    GCTGTAGACA CAGTGGAGGC CGGCTTAGGC GCTGGGTCCT CTCGTAGTCA GGCTTTTACA
    CTACTACTCT GGGTGACCAA GGCTTTAGTA CTCAGATACC ATCCTCTCAG CTCCTGCCTT
    ACAGCCCGGC TCATGGGCCT TCTGAGTGAT CCAGAACTAG GCCCTGCAGC AGCTGATGGC
    TTCTCTCTGC TTATGTCTGA CTGCACTGAT GTGCTGACCC GAGCCTGCCA TGCTGACGTG
    CGGATCATGT TCCGTCAGCG GTTCTTCACG GATAACGTAC CTGATTTAGT CCAAGGTTTC
    CATGCTGCTC CCCAAGATGT GAAGCCAAAC TACTTGAAGG GTCTGTCTCA TGTACTGAAC
    AGGCTGCCCA AGCCTGTGCT CTTACCAGAG CTGCCCACAC TCCTTTCCTT GCTGCTGGAG
    GCGCTATCCT GCACTGACTC TGTGGTCCAG CTTTCTACCC TCAGCTGCCT TCAGCCTCTT
    CTACTGGAAG CACCACAAAT TATGAGTCTT CACATTGATA CTCTGGTTAC CAAATTTCTG
    AACCTCAGCT CCAGCCCTTC CATGGCTGTC CGGATTGCTG CACTGCAGTG CATGAATGCT
    CTCACTCACC TACCCACTCC TGTGCTACTG CCATATAAAC CACAGGTGAT CCGGGCCTTA
    GCCAAGCCTC TAGATGACAA GAAGAGATTA GTACGCAAGG AAGCCGTGTC AGCTAGGGGA
    GAATGGTTCC TATTGGGAAG CCCAGGCAGT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa15552
    Clone ID Related Accession (Same CDS sequence) XM_008831976.2
    Accession Version XM_008831976.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3090bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product MMS19 nucleotide excision repair protein homolog isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008337059.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008831976.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGATGTG
    AAATCTGGAA ACTATACAGT GTTGAAAGTC GTGGAAGCCC TTGGGTCCTC TCTAGAGAAC
    CCAGAACCTC GAACTCGGGC ACGAGGGATT CAGCTTTTGT CGCAGGTGCT ACTCCAGTGC
    CACTCCTTGC TCCTGGAGAA GGAAGTGGTA CACCTGATCC TATTCTATGA GAACCGACTA
    AAGGACCATC ATCTTGTGAT TCCATCTGTC CTTCAGGGCT TGAGAGCACT TAGCCTGTGT
    GTGGCCCTGC CCCCAGGGCT GGCTGTCTCA GTGCTCAAAG CCATTTTCCA GGAGGTTCAT
    GTTCAGTCCC TGCTACAAGT GGATCGCCAC ACAGTGTTCA GTATCATCAC CAACTTCATG
    CAATCCCGAG AAGAAGAGTT AAAAGACCTA GGAGCTGACT TCACATTTGG CTTCATCCAG
    GTGATGGATG GAGAAAAGGA TCCCCGTAAT CTTCTGGTTG CTTTCCACAT CGTCCATGAC
    CTCATTTCCA GGGACTATAG CCTGGGACCT TTTGTGGAAG AGTTATTTGA AGTGACATCT
    TGTTATTTCC CTATTGATTT TACCCCTCCA CCAAATGATC CCTATGGCAT CCAGAGAGAT
    GATCTCATCC TGAGTCTTCG TGCTGTGCTG GCTTCTACAC CACGATTTGC TGAGTTCCTG
    CTTCCCCTGC TGATTGAGAA AGTAGATTCT GAAATTCTAA GTGCCAAATT GGATTCTCTG
    CAAACCTTGA ATGCTTGCTG TGCTGTGTAT GGACAGAAGG AACTAAAGGA CTTCCTCCCC
    AGCCTTTGGG CTTCCATCCG CAGAGAGGTG TTCCAGACAG CAAGTGAACG AGTGGAGGCA
    GAGGGGCTGG CAGCCCTCCA TTCCCTGACT GCGTGTTTGT CTCGATCTGT GCTGAGGGCT
    GATGCTGAGG ACCTCCTTAA TTCCTTTCTT AGCAACATTC TACAGGACTG CAGGCACCAT
    CTATGTGAAC CAGACATGAA GCTGGTATGG CCTAGTGCCA AGCTGCTGCA GACAGCTGCA
    GGTGCATCTG CCCGGGCCTG TGACCACATC ACCAGCAATG TACTTCCCTT GCTGCTGGAA
    CAGTTCCATA AGCACAGTCA GAGCAACCAG CGGCGGACAA TCCTTGAAAT GATCCTGGGT
    TTCTTAAAGC TGCAGCAGAA ATGGAGCTAT GAAGACAAAG ATGAAAGACC TCTGAGTGGC
    TTCAAGGACC AGCTGTGCTC ATTGGTATTC ATGGCCATAA CAGACCCCAG CACCCAGCTT
    CAGCTTGTTG GCATCCGGAC GCTCACAGTC TTGGGTGCCC AGCCAGATCT CCTATCTTCT
    GGGGACTTGG AGCTGGCAAT AGGTCACCTG TACAGACTGA GCTTCCTGGA GGAAGACTCC
    CAGAGTTGGA TGGCAGCACT GGAGGCATCA GGAGCCCTTG CCTCTTTCTA TCCTGGAGCC
    TTCAGCAGCT ACCTCCTACC TAAGCTTGCT AAAGAGCTGC AGAGAGGGGA GTTAGATGTG
    ACTAGAGAGC ATGGTCCCAA CAAATGTTCC CGGCATCTCC TCTGTCTGCA AGCTTTGTCA
    GCTGTTTCAA CACATCCTAG CATTGTCAAG GAGACACTGC CTCTGCTGCT GCAGCATCTC
    TGGCAGGCAA ACAAAGGAAA TGTGGTTATA GGATTCAATG ACATTATTGC TATCTGCCAG
    AGTCTCCAGC AGGTGGCAGA AAAATGCCAC CGGGACCCTG ACAGCTGCTG GTATTTCCAT
    GAGACTGCTC TACCCTGCCT GTTTGCTTTG GCTGTACAGG CTTCCATGCC AGAGGACTCC
    TCAGTTCTGA GAAAAGTACT ATTGGAAGAT GAGGTCTTAG CTGCCTTGGC ATCTGTCATC
    AGCACTGCCA CTATCCACCT GAGCTCTGAG TTAGCTGCCC AGAGTGTCAC CCGCATTGTG
    CCCCTCTTCT TAGATGGCAA CATCTCCTTT CTTCCTGAAA ACAGCTTCCC AAGCCGGTTC
    CAGCCATTCC AGGATGGCTG CTCCAGGCAG AGGCGGCTGG TTGTACTTCT TATGGCTTTT
    GTCTGCTCCC TGCCACGAAA TGTGGAAATC CCTCAACTGA CCCAACTCAT GAGGGAGCTT
    TTGGAACTGA GCTGCTGTCC TGGCTGTCCC TTCTCCTCCA CTGCTGCCGC CAAGTGCTTT
    GCAGGACTTC TCAACAAGCA CCCTGCAGGG CAGCAATTGG ATGAATTCCT CCAGCTTGCT
    GTAGACACAG TGGAGGCCGG CTTAGGCGCT GGGTCCTCTC GTAGTCAGGC TTTTACACTA
    CTACTCTGGG TGACCAAGGC TTTAGTACTC AGATACCATC CTCTCAGCTC CTGCCTTACA
    GCCCGGCTCA TGGGCCTTCT GAGTGATCCA GAACTAGGCC CTGCAGCAGC TGATGGCTTC
    TCTCTGCTTA TGTCTGACTG CACTGATGTG CTGACCCGAG CCTGCCATGC TGACGTGCGG
    ATCATGTTCC GTCAGCGGTT CTTCACGGAT AACGTACCTG ATTTAGTCCA AGGTTTCCAT
    GCTGCTCCCC AAGATGTGAA GCCAAACTAC TTGAAGGGTC TGTCTCATGT ACTGAACAGG
    CTGCCCAAGC CTGTGCTCTT ACCAGAGCTG CCCACACTCC TTTCCTTGCT GCTGGAGGCG
    CTATCCTGCA CTGACTCTGT GGTCCAGCTT TCTACCCTCA GCTGCCTTCA GCCTCTTCTA
    CTGGAAGCAC CACAAATTAT GAGTCTTCAC ATTGATACTC TGGTTACCAA ATTTCTGAAC
    CTCAGCTCCA GCCCTTCCAT GGCTGTCCGG ATTGCTGCAC TGCAGTGCAT GAATGCTCTC
    ACTCACCTAC CCACTCCTGT GCTACTGCCA TATAAACCAC AGGTGATCCG GGCCTTAGCC
    AAGCCTCTAG ATGACAAGAA GAGATTAGTA CGCAAGGAAG CCGTGTCAGC TAGGGGAGAA
    TGGTTCCTAT TGGGAAGCCC AGGCAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008830198.1
    CDS13..3102
    Translation

    Target ORF information:

    RefSeq Version XM_008831976.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili MMS19 homolog, cytosolic iron-sulfur assembly component (Mms19), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008831976.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGCTGCTG CCGCTGTTAT GGTGGAGGCA GCCGCGCCCA CGGGCGCCTT GTGGGGCCTC 
    GTGCAAGATT TCGTCATGGG TCAGCAGGAA AGTCCCGCTG ACCAGGTAGC TGCAGATGTG
    AAATCTGGAA ACTATACAGT GTTGAAAGTC GTGGAAGCCC TTGGGTCCTC TCTAGAGAAC
    CCAGAACCTC GAACTCGGGC ACGAGGGATT CAGCTTTTGT CGCAGGTGCT ACTCCAGTGC
    CACTCCTTGC TCCTGGAGAA GGAAGTGGTA CACCTGATCC TATTCTATGA GAACCGACTA
    AAGGACCATC ATCTTGTGAT TCCATCTGTC CTTCAGGGCT TGAGAGCACT TAGCCTGTGT
    GTGGCCCTGC CCCCAGGGCT GGCTGTCTCA GTGCTCAAAG CCATTTTCCA GGAGGTTCAT
    GTTCAGTCCC TGCTACAAGT GGATCGCCAC ACAGTGTTCA GTATCATCAC CAACTTCATG
    CAATCCCGAG AAGAAGAGTT AAAAGACCTA GGAGCTGACT TCACATTTGG CTTCATCCAG
    GTGATGGATG GAGAAAAGGA TCCCCGTAAT CTTCTGGTTG CTTTCCACAT CGTCCATGAC
    CTCATTTCCA GGGACTATAG CCTGGGACCT TTTGTGGAAG AGTTATTTGA AGTGACATCT
    TGTTATTTCC CTATTGATTT TACCCCTCCA CCAAATGATC CCTATGGCAT CCAGAGAGAT
    GATCTCATCC TGAGTCTTCG TGCTGTGCTG GCTTCTACAC CACGATTTGC TGAGTTCCTG
    CTTCCCCTGC TGATTGAGAA AGTAGATTCT GAAATTCTAA GTGCCAAATT GGATTCTCTG
    CAAACCTTGA ATGCTTGCTG TGCTGTGTAT GGACAGAAGG AACTAAAGGA CTTCCTCCCC
    AGCCTTTGGG CTTCCATCCG CAGAGAGGTG TTCCAGACAG CAAGTGAACG AGTGGAGGCA
    GAGGGGCTGG CAGCCCTCCA TTCCCTGACT GCGTGTTTGT CTCGATCTGT GCTGAGGGCT
    GATGCTGAGG ACCTCCTTAA TTCCTTTCTT AGCAACATTC TACAGGACTG CAGGCACCAT
    CTATGTGAAC CAGACATGAA GCTGGTATGG CCTAGTGCCA AGCTGCTGCA GACAGCTGCA
    GGTGCATCTG CCCGGGCCTG TGACCACATC ACCAGCAATG TACTTCCCTT GCTGCTGGAA
    CAGTTCCATA AGCACAGTCA GAGCAACCAG CGGCGGACAA TCCTTGAAAT GATCCTGGGT
    TTCTTAAAGC TGCAGCAGAA ATGGAGCTAT GAAGACAAAG ATGAAAGACC TCTGAGTGGC
    TTCAAGGACC AGCTGTGCTC ATTGGTATTC ATGGCCATAA CAGACCCCAG CACCCAGCTT
    CAGCTTGTTG GCATCCGGAC GCTCACAGTC TTGGGTGCCC AGCCAGATCT CCTATCTTCT
    GGGGACTTGG AGCTGGCAAT AGGTCACCTG TACAGACTGA GCTTCCTGGA GGAAGACTCC
    CAGAGTTGGA TGGCAGCACT GGAGGCATCA GGAGCCCTTG CCTCTTTCTA TCCTGGAGCC
    TTCAGCAGCT ACCTCCTACC TAAGCTTGCT AAAGAGCTGC AGAGAGGGGA GTTAGATGTG
    ACTAGAGAGC ATGGTCCCAA CAAATGTTCC CGGCATCTCC TCTGTCTGCA AGCTTTGTCA
    GCTGTTTCAA CACATCCTAG CATTGTCAAG GAGACACTGC CTCTGCTGCT GCAGCATCTC
    TGGCAGGCAA ACAAAGGAAA TGTGGTTATA GGATTCAATG ACATTATTGC TATCTGCCAG
    AGTCTCCAGC AGGTGGCAGA AAAATGCCAC CGGGACCCTG ACAGCTGCTG GTATTTCCAT
    GAGACTGCTC TACCCTGCCT GTTTGCTTTG GCTGTACAGG CTTCCATGCC AGAGGACTCC
    TCAGTTCTGA GAAAAGTACT ATTGGAAGAT GAGGTCTTAG CTGCCTTGGC ATCTGTCATC
    AGCACTGCCA CTATCCACCT GAGCTCTGAG TTAGCTGCCC AGAGTGTCAC CCGCATTGTG
    CCCCTCTTCT TAGATGGCAA CATCTCCTTT CTTCCTGAAA ACAGCTTCCC AAGCCGGTTC
    CAGCCATTCC AGGATGGCTG CTCCAGGCAG AGGCGGCTGG TTGTACTTCT TATGGCTTTT
    GTCTGCTCCC TGCCACGAAA TGTGGAAATC CCTCAACTGA CCCAACTCAT GAGGGAGCTT
    TTGGAACTGA GCTGCTGTCC TGGCTGTCCC TTCTCCTCCA CTGCTGCCGC CAAGTGCTTT
    GCAGGACTTC TCAACAAGCA CCCTGCAGGG CAGCAATTGG ATGAATTCCT CCAGCTTGCT
    GTAGACACAG TGGAGGCCGG CTTAGGCGCT GGGTCCTCTC GTAGTCAGGC TTTTACACTA
    CTACTCTGGG TGACCAAGGC TTTAGTACTC AGATACCATC CTCTCAGCTC CTGCCTTACA
    GCCCGGCTCA TGGGCCTTCT GAGTGATCCA GAACTAGGCC CTGCAGCAGC TGATGGCTTC
    TCTCTGCTTA TGTCTGACTG CACTGATGTG CTGACCCGAG CCTGCCATGC TGACGTGCGG
    ATCATGTTCC GTCAGCGGTT CTTCACGGAT AACGTACCTG ATTTAGTCCA AGGTTTCCAT
    GCTGCTCCCC AAGATGTGAA GCCAAACTAC TTGAAGGGTC TGTCTCATGT ACTGAACAGG
    CTGCCCAAGC CTGTGCTCTT ACCAGAGCTG CCCACACTCC TTTCCTTGCT GCTGGAGGCG
    CTATCCTGCA CTGACTCTGT GGTCCAGCTT TCTACCCTCA GCTGCCTTCA GCCTCTTCTA
    CTGGAAGCAC CACAAATTAT GAGTCTTCAC ATTGATACTC TGGTTACCAA ATTTCTGAAC
    CTCAGCTCCA GCCCTTCCAT GGCTGTCCGG ATTGCTGCAC TGCAGTGCAT GAATGCTCTC
    ACTCACCTAC CCACTCCTGT GCTACTGCCA TATAAACCAC AGGTGATCCG GGCCTTAGCC
    AAGCCTCTAG ATGACAAGAA GAGATTAGTA CGCAAGGAAG CCGTGTCAGC TAGGGGAGAA
    TGGTTCCTAT TGGGAAGCCC AGGCAGTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.