Pkp4 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

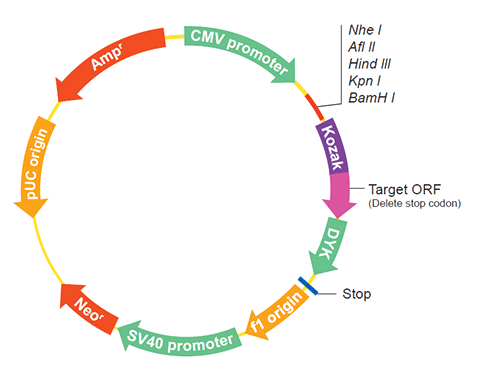
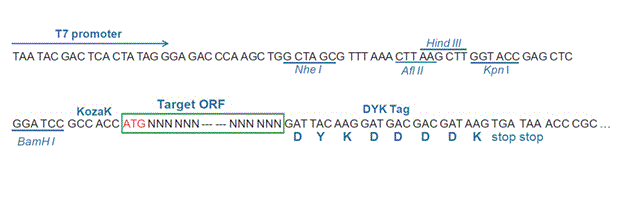
The following Pkp4 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Pkp4 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa141306 XM_029562486.1
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
ONa141307 XM_029562487.1
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X7, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa47516 XM_008831019.1
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa47517 XM_017797608.1
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa47518 XM_017797609.1
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa47519 XM_017797610.1
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa47520 XM_017797611.1
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa47521 XM_017797612.2
Latest version!
Nannospalax galili plakophilin 4 (Pkp4), transcript variant X8, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
View Old Accession Versions >>
ONa47521 XM_017797612.1 Nannospalax galili plakophilin 4 (Pkp4), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa141306
    Clone ID Related Accession (Same CDS sequence) XM_029562486.1
    Accession Version XM_029562486.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3561bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGGTGTTGG AAATCTACAA AGGACATCCA GTCAACGAAG TACCCTTACA
    TACCAAAGAA ATAATTACGC TCTGAACACA ACGGCTACCT ACGCAGAGCC CTACAGGCCA
    ATACAATACC GAGTACAAGA GTGCAGTTAC AACAGGCATG CAGGGCCAAC TGATGATGGT
    ACCACAAGAT CCCCATCAAT AGATAGCATT CAGAAGGACC CCAGGGAGTT TGCTTGGCGT
    GATCCTGAGC TGCCAGAAGT CATTCACATG CTGCAACACC AGTTCCCGTC AGTCCAGGCA
    AACGCAGCGG CCTACCTGCA GCACCTGTGC TTTGGTGACA ACAAAGTGAA GATGGAGGTG
    TATAGGCTAG GGGGAATCAA GCATCTGGTT GACCTTTTGG ACCATAGAGT TTTGGAAGTT
    CAGAAGAATG CTTGTGGTGC CCTCCGAAAC CTTGTTTTTG GCAAGTCTAC AGATGAAAAT
    AAAATAGCAA TGAAGAATGT TGGTGGAATA CCTGCCTTGT TGCGACTGTT AAGAAAGTCT
    ATTGATGCAG AAGTAAGGGA GCTTGTTACA GGAGTTCTTT GGAATTTGTC CTCATGCGAT
    GCTGTAAAGA TGACAATCAT TCGAGATGCT CTCTCAACCT TAACAAACAC TGTGATTGTT
    CCACATTCTG GGTGGAATAA CTCTTCCTTT GATGATGATC ATAAAATTAA ATTTCAGACT
    TCACTAGTTC TGAGGAACAC GACAGGTTGC CTGAGGAACC TCAGCTCTGC AGGGGAGGAA
    GCTCGAAAGC AAATGCGATC CTGTGAGGGA CTGGTAGACT CGCTGTTGTA TGTGATCCAC
    ACATGCGTGA ACACTTCTGA TTACGACAGC AAGACAGTGG AGAACTGCGT GTGCACCCTG
    AGGAACCTAT CATATCGGCT GGAGCTAGAG GTCCCTCAGG CCCGGCTGCT CGGACTGAAT
    GAACTGGATG ACTTGCTAGG AAAAGAGTCT CCCAGCAAAG ACTCAGAACC AAGCTGTTGG
    GGGAAAAAGA AGAAAAAGAA AAAGAGAACT CCACAAGAGG ATCAATGGGA TGGAGTCGGG
    CCTATCCCAG GACTGTCCAA GTCCCCCAAA GGGGTTGAGA TGCTCTGGCA CCCATCAGTG
    GTAAAACCAT ATCTGACTCT TCTAGCAGAA AGTTCCAACC CAGCCACCTT GGAAGGCTCT
    GCTGGATCTC TCCAGAACCT CTCTGCTGGC AACTGGAAGT TTGCAGCATA CATCCGGGCA
    GCTGTTCGAA AAGAAAAAGG GCTCCCCATC CTTGTTGAGC TGCTGAGGAT GGATAATGAC
    AGAGTTGTCT CTTCTGTGGC CACTGCCTTG AGGAACATGG CGCTAGATGT CCGCAACAAG
    GAGCTCATAG GTAAATATGC CATGCGAGAC CTGGTCAATC GGCTTCCTGG GGGCAGCAGC
    CCCAGCATAC TGTCTGACGA GACTGTGGCA GCCATCTGCT GTGCCCTGCA CGAGGTCACC
    AGCAAAAACA TGGAGAATGC CAAAGCCCTG GCTGACTCAG GAGGTATAGA GAAGCTGGTG
    AACATAACCA AAGGCAGAGG AGACAGGTCC TCTCTGAAAG TGGTAAAGGC GGCAGCCCAG
    GTCTTGAATA CATTATGGCA GTATCGGGAC CTGCGGAGCA TTTACAAAAA GGATGGGTGG
    AATCAGAACC ATTTTATTAC ACCTGTGTCA ACATTAGAGC GAGACCGATT CAAATCGCAT
    CCTTCCTTGT CCACCACCAA CCAACAGATG TCACCCATCA TTCAGTCAGT TGGCAGCACC
    TCTTCCTCAC CAGCACTGTT AGGAATCAGA GACCCTCGCT CTGAATATGA TAGGACCCAG
    CCACCTATGC AGTATTACAA TAGCCAAGGG GACGCCACAC ATAAAGGCCT GTACCCTGGC
    TCCAGCAAAC CTTCACCAAT TTACATCAGT TCCTATTCCT CACCAGCAAG AGAACAAAAT
    AGACGGCTAC AGCATCAACA GCTGTATTAC AGTCAAGATG ACTCCACTAG AAAGAACTTT
    GATGCATACA GGTTGTATTT GCAGTCTCCT CATAGCTATG AAGATCCTTA TTTTGACGAC
    AGAGTTCACT TTCCAGCTTC CACTGATTAC TCAACACAGT ATGGACTGAA ATCGACCACA
    AATTACGTAG ACTTTTATTC CACTAAACGA CCTTCTTACA GATCAGAACA GTACCCAGGG
    TCCCCTGACT CGTGGGTGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418346.1
    CDS1..3561
    Translation

    Target ORF information:

    RefSeq Version XM_029562486.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029562486.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGGTGTTGG AAATCTACAA AGGACATCCA GTCAACGAAG TACCCTTACA
    TACCAAAGAA ATAATTACGC TCTGAACACA ACGGCTACCT ACGCAGAGCC CTACAGGCCA
    ATACAATACC GAGTACAAGA GTGCAGTTAC AACAGGCATG CAGGGCCAAC TGATGATGGT
    ACCACAAGAT CCCCATCAAT AGATAGCATT CAGAAGGACC CCAGGGAGTT TGCTTGGCGT
    GATCCTGAGC TGCCAGAAGT CATTCACATG CTGCAACACC AGTTCCCGTC AGTCCAGGCA
    AACGCAGCGG CCTACCTGCA GCACCTGTGC TTTGGTGACA ACAAAGTGAA GATGGAGGTG
    TATAGGCTAG GGGGAATCAA GCATCTGGTT GACCTTTTGG ACCATAGAGT TTTGGAAGTT
    CAGAAGAATG CTTGTGGTGC CCTCCGAAAC CTTGTTTTTG GCAAGTCTAC AGATGAAAAT
    AAAATAGCAA TGAAGAATGT TGGTGGAATA CCTGCCTTGT TGCGACTGTT AAGAAAGTCT
    ATTGATGCAG AAGTAAGGGA GCTTGTTACA GGAGTTCTTT GGAATTTGTC CTCATGCGAT
    GCTGTAAAGA TGACAATCAT TCGAGATGCT CTCTCAACCT TAACAAACAC TGTGATTGTT
    CCACATTCTG GGTGGAATAA CTCTTCCTTT GATGATGATC ATAAAATTAA ATTTCAGACT
    TCACTAGTTC TGAGGAACAC GACAGGTTGC CTGAGGAACC TCAGCTCTGC AGGGGAGGAA
    GCTCGAAAGC AAATGCGATC CTGTGAGGGA CTGGTAGACT CGCTGTTGTA TGTGATCCAC
    ACATGCGTGA ACACTTCTGA TTACGACAGC AAGACAGTGG AGAACTGCGT GTGCACCCTG
    AGGAACCTAT CATATCGGCT GGAGCTAGAG GTCCCTCAGG CCCGGCTGCT CGGACTGAAT
    GAACTGGATG ACTTGCTAGG AAAAGAGTCT CCCAGCAAAG ACTCAGAACC AAGCTGTTGG
    GGGAAAAAGA AGAAAAAGAA AAAGAGAACT CCACAAGAGG ATCAATGGGA TGGAGTCGGG
    CCTATCCCAG GACTGTCCAA GTCCCCCAAA GGGGTTGAGA TGCTCTGGCA CCCATCAGTG
    GTAAAACCAT ATCTGACTCT TCTAGCAGAA AGTTCCAACC CAGCCACCTT GGAAGGCTCT
    GCTGGATCTC TCCAGAACCT CTCTGCTGGC AACTGGAAGT TTGCAGCATA CATCCGGGCA
    GCTGTTCGAA AAGAAAAAGG GCTCCCCATC CTTGTTGAGC TGCTGAGGAT GGATAATGAC
    AGAGTTGTCT CTTCTGTGGC CACTGCCTTG AGGAACATGG CGCTAGATGT CCGCAACAAG
    GAGCTCATAG GTAAATATGC CATGCGAGAC CTGGTCAATC GGCTTCCTGG GGGCAGCAGC
    CCCAGCATAC TGTCTGACGA GACTGTGGCA GCCATCTGCT GTGCCCTGCA CGAGGTCACC
    AGCAAAAACA TGGAGAATGC CAAAGCCCTG GCTGACTCAG GAGGTATAGA GAAGCTGGTG
    AACATAACCA AAGGCAGAGG AGACAGGTCC TCTCTGAAAG TGGTAAAGGC GGCAGCCCAG
    GTCTTGAATA CATTATGGCA GTATCGGGAC CTGCGGAGCA TTTACAAAAA GGATGGGTGG
    AATCAGAACC ATTTTATTAC ACCTGTGTCA ACATTAGAGC GAGACCGATT CAAATCGCAT
    CCTTCCTTGT CCACCACCAA CCAACAGATG TCACCCATCA TTCAGTCAGT TGGCAGCACC
    TCTTCCTCAC CAGCACTGTT AGGAATCAGA GACCCTCGCT CTGAATATGA TAGGACCCAG
    CCACCTATGC AGTATTACAA TAGCCAAGGG GACGCCACAC ATAAAGGCCT GTACCCTGGC
    TCCAGCAAAC CTTCACCAAT TTACATCAGT TCCTATTCCT CACCAGCAAG AGAACAAAAT
    AGACGGCTAC AGCATCAACA GCTGTATTAC AGTCAAGATG ACTCCACTAG AAAGAACTTT
    GATGCATACA GGTTGTATTT GCAGTCTCCT CATAGCTATG AAGATCCTTA TTTTGACGAC
    AGAGTTCACT TTCCAGCTTC CACTGATTAC TCAACACAGT ATGGACTGAA ATCGACCACA
    AATTACGTAG ACTTTTATTC CACTAAACGA CCTTCTTACA GATCAGAACA GTACCCAGGG
    TCCCCTGACT CGTGGGTGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa141307
    Clone ID Related Accession (Same CDS sequence) XM_029562487.1
    Accession Version XM_029562487.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3432bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X7
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGGTGTTGG AAATCTACAA AGGACATCCA GTCAACGAAG TACCCTTACA
    TACCAAAGAA ATAATTACGC TCTGAACACA ACGGCTACCT ACGCAGAGCC CTACAGGCCA
    ATACAATACC GAGTACAAGA GTGCAGTTAC AACAGGCATG CAGGGCCAAC TGATGATGGT
    ACCACAAGAT CCCCATCAAT AGATAGCATT CAGAAGGACC CCAGGGAGTT TGCTTGGCGT
    GATCCTGAGC TGCCAGAAGT CATTCACATG CTGCAACACC AGTTCCCGTC AGTCCAGGCA
    AACGCAGCGG CCTACCTGCA GCACCTGTGC TTTGGTGACA ACAAAGTGAA GATGGAGGTG
    TATAGGCTAG GGGGAATCAA GCATCTGGTT GACCTTTTGG ACCATAGAGT TTTGGAAGTT
    CAGAAGAATG CTTGTGGTGC CCTCCGAAAC CTTGTTTTTG GCAAGTCTAC AGATGAAAAT
    AAAATAGCAA TGAAGAATGT TGGTGGAATA CCTGCCTTGT TGCGACTGTT AAGAAAGTCT
    ATTGATGCAG AAGTAAGGGA GCTTGTTACA GGAGTTCTTT GGAATTTGTC CTCATGCGAT
    GCTGTAAAGA TGACAATCAT TCGAGATGCT CTCTCAACCT TAACAAACAC TGTGATTGTT
    CCACATTCTG GGTGGAATAA CTCTTCCTTT GATGATGATC ATAAAATTAA ATTTCAGACT
    TCACTAGTTC TGAGGAACAC GACAGGTTGC CTGAGGAACC TCAGCTCTGC AGGGGAGGAA
    GCTCGAAAGC AAATGCGATC CTGTGAGGGA CTGGTAGACT CGCTGTTGTA TGTGATCCAC
    ACATGCGTGA ACACTTCTGA TTACGACAGC AAGACAGTGG AGAACTGCGT GTGCACCCTG
    AGGAACCTAT CATATCGGCT GGAGCTAGAG GTCCCTCAGG CCCGGCTGCT CGGACTGAAT
    GAACTGGATG ACTTGCTAGG AAAAGAGTCT CCCAGCAAAG ACTCAGAACC AAGCTGTTGG
    GGGAAAAAGA AGAAAAAGAA AAAGAGAACT CCACAAGAGG ATCAATGGGA TGGAGTCGGG
    CCTATCCCAG GACTGTCCAA GTCCCCCAAA GGGGTTGAGA TGCTCTGGCA CCCATCAGTG
    GTAAAACCAT ATCTGACTCT TCTAGCAGAA AGTTCCAACC CAGCCACCTT GGAAGGCTCT
    GCTGGATCTC TCCAGAACCT CTCTGCTGGC AACTGGAAGT TTGCAGCATA CATCCGGGCA
    GCTGTTCGAA AAGAAAAAGG GCTCCCCATC CTTGTTGAGC TGCTGAGGAT GGATAATGAC
    AGAGTTGTCT CTTCTGTGGC CACTGCCTTG AGGAACATGG CGCTAGATGT CCGCAACAAG
    GAGCTCATAG GTAAATATGC CATGCGAGAC CTGGTCAATC GGCTTCCTGG GGGCAGCAGC
    CCCAGCATAC TGTCTGACGA GACTGTGGCA GCCATCTGCT GTGCCCTGCA CGAGGTCACC
    AGCAAAAACA TGGAGAATGC CAAAGCCCTG GCTGACTCAG GAGGTATAGA GAAGCTGGTG
    AACATAACCA AAGGCAGAGG AGACAGGTCC TCTCTGAAAG TGGTAAAGGC GGCAGCCCAG
    GTCTTGAATA CATTATGGCA GTATCGGGAC CTGCGGAGCA TTTACAAAAA GGATGGGTGG
    AATCAGAACC ATTTTATTAC ACCTGTGTCA ACATTAGAGC GAGACCGATT CAAATCGCAT
    CCTTCCTTGT CCACCACCAA CCAACAGATG TCACCCATCA TTCAGTCAGG CTCCAGCAAA
    CCTTCACCAA TTTACATCAG TTCCTATTCC TCACCAGCAA GAGAACAAAA TAGACGGCTA
    CAGCATCAAC AGCTGTATTA CAGTCAAGAT GACTCCACTA GAAAGAACTT TGATGCATAC
    AGGTTGTATT TGCAGTCTCC TCATAGCTAT GAAGATCCTT ATTTTGACGA CAGAGTTCAC
    TTTCCAGCTT CCACTGATTA CTCAACACAG TATGGACTGA AATCGACCAC AAATTACGTA
    GACTTTTATT CCACTAAACG ACCTTCTTAC AGATCAGAAC AGTACCCAGG GTCCCCTGAC
    TCGTGGGTGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029418347.1
    CDS1..3432
    Translation

    Target ORF information:

    RefSeq Version XM_029562487.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X7, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029562487.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGGTGTTGG AAATCTACAA AGGACATCCA GTCAACGAAG TACCCTTACA
    TACCAAAGAA ATAATTACGC TCTGAACACA ACGGCTACCT ACGCAGAGCC CTACAGGCCA
    ATACAATACC GAGTACAAGA GTGCAGTTAC AACAGGCATG CAGGGCCAAC TGATGATGGT
    ACCACAAGAT CCCCATCAAT AGATAGCATT CAGAAGGACC CCAGGGAGTT TGCTTGGCGT
    GATCCTGAGC TGCCAGAAGT CATTCACATG CTGCAACACC AGTTCCCGTC AGTCCAGGCA
    AACGCAGCGG CCTACCTGCA GCACCTGTGC TTTGGTGACA ACAAAGTGAA GATGGAGGTG
    TATAGGCTAG GGGGAATCAA GCATCTGGTT GACCTTTTGG ACCATAGAGT TTTGGAAGTT
    CAGAAGAATG CTTGTGGTGC CCTCCGAAAC CTTGTTTTTG GCAAGTCTAC AGATGAAAAT
    AAAATAGCAA TGAAGAATGT TGGTGGAATA CCTGCCTTGT TGCGACTGTT AAGAAAGTCT
    ATTGATGCAG AAGTAAGGGA GCTTGTTACA GGAGTTCTTT GGAATTTGTC CTCATGCGAT
    GCTGTAAAGA TGACAATCAT TCGAGATGCT CTCTCAACCT TAACAAACAC TGTGATTGTT
    CCACATTCTG GGTGGAATAA CTCTTCCTTT GATGATGATC ATAAAATTAA ATTTCAGACT
    TCACTAGTTC TGAGGAACAC GACAGGTTGC CTGAGGAACC TCAGCTCTGC AGGGGAGGAA
    GCTCGAAAGC AAATGCGATC CTGTGAGGGA CTGGTAGACT CGCTGTTGTA TGTGATCCAC
    ACATGCGTGA ACACTTCTGA TTACGACAGC AAGACAGTGG AGAACTGCGT GTGCACCCTG
    AGGAACCTAT CATATCGGCT GGAGCTAGAG GTCCCTCAGG CCCGGCTGCT CGGACTGAAT
    GAACTGGATG ACTTGCTAGG AAAAGAGTCT CCCAGCAAAG ACTCAGAACC AAGCTGTTGG
    GGGAAAAAGA AGAAAAAGAA AAAGAGAACT CCACAAGAGG ATCAATGGGA TGGAGTCGGG
    CCTATCCCAG GACTGTCCAA GTCCCCCAAA GGGGTTGAGA TGCTCTGGCA CCCATCAGTG
    GTAAAACCAT ATCTGACTCT TCTAGCAGAA AGTTCCAACC CAGCCACCTT GGAAGGCTCT
    GCTGGATCTC TCCAGAACCT CTCTGCTGGC AACTGGAAGT TTGCAGCATA CATCCGGGCA
    GCTGTTCGAA AAGAAAAAGG GCTCCCCATC CTTGTTGAGC TGCTGAGGAT GGATAATGAC
    AGAGTTGTCT CTTCTGTGGC CACTGCCTTG AGGAACATGG CGCTAGATGT CCGCAACAAG
    GAGCTCATAG GTAAATATGC CATGCGAGAC CTGGTCAATC GGCTTCCTGG GGGCAGCAGC
    CCCAGCATAC TGTCTGACGA GACTGTGGCA GCCATCTGCT GTGCCCTGCA CGAGGTCACC
    AGCAAAAACA TGGAGAATGC CAAAGCCCTG GCTGACTCAG GAGGTATAGA GAAGCTGGTG
    AACATAACCA AAGGCAGAGG AGACAGGTCC TCTCTGAAAG TGGTAAAGGC GGCAGCCCAG
    GTCTTGAATA CATTATGGCA GTATCGGGAC CTGCGGAGCA TTTACAAAAA GGATGGGTGG
    AATCAGAACC ATTTTATTAC ACCTGTGTCA ACATTAGAGC GAGACCGATT CAAATCGCAT
    CCTTCCTTGT CCACCACCAA CCAACAGATG TCACCCATCA TTCAGTCAGG CTCCAGCAAA
    CCTTCACCAA TTTACATCAG TTCCTATTCC TCACCAGCAA GAGAACAAAA TAGACGGCTA
    CAGCATCAAC AGCTGTATTA CAGTCAAGAT GACTCCACTA GAAAGAACTT TGATGCATAC
    AGGTTGTATT TGCAGTCTCC TCATAGCTAT GAAGATCCTT ATTTTGACGA CAGAGTTCAC
    TTTCCAGCTT CCACTGATTA CTCAACACAG TATGGACTGA AATCGACCAC AAATTACGTA
    GACTTTTATT CCACTAAACG ACCTTCTTAC AGATCAGAAC AGTACCCAGG GTCCCCTGAC
    TCGTGGGTGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa47516
    Clone ID Related Accession (Same CDS sequence) XM_008831019.1
    Accession Version XM_008831019.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3570bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGTT
    GGCAGCACCT CTTCCTCACC AGCACTGTTA GGAATCAGAG ACCCTCGCTC TGAATATGAT
    AGGACCCAGC CACCTATGCA GTATTACAAT AGCCAAGGGG ACGCCACACA TAAAGGCCTG
    TACCCTGGCT CCAGCAAACC TTCACCAATT TACATCAGTT CCTATTCCTC ACCAGCAAGA
    GAACAAAATA GACGGCTACA GCATCAACAG CTGTATTACA GTCAAGATGA CTCCACTAGA
    AAGAACTTTG ATGCATACAG GTTGTATTTG CAGTCTCCTC ATAGCTATGA AGATCCTTAT
    TTTGACGACA GAGTTCACTT TCCAGCTTCC ACTGATTACT CAACACAGTA TGGACTGAAA
    TCGACCACAA ATTACGTAGA CTTTTATTCC ACTAAACGAC CTTCTTACAG ATCAGAACAG
    TACCCAGGGT CCCCTGACTC GTGGGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008829241.1
    CDS1..3570
    Translation

    Target ORF information:

    RefSeq Version XM_008831019.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008831019.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGTT
    GGCAGCACCT CTTCCTCACC AGCACTGTTA GGAATCAGAG ACCCTCGCTC TGAATATGAT
    AGGACCCAGC CACCTATGCA GTATTACAAT AGCCAAGGGG ACGCCACACA TAAAGGCCTG
    TACCCTGGCT CCAGCAAACC TTCACCAATT TACATCAGTT CCTATTCCTC ACCAGCAAGA
    GAACAAAATA GACGGCTACA GCATCAACAG CTGTATTACA GTCAAGATGA CTCCACTAGA
    AAGAACTTTG ATGCATACAG GTTGTATTTG CAGTCTCCTC ATAGCTATGA AGATCCTTAT
    TTTGACGACA GAGTTCACTT TCCAGCTTCC ACTGATTACT CAACACAGTA TGGACTGAAA
    TCGACCACAA ATTACGTAGA CTTTTATTCC ACTAAACGAC CTTCTTACAG ATCAGAACAG
    TACCCAGGGT CCCCTGACTC GTGGGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa47517
    Clone ID Related Accession (Same CDS sequence) XM_017797608.1
    Accession Version XM_017797608.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3567bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGG TGTTGGAAAT CTACAAAGGA CATCCAGTCA ACGAAGTACC
    CTTACATACC AAAGAAATAA TTACGCTCTG AACACAACGG CTACCTACGC AGAGCCCTAC
    AGGCCAATAC AATACCGAGT ACAAGAGTGC AGTTACAACA GGCATGCAGG GCCAACTGAT
    GATGGTACCA CAAGATCCCC ATCAATAGAT AGCATTCAGA AGGACCCCAG GGAGTTTGCT
    TGGCGTGATC CTGAGCTGCC AGAAGTCATT CACATGCTGC AACACCAGTT CCCGTCAGTC
    CAGGCAAACG CAGCGGCCTA CCTGCAGCAC CTGTGCTTTG GTGACAACAA AGTGAAGATG
    GAGGTGTATA GGCTAGGGGG AATCAAGCAT CTGGTTGACC TTTTGGACCA TAGAGTTTTG
    GAAGTTCAGA AGAATGCTTG TGGTGCCCTC CGAAACCTTG TTTTTGGCAA GTCTACAGAT
    GAAAATAAAA TAGCAATGAA GAATGTTGGT GGAATACCTG CCTTGTTGCG ACTGTTAAGA
    AAGTCTATTG ATGCAGAAGT AAGGGAGCTT GTTACAGGAG TTCTTTGGAA TTTGTCCTCA
    TGCGATGCTG TAAAGATGAC AATCATTCGA GATGCTCTCT CAACCTTAAC AAACACTGTG
    ATTGTTCCAC ATTCTGGGTG GAATAACTCT TCCTTTGATG ATGATCATAA AATTAAATTT
    CAGACTTCAC TAGTTCTGAG GAACACGACA GGTTGCCTGA GGAACCTCAG CTCTGCAGGG
    GAGGAAGCTC GAAAGCAAAT GCGATCCTGT GAGGGACTGG TAGACTCGCT GTTGTATGTG
    ATCCACACAT GCGTGAACAC TTCTGATTAC GACAGCAAGA CAGTGGAGAA CTGCGTGTGC
    ACCCTGAGGA ACCTATCATA TCGGCTGGAG CTAGAGGTCC CTCAGGCCCG GCTGCTCGGA
    CTGAATGAAC TGGATGACTT GCTAGGAAAA GAGTCTCCCA GCAAAGACTC AGAACCAAGC
    TGTTGGGGGA AAAAGAAGAA AAAGAAAAAG AGAACTCCAC AAGAGGATCA ATGGGATGGA
    GTCGGGCCTA TCCCAGGACT GTCCAAGTCC CCCAAAGGGG TTGAGATGCT CTGGCACCCA
    TCAGTGGTAA AACCATATCT GACTCTTCTA GCAGAAAGTT CCAACCCAGC CACCTTGGAA
    GGCTCTGCTG GATCTCTCCA GAACCTCTCT GCTGGCAACT GGAAGTTTGC AGCATACATC
    CGGGCAGCTG TTCGAAAAGA AAAAGGGCTC CCCATCCTTG TTGAGCTGCT GAGGATGGAT
    AATGACAGAG TTGTCTCTTC TGTGGCCACT GCCTTGAGGA ACATGGCGCT AGATGTCCGC
    AACAAGGAGC TCATAGGTAA ATATGCCATG CGAGACCTGG TCAATCGGCT TCCTGGGGGC
    AGCAGCCCCA GCATACTGTC TGACGAGACT GTGGCAGCCA TCTGCTGTGC CCTGCACGAG
    GTCACCAGCA AAAACATGGA GAATGCCAAA GCCCTGGCTG ACTCAGGAGG TATAGAGAAG
    CTGGTGAACA TAACCAAAGG CAGAGGAGAC AGGTCCTCTC TGAAAGTGGT AAAGGCGGCA
    GCCCAGGTCT TGAATACATT ATGGCAGTAT CGGGACCTGC GGAGCATTTA CAAAAAGGAT
    GGGTGGAATC AGAACCATTT TATTACACCT GTGTCAACAT TAGAGCGAGA CCGATTCAAA
    TCGCATCCTT CCTTGTCCAC CACCAACCAA CAGATGTCAC CCATCATTCA GTCAGTTGGC
    AGCACCTCTT CCTCACCAGC ACTGTTAGGA ATCAGAGACC CTCGCTCTGA ATATGATAGG
    ACCCAGCCAC CTATGCAGTA TTACAATAGC CAAGGGGACG CCACACATAA AGGCCTGTAC
    CCTGGCTCCA GCAAACCTTC ACCAATTTAC ATCAGTTCCT ATTCCTCACC AGCAAGAGAA
    CAAAATAGAC GGCTACAGCA TCAACAGCTG TATTACAGTC AAGATGACTC CACTAGAAAG
    AACTTTGATG CATACAGGTT GTATTTGCAG TCTCCTCATA GCTATGAAGA TCCTTATTTT
    GACGACAGAG TTCACTTTCC AGCTTCCACT GATTACTCAA CACAGTATGG ACTGAAATCG
    ACCACAAATT ACGTAGACTT TTATTCCACT AAACGACCTT CTTACAGATC AGAACAGTAC
    CCAGGGTCCC CTGACTCGTG GGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653097.1
    CDS1..3567
    Translation

    Target ORF information:

    RefSeq Version XM_017797608.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797608.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGG TGTTGGAAAT CTACAAAGGA CATCCAGTCA ACGAAGTACC
    CTTACATACC AAAGAAATAA TTACGCTCTG AACACAACGG CTACCTACGC AGAGCCCTAC
    AGGCCAATAC AATACCGAGT ACAAGAGTGC AGTTACAACA GGCATGCAGG GCCAACTGAT
    GATGGTACCA CAAGATCCCC ATCAATAGAT AGCATTCAGA AGGACCCCAG GGAGTTTGCT
    TGGCGTGATC CTGAGCTGCC AGAAGTCATT CACATGCTGC AACACCAGTT CCCGTCAGTC
    CAGGCAAACG CAGCGGCCTA CCTGCAGCAC CTGTGCTTTG GTGACAACAA AGTGAAGATG
    GAGGTGTATA GGCTAGGGGG AATCAAGCAT CTGGTTGACC TTTTGGACCA TAGAGTTTTG
    GAAGTTCAGA AGAATGCTTG TGGTGCCCTC CGAAACCTTG TTTTTGGCAA GTCTACAGAT
    GAAAATAAAA TAGCAATGAA GAATGTTGGT GGAATACCTG CCTTGTTGCG ACTGTTAAGA
    AAGTCTATTG ATGCAGAAGT AAGGGAGCTT GTTACAGGAG TTCTTTGGAA TTTGTCCTCA
    TGCGATGCTG TAAAGATGAC AATCATTCGA GATGCTCTCT CAACCTTAAC AAACACTGTG
    ATTGTTCCAC ATTCTGGGTG GAATAACTCT TCCTTTGATG ATGATCATAA AATTAAATTT
    CAGACTTCAC TAGTTCTGAG GAACACGACA GGTTGCCTGA GGAACCTCAG CTCTGCAGGG
    GAGGAAGCTC GAAAGCAAAT GCGATCCTGT GAGGGACTGG TAGACTCGCT GTTGTATGTG
    ATCCACACAT GCGTGAACAC TTCTGATTAC GACAGCAAGA CAGTGGAGAA CTGCGTGTGC
    ACCCTGAGGA ACCTATCATA TCGGCTGGAG CTAGAGGTCC CTCAGGCCCG GCTGCTCGGA
    CTGAATGAAC TGGATGACTT GCTAGGAAAA GAGTCTCCCA GCAAAGACTC AGAACCAAGC
    TGTTGGGGGA AAAAGAAGAA AAAGAAAAAG AGAACTCCAC AAGAGGATCA ATGGGATGGA
    GTCGGGCCTA TCCCAGGACT GTCCAAGTCC CCCAAAGGGG TTGAGATGCT CTGGCACCCA
    TCAGTGGTAA AACCATATCT GACTCTTCTA GCAGAAAGTT CCAACCCAGC CACCTTGGAA
    GGCTCTGCTG GATCTCTCCA GAACCTCTCT GCTGGCAACT GGAAGTTTGC AGCATACATC
    CGGGCAGCTG TTCGAAAAGA AAAAGGGCTC CCCATCCTTG TTGAGCTGCT GAGGATGGAT
    AATGACAGAG TTGTCTCTTC TGTGGCCACT GCCTTGAGGA ACATGGCGCT AGATGTCCGC
    AACAAGGAGC TCATAGGTAA ATATGCCATG CGAGACCTGG TCAATCGGCT TCCTGGGGGC
    AGCAGCCCCA GCATACTGTC TGACGAGACT GTGGCAGCCA TCTGCTGTGC CCTGCACGAG
    GTCACCAGCA AAAACATGGA GAATGCCAAA GCCCTGGCTG ACTCAGGAGG TATAGAGAAG
    CTGGTGAACA TAACCAAAGG CAGAGGAGAC AGGTCCTCTC TGAAAGTGGT AAAGGCGGCA
    GCCCAGGTCT TGAATACATT ATGGCAGTAT CGGGACCTGC GGAGCATTTA CAAAAAGGAT
    GGGTGGAATC AGAACCATTT TATTACACCT GTGTCAACAT TAGAGCGAGA CCGATTCAAA
    TCGCATCCTT CCTTGTCCAC CACCAACCAA CAGATGTCAC CCATCATTCA GTCAGTTGGC
    AGCACCTCTT CCTCACCAGC ACTGTTAGGA ATCAGAGACC CTCGCTCTGA ATATGATAGG
    ACCCAGCCAC CTATGCAGTA TTACAATAGC CAAGGGGACG CCACACATAA AGGCCTGTAC
    CCTGGCTCCA GCAAACCTTC ACCAATTTAC ATCAGTTCCT ATTCCTCACC AGCAAGAGAA
    CAAAATAGAC GGCTACAGCA TCAACAGCTG TATTACAGTC AAGATGACTC CACTAGAAAG
    AACTTTGATG CATACAGGTT GTATTTGCAG TCTCCTCATA GCTATGAAGA TCCTTATTTT
    GACGACAGAG TTCACTTTCC AGCTTCCACT GATTACTCAA CACAGTATGG ACTGAAATCG
    ACCACAAATT ACGTAGACTT TTATTCCACT AAACGACCTT CTTACAGATC AGAACAGTAC
    CCAGGGTCCC CTGACTCGTG GGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa47518
    Clone ID Related Accession (Same CDS sequence) XM_017797609.1
    Accession Version XM_017797609.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3564bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGCAGGTGT TGGAAATCTA CAAAGGACAT CCAGTCAACG AAGTACCCTT
    ACATACCAAA GAAATAATTA CGCTCTGAAC ACAACGGCTA CCTACGCAGA GCCCTACAGG
    CCAATACAAT ACCGAGTACA AGAGTGCAGT TACAACAGGC ATGCAGGGCC AACTGATGAT
    GGTACCACAA GATCCCCATC AATAGATAGC ATTCAGAAGG ACCCCAGGGA GTTTGCTTGG
    CGTGATCCTG AGCTGCCAGA AGTCATTCAC ATGCTGCAAC ACCAGTTCCC GTCAGTCCAG
    GCAAACGCAG CGGCCTACCT GCAGCACCTG TGCTTTGGTG ACAACAAAGT GAAGATGGAG
    GTGTATAGGC TAGGGGGAAT CAAGCATCTG GTTGACCTTT TGGACCATAG AGTTTTGGAA
    GTTCAGAAGA ATGCTTGTGG TGCCCTCCGA AACCTTGTTT TTGGCAAGTC TACAGATGAA
    AATAAAATAG CAATGAAGAA TGTTGGTGGA ATACCTGCCT TGTTGCGACT GTTAAGAAAG
    TCTATTGATG CAGAAGTAAG GGAGCTTGTT ACAGGAGTTC TTTGGAATTT GTCCTCATGC
    GATGCTGTAA AGATGACAAT CATTCGAGAT GCTCTCTCAA CCTTAACAAA CACTGTGATT
    GTTCCACATT CTGGGTGGAA TAACTCTTCC TTTGATGATG ATCATAAAAT TAAATTTCAG
    ACTTCACTAG TTCTGAGGAA CACGACAGGT TGCCTGAGGA ACCTCAGCTC TGCAGGGGAG
    GAAGCTCGAA AGCAAATGCG ATCCTGTGAG GGACTGGTAG ACTCGCTGTT GTATGTGATC
    CACACATGCG TGAACACTTC TGATTACGAC AGCAAGACAG TGGAGAACTG CGTGTGCACC
    CTGAGGAACC TATCATATCG GCTGGAGCTA GAGGTCCCTC AGGCCCGGCT GCTCGGACTG
    AATGAACTGG ATGACTTGCT AGGAAAAGAG TCTCCCAGCA AAGACTCAGA ACCAAGCTGT
    TGGGGGAAAA AGAAGAAAAA GAAAAAGAGA ACTCCACAAG AGGATCAATG GGATGGAGTC
    GGGCCTATCC CAGGACTGTC CAAGTCCCCC AAAGGGGTTG AGATGCTCTG GCACCCATCA
    GTGGTAAAAC CATATCTGAC TCTTCTAGCA GAAAGTTCCA ACCCAGCCAC CTTGGAAGGC
    TCTGCTGGAT CTCTCCAGAA CCTCTCTGCT GGCAACTGGA AGTTTGCAGC ATACATCCGG
    GCAGCTGTTC GAAAAGAAAA AGGGCTCCCC ATCCTTGTTG AGCTGCTGAG GATGGATAAT
    GACAGAGTTG TCTCTTCTGT GGCCACTGCC TTGAGGAACA TGGCGCTAGA TGTCCGCAAC
    AAGGAGCTCA TAGGTAAATA TGCCATGCGA GACCTGGTCA ATCGGCTTCC TGGGGGCAGC
    AGCCCCAGCA TACTGTCTGA CGAGACTGTG GCAGCCATCT GCTGTGCCCT GCACGAGGTC
    ACCAGCAAAA ACATGGAGAA TGCCAAAGCC CTGGCTGACT CAGGAGGTAT AGAGAAGCTG
    GTGAACATAA CCAAAGGCAG AGGAGACAGG TCCTCTCTGA AAGTGGTAAA GGCGGCAGCC
    CAGGTCTTGA ATACATTATG GCAGTATCGG GACCTGCGGA GCATTTACAA AAAGGATGGG
    TGGAATCAGA ACCATTTTAT TACACCTGTG TCAACATTAG AGCGAGACCG ATTCAAATCG
    CATCCTTCCT TGTCCACCAC CAACCAACAG ATGTCACCCA TCATTCAGTC AGTTGGCAGC
    ACCTCTTCCT CACCAGCACT GTTAGGAATC AGAGACCCTC GCTCTGAATA TGATAGGACC
    CAGCCACCTA TGCAGTATTA CAATAGCCAA GGGGACGCCA CACATAAAGG CCTGTACCCT
    GGCTCCAGCA AACCTTCACC AATTTACATC AGTTCCTATT CCTCACCAGC AAGAGAACAA
    AATAGACGGC TACAGCATCA ACAGCTGTAT TACAGTCAAG ATGACTCCAC TAGAAAGAAC
    TTTGATGCAT ACAGGTTGTA TTTGCAGTCT CCTCATAGCT ATGAAGATCC TTATTTTGAC
    GACAGAGTTC ACTTTCCAGC TTCCACTGAT TACTCAACAC AGTATGGACT GAAATCGACC
    ACAAATTACG TAGACTTTTA TTCCACTAAA CGACCTTCTT ACAGATCAGA ACAGTACCCA
    GGGTCCCCTG ACTCGTGGGT GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653098.1
    CDS1..3564
    Translation

    Target ORF information:

    RefSeq Version XM_017797609.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797609.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGCAGGTGT TGGAAATCTA CAAAGGACAT CCAGTCAACG AAGTACCCTT
    ACATACCAAA GAAATAATTA CGCTCTGAAC ACAACGGCTA CCTACGCAGA GCCCTACAGG
    CCAATACAAT ACCGAGTACA AGAGTGCAGT TACAACAGGC ATGCAGGGCC AACTGATGAT
    GGTACCACAA GATCCCCATC AATAGATAGC ATTCAGAAGG ACCCCAGGGA GTTTGCTTGG
    CGTGATCCTG AGCTGCCAGA AGTCATTCAC ATGCTGCAAC ACCAGTTCCC GTCAGTCCAG
    GCAAACGCAG CGGCCTACCT GCAGCACCTG TGCTTTGGTG ACAACAAAGT GAAGATGGAG
    GTGTATAGGC TAGGGGGAAT CAAGCATCTG GTTGACCTTT TGGACCATAG AGTTTTGGAA
    GTTCAGAAGA ATGCTTGTGG TGCCCTCCGA AACCTTGTTT TTGGCAAGTC TACAGATGAA
    AATAAAATAG CAATGAAGAA TGTTGGTGGA ATACCTGCCT TGTTGCGACT GTTAAGAAAG
    TCTATTGATG CAGAAGTAAG GGAGCTTGTT ACAGGAGTTC TTTGGAATTT GTCCTCATGC
    GATGCTGTAA AGATGACAAT CATTCGAGAT GCTCTCTCAA CCTTAACAAA CACTGTGATT
    GTTCCACATT CTGGGTGGAA TAACTCTTCC TTTGATGATG ATCATAAAAT TAAATTTCAG
    ACTTCACTAG TTCTGAGGAA CACGACAGGT TGCCTGAGGA ACCTCAGCTC TGCAGGGGAG
    GAAGCTCGAA AGCAAATGCG ATCCTGTGAG GGACTGGTAG ACTCGCTGTT GTATGTGATC
    CACACATGCG TGAACACTTC TGATTACGAC AGCAAGACAG TGGAGAACTG CGTGTGCACC
    CTGAGGAACC TATCATATCG GCTGGAGCTA GAGGTCCCTC AGGCCCGGCT GCTCGGACTG
    AATGAACTGG ATGACTTGCT AGGAAAAGAG TCTCCCAGCA AAGACTCAGA ACCAAGCTGT
    TGGGGGAAAA AGAAGAAAAA GAAAAAGAGA ACTCCACAAG AGGATCAATG GGATGGAGTC
    GGGCCTATCC CAGGACTGTC CAAGTCCCCC AAAGGGGTTG AGATGCTCTG GCACCCATCA
    GTGGTAAAAC CATATCTGAC TCTTCTAGCA GAAAGTTCCA ACCCAGCCAC CTTGGAAGGC
    TCTGCTGGAT CTCTCCAGAA CCTCTCTGCT GGCAACTGGA AGTTTGCAGC ATACATCCGG
    GCAGCTGTTC GAAAAGAAAA AGGGCTCCCC ATCCTTGTTG AGCTGCTGAG GATGGATAAT
    GACAGAGTTG TCTCTTCTGT GGCCACTGCC TTGAGGAACA TGGCGCTAGA TGTCCGCAAC
    AAGGAGCTCA TAGGTAAATA TGCCATGCGA GACCTGGTCA ATCGGCTTCC TGGGGGCAGC
    AGCCCCAGCA TACTGTCTGA CGAGACTGTG GCAGCCATCT GCTGTGCCCT GCACGAGGTC
    ACCAGCAAAA ACATGGAGAA TGCCAAAGCC CTGGCTGACT CAGGAGGTAT AGAGAAGCTG
    GTGAACATAA CCAAAGGCAG AGGAGACAGG TCCTCTCTGA AAGTGGTAAA GGCGGCAGCC
    CAGGTCTTGA ATACATTATG GCAGTATCGG GACCTGCGGA GCATTTACAA AAAGGATGGG
    TGGAATCAGA ACCATTTTAT TACACCTGTG TCAACATTAG AGCGAGACCG ATTCAAATCG
    CATCCTTCCT TGTCCACCAC CAACCAACAG ATGTCACCCA TCATTCAGTC AGTTGGCAGC
    ACCTCTTCCT CACCAGCACT GTTAGGAATC AGAGACCCTC GCTCTGAATA TGATAGGACC
    CAGCCACCTA TGCAGTATTA CAATAGCCAA GGGGACGCCA CACATAAAGG CCTGTACCCT
    GGCTCCAGCA AACCTTCACC AATTTACATC AGTTCCTATT CCTCACCAGC AAGAGAACAA
    AATAGACGGC TACAGCATCA ACAGCTGTAT TACAGTCAAG ATGACTCCAC TAGAAAGAAC
    TTTGATGCAT ACAGGTTGTA TTTGCAGTCT CCTCATAGCT ATGAAGATCC TTATTTTGAC
    GACAGAGTTC ACTTTCCAGC TTCCACTGAT TACTCAACAC AGTATGGACT GAAATCGACC
    ACAAATTACG TAGACTTTTA TTCCACTAAA CGACCTTCTT ACAGATCAGA ACAGTACCCA
    GGGTCCCCTG ACTCGTGGGT GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa47519
    Clone ID Related Accession (Same CDS sequence) XM_017797610.1
    Accession Version XM_017797610.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3441bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGGC
    TCCAGCAAAC CTTCACCAAT TTACATCAGT TCCTATTCCT CACCAGCAAG AGAACAAAAT
    AGACGGCTAC AGCATCAACA GCTGTATTAC AGTCAAGATG ACTCCACTAG AAAGAACTTT
    GATGCATACA GGTTGTATTT GCAGTCTCCT CATAGCTATG AAGATCCTTA TTTTGACGAC
    AGAGTTCACT TTCCAGCTTC CACTGATTAC TCAACACAGT ATGGACTGAA ATCGACCACA
    AATTACGTAG ACTTTTATTC CACTAAACGA CCTTCTTACA GATCAGAACA GTACCCAGGG
    TCCCCTGACT CGTGGGTGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653099.1
    CDS1..3441
    Translation

    Target ORF information:

    RefSeq Version XM_017797610.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797610.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGGC
    TCCAGCAAAC CTTCACCAAT TTACATCAGT TCCTATTCCT CACCAGCAAG AGAACAAAAT
    AGACGGCTAC AGCATCAACA GCTGTATTAC AGTCAAGATG ACTCCACTAG AAAGAACTTT
    GATGCATACA GGTTGTATTT GCAGTCTCCT CATAGCTATG AAGATCCTTA TTTTGACGAC
    AGAGTTCACT TTCCAGCTTC CACTGATTAC TCAACACAGT ATGGACTGAA ATCGACCACA
    AATTACGTAG ACTTTTATTC CACTAAACGA CCTTCTTACA GATCAGAACA GTACCCAGGG
    TCCCCTGACT CGTGGGTGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa47520
    Clone ID Related Accession (Same CDS sequence) XM_017797611.1
    Accession Version XM_017797611.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3435bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGCAGGTGT TGGAAATCTA CAAAGGACAT CCAGTCAACG AAGTACCCTT
    ACATACCAAA GAAATAATTA CGCTCTGAAC ACAACGGCTA CCTACGCAGA GCCCTACAGG
    CCAATACAAT ACCGAGTACA AGAGTGCAGT TACAACAGGC ATGCAGGGCC AACTGATGAT
    GGTACCACAA GATCCCCATC AATAGATAGC ATTCAGAAGG ACCCCAGGGA GTTTGCTTGG
    CGTGATCCTG AGCTGCCAGA AGTCATTCAC ATGCTGCAAC ACCAGTTCCC GTCAGTCCAG
    GCAAACGCAG CGGCCTACCT GCAGCACCTG TGCTTTGGTG ACAACAAAGT GAAGATGGAG
    GTGTATAGGC TAGGGGGAAT CAAGCATCTG GTTGACCTTT TGGACCATAG AGTTTTGGAA
    GTTCAGAAGA ATGCTTGTGG TGCCCTCCGA AACCTTGTTT TTGGCAAGTC TACAGATGAA
    AATAAAATAG CAATGAAGAA TGTTGGTGGA ATACCTGCCT TGTTGCGACT GTTAAGAAAG
    TCTATTGATG CAGAAGTAAG GGAGCTTGTT ACAGGAGTTC TTTGGAATTT GTCCTCATGC
    GATGCTGTAA AGATGACAAT CATTCGAGAT GCTCTCTCAA CCTTAACAAA CACTGTGATT
    GTTCCACATT CTGGGTGGAA TAACTCTTCC TTTGATGATG ATCATAAAAT TAAATTTCAG
    ACTTCACTAG TTCTGAGGAA CACGACAGGT TGCCTGAGGA ACCTCAGCTC TGCAGGGGAG
    GAAGCTCGAA AGCAAATGCG ATCCTGTGAG GGACTGGTAG ACTCGCTGTT GTATGTGATC
    CACACATGCG TGAACACTTC TGATTACGAC AGCAAGACAG TGGAGAACTG CGTGTGCACC
    CTGAGGAACC TATCATATCG GCTGGAGCTA GAGGTCCCTC AGGCCCGGCT GCTCGGACTG
    AATGAACTGG ATGACTTGCT AGGAAAAGAG TCTCCCAGCA AAGACTCAGA ACCAAGCTGT
    TGGGGGAAAA AGAAGAAAAA GAAAAAGAGA ACTCCACAAG AGGATCAATG GGATGGAGTC
    GGGCCTATCC CAGGACTGTC CAAGTCCCCC AAAGGGGTTG AGATGCTCTG GCACCCATCA
    GTGGTAAAAC CATATCTGAC TCTTCTAGCA GAAAGTTCCA ACCCAGCCAC CTTGGAAGGC
    TCTGCTGGAT CTCTCCAGAA CCTCTCTGCT GGCAACTGGA AGTTTGCAGC ATACATCCGG
    GCAGCTGTTC GAAAAGAAAA AGGGCTCCCC ATCCTTGTTG AGCTGCTGAG GATGGATAAT
    GACAGAGTTG TCTCTTCTGT GGCCACTGCC TTGAGGAACA TGGCGCTAGA TGTCCGCAAC
    AAGGAGCTCA TAGGTAAATA TGCCATGCGA GACCTGGTCA ATCGGCTTCC TGGGGGCAGC
    AGCCCCAGCA TACTGTCTGA CGAGACTGTG GCAGCCATCT GCTGTGCCCT GCACGAGGTC
    ACCAGCAAAA ACATGGAGAA TGCCAAAGCC CTGGCTGACT CAGGAGGTAT AGAGAAGCTG
    GTGAACATAA CCAAAGGCAG AGGAGACAGG TCCTCTCTGA AAGTGGTAAA GGCGGCAGCC
    CAGGTCTTGA ATACATTATG GCAGTATCGG GACCTGCGGA GCATTTACAA AAAGGATGGG
    TGGAATCAGA ACCATTTTAT TACACCTGTG TCAACATTAG AGCGAGACCG ATTCAAATCG
    CATCCTTCCT TGTCCACCAC CAACCAACAG ATGTCACCCA TCATTCAGTC AGGCTCCAGC
    AAACCTTCAC CAATTTACAT CAGTTCCTAT TCCTCACCAG CAAGAGAACA AAATAGACGG
    CTACAGCATC AACAGCTGTA TTACAGTCAA GATGACTCCA CTAGAAAGAA CTTTGATGCA
    TACAGGTTGT ATTTGCAGTC TCCTCATAGC TATGAAGATC CTTATTTTGA CGACAGAGTT
    CACTTTCCAG CTTCCACTGA TTACTCAACA CAGTATGGAC TGAAATCGAC CACAAATTAC
    GTAGACTTTT ATTCCACTAA ACGACCTTCT TACAGATCAG AACAGTACCC AGGGTCCCCT
    GACTCGTGGG TGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653100.1
    CDS1..3435
    Translation

    Target ORF information:

    RefSeq Version XM_017797611.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797611.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGATCATT GGGTAACTCA
    AGAAGTTCAA CGCAAATGAA TTCTTATTCT GACAGTGGGT ACCAGGAAGC AGGGAGTTTC
    CACAACACCC AAACCGTGAG CAAGGCAGAT AGTAGACAGC AGCATTTATT CACAGGATCA
    GCAAATAACC ATTTGGTGAG GAACTCAAGG GCTGAAGGAC AAACACTGGT TCAGCCATCA
    GTAGCCAATC GGGCCATGAG AAGAGTTAGT TCAGTTCCAT CTAGAGCACA GTCTCCTTCT
    TATGTTATCA GCACAGGCGT GTCTCCATCA AGGGGGTCAC TAAGAACTTC TCTGGGTAGT
    GGATTTGGCT CTCCATCAGT GACCGACTCC CGACCTCTGA ACCCCAGTGC ATACTCATCT
    ACCACATTAC CTGCTCAGAG AGCAACCTCT CCGTACTCAC AGAGACCTGC CTCCCCAACA
    GCTGTGCGGA GGATTGGGTC TGTCACCTCC CGACAGACCT GCAATCCTAA CGGACCAGCC
    CCTCAATACC AAACTACCAC CAGGGTGGGG TCCCCACTGA CCCTGACAGA TGCCCAGACT
    CGAGTAGCTT CCCCATCCCA AGGCCAAGTG GGGTCATCAT CCCCAAAACG CTCAGGGATG
    ACCGCCGTAC CACAGCATCT GGGACCTTCA CTGCAAAGGA CTGTTCACGA CATGGAGCAA
    TTCGGACAGC AGCAGTACGA TATTTATGAG AGGATGGTTC CACCACGGCC AGACAGCCTG
    ACAGGCTTAC GGAGTTCCTA TGCCAGTCAG CATAGCCAGC TTGGGCAAGA CCTTCGTTCA
    ACTGTGTCTC CTGACTTGCA CATCACTCCT ATATATGAAG GGAGGACCTA CTACAGTCCA
    GTGTACCGCA GCCCAAACCA TGGAACTGTG GAGCTCCAAG GATCGCAGAC AGCATTGTAT
    CGCACAGGCT CAGCAGGTGT TGGAAATCTA CAAAGGACAT CCAGTCAACG AAGTACCCTT
    ACATACCAAA GAAATAATTA CGCTCTGAAC ACAACGGCTA CCTACGCAGA GCCCTACAGG
    CCAATACAAT ACCGAGTACA AGAGTGCAGT TACAACAGGC ATGCAGGGCC AACTGATGAT
    GGTACCACAA GATCCCCATC AATAGATAGC ATTCAGAAGG ACCCCAGGGA GTTTGCTTGG
    CGTGATCCTG AGCTGCCAGA AGTCATTCAC ATGCTGCAAC ACCAGTTCCC GTCAGTCCAG
    GCAAACGCAG CGGCCTACCT GCAGCACCTG TGCTTTGGTG ACAACAAAGT GAAGATGGAG
    GTGTATAGGC TAGGGGGAAT CAAGCATCTG GTTGACCTTT TGGACCATAG AGTTTTGGAA
    GTTCAGAAGA ATGCTTGTGG TGCCCTCCGA AACCTTGTTT TTGGCAAGTC TACAGATGAA
    AATAAAATAG CAATGAAGAA TGTTGGTGGA ATACCTGCCT TGTTGCGACT GTTAAGAAAG
    TCTATTGATG CAGAAGTAAG GGAGCTTGTT ACAGGAGTTC TTTGGAATTT GTCCTCATGC
    GATGCTGTAA AGATGACAAT CATTCGAGAT GCTCTCTCAA CCTTAACAAA CACTGTGATT
    GTTCCACATT CTGGGTGGAA TAACTCTTCC TTTGATGATG ATCATAAAAT TAAATTTCAG
    ACTTCACTAG TTCTGAGGAA CACGACAGGT TGCCTGAGGA ACCTCAGCTC TGCAGGGGAG
    GAAGCTCGAA AGCAAATGCG ATCCTGTGAG GGACTGGTAG ACTCGCTGTT GTATGTGATC
    CACACATGCG TGAACACTTC TGATTACGAC AGCAAGACAG TGGAGAACTG CGTGTGCACC
    CTGAGGAACC TATCATATCG GCTGGAGCTA GAGGTCCCTC AGGCCCGGCT GCTCGGACTG
    AATGAACTGG ATGACTTGCT AGGAAAAGAG TCTCCCAGCA AAGACTCAGA ACCAAGCTGT
    TGGGGGAAAA AGAAGAAAAA GAAAAAGAGA ACTCCACAAG AGGATCAATG GGATGGAGTC
    GGGCCTATCC CAGGACTGTC CAAGTCCCCC AAAGGGGTTG AGATGCTCTG GCACCCATCA
    GTGGTAAAAC CATATCTGAC TCTTCTAGCA GAAAGTTCCA ACCCAGCCAC CTTGGAAGGC
    TCTGCTGGAT CTCTCCAGAA CCTCTCTGCT GGCAACTGGA AGTTTGCAGC ATACATCCGG
    GCAGCTGTTC GAAAAGAAAA AGGGCTCCCC ATCCTTGTTG AGCTGCTGAG GATGGATAAT
    GACAGAGTTG TCTCTTCTGT GGCCACTGCC TTGAGGAACA TGGCGCTAGA TGTCCGCAAC
    AAGGAGCTCA TAGGTAAATA TGCCATGCGA GACCTGGTCA ATCGGCTTCC TGGGGGCAGC
    AGCCCCAGCA TACTGTCTGA CGAGACTGTG GCAGCCATCT GCTGTGCCCT GCACGAGGTC
    ACCAGCAAAA ACATGGAGAA TGCCAAAGCC CTGGCTGACT CAGGAGGTAT AGAGAAGCTG
    GTGAACATAA CCAAAGGCAG AGGAGACAGG TCCTCTCTGA AAGTGGTAAA GGCGGCAGCC
    CAGGTCTTGA ATACATTATG GCAGTATCGG GACCTGCGGA GCATTTACAA AAAGGATGGG
    TGGAATCAGA ACCATTTTAT TACACCTGTG TCAACATTAG AGCGAGACCG ATTCAAATCG
    CATCCTTCCT TGTCCACCAC CAACCAACAG ATGTCACCCA TCATTCAGTC AGGCTCCAGC
    AAACCTTCAC CAATTTACAT CAGTTCCTAT TCCTCACCAG CAAGAGAACA AAATAGACGG
    CTACAGCATC AACAGCTGTA TTACAGTCAA GATGACTCCA CTAGAAAGAA CTTTGATGCA
    TACAGGTTGT ATTTGCAGTC TCCTCATAGC TATGAAGATC CTTATTTTGA CGACAGAGTT
    CACTTTCCAG CTTCCACTGA TTACTCAACA CAGTATGGAC TGAAATCGAC CACAAATTAC
    GTAGACTTTT ATTCCACTAA ACGACCTTCT TACAGATCAG AACAGTACCC AGGGTCCCCT
    GACTCGTGGG TGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa47521
    Clone ID Related Accession (Same CDS sequence) XM_017797612.1 , XM_017797612.2
    Accession Version XM_017797612.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3147bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGCA
    TCAACAGCTG TATTACAGTC AAGATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653101.1
    CDS1..3147
    Translation

    Target ORF information:

    RefSeq Version XM_017797612.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797612.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGCA
    TCAACAGCTG TATTACAGTC AAGATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa47521
    Clone ID Related Accession (Same CDS sequence) XM_017797612.1 , XM_017797612.2
    Accession Version XM_017797612.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3147bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product plakophilin-4 isoform X8
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008336309.1) and transcript sequence (JL984902.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017797612.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 132 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGCA
    TCAACAGCTG TATTACAGTC AAGATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017653101.1
    CDS1..3147
    Translation

    Target ORF information:

    RefSeq Version XM_017797612.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili plakophilin 4 (Pkp4), transcript variant X8, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017797612.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGCCCGCTC CTGAGCAAGC CTCACTGGTG GAGGAGGGGC AGCCACAGAA CCACCAGGAA 
    GCTGTCTCCA CTGGGCCAGG CATGGAACCC GAGACCACAG CCACCACTAT TCTAGCTTCC
    GTGAAGGAGC AGGAGCTTCA GTTTCAACGA CTTACCCGAG AACTGGAAGT GGAAAGGCAG
    ATTGTTGCCA GTCAGCTAGA AAGATGTAGG CTTGGAGCAG AATCGCCAAG TATCGCCAGC
    ACCAGCTCAA CTGAAAAGTC ATTTCCCTGG AGATCAACAG ATGTGCCAAT TACTGGTGTA
    GGCAAACCTA GAGTTTCTGA CGCTGTCCAT CCCAACTATC TCATCAGGAC AGAGCCAGAA
    CAAGGGACCC TCTACTCACC AGAGCAGACA TCTCTCCATG AAAGTGAGGG ATCATTGGGT
    AACTCAAGAA GTTCAACGCA AATGAATTCT TATTCTGACA GTGGGTACCA GGAAGCAGGG
    AGTTTCCACA ACACCCAAAC CGTGAGCAAG GCAGATAGTA GACAGCAGCA TTTATTCACA
    GGATCAGCAA ATAACCATTT GGTGAGGAAC TCAAGGGCTG AAGGACAAAC ACTGGTTCAG
    CCATCAGTAG CCAATCGGGC CATGAGAAGA GTTAGTTCAG TTCCATCTAG AGCACAGTCT
    CCTTCTTATG TTATCAGCAC AGGCGTGTCT CCATCAAGGG GGTCACTAAG AACTTCTCTG
    GGTAGTGGAT TTGGCTCTCC ATCAGTGACC GACTCCCGAC CTCTGAACCC CAGTGCATAC
    TCATCTACCA CATTACCTGC TCAGAGAGCA ACCTCTCCGT ACTCACAGAG ACCTGCCTCC
    CCAACAGCTG TGCGGAGGAT TGGGTCTGTC ACCTCCCGAC AGACCTGCAA TCCTAACGGA
    CCAGCCCCTC AATACCAAAC TACCACCAGG GTGGGGTCCC CACTGACCCT GACAGATGCC
    CAGACTCGAG TAGCTTCCCC ATCCCAAGGC CAAGTGGGGT CATCATCCCC AAAACGCTCA
    GGGATGACCG CCGTACCACA GCATCTGGGA CCTTCACTGC AAAGGACTGT TCACGACATG
    GAGCAATTCG GACAGCAGCA GTACGATATT TATGAGAGGA TGGTTCCACC ACGGCCAGAC
    AGCCTGACAG GCTTACGGAG TTCCTATGCC AGTCAGCATA GCCAGCTTGG GCAAGACCTT
    CGTTCAACTG TGTCTCCTGA CTTGCACATC ACTCCTATAT ATGAAGGGAG GACCTACTAC
    AGTCCAGTGT ACCGCAGCCC AAACCATGGA ACTGTGGAGC TCCAAGGATC GCAGACAGCA
    TTGTATCGCA CAGGCTCAGC AGGTGTTGGA AATCTACAAA GGACATCCAG TCAACGAAGT
    ACCCTTACAT ACCAAAGAAA TAATTACGCT CTGAACACAA CGGCTACCTA CGCAGAGCCC
    TACAGGCCAA TACAATACCG AGTACAAGAG TGCAGTTACA ACAGGCATGC AGGGCCAACT
    GATGATGGTA CCACAAGATC CCCATCAATA GATAGCATTC AGAAGGACCC CAGGGAGTTT
    GCTTGGCGTG ATCCTGAGCT GCCAGAAGTC ATTCACATGC TGCAACACCA GTTCCCGTCA
    GTCCAGGCAA ACGCAGCGGC CTACCTGCAG CACCTGTGCT TTGGTGACAA CAAAGTGAAG
    ATGGAGGTGT ATAGGCTAGG GGGAATCAAG CATCTGGTTG ACCTTTTGGA CCATAGAGTT
    TTGGAAGTTC AGAAGAATGC TTGTGGTGCC CTCCGAAACC TTGTTTTTGG CAAGTCTACA
    GATGAAAATA AAATAGCAAT GAAGAATGTT GGTGGAATAC CTGCCTTGTT GCGACTGTTA
    AGAAAGTCTA TTGATGCAGA AGTAAGGGAG CTTGTTACAG GAGTTCTTTG GAATTTGTCC
    TCATGCGATG CTGTAAAGAT GACAATCATT CGAGATGCTC TCTCAACCTT AACAAACACT
    GTGATTGTTC CACATTCTGG GTGGAATAAC TCTTCCTTTG ATGATGATCA TAAAATTAAA
    TTTCAGACTT CACTAGTTCT GAGGAACACG ACAGGTTGCC TGAGGAACCT CAGCTCTGCA
    GGGGAGGAAG CTCGAAAGCA AATGCGATCC TGTGAGGGAC TGGTAGACTC GCTGTTGTAT
    GTGATCCACA CATGCGTGAA CACTTCTGAT TACGACAGCA AGACAGTGGA GAACTGCGTG
    TGCACCCTGA GGAACCTATC ATATCGGCTG GAGCTAGAGG TCCCTCAGGC CCGGCTGCTC
    GGACTGAATG AACTGGATGA CTTGCTAGGA AAAGAGTCTC CCAGCAAAGA CTCAGAACCA
    AGCTGTTGGG GGAAAAAGAA GAAAAAGAAA AAGAGAACTC CACAAGAGGA TCAATGGGAT
    GGAGTCGGGC CTATCCCAGG ACTGTCCAAG TCCCCCAAAG GGGTTGAGAT GCTCTGGCAC
    CCATCAGTGG TAAAACCATA TCTGACTCTT CTAGCAGAAA GTTCCAACCC AGCCACCTTG
    GAAGGCTCTG CTGGATCTCT CCAGAACCTC TCTGCTGGCA ACTGGAAGTT TGCAGCATAC
    ATCCGGGCAG CTGTTCGAAA AGAAAAAGGG CTCCCCATCC TTGTTGAGCT GCTGAGGATG
    GATAATGACA GAGTTGTCTC TTCTGTGGCC ACTGCCTTGA GGAACATGGC GCTAGATGTC
    CGCAACAAGG AGCTCATAGG TAAATATGCC ATGCGAGACC TGGTCAATCG GCTTCCTGGG
    GGCAGCAGCC CCAGCATACT GTCTGACGAG ACTGTGGCAG CCATCTGCTG TGCCCTGCAC
    GAGGTCACCA GCAAAAACAT GGAGAATGCC AAAGCCCTGG CTGACTCAGG AGGTATAGAG
    AAGCTGGTGA ACATAACCAA AGGCAGAGGA GACAGGTCCT CTCTGAAAGT GGTAAAGGCG
    GCAGCCCAGG TCTTGAATAC ATTATGGCAG TATCGGGACC TGCGGAGCAT TTACAAAAAG
    GATGGGTGGA ATCAGAACCA TTTTATTACA CCTGTGTCAA CATTAGAGCG AGACCGATTC
    AAATCGCATC CTTCCTTGTC CACCACCAAC CAACAGATGT CACCCATCAT TCAGTCAGCA
    TCAACAGCTG TATTACAGTC AAGATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.