Fam171b cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

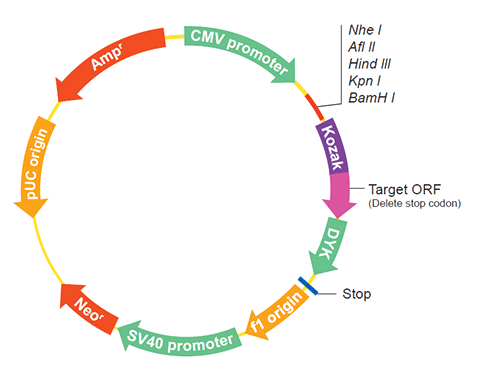
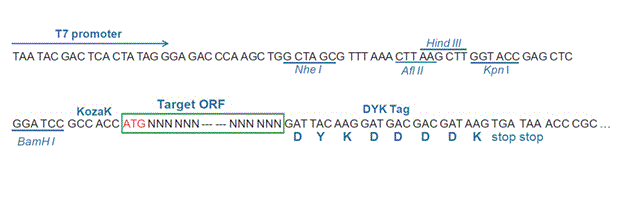
The following Fam171b gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Fam171b cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa16396 XM_008826768.3
Latest version!
Nannospalax galili family with sequence similarity 171 member B (Fam171b), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
View Old Accession Versions >>
ONa16396 XM_008826768.2 Nannospalax galili family with sequence similarity 171 member B (Fam171b), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa16396
    Clone ID Related Accession (Same CDS sequence) XM_008826768.2 , XM_008826768.3
    Accession Version XM_008826768.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2466bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein FAM171B
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008328334.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008826768.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGCGAGGC TCTGCCTGCG CGTCCCCTGC ACCCTGCTCC TTGGCCTGGC CGCCGTGCTG 
    CTGAAAGCGC GCCTGGTCCC CGCGGCCGCC AGAGCCGAAC TCGGCCGCTC CGACCTCAGT
    CTCATCCAGC AGCAGCAGCA ACAGCAGCAG CAAAAGCAGC GGGAGGAGGC AGAGGAGGAG
    AGAGAGGTGC GGGTGGCATC CCCTACTGTG ACGGTTCCAG TGTCTGTATT TATGTTGAAA
    GTCCAGGTGA ATGACATCAT CAGTCGCCAG TACCTGAGTC AAGCAGTTGT TGAGGTATTT
    GTCAACTACA CGAAGACAAA TTCTACAGTA ACTAAAAACA ATGGCGCAGT ATTGATAAAA
    GTACCCTACA AATTAGGACT CAGCCTAACC ATTATTGCTT ACAAAGATGG CTACGTCTTG
    ACACCGCTGC CTTGGAAAAC GGGAAGAATG CCAATATATT CATCAGTTAC ACTGTCACTG
    CTACCACAAA GCCAAGCAAA TATATGGCTC TTTGAAGACA CTGTTTTGAT TACTGGAAAA
    TTAACTGATG CCAAATCTCA ACCAAGTGTT CAGTTTTCGA AAGCCTTCAT TAAACTTCCC
    AACAACCATC ATATTAGCAA TGTGACTGGC TATCTGACTG TTCTACAGCA GTTTTTGAAA
    GTGGAAAATT TTCTATACAC GACTGGAATC ACTCTTAACA AACCAGGTTT GGAAAATATT
    GAATTGACTC CTCTTGCTGC AATATGTGTG AAAATCTATT CTGGAGGAAA AGAATTAAAG
    GTGGATGGTG CCATTCATGT TTCTCTCCCC CTTCTGTCTA CAAATGATAT AAACATGGGA
    GATCGCATTC CTGCTTGGAC ATTTGATATG AACATAGGTG CTTGGGTGCA TCACGGCTGG
    GGAATAGTCA AAGAACATAA CGGTCATTTA ATTTGGACTT ACGATGCACC ACATTTGGGC
    TACTGGATCG CAGCTCCACT TCCAGGAACT AGAGGTTCAG GTATGAATGA AGATTCCAAA
    GACATGACTG CTTACCATAC AGTGTTCCTT ACAGCCATAT TAGGAGGAAC GATTGTCATT
    GTCATTGGAT TTTTGGCTCT GCTACTTTGT TATTGCAGGG ATAAGTGTGG GACACCACAG
    AAAAGAGAAA GAAATATCAC TAAACTCGAG ATACTTAAGA GAGACCAGAC AACATCAACA
    ACACACATAA ATCACATCAG TTCAGTCAAA GTTGCATTAA AAGCTGAGGA CAAGACACAG
    TTATTTAACA CCAAAACAAC CTCCTACAGC CCCCAGAAAA AGGAAACCAC AAAGGTGGAG
    GCAGAAGAAA GAGCTTCCAT GGTGAAAACT CGGGACAATT TTAAAATCTA CAATGAAGAT
    GTTTCCTTTC TGTCAGTCAA TCACAATAAT TACTCAAGAA ATCCAACCGA GTCTTTGGAG
    CCAAGTGTAG GAACCAAACA GCCTAAACAT ATTAATACCA ATTTATCTCC CTCGCCAGGT
    GATGCTCAAG AGGAAAAGAG GTACCTCACA GGAAGTGAGG AGATGTTTGG GCGTTCCCGT
    ATTCCTGAGC AGCTTATGCA TATCTACAGC CAGCCCATAG CCATCCTTCA GACATCTGAC
    CTTTTCTCCA CACCAGAGCA GTTACATGCT GCTAAGTCAG CCACTTTGCC AAGAAAGGGA
    CAGTTAGTCT ATGGCCAATT GATGGAACCC GTAAACAGAG AGAATTTCAC ACAGACATTG
    CCCAAAATGC CAATGCATTC TCATGCCCAG GCCCCAGTTG CCAGAGAAGA GGACATTGTA
    CTTGAAGGTC AGCAGAGCTT GCCATCCCAG ACTTCAGACT GGAGCCGATA TTCCAACAGT
    TTGCTGGAGT CCGTCTCTGT TCCTGGAACG CTGAATGAAG CTGTCGTAAT GACTCCATTT
    TCATCAGAAC TTCAAGGAAT TTCAGAACAG ACCCTCCTGG AGCTGTCCAA AGGCAAGCCC
    TCCCCGCATC CCCGGGCGTG GTTTGTGTCT CTTGATGGAA AGCCTGTGGC ACAAGTGAGG
    CACTCCTTTA TAGACCTGAA AAAGGGCAAG AGAACCCAGA GCAATGATAC AAGTCTTGAC
    TCTGGAGTGG ACATGAATGA GCATCATTCA AGTAGAAAGC TGGAGAGGGA GAAGACATTC
    ATCAAAAGCA TGCATCAACC CAAGATCCTT TACCTGGAAG ATTTAGACCT GAGCAGCAGT
    GAGAGTGGAA CCACGGTCTG CTCCCCCGAG GACTCAGCAT TGAGACACAT CTTAGATGGA
    GGTAGCGGAG TTATTATAGA GCACCCCAGG GAAGAGTCCC CAGGAAGGAA AAGCACTGTG
    GAAGATTTTG AAGCCAACAC ATCTCCTACT AAAAAAAGGG GCCGACCACC ACCACTAGCC
    AAAAGAGACA GCAAGACAAA CATCTGGAAG AAACGAGAGG AACGCCCACT GATTCCCATA
    AACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008824990.1
    CDS108..2573
    Translation

    Target ORF information:

    RefSeq Version XM_008826768.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili family with sequence similarity 171 member B (Fam171b), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008826768.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGCGAGGC TCTGCCTGCG CGTCCCCTGC ACCCTGCTCC TTGGCCTGGC CGCCGTGCTG 
    CTGAAAGCGC GCCTGGTCCC CGCGGCCGCC AGAGCCGAAC TCGGCCGCTC CGACCTCAGT
    CTCATCCAGC AGCAGCAGCA ACAGCAGCAG CAAAAGCAGC GGGAGGAGGC AGAGGAGGAG
    AGAGAGGTGC GGGTGGCATC CCCTACTGTG ACGGTTCCAG TGTCTGTATT TATGTTGAAA
    GTCCAGGTGA ATGACATCAT CAGTCGCCAG TACCTGAGTC AAGCAGTTGT TGAGGTATTT
    GTCAACTACA CGAAGACAAA TTCTACAGTA ACTAAAAACA ATGGCGCAGT ATTGATAAAA
    GTACCCTACA AATTAGGACT CAGCCTAACC ATTATTGCTT ACAAAGATGG CTACGTCTTG
    ACACCGCTGC CTTGGAAAAC GGGAAGAATG CCAATATATT CATCAGTTAC ACTGTCACTG
    CTACCACAAA GCCAAGCAAA TATATGGCTC TTTGAAGACA CTGTTTTGAT TACTGGAAAA
    TTAACTGATG CCAAATCTCA ACCAAGTGTT CAGTTTTCGA AAGCCTTCAT TAAACTTCCC
    AACAACCATC ATATTAGCAA TGTGACTGGC TATCTGACTG TTCTACAGCA GTTTTTGAAA
    GTGGAAAATT TTCTATACAC GACTGGAATC ACTCTTAACA AACCAGGTTT GGAAAATATT
    GAATTGACTC CTCTTGCTGC AATATGTGTG AAAATCTATT CTGGAGGAAA AGAATTAAAG
    GTGGATGGTG CCATTCATGT TTCTCTCCCC CTTCTGTCTA CAAATGATAT AAACATGGGA
    GATCGCATTC CTGCTTGGAC ATTTGATATG AACATAGGTG CTTGGGTGCA TCACGGCTGG
    GGAATAGTCA AAGAACATAA CGGTCATTTA ATTTGGACTT ACGATGCACC ACATTTGGGC
    TACTGGATCG CAGCTCCACT TCCAGGAACT AGAGGTTCAG GTATGAATGA AGATTCCAAA
    GACATGACTG CTTACCATAC AGTGTTCCTT ACAGCCATAT TAGGAGGAAC GATTGTCATT
    GTCATTGGAT TTTTGGCTCT GCTACTTTGT TATTGCAGGG ATAAGTGTGG GACACCACAG
    AAAAGAGAAA GAAATATCAC TAAACTCGAG ATACTTAAGA GAGACCAGAC AACATCAACA
    ACACACATAA ATCACATCAG TTCAGTCAAA GTTGCATTAA AAGCTGAGGA CAAGACACAG
    TTATTTAACA CCAAAACAAC CTCCTACAGC CCCCAGAAAA AGGAAACCAC AAAGGTGGAG
    GCAGAAGAAA GAGCTTCCAT GGTGAAAACT CGGGACAATT TTAAAATCTA CAATGAAGAT
    GTTTCCTTTC TGTCAGTCAA TCACAATAAT TACTCAAGAA ATCCAACCGA GTCTTTGGAG
    CCAAGTGTAG GAACCAAACA GCCTAAACAT ATTAATACCA ATTTATCTCC CTCGCCAGGT
    GATGCTCAAG AGGAAAAGAG GTACCTCACA GGAAGTGAGG AGATGTTTGG GCGTTCCCGT
    ATTCCTGAGC AGCTTATGCA TATCTACAGC CAGCCCATAG CCATCCTTCA GACATCTGAC
    CTTTTCTCCA CACCAGAGCA GTTACATGCT GCTAAGTCAG CCACTTTGCC AAGAAAGGGA
    CAGTTAGTCT ATGGCCAATT GATGGAACCC GTAAACAGAG AGAATTTCAC ACAGACATTG
    CCCAAAATGC CAATGCATTC TCATGCCCAG GCCCCAGTTG CCAGAGAAGA GGACATTGTA
    CTTGAAGGTC AGCAGAGCTT GCCATCCCAG ACTTCAGACT GGAGCCGATA TTCCAACAGT
    TTGCTGGAGT CCGTCTCTGT TCCTGGAACG CTGAATGAAG CTGTCGTAAT GACTCCATTT
    TCATCAGAAC TTCAAGGAAT TTCAGAACAG ACCCTCCTGG AGCTGTCCAA AGGCAAGCCC
    TCCCCGCATC CCCGGGCGTG GTTTGTGTCT CTTGATGGAA AGCCTGTGGC ACAAGTGAGG
    CACTCCTTTA TAGACCTGAA AAAGGGCAAG AGAACCCAGA GCAATGATAC AAGTCTTGAC
    TCTGGAGTGG ACATGAATGA GCATCATTCA AGTAGAAAGC TGGAGAGGGA GAAGACATTC
    ATCAAAAGCA TGCATCAACC CAAGATCCTT TACCTGGAAG ATTTAGACCT GAGCAGCAGT
    GAGAGTGGAA CCACGGTCTG CTCCCCCGAG GACTCAGCAT TGAGACACAT CTTAGATGGA
    GGTAGCGGAG TTATTATAGA GCACCCCAGG GAAGAGTCCC CAGGAAGGAA AAGCACTGTG
    GAAGATTTTG AAGCCAACAC ATCTCCTACT AAAAAAAGGG GCCGACCACC ACCACTAGCC
    AAAAGAGACA GCAAGACAAA CATCTGGAAG AAACGAGAGG AACGCCCACT GATTCCCATA
    AACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa16396
    Clone ID Related Accession (Same CDS sequence) XM_008826768.2 , XM_008826768.3
    Accession Version XM_008826768.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2466bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protein FAM171B
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008328334.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008826768.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGCGAGGC TCTGCCTGCG CGTCCCCTGC ACCCTGCTCC TTGGCCTGGC CGCCGTGCTG 
    CTGAAAGCGC GCCTGGTCCC CGCGGCCGCC AGAGCCGAAC TCGGCCGCTC CGACCTCAGT
    CTCATCCAGC AGCAGCAGCA ACAGCAGCAG CAAAAGCAGC GGGAGGAGGC AGAGGAGGAG
    AGAGAGGTGC GGGTGGCATC CCCTACTGTG ACGGTTCCAG TGTCTGTATT TATGTTGAAA
    GTCCAGGTGA ATGACATCAT CAGTCGCCAG TACCTGAGTC AAGCAGTTGT TGAGGTATTT
    GTCAACTACA CGAAGACAAA TTCTACAGTA ACTAAAAACA ATGGCGCAGT ATTGATAAAA
    GTACCCTACA AATTAGGACT CAGCCTAACC ATTATTGCTT ACAAAGATGG CTACGTCTTG
    ACACCGCTGC CTTGGAAAAC GGGAAGAATG CCAATATATT CATCAGTTAC ACTGTCACTG
    CTACCACAAA GCCAAGCAAA TATATGGCTC TTTGAAGACA CTGTTTTGAT TACTGGAAAA
    TTAACTGATG CCAAATCTCA ACCAAGTGTT CAGTTTTCGA AAGCCTTCAT TAAACTTCCC
    AACAACCATC ATATTAGCAA TGTGACTGGC TATCTGACTG TTCTACAGCA GTTTTTGAAA
    GTGGAAAATT TTCTATACAC GACTGGAATC ACTCTTAACA AACCAGGTTT GGAAAATATT
    GAATTGACTC CTCTTGCTGC AATATGTGTG AAAATCTATT CTGGAGGAAA AGAATTAAAG
    GTGGATGGTG CCATTCATGT TTCTCTCCCC CTTCTGTCTA CAAATGATAT AAACATGGGA
    GATCGCATTC CTGCTTGGAC ATTTGATATG AACATAGGTG CTTGGGTGCA TCACGGCTGG
    GGAATAGTCA AAGAACATAA CGGTCATTTA ATTTGGACTT ACGATGCACC ACATTTGGGC
    TACTGGATCG CAGCTCCACT TCCAGGAACT AGAGGTTCAG GTATGAATGA AGATTCCAAA
    GACATGACTG CTTACCATAC AGTGTTCCTT ACAGCCATAT TAGGAGGAAC GATTGTCATT
    GTCATTGGAT TTTTGGCTCT GCTACTTTGT TATTGCAGGG ATAAGTGTGG GACACCACAG
    AAAAGAGAAA GAAATATCAC TAAACTCGAG ATACTTAAGA GAGACCAGAC AACATCAACA
    ACACACATAA ATCACATCAG TTCAGTCAAA GTTGCATTAA AAGCTGAGGA CAAGACACAG
    TTATTTAACA CCAAAACAAC CTCCTACAGC CCCCAGAAAA AGGAAACCAC AAAGGTGGAG
    GCAGAAGAAA GAGCTTCCAT GGTGAAAACT CGGGACAATT TTAAAATCTA CAATGAAGAT
    GTTTCCTTTC TGTCAGTCAA TCACAATAAT TACTCAAGAA ATCCAACCGA GTCTTTGGAG
    CCAAGTGTAG GAACCAAACA GCCTAAACAT ATTAATACCA ATTTATCTCC CTCGCCAGGT
    GATGCTCAAG AGGAAAAGAG GTACCTCACA GGAAGTGAGG AGATGTTTGG GCGTTCCCGT
    ATTCCTGAGC AGCTTATGCA TATCTACAGC CAGCCCATAG CCATCCTTCA GACATCTGAC
    CTTTTCTCCA CACCAGAGCA GTTACATGCT GCTAAGTCAG CCACTTTGCC AAGAAAGGGA
    CAGTTAGTCT ATGGCCAATT GATGGAACCC GTAAACAGAG AGAATTTCAC ACAGACATTG
    CCCAAAATGC CAATGCATTC TCATGCCCAG GCCCCAGTTG CCAGAGAAGA GGACATTGTA
    CTTGAAGGTC AGCAGAGCTT GCCATCCCAG ACTTCAGACT GGAGCCGATA TTCCAACAGT
    TTGCTGGAGT CCGTCTCTGT TCCTGGAACG CTGAATGAAG CTGTCGTAAT GACTCCATTT
    TCATCAGAAC TTCAAGGAAT TTCAGAACAG ACCCTCCTGG AGCTGTCCAA AGGCAAGCCC
    TCCCCGCATC CCCGGGCGTG GTTTGTGTCT CTTGATGGAA AGCCTGTGGC ACAAGTGAGG
    CACTCCTTTA TAGACCTGAA AAAGGGCAAG AGAACCCAGA GCAATGATAC AAGTCTTGAC
    TCTGGAGTGG ACATGAATGA GCATCATTCA AGTAGAAAGC TGGAGAGGGA GAAGACATTC
    ATCAAAAGCA TGCATCAACC CAAGATCCTT TACCTGGAAG ATTTAGACCT GAGCAGCAGT
    GAGAGTGGAA CCACGGTCTG CTCCCCCGAG GACTCAGCAT TGAGACACAT CTTAGATGGA
    GGTAGCGGAG TTATTATAGA GCACCCCAGG GAAGAGTCCC CAGGAAGGAA AAGCACTGTG
    GAAGATTTTG AAGCCAACAC ATCTCCTACT AAAAAAAGGG GCCGACCACC ACCACTAGCC
    AAAAGAGACA GCAAGACAAA CATCTGGAAG AAACGAGAGG AACGCCCACT GATTCCCATA
    AACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008824990.1
    CDS147..2612
    Translation

    Target ORF information:

    RefSeq Version XM_008826768.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili family with sequence similarity 171 member B (Fam171b), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008826768.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGCGAGGC TCTGCCTGCG CGTCCCCTGC ACCCTGCTCC TTGGCCTGGC CGCCGTGCTG 
    CTGAAAGCGC GCCTGGTCCC CGCGGCCGCC AGAGCCGAAC TCGGCCGCTC CGACCTCAGT
    CTCATCCAGC AGCAGCAGCA ACAGCAGCAG CAAAAGCAGC GGGAGGAGGC AGAGGAGGAG
    AGAGAGGTGC GGGTGGCATC CCCTACTGTG ACGGTTCCAG TGTCTGTATT TATGTTGAAA
    GTCCAGGTGA ATGACATCAT CAGTCGCCAG TACCTGAGTC AAGCAGTTGT TGAGGTATTT
    GTCAACTACA CGAAGACAAA TTCTACAGTA ACTAAAAACA ATGGCGCAGT ATTGATAAAA
    GTACCCTACA AATTAGGACT CAGCCTAACC ATTATTGCTT ACAAAGATGG CTACGTCTTG
    ACACCGCTGC CTTGGAAAAC GGGAAGAATG CCAATATATT CATCAGTTAC ACTGTCACTG
    CTACCACAAA GCCAAGCAAA TATATGGCTC TTTGAAGACA CTGTTTTGAT TACTGGAAAA
    TTAACTGATG CCAAATCTCA ACCAAGTGTT CAGTTTTCGA AAGCCTTCAT TAAACTTCCC
    AACAACCATC ATATTAGCAA TGTGACTGGC TATCTGACTG TTCTACAGCA GTTTTTGAAA
    GTGGAAAATT TTCTATACAC GACTGGAATC ACTCTTAACA AACCAGGTTT GGAAAATATT
    GAATTGACTC CTCTTGCTGC AATATGTGTG AAAATCTATT CTGGAGGAAA AGAATTAAAG
    GTGGATGGTG CCATTCATGT TTCTCTCCCC CTTCTGTCTA CAAATGATAT AAACATGGGA
    GATCGCATTC CTGCTTGGAC ATTTGATATG AACATAGGTG CTTGGGTGCA TCACGGCTGG
    GGAATAGTCA AAGAACATAA CGGTCATTTA ATTTGGACTT ACGATGCACC ACATTTGGGC
    TACTGGATCG CAGCTCCACT TCCAGGAACT AGAGGTTCAG GTATGAATGA AGATTCCAAA
    GACATGACTG CTTACCATAC AGTGTTCCTT ACAGCCATAT TAGGAGGAAC GATTGTCATT
    GTCATTGGAT TTTTGGCTCT GCTACTTTGT TATTGCAGGG ATAAGTGTGG GACACCACAG
    AAAAGAGAAA GAAATATCAC TAAACTCGAG ATACTTAAGA GAGACCAGAC AACATCAACA
    ACACACATAA ATCACATCAG TTCAGTCAAA GTTGCATTAA AAGCTGAGGA CAAGACACAG
    TTATTTAACA CCAAAACAAC CTCCTACAGC CCCCAGAAAA AGGAAACCAC AAAGGTGGAG
    GCAGAAGAAA GAGCTTCCAT GGTGAAAACT CGGGACAATT TTAAAATCTA CAATGAAGAT
    GTTTCCTTTC TGTCAGTCAA TCACAATAAT TACTCAAGAA ATCCAACCGA GTCTTTGGAG
    CCAAGTGTAG GAACCAAACA GCCTAAACAT ATTAATACCA ATTTATCTCC CTCGCCAGGT
    GATGCTCAAG AGGAAAAGAG GTACCTCACA GGAAGTGAGG AGATGTTTGG GCGTTCCCGT
    ATTCCTGAGC AGCTTATGCA TATCTACAGC CAGCCCATAG CCATCCTTCA GACATCTGAC
    CTTTTCTCCA CACCAGAGCA GTTACATGCT GCTAAGTCAG CCACTTTGCC AAGAAAGGGA
    CAGTTAGTCT ATGGCCAATT GATGGAACCC GTAAACAGAG AGAATTTCAC ACAGACATTG
    CCCAAAATGC CAATGCATTC TCATGCCCAG GCCCCAGTTG CCAGAGAAGA GGACATTGTA
    CTTGAAGGTC AGCAGAGCTT GCCATCCCAG ACTTCAGACT GGAGCCGATA TTCCAACAGT
    TTGCTGGAGT CCGTCTCTGT TCCTGGAACG CTGAATGAAG CTGTCGTAAT GACTCCATTT
    TCATCAGAAC TTCAAGGAAT TTCAGAACAG ACCCTCCTGG AGCTGTCCAA AGGCAAGCCC
    TCCCCGCATC CCCGGGCGTG GTTTGTGTCT CTTGATGGAA AGCCTGTGGC ACAAGTGAGG
    CACTCCTTTA TAGACCTGAA AAAGGGCAAG AGAACCCAGA GCAATGATAC AAGTCTTGAC
    TCTGGAGTGG ACATGAATGA GCATCATTCA AGTAGAAAGC TGGAGAGGGA GAAGACATTC
    ATCAAAAGCA TGCATCAACC CAAGATCCTT TACCTGGAAG ATTTAGACCT GAGCAGCAGT
    GAGAGTGGAA CCACGGTCTG CTCCCCCGAG GACTCAGCAT TGAGACACAT CTTAGATGGA
    GGTAGCGGAG TTATTATAGA GCACCCCAGG GAAGAGTCCC CAGGAAGGAA AAGCACTGTG
    GAAGATTTTG AAGCCAACAC ATCTCCTACT AAAAAAAGGG GCCGACCACC ACCACTAGCC
    AAAAGAGACA GCAAGACAAA CATCTGGAAG AAACGAGAGG AACGCCCACT GATTCCCATA
    AACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.