Peak1 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

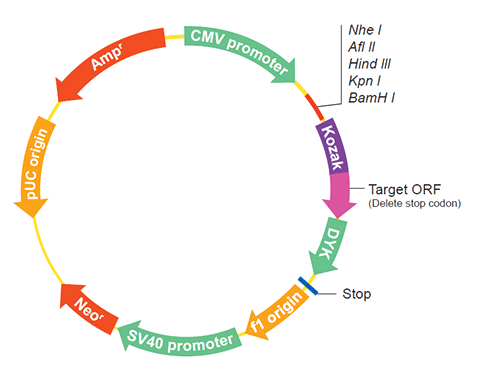
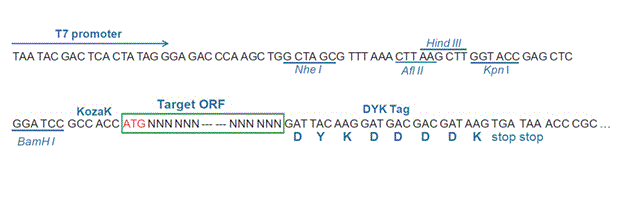
The following Peak1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Peak1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa40458 XM_008823439.3
Latest version!
Nannospalax galili pseudopodium enriched atypical kinase 1 (Peak1), mRNA. pcDNA3.1-C-(k)DYK or customized vector 24-26 $1021.30
$1459.00
View Old Accession Versions >>
ONa40458 XM_008823439.2 Nannospalax galili pseudopodium enriched atypical kinase 1 (Peak1), mRNA. pcDNA3.1-C-(k)DYK or customized vector 24-26 $1021.30
$1459.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa40458
    Clone ID Related Accession (Same CDS sequence) XM_008823439.2 , XM_008823439.3
    Accession Version XM_008823439.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 5217bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product pseudopodium-enriched atypical kinase 1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008359594.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008823439.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    5101
    5161
    ATGTCTGCTT GTAACACCTT TACTGAACAC GTTTGGAAAC CTGGTGAATG CAAGAATTGC 
    TTCAAACCTA AAAGCTTGCA CCAGCTTCCC CCAGACTCTG AGAAGGCACC CATCACCCAT
    GGCAATGTGA AAACTAATGC CAATCATAGT AACAACCACC GTGTCAGGAA CACTGGGAAT
    TTCCGGCCTC CTGTGGCTAA AAAACCCACT ATAGCTGTGA AGCCCACTAT GATGGTGGCA
    GATGGGCAAA GTGTATGTGG TGAGCTTAGT ATCCAAGAAC ACTGTGAGAA CAAACCTGTC
    ATCATAGGAT GGAACCAAAA CAAGACTTCT TTGAGCCAGA AACCACTTAA CAATAATAAT
    GAAGATGATA TTGAAGGATT TGGCCATGTT CCTAAGCAGT ATGGCAGTAA TGACAGTGCA
    AAGAAGATAT CAAATAACAA TAATGGACTA ACTGATGTGT TAAAAGAGAT AGCAGGCCTA
    GATACCACCC CTCAAGTGAG AGGAAATGAA ACAAACTCCA GAGAAACATT TTTAGGGAGA
    ATAAACGATT GCTATAAACG TTCACTGGAA AGAAAGATTC CACCAAGTTG CATGATAGGT
    GGTGTGAAGG ATACTCAGGG CAAGCATGTT ATACTGAGTG GGAGCACAGA GGTCATCAGT
    AATGAAGGAG GCCGGTTCTG CTACCCTGAG TTCTCAAGTG GAGAGGAGAG TGAGGAAGAT
    GCACTTTTAA GTAACATGGA GGAGGAGCAT GAGAGCTGGG ATGAGAGTGA CGAGGAGCTG
    TTGGCCATGG AGATTCGCAT GAGAGGGCAG CCTCGCTTTG CTAATTTTAG GGCAAACACT
    TTGTCTCCTG TTCGATTCTT TGTGAGCAAA AAGTGGAATA CTGTCCCCCT AAGGAATAAG
    TCTCTGCAGA GAATCTGTGC TGTAGACTAT GATGACAGCT ATGATGAAAT CCTTAATGGT
    TATGAGGAAA ATTCTGGGGT TTCCTATGGT CAAGGAACCA TTCAGAGCAT GGTTTCATCT
    GACTCAACAT CACCAGATTC CTCTTTGACG GAAGAATCAC ATTCTGAAAC AGCTAGTAAT
    TTATCCCAGA AGATTTATAA TGGGGCGATA TCTCCTGGTA ACCCAGGAGA TTCTAAGGAC
    ATGAAAGAAA TTGAGTCTAA CTATGAAAGT CTCGCTGGTA ATAATCAGAA GGATTTATCA
    CAAACTTGCA AAGGCTCAGC AAAAGTTCCA GAGACACACA AAGCAGTCCT TGCTCTCCGA
    TTAGAAGAGA AGGATGGCAA AATTGCTGTA CAAACTGAGA AACTAGAAAG CAAAGCCTCT
    ACAGATATTG CTGGTCAAGC AGTAACCATA AGCCTTGTCC CTGTAGAAGA GCAAGCAAAG
    CCCTACCGAG TCGTAAATCT GGAACAGCCA TTGTGCAAAC CATATACCGT TGTGGATGTG
    TCAGCCGCCA TGGCCAGTGA GCACCTTGGG AGCCCCAAGA GAAAAGTTTC ATCTTCTACT
    CCAAACTCTC CAGTGACATC ACCTGCATTG ACACCAGGAC AAATAAGTAC TCATTTTAAA
    AAATCCAGTG CAATCCGATA CCAGGAAGTG TGGACTTCCA GCACCAGTCC ACGACAAAAG
    ATCCCCAAAG TAGAATTAAT TACTGGAGGA ACTGGACCAA ATATCCCTCC AAGAAAAACA
    TGCCATAAAT CAGCACCTAC TTCACCCACA GCTACAAATA TTTCCTCCAA AACCATCCCT
    GTTAAGTCAC CTAATTTGTC TGAAATAAAA TTTAATAGTT ATAACAACGC TGGTATGCCA
    CCTTTTCCCA TTATCATTCA TGATGAGCCA TCCTATGCTC GAAGTTCCAA AAATGCTATT
    AAAGTTCCCA TTGTTATTAA TCCAAATGCA TATGATAATC TAGCCATCTA TAAAAGCTTT
    CTGGGAACAA GTGGAGAACT CTCAGTAAAG GAAAAAACCA CAAGTGTAAT AAGCCATACT
    TATGAAGAAA TAGAAACTGA AAGCAAAGTG TCTGATAACA CCACTAGCAA ACTCCCTGAC
    TGTCCTCAAG CTAAAGGGTT TTCTAACAGC ACAGAGCATA AAAGAGGCTC AGTGGCTCAG
    AAGGTTCAGG AGTTTAACAG TTGTCTCAGC AGAGGTCAGC CTTCTCCACA GAGAAGCTAC
    AGTTCCAGCC ACAGCTCCCC TACAAAAATC CAGAGACCCA CTCAAGAGCC TGTGGCCAAA
    ACAGAAAGTG GGCAGGAGTC TCAGATGGCG GGCAGCAGTG GCAGCATCAG GGAGAAAGCA
    AGCACAGTGC TTTGTCAGAT TGTGGCTTCT ATCCCACCCC CCCAGTCTCC TCCAGAAGCA
    CCTCAGTCTA GCCCTAAGGC TTGCAGTGTG GAAGAGCTTT ATGCCATTCC TCCAGATGCT
    GATGCTACAA AAAGTATACC TAAAACTACA CCAGTCCGGC CCAAATCTCT CTTTACATCT
    CAGCCTAGTG TGGAGACTGA GGCACACCAG ACCACTGAAA GTCCTCCTAC TAAAATTCAG
    AAAGATCCAG TCACAAAGCC AGTCATTTCT CCACCCTCCA AATTAGTGAC CAACCCCCAG
    AGTGAGCCAC CACCTCCCTT TCCCCCACCA CGCTCTACTT CTTCCCCTTA CCATGCAAGT
    AACCTTTTGC AGAGGCATTT TACCAGCTGG ACAAAGCCAA CCAGTCCTAC CAGATCAACA
    GAAGCTGAAT CAGTTTTGCA TTCTGAAGGC AGCAGGCGAG CAGCTGATGC AAAGCCTAAA
    CGTTGGATAT CATTTAAAAG CTTCTTCCGC CGTCGGAAAA CAGAAGAGGA AGAAGACAAA
    GAGCGAGAGA AGGGAAAACT GGTGGGTTTA GATGGTACAG TCATCCACAT GCTGCCACCA
    CCTCCTGTAC AGCGCCATCA CTGGTTCACA GAAGCAAAAG GAGAGTCCAG TGAGAAACCT
    GCCATTGTCT TCATGTACAG GTGTGACCCT GACCAAAGCC AGCTTATTGT GGATAAGAGC
    AAGGCTGGGA CAGAACAGGC AGTGGTTACA GAGAAAGGAA GAACAGAGGA TGTGTTACTC
    CGGGACTTAG AAGAAAAGAA AAGTGGCCAT TCTTCTCCAT TGCAAATTCC TGAAAAAGTT
    CACAGTCACA TGACCCATGA AGTGGCAGAG GAATTTTCTC CTCAAGATCC AAGAACTCGT
    GTTGTGAAGC AAGATGGCAT TTCAGTCACA CCAGTATTGT CCCCACCTGA CCTGGAAAGG
    GAAGAAGAAA AAGATGACAC TTCAGATCCT ATAGACCTGA ACCCCTGTAG TGCAACATAC
    AGCAACTTAG GCCAATCTAG AGCAGCTATG ATACCTCCCA AGCATCCACG GCAGCCCAAG
    GGAGCTTTGG ATGACGCCAT TGCCTTCGGA GAGAAAACAG ACCAAGAAAT ATTGAGTGCT
    TCCCAACCCA CACCACCCCC ACTGCCAAAG AAAATGATAA GAGCCAATAC AGAACCAATC
    TCCAGAGACC TTCAGAAATC CATGGAAAGT AGTCTTTATG TCGTGGCTAA TCCTACCTAT
    GATATTGATC CCAACTGGGA TGCCAGCAGT GCTGGCTCTT CCATTAGCTA TGAACTCAAA
    GGACTGGACA TTGAGTCTTG TGACTCCTTG GAGAGACCTT TGCACAAGGA GAGACCTGTC
    CCTTCAGCAG CAAACAGTAT CACCAGCTTA ACCACTCTTA GTATTAAAGA CAGATTTTCC
    AACAGCATGG AGTCCCTGTC CAGCCGACGT GGTCTCCCCT GCAGACAGGG TCGAATCATC
    CAGAAACCAC AGAGACAAGC ACTTTATCGA GGACTTGAAA ACCGAGAGGA AGTGGTGGGT
    AAAATCCGAA GCCTTCATAC AGATGCCTTG AAGAAACTGG CTGTTAAATG TGAAGACCTC
    TTCATGGCTG GGCAGAAAGA CCAACTCCGT TTTGGGGTGG ACAGCTGGTC AGACTTTAGG
    TTAACCAGTG ACAAACCATG TTGTGAAGCA GGTGATGCTG TTTACTACAC TGCCTCATAT
    GCAAAAGATC CACTTAATAA CTATGCAGTC AAGATCTGTA AGAGCAAAGC TAAAGAATCT
    CAGCAGTATT ATCACAGCTT GGCTGTCCGA CAGAGTCTGG CTGTACATTT TAACATCCAG
    CAAGACTGTG GTCATTTCCT TGCTGAAGTC CCTAACCGTC TGCTTCCCTG GGAAGATTCT
    GATGCCCCTG AAAAGGCAGG GGATGAAATG GAAGACATTG AGGAAGAGGC GAAAGAAGAA
    ATTGATGAAA AAAATCCAGA GCCCTGCTCT GAAACAGAGT CATCGGAGAA AGAGAGCCAA
    GGAGTCACAA GCAGGAAGCA GAGAAGCCAT GTTGTAGTCA TCACCAGAGA GGTTCCCCAT
    CTCACTGTGG CCGACTTTGT GCGAGGCTCT TTGCCCCATC ATGAGAAAAG CCCTGACTTG
    TATGAGAGGC AAGTGTGTCT GCTGCTCTTA CAGCTGTGCT CTGGCCTTGA GCATCTCAAG
    CCCTACCATG TCACTCACTG CGATCTACGC CTTGAGAACC TGTTGCTTGT CCACCACCAG
    CCCGGGGGAA CTGCCCAGAG CCCTGGGTCT GCAGATCCTA GCCCCACCTC ATCTTATCCC
    ACAAGGCTTA TTGTGAGCAA CTTCTCTCAA GCCAAGCAAA AGAGCCATCT GGTGGACCCT
    GAGATACTCC GAGACCAGTC CCGCCTTGCC CCAGAGATCA TCACAGCCAC TCAGTATAAA
    AAGTGTGATG AGTTCCAGAC AGGCATCCTC ATCTATGAGA TGCTGCACCT GCCCAACCCT
    TTTGATGAGA ACCCAGAGCT GAAAGAGAAG GAGTACACCC GTACAGATCT GCCTCAAATC
    CCTCTCCGTT CTCCCTACTC CTGGGGCCTG CAGCAGCTGG CCAGCTGCCT CCTAAATCCC
    AACCCTTCTG AGCGCATCCT CATTTCTGAT GCCAAAGGCA TCCTTCAGTG TCTGCTCTGG
    GGTCCTCGTG AAGATCTTTT CCAAACCTTC ACCACTTCCA CAAGCCTAGT GCAGAGGAAT
    GCCCTGCTCC AAAACTGGTT GGACATTAAG CGAACACTGC TGATGATCAA GTTTGCTGAA
    AAGTCCTTAG ACAGAGAAGG GGGCATAAGC CTCGAGGACT GGCTTTGTGC TCAGTATCTG
    GCTTTTGCCA CCACAGACTC CCTGAGTTGT ATTGTAAAAA TCCTGCAACA TCGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008821661.1
    CDS69..5285
    Translation

    Target ORF information:

    RefSeq Version XM_008823439.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili pseudopodium enriched atypical kinase 1 (Peak1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008823439.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    5101
    5161
    ATGTCTGCTT GTAACACCTT TACTGAACAC GTTTGGAAAC CTGGTGAATG CAAGAATTGC 
    TTCAAACCTA AAAGCTTGCA CCAGCTTCCC CCAGACTCTG AGAAGGCACC CATCACCCAT
    GGCAATGTGA AAACTAATGC CAATCATAGT AACAACCACC GTGTCAGGAA CACTGGGAAT
    TTCCGGCCTC CTGTGGCTAA AAAACCCACT ATAGCTGTGA AGCCCACTAT GATGGTGGCA
    GATGGGCAAA GTGTATGTGG TGAGCTTAGT ATCCAAGAAC ACTGTGAGAA CAAACCTGTC
    ATCATAGGAT GGAACCAAAA CAAGACTTCT TTGAGCCAGA AACCACTTAA CAATAATAAT
    GAAGATGATA TTGAAGGATT TGGCCATGTT CCTAAGCAGT ATGGCAGTAA TGACAGTGCA
    AAGAAGATAT CAAATAACAA TAATGGACTA ACTGATGTGT TAAAAGAGAT AGCAGGCCTA
    GATACCACCC CTCAAGTGAG AGGAAATGAA ACAAACTCCA GAGAAACATT TTTAGGGAGA
    ATAAACGATT GCTATAAACG TTCACTGGAA AGAAAGATTC CACCAAGTTG CATGATAGGT
    GGTGTGAAGG ATACTCAGGG CAAGCATGTT ATACTGAGTG GGAGCACAGA GGTCATCAGT
    AATGAAGGAG GCCGGTTCTG CTACCCTGAG TTCTCAAGTG GAGAGGAGAG TGAGGAAGAT
    GCACTTTTAA GTAACATGGA GGAGGAGCAT GAGAGCTGGG ATGAGAGTGA CGAGGAGCTG
    TTGGCCATGG AGATTCGCAT GAGAGGGCAG CCTCGCTTTG CTAATTTTAG GGCAAACACT
    TTGTCTCCTG TTCGATTCTT TGTGAGCAAA AAGTGGAATA CTGTCCCCCT AAGGAATAAG
    TCTCTGCAGA GAATCTGTGC TGTAGACTAT GATGACAGCT ATGATGAAAT CCTTAATGGT
    TATGAGGAAA ATTCTGGGGT TTCCTATGGT CAAGGAACCA TTCAGAGCAT GGTTTCATCT
    GACTCAACAT CACCAGATTC CTCTTTGACG GAAGAATCAC ATTCTGAAAC AGCTAGTAAT
    TTATCCCAGA AGATTTATAA TGGGGCGATA TCTCCTGGTA ACCCAGGAGA TTCTAAGGAC
    ATGAAAGAAA TTGAGTCTAA CTATGAAAGT CTCGCTGGTA ATAATCAGAA GGATTTATCA
    CAAACTTGCA AAGGCTCAGC AAAAGTTCCA GAGACACACA AAGCAGTCCT TGCTCTCCGA
    TTAGAAGAGA AGGATGGCAA AATTGCTGTA CAAACTGAGA AACTAGAAAG CAAAGCCTCT
    ACAGATATTG CTGGTCAAGC AGTAACCATA AGCCTTGTCC CTGTAGAAGA GCAAGCAAAG
    CCCTACCGAG TCGTAAATCT GGAACAGCCA TTGTGCAAAC CATATACCGT TGTGGATGTG
    TCAGCCGCCA TGGCCAGTGA GCACCTTGGG AGCCCCAAGA GAAAAGTTTC ATCTTCTACT
    CCAAACTCTC CAGTGACATC ACCTGCATTG ACACCAGGAC AAATAAGTAC TCATTTTAAA
    AAATCCAGTG CAATCCGATA CCAGGAAGTG TGGACTTCCA GCACCAGTCC ACGACAAAAG
    ATCCCCAAAG TAGAATTAAT TACTGGAGGA ACTGGACCAA ATATCCCTCC AAGAAAAACA
    TGCCATAAAT CAGCACCTAC TTCACCCACA GCTACAAATA TTTCCTCCAA AACCATCCCT
    GTTAAGTCAC CTAATTTGTC TGAAATAAAA TTTAATAGTT ATAACAACGC TGGTATGCCA
    CCTTTTCCCA TTATCATTCA TGATGAGCCA TCCTATGCTC GAAGTTCCAA AAATGCTATT
    AAAGTTCCCA TTGTTATTAA TCCAAATGCA TATGATAATC TAGCCATCTA TAAAAGCTTT
    CTGGGAACAA GTGGAGAACT CTCAGTAAAG GAAAAAACCA CAAGTGTAAT AAGCCATACT
    TATGAAGAAA TAGAAACTGA AAGCAAAGTG TCTGATAACA CCACTAGCAA ACTCCCTGAC
    TGTCCTCAAG CTAAAGGGTT TTCTAACAGC ACAGAGCATA AAAGAGGCTC AGTGGCTCAG
    AAGGTTCAGG AGTTTAACAG TTGTCTCAGC AGAGGTCAGC CTTCTCCACA GAGAAGCTAC
    AGTTCCAGCC ACAGCTCCCC TACAAAAATC CAGAGACCCA CTCAAGAGCC TGTGGCCAAA
    ACAGAAAGTG GGCAGGAGTC TCAGATGGCG GGCAGCAGTG GCAGCATCAG GGAGAAAGCA
    AGCACAGTGC TTTGTCAGAT TGTGGCTTCT ATCCCACCCC CCCAGTCTCC TCCAGAAGCA
    CCTCAGTCTA GCCCTAAGGC TTGCAGTGTG GAAGAGCTTT ATGCCATTCC TCCAGATGCT
    GATGCTACAA AAAGTATACC TAAAACTACA CCAGTCCGGC CCAAATCTCT CTTTACATCT
    CAGCCTAGTG TGGAGACTGA GGCACACCAG ACCACTGAAA GTCCTCCTAC TAAAATTCAG
    AAAGATCCAG TCACAAAGCC AGTCATTTCT CCACCCTCCA AATTAGTGAC CAACCCCCAG
    AGTGAGCCAC CACCTCCCTT TCCCCCACCA CGCTCTACTT CTTCCCCTTA CCATGCAAGT
    AACCTTTTGC AGAGGCATTT TACCAGCTGG ACAAAGCCAA CCAGTCCTAC CAGATCAACA
    GAAGCTGAAT CAGTTTTGCA TTCTGAAGGC AGCAGGCGAG CAGCTGATGC AAAGCCTAAA
    CGTTGGATAT CATTTAAAAG CTTCTTCCGC CGTCGGAAAA CAGAAGAGGA AGAAGACAAA
    GAGCGAGAGA AGGGAAAACT GGTGGGTTTA GATGGTACAG TCATCCACAT GCTGCCACCA
    CCTCCTGTAC AGCGCCATCA CTGGTTCACA GAAGCAAAAG GAGAGTCCAG TGAGAAACCT
    GCCATTGTCT TCATGTACAG GTGTGACCCT GACCAAAGCC AGCTTATTGT GGATAAGAGC
    AAGGCTGGGA CAGAACAGGC AGTGGTTACA GAGAAAGGAA GAACAGAGGA TGTGTTACTC
    CGGGACTTAG AAGAAAAGAA AAGTGGCCAT TCTTCTCCAT TGCAAATTCC TGAAAAAGTT
    CACAGTCACA TGACCCATGA AGTGGCAGAG GAATTTTCTC CTCAAGATCC AAGAACTCGT
    GTTGTGAAGC AAGATGGCAT TTCAGTCACA CCAGTATTGT CCCCACCTGA CCTGGAAAGG
    GAAGAAGAAA AAGATGACAC TTCAGATCCT ATAGACCTGA ACCCCTGTAG TGCAACATAC
    AGCAACTTAG GCCAATCTAG AGCAGCTATG ATACCTCCCA AGCATCCACG GCAGCCCAAG
    GGAGCTTTGG ATGACGCCAT TGCCTTCGGA GAGAAAACAG ACCAAGAAAT ATTGAGTGCT
    TCCCAACCCA CACCACCCCC ACTGCCAAAG AAAATGATAA GAGCCAATAC AGAACCAATC
    TCCAGAGACC TTCAGAAATC CATGGAAAGT AGTCTTTATG TCGTGGCTAA TCCTACCTAT
    GATATTGATC CCAACTGGGA TGCCAGCAGT GCTGGCTCTT CCATTAGCTA TGAACTCAAA
    GGACTGGACA TTGAGTCTTG TGACTCCTTG GAGAGACCTT TGCACAAGGA GAGACCTGTC
    CCTTCAGCAG CAAACAGTAT CACCAGCTTA ACCACTCTTA GTATTAAAGA CAGATTTTCC
    AACAGCATGG AGTCCCTGTC CAGCCGACGT GGTCTCCCCT GCAGACAGGG TCGAATCATC
    CAGAAACCAC AGAGACAAGC ACTTTATCGA GGACTTGAAA ACCGAGAGGA AGTGGTGGGT
    AAAATCCGAA GCCTTCATAC AGATGCCTTG AAGAAACTGG CTGTTAAATG TGAAGACCTC
    TTCATGGCTG GGCAGAAAGA CCAACTCCGT TTTGGGGTGG ACAGCTGGTC AGACTTTAGG
    TTAACCAGTG ACAAACCATG TTGTGAAGCA GGTGATGCTG TTTACTACAC TGCCTCATAT
    GCAAAAGATC CACTTAATAA CTATGCAGTC AAGATCTGTA AGAGCAAAGC TAAAGAATCT
    CAGCAGTATT ATCACAGCTT GGCTGTCCGA CAGAGTCTGG CTGTACATTT TAACATCCAG
    CAAGACTGTG GTCATTTCCT TGCTGAAGTC CCTAACCGTC TGCTTCCCTG GGAAGATTCT
    GATGCCCCTG AAAAGGCAGG GGATGAAATG GAAGACATTG AGGAAGAGGC GAAAGAAGAA
    ATTGATGAAA AAAATCCAGA GCCCTGCTCT GAAACAGAGT CATCGGAGAA AGAGAGCCAA
    GGAGTCACAA GCAGGAAGCA GAGAAGCCAT GTTGTAGTCA TCACCAGAGA GGTTCCCCAT
    CTCACTGTGG CCGACTTTGT GCGAGGCTCT TTGCCCCATC ATGAGAAAAG CCCTGACTTG
    TATGAGAGGC AAGTGTGTCT GCTGCTCTTA CAGCTGTGCT CTGGCCTTGA GCATCTCAAG
    CCCTACCATG TCACTCACTG CGATCTACGC CTTGAGAACC TGTTGCTTGT CCACCACCAG
    CCCGGGGGAA CTGCCCAGAG CCCTGGGTCT GCAGATCCTA GCCCCACCTC ATCTTATCCC
    ACAAGGCTTA TTGTGAGCAA CTTCTCTCAA GCCAAGCAAA AGAGCCATCT GGTGGACCCT
    GAGATACTCC GAGACCAGTC CCGCCTTGCC CCAGAGATCA TCACAGCCAC TCAGTATAAA
    AAGTGTGATG AGTTCCAGAC AGGCATCCTC ATCTATGAGA TGCTGCACCT GCCCAACCCT
    TTTGATGAGA ACCCAGAGCT GAAAGAGAAG GAGTACACCC GTACAGATCT GCCTCAAATC
    CCTCTCCGTT CTCCCTACTC CTGGGGCCTG CAGCAGCTGG CCAGCTGCCT CCTAAATCCC
    AACCCTTCTG AGCGCATCCT CATTTCTGAT GCCAAAGGCA TCCTTCAGTG TCTGCTCTGG
    GGTCCTCGTG AAGATCTTTT CCAAACCTTC ACCACTTCCA CAAGCCTAGT GCAGAGGAAT
    GCCCTGCTCC AAAACTGGTT GGACATTAAG CGAACACTGC TGATGATCAA GTTTGCTGAA
    AAGTCCTTAG ACAGAGAAGG GGGCATAAGC CTCGAGGACT GGCTTTGTGC TCAGTATCTG
    GCTTTTGCCA CCACAGACTC CCTGAGTTGT ATTGTAAAAA TCCTGCAACA TCGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa40458
    Clone ID Related Accession (Same CDS sequence) XM_008823439.2 , XM_008823439.3
    Accession Version XM_008823439.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 5217bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product inactive tyrosine-protein kinase PEAK1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008359594.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008823439.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    5101
    5161
    ATGTCTGCTT GTAACACCTT TACTGAACAC GTTTGGAAAC CTGGTGAATG CAAGAATTGC 
    TTCAAACCTA AAAGCTTGCA CCAGCTTCCC CCAGACTCTG AGAAGGCACC CATCACCCAT
    GGCAATGTGA AAACTAATGC CAATCATAGT AACAACCACC GTGTCAGGAA CACTGGGAAT
    TTCCGGCCTC CTGTGGCTAA AAAACCCACT ATAGCTGTGA AGCCCACTAT GATGGTGGCA
    GATGGGCAAA GTGTATGTGG TGAGCTTAGT ATCCAAGAAC ACTGTGAGAA CAAACCTGTC
    ATCATAGGAT GGAACCAAAA CAAGACTTCT TTGAGCCAGA AACCACTTAA CAATAATAAT
    GAAGATGATA TTGAAGGATT TGGCCATGTT CCTAAGCAGT ATGGCAGTAA TGACAGTGCA
    AAGAAGATAT CAAATAACAA TAATGGACTA ACTGATGTGT TAAAAGAGAT AGCAGGCCTA
    GATACCACCC CTCAAGTGAG AGGAAATGAA ACAAACTCCA GAGAAACATT TTTAGGGAGA
    ATAAACGATT GCTATAAACG TTCACTGGAA AGAAAGATTC CACCAAGTTG CATGATAGGT
    GGTGTGAAGG ATACTCAGGG CAAGCATGTT ATACTGAGTG GGAGCACAGA GGTCATCAGT
    AATGAAGGAG GCCGGTTCTG CTACCCTGAG TTCTCAAGTG GAGAGGAGAG TGAGGAAGAT
    GCACTTTTAA GTAACATGGA GGAGGAGCAT GAGAGCTGGG ATGAGAGTGA CGAGGAGCTG
    TTGGCCATGG AGATTCGCAT GAGAGGGCAG CCTCGCTTTG CTAATTTTAG GGCAAACACT
    TTGTCTCCTG TTCGATTCTT TGTGAGCAAA AAGTGGAATA CTGTCCCCCT AAGGAATAAG
    TCTCTGCAGA GAATCTGTGC TGTAGACTAT GATGACAGCT ATGATGAAAT CCTTAATGGT
    TATGAGGAAA ATTCTGGGGT TTCCTATGGT CAAGGAACCA TTCAGAGCAT GGTTTCATCT
    GACTCAACAT CACCAGATTC CTCTTTGACG GAAGAATCAC ATTCTGAAAC AGCTAGTAAT
    TTATCCCAGA AGATTTATAA TGGGGCGATA TCTCCTGGTA ACCCAGGAGA TTCTAAGGAC
    ATGAAAGAAA TTGAGTCTAA CTATGAAAGT CTCGCTGGTA ATAATCAGAA GGATTTATCA
    CAAACTTGCA AAGGCTCAGC AAAAGTTCCA GAGACACACA AAGCAGTCCT TGCTCTCCGA
    TTAGAAGAGA AGGATGGCAA AATTGCTGTA CAAACTGAGA AACTAGAAAG CAAAGCCTCT
    ACAGATATTG CTGGTCAAGC AGTAACCATA AGCCTTGTCC CTGTAGAAGA GCAAGCAAAG
    CCCTACCGAG TCGTAAATCT GGAACAGCCA TTGTGCAAAC CATATACCGT TGTGGATGTG
    TCAGCCGCCA TGGCCAGTGA GCACCTTGGG AGCCCCAAGA GAAAAGTTTC ATCTTCTACT
    CCAAACTCTC CAGTGACATC ACCTGCATTG ACACCAGGAC AAATAAGTAC TCATTTTAAA
    AAATCCAGTG CAATCCGATA CCAGGAAGTG TGGACTTCCA GCACCAGTCC ACGACAAAAG
    ATCCCCAAAG TAGAATTAAT TACTGGAGGA ACTGGACCAA ATATCCCTCC AAGAAAAACA
    TGCCATAAAT CAGCACCTAC TTCACCCACA GCTACAAATA TTTCCTCCAA AACCATCCCT
    GTTAAGTCAC CTAATTTGTC TGAAATAAAA TTTAATAGTT ATAACAACGC TGGTATGCCA
    CCTTTTCCCA TTATCATTCA TGATGAGCCA TCCTATGCTC GAAGTTCCAA AAATGCTATT
    AAAGTTCCCA TTGTTATTAA TCCAAATGCA TATGATAATC TAGCCATCTA TAAAAGCTTT
    CTGGGAACAA GTGGAGAACT CTCAGTAAAG GAAAAAACCA CAAGTGTAAT AAGCCATACT
    TATGAAGAAA TAGAAACTGA AAGCAAAGTG TCTGATAACA CCACTAGCAA ACTCCCTGAC
    TGTCCTCAAG CTAAAGGGTT TTCTAACAGC ACAGAGCATA AAAGAGGCTC AGTGGCTCAG
    AAGGTTCAGG AGTTTAACAG TTGTCTCAGC AGAGGTCAGC CTTCTCCACA GAGAAGCTAC
    AGTTCCAGCC ACAGCTCCCC TACAAAAATC CAGAGACCCA CTCAAGAGCC TGTGGCCAAA
    ACAGAAAGTG GGCAGGAGTC TCAGATGGCG GGCAGCAGTG GCAGCATCAG GGAGAAAGCA
    AGCACAGTGC TTTGTCAGAT TGTGGCTTCT ATCCCACCCC CCCAGTCTCC TCCAGAAGCA
    CCTCAGTCTA GCCCTAAGGC TTGCAGTGTG GAAGAGCTTT ATGCCATTCC TCCAGATGCT
    GATGCTACAA AAAGTATACC TAAAACTACA CCAGTCCGGC CCAAATCTCT CTTTACATCT
    CAGCCTAGTG TGGAGACTGA GGCACACCAG ACCACTGAAA GTCCTCCTAC TAAAATTCAG
    AAAGATCCAG TCACAAAGCC AGTCATTTCT CCACCCTCCA AATTAGTGAC CAACCCCCAG
    AGTGAGCCAC CACCTCCCTT TCCCCCACCA CGCTCTACTT CTTCCCCTTA CCATGCAAGT
    AACCTTTTGC AGAGGCATTT TACCAGCTGG ACAAAGCCAA CCAGTCCTAC CAGATCAACA
    GAAGCTGAAT CAGTTTTGCA TTCTGAAGGC AGCAGGCGAG CAGCTGATGC AAAGCCTAAA
    CGTTGGATAT CATTTAAAAG CTTCTTCCGC CGTCGGAAAA CAGAAGAGGA AGAAGACAAA
    GAGCGAGAGA AGGGAAAACT GGTGGGTTTA GATGGTACAG TCATCCACAT GCTGCCACCA
    CCTCCTGTAC AGCGCCATCA CTGGTTCACA GAAGCAAAAG GAGAGTCCAG TGAGAAACCT
    GCCATTGTCT TCATGTACAG GTGTGACCCT GACCAAAGCC AGCTTATTGT GGATAAGAGC
    AAGGCTGGGA CAGAACAGGC AGTGGTTACA GAGAAAGGAA GAACAGAGGA TGTGTTACTC
    CGGGACTTAG AAGAAAAGAA AAGTGGCCAT TCTTCTCCAT TGCAAATTCC TGAAAAAGTT
    CACAGTCACA TGACCCATGA AGTGGCAGAG GAATTTTCTC CTCAAGATCC AAGAACTCGT
    GTTGTGAAGC AAGATGGCAT TTCAGTCACA CCAGTATTGT CCCCACCTGA CCTGGAAAGG
    GAAGAAGAAA AAGATGACAC TTCAGATCCT ATAGACCTGA ACCCCTGTAG TGCAACATAC
    AGCAACTTAG GCCAATCTAG AGCAGCTATG ATACCTCCCA AGCATCCACG GCAGCCCAAG
    GGAGCTTTGG ATGACGCCAT TGCCTTCGGA GAGAAAACAG ACCAAGAAAT ATTGAGTGCT
    TCCCAACCCA CACCACCCCC ACTGCCAAAG AAAATGATAA GAGCCAATAC AGAACCAATC
    TCCAGAGACC TTCAGAAATC CATGGAAAGT AGTCTTTATG TCGTGGCTAA TCCTACCTAT
    GATATTGATC CCAACTGGGA TGCCAGCAGT GCTGGCTCTT CCATTAGCTA TGAACTCAAA
    GGACTGGACA TTGAGTCTTG TGACTCCTTG GAGAGACCTT TGCACAAGGA GAGACCTGTC
    CCTTCAGCAG CAAACAGTAT CACCAGCTTA ACCACTCTTA GTATTAAAGA CAGATTTTCC
    AACAGCATGG AGTCCCTGTC CAGCCGACGT GGTCTCCCCT GCAGACAGGG TCGAATCATC
    CAGAAACCAC AGAGACAAGC ACTTTATCGA GGACTTGAAA ACCGAGAGGA AGTGGTGGGT
    AAAATCCGAA GCCTTCATAC AGATGCCTTG AAGAAACTGG CTGTTAAATG TGAAGACCTC
    TTCATGGCTG GGCAGAAAGA CCAACTCCGT TTTGGGGTGG ACAGCTGGTC AGACTTTAGG
    TTAACCAGTG ACAAACCATG TTGTGAAGCA GGTGATGCTG TTTACTACAC TGCCTCATAT
    GCAAAAGATC CACTTAATAA CTATGCAGTC AAGATCTGTA AGAGCAAAGC TAAAGAATCT
    CAGCAGTATT ATCACAGCTT GGCTGTCCGA CAGAGTCTGG CTGTACATTT TAACATCCAG
    CAAGACTGTG GTCATTTCCT TGCTGAAGTC CCTAACCGTC TGCTTCCCTG GGAAGATTCT
    GATGCCCCTG AAAAGGCAGG GGATGAAATG GAAGACATTG AGGAAGAGGC GAAAGAAGAA
    ATTGATGAAA AAAATCCAGA GCCCTGCTCT GAAACAGAGT CATCGGAGAA AGAGAGCCAA
    GGAGTCACAA GCAGGAAGCA GAGAAGCCAT GTTGTAGTCA TCACCAGAGA GGTTCCCCAT
    CTCACTGTGG CCGACTTTGT GCGAGGCTCT TTGCCCCATC ATGAGAAAAG CCCTGACTTG
    TATGAGAGGC AAGTGTGTCT GCTGCTCTTA CAGCTGTGCT CTGGCCTTGA GCATCTCAAG
    CCCTACCATG TCACTCACTG CGATCTACGC CTTGAGAACC TGTTGCTTGT CCACCACCAG
    CCCGGGGGAA CTGCCCAGAG CCCTGGGTCT GCAGATCCTA GCCCCACCTC ATCTTATCCC
    ACAAGGCTTA TTGTGAGCAA CTTCTCTCAA GCCAAGCAAA AGAGCCATCT GGTGGACCCT
    GAGATACTCC GAGACCAGTC CCGCCTTGCC CCAGAGATCA TCACAGCCAC TCAGTATAAA
    AAGTGTGATG AGTTCCAGAC AGGCATCCTC ATCTATGAGA TGCTGCACCT GCCCAACCCT
    TTTGATGAGA ACCCAGAGCT GAAAGAGAAG GAGTACACCC GTACAGATCT GCCTCAAATC
    CCTCTCCGTT CTCCCTACTC CTGGGGCCTG CAGCAGCTGG CCAGCTGCCT CCTAAATCCC
    AACCCTTCTG AGCGCATCCT CATTTCTGAT GCCAAAGGCA TCCTTCAGTG TCTGCTCTGG
    GGTCCTCGTG AAGATCTTTT CCAAACCTTC ACCACTTCCA CAAGCCTAGT GCAGAGGAAT
    GCCCTGCTCC AAAACTGGTT GGACATTAAG CGAACACTGC TGATGATCAA GTTTGCTGAA
    AAGTCCTTAG ACAGAGAAGG GGGCATAAGC CTCGAGGACT GGCTTTGTGC TCAGTATCTG
    GCTTTTGCCA CCACAGACTC CCTGAGTTGT ATTGTAAAAA TCCTGCAACA TCGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008821661.1
    CDS102..5318
    Translation

    Target ORF information:

    RefSeq Version XM_008823439.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili pseudopodium enriched atypical kinase 1 (Peak1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008823439.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    5101
    5161
    ATGTCTGCTT GTAACACCTT TACTGAACAC GTTTGGAAAC CTGGTGAATG CAAGAATTGC 
    TTCAAACCTA AAAGCTTGCA CCAGCTTCCC CCAGACTCTG AGAAGGCACC CATCACCCAT
    GGCAATGTGA AAACTAATGC CAATCATAGT AACAACCACC GTGTCAGGAA CACTGGGAAT
    TTCCGGCCTC CTGTGGCTAA AAAACCCACT ATAGCTGTGA AGCCCACTAT GATGGTGGCA
    GATGGGCAAA GTGTATGTGG TGAGCTTAGT ATCCAAGAAC ACTGTGAGAA CAAACCTGTC
    ATCATAGGAT GGAACCAAAA CAAGACTTCT TTGAGCCAGA AACCACTTAA CAATAATAAT
    GAAGATGATA TTGAAGGATT TGGCCATGTT CCTAAGCAGT ATGGCAGTAA TGACAGTGCA
    AAGAAGATAT CAAATAACAA TAATGGACTA ACTGATGTGT TAAAAGAGAT AGCAGGCCTA
    GATACCACCC CTCAAGTGAG AGGAAATGAA ACAAACTCCA GAGAAACATT TTTAGGGAGA
    ATAAACGATT GCTATAAACG TTCACTGGAA AGAAAGATTC CACCAAGTTG CATGATAGGT
    GGTGTGAAGG ATACTCAGGG CAAGCATGTT ATACTGAGTG GGAGCACAGA GGTCATCAGT
    AATGAAGGAG GCCGGTTCTG CTACCCTGAG TTCTCAAGTG GAGAGGAGAG TGAGGAAGAT
    GCACTTTTAA GTAACATGGA GGAGGAGCAT GAGAGCTGGG ATGAGAGTGA CGAGGAGCTG
    TTGGCCATGG AGATTCGCAT GAGAGGGCAG CCTCGCTTTG CTAATTTTAG GGCAAACACT
    TTGTCTCCTG TTCGATTCTT TGTGAGCAAA AAGTGGAATA CTGTCCCCCT AAGGAATAAG
    TCTCTGCAGA GAATCTGTGC TGTAGACTAT GATGACAGCT ATGATGAAAT CCTTAATGGT
    TATGAGGAAA ATTCTGGGGT TTCCTATGGT CAAGGAACCA TTCAGAGCAT GGTTTCATCT
    GACTCAACAT CACCAGATTC CTCTTTGACG GAAGAATCAC ATTCTGAAAC AGCTAGTAAT
    TTATCCCAGA AGATTTATAA TGGGGCGATA TCTCCTGGTA ACCCAGGAGA TTCTAAGGAC
    ATGAAAGAAA TTGAGTCTAA CTATGAAAGT CTCGCTGGTA ATAATCAGAA GGATTTATCA
    CAAACTTGCA AAGGCTCAGC AAAAGTTCCA GAGACACACA AAGCAGTCCT TGCTCTCCGA
    TTAGAAGAGA AGGATGGCAA AATTGCTGTA CAAACTGAGA AACTAGAAAG CAAAGCCTCT
    ACAGATATTG CTGGTCAAGC AGTAACCATA AGCCTTGTCC CTGTAGAAGA GCAAGCAAAG
    CCCTACCGAG TCGTAAATCT GGAACAGCCA TTGTGCAAAC CATATACCGT TGTGGATGTG
    TCAGCCGCCA TGGCCAGTGA GCACCTTGGG AGCCCCAAGA GAAAAGTTTC ATCTTCTACT
    CCAAACTCTC CAGTGACATC ACCTGCATTG ACACCAGGAC AAATAAGTAC TCATTTTAAA
    AAATCCAGTG CAATCCGATA CCAGGAAGTG TGGACTTCCA GCACCAGTCC ACGACAAAAG
    ATCCCCAAAG TAGAATTAAT TACTGGAGGA ACTGGACCAA ATATCCCTCC AAGAAAAACA
    TGCCATAAAT CAGCACCTAC TTCACCCACA GCTACAAATA TTTCCTCCAA AACCATCCCT
    GTTAAGTCAC CTAATTTGTC TGAAATAAAA TTTAATAGTT ATAACAACGC TGGTATGCCA
    CCTTTTCCCA TTATCATTCA TGATGAGCCA TCCTATGCTC GAAGTTCCAA AAATGCTATT
    AAAGTTCCCA TTGTTATTAA TCCAAATGCA TATGATAATC TAGCCATCTA TAAAAGCTTT
    CTGGGAACAA GTGGAGAACT CTCAGTAAAG GAAAAAACCA CAAGTGTAAT AAGCCATACT
    TATGAAGAAA TAGAAACTGA AAGCAAAGTG TCTGATAACA CCACTAGCAA ACTCCCTGAC
    TGTCCTCAAG CTAAAGGGTT TTCTAACAGC ACAGAGCATA AAAGAGGCTC AGTGGCTCAG
    AAGGTTCAGG AGTTTAACAG TTGTCTCAGC AGAGGTCAGC CTTCTCCACA GAGAAGCTAC
    AGTTCCAGCC ACAGCTCCCC TACAAAAATC CAGAGACCCA CTCAAGAGCC TGTGGCCAAA
    ACAGAAAGTG GGCAGGAGTC TCAGATGGCG GGCAGCAGTG GCAGCATCAG GGAGAAAGCA
    AGCACAGTGC TTTGTCAGAT TGTGGCTTCT ATCCCACCCC CCCAGTCTCC TCCAGAAGCA
    CCTCAGTCTA GCCCTAAGGC TTGCAGTGTG GAAGAGCTTT ATGCCATTCC TCCAGATGCT
    GATGCTACAA AAAGTATACC TAAAACTACA CCAGTCCGGC CCAAATCTCT CTTTACATCT
    CAGCCTAGTG TGGAGACTGA GGCACACCAG ACCACTGAAA GTCCTCCTAC TAAAATTCAG
    AAAGATCCAG TCACAAAGCC AGTCATTTCT CCACCCTCCA AATTAGTGAC CAACCCCCAG
    AGTGAGCCAC CACCTCCCTT TCCCCCACCA CGCTCTACTT CTTCCCCTTA CCATGCAAGT
    AACCTTTTGC AGAGGCATTT TACCAGCTGG ACAAAGCCAA CCAGTCCTAC CAGATCAACA
    GAAGCTGAAT CAGTTTTGCA TTCTGAAGGC AGCAGGCGAG CAGCTGATGC AAAGCCTAAA
    CGTTGGATAT CATTTAAAAG CTTCTTCCGC CGTCGGAAAA CAGAAGAGGA AGAAGACAAA
    GAGCGAGAGA AGGGAAAACT GGTGGGTTTA GATGGTACAG TCATCCACAT GCTGCCACCA
    CCTCCTGTAC AGCGCCATCA CTGGTTCACA GAAGCAAAAG GAGAGTCCAG TGAGAAACCT
    GCCATTGTCT TCATGTACAG GTGTGACCCT GACCAAAGCC AGCTTATTGT GGATAAGAGC
    AAGGCTGGGA CAGAACAGGC AGTGGTTACA GAGAAAGGAA GAACAGAGGA TGTGTTACTC
    CGGGACTTAG AAGAAAAGAA AAGTGGCCAT TCTTCTCCAT TGCAAATTCC TGAAAAAGTT
    CACAGTCACA TGACCCATGA AGTGGCAGAG GAATTTTCTC CTCAAGATCC AAGAACTCGT
    GTTGTGAAGC AAGATGGCAT TTCAGTCACA CCAGTATTGT CCCCACCTGA CCTGGAAAGG
    GAAGAAGAAA AAGATGACAC TTCAGATCCT ATAGACCTGA ACCCCTGTAG TGCAACATAC
    AGCAACTTAG GCCAATCTAG AGCAGCTATG ATACCTCCCA AGCATCCACG GCAGCCCAAG
    GGAGCTTTGG ATGACGCCAT TGCCTTCGGA GAGAAAACAG ACCAAGAAAT ATTGAGTGCT
    TCCCAACCCA CACCACCCCC ACTGCCAAAG AAAATGATAA GAGCCAATAC AGAACCAATC
    TCCAGAGACC TTCAGAAATC CATGGAAAGT AGTCTTTATG TCGTGGCTAA TCCTACCTAT
    GATATTGATC CCAACTGGGA TGCCAGCAGT GCTGGCTCTT CCATTAGCTA TGAACTCAAA
    GGACTGGACA TTGAGTCTTG TGACTCCTTG GAGAGACCTT TGCACAAGGA GAGACCTGTC
    CCTTCAGCAG CAAACAGTAT CACCAGCTTA ACCACTCTTA GTATTAAAGA CAGATTTTCC
    AACAGCATGG AGTCCCTGTC CAGCCGACGT GGTCTCCCCT GCAGACAGGG TCGAATCATC
    CAGAAACCAC AGAGACAAGC ACTTTATCGA GGACTTGAAA ACCGAGAGGA AGTGGTGGGT
    AAAATCCGAA GCCTTCATAC AGATGCCTTG AAGAAACTGG CTGTTAAATG TGAAGACCTC
    TTCATGGCTG GGCAGAAAGA CCAACTCCGT TTTGGGGTGG ACAGCTGGTC AGACTTTAGG
    TTAACCAGTG ACAAACCATG TTGTGAAGCA GGTGATGCTG TTTACTACAC TGCCTCATAT
    GCAAAAGATC CACTTAATAA CTATGCAGTC AAGATCTGTA AGAGCAAAGC TAAAGAATCT
    CAGCAGTATT ATCACAGCTT GGCTGTCCGA CAGAGTCTGG CTGTACATTT TAACATCCAG
    CAAGACTGTG GTCATTTCCT TGCTGAAGTC CCTAACCGTC TGCTTCCCTG GGAAGATTCT
    GATGCCCCTG AAAAGGCAGG GGATGAAATG GAAGACATTG AGGAAGAGGC GAAAGAAGAA
    ATTGATGAAA AAAATCCAGA GCCCTGCTCT GAAACAGAGT CATCGGAGAA AGAGAGCCAA
    GGAGTCACAA GCAGGAAGCA GAGAAGCCAT GTTGTAGTCA TCACCAGAGA GGTTCCCCAT
    CTCACTGTGG CCGACTTTGT GCGAGGCTCT TTGCCCCATC ATGAGAAAAG CCCTGACTTG
    TATGAGAGGC AAGTGTGTCT GCTGCTCTTA CAGCTGTGCT CTGGCCTTGA GCATCTCAAG
    CCCTACCATG TCACTCACTG CGATCTACGC CTTGAGAACC TGTTGCTTGT CCACCACCAG
    CCCGGGGGAA CTGCCCAGAG CCCTGGGTCT GCAGATCCTA GCCCCACCTC ATCTTATCCC
    ACAAGGCTTA TTGTGAGCAA CTTCTCTCAA GCCAAGCAAA AGAGCCATCT GGTGGACCCT
    GAGATACTCC GAGACCAGTC CCGCCTTGCC CCAGAGATCA TCACAGCCAC TCAGTATAAA
    AAGTGTGATG AGTTCCAGAC AGGCATCCTC ATCTATGAGA TGCTGCACCT GCCCAACCCT
    TTTGATGAGA ACCCAGAGCT GAAAGAGAAG GAGTACACCC GTACAGATCT GCCTCAAATC
    CCTCTCCGTT CTCCCTACTC CTGGGGCCTG CAGCAGCTGG CCAGCTGCCT CCTAAATCCC
    AACCCTTCTG AGCGCATCCT CATTTCTGAT GCCAAAGGCA TCCTTCAGTG TCTGCTCTGG
    GGTCCTCGTG AAGATCTTTT CCAAACCTTC ACCACTTCCA CAAGCCTAGT GCAGAGGAAT
    GCCCTGCTCC AAAACTGGTT GGACATTAAG CGAACACTGC TGATGATCAA GTTTGCTGAA
    AAGTCCTTAG ACAGAGAAGG GGGCATAAGC CTCGAGGACT GGCTTTGTGC TCAGTATCTG
    GCTTTTGCCA CCACAGACTC CCTGAGTTGT ATTGTAAAAA TCCTGCAACA TCGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.