Pcdh17 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

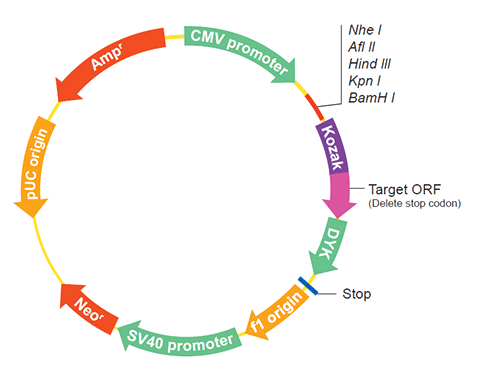
The following Pcdh17 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Pcdh17 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa40016 XM_017795561.2
Latest version!
Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa40017 XM_008822921.3
Latest version!
Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa40018 XM_008822922.2
Latest version!
Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
View Old Accession Versions >>
ONa40017 XM_008822921.2 Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
ONa40016 XM_017795561.1 Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa40016
    Clone ID Related Accession (Same CDS sequence) XM_017795561.2 , XM_017795561.1
    Accession Version XM_017795561.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3567bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
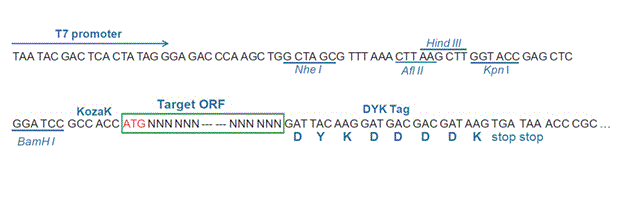
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protocadherin-17 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008359214.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_017795561.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGTAG CTCCACGTTT
    AAGGACCCAG AAAGAGCCAG CCTGAGAGAC AGTGGGCACG GGGACAGTGA TCAGGCTGAC
    AGTGACCAAG ACACTAACAA AGGCTCCTGC TGTGACATGT CTGTTAGGGA GGCACTCAAG
    ATGAAAACTA CTTCAACTAA AAGCCAACCA CTTGAACAAG CATTCCCGAC TTTGCTTTCC
    TTTGCTATCC TCACCCTACA CACCATCACA ACTAGACTTC AGTCTGTTGA TCCGCTTCCT
    CCAGAACCAG AAGAGTGTGT TAATTGCACA GATGAATGCC GAGTGCTTGG TCATTCTGAT
    AGGTGTTGGA TGCCGCAGTT CCCTGCAGCC AATCAGGCTG AAAATGCAGA TTACCGCACA
    AATCTCTTTG TACCCACAGT GGAAGCTAAT GTTGAGACTG AGACTTATGA AACTGTGAAT
    CCCACTGGGA AAAAGACTTT TTGTACATTT GGAAAAGACA AGAGAGAGCA CACTATTCTC
    ATTGCCAATG TGAAACCTTA TTTAAAAGCC AAACGTGCCC TGAGCCCTCT CCTCCAAGAG
    GTCCCCTCAG CATCAAACAG CCCTACCAAG GCATGCATAG AGCCTTGCAC CTCCACCAAA
    GGCTCCCTGG ATGGCTGTGA AGCCAAATCA GGGGCCCTCG CTGAAGCAAG CAGTTCCTAT
    CTGCCCACTG ACAGTCAGTA CCTGTCGCCC AGTAAGCAGC CGAGAGATCC TCCCTTCATG
    GCTACTGATC AGATGGCAAG GGTCTTCGCA GATGTGCACT CCAGAGCCAG CCGGGATTCC
    AGCGAGATGG GAGCTGTGCT GGAGCAGATT GACCACGCCG GCAGGGATCT GGGCAGAGAG
    TCGGTGGACG CAGAGGAAGT CGTGAGAGAG ATTGATAAGC TCTTGCAGGA CTGCCGGGGA
    AATGATCCCG TGGCTGTGAG AAAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017651050.1
    CDS207..3773
    Translation

    Target ORF information:

    RefSeq Version XM_017795561.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017795561.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGTAG CTCCACGTTT
    AAGGACCCAG AAAGAGCCAG CCTGAGAGAC AGTGGGCACG GGGACAGTGA TCAGGCTGAC
    AGTGACCAAG ACACTAACAA AGGCTCCTGC TGTGACATGT CTGTTAGGGA GGCACTCAAG
    ATGAAAACTA CTTCAACTAA AAGCCAACCA CTTGAACAAG CATTCCCGAC TTTGCTTTCC
    TTTGCTATCC TCACCCTACA CACCATCACA ACTAGACTTC AGTCTGTTGA TCCGCTTCCT
    CCAGAACCAG AAGAGTGTGT TAATTGCACA GATGAATGCC GAGTGCTTGG TCATTCTGAT
    AGGTGTTGGA TGCCGCAGTT CCCTGCAGCC AATCAGGCTG AAAATGCAGA TTACCGCACA
    AATCTCTTTG TACCCACAGT GGAAGCTAAT GTTGAGACTG AGACTTATGA AACTGTGAAT
    CCCACTGGGA AAAAGACTTT TTGTACATTT GGAAAAGACA AGAGAGAGCA CACTATTCTC
    ATTGCCAATG TGAAACCTTA TTTAAAAGCC AAACGTGCCC TGAGCCCTCT CCTCCAAGAG
    GTCCCCTCAG CATCAAACAG CCCTACCAAG GCATGCATAG AGCCTTGCAC CTCCACCAAA
    GGCTCCCTGG ATGGCTGTGA AGCCAAATCA GGGGCCCTCG CTGAAGCAAG CAGTTCCTAT
    CTGCCCACTG ACAGTCAGTA CCTGTCGCCC AGTAAGCAGC CGAGAGATCC TCCCTTCATG
    GCTACTGATC AGATGGCAAG GGTCTTCGCA GATGTGCACT CCAGAGCCAG CCGGGATTCC
    AGCGAGATGG GAGCTGTGCT GGAGCAGATT GACCACGCCG GCAGGGATCT GGGCAGAGAG
    TCGGTGGACG CAGAGGAAGT CGTGAGAGAG ATTGATAAGC TCTTGCAGGA CTGCCGGGGA
    AATGATCCCG TGGCTGTGAG AAAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa40016
    Clone ID Related Accession (Same CDS sequence) XM_017795561.2 , XM_017795561.1
    Accession Version XM_017795561.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3567bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protocadherin-17 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008359214.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGTAG CTCCACGTTT
    AAGGACCCAG AAAGAGCCAG CCTGAGAGAC AGTGGGCACG GGGACAGTGA TCAGGCTGAC
    AGTGACCAAG ACACTAACAA AGGCTCCTGC TGTGACATGT CTGTTAGGGA GGCACTCAAG
    ATGAAAACTA CTTCAACTAA AAGCCAACCA CTTGAACAAG CATTCCCGAC TTTGCTTTCC
    TTTGCTATCC TCACCCTACA CACCATCACA ACTAGACTTC AGTCTGTTGA TCCGCTTCCT
    CCAGAACCAG AAGAGTGTGT TAATTGCACA GATGAATGCC GAGTGCTTGG TCATTCTGAT
    AGGTGTTGGA TGCCGCAGTT CCCTGCAGCC AATCAGGCTG AAAATGCAGA TTACCGCACA
    AATCTCTTTG TACCCACAGT GGAAGCTAAT GTTGAGACTG AGACTTATGA AACTGTGAAT
    CCCACTGGGA AAAAGACTTT TTGTACATTT GGAAAAGACA AGAGAGAGCA CACTATTCTC
    ATTGCCAATG TGAAACCTTA TTTAAAAGCC AAACGTGCCC TGAGCCCTCT CCTCCAAGAG
    GTCCCCTCAG CATCAAACAG CCCTACCAAG GCATGCATAG AGCCTTGCAC CTCCACCAAA
    GGCTCCCTGG ATGGCTGTGA AGCCAAATCA GGGGCCCTCG CTGAAGCAAG CAGTTCCTAT
    CTGCCCACTG ACAGTCAGTA CCTGTCGCCC AGTAAGCAGC CGAGAGATCC TCCCTTCATG
    GCTACTGATC AGATGGCAAG GGTCTTCGCA GATGTGCACT CCAGAGCCAG CCGGGATTCC
    AGCGAGATGG GAGCTGTGCT GGAGCAGATT GACCACGCCG GCAGGGATCT GGGCAGAGAG
    TCGGTGGACG CAGAGGAAGT CGTGAGAGAG ATTGATAAGC TCTTGCAGGA CTGCCGGGGA
    AATGATCCCG TGGCTGTGAG AAAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017651050.1
    CDS212..3778
    Translation

    Target ORF information:

    RefSeq Version XM_017795561.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017795561.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGTAG CTCCACGTTT
    AAGGACCCAG AAAGAGCCAG CCTGAGAGAC AGTGGGCACG GGGACAGTGA TCAGGCTGAC
    AGTGACCAAG ACACTAACAA AGGCTCCTGC TGTGACATGT CTGTTAGGGA GGCACTCAAG
    ATGAAAACTA CTTCAACTAA AAGCCAACCA CTTGAACAAG CATTCCCGAC TTTGCTTTCC
    TTTGCTATCC TCACCCTACA CACCATCACA ACTAGACTTC AGTCTGTTGA TCCGCTTCCT
    CCAGAACCAG AAGAGTGTGT TAATTGCACA GATGAATGCC GAGTGCTTGG TCATTCTGAT
    AGGTGTTGGA TGCCGCAGTT CCCTGCAGCC AATCAGGCTG AAAATGCAGA TTACCGCACA
    AATCTCTTTG TACCCACAGT GGAAGCTAAT GTTGAGACTG AGACTTATGA AACTGTGAAT
    CCCACTGGGA AAAAGACTTT TTGTACATTT GGAAAAGACA AGAGAGAGCA CACTATTCTC
    ATTGCCAATG TGAAACCTTA TTTAAAAGCC AAACGTGCCC TGAGCCCTCT CCTCCAAGAG
    GTCCCCTCAG CATCAAACAG CCCTACCAAG GCATGCATAG AGCCTTGCAC CTCCACCAAA
    GGCTCCCTGG ATGGCTGTGA AGCCAAATCA GGGGCCCTCG CTGAAGCAAG CAGTTCCTAT
    CTGCCCACTG ACAGTCAGTA CCTGTCGCCC AGTAAGCAGC CGAGAGATCC TCCCTTCATG
    GCTACTGATC AGATGGCAAG GGTCTTCGCA GATGTGCACT CCAGAGCCAG CCGGGATTCC
    AGCGAGATGG GAGCTGTGCT GGAGCAGATT GACCACGCCG GCAGGGATCT GGGCAGAGAG
    TCGGTGGACG CAGAGGAAGT CGTGAGAGAG ATTGATAAGC TCTTGCAGGA CTGCCGGGGA
    AATGATCCCG TGGCTGTGAG AAAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa40017
    Clone ID Related Accession (Same CDS sequence) XM_008822921.2 , XM_008822921.3
    Accession Version XM_008822921.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3564bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protocadherin-17 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008359214.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008822921.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGCTC CACGTTTAAG
    GACCCAGAAA GAGCCAGCCT GAGAGACAGT GGGCACGGGG ACAGTGATCA GGCTGACAGT
    GACCAAGACA CTAACAAAGG CTCCTGCTGT GACATGTCTG TTAGGGAGGC ACTCAAGATG
    AAAACTACTT CAACTAAAAG CCAACCACTT GAACAAGCAT TCCCGACTTT GCTTTCCTTT
    GCTATCCTCA CCCTACACAC CATCACAACT AGACTTCAGT CTGTTGATCC GCTTCCTCCA
    GAACCAGAAG AGTGTGTTAA TTGCACAGAT GAATGCCGAG TGCTTGGTCA TTCTGATAGG
    TGTTGGATGC CGCAGTTCCC TGCAGCCAAT CAGGCTGAAA ATGCAGATTA CCGCACAAAT
    CTCTTTGTAC CCACAGTGGA AGCTAATGTT GAGACTGAGA CTTATGAAAC TGTGAATCCC
    ACTGGGAAAA AGACTTTTTG TACATTTGGA AAAGACAAGA GAGAGCACAC TATTCTCATT
    GCCAATGTGA AACCTTATTT AAAAGCCAAA CGTGCCCTGA GCCCTCTCCT CCAAGAGGTC
    CCCTCAGCAT CAAACAGCCC TACCAAGGCA TGCATAGAGC CTTGCACCTC CACCAAAGGC
    TCCCTGGATG GCTGTGAAGC CAAATCAGGG GCCCTCGCTG AAGCAAGCAG TTCCTATCTG
    CCCACTGACA GTCAGTACCT GTCGCCCAGT AAGCAGCCGA GAGATCCTCC CTTCATGGCT
    ACTGATCAGA TGGCAAGGGT CTTCGCAGAT GTGCACTCCA GAGCCAGCCG GGATTCCAGC
    GAGATGGGAG CTGTGCTGGA GCAGATTGAC CACGCCGGCA GGGATCTGGG CAGAGAGTCG
    GTGGACGCAG AGGAAGTCGT GAGAGAGATT GATAAGCTCT TGCAGGACTG CCGGGGAAAT
    GATCCCGTGG CTGTGAGAAA GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008821143.1
    CDS212..3775
    Translation

    Target ORF information:

    RefSeq Version XM_008822921.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008822921.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGCTC CACGTTTAAG
    GACCCAGAAA GAGCCAGCCT GAGAGACAGT GGGCACGGGG ACAGTGATCA GGCTGACAGT
    GACCAAGACA CTAACAAAGG CTCCTGCTGT GACATGTCTG TTAGGGAGGC ACTCAAGATG
    AAAACTACTT CAACTAAAAG CCAACCACTT GAACAAGCAT TCCCGACTTT GCTTTCCTTT
    GCTATCCTCA CCCTACACAC CATCACAACT AGACTTCAGT CTGTTGATCC GCTTCCTCCA
    GAACCAGAAG AGTGTGTTAA TTGCACAGAT GAATGCCGAG TGCTTGGTCA TTCTGATAGG
    TGTTGGATGC CGCAGTTCCC TGCAGCCAAT CAGGCTGAAA ATGCAGATTA CCGCACAAAT
    CTCTTTGTAC CCACAGTGGA AGCTAATGTT GAGACTGAGA CTTATGAAAC TGTGAATCCC
    ACTGGGAAAA AGACTTTTTG TACATTTGGA AAAGACAAGA GAGAGCACAC TATTCTCATT
    GCCAATGTGA AACCTTATTT AAAAGCCAAA CGTGCCCTGA GCCCTCTCCT CCAAGAGGTC
    CCCTCAGCAT CAAACAGCCC TACCAAGGCA TGCATAGAGC CTTGCACCTC CACCAAAGGC
    TCCCTGGATG GCTGTGAAGC CAAATCAGGG GCCCTCGCTG AAGCAAGCAG TTCCTATCTG
    CCCACTGACA GTCAGTACCT GTCGCCCAGT AAGCAGCCGA GAGATCCTCC CTTCATGGCT
    ACTGATCAGA TGGCAAGGGT CTTCGCAGAT GTGCACTCCA GAGCCAGCCG GGATTCCAGC
    GAGATGGGAG CTGTGCTGGA GCAGATTGAC CACGCCGGCA GGGATCTGGG CAGAGAGTCG
    GTGGACGCAG AGGAAGTCGT GAGAGAGATT GATAAGCTCT TGCAGGACTG CCGGGGAAAT
    GATCCCGTGG CTGTGAGAAA GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa40017
    Clone ID Related Accession (Same CDS sequence) XM_008822921.2 , XM_008822921.3
    Accession Version XM_008822921.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3564bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protocadherin-17 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008359214.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008822921.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGCTC CACGTTTAAG
    GACCCAGAAA GAGCCAGCCT GAGAGACAGT GGGCACGGGG ACAGTGATCA GGCTGACAGT
    GACCAAGACA CTAACAAAGG CTCCTGCTGT GACATGTCTG TTAGGGAGGC ACTCAAGATG
    AAAACTACTT CAACTAAAAG CCAACCACTT GAACAAGCAT TCCCGACTTT GCTTTCCTTT
    GCTATCCTCA CCCTACACAC CATCACAACT AGACTTCAGT CTGTTGATCC GCTTCCTCCA
    GAACCAGAAG AGTGTGTTAA TTGCACAGAT GAATGCCGAG TGCTTGGTCA TTCTGATAGG
    TGTTGGATGC CGCAGTTCCC TGCAGCCAAT CAGGCTGAAA ATGCAGATTA CCGCACAAAT
    CTCTTTGTAC CCACAGTGGA AGCTAATGTT GAGACTGAGA CTTATGAAAC TGTGAATCCC
    ACTGGGAAAA AGACTTTTTG TACATTTGGA AAAGACAAGA GAGAGCACAC TATTCTCATT
    GCCAATGTGA AACCTTATTT AAAAGCCAAA CGTGCCCTGA GCCCTCTCCT CCAAGAGGTC
    CCCTCAGCAT CAAACAGCCC TACCAAGGCA TGCATAGAGC CTTGCACCTC CACCAAAGGC
    TCCCTGGATG GCTGTGAAGC CAAATCAGGG GCCCTCGCTG AAGCAAGCAG TTCCTATCTG
    CCCACTGACA GTCAGTACCT GTCGCCCAGT AAGCAGCCGA GAGATCCTCC CTTCATGGCT
    ACTGATCAGA TGGCAAGGGT CTTCGCAGAT GTGCACTCCA GAGCCAGCCG GGATTCCAGC
    GAGATGGGAG CTGTGCTGGA GCAGATTGAC CACGCCGGCA GGGATCTGGG CAGAGAGTCG
    GTGGACGCAG AGGAAGTCGT GAGAGAGATT GATAAGCTCT TGCAGGACTG CCGGGGAAAT
    GATCCCGTGG CTGTGAGAAA GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008821143.1
    CDS207..3770
    Translation

    Target ORF information:

    RefSeq Version XM_008822921.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008822921.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGCTC CACGTTTAAG
    GACCCAGAAA GAGCCAGCCT GAGAGACAGT GGGCACGGGG ACAGTGATCA GGCTGACAGT
    GACCAAGACA CTAACAAAGG CTCCTGCTGT GACATGTCTG TTAGGGAGGC ACTCAAGATG
    AAAACTACTT CAACTAAAAG CCAACCACTT GAACAAGCAT TCCCGACTTT GCTTTCCTTT
    GCTATCCTCA CCCTACACAC CATCACAACT AGACTTCAGT CTGTTGATCC GCTTCCTCCA
    GAACCAGAAG AGTGTGTTAA TTGCACAGAT GAATGCCGAG TGCTTGGTCA TTCTGATAGG
    TGTTGGATGC CGCAGTTCCC TGCAGCCAAT CAGGCTGAAA ATGCAGATTA CCGCACAAAT
    CTCTTTGTAC CCACAGTGGA AGCTAATGTT GAGACTGAGA CTTATGAAAC TGTGAATCCC
    ACTGGGAAAA AGACTTTTTG TACATTTGGA AAAGACAAGA GAGAGCACAC TATTCTCATT
    GCCAATGTGA AACCTTATTT AAAAGCCAAA CGTGCCCTGA GCCCTCTCCT CCAAGAGGTC
    CCCTCAGCAT CAAACAGCCC TACCAAGGCA TGCATAGAGC CTTGCACCTC CACCAAAGGC
    TCCCTGGATG GCTGTGAAGC CAAATCAGGG GCCCTCGCTG AAGCAAGCAG TTCCTATCTG
    CCCACTGACA GTCAGTACCT GTCGCCCAGT AAGCAGCCGA GAGATCCTCC CTTCATGGCT
    ACTGATCAGA TGGCAAGGGT CTTCGCAGAT GTGCACTCCA GAGCCAGCCG GGATTCCAGC
    GAGATGGGAG CTGTGCTGGA GCAGATTGAC CACGCCGGCA GGGATCTGGG CAGAGAGTCG
    GTGGACGCAG AGGAAGTCGT GAGAGAGATT GATAAGCTCT TGCAGGACTG CCGGGGAAAT
    GATCCCGTGG CTGTGAGAAA GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa40018
    Clone ID Related Accession (Same CDS sequence) XM_008822922.2
    Accession Version XM_008822922.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3483bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product protocadherin-17 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008359214.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008822922.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGTAG CTCCACGTTT
    AAGGACCCAG AAAGAGCCAG CCTGAGAGAC AGTGGGCACG GGGACAGTGA TCAGGCTGAC
    AGTGACCAAG ACACTAACAA AGGCTCCTGC TGTGACATGT CTGTTAGGGA GGCACTCAAG
    ATGAAAACTA CTTCAACTAA AAGCCAACCA CTTGAACAAG AACCAGAAGA GTGTGTTAAT
    TGCACAGATG AATGCCGAGT GCTTGGTCAT TCTGATAGGT GTTGGATGCC GCAGTTCCCT
    GCAGCCAATC AGGCTGAAAA TGCAGATTAC CGCACAAATC TCTTTGTACC CACAGTGGAA
    GCTAATGTTG AGACTGAGAC TTATGAAACT GTGAATCCCA CTGGGAAAAA GACTTTTTGT
    ACATTTGGAA AAGACAAGAG AGAGCACACT ATTCTCATTG CCAATGTGAA ACCTTATTTA
    AAAGCCAAAC GTGCCCTGAG CCCTCTCCTC CAAGAGGTCC CCTCAGCATC AAACAGCCCT
    ACCAAGGCAT GCATAGAGCC TTGCACCTCC ACCAAAGGCT CCCTGGATGG CTGTGAAGCC
    AAATCAGGGG CCCTCGCTGA AGCAAGCAGT TCCTATCTGC CCACTGACAG TCAGTACCTG
    TCGCCCAGTA AGCAGCCGAG AGATCCTCCC TTCATGGCTA CTGATCAGAT GGCAAGGGTC
    TTCGCAGATG TGCACTCCAG AGCCAGCCGG GATTCCAGCG AGATGGGAGC TGTGCTGGAG
    CAGATTGACC ACGCCGGCAG GGATCTGGGC AGAGAGTCGG TGGACGCAGA GGAAGTCGTG
    AGAGAGATTG ATAAGCTCTT GCAGGACTGC CGGGGAAATG ATCCCGTGGC TGTGAGAAAG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008821144.1
    CDS20..3502
    Translation

    Target ORF information:

    RefSeq Version XM_008822922.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili protocadherin 17 (Pcdh17), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008822922.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGTACCTTT CCATCTGTTG CTGCTTTCTT TTATGGGCCC CTGCCCTGAC ACTCAAAAAC 
    CTCAACTACT CAGTGCCAGA GGAGCAAGGG GCCGGCACTG TGATAGGCAA CATCGGTAAG
    GATGCTCGAC TGCAGCCCGG GCTTCCGCCG GCTGAGCGCG GTAGCAGCAG CGGGCGAAGC
    AAGTCCGGCA GTTACAGGGT TCTGGAGAAC TCTGCGCCTC ACCTGCTGGA CGTGGACGCT
    GACAGCGGGC TCCTCTACAC CAAGCAGCGC ATCGACCGTG AGTCCTTGTG CCGCCACAAT
    GCCAAGTGCC AGCTGTCCCT AGAGGTGTTC GCTAACGACA AGGAGATCTG CATGATCAAG
    GTGGAAATCC AGGATATCAA CGACAACGCT CCGTCTTTCC CCTCTGACCA GATCGAGATG
    GACATCTCCG AGAACGCGGC CCCAGGCACC CGCTTCCCCC TGACCAGCGC ACACGACCCA
    GACGCCGGCG AGAACGGGCT CCGCACCTAC CTGCTCACAC GCGATGACCA CGGCCTCTTT
    GCATTGGACG TCAAGTCCCG TGGAGACGGC ACCAAGTTCC CAGAACTGGT CATCCAAAAG
    GCGTTGGACC GGGAGCAGCA GAACCACCAC ACTCTGGTGT TGACTGCCCT GGATGGCGGC
    GAGCCTCCGC GGTCTGCCAC CGTACAGATC AACGTGAAGG TGATCGACTC CAACGACAAC
    AGTCCAGTCT TCGAGGCCCC GTCCTACTTG GTAGAACTGC CCGAGAACGC CCCCCTGGGC
    ACCGTGGTCA TTGATCTAAA TGCCACCGAC GCTGATGAGG GTCCCAACGG GGAAGTGCTG
    TATTCTTTCA GCAGCTACGT GCCCGACCGC GTGCGGGAGC TCTTCTCCAT TGATCCCAAG
    ACCGGTCTGA TCCGTGTAAA GGGCAACCTG GACTATGAGG AGAATGGTAT GCTAGAGATC
    GACGTGCAGG CCAGAGACCT GGGACCTAAC CCAATTCCTG CCCACTGCAA GGTCACTGTC
    AAGCTCATCG ACCGCAATGA CAACGCGCCG TCCATCGGTT TCGTCTCCGT GCGCCAGGGG
    GCGCTCAGCG AGGCCGCCCC TCCTGGCACT GTGATCGCCC TGGTTCGGGT CACTGACCGA
    GACTCAGGCA AGAACGGGCA GCTGCAGTGC CGGGTGCTGG GTGGAGGAGG TACTGGCGGC
    GGCGGAGGCC TAGGCGGGCC GGGAGGTTCC GTCCCCTTCA AGCTTGAAGA GAACTACGAC
    AACTTCTACA CTGTGGTGAC TGACCGTCCG CTGGACCGCG AGACCCAAGA CGAATACAAT
    GTGACAATCG TGGCACGGGA CGGGGGCTCC CCTCCCCTCA ACTCCACCAA GTCATTCGCT
    GTCAAGATAC TGGACGAGAA CGACAACCCT CCTCGGTTCA CCAAAGGGCT GTATGTGCTC
    CAGGTGCACG AGAACAACAT TCCAGGGGAA TACCTGGGCT CTGTGCTCGC CCAGGATCCC
    GACCTGGGCC AAAATGGGAC AGTGTCCTAC TCCATTCTGC CTTCGCACAT CGGCGACGTG
    TCCATCTACA CCTATGTGTC CGTGAACCCC ACAAACGGGG CCATATATGC CCTGCGCTCC
    TTTAACTATG AGCAAACGAA GGCATTTGAG TTCAAGGTAC TGGCTAAGGA CTCCGGGGCA
    CCCGCGCACT TAGAGAGCAA TGCCACGGTG AGGGTGACAG TGTTAGATGT GAACGACAAC
    GCTCCAGTGA TCGTACTTCC CACGCTGCAG AACGACACCG CTGAGCTTCA GGTCCCGCGT
    AACGCTGGCC TGGGCTACCT GGTAAGCACA GTGCGCGCCC TGGACAGCGA CTTTGGAGAG
    AGCGGGCGCC TCACTTACGA GATTGTGGAC GGCAACGACG ACCACCTGTT TGAGATCGAT
    CCATCCAGCG GCGAGATCCG CACGCTGCAC CCTTTCTGGG AGGACGTGAC ACCTGTGGTG
    GAGCTGGTGG TGAAAGTGAC CGACCATGGC AAGCCCACCC TGTCAGCGGT GGCCAAGCTC
    ATCATTCGCT CTGTGAGCGG CTCTCTACCT GAGGGGGTAC CTCGAGTGAA TGGTGAGCAG
    CACCACTGGG ACATGTCGTT GCCACTCATA GTGACTCTGA GCACGATCTC CATCATCCTC
    CTAGCGGCCA TGATCACCAT CGCTGTGAAG TGCAAGCGCG AAAACAAGGA GATTCGCACT
    TACAACTGCC GCATCGCCGA ATACAGCCAC CCGCAGCTGG GCGGGGGGAA AGGCAAGAAG
    AAGAAGATCA ACAAAAATGA TATCATGCTG GTGCAGAGTG AGGTGGAGGA GAGGAACGCC
    ATGAACGTCA TGAACGTGGT GAGCAGTCCC TCCCTGGCCA CCTCCCCCAT GTACTTCGAC
    TACCAAACCC GCCTGCCCCT CAGCTCACCC CGGTCAGAGG TGATGTATCT TAAGCCAGCC
    TCCAACAACC TGGCTGTCCC TCAGGGGCAC GCAGGCTGCC ACACCAGCTT CACCGGACAA
    GGGACTAATT CAAGCGAGAC CCCTGCCACT CGGATGTCCA TAATTCAGAC AGACAATTTT
    CCCGCAGAGC CCAATTACAT GGGCAGCAGG CAGCAGTTTG TTCAAAGTAG CTCCACGTTT
    AAGGACCCAG AAAGAGCCAG CCTGAGAGAC AGTGGGCACG GGGACAGTGA TCAGGCTGAC
    AGTGACCAAG ACACTAACAA AGGCTCCTGC TGTGACATGT CTGTTAGGGA GGCACTCAAG
    ATGAAAACTA CTTCAACTAA AAGCCAACCA CTTGAACAAG AACCAGAAGA GTGTGTTAAT
    TGCACAGATG AATGCCGAGT GCTTGGTCAT TCTGATAGGT GTTGGATGCC GCAGTTCCCT
    GCAGCCAATC AGGCTGAAAA TGCAGATTAC CGCACAAATC TCTTTGTACC CACAGTGGAA
    GCTAATGTTG AGACTGAGAC TTATGAAACT GTGAATCCCA CTGGGAAAAA GACTTTTTGT
    ACATTTGGAA AAGACAAGAG AGAGCACACT ATTCTCATTG CCAATGTGAA ACCTTATTTA
    AAAGCCAAAC GTGCCCTGAG CCCTCTCCTC CAAGAGGTCC CCTCAGCATC AAACAGCCCT
    ACCAAGGCAT GCATAGAGCC TTGCACCTCC ACCAAAGGCT CCCTGGATGG CTGTGAAGCC
    AAATCAGGGG CCCTCGCTGA AGCAAGCAGT TCCTATCTGC CCACTGACAG TCAGTACCTG
    TCGCCCAGTA AGCAGCCGAG AGATCCTCCC TTCATGGCTA CTGATCAGAT GGCAAGGGTC
    TTCGCAGATG TGCACTCCAG AGCCAGCCGG GATTCCAGCG AGATGGGAGC TGTGCTGGAG
    CAGATTGACC ACGCCGGCAG GGATCTGGGC AGAGAGTCGG TGGACGCAGA GGAAGTCGTG
    AGAGAGATTG ATAAGCTCTT GCAGGACTGC CGGGGAAATG ATCCCGTGGC TGTGAGAAAG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.