ZNF423 cDNA ORF clone, Loxodonta africana(African savanna elephant)

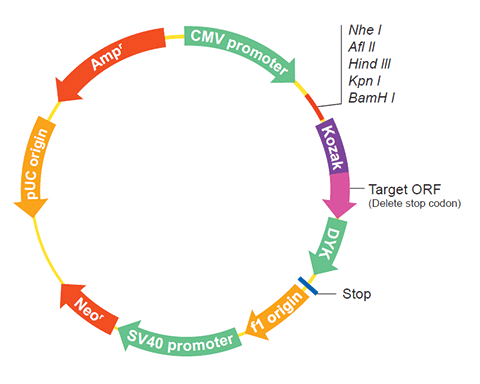
The following ZNF423 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ZNF423 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OLo48098 XM_010596139.2
Latest version!
Loxodonta africana zinc finger protein 423 (ZNF423), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
View Old Accession Versions >>
OLo48098 XM_010596139.1 Loxodonta africana zinc finger protein 423 (ZNF423), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OLo48098
    Clone ID Related Accession (Same CDS sequence) XM_010596139.1 , XM_010596139.2
    Accession Version XM_010596139.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3645bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
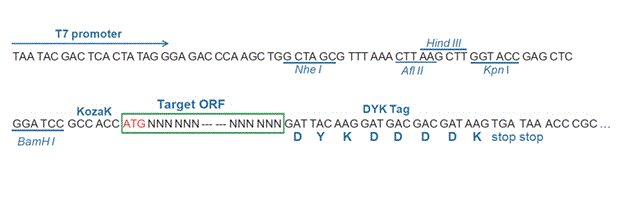
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-12-10
    Organism Loxodonta africana(African savanna elephant)
    Product LOW QUALITY PROTEIN: zinc finger protein 423
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573463.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Loxodonta africana Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGAGGACG AGTCAATTTA CACCTGCGAT CACTGTCAGC AGGACTTCGA GTCTCTGGCA 
    GACCTGACGG ACCACCGGGC CCACCGCTGT CCTGGAGATG GTGATGACGA CCCACAACTC
    TCCTGGGTGG CCTCGTCTCC CTCCAGCAAG GATGTTGCAT CACCCACGCA GATGATCGGC
    GATGGGTGTG ACCTGGGCCT CGGTGAGGAG GAAGGGGGCA CGGGCCTGCC ATACCCTTGC
    CAGTTCTGCG ACAAGTCCTT CATCCGCCTG AGCTACTTGA AGAGGCACGA GCAGATCCAC
    AGTGACAAGC TGCCATTCAA GTGCACCTTC TGCAGCCGCC TCTTCAAACA CAAGAGGAGC
    CGCGACCGGC ACATCAAGCT GCACACGGGT GACAAGAAGT ACCACTGCCA CGAGTGCGAG
    GCGGCCTTCT CCCGCAGCGA CCACCTCAAG ATCCACCTGA AAACTCACAG CTCCAGCAAG
    CCCTTCAAGT GCACCATCTG CAAGCGCGGC TTCTCCTCCA CCAGCTCGCT GCAGAGCCAC
    ATGCAGGCCC ACAAGAAGAA CAAGGAGCAC CTGGCCAAGT CAGAGAAGGA GACCAAGAAG
    GACGACTTCA TGTGCGACTA CTGTGAGGAC ACCTTCAGCC AGACCGAGGA GCTGGAGAAG
    CACGTGCTCA CGCGCCACCC CCAGCTGTCC GAGAAGGCGG ACCTGCAGTG CATCCACTGC
    CCTGAGGTCT TCGTTGACGA GAACACGCTG CTCACCCACA TCCACCAAGC CCACGCCAAC
    AAGAAACACA AGTGCCCCAT GTGCCCCGAG CAGTTTTCCT CAGTGGAGGA GGTCTACTGC
    CACCTGGACA GCCACCGGCA GCCAGACTCC AGCAACCACA GCATCAGCCC TGACCCTGTG
    CTGGGCAGTG TGGCCTCCAT GAGCAGCGCC ACACCTGACT CCAGTGCCTC CGTGGAGCGT
    GGCTCCACCC CAGACTCCAC CTTGAAGCCA CTGCGGGGGC AGAAGAAGAT GCGCGATGAG
    GGGCAGGGCT GGTCCAAGGT TGTCTACAGC TGCCCCTATT GTTCTAAGCG GGACTTCAAC
    AGCCTGGCTG TGCTGGAAAT CCACCTGAAG ACCATCCATG CTGATAAGCC CCAGCAGAGC
    CACACGTGTC AGATCTGCCT GGACTCCATG CCTACCCTCT ACAACCTCAA TGAGCATGTG
    CGCAAGCTGC ACAAGAACCA CGCCTACCCC GTGATACAGT TCGGCAACAT CTCCGCGTTC
    CACTGCAACT ACTGCCCCGA GATGTTTGCT GACATCAACA GCCTGCAGGA GCACATCCGC
    GTCTCCCACT GCGGCCCCAA CGCCCACCCG CCCGATGGCA ACAATGCCTT CTTCTGCAGC
    CAGTGCTCCA TGGGCTTCCT TACCGAGTCC TCCCTCACGG AGCACATCCA GCAGGCCCAC
    TGCAGCGTCG GCGGCACCAA GCTCGAGTCG CCGGTCGTGC AGCCTTCACA GTCCTTCATG
    GAGGTCTATT CCTGCCCCTA CTGCACCAAC TCGCCCATCT TCGGCTCCAT CCTGAAGCTC
    ACCAAGCACA TCAAAGAAAA CCACAAGAAT ATTCCACTGG CCCACAGCAA GAAGTCCAAG
    ACGGAGCAGA GCCCGGTCTC GTCCGACGTG GAGGTGTCTT CCCCGAAGCG GCAGAGGCTC
    TCGGTGAGTG CCAACTCCAT CTCCAACAGC GAGTATCCCT GCAACCAGTG TGACCTCAAG
    TTCTCCAATT TTGAGAGCTT CCAGACCCAC CTGAAGCTGC ACCTGGAGCT GCTCCTGAGG
    AAGCAGGCGT GCCCCCAGTG CAAAGAGGAC TTTGACTCCC AGGAGTCCCT CCTGCAGCAC
    CTGACGGTGC ATTATACAAC CACATCCACC CACTACGTGT GTGAGAGCTG TGACAAGCAG
    TTCTCTTCAG TGGATGACCT GCAGAAGCAC CTGCTGGACA TGCACACCTT CGTGCTGTAC
    CACTGCACCT TGTGCCAGGA GGTCTTCGAC TCCAAGGTGT CCATCCAGGT GCACCTGGCG
    GTGAAGCACA GCAATGAGAA GAAGATGTAC CGCTGCACGG CCTGCAACTG GGACTTCCGC
    AAGGAGGCTG ACCTGCAGGT GCACGTCAAG CACAGCCACC TGGGCAACCC GGCCAAGGCC
    CACAAGTGCA TCTTCTGCGG GGAGACCTTC AGCACTGAGG TGGAACTGCA GTGCCATATC
    ACCACACACA GCAAGAAGTA CAACTGCAAG TTCTGTAGCA AGGCCTTCCA TGCCATCATC
    TTGCTGGAGA AGCACCTGCG GGAGAAGCAC TGTGTGTTTG ATGCGGCCAC CGAGAATGGC
    ACGGCCAACG GGGTGCCCCC TGCCGCCCCC AAGAAGGCCG AGCCAGCTGA CCTACAGGGC
    ATGCTGCTTA AGAACCCTGA GGCGCCCAAC AGCCACGAGG CCAGCGAGGA CGATGTGGAC
    GCGTCAGAGC CCATGTACGG CTGTGACATC TGTGGGGCGG CCTACACCAT GGAGGTGCTG
    CTGCAGAATC ACCGGCTCCG AGACCACAAC ATCCGGCCGG GCGAGGACGA CGGCTCCCGC
    AAGAAGGCCG AGTTCATCAA GGGCAGCCAC AAGTGCAACA TTTGCTCGCG GACTTTCTTC
    TCGGAGAACG GTCTCCGGGA GCACCTGCAG ACGCACCGGG GCCCTGCCAA GCACTACATG
    TGCCCAATCT GTGGCGAGCG CTTCCCCTCA TTGCTGACGC TCACGGAGCA CAAGGTGACC
    CACAGCAAGA GCCTGGACAC GGGCACCTGC CGCATCTGCA AGATGCCCCT GCAGAGCGAG
    GAGGATTTCA TCGAGCACTG CCAGATGCAC CCCGATCTGC GCAACTCACT CACAGGCTTC
    CGCTGCGTGG TCTGCATGCA GACAGTCACC TCAACGCTCG AGCTCAAGAT CCACGGCACC
    TTCCACATGC AGAAGCTGGC AGGCAGCTCA GCTGCATCCT CCCCCAACGG CCAGGGGCTG
    CAGAAGCTCT ACAAGTGTGC CCTGTGCCTC AAGGAGTGCC GCAGCAAGCA GGACCTGGTG
    AAGCTGGACG TCAACGGGCT GCCCTACGGC CTCTGCGCCA GCTGCATGGC CCGCAGTGCT
    AACGGACAGG TGGGTGGCCT GGCCCCACCC GAGCCCGCAG ACCGGCCCTG CGCTGGCCTC
    CGCTGCCCTG AGTGCAGCGT CAAGTTTGAG AGTGCTGAGG ACCTGGAGAG CCACATGCAG
    GGCGACCACC GCGACCTCAC CCCAGAGGCC AGTGGGCCCC GAAAAGGTGC CCAGACTTCG
    CCAGTGCCCC GGAAAAAGAC ATACCAGTGC ATCAAGTGCC AGATGACGTT TGAGAATGAG
    AGAGAGATCC AAATCCATGT TGCCAACCAC ATGATTGAGG AAGGCATCAA CCACGAGTGT
    AAGCTGTGCA ACCAGACATT TGACTCCCCA GCCAAGCTCC TCTGCCACNC TACCTTCAAA
    TGCCCTGTGT GCTTCACAGT CTTTGTCCAG GCCAACAAGC TGCAGCAGCA CATCTTTGCT
    GTGCACGGGC AGGAGGATAA GATCTACGAC TGCTCGCAAT GCCCGCAGAA GTTCTTCTTC
    CAGACGGAGC TGCAGAACCA CACCATGAGC CAGCACGCAC AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_010594441.1
    CDS152..3796
    Translation

    Target ORF information:

    RefSeq Version XM_010596139.1
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 423 (ZNF423), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010596139.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGAGGACG AGTCAATTTA CACCTGCGAT CACTGTCAGC AGGACTTCGA GTCTCTGGCA 
    GACCTGACGG ACCACCGGGC CCACCGCTGT CCTGGAGATG GTGATGACGA CCCACAACTC
    TCCTGGGTGG CCTCGTCTCC CTCCAGCAAG GATGTTGCAT CACCCACGCA GATGATCGGC
    GATGGGTGTG ACCTGGGCCT CGGTGAGGAG GAAGGGGGCA CGGGCCTGCC ATACCCTTGC
    CAGTTCTGCG ACAAGTCCTT CATCCGCCTG AGCTACTTGA AGAGGCACGA GCAGATCCAC
    AGTGACAAGC TGCCATTCAA GTGCACCTTC TGCAGCCGCC TCTTCAAACA CAAGAGGAGC
    CGCGACCGGC ACATCAAGCT GCACACGGGT GACAAGAAGT ACCACTGCCA CGAGTGCGAG
    GCGGCCTTCT CCCGCAGCGA CCACCTCAAG ATCCACCTGA AAACTCACAG CTCCAGCAAG
    CCCTTCAAGT GCACCATCTG CAAGCGCGGC TTCTCCTCCA CCAGCTCGCT GCAGAGCCAC
    ATGCAGGCCC ACAAGAAGAA CAAGGAGCAC CTGGCCAAGT CAGAGAAGGA GACCAAGAAG
    GACGACTTCA TGTGCGACTA CTGTGAGGAC ACCTTCAGCC AGACCGAGGA GCTGGAGAAG
    CACGTGCTCA CGCGCCACCC CCAGCTGTCC GAGAAGGCGG ACCTGCAGTG CATCCACTGC
    CCTGAGGTCT TCGTTGACGA GAACACGCTG CTCACCCACA TCCACCAAGC CCACGCCAAC
    AAGAAACACA AGTGCCCCAT GTGCCCCGAG CAGTTTTCCT CAGTGGAGGA GGTCTACTGC
    CACCTGGACA GCCACCGGCA GCCAGACTCC AGCAACCACA GCATCAGCCC TGACCCTGTG
    CTGGGCAGTG TGGCCTCCAT GAGCAGCGCC ACACCTGACT CCAGTGCCTC CGTGGAGCGT
    GGCTCCACCC CAGACTCCAC CTTGAAGCCA CTGCGGGGGC AGAAGAAGAT GCGCGATGAG
    GGGCAGGGCT GGTCCAAGGT TGTCTACAGC TGCCCCTATT GTTCTAAGCG GGACTTCAAC
    AGCCTGGCTG TGCTGGAAAT CCACCTGAAG ACCATCCATG CTGATAAGCC CCAGCAGAGC
    CACACGTGTC AGATCTGCCT GGACTCCATG CCTACCCTCT ACAACCTCAA TGAGCATGTG
    CGCAAGCTGC ACAAGAACCA CGCCTACCCC GTGATACAGT TCGGCAACAT CTCCGCGTTC
    CACTGCAACT ACTGCCCCGA GATGTTTGCT GACATCAACA GCCTGCAGGA GCACATCCGC
    GTCTCCCACT GCGGCCCCAA CGCCCACCCG CCCGATGGCA ACAATGCCTT CTTCTGCAGC
    CAGTGCTCCA TGGGCTTCCT TACCGAGTCC TCCCTCACGG AGCACATCCA GCAGGCCCAC
    TGCAGCGTCG GCGGCACCAA GCTCGAGTCG CCGGTCGTGC AGCCTTCACA GTCCTTCATG
    GAGGTCTATT CCTGCCCCTA CTGCACCAAC TCGCCCATCT TCGGCTCCAT CCTGAAGCTC
    ACCAAGCACA TCAAAGAAAA CCACAAGAAT ATTCCACTGG CCCACAGCAA GAAGTCCAAG
    ACGGAGCAGA GCCCGGTCTC GTCCGACGTG GAGGTGTCTT CCCCGAAGCG GCAGAGGCTC
    TCGGTGAGTG CCAACTCCAT CTCCAACAGC GAGTATCCCT GCAACCAGTG TGACCTCAAG
    TTCTCCAATT TTGAGAGCTT CCAGACCCAC CTGAAGCTGC ACCTGGAGCT GCTCCTGAGG
    AAGCAGGCGT GCCCCCAGTG CAAAGAGGAC TTTGACTCCC AGGAGTCCCT CCTGCAGCAC
    CTGACGGTGC ATTATACAAC CACATCCACC CACTACGTGT GTGAGAGCTG TGACAAGCAG
    TTCTCTTCAG TGGATGACCT GCAGAAGCAC CTGCTGGACA TGCACACCTT CGTGCTGTAC
    CACTGCACCT TGTGCCAGGA GGTCTTCGAC TCCAAGGTGT CCATCCAGGT GCACCTGGCG
    GTGAAGCACA GCAATGAGAA GAAGATGTAC CGCTGCACGG CCTGCAACTG GGACTTCCGC
    AAGGAGGCTG ACCTGCAGGT GCACGTCAAG CACAGCCACC TGGGCAACCC GGCCAAGGCC
    CACAAGTGCA TCTTCTGCGG GGAGACCTTC AGCACTGAGG TGGAACTGCA GTGCCATATC
    ACCACACACA GCAAGAAGTA CAACTGCAAG TTCTGTAGCA AGGCCTTCCA TGCCATCATC
    TTGCTGGAGA AGCACCTGCG GGAGAAGCAC TGTGTGTTTG ATGCGGCCAC CGAGAATGGC
    ACGGCCAACG GGGTGCCCCC TGCCGCCCCC AAGAAGGCCG AGCCAGCTGA CCTACAGGGC
    ATGCTGCTTA AGAACCCTGA GGCGCCCAAC AGCCACGAGG CCAGCGAGGA CGATGTGGAC
    GCGTCAGAGC CCATGTACGG CTGTGACATC TGTGGGGCGG CCTACACCAT GGAGGTGCTG
    CTGCAGAATC ACCGGCTCCG AGACCACAAC ATCCGGCCGG GCGAGGACGA CGGCTCCCGC
    AAGAAGGCCG AGTTCATCAA GGGCAGCCAC AAGTGCAACA TTTGCTCGCG GACTTTCTTC
    TCGGAGAACG GTCTCCGGGA GCACCTGCAG ACGCACCGGG GCCCTGCCAA GCACTACATG
    TGCCCAATCT GTGGCGAGCG CTTCCCCTCA TTGCTGACGC TCACGGAGCA CAAGGTGACC
    CACAGCAAGA GCCTGGACAC GGGCACCTGC CGCATCTGCA AGATGCCCCT GCAGAGCGAG
    GAGGATTTCA TCGAGCACTG CCAGATGCAC CCCGATCTGC GCAACTCACT CACAGGCTTC
    CGCTGCGTGG TCTGCATGCA GACAGTCACC TCAACGCTCG AGCTCAAGAT CCACGGCACC
    TTCCACATGC AGAAGCTGGC AGGCAGCTCA GCTGCATCCT CCCCCAACGG CCAGGGGCTG
    CAGAAGCTCT ACAAGTGTGC CCTGTGCCTC AAGGAGTGCC GCAGCAAGCA GGACCTGGTG
    AAGCTGGACG TCAACGGGCT GCCCTACGGC CTCTGCGCCA GCTGCATGGC CCGCAGTGCT
    AACGGACAGG TGGGTGGCCT GGCCCCACCC GAGCCCGCAG ACCGGCCCTG CGCTGGCCTC
    CGCTGCCCTG AGTGCAGCGT CAAGTTTGAG AGTGCTGAGG ACCTGGAGAG CCACATGCAG
    GGCGACCACC GCGACCTCAC CCCAGAGGCC AGTGGGCCCC GAAAAGGTGC CCAGACTTCG
    CCAGTGCCCC GGAAAAAGAC ATACCAGTGC ATCAAGTGCC AGATGACGTT TGAGAATGAG
    AGAGAGATCC AAATCCATGT TGCCAACCAC ATGATTGAGG AAGGCATCAA CCACGAGTGT
    AAGCTGTGCA ACCAGACATT TGACTCCCCA GCCAAGCTCC TCTGCCACNC TACCTTCAAA
    TGCCCTGTGT GCTTCACAGT CTTTGTCCAG GCCAACAAGC TGCAGCAGCA CATCTTTGCT
    GTGCACGGGC AGGAGGATAA GATCTACGAC TGCTCGCAAT GCCCGCAGAA GTTCTTCTTC
    CAGACGGAGC TGCAGAACCA CACCATGAGC CAGCACGCAC AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OLo48098
    Clone ID Related Accession (Same CDS sequence) XM_010596139.1 , XM_010596139.2
    Accession Version XM_010596139.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3645bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-01-15
    Organism Loxodonta africana(African savanna elephant)
    Product LOW QUALITY PROTEIN: zinc finger protein 423
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573463.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jan 16, 2018 this sequence version replaced XM_010596139.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Loxodonta africana Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGAGGACG AGTCAATTTA CACCTGCGAT CACTGTCAGC AGGACTTCGA GTCTCTGGCA 
    GACCTGACGG ACCACCGGGC CCACCGCTGT CCTGGAGATG GTGATGACGA CCCACAACTC
    TCCTGGGTGG CCTCGTCTCC CTCCAGCAAG GATGTTGCAT CACCCACGCA GATGATCGGC
    GATGGGTGTG ACCTGGGCCT CGGTGAGGAG GAAGGGGGCA CGGGCCTGCC ATACCCTTGC
    CAGTTCTGCG ACAAGTCCTT CATCCGCCTG AGCTACTTGA AGAGGCACGA GCAGATCCAC
    AGTGACAAGC TGCCATTCAA GTGCACCTTC TGCAGCCGCC TCTTCAAACA CAAGAGGAGC
    CGCGACCGGC ACATCAAGCT GCACACGGGT GACAAGAAGT ACCACTGCCA CGAGTGCGAG
    GCGGCCTTCT CCCGCAGCGA CCACCTCAAG ATCCACCTGA AAACTCACAG CTCCAGCAAG
    CCCTTCAAGT GCACCATCTG CAAGCGCGGC TTCTCCTCCA CCAGCTCGCT GCAGAGCCAC
    ATGCAGGCCC ACAAGAAGAA CAAGGAGCAC CTGGCCAAGT CAGAGAAGGA GACCAAGAAG
    GACGACTTCA TGTGCGACTA CTGTGAGGAC ACCTTCAGCC AGACCGAGGA GCTGGAGAAG
    CACGTGCTCA CGCGCCACCC CCAGCTGTCC GAGAAGGCGG ACCTGCAGTG CATCCACTGC
    CCTGAGGTCT TCGTTGACGA GAACACGCTG CTCACCCACA TCCACCAAGC CCACGCCAAC
    AAGAAACACA AGTGCCCCAT GTGCCCCGAG CAGTTTTCCT CAGTGGAGGA GGTCTACTGC
    CACCTGGACA GCCACCGGCA GCCAGACTCC AGCAACCACA GCATCAGCCC TGACCCTGTG
    CTGGGCAGTG TGGCCTCCAT GAGCAGCGCC ACACCTGACT CCAGTGCCTC CGTGGAGCGT
    GGCTCCACCC CAGACTCCAC CTTGAAGCCA CTGCGGGGGC AGAAGAAGAT GCGCGATGAG
    GGGCAGGGCT GGTCCAAGGT TGTCTACAGC TGCCCCTATT GTTCTAAGCG GGACTTCAAC
    AGCCTGGCTG TGCTGGAAAT CCACCTGAAG ACCATCCATG CTGATAAGCC CCAGCAGAGC
    CACACGTGTC AGATCTGCCT GGACTCCATG CCTACCCTCT ACAACCTCAA TGAGCATGTG
    CGCAAGCTGC ACAAGAACCA CGCCTACCCC GTGATACAGT TCGGCAACAT CTCCGCGTTC
    CACTGCAACT ACTGCCCCGA GATGTTTGCT GACATCAACA GCCTGCAGGA GCACATCCGC
    GTCTCCCACT GCGGCCCCAA CGCCCACCCG CCCGATGGCA ACAATGCCTT CTTCTGCAGC
    CAGTGCTCCA TGGGCTTCCT TACCGAGTCC TCCCTCACGG AGCACATCCA GCAGGCCCAC
    TGCAGCGTCG GCGGCACCAA GCTCGAGTCG CCGGTCGTGC AGCCTTCACA GTCCTTCATG
    GAGGTCTATT CCTGCCCCTA CTGCACCAAC TCGCCCATCT TCGGCTCCAT CCTGAAGCTC
    ACCAAGCACA TCAAAGAAAA CCACAAGAAT ATTCCACTGG CCCACAGCAA GAAGTCCAAG
    ACGGAGCAGA GCCCGGTCTC GTCCGACGTG GAGGTGTCTT CCCCGAAGCG GCAGAGGCTC
    TCGGTGAGTG CCAACTCCAT CTCCAACAGC GAGTATCCCT GCAACCAGTG TGACCTCAAG
    TTCTCCAATT TTGAGAGCTT CCAGACCCAC CTGAAGCTGC ACCTGGAGCT GCTCCTGAGG
    AAGCAGGCGT GCCCCCAGTG CAAAGAGGAC TTTGACTCCC AGGAGTCCCT CCTGCAGCAC
    CTGACGGTGC ATTATACAAC CACATCCACC CACTACGTGT GTGAGAGCTG TGACAAGCAG
    TTCTCTTCAG TGGATGACCT GCAGAAGCAC CTGCTGGACA TGCACACCTT CGTGCTGTAC
    CACTGCACCT TGTGCCAGGA GGTCTTCGAC TCCAAGGTGT CCATCCAGGT GCACCTGGCG
    GTGAAGCACA GCAATGAGAA GAAGATGTAC CGCTGCACGG CCTGCAACTG GGACTTCCGC
    AAGGAGGCTG ACCTGCAGGT GCACGTCAAG CACAGCCACC TGGGCAACCC GGCCAAGGCC
    CACAAGTGCA TCTTCTGCGG GGAGACCTTC AGCACTGAGG TGGAACTGCA GTGCCATATC
    ACCACACACA GCAAGAAGTA CAACTGCAAG TTCTGTAGCA AGGCCTTCCA TGCCATCATC
    TTGCTGGAGA AGCACCTGCG GGAGAAGCAC TGTGTGTTTG ATGCGGCCAC CGAGAATGGC
    ACGGCCAACG GGGTGCCCCC TGCCGCCCCC AAGAAGGCCG AGCCAGCTGA CCTACAGGGC
    ATGCTGCTTA AGAACCCTGA GGCGCCCAAC AGCCACGAGG CCAGCGAGGA CGATGTGGAC
    GCGTCAGAGC CCATGTACGG CTGTGACATC TGTGGGGCGG CCTACACCAT GGAGGTGCTG
    CTGCAGAATC ACCGGCTCCG AGACCACAAC ATCCGGCCGG GCGAGGACGA CGGCTCCCGC
    AAGAAGGCCG AGTTCATCAA GGGCAGCCAC AAGTGCAACA TTTGCTCGCG GACTTTCTTC
    TCGGAGAACG GTCTCCGGGA GCACCTGCAG ACGCACCGGG GCCCTGCCAA GCACTACATG
    TGCCCAATCT GTGGCGAGCG CTTCCCCTCA TTGCTGACGC TCACGGAGCA CAAGGTGACC
    CACAGCAAGA GCCTGGACAC GGGCACCTGC CGCATCTGCA AGATGCCCCT GCAGAGCGAG
    GAGGATTTCA TCGAGCACTG CCAGATGCAC CCCGATCTGC GCAACTCACT CACAGGCTTC
    CGCTGCGTGG TCTGCATGCA GACAGTCACC TCAACGCTCG AGCTCAAGAT CCACGGCACC
    TTCCACATGC AGAAGCTGGC AGGCAGCTCA GCTGCATCCT CCCCCAACGG CCAGGGGCTG
    CAGAAGCTCT ACAAGTGTGC CCTGTGCCTC AAGGAGTGCC GCAGCAAGCA GGACCTGGTG
    AAGCTGGACG TCAACGGGCT GCCCTACGGC CTCTGCGCCA GCTGCATGGC CCGCAGTGCT
    AACGGACAGG TGGGTGGCCT GGCCCCACCC GAGCCCGCAG ACCGGCCCTG CGCTGGCCTC
    CGCTGCCCTG AGTGCAGCGT CAAGTTTGAG AGTGCTGAGG ACCTGGAGAG CCACATGCAG
    GGCGACCACC GCGACCTCAC CCCAGAGGCC AGTGGGCCCC GAAAAGGTGC CCAGACTTCG
    CCAGTGCCCC GGAAAAAGAC ATACCAGTGC ATCAAGTGCC AGATGACGTT TGAGAATGAG
    AGAGAGATCC AAATCCATGT TGCCAACCAC ATGATTGAGG AAGGCATCAA CCACGAGTGT
    AAGCTGTGCA ACCAGACATT TGACTCCCCA GCCAAGCTCC TCTGCCACNC TACCTTCAAA
    TGCCCTGTGT GCTTCACAGT CTTTGTCCAG GCCAACAAGC TGCAGCAGCA CATCTTTGCT
    GTGCACGGGC AGGAGGATAA GATCTACGAC TGCTCGCAAT GCCCGCAGAA GTTCTTCTTC
    CAGACGGAGC TGCAGAACCA CACCATGAGC CAGCACGCAC AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_010594441.1
    CDS252..3896
    Translation

    Target ORF information:

    RefSeq Version XM_010596139.2
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 423 (ZNF423), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010596139.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGAGGACG AGTCAATTTA CACCTGCGAT CACTGTCAGC AGGACTTCGA GTCTCTGGCA 
    GACCTGACGG ACCACCGGGC CCACCGCTGT CCTGGAGATG GTGATGACGA CCCACAACTC
    TCCTGGGTGG CCTCGTCTCC CTCCAGCAAG GATGTTGCAT CACCCACGCA GATGATCGGC
    GATGGGTGTG ACCTGGGCCT CGGTGAGGAG GAAGGGGGCA CGGGCCTGCC ATACCCTTGC
    CAGTTCTGCG ACAAGTCCTT CATCCGCCTG AGCTACTTGA AGAGGCACGA GCAGATCCAC
    AGTGACAAGC TGCCATTCAA GTGCACCTTC TGCAGCCGCC TCTTCAAACA CAAGAGGAGC
    CGCGACCGGC ACATCAAGCT GCACACGGGT GACAAGAAGT ACCACTGCCA CGAGTGCGAG
    GCGGCCTTCT CCCGCAGCGA CCACCTCAAG ATCCACCTGA AAACTCACAG CTCCAGCAAG
    CCCTTCAAGT GCACCATCTG CAAGCGCGGC TTCTCCTCCA CCAGCTCGCT GCAGAGCCAC
    ATGCAGGCCC ACAAGAAGAA CAAGGAGCAC CTGGCCAAGT CAGAGAAGGA GACCAAGAAG
    GACGACTTCA TGTGCGACTA CTGTGAGGAC ACCTTCAGCC AGACCGAGGA GCTGGAGAAG
    CACGTGCTCA CGCGCCACCC CCAGCTGTCC GAGAAGGCGG ACCTGCAGTG CATCCACTGC
    CCTGAGGTCT TCGTTGACGA GAACACGCTG CTCACCCACA TCCACCAAGC CCACGCCAAC
    AAGAAACACA AGTGCCCCAT GTGCCCCGAG CAGTTTTCCT CAGTGGAGGA GGTCTACTGC
    CACCTGGACA GCCACCGGCA GCCAGACTCC AGCAACCACA GCATCAGCCC TGACCCTGTG
    CTGGGCAGTG TGGCCTCCAT GAGCAGCGCC ACACCTGACT CCAGTGCCTC CGTGGAGCGT
    GGCTCCACCC CAGACTCCAC CTTGAAGCCA CTGCGGGGGC AGAAGAAGAT GCGCGATGAG
    GGGCAGGGCT GGTCCAAGGT TGTCTACAGC TGCCCCTATT GTTCTAAGCG GGACTTCAAC
    AGCCTGGCTG TGCTGGAAAT CCACCTGAAG ACCATCCATG CTGATAAGCC CCAGCAGAGC
    CACACGTGTC AGATCTGCCT GGACTCCATG CCTACCCTCT ACAACCTCAA TGAGCATGTG
    CGCAAGCTGC ACAAGAACCA CGCCTACCCC GTGATACAGT TCGGCAACAT CTCCGCGTTC
    CACTGCAACT ACTGCCCCGA GATGTTTGCT GACATCAACA GCCTGCAGGA GCACATCCGC
    GTCTCCCACT GCGGCCCCAA CGCCCACCCG CCCGATGGCA ACAATGCCTT CTTCTGCAGC
    CAGTGCTCCA TGGGCTTCCT TACCGAGTCC TCCCTCACGG AGCACATCCA GCAGGCCCAC
    TGCAGCGTCG GCGGCACCAA GCTCGAGTCG CCGGTCGTGC AGCCTTCACA GTCCTTCATG
    GAGGTCTATT CCTGCCCCTA CTGCACCAAC TCGCCCATCT TCGGCTCCAT CCTGAAGCTC
    ACCAAGCACA TCAAAGAAAA CCACAAGAAT ATTCCACTGG CCCACAGCAA GAAGTCCAAG
    ACGGAGCAGA GCCCGGTCTC GTCCGACGTG GAGGTGTCTT CCCCGAAGCG GCAGAGGCTC
    TCGGTGAGTG CCAACTCCAT CTCCAACAGC GAGTATCCCT GCAACCAGTG TGACCTCAAG
    TTCTCCAATT TTGAGAGCTT CCAGACCCAC CTGAAGCTGC ACCTGGAGCT GCTCCTGAGG
    AAGCAGGCGT GCCCCCAGTG CAAAGAGGAC TTTGACTCCC AGGAGTCCCT CCTGCAGCAC
    CTGACGGTGC ATTATACAAC CACATCCACC CACTACGTGT GTGAGAGCTG TGACAAGCAG
    TTCTCTTCAG TGGATGACCT GCAGAAGCAC CTGCTGGACA TGCACACCTT CGTGCTGTAC
    CACTGCACCT TGTGCCAGGA GGTCTTCGAC TCCAAGGTGT CCATCCAGGT GCACCTGGCG
    GTGAAGCACA GCAATGAGAA GAAGATGTAC CGCTGCACGG CCTGCAACTG GGACTTCCGC
    AAGGAGGCTG ACCTGCAGGT GCACGTCAAG CACAGCCACC TGGGCAACCC GGCCAAGGCC
    CACAAGTGCA TCTTCTGCGG GGAGACCTTC AGCACTGAGG TGGAACTGCA GTGCCATATC
    ACCACACACA GCAAGAAGTA CAACTGCAAG TTCTGTAGCA AGGCCTTCCA TGCCATCATC
    TTGCTGGAGA AGCACCTGCG GGAGAAGCAC TGTGTGTTTG ATGCGGCCAC CGAGAATGGC
    ACGGCCAACG GGGTGCCCCC TGCCGCCCCC AAGAAGGCCG AGCCAGCTGA CCTACAGGGC
    ATGCTGCTTA AGAACCCTGA GGCGCCCAAC AGCCACGAGG CCAGCGAGGA CGATGTGGAC
    GCGTCAGAGC CCATGTACGG CTGTGACATC TGTGGGGCGG CCTACACCAT GGAGGTGCTG
    CTGCAGAATC ACCGGCTCCG AGACCACAAC ATCCGGCCGG GCGAGGACGA CGGCTCCCGC
    AAGAAGGCCG AGTTCATCAA GGGCAGCCAC AAGTGCAACA TTTGCTCGCG GACTTTCTTC
    TCGGAGAACG GTCTCCGGGA GCACCTGCAG ACGCACCGGG GCCCTGCCAA GCACTACATG
    TGCCCAATCT GTGGCGAGCG CTTCCCCTCA TTGCTGACGC TCACGGAGCA CAAGGTGACC
    CACAGCAAGA GCCTGGACAC GGGCACCTGC CGCATCTGCA AGATGCCCCT GCAGAGCGAG
    GAGGATTTCA TCGAGCACTG CCAGATGCAC CCCGATCTGC GCAACTCACT CACAGGCTTC
    CGCTGCGTGG TCTGCATGCA GACAGTCACC TCAACGCTCG AGCTCAAGAT CCACGGCACC
    TTCCACATGC AGAAGCTGGC AGGCAGCTCA GCTGCATCCT CCCCCAACGG CCAGGGGCTG
    CAGAAGCTCT ACAAGTGTGC CCTGTGCCTC AAGGAGTGCC GCAGCAAGCA GGACCTGGTG
    AAGCTGGACG TCAACGGGCT GCCCTACGGC CTCTGCGCCA GCTGCATGGC CCGCAGTGCT
    AACGGACAGG TGGGTGGCCT GGCCCCACCC GAGCCCGCAG ACCGGCCCTG CGCTGGCCTC
    CGCTGCCCTG AGTGCAGCGT CAAGTTTGAG AGTGCTGAGG ACCTGGAGAG CCACATGCAG
    GGCGACCACC GCGACCTCAC CCCAGAGGCC AGTGGGCCCC GAAAAGGTGC CCAGACTTCG
    CCAGTGCCCC GGAAAAAGAC ATACCAGTGC ATCAAGTGCC AGATGACGTT TGAGAATGAG
    AGAGAGATCC AAATCCATGT TGCCAACCAC ATGATTGAGG AAGGCATCAA CCACGAGTGT
    AAGCTGTGCA ACCAGACATT TGACTCCCCA GCCAAGCTCC TCTGCCACNC TACCTTCAAA
    TGCCCTGTGT GCTTCACAGT CTTTGTCCAG GCCAACAAGC TGCAGCAGCA CATCTTTGCT
    GTGCACGGGC AGGAGGATAA GATCTACGAC TGCTCGCAAT GCCCGCAGAA GTTCTTCTTC
    CAGACGGAGC TGCAGAACCA CACCATGAGC CAGCACGCAC AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.