LOC102360717 cDNA ORF clone, Latimeria chalumnae(coelacanth)

The following LOC102360717 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC102360717 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OLa42543 XM_014497990.1
Latest version!
Latimeria chalumnae chromosome unknown open reading frame, human C11orf30 (LOC102360717), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OLa42543
    Clone ID Related Accession (Same CDS sequence) XM_014497990.1
    Accession Version XM_014497990.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3687bp)
    Protein sequence
    SNP
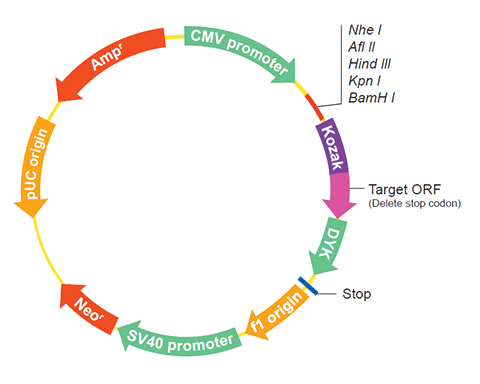
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
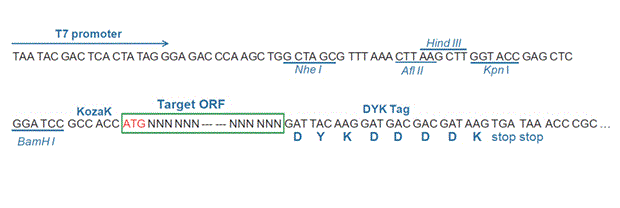
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-10-25
    Organism Latimeria chalumnae(coelacanth)
    Product protein EMSY
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005821750.1) and transcript sequence (GAAA01009436.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Latimeria chalumnae Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases assembly gap :: added 213 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGTCGGGCC CTAACAGTTC ATCAGAATGG TCGATTGAAG GTCGCAGGTT GGTCCCATTG 
    ATGCCAAGGT TGGTGCCACA GACAGCGTTC ACAGTGACGG CAAATGCTGT TGCAAATGCA
    GCAGTTCAGC ACAACGCATC ACTTCCTTCA CCTGCGGAAA CAGGAAATAA AGAAGTGGTG
    GTTTGCTATT CTTACACCAG TACGACTTCC ACACCTACTT CTACCACAGT CCCGAGTGGT
    AGTGTAGCAA CAGTGAAATC TCCCAGACCT GCCAGTCCTG CCTCAAACGT TGTCGTCTTA
    CCCAGTGGCA GCACCGTTTA TGTCAAGAGT GTCAGCTGTT CGGACGAAGA TGAAAAACCT
    CGCAAGCGGA GGCGCACCAA CTCCTCCAGT TCCTCCCCAG TTGTCACGAG GGAGGTCCCC
    AAGGCAGTCA CCCCTGTCTC GAAAACCATC ACCGTTCCTG TCACGAGCAG CTCCAAGATG
    AGCAACATCA TGCAAAGCAT TGCCAACTCC TTGCCTCCGC ACATGTCTCC CGTGAAAATC
    ACTTTCACAA AACCGTCAAC CCAGACGACG AATACAACAA CGCAAAAGGT GATTATAGTA
    ACAACCTCTC CCAGCTCAAC TTTTGTACCA AACATTCTGT CCAAGTCCCA TAATTATGCA
    GCGGTCACCA AACTGGTCCC CACATCGGTC ATTACATCGA CGACACAGAA GCAGCCGATG
    GTCATCACAG CCTCTCAGTC GTCCTTAGTG GCTGCCGCCG CCGCCGCCGC CAGCAGTAGT
    TCTACCCTGT CTTCAGGTCC CAGCACTGTT GCTGTAACAT CGGTGGTTTC TTCCACACCT
    TCAGTCGTCA TGTCAGCAGT AGCACAAGGA GCGTCTTCAA CAGCAGTCAA AGTTTCATCA
    GCCCGGCTTC CTTCGCCTAA AACTCTGGTG GGCTCTCCAA CCCAGATCCT GGCTCAGTTC
    CCCAAGCAGC ACCAACAGTC TGCCAAGCAG CAGACGCAGT CACCCCTGCA GCAACAGACA
    CAGGGCACCC TGTCTTCTCA GGCCGCTCAG CAGCATATTC AACAGTCCCA GACGCCGTCT
    GGGGTTAAAC CTACAATTCA GATCAAACAG GAGTCTGGAG TGAAGATAAT CACACAACAA
    ATGCAGCCCA GTAAAATCCT CCCTAAACCA GCAACCGCTA CCATGCAGAG CAGCAGCAGT
    TCCCCCATCA TGGTGGTTAG CAGTAACGGT GCCATCATGA CAACTAAACT GGTCACTACA
    CCCTCAGACA AAATTGATAT GTTGAACCCT AATTTTGTTG CAGGTACCAC CACAAAAATA
    ACCACCATCC CAATGACTTC CAAACCCAAC GTGATAGTCG TACAAAAGGC TACAGGGAAA
    GGGGCAACTT TCCAGGGGCT CCCAGGCAAA AACGTTGTCA CAACATTGTT AAATGCAGGG
    GGCGAAAAGA CAATTCAGGC AATGCCAGCA GGTACGAAAC CAGCCATCAT CACGGCCACG
    AGACCCATCA CTAAAATGAT AGTCACGCAG CCAAAGGGAA TGGGGGCAAC GGTTCAGCCG
    ACAACCAAAA TCATCCCCAC GAAGATTGTC TATGGACAGC AAGGAAAGAC GCAGGTCCTA
    ATAAAGCCCA AACCTGTGAC CTTCCAGGCC GCCATGGTGA GCGAGCATAC CAGACAGTTG
    GTCACCGAGA CACTTCAGCA GGCATCCAGG GTGGCCGAGG GGAACAGCTC TGCTGTTCAG
    GAAGGGGTCG TGAAAGAGGA ATCTCACACC TACATTGACA GCAGCTCCTC CTCCATTGAG
    TCCTCTCAAA GTTCACAAGT TGCAGAGTCC CAGTCTGTGG TTCACGTGAT CACAACCAGA
    AGCCAGGATT GGACAGACCA TGAGGTTTCC ATGGAGTCCA GCCCCACTAT AATTTACCAG
    GAAGCAACCA GTGAATCTCA GTCCGCTACT TCCACCATTA AAGCCTTACT AGAGCTTCAG
    CAAACAACAG TTAAAGAGAA GATGGATGCA AAACCTAGGC AGCACACTAT TGACCTAAGT
    CAGATGGCCG TTCCTATCCA AATGACACAT GAAAAGAGGC AGTCTCCCGA AAACCCTGCT
    ATAACTGTAG TCGAATCAGA TCTCGTTACA GAGTATATCA GCACTGTCAA AACTGCCAAG
    CCTGGCACTT CCACTTCCAG CATGAGTCCT GGCGAAGTGG CACTGACGTC CCTGCTGTCC
    GCCAGTCACC AGCAGCTGCA GTCCCAGCCC CAGCGCACTT TGGTACAGCA GCAGGTGGTT
    CAAGCGCAGA CTACGTCACA GGCGCCGGTA TTAGTGAAGT CAATCCCGGT GTCTTCCACA
    GGCACAGTCA CCCACATCAT GCAGCAGGTT GTAAGCAGTC ATATAACCTC AGCCAAACAG
    ATGGAAGATC TGGGAACTGA AGAGGGAGAG GTGGAAGAAA TGGATACGTT AGACCCCCAG
    ACTGGTCTGT TTTACAGGTC TGCTCAAACT CTGCTGCAGA AGCCACAAAA GCAAAGCCAG
    CTGTCTGCGG ACCAGTCTTG CGTGCAAGCT CACATGCAGC AGCAGCCGCC CATGAAGCAG
    CAGCTGAAGC AGGCCACAAC CCTGGAACAG CTGCAGGCGC AGCACAGGCT CCAGCAAGCA
    GCCCATCAGC TCTATACCAA GCAACTGCAA AAGCAGACGG CTGTGGTACA GCGGGACCAG
    GAGCAGCCGA GAGCGCCTTT ACAGCAACAG CAGCCGCCGC CGCAGATTGT GGCAAAAGAG
    AGACTGGTAT CTTCGGCTGT GACGCAGCCA CAGCAGACCG TTGTGCAGGT GCTGGCGGTG
    AAAGCCCCCC AGCAGCAGCT TCCCAAACTC CAGCAAATGC CCGTCCAGCA GAGAGTGCAA
    ACGCAGTCCC AGCCCATGTA CACTTTCTCC AAGCAGCCTG CCTCTTCAGA GAAACTGTCA
    GCAGGACAGG TGCAGCTTCC AATTATAACT CAAGGCGGAA CAGTTACAAA GATAACATTT
    GATAGCCACC AGGCTCCCAC CATCTCCAAG TCAGCCAGCA GCGACTCTGG GACAAAATCG
    GCAGCACTGG CCACAAGCGT ACTCCCAGCA CAGCCGTCTG AAAAACCTGG GGTGGCGGAC
    ATTGTGAAAA TCTCCATGAT GGAAGCTCAG ATTGAAACAA ACATAGAGCC CATGGCTGTG
    GATTCACCCA GTGAAAGAAC TAAAGTTGCA AAAGCTGCAG CCACAGTGGT ATCAGCCCCT
    CCGAGCCAGC CACAGCAGCG TAAAGAACCC CCGGGGAACC CCCCTGCTCC TGCTCCACCC
    CCACTCCCAG CAGCAGCAGC AGCGGCATCT TCATCGGTGG TGGTGGCGGC GGCATCATCC
    TCATCGGTTC CCTCCTCTAC ACCAGAAAAA AGTGAAGCCC TGGCAGTGCC TGTGACCAGC
    CAGTTCATCC ACATTCAGAA CCTGACGCAA AAGAAAACTG AAGAGATACC GGCCGATATT
    CTCATCCAGA CTATCCCCCA GTATTCCATC CCCTGCCACT CCAGTTCCAA TGTGGTGGTG
    GAGCCCAGTG GGCTCTTGGA GATCAATAAC TTCACCAGCC AGAGGATCGC TGACGAGGAG
    ACAGCTATGG AGCAGGACGT GGACAGCAGC GCAGAGGAGG GTACCGAGCC CAGCCCATCC
    CAGAGCTCTG CCGAACAGTC ACAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014353476.1
    CDS73..3759
    Translation

    Target ORF information:

    RefSeq Version XM_014497990.1
    Organism Latimeria chalumnae(coelacanth)
    Definition Latimeria chalumnae chromosome unknown open reading frame, human C11orf30 (LOC102360717), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014497990.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGTCGGGCC CTAACAGTTC ATCAGAATGG TCGATTGAAG GTCGCAGGTT GGTCCCATTG 
    ATGCCAAGGT TGGTGCCACA GACAGCGTTC ACAGTGACGG CAAATGCTGT TGCAAATGCA
    GCAGTTCAGC ACAACGCATC ACTTCCTTCA CCTGCGGAAA CAGGAAATAA AGAAGTGGTG
    GTTTGCTATT CTTACACCAG TACGACTTCC ACACCTACTT CTACCACAGT CCCGAGTGGT
    AGTGTAGCAA CAGTGAAATC TCCCAGACCT GCCAGTCCTG CCTCAAACGT TGTCGTCTTA
    CCCAGTGGCA GCACCGTTTA TGTCAAGAGT GTCAGCTGTT CGGACGAAGA TGAAAAACCT
    CGCAAGCGGA GGCGCACCAA CTCCTCCAGT TCCTCCCCAG TTGTCACGAG GGAGGTCCCC
    AAGGCAGTCA CCCCTGTCTC GAAAACCATC ACCGTTCCTG TCACGAGCAG CTCCAAGATG
    AGCAACATCA TGCAAAGCAT TGCCAACTCC TTGCCTCCGC ACATGTCTCC CGTGAAAATC
    ACTTTCACAA AACCGTCAAC CCAGACGACG AATACAACAA CGCAAAAGGT GATTATAGTA
    ACAACCTCTC CCAGCTCAAC TTTTGTACCA AACATTCTGT CCAAGTCCCA TAATTATGCA
    GCGGTCACCA AACTGGTCCC CACATCGGTC ATTACATCGA CGACACAGAA GCAGCCGATG
    GTCATCACAG CCTCTCAGTC GTCCTTAGTG GCTGCCGCCG CCGCCGCCGC CAGCAGTAGT
    TCTACCCTGT CTTCAGGTCC CAGCACTGTT GCTGTAACAT CGGTGGTTTC TTCCACACCT
    TCAGTCGTCA TGTCAGCAGT AGCACAAGGA GCGTCTTCAA CAGCAGTCAA AGTTTCATCA
    GCCCGGCTTC CTTCGCCTAA AACTCTGGTG GGCTCTCCAA CCCAGATCCT GGCTCAGTTC
    CCCAAGCAGC ACCAACAGTC TGCCAAGCAG CAGACGCAGT CACCCCTGCA GCAACAGACA
    CAGGGCACCC TGTCTTCTCA GGCCGCTCAG CAGCATATTC AACAGTCCCA GACGCCGTCT
    GGGGTTAAAC CTACAATTCA GATCAAACAG GAGTCTGGAG TGAAGATAAT CACACAACAA
    ATGCAGCCCA GTAAAATCCT CCCTAAACCA GCAACCGCTA CCATGCAGAG CAGCAGCAGT
    TCCCCCATCA TGGTGGTTAG CAGTAACGGT GCCATCATGA CAACTAAACT GGTCACTACA
    CCCTCAGACA AAATTGATAT GTTGAACCCT AATTTTGTTG CAGGTACCAC CACAAAAATA
    ACCACCATCC CAATGACTTC CAAACCCAAC GTGATAGTCG TACAAAAGGC TACAGGGAAA
    GGGGCAACTT TCCAGGGGCT CCCAGGCAAA AACGTTGTCA CAACATTGTT AAATGCAGGG
    GGCGAAAAGA CAATTCAGGC AATGCCAGCA GGTACGAAAC CAGCCATCAT CACGGCCACG
    AGACCCATCA CTAAAATGAT AGTCACGCAG CCAAAGGGAA TGGGGGCAAC GGTTCAGCCG
    ACAACCAAAA TCATCCCCAC GAAGATTGTC TATGGACAGC AAGGAAAGAC GCAGGTCCTA
    ATAAAGCCCA AACCTGTGAC CTTCCAGGCC GCCATGGTGA GCGAGCATAC CAGACAGTTG
    GTCACCGAGA CACTTCAGCA GGCATCCAGG GTGGCCGAGG GGAACAGCTC TGCTGTTCAG
    GAAGGGGTCG TGAAAGAGGA ATCTCACACC TACATTGACA GCAGCTCCTC CTCCATTGAG
    TCCTCTCAAA GTTCACAAGT TGCAGAGTCC CAGTCTGTGG TTCACGTGAT CACAACCAGA
    AGCCAGGATT GGACAGACCA TGAGGTTTCC ATGGAGTCCA GCCCCACTAT AATTTACCAG
    GAAGCAACCA GTGAATCTCA GTCCGCTACT TCCACCATTA AAGCCTTACT AGAGCTTCAG
    CAAACAACAG TTAAAGAGAA GATGGATGCA AAACCTAGGC AGCACACTAT TGACCTAAGT
    CAGATGGCCG TTCCTATCCA AATGACACAT GAAAAGAGGC AGTCTCCCGA AAACCCTGCT
    ATAACTGTAG TCGAATCAGA TCTCGTTACA GAGTATATCA GCACTGTCAA AACTGCCAAG
    CCTGGCACTT CCACTTCCAG CATGAGTCCT GGCGAAGTGG CACTGACGTC CCTGCTGTCC
    GCCAGTCACC AGCAGCTGCA GTCCCAGCCC CAGCGCACTT TGGTACAGCA GCAGGTGGTT
    CAAGCGCAGA CTACGTCACA GGCGCCGGTA TTAGTGAAGT CAATCCCGGT GTCTTCCACA
    GGCACAGTCA CCCACATCAT GCAGCAGGTT GTAAGCAGTC ATATAACCTC AGCCAAACAG
    ATGGAAGATC TGGGAACTGA AGAGGGAGAG GTGGAAGAAA TGGATACGTT AGACCCCCAG
    ACTGGTCTGT TTTACAGGTC TGCTCAAACT CTGCTGCAGA AGCCACAAAA GCAAAGCCAG
    CTGTCTGCGG ACCAGTCTTG CGTGCAAGCT CACATGCAGC AGCAGCCGCC CATGAAGCAG
    CAGCTGAAGC AGGCCACAAC CCTGGAACAG CTGCAGGCGC AGCACAGGCT CCAGCAAGCA
    GCCCATCAGC TCTATACCAA GCAACTGCAA AAGCAGACGG CTGTGGTACA GCGGGACCAG
    GAGCAGCCGA GAGCGCCTTT ACAGCAACAG CAGCCGCCGC CGCAGATTGT GGCAAAAGAG
    AGACTGGTAT CTTCGGCTGT GACGCAGCCA CAGCAGACCG TTGTGCAGGT GCTGGCGGTG
    AAAGCCCCCC AGCAGCAGCT TCCCAAACTC CAGCAAATGC CCGTCCAGCA GAGAGTGCAA
    ACGCAGTCCC AGCCCATGTA CACTTTCTCC AAGCAGCCTG CCTCTTCAGA GAAACTGTCA
    GCAGGACAGG TGCAGCTTCC AATTATAACT CAAGGCGGAA CAGTTACAAA GATAACATTT
    GATAGCCACC AGGCTCCCAC CATCTCCAAG TCAGCCAGCA GCGACTCTGG GACAAAATCG
    GCAGCACTGG CCACAAGCGT ACTCCCAGCA CAGCCGTCTG AAAAACCTGG GGTGGCGGAC
    ATTGTGAAAA TCTCCATGAT GGAAGCTCAG ATTGAAACAA ACATAGAGCC CATGGCTGTG
    GATTCACCCA GTGAAAGAAC TAAAGTTGCA AAAGCTGCAG CCACAGTGGT ATCAGCCCCT
    CCGAGCCAGC CACAGCAGCG TAAAGAACCC CCGGGGAACC CCCCTGCTCC TGCTCCACCC
    CCACTCCCAG CAGCAGCAGC AGCGGCATCT TCATCGGTGG TGGTGGCGGC GGCATCATCC
    TCATCGGTTC CCTCCTCTAC ACCAGAAAAA AGTGAAGCCC TGGCAGTGCC TGTGACCAGC
    CAGTTCATCC ACATTCAGAA CCTGACGCAA AAGAAAACTG AAGAGATACC GGCCGATATT
    CTCATCCAGA CTATCCCCCA GTATTCCATC CCCTGCCACT CCAGTTCCAA TGTGGTGGTG
    GAGCCCAGTG GGCTCTTGGA GATCAATAAC TTCACCAGCC AGAGGATCGC TGACGAGGAG
    ACAGCTATGG AGCAGGACGT GGACAGCAGC GCAGAGGAGG GTACCGAGCC CAGCCCATCC
    CAGAGCTCTG CCGAACAGTC ACAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.