ASXL2 cDNA ORF clone, Equus asinus(ass)

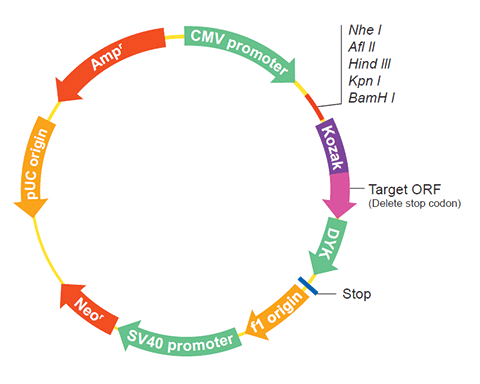
The following ASXL2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ASXL2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OEq01798 XM_014856740.1
Latest version!
Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $797.30
$1139.00
OEq01799 XM_014856743.1
Latest version!
Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $797.30
$1139.00
OEq01800 XM_014856748.1
Latest version!
Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $797.30
$1139.00
OEq01801 XM_014856758.1
Latest version!
Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq01802 XM_014856767.1
Latest version!
Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq01802 XM_014856774.1
Latest version!
Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OEq01802 XM_014856782.1
Latest version!
Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X7, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OEq01798
    Clone ID Related Accession (Same CDS sequence) XM_014856740.1
    Accession Version XM_014856740.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4329bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
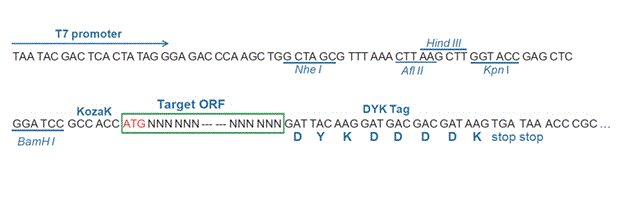
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product putative Polycomb group protein ASXL2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014636848.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    ATGAGGGAAA AGGGCCGTAG GAAGAAGGGC AGGACCTGGG CGGAGGCCGC CAAGACGGTC 
    TTAGAAAAAT ACCCCAATAC ACCCATGAGT CATAAAGAAA TTCTTCAAGT TATCCAGAGA
    GAAGGACTAA AAGAAATCAG AAGTGGGACT TCCCCTCTTG CATGCCTGAA TGCAATGCTG
    CACACAAACT CCCGAGGTGA AGAGGGCATC TTCTATAAGG TTCCAGGTAG AATGGGAGTA
    TATACCTTGA AGAAAGATGT GCCGGATGGG GTGAAAGAGC TATCAGAAGG TTCAGAAGAA
    AGCAGTGATG GTCAGTCAGA TTCCCAGAGT TCTGAGAACA GCAGCAGCAG CAGTGATGGT
    GGCAGCAACA AGGAGGGAAA AAAGAGCAGG TGGAAAAGGA AAGTATCGTC CAGACTGTCA
    CAGCCATCCT CTCCCCAGTC AGGCTGCCCA TCACCCACCA TTCCAGCAGG TAAAGTCATT
    TCTCCATCAC AGAAGCACAC CAAGAAGGCA CTAAAGCAGG CTCTAAAACA GCAACAACAG
    AAGAAGCAGC AGCAGCAATG CAGGCCAAGC ATGTCCATCT CGTCCAACCA GCATCTATCT
    CTGAAGACTG TCAAAGCAGC CAGTGACTCC GTACCTGCCA AACCTGCGAT GTGGGAAGGA
    AAGCAATCTG ATGGACAGTC AAGCAGCCCT CAGAACTCAA ATTCTAGCTT TGCTTCTTCA
    GTTAAAGTGG AAAATCCTTT GCTAAGCTTG GGGAAGAAGT CATTCCAGAG GTCTGACAGG
    CTCCACACAA GGCAAATGAA AAGAACTAAA TGTGCTGAAA TTGATGTTGA GACACCAGAC
    TCCATTCTGG TTAATACAAA TCTACGAGCA CTGATCAACA AACACACCTT TTCAGTCCTT
    CCTGGAGATT GCCAACAGCG ATTGCTTTTA CTACTTCCAG AGGTGGATCG ACAGATTGGT
    CCAGATGGTC TGATGAAGTT AAATGGCTCA GCCCTTAACA ATGAGTTCTT CACTTCAGCA
    GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA GGTGAGTTTA CACCTGAGAT GCAGGTGAGA
    ATTCGACAAG AGATTGAGAA GGAGAAAAAA GTAGAGCCAT GGAAAGAACA ATTCTTTGAA
    AGCTACTATG GTCAGAGTTC TGGCCTGAGC CTTGAGGATT CAAAGAAATT AACGGGTTCA
    CCCAGTGATT CCAAAGTAAA GAAAACCCCA GCTGAGCAAC CAAAATCCAT GCTTCCTTCA
    GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA
    GTACCAATGC CATCACCAGT CAGAAAAGAG GAGCGCGAAA GCCAAGATAA GGTGCAGCCA
    AGCTCCAAAT CCACAGAGCC CCTACTTTCC TCAGCTAGCA ATGCAAATGA GCTTAGCAGT
    GTTCTTTCCA TCAAGTGCCC AAAGGACGAG GATCATTTGG AGCAGAAGCC AGTTGCCTCT
    GCTGAACAGG AGTCTGAGAA GGAGAATCAT CTCACTACAG CCTCTAATTA TAACAAAAAT
    GAAAGCCAGG AAGCTTTAGT TACATCTCCG AGCAAATCCA AGAGTCCTGA GGTGGAAAAA
    CCAATAATGA AGCCCATAGT AGAAGCAAGT CCACAGGAGG CCACTATGAA AGAGCTTCCG
    TCAGCTCTGG TTGACCACAG CCCAGAAAGC CTCAAGAGGA AAGCTTCTCT CACCCAAGAA
    GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA CGTGTCACAG AGAATCGCCA CCACCAGCAG
    CCATTTCAGG TCTCGCCACA GCCCTTTCTC AATAGAGTGG ACAGGATCCC GGTGCGAAAA
    GTACCACCTC TCAAGATCCC AGTCTCCAGA ATCTCCCCCA TGCCGTTTCC TACATCGCAG
    GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC ATCACTAGTC CTAACAGAAC AGGAGCCAGA
    ACTCTTGCAG ACATCAAAGC AAAAGCCCAG CTGGTCAAAG CACAGAGGGC AGCAGCTGCC
    GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA GTTGGAGGGA CCATTCCAGG ACCTGGCCCA
    GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA
    AACTCAGAAA GAGTCGGTGA AACTGGAAAG GGCCCCACAC TGGAACTGGC AGGAACTGGA
    AGCAGGGGAG GTACGAGAGA GCTTTTACCC TCTGGTCCAG ACACTCAGCC CCAATCTGAG
    ACCAAGACCC CAGGCCAGGC ACAGCCTCAT AGTGTCTCTG GAGCACAACT ACAGCAAACC
    CCCTCAGTGC CTCCAATATC TGCCATCAGT GGAGCATGCA CAAGTGTCCC ATCACCAGCC
    CACACTAATG CACCCCCACC AGCTTTAGTG AAATTGAATA ATGAAAAACT GAATCCCTCC
    AGGGCAGCAG CCACCATGGC CTCTCTAAGC CACCCACCGT GGCCCAGTAA TTGCTGGCAA
    GAGAAAGCAC CTTCTACTCC AGCAGATCCT GCTCATTTTA CTGCTGATGG CACAGCTGAG
    CCCAAAGCAG CTTCTAGTAA GAATCCACCA AACCCTTCAG CCTCAGCAGA GACAAATGCT
    AGTGCTTCAG TGGATATGAC TCCCTCCCCT TTAACATCTT TATTAACAAC AGCCACTTTA
    GAAAAGCTTC CTGTACCCCA GGTCAGTGTA ACTGTAGCAC CTACCGGATC AGCTCTATCC
    TTGAGCACTT TGCCAGCAGC TTCTAGCCTT AAAACTCCAG GAATTTCTTC AAATATGAAT
    GGACCCATTT CAAGGCCAAG TTCTAGTATC CCTGCTAATA ATCCTCTGGT CACTCAGCTG
    CTCCAGGGCA AAGATGTTCC CATGGAGCAA ATTCTGCCTA AACCTCTCAC CAAAGTTGAA
    ATGAAAACTG TTCCACTGAC TACAAAAGAG GAAAAGGGGA TAGGAGCACT CACAGGCACC
    AACATAACAG AAAATAGCAC CAGAGAGGAA GGTAACGAGA GGCAGTCTCA TCCAGCTATA
    CAGCAGCTGG GGAAAACCTT GCAGAGTAAG CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG
    CTCTTTTCAG GTAAGGATCT GAGGGAGTCT AGCATTGACA CACACCAATA CCGAGAAGGA
    CTAAGTAAAG CAACCCAAGA GCAGATCCTT CAGACTCTCA TCCAAAGGGT TCAGAGGCAA
    AATGTTTCCT CGTTTGCACA GCCCTCTCAG TTCAACTTCA CTCACTCAGG TTTCCAGTTA
    GAAGACCTCT CCATAAGCCA GAGGTTCATG CTGGGTTTTG CTGGCAGAAG GACATCAAAG
    CCTGCAATGG CAGGTCACTA CTTACTTAAC ATTTCCACCT ATGGCCGGGG TTCAGAGAGC
    TTTAGGAGGA CCCATTCTGT AAACCCTGAA GACCGTTTTT GTCTAAGTAG CCCCACTGAG
    GCCTTGAAAA TGGGATATAC AGACTGTAAA AATGCAACAG GAGATAGTAG CAGCAGCAAA
    GAAGAAGATA CTGATGAGGA AAGTACTGGT GATGAGCAAG AATCTATCAT GGTGAAGGAG
    GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG TGTGAAGCAA GTTCAGGACC CCACAGTAGA
    GAAAACCTAT CCACCAATGA TTGTTTAGCT AAAAAGAACG TGAAGGCAGA GACACCAGTG
    CATGAGCAAA CCACTTTAAG CAAGGAGAAT TACCTCTTCC CCAGAGGCCA AATGTTTGAT
    GAAAAGACCC TAGCCAGAGA TTTTATTCAG GCAGCACAGA AGCAAATGGC TCATGCAGTA
    AGAGGTAAGA CAATGCGTAG CAGCCCTGAG CTTTTCAATT CTACTGCTCT TCCTCTACCT
    ACAGACAGTC CCACACATCA GCCTCTCCTC CTTCCACCAC TGCAAACCCC AAAGCTGTAT
    GGAAGCCCCA CACAGATCGG GCCAAGCTAC AGAGGCATGA TCAATGTCTC CACCTCATCT
    GACACGGACC ATAACTCTGC TGTACCGGGG ATGCCTGACT GTAGCCAGGT ATCTAGTAAC
    ATAGGTGATG TCATGTCCTT TTCAGTGACT GTCACTACCA TCCCTGCTAG CCAAGCTATG
    AATCCCAGTA GCCACGGCCA GACCATTCCT GTTCAGGCCT TCCCTGAAGA AAACAGCATA
    GATAACACGC CTTCGAAATG TTACTGCCGT TTGAAAGCTA TGATCATGTG CAAGGGGTGT
    GGAGCTTTCT GCCACGATGA TTGCATTGGC CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC
    GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014712226.1
    CDS250..4578
    Translation

    Target ORF information:

    RefSeq Version XM_014856740.1
    Organism Equus asinus(ass)
    Definition Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014856740.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    ATGAGGGAAA AGGGCCGTAG GAAGAAGGGC AGGACCTGGG CGGAGGCCGC CAAGACGGTC 
    TTAGAAAAAT ACCCCAATAC ACCCATGAGT CATAAAGAAA TTCTTCAAGT TATCCAGAGA
    GAAGGACTAA AAGAAATCAG AAGTGGGACT TCCCCTCTTG CATGCCTGAA TGCAATGCTG
    CACACAAACT CCCGAGGTGA AGAGGGCATC TTCTATAAGG TTCCAGGTAG AATGGGAGTA
    TATACCTTGA AGAAAGATGT GCCGGATGGG GTGAAAGAGC TATCAGAAGG TTCAGAAGAA
    AGCAGTGATG GTCAGTCAGA TTCCCAGAGT TCTGAGAACA GCAGCAGCAG CAGTGATGGT
    GGCAGCAACA AGGAGGGAAA AAAGAGCAGG TGGAAAAGGA AAGTATCGTC CAGACTGTCA
    CAGCCATCCT CTCCCCAGTC AGGCTGCCCA TCACCCACCA TTCCAGCAGG TAAAGTCATT
    TCTCCATCAC AGAAGCACAC CAAGAAGGCA CTAAAGCAGG CTCTAAAACA GCAACAACAG
    AAGAAGCAGC AGCAGCAATG CAGGCCAAGC ATGTCCATCT CGTCCAACCA GCATCTATCT
    CTGAAGACTG TCAAAGCAGC CAGTGACTCC GTACCTGCCA AACCTGCGAT GTGGGAAGGA
    AAGCAATCTG ATGGACAGTC AAGCAGCCCT CAGAACTCAA ATTCTAGCTT TGCTTCTTCA
    GTTAAAGTGG AAAATCCTTT GCTAAGCTTG GGGAAGAAGT CATTCCAGAG GTCTGACAGG
    CTCCACACAA GGCAAATGAA AAGAACTAAA TGTGCTGAAA TTGATGTTGA GACACCAGAC
    TCCATTCTGG TTAATACAAA TCTACGAGCA CTGATCAACA AACACACCTT TTCAGTCCTT
    CCTGGAGATT GCCAACAGCG ATTGCTTTTA CTACTTCCAG AGGTGGATCG ACAGATTGGT
    CCAGATGGTC TGATGAAGTT AAATGGCTCA GCCCTTAACA ATGAGTTCTT CACTTCAGCA
    GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA GGTGAGTTTA CACCTGAGAT GCAGGTGAGA
    ATTCGACAAG AGATTGAGAA GGAGAAAAAA GTAGAGCCAT GGAAAGAACA ATTCTTTGAA
    AGCTACTATG GTCAGAGTTC TGGCCTGAGC CTTGAGGATT CAAAGAAATT AACGGGTTCA
    CCCAGTGATT CCAAAGTAAA GAAAACCCCA GCTGAGCAAC CAAAATCCAT GCTTCCTTCA
    GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA
    GTACCAATGC CATCACCAGT CAGAAAAGAG GAGCGCGAAA GCCAAGATAA GGTGCAGCCA
    AGCTCCAAAT CCACAGAGCC CCTACTTTCC TCAGCTAGCA ATGCAAATGA GCTTAGCAGT
    GTTCTTTCCA TCAAGTGCCC AAAGGACGAG GATCATTTGG AGCAGAAGCC AGTTGCCTCT
    GCTGAACAGG AGTCTGAGAA GGAGAATCAT CTCACTACAG CCTCTAATTA TAACAAAAAT
    GAAAGCCAGG AAGCTTTAGT TACATCTCCG AGCAAATCCA AGAGTCCTGA GGTGGAAAAA
    CCAATAATGA AGCCCATAGT AGAAGCAAGT CCACAGGAGG CCACTATGAA AGAGCTTCCG
    TCAGCTCTGG TTGACCACAG CCCAGAAAGC CTCAAGAGGA AAGCTTCTCT CACCCAAGAA
    GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA CGTGTCACAG AGAATCGCCA CCACCAGCAG
    CCATTTCAGG TCTCGCCACA GCCCTTTCTC AATAGAGTGG ACAGGATCCC GGTGCGAAAA
    GTACCACCTC TCAAGATCCC AGTCTCCAGA ATCTCCCCCA TGCCGTTTCC TACATCGCAG
    GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC ATCACTAGTC CTAACAGAAC AGGAGCCAGA
    ACTCTTGCAG ACATCAAAGC AAAAGCCCAG CTGGTCAAAG CACAGAGGGC AGCAGCTGCC
    GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA GTTGGAGGGA CCATTCCAGG ACCTGGCCCA
    GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA
    AACTCAGAAA GAGTCGGTGA AACTGGAAAG GGCCCCACAC TGGAACTGGC AGGAACTGGA
    AGCAGGGGAG GTACGAGAGA GCTTTTACCC TCTGGTCCAG ACACTCAGCC CCAATCTGAG
    ACCAAGACCC CAGGCCAGGC ACAGCCTCAT AGTGTCTCTG GAGCACAACT ACAGCAAACC
    CCCTCAGTGC CTCCAATATC TGCCATCAGT GGAGCATGCA CAAGTGTCCC ATCACCAGCC
    CACACTAATG CACCCCCACC AGCTTTAGTG AAATTGAATA ATGAAAAACT GAATCCCTCC
    AGGGCAGCAG CCACCATGGC CTCTCTAAGC CACCCACCGT GGCCCAGTAA TTGCTGGCAA
    GAGAAAGCAC CTTCTACTCC AGCAGATCCT GCTCATTTTA CTGCTGATGG CACAGCTGAG
    CCCAAAGCAG CTTCTAGTAA GAATCCACCA AACCCTTCAG CCTCAGCAGA GACAAATGCT
    AGTGCTTCAG TGGATATGAC TCCCTCCCCT TTAACATCTT TATTAACAAC AGCCACTTTA
    GAAAAGCTTC CTGTACCCCA GGTCAGTGTA ACTGTAGCAC CTACCGGATC AGCTCTATCC
    TTGAGCACTT TGCCAGCAGC TTCTAGCCTT AAAACTCCAG GAATTTCTTC AAATATGAAT
    GGACCCATTT CAAGGCCAAG TTCTAGTATC CCTGCTAATA ATCCTCTGGT CACTCAGCTG
    CTCCAGGGCA AAGATGTTCC CATGGAGCAA ATTCTGCCTA AACCTCTCAC CAAAGTTGAA
    ATGAAAACTG TTCCACTGAC TACAAAAGAG GAAAAGGGGA TAGGAGCACT CACAGGCACC
    AACATAACAG AAAATAGCAC CAGAGAGGAA GGTAACGAGA GGCAGTCTCA TCCAGCTATA
    CAGCAGCTGG GGAAAACCTT GCAGAGTAAG CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG
    CTCTTTTCAG GTAAGGATCT GAGGGAGTCT AGCATTGACA CACACCAATA CCGAGAAGGA
    CTAAGTAAAG CAACCCAAGA GCAGATCCTT CAGACTCTCA TCCAAAGGGT TCAGAGGCAA
    AATGTTTCCT CGTTTGCACA GCCCTCTCAG TTCAACTTCA CTCACTCAGG TTTCCAGTTA
    GAAGACCTCT CCATAAGCCA GAGGTTCATG CTGGGTTTTG CTGGCAGAAG GACATCAAAG
    CCTGCAATGG CAGGTCACTA CTTACTTAAC ATTTCCACCT ATGGCCGGGG TTCAGAGAGC
    TTTAGGAGGA CCCATTCTGT AAACCCTGAA GACCGTTTTT GTCTAAGTAG CCCCACTGAG
    GCCTTGAAAA TGGGATATAC AGACTGTAAA AATGCAACAG GAGATAGTAG CAGCAGCAAA
    GAAGAAGATA CTGATGAGGA AAGTACTGGT GATGAGCAAG AATCTATCAT GGTGAAGGAG
    GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG TGTGAAGCAA GTTCAGGACC CCACAGTAGA
    GAAAACCTAT CCACCAATGA TTGTTTAGCT AAAAAGAACG TGAAGGCAGA GACACCAGTG
    CATGAGCAAA CCACTTTAAG CAAGGAGAAT TACCTCTTCC CCAGAGGCCA AATGTTTGAT
    GAAAAGACCC TAGCCAGAGA TTTTATTCAG GCAGCACAGA AGCAAATGGC TCATGCAGTA
    AGAGGTAAGA CAATGCGTAG CAGCCCTGAG CTTTTCAATT CTACTGCTCT TCCTCTACCT
    ACAGACAGTC CCACACATCA GCCTCTCCTC CTTCCACCAC TGCAAACCCC AAAGCTGTAT
    GGAAGCCCCA CACAGATCGG GCCAAGCTAC AGAGGCATGA TCAATGTCTC CACCTCATCT
    GACACGGACC ATAACTCTGC TGTACCGGGG ATGCCTGACT GTAGCCAGGT ATCTAGTAAC
    ATAGGTGATG TCATGTCCTT TTCAGTGACT GTCACTACCA TCCCTGCTAG CCAAGCTATG
    AATCCCAGTA GCCACGGCCA GACCATTCCT GTTCAGGCCT TCCCTGAAGA AAACAGCATA
    GATAACACGC CTTCGAAATG TTACTGCCGT TTGAAAGCTA TGATCATGTG CAAGGGGTGT
    GGAGCTTTCT GCCACGATGA TTGCATTGGC CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC
    GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq01799
    Clone ID Related Accession (Same CDS sequence) XM_014856743.1
    Accession Version XM_014856743.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4326bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product putative Polycomb group protein ASXL2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014636848.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    ATGAGGGAAA AGGGCCGTAG GAAGAAGGGC AGGACCTGGG CGGAGGCCGC CAAGACGGTC 
    TTAGAAAAAT ACCCCAATAC ACCCATGAGT CATAAAGAAA TTCTTCAAGT TATCCAGAGA
    GAAGGACTAA AAGAAATCAG TGGGACTTCC CCTCTTGCAT GCCTGAATGC AATGCTGCAC
    ACAAACTCCC GAGGTGAAGA GGGCATCTTC TATAAGGTTC CAGGTAGAAT GGGAGTATAT
    ACCTTGAAGA AAGATGTGCC GGATGGGGTG AAAGAGCTAT CAGAAGGTTC AGAAGAAAGC
    AGTGATGGTC AGTCAGATTC CCAGAGTTCT GAGAACAGCA GCAGCAGCAG TGATGGTGGC
    AGCAACAAGG AGGGAAAAAA GAGCAGGTGG AAAAGGAAAG TATCGTCCAG ACTGTCACAG
    CCATCCTCTC CCCAGTCAGG CTGCCCATCA CCCACCATTC CAGCAGGTAA AGTCATTTCT
    CCATCACAGA AGCACACCAA GAAGGCACTA AAGCAGGCTC TAAAACAGCA ACAACAGAAG
    AAGCAGCAGC AGCAATGCAG GCCAAGCATG TCCATCTCGT CCAACCAGCA TCTATCTCTG
    AAGACTGTCA AAGCAGCCAG TGACTCCGTA CCTGCCAAAC CTGCGATGTG GGAAGGAAAG
    CAATCTGATG GACAGTCAAG CAGCCCTCAG AACTCAAATT CTAGCTTTGC TTCTTCAGTT
    AAAGTGGAAA ATCCTTTGCT AAGCTTGGGG AAGAAGTCAT TCCAGAGGTC TGACAGGCTC
    CACACAAGGC AAATGAAAAG AACTAAATGT GCTGAAATTG ATGTTGAGAC ACCAGACTCC
    ATTCTGGTTA ATACAAATCT ACGAGCACTG ATCAACAAAC ACACCTTTTC AGTCCTTCCT
    GGAGATTGCC AACAGCGATT GCTTTTACTA CTTCCAGAGG TGGATCGACA GATTGGTCCA
    GATGGTCTGA TGAAGTTAAA TGGCTCAGCC CTTAACAATG AGTTCTTCAC TTCAGCAGCC
    CAAGGCTGGA AGGAAAGACT CTCAGAAGGT GAGTTTACAC CTGAGATGCA GGTGAGAATT
    CGACAAGAGA TTGAGAAGGA GAAAAAAGTA GAGCCATGGA AAGAACAATT CTTTGAAAGC
    TACTATGGTC AGAGTTCTGG CCTGAGCCTT GAGGATTCAA AGAAATTAAC GGGTTCACCC
    AGTGATTCCA AAGTAAAGAA AACCCCAGCT GAGCAACCAA AATCCATGCT TCCTTCAGAG
    GCCTCTCCTC TCAGTGTAGT CCCAGTAATT CCCCAGTTAG AGTCTAAAGA AGAAGAAGTA
    CCAATGCCAT CACCAGTCAG AAAAGAGGAG CGCGAAAGCC AAGATAAGGT GCAGCCAAGC
    TCCAAATCCA CAGAGCCCCT ACTTTCCTCA GCTAGCAATG CAAATGAGCT TAGCAGTGTT
    CTTTCCATCA AGTGCCCAAA GGACGAGGAT CATTTGGAGC AGAAGCCAGT TGCCTCTGCT
    GAACAGGAGT CTGAGAAGGA GAATCATCTC ACTACAGCCT CTAATTATAA CAAAAATGAA
    AGCCAGGAAG CTTTAGTTAC ATCTCCGAGC AAATCCAAGA GTCCTGAGGT GGAAAAACCA
    ATAATGAAGC CCATAGTAGA AGCAAGTCCA CAGGAGGCCA CTATGAAAGA GCTTCCGTCA
    GCTCTGGTTG ACCACAGCCC AGAAAGCCTC AAGAGGAAAG CTTCTCTCAC CCAAGAAGAG
    TCCCCTATGA GCTGGGAGAA GAGGCCACGT GTCACAGAGA ATCGCCACCA CCAGCAGCCA
    TTTCAGGTCT CGCCACAGCC CTTTCTCAAT AGAGTGGACA GGATCCCGGT GCGAAAAGTA
    CCACCTCTCA AGATCCCAGT CTCCAGAATC TCCCCCATGC CGTTTCCTAC ATCGCAGGTC
    TCTCCCAGGG CTCGTTTTCC AGTCTCCATC ACTAGTCCTA ACAGAACAGG AGCCAGAACT
    CTTGCAGACA TCAAAGCAAA AGCCCAGCTG GTCAAAGCAC AGAGGGCAGC AGCTGCCGCT
    GCAGCTGCCG CTGCTGCAGC CGCCTCAGTT GGAGGGACCA TTCCAGGACC TGGCCCAGGG
    GGTGGACAAG GTCCAGGAGA GGGTGGTGAA AGGAAAACTG CTAGAGGAGG GAGTCCAAAC
    TCAGAAAGAG TCGGTGAAAC TGGAAAGGGC CCCACACTGG AACTGGCAGG AACTGGAAGC
    AGGGGAGGTA CGAGAGAGCT TTTACCCTCT GGTCCAGACA CTCAGCCCCA ATCTGAGACC
    AAGACCCCAG GCCAGGCACA GCCTCATAGT GTCTCTGGAG CACAACTACA GCAAACCCCC
    TCAGTGCCTC CAATATCTGC CATCAGTGGA GCATGCACAA GTGTCCCATC ACCAGCCCAC
    ACTAATGCAC CCCCACCAGC TTTAGTGAAA TTGAATAATG AAAAACTGAA TCCCTCCAGG
    GCAGCAGCCA CCATGGCCTC TCTAAGCCAC CCACCGTGGC CCAGTAATTG CTGGCAAGAG
    AAAGCACCTT CTACTCCAGC AGATCCTGCT CATTTTACTG CTGATGGCAC AGCTGAGCCC
    AAAGCAGCTT CTAGTAAGAA TCCACCAAAC CCTTCAGCCT CAGCAGAGAC AAATGCTAGT
    GCTTCAGTGG ATATGACTCC CTCCCCTTTA ACATCTTTAT TAACAACAGC CACTTTAGAA
    AAGCTTCCTG TACCCCAGGT CAGTGTAACT GTAGCACCTA CCGGATCAGC TCTATCCTTG
    AGCACTTTGC CAGCAGCTTC TAGCCTTAAA ACTCCAGGAA TTTCTTCAAA TATGAATGGA
    CCCATTTCAA GGCCAAGTTC TAGTATCCCT GCTAATAATC CTCTGGTCAC TCAGCTGCTC
    CAGGGCAAAG ATGTTCCCAT GGAGCAAATT CTGCCTAAAC CTCTCACCAA AGTTGAAATG
    AAAACTGTTC CACTGACTAC AAAAGAGGAA AAGGGGATAG GAGCACTCAC AGGCACCAAC
    ATAACAGAAA ATAGCACCAG AGAGGAAGGT AACGAGAGGC AGTCTCATCC AGCTATACAG
    CAGCTGGGGA AAACCTTGCA GAGTAAGCAG CTCCCCCAGG TTCCAAGGCC CCTTCAGCTC
    TTTTCAGGTA AGGATCTGAG GGAGTCTAGC ATTGACACAC ACCAATACCG AGAAGGACTA
    AGTAAAGCAA CCCAAGAGCA GATCCTTCAG ACTCTCATCC AAAGGGTTCA GAGGCAAAAT
    GTTTCCTCGT TTGCACAGCC CTCTCAGTTC AACTTCACTC ACTCAGGTTT CCAGTTAGAA
    GACCTCTCCA TAAGCCAGAG GTTCATGCTG GGTTTTGCTG GCAGAAGGAC ATCAAAGCCT
    GCAATGGCAG GTCACTACTT ACTTAACATT TCCACCTATG GCCGGGGTTC AGAGAGCTTT
    AGGAGGACCC ATTCTGTAAA CCCTGAAGAC CGTTTTTGTC TAAGTAGCCC CACTGAGGCC
    TTGAAAATGG GATATACAGA CTGTAAAAAT GCAACAGGAG ATAGTAGCAG CAGCAAAGAA
    GAAGATACTG ATGAGGAAAG TACTGGTGAT GAGCAAGAAT CTATCATGGT GAAGGAGGAG
    CCCCAGGCTG CCCAGAGTTC TGGCAAGTGT GAAGCAAGTT CAGGACCCCA CAGTAGAGAA
    AACCTATCCA CCAATGATTG TTTAGCTAAA AAGAACGTGA AGGCAGAGAC ACCAGTGCAT
    GAGCAAACCA CTTTAAGCAA GGAGAATTAC CTCTTCCCCA GAGGCCAAAT GTTTGATGAA
    AAGACCCTAG CCAGAGATTT TATTCAGGCA GCACAGAAGC AAATGGCTCA TGCAGTAAGA
    GGTAAGACAA TGCGTAGCAG CCCTGAGCTT TTCAATTCTA CTGCTCTTCC TCTACCTACA
    GACAGTCCCA CACATCAGCC TCTCCTCCTT CCACCACTGC AAACCCCAAA GCTGTATGGA
    AGCCCCACAC AGATCGGGCC AAGCTACAGA GGCATGATCA ATGTCTCCAC CTCATCTGAC
    ACGGACCATA ACTCTGCTGT ACCGGGGATG CCTGACTGTA GCCAGGTATC TAGTAACATA
    GGTGATGTCA TGTCCTTTTC AGTGACTGTC ACTACCATCC CTGCTAGCCA AGCTATGAAT
    CCCAGTAGCC ACGGCCAGAC CATTCCTGTT CAGGCCTTCC CTGAAGAAAA CAGCATAGAT
    AACACGCCTT CGAAATGTTA CTGCCGTTTG AAAGCTATGA TCATGTGCAA GGGGTGTGGA
    GCTTTCTGCC ACGATGATTG CATTGGCCCC TCTAAACTGT GTGTCTCTTG CCTTGTCGTT
    CGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014712229.1
    CDS250..4575
    Translation

    Target ORF information:

    RefSeq Version XM_014856743.1
    Organism Equus asinus(ass)
    Definition Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014856743.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    ATGAGGGAAA AGGGCCGTAG GAAGAAGGGC AGGACCTGGG CGGAGGCCGC CAAGACGGTC 
    TTAGAAAAAT ACCCCAATAC ACCCATGAGT CATAAAGAAA TTCTTCAAGT TATCCAGAGA
    GAAGGACTAA AAGAAATCAG TGGGACTTCC CCTCTTGCAT GCCTGAATGC AATGCTGCAC
    ACAAACTCCC GAGGTGAAGA GGGCATCTTC TATAAGGTTC CAGGTAGAAT GGGAGTATAT
    ACCTTGAAGA AAGATGTGCC GGATGGGGTG AAAGAGCTAT CAGAAGGTTC AGAAGAAAGC
    AGTGATGGTC AGTCAGATTC CCAGAGTTCT GAGAACAGCA GCAGCAGCAG TGATGGTGGC
    AGCAACAAGG AGGGAAAAAA GAGCAGGTGG AAAAGGAAAG TATCGTCCAG ACTGTCACAG
    CCATCCTCTC CCCAGTCAGG CTGCCCATCA CCCACCATTC CAGCAGGTAA AGTCATTTCT
    CCATCACAGA AGCACACCAA GAAGGCACTA AAGCAGGCTC TAAAACAGCA ACAACAGAAG
    AAGCAGCAGC AGCAATGCAG GCCAAGCATG TCCATCTCGT CCAACCAGCA TCTATCTCTG
    AAGACTGTCA AAGCAGCCAG TGACTCCGTA CCTGCCAAAC CTGCGATGTG GGAAGGAAAG
    CAATCTGATG GACAGTCAAG CAGCCCTCAG AACTCAAATT CTAGCTTTGC TTCTTCAGTT
    AAAGTGGAAA ATCCTTTGCT AAGCTTGGGG AAGAAGTCAT TCCAGAGGTC TGACAGGCTC
    CACACAAGGC AAATGAAAAG AACTAAATGT GCTGAAATTG ATGTTGAGAC ACCAGACTCC
    ATTCTGGTTA ATACAAATCT ACGAGCACTG ATCAACAAAC ACACCTTTTC AGTCCTTCCT
    GGAGATTGCC AACAGCGATT GCTTTTACTA CTTCCAGAGG TGGATCGACA GATTGGTCCA
    GATGGTCTGA TGAAGTTAAA TGGCTCAGCC CTTAACAATG AGTTCTTCAC TTCAGCAGCC
    CAAGGCTGGA AGGAAAGACT CTCAGAAGGT GAGTTTACAC CTGAGATGCA GGTGAGAATT
    CGACAAGAGA TTGAGAAGGA GAAAAAAGTA GAGCCATGGA AAGAACAATT CTTTGAAAGC
    TACTATGGTC AGAGTTCTGG CCTGAGCCTT GAGGATTCAA AGAAATTAAC GGGTTCACCC
    AGTGATTCCA AAGTAAAGAA AACCCCAGCT GAGCAACCAA AATCCATGCT TCCTTCAGAG
    GCCTCTCCTC TCAGTGTAGT CCCAGTAATT CCCCAGTTAG AGTCTAAAGA AGAAGAAGTA
    CCAATGCCAT CACCAGTCAG AAAAGAGGAG CGCGAAAGCC AAGATAAGGT GCAGCCAAGC
    TCCAAATCCA CAGAGCCCCT ACTTTCCTCA GCTAGCAATG CAAATGAGCT TAGCAGTGTT
    CTTTCCATCA AGTGCCCAAA GGACGAGGAT CATTTGGAGC AGAAGCCAGT TGCCTCTGCT
    GAACAGGAGT CTGAGAAGGA GAATCATCTC ACTACAGCCT CTAATTATAA CAAAAATGAA
    AGCCAGGAAG CTTTAGTTAC ATCTCCGAGC AAATCCAAGA GTCCTGAGGT GGAAAAACCA
    ATAATGAAGC CCATAGTAGA AGCAAGTCCA CAGGAGGCCA CTATGAAAGA GCTTCCGTCA
    GCTCTGGTTG ACCACAGCCC AGAAAGCCTC AAGAGGAAAG CTTCTCTCAC CCAAGAAGAG
    TCCCCTATGA GCTGGGAGAA GAGGCCACGT GTCACAGAGA ATCGCCACCA CCAGCAGCCA
    TTTCAGGTCT CGCCACAGCC CTTTCTCAAT AGAGTGGACA GGATCCCGGT GCGAAAAGTA
    CCACCTCTCA AGATCCCAGT CTCCAGAATC TCCCCCATGC CGTTTCCTAC ATCGCAGGTC
    TCTCCCAGGG CTCGTTTTCC AGTCTCCATC ACTAGTCCTA ACAGAACAGG AGCCAGAACT
    CTTGCAGACA TCAAAGCAAA AGCCCAGCTG GTCAAAGCAC AGAGGGCAGC AGCTGCCGCT
    GCAGCTGCCG CTGCTGCAGC CGCCTCAGTT GGAGGGACCA TTCCAGGACC TGGCCCAGGG
    GGTGGACAAG GTCCAGGAGA GGGTGGTGAA AGGAAAACTG CTAGAGGAGG GAGTCCAAAC
    TCAGAAAGAG TCGGTGAAAC TGGAAAGGGC CCCACACTGG AACTGGCAGG AACTGGAAGC
    AGGGGAGGTA CGAGAGAGCT TTTACCCTCT GGTCCAGACA CTCAGCCCCA ATCTGAGACC
    AAGACCCCAG GCCAGGCACA GCCTCATAGT GTCTCTGGAG CACAACTACA GCAAACCCCC
    TCAGTGCCTC CAATATCTGC CATCAGTGGA GCATGCACAA GTGTCCCATC ACCAGCCCAC
    ACTAATGCAC CCCCACCAGC TTTAGTGAAA TTGAATAATG AAAAACTGAA TCCCTCCAGG
    GCAGCAGCCA CCATGGCCTC TCTAAGCCAC CCACCGTGGC CCAGTAATTG CTGGCAAGAG
    AAAGCACCTT CTACTCCAGC AGATCCTGCT CATTTTACTG CTGATGGCAC AGCTGAGCCC
    AAAGCAGCTT CTAGTAAGAA TCCACCAAAC CCTTCAGCCT CAGCAGAGAC AAATGCTAGT
    GCTTCAGTGG ATATGACTCC CTCCCCTTTA ACATCTTTAT TAACAACAGC CACTTTAGAA
    AAGCTTCCTG TACCCCAGGT CAGTGTAACT GTAGCACCTA CCGGATCAGC TCTATCCTTG
    AGCACTTTGC CAGCAGCTTC TAGCCTTAAA ACTCCAGGAA TTTCTTCAAA TATGAATGGA
    CCCATTTCAA GGCCAAGTTC TAGTATCCCT GCTAATAATC CTCTGGTCAC TCAGCTGCTC
    CAGGGCAAAG ATGTTCCCAT GGAGCAAATT CTGCCTAAAC CTCTCACCAA AGTTGAAATG
    AAAACTGTTC CACTGACTAC AAAAGAGGAA AAGGGGATAG GAGCACTCAC AGGCACCAAC
    ATAACAGAAA ATAGCACCAG AGAGGAAGGT AACGAGAGGC AGTCTCATCC AGCTATACAG
    CAGCTGGGGA AAACCTTGCA GAGTAAGCAG CTCCCCCAGG TTCCAAGGCC CCTTCAGCTC
    TTTTCAGGTA AGGATCTGAG GGAGTCTAGC ATTGACACAC ACCAATACCG AGAAGGACTA
    AGTAAAGCAA CCCAAGAGCA GATCCTTCAG ACTCTCATCC AAAGGGTTCA GAGGCAAAAT
    GTTTCCTCGT TTGCACAGCC CTCTCAGTTC AACTTCACTC ACTCAGGTTT CCAGTTAGAA
    GACCTCTCCA TAAGCCAGAG GTTCATGCTG GGTTTTGCTG GCAGAAGGAC ATCAAAGCCT
    GCAATGGCAG GTCACTACTT ACTTAACATT TCCACCTATG GCCGGGGTTC AGAGAGCTTT
    AGGAGGACCC ATTCTGTAAA CCCTGAAGAC CGTTTTTGTC TAAGTAGCCC CACTGAGGCC
    TTGAAAATGG GATATACAGA CTGTAAAAAT GCAACAGGAG ATAGTAGCAG CAGCAAAGAA
    GAAGATACTG ATGAGGAAAG TACTGGTGAT GAGCAAGAAT CTATCATGGT GAAGGAGGAG
    CCCCAGGCTG CCCAGAGTTC TGGCAAGTGT GAAGCAAGTT CAGGACCCCA CAGTAGAGAA
    AACCTATCCA CCAATGATTG TTTAGCTAAA AAGAACGTGA AGGCAGAGAC ACCAGTGCAT
    GAGCAAACCA CTTTAAGCAA GGAGAATTAC CTCTTCCCCA GAGGCCAAAT GTTTGATGAA
    AAGACCCTAG CCAGAGATTT TATTCAGGCA GCACAGAAGC AAATGGCTCA TGCAGTAAGA
    GGTAAGACAA TGCGTAGCAG CCCTGAGCTT TTCAATTCTA CTGCTCTTCC TCTACCTACA
    GACAGTCCCA CACATCAGCC TCTCCTCCTT CCACCACTGC AAACCCCAAA GCTGTATGGA
    AGCCCCACAC AGATCGGGCC AAGCTACAGA GGCATGATCA ATGTCTCCAC CTCATCTGAC
    ACGGACCATA ACTCTGCTGT ACCGGGGATG CCTGACTGTA GCCAGGTATC TAGTAACATA
    GGTGATGTCA TGTCCTTTTC AGTGACTGTC ACTACCATCC CTGCTAGCCA AGCTATGAAT
    CCCAGTAGCC ACGGCCAGAC CATTCCTGTT CAGGCCTTCC CTGAAGAAAA CAGCATAGAT
    AACACGCCTT CGAAATGTTA CTGCCGTTTG AAAGCTATGA TCATGTGCAA GGGGTGTGGA
    GCTTTCTGCC ACGATGATTG CATTGGCCCC TCTAAACTGT GTGTCTCTTG CCTTGTCGTT
    CGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq01800
    Clone ID Related Accession (Same CDS sequence) XM_014856748.1
    Accession Version XM_014856748.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4128bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product putative Polycomb group protein ASXL2 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014636848.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    ATGCCAGTTC TTTCCCGTAT ATGTAAACCT GATCGTAAGG GTTGGGATAC AAAGCTGAAG 
    CTAAGTATGA TGTCATCTAG CACAAACCTT TCAATGTTGT CTACTATGTA TTCCTTTCTT
    AGGACATCTA AGAGTCAGTT GAAATGCTGT CTTCCAAAAC TTGTGTATTC CAATGAACCA
    TGCTTCTTCA TATTCATGTC AGTATCGTCC AGACTGTCAC AGCCATCCTC TCCCCAGTCA
    GGCTGCCCAT CACCCACCAT TCCAGCAGGT AAAGTCATTT CTCCATCACA GAAGCACACC
    AAGAAGGCAC TAAAGCAGGC TCTAAAACAG CAACAACAGA AGAAGCAGCA GCAGCAATGC
    AGGCCAAGCA TGTCCATCTC GTCCAACCAG CATCTATCTC TGAAGACTGT CAAAGCAGCC
    AGTGACTCCG TACCTGCCAA ACCTGCGATG TGGGAAGGAA AGCAATCTGA TGGACAGTCA
    AGCAGCCCTC AGAACTCAAA TTCTAGCTTT GCTTCTTCAG TTAAAGTGGA AAATCCTTTG
    CTAAGCTTGG GGAAGAAGTC ATTCCAGAGG TCTGACAGGC TCCACACAAG GCAAATGAAA
    AGAACTAAAT GTGCTGAAAT TGATGTTGAG ACACCAGACT CCATTCTGGT TAATACAAAT
    CTACGAGCAC TGATCAACAA ACACACCTTT TCAGTCCTTC CTGGAGATTG CCAACAGCGA
    TTGCTTTTAC TACTTCCAGA GGTGGATCGA CAGATTGGTC CAGATGGTCT GATGAAGTTA
    AATGGCTCAG CCCTTAACAA TGAGTTCTTC ACTTCAGCAG CCCAAGGCTG GAAGGAAAGA
    CTCTCAGAAG GTGAGTTTAC ACCTGAGATG CAGGTGAGAA TTCGACAAGA GATTGAGAAG
    GAGAAAAAAG TAGAGCCATG GAAAGAACAA TTCTTTGAAA GCTACTATGG TCAGAGTTCT
    GGCCTGAGCC TTGAGGATTC AAAGAAATTA ACGGGTTCAC CCAGTGATTC CAAAGTAAAG
    AAAACCCCAG CTGAGCAACC AAAATCCATG CTTCCTTCAG AGGCCTCTCC TCTCAGTGTA
    GTCCCAGTAA TTCCCCAGTT AGAGTCTAAA GAAGAAGAAG TACCAATGCC ATCACCAGTC
    AGAAAAGAGG AGCGCGAAAG CCAAGATAAG GTGCAGCCAA GCTCCAAATC CACAGAGCCC
    CTACTTTCCT CAGCTAGCAA TGCAAATGAG CTTAGCAGTG TTCTTTCCAT CAAGTGCCCA
    AAGGACGAGG ATCATTTGGA GCAGAAGCCA GTTGCCTCTG CTGAACAGGA GTCTGAGAAG
    GAGAATCATC TCACTACAGC CTCTAATTAT AACAAAAATG AAAGCCAGGA AGCTTTAGTT
    ACATCTCCGA GCAAATCCAA GAGTCCTGAG GTGGAAAAAC CAATAATGAA GCCCATAGTA
    GAAGCAAGTC CACAGGAGGC CACTATGAAA GAGCTTCCGT CAGCTCTGGT TGACCACAGC
    CCAGAAAGCC TCAAGAGGAA AGCTTCTCTC ACCCAAGAAG AGTCCCCTAT GAGCTGGGAG
    AAGAGGCCAC GTGTCACAGA GAATCGCCAC CACCAGCAGC CATTTCAGGT CTCGCCACAG
    CCCTTTCTCA ATAGAGTGGA CAGGATCCCG GTGCGAAAAG TACCACCTCT CAAGATCCCA
    GTCTCCAGAA TCTCCCCCAT GCCGTTTCCT ACATCGCAGG TCTCTCCCAG GGCTCGTTTT
    CCAGTCTCCA TCACTAGTCC TAACAGAACA GGAGCCAGAA CTCTTGCAGA CATCAAAGCA
    AAAGCCCAGC TGGTCAAAGC ACAGAGGGCA GCAGCTGCCG CTGCAGCTGC CGCTGCTGCA
    GCCGCCTCAG TTGGAGGGAC CATTCCAGGA CCTGGCCCAG GGGGTGGACA AGGTCCAGGA
    GAGGGTGGTG AAAGGAAAAC TGCTAGAGGA GGGAGTCCAA ACTCAGAAAG AGTCGGTGAA
    ACTGGAAAGG GCCCCACACT GGAACTGGCA GGAACTGGAA GCAGGGGAGG TACGAGAGAG
    CTTTTACCCT CTGGTCCAGA CACTCAGCCC CAATCTGAGA CCAAGACCCC AGGCCAGGCA
    CAGCCTCATA GTGTCTCTGG AGCACAACTA CAGCAAACCC CCTCAGTGCC TCCAATATCT
    GCCATCAGTG GAGCATGCAC AAGTGTCCCA TCACCAGCCC ACACTAATGC ACCCCCACCA
    GCTTTAGTGA AATTGAATAA TGAAAAACTG AATCCCTCCA GGGCAGCAGC CACCATGGCC
    TCTCTAAGCC ACCCACCGTG GCCCAGTAAT TGCTGGCAAG AGAAAGCACC TTCTACTCCA
    GCAGATCCTG CTCATTTTAC TGCTGATGGC ACAGCTGAGC CCAAAGCAGC TTCTAGTAAG
    AATCCACCAA ACCCTTCAGC CTCAGCAGAG ACAAATGCTA GTGCTTCAGT GGATATGACT
    CCCTCCCCTT TAACATCTTT ATTAACAACA GCCACTTTAG AAAAGCTTCC TGTACCCCAG
    GTCAGTGTAA CTGTAGCACC TACCGGATCA GCTCTATCCT TGAGCACTTT GCCAGCAGCT
    TCTAGCCTTA AAACTCCAGG AATTTCTTCA AATATGAATG GACCCATTTC AAGGCCAAGT
    TCTAGTATCC CTGCTAATAA TCCTCTGGTC ACTCAGCTGC TCCAGGGCAA AGATGTTCCC
    ATGGAGCAAA TTCTGCCTAA ACCTCTCACC AAAGTTGAAA TGAAAACTGT TCCACTGACT
    ACAAAAGAGG AAAAGGGGAT AGGAGCACTC ACAGGCACCA ACATAACAGA AAATAGCACC
    AGAGAGGAAG GTAACGAGAG GCAGTCTCAT CCAGCTATAC AGCAGCTGGG GAAAACCTTG
    CAGAGTAAGC AGCTCCCCCA GGTTCCAAGG CCCCTTCAGC TCTTTTCAGG TAAGGATCTG
    AGGGAGTCTA GCATTGACAC ACACCAATAC CGAGAAGGAC TAAGTAAAGC AACCCAAGAG
    CAGATCCTTC AGACTCTCAT CCAAAGGGTT CAGAGGCAAA ATGTTTCCTC GTTTGCACAG
    CCCTCTCAGT TCAACTTCAC TCACTCAGGT TTCCAGTTAG AAGACCTCTC CATAAGCCAG
    AGGTTCATGC TGGGTTTTGC TGGCAGAAGG ACATCAAAGC CTGCAATGGC AGGTCACTAC
    TTACTTAACA TTTCCACCTA TGGCCGGGGT TCAGAGAGCT TTAGGAGGAC CCATTCTGTA
    AACCCTGAAG ACCGTTTTTG TCTAAGTAGC CCCACTGAGG CCTTGAAAAT GGGATATACA
    GACTGTAAAA ATGCAACAGG AGATAGTAGC AGCAGCAAAG AAGAAGATAC TGATGAGGAA
    AGTACTGGTG ATGAGCAAGA ATCTATCATG GTGAAGGAGG AGCCCCAGGC TGCCCAGAGT
    TCTGGCAAGT GTGAAGCAAG TTCAGGACCC CACAGTAGAG AAAACCTATC CACCAATGAT
    TGTTTAGCTA AAAAGAACGT GAAGGCAGAG ACACCAGTGC ATGAGCAAAC CACTTTAAGC
    AAGGAGAATT ACCTCTTCCC CAGAGGCCAA ATGTTTGATG AAAAGACCCT AGCCAGAGAT
    TTTATTCAGG CAGCACAGAA GCAAATGGCT CATGCAGTAA GAGGTAAGAC AATGCGTAGC
    AGCCCTGAGC TTTTCAATTC TACTGCTCTT CCTCTACCTA CAGACAGTCC CACACATCAG
    CCTCTCCTCC TTCCACCACT GCAAACCCCA AAGCTGTATG GAAGCCCCAC ACAGATCGGG
    CCAAGCTACA GAGGCATGAT CAATGTCTCC ACCTCATCTG ACACGGACCA TAACTCTGCT
    GTACCGGGGA TGCCTGACTG TAGCCAGGTA TCTAGTAACA TAGGTGATGT CATGTCCTTT
    TCAGTGACTG TCACTACCAT CCCTGCTAGC CAAGCTATGA ATCCCAGTAG CCACGGCCAG
    ACCATTCCTG TTCAGGCCTT CCCTGAAGAA AACAGCATAG ATAACACGCC TTCGAAATGT
    TACTGCCGTT TGAAAGCTAT GATCATGTGC AAGGGGTGTG GAGCTTTCTG CCACGATGAT
    TGCATTGGCC CCTCTAAACT GTGTGTCTCT TGCCTTGTCG TTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014712234.1
    CDS875..5002
    Translation

    Target ORF information:

    RefSeq Version XM_014856748.1
    Organism Equus asinus(ass)
    Definition Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014856748.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    ATGCCAGTTC TTTCCCGTAT ATGTAAACCT GATCGTAAGG GTTGGGATAC AAAGCTGAAG 
    CTAAGTATGA TGTCATCTAG CACAAACCTT TCAATGTTGT CTACTATGTA TTCCTTTCTT
    AGGACATCTA AGAGTCAGTT GAAATGCTGT CTTCCAAAAC TTGTGTATTC CAATGAACCA
    TGCTTCTTCA TATTCATGTC AGTATCGTCC AGACTGTCAC AGCCATCCTC TCCCCAGTCA
    GGCTGCCCAT CACCCACCAT TCCAGCAGGT AAAGTCATTT CTCCATCACA GAAGCACACC
    AAGAAGGCAC TAAAGCAGGC TCTAAAACAG CAACAACAGA AGAAGCAGCA GCAGCAATGC
    AGGCCAAGCA TGTCCATCTC GTCCAACCAG CATCTATCTC TGAAGACTGT CAAAGCAGCC
    AGTGACTCCG TACCTGCCAA ACCTGCGATG TGGGAAGGAA AGCAATCTGA TGGACAGTCA
    AGCAGCCCTC AGAACTCAAA TTCTAGCTTT GCTTCTTCAG TTAAAGTGGA AAATCCTTTG
    CTAAGCTTGG GGAAGAAGTC ATTCCAGAGG TCTGACAGGC TCCACACAAG GCAAATGAAA
    AGAACTAAAT GTGCTGAAAT TGATGTTGAG ACACCAGACT CCATTCTGGT TAATACAAAT
    CTACGAGCAC TGATCAACAA ACACACCTTT TCAGTCCTTC CTGGAGATTG CCAACAGCGA
    TTGCTTTTAC TACTTCCAGA GGTGGATCGA CAGATTGGTC CAGATGGTCT GATGAAGTTA
    AATGGCTCAG CCCTTAACAA TGAGTTCTTC ACTTCAGCAG CCCAAGGCTG GAAGGAAAGA
    CTCTCAGAAG GTGAGTTTAC ACCTGAGATG CAGGTGAGAA TTCGACAAGA GATTGAGAAG
    GAGAAAAAAG TAGAGCCATG GAAAGAACAA TTCTTTGAAA GCTACTATGG TCAGAGTTCT
    GGCCTGAGCC TTGAGGATTC AAAGAAATTA ACGGGTTCAC CCAGTGATTC CAAAGTAAAG
    AAAACCCCAG CTGAGCAACC AAAATCCATG CTTCCTTCAG AGGCCTCTCC TCTCAGTGTA
    GTCCCAGTAA TTCCCCAGTT AGAGTCTAAA GAAGAAGAAG TACCAATGCC ATCACCAGTC
    AGAAAAGAGG AGCGCGAAAG CCAAGATAAG GTGCAGCCAA GCTCCAAATC CACAGAGCCC
    CTACTTTCCT CAGCTAGCAA TGCAAATGAG CTTAGCAGTG TTCTTTCCAT CAAGTGCCCA
    AAGGACGAGG ATCATTTGGA GCAGAAGCCA GTTGCCTCTG CTGAACAGGA GTCTGAGAAG
    GAGAATCATC TCACTACAGC CTCTAATTAT AACAAAAATG AAAGCCAGGA AGCTTTAGTT
    ACATCTCCGA GCAAATCCAA GAGTCCTGAG GTGGAAAAAC CAATAATGAA GCCCATAGTA
    GAAGCAAGTC CACAGGAGGC CACTATGAAA GAGCTTCCGT CAGCTCTGGT TGACCACAGC
    CCAGAAAGCC TCAAGAGGAA AGCTTCTCTC ACCCAAGAAG AGTCCCCTAT GAGCTGGGAG
    AAGAGGCCAC GTGTCACAGA GAATCGCCAC CACCAGCAGC CATTTCAGGT CTCGCCACAG
    CCCTTTCTCA ATAGAGTGGA CAGGATCCCG GTGCGAAAAG TACCACCTCT CAAGATCCCA
    GTCTCCAGAA TCTCCCCCAT GCCGTTTCCT ACATCGCAGG TCTCTCCCAG GGCTCGTTTT
    CCAGTCTCCA TCACTAGTCC TAACAGAACA GGAGCCAGAA CTCTTGCAGA CATCAAAGCA
    AAAGCCCAGC TGGTCAAAGC ACAGAGGGCA GCAGCTGCCG CTGCAGCTGC CGCTGCTGCA
    GCCGCCTCAG TTGGAGGGAC CATTCCAGGA CCTGGCCCAG GGGGTGGACA AGGTCCAGGA
    GAGGGTGGTG AAAGGAAAAC TGCTAGAGGA GGGAGTCCAA ACTCAGAAAG AGTCGGTGAA
    ACTGGAAAGG GCCCCACACT GGAACTGGCA GGAACTGGAA GCAGGGGAGG TACGAGAGAG
    CTTTTACCCT CTGGTCCAGA CACTCAGCCC CAATCTGAGA CCAAGACCCC AGGCCAGGCA
    CAGCCTCATA GTGTCTCTGG AGCACAACTA CAGCAAACCC CCTCAGTGCC TCCAATATCT
    GCCATCAGTG GAGCATGCAC AAGTGTCCCA TCACCAGCCC ACACTAATGC ACCCCCACCA
    GCTTTAGTGA AATTGAATAA TGAAAAACTG AATCCCTCCA GGGCAGCAGC CACCATGGCC
    TCTCTAAGCC ACCCACCGTG GCCCAGTAAT TGCTGGCAAG AGAAAGCACC TTCTACTCCA
    GCAGATCCTG CTCATTTTAC TGCTGATGGC ACAGCTGAGC CCAAAGCAGC TTCTAGTAAG
    AATCCACCAA ACCCTTCAGC CTCAGCAGAG ACAAATGCTA GTGCTTCAGT GGATATGACT
    CCCTCCCCTT TAACATCTTT ATTAACAACA GCCACTTTAG AAAAGCTTCC TGTACCCCAG
    GTCAGTGTAA CTGTAGCACC TACCGGATCA GCTCTATCCT TGAGCACTTT GCCAGCAGCT
    TCTAGCCTTA AAACTCCAGG AATTTCTTCA AATATGAATG GACCCATTTC AAGGCCAAGT
    TCTAGTATCC CTGCTAATAA TCCTCTGGTC ACTCAGCTGC TCCAGGGCAA AGATGTTCCC
    ATGGAGCAAA TTCTGCCTAA ACCTCTCACC AAAGTTGAAA TGAAAACTGT TCCACTGACT
    ACAAAAGAGG AAAAGGGGAT AGGAGCACTC ACAGGCACCA ACATAACAGA AAATAGCACC
    AGAGAGGAAG GTAACGAGAG GCAGTCTCAT CCAGCTATAC AGCAGCTGGG GAAAACCTTG
    CAGAGTAAGC AGCTCCCCCA GGTTCCAAGG CCCCTTCAGC TCTTTTCAGG TAAGGATCTG
    AGGGAGTCTA GCATTGACAC ACACCAATAC CGAGAAGGAC TAAGTAAAGC AACCCAAGAG
    CAGATCCTTC AGACTCTCAT CCAAAGGGTT CAGAGGCAAA ATGTTTCCTC GTTTGCACAG
    CCCTCTCAGT TCAACTTCAC TCACTCAGGT TTCCAGTTAG AAGACCTCTC CATAAGCCAG
    AGGTTCATGC TGGGTTTTGC TGGCAGAAGG ACATCAAAGC CTGCAATGGC AGGTCACTAC
    TTACTTAACA TTTCCACCTA TGGCCGGGGT TCAGAGAGCT TTAGGAGGAC CCATTCTGTA
    AACCCTGAAG ACCGTTTTTG TCTAAGTAGC CCCACTGAGG CCTTGAAAAT GGGATATACA
    GACTGTAAAA ATGCAACAGG AGATAGTAGC AGCAGCAAAG AAGAAGATAC TGATGAGGAA
    AGTACTGGTG ATGAGCAAGA ATCTATCATG GTGAAGGAGG AGCCCCAGGC TGCCCAGAGT
    TCTGGCAAGT GTGAAGCAAG TTCAGGACCC CACAGTAGAG AAAACCTATC CACCAATGAT
    TGTTTAGCTA AAAAGAACGT GAAGGCAGAG ACACCAGTGC ATGAGCAAAC CACTTTAAGC
    AAGGAGAATT ACCTCTTCCC CAGAGGCCAA ATGTTTGATG AAAAGACCCT AGCCAGAGAT
    TTTATTCAGG CAGCACAGAA GCAAATGGCT CATGCAGTAA GAGGTAAGAC AATGCGTAGC
    AGCCCTGAGC TTTTCAATTC TACTGCTCTT CCTCTACCTA CAGACAGTCC CACACATCAG
    CCTCTCCTCC TTCCACCACT GCAAACCCCA AAGCTGTATG GAAGCCCCAC ACAGATCGGG
    CCAAGCTACA GAGGCATGAT CAATGTCTCC ACCTCATCTG ACACGGACCA TAACTCTGCT
    GTACCGGGGA TGCCTGACTG TAGCCAGGTA TCTAGTAACA TAGGTGATGT CATGTCCTTT
    TCAGTGACTG TCACTACCAT CCCTGCTAGC CAAGCTATGA ATCCCAGTAG CCACGGCCAG
    ACCATTCCTG TTCAGGCCTT CCCTGAAGAA AACAGCATAG ATAACACGCC TTCGAAATGT
    TACTGCCGTT TGAAAGCTAT GATCATGTGC AAGGGGTGTG GAGCTTTCTG CCACGATGAT
    TGCATTGGCC CCTCTAAACT GTGTGTCTCT TGCCTTGTCG TTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq01801
    Clone ID Related Accession (Same CDS sequence) XM_014856758.1
    Accession Version XM_014856758.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3963bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product putative Polycomb group protein ASXL2 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014636848.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    ATGTTCAAAG AAGAGCTTTA TGGAATTCCA AACCAAGTAT CGTCCAGACT GTCACAGCCA 
    TCCTCTCCCC AGTCAGGCTG CCCATCACCC ACCATTCCAG CAGGTAAAGT CATTTCTCCA
    TCACAGAAGC ACACCAAGAA GGCACTAAAG CAGGCTCTAA AACAGCAACA ACAGAAGAAG
    CAGCAGCAGC AATGCAGGCC AAGCATGTCC ATCTCGTCCA ACCAGCATCT ATCTCTGAAG
    ACTGTCAAAG CAGCCAGTGA CTCCGTACCT GCCAAACCTG CGATGTGGGA AGGAAAGCAA
    TCTGATGGAC AGTCAAGCAG CCCTCAGAAC TCAAATTCTA GCTTTGCTTC TTCAGTTAAA
    GTGGAAAATC CTTTGCTAAG CTTGGGGAAG AAGTCATTCC AGAGGTCTGA CAGGCTCCAC
    ACAAGGCAAA TGAAAAGAAC TAAATGTGCT GAAATTGATG TTGAGACACC AGACTCCATT
    CTGGTTAATA CAAATCTACG AGCACTGATC AACAAACACA CCTTTTCAGT CCTTCCTGGA
    GATTGCCAAC AGCGATTGCT TTTACTACTT CCAGAGGTGG ATCGACAGAT TGGTCCAGAT
    GGTCTGATGA AGTTAAATGG CTCAGCCCTT AACAATGAGT TCTTCACTTC AGCAGCCCAA
    GGCTGGAAGG AAAGACTCTC AGAAGGTGAG TTTACACCTG AGATGCAGGT GAGAATTCGA
    CAAGAGATTG AGAAGGAGAA AAAAGTAGAG CCATGGAAAG AACAATTCTT TGAAAGCTAC
    TATGGTCAGA GTTCTGGCCT GAGCCTTGAG GATTCAAAGA AATTAACGGG TTCACCCAGT
    GATTCCAAAG TAAAGAAAAC CCCAGCTGAG CAACCAAAAT CCATGCTTCC TTCAGAGGCC
    TCTCCTCTCA GTGTAGTCCC AGTAATTCCC CAGTTAGAGT CTAAAGAAGA AGAAGTACCA
    ATGCCATCAC CAGTCAGAAA AGAGGAGCGC GAAAGCCAAG ATAAGGTGCA GCCAAGCTCC
    AAATCCACAG AGCCCCTACT TTCCTCAGCT AGCAATGCAA ATGAGCTTAG CAGTGTTCTT
    TCCATCAAGT GCCCAAAGGA CGAGGATCAT TTGGAGCAGA AGCCAGTTGC CTCTGCTGAA
    CAGGAGTCTG AGAAGGAGAA TCATCTCACT ACAGCCTCTA ATTATAACAA AAATGAAAGC
    CAGGAAGCTT TAGTTACATC TCCGAGCAAA TCCAAGAGTC CTGAGGTGGA AAAACCAATA
    ATGAAGCCCA TAGTAGAAGC AAGTCCACAG GAGGCCACTA TGAAAGAGCT TCCGTCAGCT
    CTGGTTGACC ACAGCCCAGA AAGCCTCAAG AGGAAAGCTT CTCTCACCCA AGAAGAGTCC
    CCTATGAGCT GGGAGAAGAG GCCACGTGTC ACAGAGAATC GCCACCACCA GCAGCCATTT
    CAGGTCTCGC CACAGCCCTT TCTCAATAGA GTGGACAGGA TCCCGGTGCG AAAAGTACCA
    CCTCTCAAGA TCCCAGTCTC CAGAATCTCC CCCATGCCGT TTCCTACATC GCAGGTCTCT
    CCCAGGGCTC GTTTTCCAGT CTCCATCACT AGTCCTAACA GAACAGGAGC CAGAACTCTT
    GCAGACATCA AAGCAAAAGC CCAGCTGGTC AAAGCACAGA GGGCAGCAGC TGCCGCTGCA
    GCTGCCGCTG CTGCAGCCGC CTCAGTTGGA GGGACCATTC CAGGACCTGG CCCAGGGGGT
    GGACAAGGTC CAGGAGAGGG TGGTGAAAGG AAAACTGCTA GAGGAGGGAG TCCAAACTCA
    GAAAGAGTCG GTGAAACTGG AAAGGGCCCC ACACTGGAAC TGGCAGGAAC TGGAAGCAGG
    GGAGGTACGA GAGAGCTTTT ACCCTCTGGT CCAGACACTC AGCCCCAATC TGAGACCAAG
    ACCCCAGGCC AGGCACAGCC TCATAGTGTC TCTGGAGCAC AACTACAGCA AACCCCCTCA
    GTGCCTCCAA TATCTGCCAT CAGTGGAGCA TGCACAAGTG TCCCATCACC AGCCCACACT
    AATGCACCCC CACCAGCTTT AGTGAAATTG AATAATGAAA AACTGAATCC CTCCAGGGCA
    GCAGCCACCA TGGCCTCTCT AAGCCACCCA CCGTGGCCCA GTAATTGCTG GCAAGAGAAA
    GCACCTTCTA CTCCAGCAGA TCCTGCTCAT TTTACTGCTG ATGGCACAGC TGAGCCCAAA
    GCAGCTTCTA GTAAGAATCC ACCAAACCCT TCAGCCTCAG CAGAGACAAA TGCTAGTGCT
    TCAGTGGATA TGACTCCCTC CCCTTTAACA TCTTTATTAA CAACAGCCAC TTTAGAAAAG
    CTTCCTGTAC CCCAGGTCAG TGTAACTGTA GCACCTACCG GATCAGCTCT ATCCTTGAGC
    ACTTTGCCAG CAGCTTCTAG CCTTAAAACT CCAGGAATTT CTTCAAATAT GAATGGACCC
    ATTTCAAGGC CAAGTTCTAG TATCCCTGCT AATAATCCTC TGGTCACTCA GCTGCTCCAG
    GGCAAAGATG TTCCCATGGA GCAAATTCTG CCTAAACCTC TCACCAAAGT TGAAATGAAA
    ACTGTTCCAC TGACTACAAA AGAGGAAAAG GGGATAGGAG CACTCACAGG CACCAACATA
    ACAGAAAATA GCACCAGAGA GGAAGGTAAC GAGAGGCAGT CTCATCCAGC TATACAGCAG
    CTGGGGAAAA CCTTGCAGAG TAAGCAGCTC CCCCAGGTTC CAAGGCCCCT TCAGCTCTTT
    TCAGGTAAGG ATCTGAGGGA GTCTAGCATT GACACACACC AATACCGAGA AGGACTAAGT
    AAAGCAACCC AAGAGCAGAT CCTTCAGACT CTCATCCAAA GGGTTCAGAG GCAAAATGTT
    TCCTCGTTTG CACAGCCCTC TCAGTTCAAC TTCACTCACT CAGGTTTCCA GTTAGAAGAC
    CTCTCCATAA GCCAGAGGTT CATGCTGGGT TTTGCTGGCA GAAGGACATC AAAGCCTGCA
    ATGGCAGGTC ACTACTTACT TAACATTTCC ACCTATGGCC GGGGTTCAGA GAGCTTTAGG
    AGGACCCATT CTGTAAACCC TGAAGACCGT TTTTGTCTAA GTAGCCCCAC TGAGGCCTTG
    AAAATGGGAT ATACAGACTG TAAAAATGCA ACAGGAGATA GTAGCAGCAG CAAAGAAGAA
    GATACTGATG AGGAAAGTAC TGGTGATGAG CAAGAATCTA TCATGGTGAA GGAGGAGCCC
    CAGGCTGCCC AGAGTTCTGG CAAGTGTGAA GCAAGTTCAG GACCCCACAG TAGAGAAAAC
    CTATCCACCA ATGATTGTTT AGCTAAAAAG AACGTGAAGG CAGAGACACC AGTGCATGAG
    CAAACCACTT TAAGCAAGGA GAATTACCTC TTCCCCAGAG GCCAAATGTT TGATGAAAAG
    ACCCTAGCCA GAGATTTTAT TCAGGCAGCA CAGAAGCAAA TGGCTCATGC AGTAAGAGGT
    AAGACAATGC GTAGCAGCCC TGAGCTTTTC AATTCTACTG CTCTTCCTCT ACCTACAGAC
    AGTCCCACAC ATCAGCCTCT CCTCCTTCCA CCACTGCAAA CCCCAAAGCT GTATGGAAGC
    CCCACACAGA TCGGGCCAAG CTACAGAGGC ATGATCAATG TCTCCACCTC ATCTGACACG
    GACCATAACT CTGCTGTACC GGGGATGCCT GACTGTAGCC AGGTATCTAG TAACATAGGT
    GATGTCATGT CCTTTTCAGT GACTGTCACT ACCATCCCTG CTAGCCAAGC TATGAATCCC
    AGTAGCCACG GCCAGACCAT TCCTGTTCAG GCCTTCCCTG AAGAAAACAG CATAGATAAC
    ACGCCTTCGA AATGTTACTG CCGTTTGAAA GCTATGATCA TGTGCAAGGG GTGTGGAGCT
    TTCTGCCACG ATGATTGCAT TGGCCCCTCT AAACTGTGTG TCTCTTGCCT TGTCGTTCGG
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014712244.1
    CDS769..4731
    Translation

    Target ORF information:

    RefSeq Version XM_014856758.1
    Organism Equus asinus(ass)
    Definition Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014856758.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    ATGTTCAAAG AAGAGCTTTA TGGAATTCCA AACCAAGTAT CGTCCAGACT GTCACAGCCA 
    TCCTCTCCCC AGTCAGGCTG CCCATCACCC ACCATTCCAG CAGGTAAAGT CATTTCTCCA
    TCACAGAAGC ACACCAAGAA GGCACTAAAG CAGGCTCTAA AACAGCAACA ACAGAAGAAG
    CAGCAGCAGC AATGCAGGCC AAGCATGTCC ATCTCGTCCA ACCAGCATCT ATCTCTGAAG
    ACTGTCAAAG CAGCCAGTGA CTCCGTACCT GCCAAACCTG CGATGTGGGA AGGAAAGCAA
    TCTGATGGAC AGTCAAGCAG CCCTCAGAAC TCAAATTCTA GCTTTGCTTC TTCAGTTAAA
    GTGGAAAATC CTTTGCTAAG CTTGGGGAAG AAGTCATTCC AGAGGTCTGA CAGGCTCCAC
    ACAAGGCAAA TGAAAAGAAC TAAATGTGCT GAAATTGATG TTGAGACACC AGACTCCATT
    CTGGTTAATA CAAATCTACG AGCACTGATC AACAAACACA CCTTTTCAGT CCTTCCTGGA
    GATTGCCAAC AGCGATTGCT TTTACTACTT CCAGAGGTGG ATCGACAGAT TGGTCCAGAT
    GGTCTGATGA AGTTAAATGG CTCAGCCCTT AACAATGAGT TCTTCACTTC AGCAGCCCAA
    GGCTGGAAGG AAAGACTCTC AGAAGGTGAG TTTACACCTG AGATGCAGGT GAGAATTCGA
    CAAGAGATTG AGAAGGAGAA AAAAGTAGAG CCATGGAAAG AACAATTCTT TGAAAGCTAC
    TATGGTCAGA GTTCTGGCCT GAGCCTTGAG GATTCAAAGA AATTAACGGG TTCACCCAGT
    GATTCCAAAG TAAAGAAAAC CCCAGCTGAG CAACCAAAAT CCATGCTTCC TTCAGAGGCC
    TCTCCTCTCA GTGTAGTCCC AGTAATTCCC CAGTTAGAGT CTAAAGAAGA AGAAGTACCA
    ATGCCATCAC CAGTCAGAAA AGAGGAGCGC GAAAGCCAAG ATAAGGTGCA GCCAAGCTCC
    AAATCCACAG AGCCCCTACT TTCCTCAGCT AGCAATGCAA ATGAGCTTAG CAGTGTTCTT
    TCCATCAAGT GCCCAAAGGA CGAGGATCAT TTGGAGCAGA AGCCAGTTGC CTCTGCTGAA
    CAGGAGTCTG AGAAGGAGAA TCATCTCACT ACAGCCTCTA ATTATAACAA AAATGAAAGC
    CAGGAAGCTT TAGTTACATC TCCGAGCAAA TCCAAGAGTC CTGAGGTGGA AAAACCAATA
    ATGAAGCCCA TAGTAGAAGC AAGTCCACAG GAGGCCACTA TGAAAGAGCT TCCGTCAGCT
    CTGGTTGACC ACAGCCCAGA AAGCCTCAAG AGGAAAGCTT CTCTCACCCA AGAAGAGTCC
    CCTATGAGCT GGGAGAAGAG GCCACGTGTC ACAGAGAATC GCCACCACCA GCAGCCATTT
    CAGGTCTCGC CACAGCCCTT TCTCAATAGA GTGGACAGGA TCCCGGTGCG AAAAGTACCA
    CCTCTCAAGA TCCCAGTCTC CAGAATCTCC CCCATGCCGT TTCCTACATC GCAGGTCTCT
    CCCAGGGCTC GTTTTCCAGT CTCCATCACT AGTCCTAACA GAACAGGAGC CAGAACTCTT
    GCAGACATCA AAGCAAAAGC CCAGCTGGTC AAAGCACAGA GGGCAGCAGC TGCCGCTGCA
    GCTGCCGCTG CTGCAGCCGC CTCAGTTGGA GGGACCATTC CAGGACCTGG CCCAGGGGGT
    GGACAAGGTC CAGGAGAGGG TGGTGAAAGG AAAACTGCTA GAGGAGGGAG TCCAAACTCA
    GAAAGAGTCG GTGAAACTGG AAAGGGCCCC ACACTGGAAC TGGCAGGAAC TGGAAGCAGG
    GGAGGTACGA GAGAGCTTTT ACCCTCTGGT CCAGACACTC AGCCCCAATC TGAGACCAAG
    ACCCCAGGCC AGGCACAGCC TCATAGTGTC TCTGGAGCAC AACTACAGCA AACCCCCTCA
    GTGCCTCCAA TATCTGCCAT CAGTGGAGCA TGCACAAGTG TCCCATCACC AGCCCACACT
    AATGCACCCC CACCAGCTTT AGTGAAATTG AATAATGAAA AACTGAATCC CTCCAGGGCA
    GCAGCCACCA TGGCCTCTCT AAGCCACCCA CCGTGGCCCA GTAATTGCTG GCAAGAGAAA
    GCACCTTCTA CTCCAGCAGA TCCTGCTCAT TTTACTGCTG ATGGCACAGC TGAGCCCAAA
    GCAGCTTCTA GTAAGAATCC ACCAAACCCT TCAGCCTCAG CAGAGACAAA TGCTAGTGCT
    TCAGTGGATA TGACTCCCTC CCCTTTAACA TCTTTATTAA CAACAGCCAC TTTAGAAAAG
    CTTCCTGTAC CCCAGGTCAG TGTAACTGTA GCACCTACCG GATCAGCTCT ATCCTTGAGC
    ACTTTGCCAG CAGCTTCTAG CCTTAAAACT CCAGGAATTT CTTCAAATAT GAATGGACCC
    ATTTCAAGGC CAAGTTCTAG TATCCCTGCT AATAATCCTC TGGTCACTCA GCTGCTCCAG
    GGCAAAGATG TTCCCATGGA GCAAATTCTG CCTAAACCTC TCACCAAAGT TGAAATGAAA
    ACTGTTCCAC TGACTACAAA AGAGGAAAAG GGGATAGGAG CACTCACAGG CACCAACATA
    ACAGAAAATA GCACCAGAGA GGAAGGTAAC GAGAGGCAGT CTCATCCAGC TATACAGCAG
    CTGGGGAAAA CCTTGCAGAG TAAGCAGCTC CCCCAGGTTC CAAGGCCCCT TCAGCTCTTT
    TCAGGTAAGG ATCTGAGGGA GTCTAGCATT GACACACACC AATACCGAGA AGGACTAAGT
    AAAGCAACCC AAGAGCAGAT CCTTCAGACT CTCATCCAAA GGGTTCAGAG GCAAAATGTT
    TCCTCGTTTG CACAGCCCTC TCAGTTCAAC TTCACTCACT CAGGTTTCCA GTTAGAAGAC
    CTCTCCATAA GCCAGAGGTT CATGCTGGGT TTTGCTGGCA GAAGGACATC AAAGCCTGCA
    ATGGCAGGTC ACTACTTACT TAACATTTCC ACCTATGGCC GGGGTTCAGA GAGCTTTAGG
    AGGACCCATT CTGTAAACCC TGAAGACCGT TTTTGTCTAA GTAGCCCCAC TGAGGCCTTG
    AAAATGGGAT ATACAGACTG TAAAAATGCA ACAGGAGATA GTAGCAGCAG CAAAGAAGAA
    GATACTGATG AGGAAAGTAC TGGTGATGAG CAAGAATCTA TCATGGTGAA GGAGGAGCCC
    CAGGCTGCCC AGAGTTCTGG CAAGTGTGAA GCAAGTTCAG GACCCCACAG TAGAGAAAAC
    CTATCCACCA ATGATTGTTT AGCTAAAAAG AACGTGAAGG CAGAGACACC AGTGCATGAG
    CAAACCACTT TAAGCAAGGA GAATTACCTC TTCCCCAGAG GCCAAATGTT TGATGAAAAG
    ACCCTAGCCA GAGATTTTAT TCAGGCAGCA CAGAAGCAAA TGGCTCATGC AGTAAGAGGT
    AAGACAATGC GTAGCAGCCC TGAGCTTTTC AATTCTACTG CTCTTCCTCT ACCTACAGAC
    AGTCCCACAC ATCAGCCTCT CCTCCTTCCA CCACTGCAAA CCCCAAAGCT GTATGGAAGC
    CCCACACAGA TCGGGCCAAG CTACAGAGGC ATGATCAATG TCTCCACCTC ATCTGACACG
    GACCATAACT CTGCTGTACC GGGGATGCCT GACTGTAGCC AGGTATCTAG TAACATAGGT
    GATGTCATGT CCTTTTCAGT GACTGTCACT ACCATCCCTG CTAGCCAAGC TATGAATCCC
    AGTAGCCACG GCCAGACCAT TCCTGTTCAG GCCTTCCCTG AAGAAAACAG CATAGATAAC
    ACGCCTTCGA AATGTTACTG CCGTTTGAAA GCTATGATCA TGTGCAAGGG GTGTGGAGCT
    TTCTGCCACG ATGATTGCAT TGGCCCCTCT AAACTGTGTG TCTCTTGCCT TGTCGTTCGG
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq01802
    Clone ID Related Accession (Same CDS sequence) XM_014856767.1 , XM_014856782.1 , XM_014856774.1
    Accession Version XM_014856767.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3759bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product putative Polycomb group protein ASXL2 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014636848.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTCCATCT CGTCCAACCA GCATCTATCT CTGAAGACTG TCAAAGCAGC CAGTGACTCC 
    GTACCTGCCA AACCTGCGAT GTGGGAAGGA AAGCAATCTG ATGGACAGTC AAGCAGCCCT
    CAGAACTCAA ATTCTAGCTT TGCTTCTTCA GTTAAAGTGG AAAATCCTTT GCTAAGCTTG
    GGGAAGAAGT CATTCCAGAG GTCTGACAGG CTCCACACAA GGCAAATGAA AAGAACTAAA
    TGTGCTGAAA TTGATGTTGA GACACCAGAC TCCATTCTGG TTAATACAAA TCTACGAGCA
    CTGATCAACA AACACACCTT TTCAGTCCTT CCTGGAGATT GCCAACAGCG ATTGCTTTTA
    CTACTTCCAG AGGTGGATCG ACAGATTGGT CCAGATGGTC TGATGAAGTT AAATGGCTCA
    GCCCTTAACA ATGAGTTCTT CACTTCAGCA GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA
    GGTGAGTTTA CACCTGAGAT GCAGGTGAGA ATTCGACAAG AGATTGAGAA GGAGAAAAAA
    GTAGAGCCAT GGAAAGAACA ATTCTTTGAA AGCTACTATG GTCAGAGTTC TGGCCTGAGC
    CTTGAGGATT CAAAGAAATT AACGGGTTCA CCCAGTGATT CCAAAGTAAA GAAAACCCCA
    GCTGAGCAAC CAAAATCCAT GCTTCCTTCA GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA
    ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA GTACCAATGC CATCACCAGT CAGAAAAGAG
    GAGCGCGAAA GCCAAGATAA GGTGCAGCCA AGCTCCAAAT CCACAGAGCC CCTACTTTCC
    TCAGCTAGCA ATGCAAATGA GCTTAGCAGT GTTCTTTCCA TCAAGTGCCC AAAGGACGAG
    GATCATTTGG AGCAGAAGCC AGTTGCCTCT GCTGAACAGG AGTCTGAGAA GGAGAATCAT
    CTCACTACAG CCTCTAATTA TAACAAAAAT GAAAGCCAGG AAGCTTTAGT TACATCTCCG
    AGCAAATCCA AGAGTCCTGA GGTGGAAAAA CCAATAATGA AGCCCATAGT AGAAGCAAGT
    CCACAGGAGG CCACTATGAA AGAGCTTCCG TCAGCTCTGG TTGACCACAG CCCAGAAAGC
    CTCAAGAGGA AAGCTTCTCT CACCCAAGAA GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA
    CGTGTCACAG AGAATCGCCA CCACCAGCAG CCATTTCAGG TCTCGCCACA GCCCTTTCTC
    AATAGAGTGG ACAGGATCCC GGTGCGAAAA GTACCACCTC TCAAGATCCC AGTCTCCAGA
    ATCTCCCCCA TGCCGTTTCC TACATCGCAG GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC
    ATCACTAGTC CTAACAGAAC AGGAGCCAGA ACTCTTGCAG ACATCAAAGC AAAAGCCCAG
    CTGGTCAAAG CACAGAGGGC AGCAGCTGCC GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA
    GTTGGAGGGA CCATTCCAGG ACCTGGCCCA GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT
    GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA AACTCAGAAA GAGTCGGTGA AACTGGAAAG
    GGCCCCACAC TGGAACTGGC AGGAACTGGA AGCAGGGGAG GTACGAGAGA GCTTTTACCC
    TCTGGTCCAG ACACTCAGCC CCAATCTGAG ACCAAGACCC CAGGCCAGGC ACAGCCTCAT
    AGTGTCTCTG GAGCACAACT ACAGCAAACC CCCTCAGTGC CTCCAATATC TGCCATCAGT
    GGAGCATGCA CAAGTGTCCC ATCACCAGCC CACACTAATG CACCCCCACC AGCTTTAGTG
    AAATTGAATA ATGAAAAACT GAATCCCTCC AGGGCAGCAG CCACCATGGC CTCTCTAAGC
    CACCCACCGT GGCCCAGTAA TTGCTGGCAA GAGAAAGCAC CTTCTACTCC AGCAGATCCT
    GCTCATTTTA CTGCTGATGG CACAGCTGAG CCCAAAGCAG CTTCTAGTAA GAATCCACCA
    AACCCTTCAG CCTCAGCAGA GACAAATGCT AGTGCTTCAG TGGATATGAC TCCCTCCCCT
    TTAACATCTT TATTAACAAC AGCCACTTTA GAAAAGCTTC CTGTACCCCA GGTCAGTGTA
    ACTGTAGCAC CTACCGGATC AGCTCTATCC TTGAGCACTT TGCCAGCAGC TTCTAGCCTT
    AAAACTCCAG GAATTTCTTC AAATATGAAT GGACCCATTT CAAGGCCAAG TTCTAGTATC
    CCTGCTAATA ATCCTCTGGT CACTCAGCTG CTCCAGGGCA AAGATGTTCC CATGGAGCAA
    ATTCTGCCTA AACCTCTCAC CAAAGTTGAA ATGAAAACTG TTCCACTGAC TACAAAAGAG
    GAAAAGGGGA TAGGAGCACT CACAGGCACC AACATAACAG AAAATAGCAC CAGAGAGGAA
    GGTAACGAGA GGCAGTCTCA TCCAGCTATA CAGCAGCTGG GGAAAACCTT GCAGAGTAAG
    CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG CTCTTTTCAG GTAAGGATCT GAGGGAGTCT
    AGCATTGACA CACACCAATA CCGAGAAGGA CTAAGTAAAG CAACCCAAGA GCAGATCCTT
    CAGACTCTCA TCCAAAGGGT TCAGAGGCAA AATGTTTCCT CGTTTGCACA GCCCTCTCAG
    TTCAACTTCA CTCACTCAGG TTTCCAGTTA GAAGACCTCT CCATAAGCCA GAGGTTCATG
    CTGGGTTTTG CTGGCAGAAG GACATCAAAG CCTGCAATGG CAGGTCACTA CTTACTTAAC
    ATTTCCACCT ATGGCCGGGG TTCAGAGAGC TTTAGGAGGA CCCATTCTGT AAACCCTGAA
    GACCGTTTTT GTCTAAGTAG CCCCACTGAG GCCTTGAAAA TGGGATATAC AGACTGTAAA
    AATGCAACAG GAGATAGTAG CAGCAGCAAA GAAGAAGATA CTGATGAGGA AAGTACTGGT
    GATGAGCAAG AATCTATCAT GGTGAAGGAG GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG
    TGTGAAGCAA GTTCAGGACC CCACAGTAGA GAAAACCTAT CCACCAATGA TTGTTTAGCT
    AAAAAGAACG TGAAGGCAGA GACACCAGTG CATGAGCAAA CCACTTTAAG CAAGGAGAAT
    TACCTCTTCC CCAGAGGCCA AATGTTTGAT GAAAAGACCC TAGCCAGAGA TTTTATTCAG
    GCAGCACAGA AGCAAATGGC TCATGCAGTA AGAGGTAAGA CAATGCGTAG CAGCCCTGAG
    CTTTTCAATT CTACTGCTCT TCCTCTACCT ACAGACAGTC CCACACATCA GCCTCTCCTC
    CTTCCACCAC TGCAAACCCC AAAGCTGTAT GGAAGCCCCA CACAGATCGG GCCAAGCTAC
    AGAGGCATGA TCAATGTCTC CACCTCATCT GACACGGACC ATAACTCTGC TGTACCGGGG
    ATGCCTGACT GTAGCCAGGT ATCTAGTAAC ATAGGTGATG TCATGTCCTT TTCAGTGACT
    GTCACTACCA TCCCTGCTAG CCAAGCTATG AATCCCAGTA GCCACGGCCA GACCATTCCT
    GTTCAGGCCT TCCCTGAAGA AAACAGCATA GATAACACGC CTTCGAAATG TTACTGCCGT
    TTGAAAGCTA TGATCATGTG CAAGGGGTGT GGAGCTTTCT GCCACGATGA TTGCATTGGC
    CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014712253.1
    CDS675..4433
    Translation

    Target ORF information:

    RefSeq Version XM_014856767.1
    Organism Equus asinus(ass)
    Definition Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014856767.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTCCATCT CGTCCAACCA GCATCTATCT CTGAAGACTG TCAAAGCAGC CAGTGACTCC 
    GTACCTGCCA AACCTGCGAT GTGGGAAGGA AAGCAATCTG ATGGACAGTC AAGCAGCCCT
    CAGAACTCAA ATTCTAGCTT TGCTTCTTCA GTTAAAGTGG AAAATCCTTT GCTAAGCTTG
    GGGAAGAAGT CATTCCAGAG GTCTGACAGG CTCCACACAA GGCAAATGAA AAGAACTAAA
    TGTGCTGAAA TTGATGTTGA GACACCAGAC TCCATTCTGG TTAATACAAA TCTACGAGCA
    CTGATCAACA AACACACCTT TTCAGTCCTT CCTGGAGATT GCCAACAGCG ATTGCTTTTA
    CTACTTCCAG AGGTGGATCG ACAGATTGGT CCAGATGGTC TGATGAAGTT AAATGGCTCA
    GCCCTTAACA ATGAGTTCTT CACTTCAGCA GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA
    GGTGAGTTTA CACCTGAGAT GCAGGTGAGA ATTCGACAAG AGATTGAGAA GGAGAAAAAA
    GTAGAGCCAT GGAAAGAACA ATTCTTTGAA AGCTACTATG GTCAGAGTTC TGGCCTGAGC
    CTTGAGGATT CAAAGAAATT AACGGGTTCA CCCAGTGATT CCAAAGTAAA GAAAACCCCA
    GCTGAGCAAC CAAAATCCAT GCTTCCTTCA GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA
    ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA GTACCAATGC CATCACCAGT CAGAAAAGAG
    GAGCGCGAAA GCCAAGATAA GGTGCAGCCA AGCTCCAAAT CCACAGAGCC CCTACTTTCC
    TCAGCTAGCA ATGCAAATGA GCTTAGCAGT GTTCTTTCCA TCAAGTGCCC AAAGGACGAG
    GATCATTTGG AGCAGAAGCC AGTTGCCTCT GCTGAACAGG AGTCTGAGAA GGAGAATCAT
    CTCACTACAG CCTCTAATTA TAACAAAAAT GAAAGCCAGG AAGCTTTAGT TACATCTCCG
    AGCAAATCCA AGAGTCCTGA GGTGGAAAAA CCAATAATGA AGCCCATAGT AGAAGCAAGT
    CCACAGGAGG CCACTATGAA AGAGCTTCCG TCAGCTCTGG TTGACCACAG CCCAGAAAGC
    CTCAAGAGGA AAGCTTCTCT CACCCAAGAA GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA
    CGTGTCACAG AGAATCGCCA CCACCAGCAG CCATTTCAGG TCTCGCCACA GCCCTTTCTC
    AATAGAGTGG ACAGGATCCC GGTGCGAAAA GTACCACCTC TCAAGATCCC AGTCTCCAGA
    ATCTCCCCCA TGCCGTTTCC TACATCGCAG GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC
    ATCACTAGTC CTAACAGAAC AGGAGCCAGA ACTCTTGCAG ACATCAAAGC AAAAGCCCAG
    CTGGTCAAAG CACAGAGGGC AGCAGCTGCC GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA
    GTTGGAGGGA CCATTCCAGG ACCTGGCCCA GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT
    GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA AACTCAGAAA GAGTCGGTGA AACTGGAAAG
    GGCCCCACAC TGGAACTGGC AGGAACTGGA AGCAGGGGAG GTACGAGAGA GCTTTTACCC
    TCTGGTCCAG ACACTCAGCC CCAATCTGAG ACCAAGACCC CAGGCCAGGC ACAGCCTCAT
    AGTGTCTCTG GAGCACAACT ACAGCAAACC CCCTCAGTGC CTCCAATATC TGCCATCAGT
    GGAGCATGCA CAAGTGTCCC ATCACCAGCC CACACTAATG CACCCCCACC AGCTTTAGTG
    AAATTGAATA ATGAAAAACT GAATCCCTCC AGGGCAGCAG CCACCATGGC CTCTCTAAGC
    CACCCACCGT GGCCCAGTAA TTGCTGGCAA GAGAAAGCAC CTTCTACTCC AGCAGATCCT
    GCTCATTTTA CTGCTGATGG CACAGCTGAG CCCAAAGCAG CTTCTAGTAA GAATCCACCA
    AACCCTTCAG CCTCAGCAGA GACAAATGCT AGTGCTTCAG TGGATATGAC TCCCTCCCCT
    TTAACATCTT TATTAACAAC AGCCACTTTA GAAAAGCTTC CTGTACCCCA GGTCAGTGTA
    ACTGTAGCAC CTACCGGATC AGCTCTATCC TTGAGCACTT TGCCAGCAGC TTCTAGCCTT
    AAAACTCCAG GAATTTCTTC AAATATGAAT GGACCCATTT CAAGGCCAAG TTCTAGTATC
    CCTGCTAATA ATCCTCTGGT CACTCAGCTG CTCCAGGGCA AAGATGTTCC CATGGAGCAA
    ATTCTGCCTA AACCTCTCAC CAAAGTTGAA ATGAAAACTG TTCCACTGAC TACAAAAGAG
    GAAAAGGGGA TAGGAGCACT CACAGGCACC AACATAACAG AAAATAGCAC CAGAGAGGAA
    GGTAACGAGA GGCAGTCTCA TCCAGCTATA CAGCAGCTGG GGAAAACCTT GCAGAGTAAG
    CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG CTCTTTTCAG GTAAGGATCT GAGGGAGTCT
    AGCATTGACA CACACCAATA CCGAGAAGGA CTAAGTAAAG CAACCCAAGA GCAGATCCTT
    CAGACTCTCA TCCAAAGGGT TCAGAGGCAA AATGTTTCCT CGTTTGCACA GCCCTCTCAG
    TTCAACTTCA CTCACTCAGG TTTCCAGTTA GAAGACCTCT CCATAAGCCA GAGGTTCATG
    CTGGGTTTTG CTGGCAGAAG GACATCAAAG CCTGCAATGG CAGGTCACTA CTTACTTAAC
    ATTTCCACCT ATGGCCGGGG TTCAGAGAGC TTTAGGAGGA CCCATTCTGT AAACCCTGAA
    GACCGTTTTT GTCTAAGTAG CCCCACTGAG GCCTTGAAAA TGGGATATAC AGACTGTAAA
    AATGCAACAG GAGATAGTAG CAGCAGCAAA GAAGAAGATA CTGATGAGGA AAGTACTGGT
    GATGAGCAAG AATCTATCAT GGTGAAGGAG GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG
    TGTGAAGCAA GTTCAGGACC CCACAGTAGA GAAAACCTAT CCACCAATGA TTGTTTAGCT
    AAAAAGAACG TGAAGGCAGA GACACCAGTG CATGAGCAAA CCACTTTAAG CAAGGAGAAT
    TACCTCTTCC CCAGAGGCCA AATGTTTGAT GAAAAGACCC TAGCCAGAGA TTTTATTCAG
    GCAGCACAGA AGCAAATGGC TCATGCAGTA AGAGGTAAGA CAATGCGTAG CAGCCCTGAG
    CTTTTCAATT CTACTGCTCT TCCTCTACCT ACAGACAGTC CCACACATCA GCCTCTCCTC
    CTTCCACCAC TGCAAACCCC AAAGCTGTAT GGAAGCCCCA CACAGATCGG GCCAAGCTAC
    AGAGGCATGA TCAATGTCTC CACCTCATCT GACACGGACC ATAACTCTGC TGTACCGGGG
    ATGCCTGACT GTAGCCAGGT ATCTAGTAAC ATAGGTGATG TCATGTCCTT TTCAGTGACT
    GTCACTACCA TCCCTGCTAG CCAAGCTATG AATCCCAGTA GCCACGGCCA GACCATTCCT
    GTTCAGGCCT TCCCTGAAGA AAACAGCATA GATAACACGC CTTCGAAATG TTACTGCCGT
    TTGAAAGCTA TGATCATGTG CAAGGGGTGT GGAGCTTTCT GCCACGATGA TTGCATTGGC
    CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq01802
    Clone ID Related Accession (Same CDS sequence) XM_014856767.1 , XM_014856782.1 , XM_014856774.1
    Accession Version XM_014856782.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3759bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product putative Polycomb group protein ASXL2 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014636848.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTCCATCT CGTCCAACCA GCATCTATCT CTGAAGACTG TCAAAGCAGC CAGTGACTCC 
    GTACCTGCCA AACCTGCGAT GTGGGAAGGA AAGCAATCTG ATGGACAGTC AAGCAGCCCT
    CAGAACTCAA ATTCTAGCTT TGCTTCTTCA GTTAAAGTGG AAAATCCTTT GCTAAGCTTG
    GGGAAGAAGT CATTCCAGAG GTCTGACAGG CTCCACACAA GGCAAATGAA AAGAACTAAA
    TGTGCTGAAA TTGATGTTGA GACACCAGAC TCCATTCTGG TTAATACAAA TCTACGAGCA
    CTGATCAACA AACACACCTT TTCAGTCCTT CCTGGAGATT GCCAACAGCG ATTGCTTTTA
    CTACTTCCAG AGGTGGATCG ACAGATTGGT CCAGATGGTC TGATGAAGTT AAATGGCTCA
    GCCCTTAACA ATGAGTTCTT CACTTCAGCA GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA
    GGTGAGTTTA CACCTGAGAT GCAGGTGAGA ATTCGACAAG AGATTGAGAA GGAGAAAAAA
    GTAGAGCCAT GGAAAGAACA ATTCTTTGAA AGCTACTATG GTCAGAGTTC TGGCCTGAGC
    CTTGAGGATT CAAAGAAATT AACGGGTTCA CCCAGTGATT CCAAAGTAAA GAAAACCCCA
    GCTGAGCAAC CAAAATCCAT GCTTCCTTCA GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA
    ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA GTACCAATGC CATCACCAGT CAGAAAAGAG
    GAGCGCGAAA GCCAAGATAA GGTGCAGCCA AGCTCCAAAT CCACAGAGCC CCTACTTTCC
    TCAGCTAGCA ATGCAAATGA GCTTAGCAGT GTTCTTTCCA TCAAGTGCCC AAAGGACGAG
    GATCATTTGG AGCAGAAGCC AGTTGCCTCT GCTGAACAGG AGTCTGAGAA GGAGAATCAT
    CTCACTACAG CCTCTAATTA TAACAAAAAT GAAAGCCAGG AAGCTTTAGT TACATCTCCG
    AGCAAATCCA AGAGTCCTGA GGTGGAAAAA CCAATAATGA AGCCCATAGT AGAAGCAAGT
    CCACAGGAGG CCACTATGAA AGAGCTTCCG TCAGCTCTGG TTGACCACAG CCCAGAAAGC
    CTCAAGAGGA AAGCTTCTCT CACCCAAGAA GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA
    CGTGTCACAG AGAATCGCCA CCACCAGCAG CCATTTCAGG TCTCGCCACA GCCCTTTCTC
    AATAGAGTGG ACAGGATCCC GGTGCGAAAA GTACCACCTC TCAAGATCCC AGTCTCCAGA
    ATCTCCCCCA TGCCGTTTCC TACATCGCAG GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC
    ATCACTAGTC CTAACAGAAC AGGAGCCAGA ACTCTTGCAG ACATCAAAGC AAAAGCCCAG
    CTGGTCAAAG CACAGAGGGC AGCAGCTGCC GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA
    GTTGGAGGGA CCATTCCAGG ACCTGGCCCA GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT
    GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA AACTCAGAAA GAGTCGGTGA AACTGGAAAG
    GGCCCCACAC TGGAACTGGC AGGAACTGGA AGCAGGGGAG GTACGAGAGA GCTTTTACCC
    TCTGGTCCAG ACACTCAGCC CCAATCTGAG ACCAAGACCC CAGGCCAGGC ACAGCCTCAT
    AGTGTCTCTG GAGCACAACT ACAGCAAACC CCCTCAGTGC CTCCAATATC TGCCATCAGT
    GGAGCATGCA CAAGTGTCCC ATCACCAGCC CACACTAATG CACCCCCACC AGCTTTAGTG
    AAATTGAATA ATGAAAAACT GAATCCCTCC AGGGCAGCAG CCACCATGGC CTCTCTAAGC
    CACCCACCGT GGCCCAGTAA TTGCTGGCAA GAGAAAGCAC CTTCTACTCC AGCAGATCCT
    GCTCATTTTA CTGCTGATGG CACAGCTGAG CCCAAAGCAG CTTCTAGTAA GAATCCACCA
    AACCCTTCAG CCTCAGCAGA GACAAATGCT AGTGCTTCAG TGGATATGAC TCCCTCCCCT
    TTAACATCTT TATTAACAAC AGCCACTTTA GAAAAGCTTC CTGTACCCCA GGTCAGTGTA
    ACTGTAGCAC CTACCGGATC AGCTCTATCC TTGAGCACTT TGCCAGCAGC TTCTAGCCTT
    AAAACTCCAG GAATTTCTTC AAATATGAAT GGACCCATTT CAAGGCCAAG TTCTAGTATC
    CCTGCTAATA ATCCTCTGGT CACTCAGCTG CTCCAGGGCA AAGATGTTCC CATGGAGCAA
    ATTCTGCCTA AACCTCTCAC CAAAGTTGAA ATGAAAACTG TTCCACTGAC TACAAAAGAG
    GAAAAGGGGA TAGGAGCACT CACAGGCACC AACATAACAG AAAATAGCAC CAGAGAGGAA
    GGTAACGAGA GGCAGTCTCA TCCAGCTATA CAGCAGCTGG GGAAAACCTT GCAGAGTAAG
    CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG CTCTTTTCAG GTAAGGATCT GAGGGAGTCT
    AGCATTGACA CACACCAATA CCGAGAAGGA CTAAGTAAAG CAACCCAAGA GCAGATCCTT
    CAGACTCTCA TCCAAAGGGT TCAGAGGCAA AATGTTTCCT CGTTTGCACA GCCCTCTCAG
    TTCAACTTCA CTCACTCAGG TTTCCAGTTA GAAGACCTCT CCATAAGCCA GAGGTTCATG
    CTGGGTTTTG CTGGCAGAAG GACATCAAAG CCTGCAATGG CAGGTCACTA CTTACTTAAC
    ATTTCCACCT ATGGCCGGGG TTCAGAGAGC TTTAGGAGGA CCCATTCTGT AAACCCTGAA
    GACCGTTTTT GTCTAAGTAG CCCCACTGAG GCCTTGAAAA TGGGATATAC AGACTGTAAA
    AATGCAACAG GAGATAGTAG CAGCAGCAAA GAAGAAGATA CTGATGAGGA AAGTACTGGT
    GATGAGCAAG AATCTATCAT GGTGAAGGAG GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG
    TGTGAAGCAA GTTCAGGACC CCACAGTAGA GAAAACCTAT CCACCAATGA TTGTTTAGCT
    AAAAAGAACG TGAAGGCAGA GACACCAGTG CATGAGCAAA CCACTTTAAG CAAGGAGAAT
    TACCTCTTCC CCAGAGGCCA AATGTTTGAT GAAAAGACCC TAGCCAGAGA TTTTATTCAG
    GCAGCACAGA AGCAAATGGC TCATGCAGTA AGAGGTAAGA CAATGCGTAG CAGCCCTGAG
    CTTTTCAATT CTACTGCTCT TCCTCTACCT ACAGACAGTC CCACACATCA GCCTCTCCTC
    CTTCCACCAC TGCAAACCCC AAAGCTGTAT GGAAGCCCCA CACAGATCGG GCCAAGCTAC
    AGAGGCATGA TCAATGTCTC CACCTCATCT GACACGGACC ATAACTCTGC TGTACCGGGG
    ATGCCTGACT GTAGCCAGGT ATCTAGTAAC ATAGGTGATG TCATGTCCTT TTCAGTGACT
    GTCACTACCA TCCCTGCTAG CCAAGCTATG AATCCCAGTA GCCACGGCCA GACCATTCCT
    GTTCAGGCCT TCCCTGAAGA AAACAGCATA GATAACACGC CTTCGAAATG TTACTGCCGT
    TTGAAAGCTA TGATCATGTG CAAGGGGTGT GGAGCTTTCT GCCACGATGA TTGCATTGGC
    CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014712268.1
    CDS231..3989
    Translation

    Target ORF information:

    RefSeq Version XM_014856782.1
    Organism Equus asinus(ass)
    Definition Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X7, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014856782.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTCCATCT CGTCCAACCA GCATCTATCT CTGAAGACTG TCAAAGCAGC CAGTGACTCC 
    GTACCTGCCA AACCTGCGAT GTGGGAAGGA AAGCAATCTG ATGGACAGTC AAGCAGCCCT
    CAGAACTCAA ATTCTAGCTT TGCTTCTTCA GTTAAAGTGG AAAATCCTTT GCTAAGCTTG
    GGGAAGAAGT CATTCCAGAG GTCTGACAGG CTCCACACAA GGCAAATGAA AAGAACTAAA
    TGTGCTGAAA TTGATGTTGA GACACCAGAC TCCATTCTGG TTAATACAAA TCTACGAGCA
    CTGATCAACA AACACACCTT TTCAGTCCTT CCTGGAGATT GCCAACAGCG ATTGCTTTTA
    CTACTTCCAG AGGTGGATCG ACAGATTGGT CCAGATGGTC TGATGAAGTT AAATGGCTCA
    GCCCTTAACA ATGAGTTCTT CACTTCAGCA GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA
    GGTGAGTTTA CACCTGAGAT GCAGGTGAGA ATTCGACAAG AGATTGAGAA GGAGAAAAAA
    GTAGAGCCAT GGAAAGAACA ATTCTTTGAA AGCTACTATG GTCAGAGTTC TGGCCTGAGC
    CTTGAGGATT CAAAGAAATT AACGGGTTCA CCCAGTGATT CCAAAGTAAA GAAAACCCCA
    GCTGAGCAAC CAAAATCCAT GCTTCCTTCA GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA
    ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA GTACCAATGC CATCACCAGT CAGAAAAGAG
    GAGCGCGAAA GCCAAGATAA GGTGCAGCCA AGCTCCAAAT CCACAGAGCC CCTACTTTCC
    TCAGCTAGCA ATGCAAATGA GCTTAGCAGT GTTCTTTCCA TCAAGTGCCC AAAGGACGAG
    GATCATTTGG AGCAGAAGCC AGTTGCCTCT GCTGAACAGG AGTCTGAGAA GGAGAATCAT
    CTCACTACAG CCTCTAATTA TAACAAAAAT GAAAGCCAGG AAGCTTTAGT TACATCTCCG
    AGCAAATCCA AGAGTCCTGA GGTGGAAAAA CCAATAATGA AGCCCATAGT AGAAGCAAGT
    CCACAGGAGG CCACTATGAA AGAGCTTCCG TCAGCTCTGG TTGACCACAG CCCAGAAAGC
    CTCAAGAGGA AAGCTTCTCT CACCCAAGAA GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA
    CGTGTCACAG AGAATCGCCA CCACCAGCAG CCATTTCAGG TCTCGCCACA GCCCTTTCTC
    AATAGAGTGG ACAGGATCCC GGTGCGAAAA GTACCACCTC TCAAGATCCC AGTCTCCAGA
    ATCTCCCCCA TGCCGTTTCC TACATCGCAG GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC
    ATCACTAGTC CTAACAGAAC AGGAGCCAGA ACTCTTGCAG ACATCAAAGC AAAAGCCCAG
    CTGGTCAAAG CACAGAGGGC AGCAGCTGCC GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA
    GTTGGAGGGA CCATTCCAGG ACCTGGCCCA GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT
    GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA AACTCAGAAA GAGTCGGTGA AACTGGAAAG
    GGCCCCACAC TGGAACTGGC AGGAACTGGA AGCAGGGGAG GTACGAGAGA GCTTTTACCC
    TCTGGTCCAG ACACTCAGCC CCAATCTGAG ACCAAGACCC CAGGCCAGGC ACAGCCTCAT
    AGTGTCTCTG GAGCACAACT ACAGCAAACC CCCTCAGTGC CTCCAATATC TGCCATCAGT
    GGAGCATGCA CAAGTGTCCC ATCACCAGCC CACACTAATG CACCCCCACC AGCTTTAGTG
    AAATTGAATA ATGAAAAACT GAATCCCTCC AGGGCAGCAG CCACCATGGC CTCTCTAAGC
    CACCCACCGT GGCCCAGTAA TTGCTGGCAA GAGAAAGCAC CTTCTACTCC AGCAGATCCT
    GCTCATTTTA CTGCTGATGG CACAGCTGAG CCCAAAGCAG CTTCTAGTAA GAATCCACCA
    AACCCTTCAG CCTCAGCAGA GACAAATGCT AGTGCTTCAG TGGATATGAC TCCCTCCCCT
    TTAACATCTT TATTAACAAC AGCCACTTTA GAAAAGCTTC CTGTACCCCA GGTCAGTGTA
    ACTGTAGCAC CTACCGGATC AGCTCTATCC TTGAGCACTT TGCCAGCAGC TTCTAGCCTT
    AAAACTCCAG GAATTTCTTC AAATATGAAT GGACCCATTT CAAGGCCAAG TTCTAGTATC
    CCTGCTAATA ATCCTCTGGT CACTCAGCTG CTCCAGGGCA AAGATGTTCC CATGGAGCAA
    ATTCTGCCTA AACCTCTCAC CAAAGTTGAA ATGAAAACTG TTCCACTGAC TACAAAAGAG
    GAAAAGGGGA TAGGAGCACT CACAGGCACC AACATAACAG AAAATAGCAC CAGAGAGGAA
    GGTAACGAGA GGCAGTCTCA TCCAGCTATA CAGCAGCTGG GGAAAACCTT GCAGAGTAAG
    CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG CTCTTTTCAG GTAAGGATCT GAGGGAGTCT
    AGCATTGACA CACACCAATA CCGAGAAGGA CTAAGTAAAG CAACCCAAGA GCAGATCCTT
    CAGACTCTCA TCCAAAGGGT TCAGAGGCAA AATGTTTCCT CGTTTGCACA GCCCTCTCAG
    TTCAACTTCA CTCACTCAGG TTTCCAGTTA GAAGACCTCT CCATAAGCCA GAGGTTCATG
    CTGGGTTTTG CTGGCAGAAG GACATCAAAG CCTGCAATGG CAGGTCACTA CTTACTTAAC
    ATTTCCACCT ATGGCCGGGG TTCAGAGAGC TTTAGGAGGA CCCATTCTGT AAACCCTGAA
    GACCGTTTTT GTCTAAGTAG CCCCACTGAG GCCTTGAAAA TGGGATATAC AGACTGTAAA
    AATGCAACAG GAGATAGTAG CAGCAGCAAA GAAGAAGATA CTGATGAGGA AAGTACTGGT
    GATGAGCAAG AATCTATCAT GGTGAAGGAG GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG
    TGTGAAGCAA GTTCAGGACC CCACAGTAGA GAAAACCTAT CCACCAATGA TTGTTTAGCT
    AAAAAGAACG TGAAGGCAGA GACACCAGTG CATGAGCAAA CCACTTTAAG CAAGGAGAAT
    TACCTCTTCC CCAGAGGCCA AATGTTTGAT GAAAAGACCC TAGCCAGAGA TTTTATTCAG
    GCAGCACAGA AGCAAATGGC TCATGCAGTA AGAGGTAAGA CAATGCGTAG CAGCCCTGAG
    CTTTTCAATT CTACTGCTCT TCCTCTACCT ACAGACAGTC CCACACATCA GCCTCTCCTC
    CTTCCACCAC TGCAAACCCC AAAGCTGTAT GGAAGCCCCA CACAGATCGG GCCAAGCTAC
    AGAGGCATGA TCAATGTCTC CACCTCATCT GACACGGACC ATAACTCTGC TGTACCGGGG
    ATGCCTGACT GTAGCCAGGT ATCTAGTAAC ATAGGTGATG TCATGTCCTT TTCAGTGACT
    GTCACTACCA TCCCTGCTAG CCAAGCTATG AATCCCAGTA GCCACGGCCA GACCATTCCT
    GTTCAGGCCT TCCCTGAAGA AAACAGCATA GATAACACGC CTTCGAAATG TTACTGCCGT
    TTGAAAGCTA TGATCATGTG CAAGGGGTGT GGAGCTTTCT GCCACGATGA TTGCATTGGC
    CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq01802
    Clone ID Related Accession (Same CDS sequence) XM_014856767.1 , XM_014856782.1 , XM_014856774.1
    Accession Version XM_014856774.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3759bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product putative Polycomb group protein ASXL2 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014636848.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTCCATCT CGTCCAACCA GCATCTATCT CTGAAGACTG TCAAAGCAGC CAGTGACTCC 
    GTACCTGCCA AACCTGCGAT GTGGGAAGGA AAGCAATCTG ATGGACAGTC AAGCAGCCCT
    CAGAACTCAA ATTCTAGCTT TGCTTCTTCA GTTAAAGTGG AAAATCCTTT GCTAAGCTTG
    GGGAAGAAGT CATTCCAGAG GTCTGACAGG CTCCACACAA GGCAAATGAA AAGAACTAAA
    TGTGCTGAAA TTGATGTTGA GACACCAGAC TCCATTCTGG TTAATACAAA TCTACGAGCA
    CTGATCAACA AACACACCTT TTCAGTCCTT CCTGGAGATT GCCAACAGCG ATTGCTTTTA
    CTACTTCCAG AGGTGGATCG ACAGATTGGT CCAGATGGTC TGATGAAGTT AAATGGCTCA
    GCCCTTAACA ATGAGTTCTT CACTTCAGCA GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA
    GGTGAGTTTA CACCTGAGAT GCAGGTGAGA ATTCGACAAG AGATTGAGAA GGAGAAAAAA
    GTAGAGCCAT GGAAAGAACA ATTCTTTGAA AGCTACTATG GTCAGAGTTC TGGCCTGAGC
    CTTGAGGATT CAAAGAAATT AACGGGTTCA CCCAGTGATT CCAAAGTAAA GAAAACCCCA
    GCTGAGCAAC CAAAATCCAT GCTTCCTTCA GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA
    ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA GTACCAATGC CATCACCAGT CAGAAAAGAG
    GAGCGCGAAA GCCAAGATAA GGTGCAGCCA AGCTCCAAAT CCACAGAGCC CCTACTTTCC
    TCAGCTAGCA ATGCAAATGA GCTTAGCAGT GTTCTTTCCA TCAAGTGCCC AAAGGACGAG
    GATCATTTGG AGCAGAAGCC AGTTGCCTCT GCTGAACAGG AGTCTGAGAA GGAGAATCAT
    CTCACTACAG CCTCTAATTA TAACAAAAAT GAAAGCCAGG AAGCTTTAGT TACATCTCCG
    AGCAAATCCA AGAGTCCTGA GGTGGAAAAA CCAATAATGA AGCCCATAGT AGAAGCAAGT
    CCACAGGAGG CCACTATGAA AGAGCTTCCG TCAGCTCTGG TTGACCACAG CCCAGAAAGC
    CTCAAGAGGA AAGCTTCTCT CACCCAAGAA GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA
    CGTGTCACAG AGAATCGCCA CCACCAGCAG CCATTTCAGG TCTCGCCACA GCCCTTTCTC
    AATAGAGTGG ACAGGATCCC GGTGCGAAAA GTACCACCTC TCAAGATCCC AGTCTCCAGA
    ATCTCCCCCA TGCCGTTTCC TACATCGCAG GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC
    ATCACTAGTC CTAACAGAAC AGGAGCCAGA ACTCTTGCAG ACATCAAAGC AAAAGCCCAG
    CTGGTCAAAG CACAGAGGGC AGCAGCTGCC GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA
    GTTGGAGGGA CCATTCCAGG ACCTGGCCCA GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT
    GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA AACTCAGAAA GAGTCGGTGA AACTGGAAAG
    GGCCCCACAC TGGAACTGGC AGGAACTGGA AGCAGGGGAG GTACGAGAGA GCTTTTACCC
    TCTGGTCCAG ACACTCAGCC CCAATCTGAG ACCAAGACCC CAGGCCAGGC ACAGCCTCAT
    AGTGTCTCTG GAGCACAACT ACAGCAAACC CCCTCAGTGC CTCCAATATC TGCCATCAGT
    GGAGCATGCA CAAGTGTCCC ATCACCAGCC CACACTAATG CACCCCCACC AGCTTTAGTG
    AAATTGAATA ATGAAAAACT GAATCCCTCC AGGGCAGCAG CCACCATGGC CTCTCTAAGC
    CACCCACCGT GGCCCAGTAA TTGCTGGCAA GAGAAAGCAC CTTCTACTCC AGCAGATCCT
    GCTCATTTTA CTGCTGATGG CACAGCTGAG CCCAAAGCAG CTTCTAGTAA GAATCCACCA
    AACCCTTCAG CCTCAGCAGA GACAAATGCT AGTGCTTCAG TGGATATGAC TCCCTCCCCT
    TTAACATCTT TATTAACAAC AGCCACTTTA GAAAAGCTTC CTGTACCCCA GGTCAGTGTA
    ACTGTAGCAC CTACCGGATC AGCTCTATCC TTGAGCACTT TGCCAGCAGC TTCTAGCCTT
    AAAACTCCAG GAATTTCTTC AAATATGAAT GGACCCATTT CAAGGCCAAG TTCTAGTATC
    CCTGCTAATA ATCCTCTGGT CACTCAGCTG CTCCAGGGCA AAGATGTTCC CATGGAGCAA
    ATTCTGCCTA AACCTCTCAC CAAAGTTGAA ATGAAAACTG TTCCACTGAC TACAAAAGAG
    GAAAAGGGGA TAGGAGCACT CACAGGCACC AACATAACAG AAAATAGCAC CAGAGAGGAA
    GGTAACGAGA GGCAGTCTCA TCCAGCTATA CAGCAGCTGG GGAAAACCTT GCAGAGTAAG
    CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG CTCTTTTCAG GTAAGGATCT GAGGGAGTCT
    AGCATTGACA CACACCAATA CCGAGAAGGA CTAAGTAAAG CAACCCAAGA GCAGATCCTT
    CAGACTCTCA TCCAAAGGGT TCAGAGGCAA AATGTTTCCT CGTTTGCACA GCCCTCTCAG
    TTCAACTTCA CTCACTCAGG TTTCCAGTTA GAAGACCTCT CCATAAGCCA GAGGTTCATG
    CTGGGTTTTG CTGGCAGAAG GACATCAAAG CCTGCAATGG CAGGTCACTA CTTACTTAAC
    ATTTCCACCT ATGGCCGGGG TTCAGAGAGC TTTAGGAGGA CCCATTCTGT AAACCCTGAA
    GACCGTTTTT GTCTAAGTAG CCCCACTGAG GCCTTGAAAA TGGGATATAC AGACTGTAAA
    AATGCAACAG GAGATAGTAG CAGCAGCAAA GAAGAAGATA CTGATGAGGA AAGTACTGGT
    GATGAGCAAG AATCTATCAT GGTGAAGGAG GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG
    TGTGAAGCAA GTTCAGGACC CCACAGTAGA GAAAACCTAT CCACCAATGA TTGTTTAGCT
    AAAAAGAACG TGAAGGCAGA GACACCAGTG CATGAGCAAA CCACTTTAAG CAAGGAGAAT
    TACCTCTTCC CCAGAGGCCA AATGTTTGAT GAAAAGACCC TAGCCAGAGA TTTTATTCAG
    GCAGCACAGA AGCAAATGGC TCATGCAGTA AGAGGTAAGA CAATGCGTAG CAGCCCTGAG
    CTTTTCAATT CTACTGCTCT TCCTCTACCT ACAGACAGTC CCACACATCA GCCTCTCCTC
    CTTCCACCAC TGCAAACCCC AAAGCTGTAT GGAAGCCCCA CACAGATCGG GCCAAGCTAC
    AGAGGCATGA TCAATGTCTC CACCTCATCT GACACGGACC ATAACTCTGC TGTACCGGGG
    ATGCCTGACT GTAGCCAGGT ATCTAGTAAC ATAGGTGATG TCATGTCCTT TTCAGTGACT
    GTCACTACCA TCCCTGCTAG CCAAGCTATG AATCCCAGTA GCCACGGCCA GACCATTCCT
    GTTCAGGCCT TCCCTGAAGA AAACAGCATA GATAACACGC CTTCGAAATG TTACTGCCGT
    TTGAAAGCTA TGATCATGTG CAAGGGGTGT GGAGCTTTCT GCCACGATGA TTGCATTGGC
    CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014712260.1
    CDS844..4602
    Translation

    Target ORF information:

    RefSeq Version XM_014856774.1
    Organism Equus asinus(ass)
    Definition Equus asinus additional sex combs like 2, transcriptional regulator (ASXL2), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014856774.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTCCATCT CGTCCAACCA GCATCTATCT CTGAAGACTG TCAAAGCAGC CAGTGACTCC 
    GTACCTGCCA AACCTGCGAT GTGGGAAGGA AAGCAATCTG ATGGACAGTC AAGCAGCCCT
    CAGAACTCAA ATTCTAGCTT TGCTTCTTCA GTTAAAGTGG AAAATCCTTT GCTAAGCTTG
    GGGAAGAAGT CATTCCAGAG GTCTGACAGG CTCCACACAA GGCAAATGAA AAGAACTAAA
    TGTGCTGAAA TTGATGTTGA GACACCAGAC TCCATTCTGG TTAATACAAA TCTACGAGCA
    CTGATCAACA AACACACCTT TTCAGTCCTT CCTGGAGATT GCCAACAGCG ATTGCTTTTA
    CTACTTCCAG AGGTGGATCG ACAGATTGGT CCAGATGGTC TGATGAAGTT AAATGGCTCA
    GCCCTTAACA ATGAGTTCTT CACTTCAGCA GCCCAAGGCT GGAAGGAAAG ACTCTCAGAA
    GGTGAGTTTA CACCTGAGAT GCAGGTGAGA ATTCGACAAG AGATTGAGAA GGAGAAAAAA
    GTAGAGCCAT GGAAAGAACA ATTCTTTGAA AGCTACTATG GTCAGAGTTC TGGCCTGAGC
    CTTGAGGATT CAAAGAAATT AACGGGTTCA CCCAGTGATT CCAAAGTAAA GAAAACCCCA
    GCTGAGCAAC CAAAATCCAT GCTTCCTTCA GAGGCCTCTC CTCTCAGTGT AGTCCCAGTA
    ATTCCCCAGT TAGAGTCTAA AGAAGAAGAA GTACCAATGC CATCACCAGT CAGAAAAGAG
    GAGCGCGAAA GCCAAGATAA GGTGCAGCCA AGCTCCAAAT CCACAGAGCC CCTACTTTCC
    TCAGCTAGCA ATGCAAATGA GCTTAGCAGT GTTCTTTCCA TCAAGTGCCC AAAGGACGAG
    GATCATTTGG AGCAGAAGCC AGTTGCCTCT GCTGAACAGG AGTCTGAGAA GGAGAATCAT
    CTCACTACAG CCTCTAATTA TAACAAAAAT GAAAGCCAGG AAGCTTTAGT TACATCTCCG
    AGCAAATCCA AGAGTCCTGA GGTGGAAAAA CCAATAATGA AGCCCATAGT AGAAGCAAGT
    CCACAGGAGG CCACTATGAA AGAGCTTCCG TCAGCTCTGG TTGACCACAG CCCAGAAAGC
    CTCAAGAGGA AAGCTTCTCT CACCCAAGAA GAGTCCCCTA TGAGCTGGGA GAAGAGGCCA
    CGTGTCACAG AGAATCGCCA CCACCAGCAG CCATTTCAGG TCTCGCCACA GCCCTTTCTC
    AATAGAGTGG ACAGGATCCC GGTGCGAAAA GTACCACCTC TCAAGATCCC AGTCTCCAGA
    ATCTCCCCCA TGCCGTTTCC TACATCGCAG GTCTCTCCCA GGGCTCGTTT TCCAGTCTCC
    ATCACTAGTC CTAACAGAAC AGGAGCCAGA ACTCTTGCAG ACATCAAAGC AAAAGCCCAG
    CTGGTCAAAG CACAGAGGGC AGCAGCTGCC GCTGCAGCTG CCGCTGCTGC AGCCGCCTCA
    GTTGGAGGGA CCATTCCAGG ACCTGGCCCA GGGGGTGGAC AAGGTCCAGG AGAGGGTGGT
    GAAAGGAAAA CTGCTAGAGG AGGGAGTCCA AACTCAGAAA GAGTCGGTGA AACTGGAAAG
    GGCCCCACAC TGGAACTGGC AGGAACTGGA AGCAGGGGAG GTACGAGAGA GCTTTTACCC
    TCTGGTCCAG ACACTCAGCC CCAATCTGAG ACCAAGACCC CAGGCCAGGC ACAGCCTCAT
    AGTGTCTCTG GAGCACAACT ACAGCAAACC CCCTCAGTGC CTCCAATATC TGCCATCAGT
    GGAGCATGCA CAAGTGTCCC ATCACCAGCC CACACTAATG CACCCCCACC AGCTTTAGTG
    AAATTGAATA ATGAAAAACT GAATCCCTCC AGGGCAGCAG CCACCATGGC CTCTCTAAGC
    CACCCACCGT GGCCCAGTAA TTGCTGGCAA GAGAAAGCAC CTTCTACTCC AGCAGATCCT
    GCTCATTTTA CTGCTGATGG CACAGCTGAG CCCAAAGCAG CTTCTAGTAA GAATCCACCA
    AACCCTTCAG CCTCAGCAGA GACAAATGCT AGTGCTTCAG TGGATATGAC TCCCTCCCCT
    TTAACATCTT TATTAACAAC AGCCACTTTA GAAAAGCTTC CTGTACCCCA GGTCAGTGTA
    ACTGTAGCAC CTACCGGATC AGCTCTATCC TTGAGCACTT TGCCAGCAGC TTCTAGCCTT
    AAAACTCCAG GAATTTCTTC AAATATGAAT GGACCCATTT CAAGGCCAAG TTCTAGTATC
    CCTGCTAATA ATCCTCTGGT CACTCAGCTG CTCCAGGGCA AAGATGTTCC CATGGAGCAA
    ATTCTGCCTA AACCTCTCAC CAAAGTTGAA ATGAAAACTG TTCCACTGAC TACAAAAGAG
    GAAAAGGGGA TAGGAGCACT CACAGGCACC AACATAACAG AAAATAGCAC CAGAGAGGAA
    GGTAACGAGA GGCAGTCTCA TCCAGCTATA CAGCAGCTGG GGAAAACCTT GCAGAGTAAG
    CAGCTCCCCC AGGTTCCAAG GCCCCTTCAG CTCTTTTCAG GTAAGGATCT GAGGGAGTCT
    AGCATTGACA CACACCAATA CCGAGAAGGA CTAAGTAAAG CAACCCAAGA GCAGATCCTT
    CAGACTCTCA TCCAAAGGGT TCAGAGGCAA AATGTTTCCT CGTTTGCACA GCCCTCTCAG
    TTCAACTTCA CTCACTCAGG TTTCCAGTTA GAAGACCTCT CCATAAGCCA GAGGTTCATG
    CTGGGTTTTG CTGGCAGAAG GACATCAAAG CCTGCAATGG CAGGTCACTA CTTACTTAAC
    ATTTCCACCT ATGGCCGGGG TTCAGAGAGC TTTAGGAGGA CCCATTCTGT AAACCCTGAA
    GACCGTTTTT GTCTAAGTAG CCCCACTGAG GCCTTGAAAA TGGGATATAC AGACTGTAAA
    AATGCAACAG GAGATAGTAG CAGCAGCAAA GAAGAAGATA CTGATGAGGA AAGTACTGGT
    GATGAGCAAG AATCTATCAT GGTGAAGGAG GAGCCCCAGG CTGCCCAGAG TTCTGGCAAG
    TGTGAAGCAA GTTCAGGACC CCACAGTAGA GAAAACCTAT CCACCAATGA TTGTTTAGCT
    AAAAAGAACG TGAAGGCAGA GACACCAGTG CATGAGCAAA CCACTTTAAG CAAGGAGAAT
    TACCTCTTCC CCAGAGGCCA AATGTTTGAT GAAAAGACCC TAGCCAGAGA TTTTATTCAG
    GCAGCACAGA AGCAAATGGC TCATGCAGTA AGAGGTAAGA CAATGCGTAG CAGCCCTGAG
    CTTTTCAATT CTACTGCTCT TCCTCTACCT ACAGACAGTC CCACACATCA GCCTCTCCTC
    CTTCCACCAC TGCAAACCCC AAAGCTGTAT GGAAGCCCCA CACAGATCGG GCCAAGCTAC
    AGAGGCATGA TCAATGTCTC CACCTCATCT GACACGGACC ATAACTCTGC TGTACCGGGG
    ATGCCTGACT GTAGCCAGGT ATCTAGTAAC ATAGGTGATG TCATGTCCTT TTCAGTGACT
    GTCACTACCA TCCCTGCTAG CCAAGCTATG AATCCCAGTA GCCACGGCCA GACCATTCCT
    GTTCAGGCCT TCCCTGAAGA AAACAGCATA GATAACACGC CTTCGAAATG TTACTGCCGT
    TTGAAAGCTA TGATCATGTG CAAGGGGTGT GGAGCTTTCT GCCACGATGA TTGCATTGGC
    CCCTCTAAAC TGTGTGTCTC TTGCCTTGTC GTTCGGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.