AKAP1 cDNA ORF clone, Corvus cornix cornix

The following AKAP1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the AKAP1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCo106263 XM_010402284.3
Latest version!
Corvus cornix cornix A-kinase anchoring protein 1 (AKAP1), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCo106263
    Clone ID Related Accession (Same CDS sequence) XM_010402284.3
    Accession Version XM_010402284.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2604bp)
    Protein sequence
    SNP
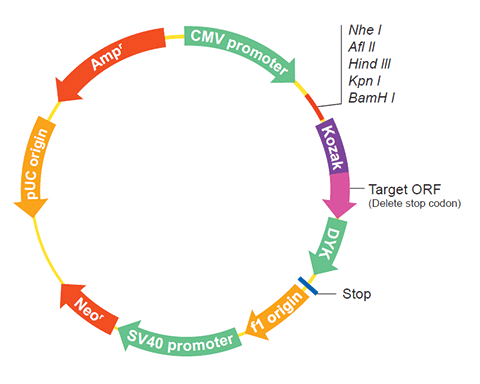
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
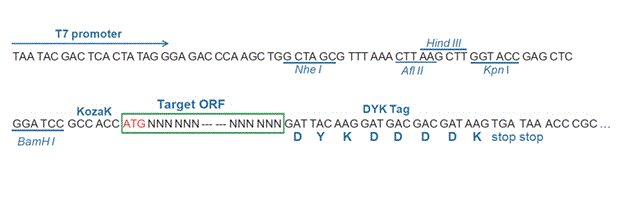
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product A-kinase anchor protein 1, mitochondrial
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018114029.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_010402284.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTTTAC GCTTCCGCAA TTTCGTCCCG TATGCCATTC CTGGAGTGCT GGCACTTCTT 
    GGCTGCTGGT GGATCTATTC CTGGAGAAAA AAGCACTCAA GCTATCGTGA CAAACAAGCA
    ATAGCCATTC AAAGGGAGAA GCAGGAAGAA GTATCAGAGA GTGATTCACG TTCCAAACCA
    GAAGCATGTG TTCCTCGAAG ACTGCCTCTT CCGTCAGAAG AAGAGTGCCT GCAGAGCCCA
    GCCCTGACCT CCCTGCTGTC TGCAGGGCCG ACGACGCCCT CTCTCCTGCG CCCAGCTCAC
    GAGAGGCCGG ATCTCTCACG GGACCTCCCA GACCTGTCGG CAGCGACAGC TGGGCCCAGC
    ACCCGTGAGG ACGACAGTGA AAAGCTGGAA TCGATAGGAT CTCGAGAGGG AAGCGGTGTC
    CCCGCTCGTG CCTCCCCCCC TCTGCTCTCA GAGAGCACCG AGTGTCGCCA GAGCGCGGCA
    CTGAGCCACG CACCGCAGCC AGGCTCGGGG ACAAAGCAAG GCCAGCAGCC ACCCCCAACA
    CAGGAGTCTT TGGGAGTCAG GGAGGACATC AGCAATGCAG AGCAGTCAGA TGAGTTTTTG
    TTTAAGCCCC CTAAGGAAAA GCAGATGCCA GGAATTGTGC AGTCGGATAC TGGCTCTATG
    ACAGCCCGTT GCTTGGGATT GGAGAAAGAA GCCAATGCCC CACAAGCCTT TCTCAATGAA
    GCTGAAGTTG TATCAGGTCA CGAGGATTCT GCAGTGAGTG TGTTACCAGG GAGTTTGGAG
    TCTGCCTGTC CAAAGCAGTC CAGGGAAGAA GAGATGTCCG AGTCAATCAC TGGTACTGTA
    CCAGTGTGTC AGAAGGACAC ACAGCCTAAA GGAAATGAGG CTGAAAGAGA GAAGACTGGG
    GGAGTGAGTT TGGACAAGGA AGTTGAGAAA ATTGAGCAAG TAGCAATACA GATCATTTCC
    AAGGTCATTT TGGCAGCAAC TGAGGAAGTG CTGTCGGGTT CTGCAGGGGA TGCATCCCCT
    TGGCTCTGCC AGGCCACTGC CAGCCGAGCT GAGGCACCTC TGGGGATGGA GAGTGTTGCT
    GCCTCTGGTC AGGTGCTTGT GGAGGGAGCC ACGGCAGCCG ATGAGAGCAT GGCTGCAGGG
    AGCGGTGCAG AGGAGCAGAG TCTGGGTGTG ACAGATTCCA GCTGCTCATC ACACGGCTGT
    TGGGCCAGCC CTGTTCAGGG AAACACAAAG GTCTGTCGGG TGAAGAGCCA GGTGTGCAGG
    GAGTCCCAAG GAGATGATCG GACTTGTGTG GAGAACTCAC TGGAAAAGTC TCCTCTGGCC
    ATGGAGGACT CTGGGTACAG CACACACACA CCCGGAGGTG GGACGAGTGT AGAGGACACC
    CTGCAGAGCA CAGTGCTGTC TGTCACATCA GACCAGCACT CGGACTCACT GAGCACATCC
    TCAGCCCCAG ACACGTCTGC CGAGCAGAGC TTGGTACCAA GGGAAACCCC CCCTGCTCCT
    GGGCTGCCCG AGGGCAGCAC AGTGCCCTAC AGCAATGGGA TCCTAAAAGA GGATGGGCCA
    GACCTGAGTC AGGAGTGTAG CAGTGCACCA GGGACGGATG GAGATCATTC AGAAGGTTCA
    GATGTAAATA GTGTGGATTT TGTGGACAGT GGCAGTGCCA TGAGGAAGAC AGTGGCTCGC
    CAGAACGCGA AGCTGGAAGG AGGATCCAGC AAGCCTGACT TCGTTATCTG GGAAATCGAG
    GTCCCAAAGG AATTAGTTGG CCGCTTGATT GGCAAACAAG GGAGGTTTAT GAGCTACTTG
    AGGCAAGCGT CTGGTGCCAA AATTTATGTT TCAACACTAC CTTATTTCCG TGACTCCCAA
    GTCTGTCACA TCGAAGGGAC CTCGCATCAA GTAGAGAAAG TCCTGAGCCT GATTGGCAAG
    AAGTTTAAAG AGCTGTGTCT CACCAACATC TACACCATCC CTCCACCGAT GCCGCTGCCG
    CTTCACTCCC TGCTCGTGTC CGCCTGGCTG TTCCTCCCTG ATGGAGTCAC TGTGGAGGTG
    GTGGTGGCAC ACCAGGTGGA TGCAGGGCAC ATGTTCCTGC AGCAGCACAC GCACCCCACG
    TTCCACGTCC TGCGCAGCCT CGACCAGCAG ATGTTCGCCT GCTACTCTCA GCCCGAAATT
    CCAACCCTGC CCACTCCGGT AGAAGTTGGT ATTATCTGTG CAGCTCCAGG CCTGGATGGG
    GCATGGCTCC GGGCTCAAGT CATCAGCTAC TTCGAGGAGA CCGATGAAGT GGAGCTCAAA
    TATGTGGACT ATGGAGGATA TGACAAAGTG AAGGTCGACA CACTCAGGCA AATCAGGTCT
    GATTTTTTAA CACTACCTTT CCAAGGAGCA GAAGTTTTAC TTGACAATGT GGTGCCACTT
    CCAGACGAGG ATCGCTTTTC CCCAGAAGCC GATGCTGCTG TCAGTGAGAT GACCAGAGGC
    GCCGTCCTCG TGGCACAGGT CACAAATTAT GACAGTGTCA CGGGACTGCC GCTGATACAG
    CTGTGGAACT TGATGGGAGA TGAGGTGGTG TCAATAAACA GGACTCTGGT GGAAAGAGGG
    TTTGCTCGGT GGCTCGACTA CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_010400586.2
    CDS520..3123
    Translation

    Target ORF information:

    RefSeq Version XM_010402284.3
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix A-kinase anchoring protein 1 (AKAP1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010402284.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTTTAC GCTTCCGCAA TTTCGTCCCG TATGCCATTC CTGGAGTGCT GGCACTTCTT 
    GGCTGCTGGT GGATCTATTC CTGGAGAAAA AAGCACTCAA GCTATCGTGA CAAACAAGCA
    ATAGCCATTC AAAGGGAGAA GCAGGAAGAA GTATCAGAGA GTGATTCACG TTCCAAACCA
    GAAGCATGTG TTCCTCGAAG ACTGCCTCTT CCGTCAGAAG AAGAGTGCCT GCAGAGCCCA
    GCCCTGACCT CCCTGCTGTC TGCAGGGCCG ACGACGCCCT CTCTCCTGCG CCCAGCTCAC
    GAGAGGCCGG ATCTCTCACG GGACCTCCCA GACCTGTCGG CAGCGACAGC TGGGCCCAGC
    ACCCGTGAGG ACGACAGTGA AAAGCTGGAA TCGATAGGAT CTCGAGAGGG AAGCGGTGTC
    CCCGCTCGTG CCTCCCCCCC TCTGCTCTCA GAGAGCACCG AGTGTCGCCA GAGCGCGGCA
    CTGAGCCACG CACCGCAGCC AGGCTCGGGG ACAAAGCAAG GCCAGCAGCC ACCCCCAACA
    CAGGAGTCTT TGGGAGTCAG GGAGGACATC AGCAATGCAG AGCAGTCAGA TGAGTTTTTG
    TTTAAGCCCC CTAAGGAAAA GCAGATGCCA GGAATTGTGC AGTCGGATAC TGGCTCTATG
    ACAGCCCGTT GCTTGGGATT GGAGAAAGAA GCCAATGCCC CACAAGCCTT TCTCAATGAA
    GCTGAAGTTG TATCAGGTCA CGAGGATTCT GCAGTGAGTG TGTTACCAGG GAGTTTGGAG
    TCTGCCTGTC CAAAGCAGTC CAGGGAAGAA GAGATGTCCG AGTCAATCAC TGGTACTGTA
    CCAGTGTGTC AGAAGGACAC ACAGCCTAAA GGAAATGAGG CTGAAAGAGA GAAGACTGGG
    GGAGTGAGTT TGGACAAGGA AGTTGAGAAA ATTGAGCAAG TAGCAATACA GATCATTTCC
    AAGGTCATTT TGGCAGCAAC TGAGGAAGTG CTGTCGGGTT CTGCAGGGGA TGCATCCCCT
    TGGCTCTGCC AGGCCACTGC CAGCCGAGCT GAGGCACCTC TGGGGATGGA GAGTGTTGCT
    GCCTCTGGTC AGGTGCTTGT GGAGGGAGCC ACGGCAGCCG ATGAGAGCAT GGCTGCAGGG
    AGCGGTGCAG AGGAGCAGAG TCTGGGTGTG ACAGATTCCA GCTGCTCATC ACACGGCTGT
    TGGGCCAGCC CTGTTCAGGG AAACACAAAG GTCTGTCGGG TGAAGAGCCA GGTGTGCAGG
    GAGTCCCAAG GAGATGATCG GACTTGTGTG GAGAACTCAC TGGAAAAGTC TCCTCTGGCC
    ATGGAGGACT CTGGGTACAG CACACACACA CCCGGAGGTG GGACGAGTGT AGAGGACACC
    CTGCAGAGCA CAGTGCTGTC TGTCACATCA GACCAGCACT CGGACTCACT GAGCACATCC
    TCAGCCCCAG ACACGTCTGC CGAGCAGAGC TTGGTACCAA GGGAAACCCC CCCTGCTCCT
    GGGCTGCCCG AGGGCAGCAC AGTGCCCTAC AGCAATGGGA TCCTAAAAGA GGATGGGCCA
    GACCTGAGTC AGGAGTGTAG CAGTGCACCA GGGACGGATG GAGATCATTC AGAAGGTTCA
    GATGTAAATA GTGTGGATTT TGTGGACAGT GGCAGTGCCA TGAGGAAGAC AGTGGCTCGC
    CAGAACGCGA AGCTGGAAGG AGGATCCAGC AAGCCTGACT TCGTTATCTG GGAAATCGAG
    GTCCCAAAGG AATTAGTTGG CCGCTTGATT GGCAAACAAG GGAGGTTTAT GAGCTACTTG
    AGGCAAGCGT CTGGTGCCAA AATTTATGTT TCAACACTAC CTTATTTCCG TGACTCCCAA
    GTCTGTCACA TCGAAGGGAC CTCGCATCAA GTAGAGAAAG TCCTGAGCCT GATTGGCAAG
    AAGTTTAAAG AGCTGTGTCT CACCAACATC TACACCATCC CTCCACCGAT GCCGCTGCCG
    CTTCACTCCC TGCTCGTGTC CGCCTGGCTG TTCCTCCCTG ATGGAGTCAC TGTGGAGGTG
    GTGGTGGCAC ACCAGGTGGA TGCAGGGCAC ATGTTCCTGC AGCAGCACAC GCACCCCACG
    TTCCACGTCC TGCGCAGCCT CGACCAGCAG ATGTTCGCCT GCTACTCTCA GCCCGAAATT
    CCAACCCTGC CCACTCCGGT AGAAGTTGGT ATTATCTGTG CAGCTCCAGG CCTGGATGGG
    GCATGGCTCC GGGCTCAAGT CATCAGCTAC TTCGAGGAGA CCGATGAAGT GGAGCTCAAA
    TATGTGGACT ATGGAGGATA TGACAAAGTG AAGGTCGACA CACTCAGGCA AATCAGGTCT
    GATTTTTTAA CACTACCTTT CCAAGGAGCA GAAGTTTTAC TTGACAATGT GGTGCCACTT
    CCAGACGAGG ATCGCTTTTC CCCAGAAGCC GATGCTGCTG TCAGTGAGAT GACCAGAGGC
    GCCGTCCTCG TGGCACAGGT CACAAATTAT GACAGTGTCA CGGGACTGCC GCTGATACAG
    CTGTGGAACT TGATGGGAGA TGAGGTGGTG TCAATAAACA GGACTCTGGT GGAAAGAGGG
    TTTGCTCGGT GGCTCGACTA CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.