LOC105363688 cDNA ORF clone, Ceratosolen solmsi marchali

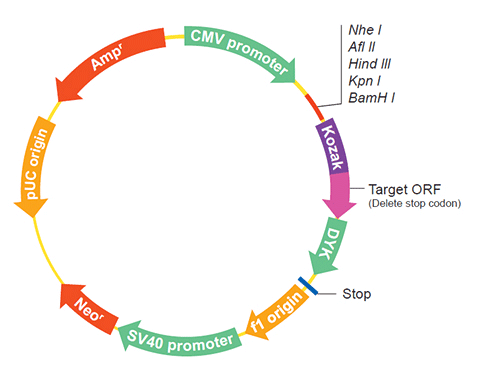
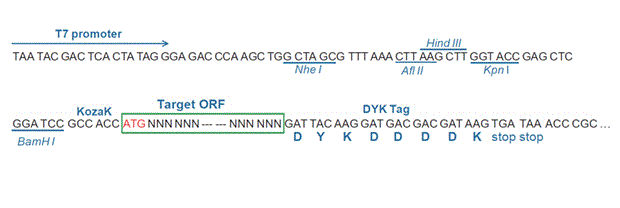
The following LOC105363688 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105363688 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe199393 XM_011501439.1
Latest version!
Ceratosolen solmsi marchali agrin-like (LOC105363688), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe199393
    Clone ID Related Accession (Same CDS sequence) XM_011501439.1
    Accession Version XM_011501439.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3432bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product agrin-like
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948428.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 15% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGACCTTTG ACCCCAATTA CTCTGTGACA CTTATAGCTA AAACCAAGCC TAATGAGAAG 
    ATCGATCCAT GCGAGAAGCT TAACTGCACC CTCGGCTCGC AGTGCGTACG CAGCAAGGAC
    GGCACCGAGG CCAAATGCGA GTGTCTCGAA TCGTGCCCGA GCCTCGGGGA CCACGAAGGC
    GCGGGTCCGG TATGCGGTAC CGACGGCGTC GACTACCCGA GCCTCTGCGA TCTCAATCGA
    CAGGCATGCG CCACCGCCGC CAACATCTCC GTCGCTTTTC GCGGCAAATG CGATCCTTGC
    GCGGGGGTGA CGTGCACGGA ACCGGAAGTC TGTCAGTTGG ACGCCTCGAG ACAGCCGTCC
    TGTCGCTGCA GCGAACAATG CGGCCTTGAA TTTTCACCTG TCTGTGGCAG CGATGGTAAA
    ACATATTCCA ACGAGTGCAT CTTGCGCCAG GAGGCCTGCA AATCTCGGCT TCAGCTCCGG
    AAAATTTACA ACGGCGAATG TAATTCCGGG GTGAATCCGT GCGACGGTGC CAAGTGCGGC
    TCCCAGGAGC AGTGCGCGAT CGATCGCTAC GGCATCGCCA AGTGCGAGTG CGGCCCCGAG
    TGCGAGACCG TAATGAGGCC CGTCTGCGCC AGGGGTGGTA CCACCTACGT CTCCCTCTGC
    GAACTCAAGA GGCAGGCCTG CCTCGCCAGG ACGACCGTCG AGGTCGCGTA CACGGGCGCC
    TGCGGCTCCA AGGGCCCCTG CTCCGAGAAG ATCTGCCAGT GGGGCGCCGT GTGCACGGAG
    AGCGAGGACG CGGGTGTCTG CGAGTGCCCG AGCTGCAGCG CCGAATTCCA GCCGGTTTGC
    GGCGACGACG GCATCAGCTA CGGGAACGAG TGCAAGCTGC GCCTCGAGGC CTGCCAGCAC
    CGACGCGACA TACGCGTCCT CTACCACCAA CAATGCAATG GCTGCGAGAA CACGAAGTGC
    GATCATTACG GCAAGTGCGA AAGCGATGCC AGTGGCCAGG CAAAGTGTGT GTGCCCGAGC
    GACTGCGAGG AACCGGAGAC CGGGAGTTCA AGTATAGTTT GCGGCTCCGA TGGGGTGACT
    TATGAAAGCG AATGCGAATT GAAGAAAACT TCTTGCAGTG TCCAGACTTT GGTAGTGGTC
    AGTTATAAAG GGGATTGCGA ACTCTGCTCC AACGTCGAGT GCGACAACGA GGCCCGATGC
    GAGGCCGGTG TCTGCGTCTG CCCCTTGAGC TGTCCGGAGG CCAGTGGAGC CTACGTCTGC
    GGCAGCGACA GCAAGACCTA CACCTCGGAA TGCGAGCTCC AGAAGGCGGC CTGCGAGCGC
    GATCCCAATC TTTCCGCCCT ACACGTCAAC TACTACGGCG AGTGCGGACA AGGATTTCCC
    GTCGCTGCTC TCACTACCAT GTCGACGTCG TCGATAACGC GCCTGGTGAC GTCGGCGGAG
    ATGACGTCTG ACCTGGAGCT CGAGGCTTGC CGCAACATCC ACTGCGACTT CAATGCGACG
    TGCGAGCTCG GTGACGATCA CTTTCCCCGC TGCAGCTGCA AGTTCGACTG TGCCTCGATC
    GCCCCGGAGA ATATGCAACC GGTTTGTGGT AGCGACCTGC GCACCTACTC GAGCAAATGC
    CACATGCTTA TGGAGGCCTG CCAACGCCAG CAAGAGCTTA GGCTCAGGCC CCTCGACCTC
    TGCCAAGGCA TGGAGGTGAA ACCCTGTAAC GGAGAGCAGC CCCTGGTTGA CTCCGAGGGC
    AACGAATACG ACTGCGGCAG CGGACCGAGT CGCAAGGACT GCCCCAGTCA CACGTACTGT
    CATCAAACCC CGAGATTTGC TCGCTGCTGC AAGAAAGGCA TGCAGATCCT GAAGTGCGAG
    GACTCGTGGC ACGGCTGCTG TCCGGACGGG AAGACCGCGG CCCTAGGGCC CGAGGGGGCC
    GGCTGTCCGA ATCTCTGCAA CTGCAACCGG CTGGGCAGCC TCTCGGACAC TTGCAGCCCC
    GAGACCGGGC AGTGCGAATG CCGGCCCGGA GTGGGAGGAC TCAAGTGCGA TAGGTGCATG
    CCTGGATACT GGGGCTTGTC CAAGATCGAT AAGGGACACC AGGGCTGCAT TCCTTGCGGC
    TGCTCGCTAT TTGGCTCGAC TCGCGAGGAT TGCGAGCAAA TGACGGGACT GTGCGTTTGC
    AAGTCGGAAA TCCAGGGAAA GAAGTGCACG ATATGTACCG ATCATAATAA GATTCTAACC
    CCTAAAGGAT GCCAGCCAGC GGATGCTGTA CTCCCGATAC CCAGTAGCTG CAACGAGCTC
    GAGTGCTACT CGGGCAGCCA CTGCACGGAG TCGAGCGTCG GGGTCGCGGG ACCGCGCTGC
    ATCTGCCCCG TTGGCTGCCC CGAGGAGACC CCGGCCGTCT CCGTCTGCGG TAGCGACGGC
    CAGACCTACG ACAACGAGTG CGAGCTACGG CTCTACGCCT GCCGCTACCA GACGGACGTC
    GTGCCCCAGG CATTTGGCCA CTGCCGAGAC GATTCCATGA CCAACACGGA TTTCCCAGTG
    AAGAGATTCA CCGCTGTGCA CTACACACAG CCAGCAGCGG CGATTTCGCC TCTATCCAAG
    TCAACGAGGC ACTTGCTCGT ACCGGAGCCC GACGCCCGCT ACTACTACAC CAATCGAGCC
    CATCAAGAGA CTATTCCTGT TGACAGGAAG AATCTCAAAC ATGGCTCTGC GGCGGCCTAT
    CGTCCAACGC CGGCGACAAT TAGGGTCGTA ACTCCCTTGC TGGGCGACTT TTGCAACGAC
    GACAAGGACT GCGGCATATC GAACAGCCTT TGCATAAACG GACGCTGCAT TTGCACGGAT
    GGCTTTGCTG AAACTAGCGA CAGGCAAGAG TGTTCTAGTT TAGCAAACTA CGCGCCGGTG
    ACGCCGACGG AGGAGATCCG TGCCTGCCTC TCGTTCCCCT GCCACATGTC CGCTACGTGC
    ATCGACTTGC CCGGTGCCAC CTACATGTGC AACTGCCTCG AGAACTACAC AGGCTTCCAC
    TGCGACGAGG AGATCAACCG GCGAGTGTAC GAAGCTTCCT TCGACGGGAA GAGTTACGTT
    CGCATGAATC GACTGAAAGC CTATTATAAG CTGAGCATCG AGGTGGAGTT CAAAACTTAC
    GCGGAGAATG GCATCATCGT GTACAACCAG CAGAAGCAGG ATGGCACCGG TGACTTTGTT
    TCGTTGGCCA TCGTCGACGG TTTCGTCCAG TTTCGATACA ATTTAGGTAA TGGGCCTGTT
    ATTCTCACTT CACCCGAACG TGTCTCGATG AAGACGTTCC ACAGGGTCAC CGCTAAAAGA
    TATCACAAAG ACGGGGTTCT ACTATTTAAC GAAAATGAGG AGGTCGCAGG TCAAAGTGAA
    GGAATGTTGA AGAGTCTTGA CTTGAATCAA GATACGTTCA TTGGCAATAT ACCGACTAAT
    TATAGCAAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011499741.1
    CDS1..3432
    Translation

    Target ORF information:

    RefSeq Version XM_011501439.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali agrin-like (LOC105363688), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011501439.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGACCTTTG ACCCCAATTA CTCTGTGACA CTTATAGCTA AAACCAAGCC TAATGAGAAG 
    ATCGATCCAT GCGAGAAGCT TAACTGCACC CTCGGCTCGC AGTGCGTACG CAGCAAGGAC
    GGCACCGAGG CCAAATGCGA GTGTCTCGAA TCGTGCCCGA GCCTCGGGGA CCACGAAGGC
    GCGGGTCCGG TATGCGGTAC CGACGGCGTC GACTACCCGA GCCTCTGCGA TCTCAATCGA
    CAGGCATGCG CCACCGCCGC CAACATCTCC GTCGCTTTTC GCGGCAAATG CGATCCTTGC
    GCGGGGGTGA CGTGCACGGA ACCGGAAGTC TGTCAGTTGG ACGCCTCGAG ACAGCCGTCC
    TGTCGCTGCA GCGAACAATG CGGCCTTGAA TTTTCACCTG TCTGTGGCAG CGATGGTAAA
    ACATATTCCA ACGAGTGCAT CTTGCGCCAG GAGGCCTGCA AATCTCGGCT TCAGCTCCGG
    AAAATTTACA ACGGCGAATG TAATTCCGGG GTGAATCCGT GCGACGGTGC CAAGTGCGGC
    TCCCAGGAGC AGTGCGCGAT CGATCGCTAC GGCATCGCCA AGTGCGAGTG CGGCCCCGAG
    TGCGAGACCG TAATGAGGCC CGTCTGCGCC AGGGGTGGTA CCACCTACGT CTCCCTCTGC
    GAACTCAAGA GGCAGGCCTG CCTCGCCAGG ACGACCGTCG AGGTCGCGTA CACGGGCGCC
    TGCGGCTCCA AGGGCCCCTG CTCCGAGAAG ATCTGCCAGT GGGGCGCCGT GTGCACGGAG
    AGCGAGGACG CGGGTGTCTG CGAGTGCCCG AGCTGCAGCG CCGAATTCCA GCCGGTTTGC
    GGCGACGACG GCATCAGCTA CGGGAACGAG TGCAAGCTGC GCCTCGAGGC CTGCCAGCAC
    CGACGCGACA TACGCGTCCT CTACCACCAA CAATGCAATG GCTGCGAGAA CACGAAGTGC
    GATCATTACG GCAAGTGCGA AAGCGATGCC AGTGGCCAGG CAAAGTGTGT GTGCCCGAGC
    GACTGCGAGG AACCGGAGAC CGGGAGTTCA AGTATAGTTT GCGGCTCCGA TGGGGTGACT
    TATGAAAGCG AATGCGAATT GAAGAAAACT TCTTGCAGTG TCCAGACTTT GGTAGTGGTC
    AGTTATAAAG GGGATTGCGA ACTCTGCTCC AACGTCGAGT GCGACAACGA GGCCCGATGC
    GAGGCCGGTG TCTGCGTCTG CCCCTTGAGC TGTCCGGAGG CCAGTGGAGC CTACGTCTGC
    GGCAGCGACA GCAAGACCTA CACCTCGGAA TGCGAGCTCC AGAAGGCGGC CTGCGAGCGC
    GATCCCAATC TTTCCGCCCT ACACGTCAAC TACTACGGCG AGTGCGGACA AGGATTTCCC
    GTCGCTGCTC TCACTACCAT GTCGACGTCG TCGATAACGC GCCTGGTGAC GTCGGCGGAG
    ATGACGTCTG ACCTGGAGCT CGAGGCTTGC CGCAACATCC ACTGCGACTT CAATGCGACG
    TGCGAGCTCG GTGACGATCA CTTTCCCCGC TGCAGCTGCA AGTTCGACTG TGCCTCGATC
    GCCCCGGAGA ATATGCAACC GGTTTGTGGT AGCGACCTGC GCACCTACTC GAGCAAATGC
    CACATGCTTA TGGAGGCCTG CCAACGCCAG CAAGAGCTTA GGCTCAGGCC CCTCGACCTC
    TGCCAAGGCA TGGAGGTGAA ACCCTGTAAC GGAGAGCAGC CCCTGGTTGA CTCCGAGGGC
    AACGAATACG ACTGCGGCAG CGGACCGAGT CGCAAGGACT GCCCCAGTCA CACGTACTGT
    CATCAAACCC CGAGATTTGC TCGCTGCTGC AAGAAAGGCA TGCAGATCCT GAAGTGCGAG
    GACTCGTGGC ACGGCTGCTG TCCGGACGGG AAGACCGCGG CCCTAGGGCC CGAGGGGGCC
    GGCTGTCCGA ATCTCTGCAA CTGCAACCGG CTGGGCAGCC TCTCGGACAC TTGCAGCCCC
    GAGACCGGGC AGTGCGAATG CCGGCCCGGA GTGGGAGGAC TCAAGTGCGA TAGGTGCATG
    CCTGGATACT GGGGCTTGTC CAAGATCGAT AAGGGACACC AGGGCTGCAT TCCTTGCGGC
    TGCTCGCTAT TTGGCTCGAC TCGCGAGGAT TGCGAGCAAA TGACGGGACT GTGCGTTTGC
    AAGTCGGAAA TCCAGGGAAA GAAGTGCACG ATATGTACCG ATCATAATAA GATTCTAACC
    CCTAAAGGAT GCCAGCCAGC GGATGCTGTA CTCCCGATAC CCAGTAGCTG CAACGAGCTC
    GAGTGCTACT CGGGCAGCCA CTGCACGGAG TCGAGCGTCG GGGTCGCGGG ACCGCGCTGC
    ATCTGCCCCG TTGGCTGCCC CGAGGAGACC CCGGCCGTCT CCGTCTGCGG TAGCGACGGC
    CAGACCTACG ACAACGAGTG CGAGCTACGG CTCTACGCCT GCCGCTACCA GACGGACGTC
    GTGCCCCAGG CATTTGGCCA CTGCCGAGAC GATTCCATGA CCAACACGGA TTTCCCAGTG
    AAGAGATTCA CCGCTGTGCA CTACACACAG CCAGCAGCGG CGATTTCGCC TCTATCCAAG
    TCAACGAGGC ACTTGCTCGT ACCGGAGCCC GACGCCCGCT ACTACTACAC CAATCGAGCC
    CATCAAGAGA CTATTCCTGT TGACAGGAAG AATCTCAAAC ATGGCTCTGC GGCGGCCTAT
    CGTCCAACGC CGGCGACAAT TAGGGTCGTA ACTCCCTTGC TGGGCGACTT TTGCAACGAC
    GACAAGGACT GCGGCATATC GAACAGCCTT TGCATAAACG GACGCTGCAT TTGCACGGAT
    GGCTTTGCTG AAACTAGCGA CAGGCAAGAG TGTTCTAGTT TAGCAAACTA CGCGCCGGTG
    ACGCCGACGG AGGAGATCCG TGCCTGCCTC TCGTTCCCCT GCCACATGTC CGCTACGTGC
    ATCGACTTGC CCGGTGCCAC CTACATGTGC AACTGCCTCG AGAACTACAC AGGCTTCCAC
    TGCGACGAGG AGATCAACCG GCGAGTGTAC GAAGCTTCCT TCGACGGGAA GAGTTACGTT
    CGCATGAATC GACTGAAAGC CTATTATAAG CTGAGCATCG AGGTGGAGTT CAAAACTTAC
    GCGGAGAATG GCATCATCGT GTACAACCAG CAGAAGCAGG ATGGCACCGG TGACTTTGTT
    TCGTTGGCCA TCGTCGACGG TTTCGTCCAG TTTCGATACA ATTTAGGTAA TGGGCCTGTT
    ATTCTCACTT CACCCGAACG TGTCTCGATG AAGACGTTCC ACAGGGTCAC CGCTAAAAGA
    TATCACAAAG ACGGGGTTCT ACTATTTAAC GAAAATGAGG AGGTCGCAGG TCAAAGTGAA
    GGAATGTTGA AGAGTCTTGA CTTGAATCAA GATACGTTCA TTGGCAATAT ACCGACTAAT
    TATAGCAAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.