LOC105363679 cDNA ORF clone, Ceratosolen solmsi marchali

The following LOC105363679 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105363679 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe199384 XM_011501429.1
Latest version!
Ceratosolen solmsi marchali polyhomeotic-proximal chromatin protein-like (LOC105363679), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe199384
    Clone ID Related Accession (Same CDS sequence) XM_011501429.1
    Accession Version XM_011501429.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3345bp)
    Protein sequence
    SNP
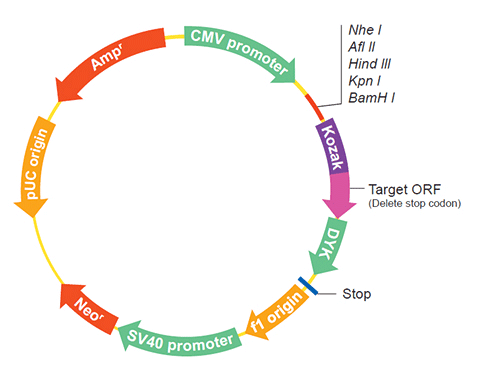
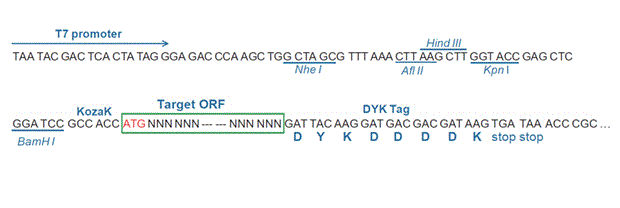
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product polyhomeotic-proximal chromatin protein-like
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948428.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGCCGACA ACAAACAGAT GGAGATGGAT CAGTCACAGG CCCAGGCCCA ACAACAAAAC 
    CAGAACCAGC AGTCCCAACA GATGATAATA ACGACTCATG ATATGCAGCA GAATGTGCAG
    CAGCAGGCTC AACAGCAGCA ACAGAATCAG GCTCAGCAAC AGAATCAGCA GCAGGCAAAC
    GGACCACAGA AGTTACAGAC ACAAGTCCAA GTCCAGCCGC AGGTCGCAGC AATCATGCCG
    CAGCAGCATT TGCAGGACGC CGTGGCAGTC TCGATGCAGC ATCAGCAGCA GTCGCAAAAC
    GTCGGCGGCG TCTCGATGAC GCTCTCCGGT CAGCAGGGTG CGACTACCAT CACGACCATG
    GCCGCCCATC CCCAGGCGGT CCAGGTCATC CAGCAGCCGA TGCAGAATCA GTATCACCTC
    CAGCAGCTCT ACAATGCCCA GGGCACGCCG CTGCTCATGC CCGGTAATCT TCTGGCCCAC
    CCGGCCGGCA TTAATCCCTC GCCCATACAG GTGCAGTTCA ACAACATAGC CGGCAAGCCC
    TTCCAGACGG GCGCGCAACT CGCTCCCCAC ATGCTGACAA CCGCGTCAAC GGGACAGGGT
    GGTGCGCATC CCGGGGCTGC CGGCGCCAAG GTCCAGGGCT TCCCCGCCGG TTACATACCG
    GTGCCGACGT CGGCGACGCC GGGCGGTGGA CAGACCCTCG TCTTCGGCCA GCTCGAGGTC
    GTACCCCAGC ACCAGACCTC CATTCAGCAA CAGCAGCAAC AGCAGGGCAA CAACAAGAAC
    GACCAAGTGC AAAAGTATAC AACGTGTACG GCTGGCGCAC CATCGGGCCA GAATCGCGGC
    ATGCAATTCG CCCCCTGGCA ATTCGCCGCC CAGGGCATCT GGACCGGACT TCAACCGCAG
    ACGTTGCTCA CGGCAGCTCC AAATCAAATA TTTATACGAG ACCCGACGCA GCCTGACATG
    TTCATACAGA GTCCGCAGCC CATTCAGACG CATAATGCAC TGGCGGCGCA GCAGCAAATC
    CAGGGTGTCC AGCAAATAGC TACGACGGGA GGCAAGCCCC GGGTGATGAA CATACAGCAG
    CAGCAGCAGA CGAACAAGCA GGGCGTCGTG AGCCAACGTC CGCTCAGCAT CCTCCCGTCG
    TCCTTACAGG GCGTCCAGGC GGCCAATATC AGGCCAGCAA GTTCCGTGTC CACGCAGACG
    AACCACGGGG TCCAGGCGAC GGTCCACGCC CAGAGCGGCA AAGGAGGTGG CGGCGCGGGC
    AAAGGCCGCG GTAAGCCGGT GGTTCGCACA AGTCCCGGTC CTAACGCCAT CAATGTCACG
    GTAACGAAGG CCGGTGGCGG CGGCAACGCA TCCGGCGCAC AAACTAAAAA CGCCAATGTC
    CAGCACGCGA CAATGATAAT GCAGCCGCAG CCCGGGCCCC AGACCGCGGG CAACAATAAC
    GGAACGAATA ACAAAATGCT AATAGCGACG AGCACAGCAA CTTCTGCGCA ACCACCCGGC
    TCACCAATGA CCGCCGCTGA CAAGCAAAAT TTCGGCCAGC AACAAAACAA ACAAACCGTT
    ATGCAATCAC CCCAGCAGCA GCAGCAACAA CAGCAGCAGC AGCAGGCCCA GCAGCAGGCC
    CAGGCCCAAG CTCAGCAGCA GCAGGCTCAG GCACAGGCTC AACAGCAGGC CCAACTCCAA
    GCCCAACAGC AGCAGCAGAT ACAGCAGATA TTCATCCAAC AGATTCAGCA GCAACAGCAA
    CTGCAGCAGC AGTACCAGCA GGCCCAGCAG GCGCCCCAGC AGATTCAACC CAAACCCCTT
    ATGGGTATGG CGGTACAGCA GCAGCCTGGC CAGCAGCAGA ACGTCGTCCT TGGTGGTGAG
    CGACCGATAA TGCCGGTAGT CTCGATCAAC CCCGCCCTTA TTGGCAATCA GATCGTCAGT
    GGGGCCCATC AGATTCAGGC ACTACCGATC GTCAGCCAGA CGGCCGATCA ATTGCAGGCC
    GCTGCCGTCG CGGCAGCGGC CCAACAACAG ATGCATCAGG CCGCTACCCA ACAGCAGCTC
    CAGCAGCAGC ATCAACAACA ACAACAGCAG CAGCAGCAGC AGCAGCAACA ACAGCAACAG
    CAGCAGCAAC AACAACAACA ACAGCAGCAA CAGCAGCAGC AACAACAACA GCAGCAGCAG
    CAGCAGCAAC AGCAACAGCA ACAGCAACAG CAGCAACAGA CTTCCACGGA ACAAGGTCAG
    AGTATGCCGA TACTCGTGAC GTCACCCGAC AGGGCCGCAC CCGGCCACAT CGAACTCCAG
    TCGTTGATGC AGCCACCGCC ACCGGCGGCC ACCCCCATGA GCTCCACGGT CGATGATCCT
    TCTAAAATAA TCATCCCTAC GAAGAAGGAA TCCTCGGAGA TGGCCACTGG CGATGATGTA
    TCAATGGATA CGTCTGGTCA GTCGGAAATC GACCAGAGGA ATATCGGCAA GGACGAGCAT
    CTGGATGGAG TGTCGATTAA GAGCGACGAT AAAACCAATA ATCCTCTTAT AAATCTTGCG
    AACGCCGTAA ACTCGATAAC AAATGGCAAT ATCGGCGAGG AGACGACGGT CTTGGAATCT
    CTGCCGATGA CAGTGAGCAG CAAGCAGGTG CCACCCAAGG CAATGGTTAA ACCGCAAGTG
    CTCACCCACG TTATCGAGGG CTTCGTCATA CAAGAAGCAT CGGAGCCATT TGCCGTGAAT
    CGCTCGTCAC TCAATGGATC GATAACGCAA GAAACAAACA ACATTGGTAG AAATCACTCC
    GCGGATAAAG AAAATCACGA GGAGCCACTG ATCAAAAGAA AGAAAAATTC TGTCAATTAC
    TCAACGGATG GAGACCAGGG CCTGCAAGGA AAATGCGAGG CATGTGGCAA TATTCTGGAC
    GAGCAGAACA TGAAAATCAA GAAAGACAAG AGGTTCTGCT CAACTATTTG CGCCAAATCG
    AAAAAGAAAG AAATTCGAGA TAACGGAGAC AAACAATGGT CGGAAATAGA AATTGATGTT
    AAAATTGATA ACGACTCGAT TAAAAAGAAT GGAGACGATA AGTCGATGAT TGGTTTACCT
    CATAATGTGG CATTAGACGA CTCTTTGCCA AAGATAAATC CTGTTAAGTG GACGGTCGGC
    GAAGTTTGCG ACTTTATAAG AAATTTGCCG GGCTGTGCAG ATTACGCCGA GGATTTCGCC
    ATTCAAGAAA TCGACGGCCA GGCTCTCATG CTCCTCAAAG AGGATCACTT AATGTCCGCA
    ATGAGCATCA AGCTCGGGCC GGCCTTGAAG ATCGTAGCAA AAATCGATTC GATGAGGATG
    GATTCAACAA CGAACGCCAG TCCCGTGACT GGCAGTAACG TTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011499731.1
    CDS172..3516
    Translation

    Target ORF information:

    RefSeq Version XM_011501429.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali polyhomeotic-proximal chromatin protein-like (LOC105363679), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011501429.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGCCGACA ACAAACAGAT GGAGATGGAT CAGTCACAGG CCCAGGCCCA ACAACAAAAC 
    CAGAACCAGC AGTCCCAACA GATGATAATA ACGACTCATG ATATGCAGCA GAATGTGCAG
    CAGCAGGCTC AACAGCAGCA ACAGAATCAG GCTCAGCAAC AGAATCAGCA GCAGGCAAAC
    GGACCACAGA AGTTACAGAC ACAAGTCCAA GTCCAGCCGC AGGTCGCAGC AATCATGCCG
    CAGCAGCATT TGCAGGACGC CGTGGCAGTC TCGATGCAGC ATCAGCAGCA GTCGCAAAAC
    GTCGGCGGCG TCTCGATGAC GCTCTCCGGT CAGCAGGGTG CGACTACCAT CACGACCATG
    GCCGCCCATC CCCAGGCGGT CCAGGTCATC CAGCAGCCGA TGCAGAATCA GTATCACCTC
    CAGCAGCTCT ACAATGCCCA GGGCACGCCG CTGCTCATGC CCGGTAATCT TCTGGCCCAC
    CCGGCCGGCA TTAATCCCTC GCCCATACAG GTGCAGTTCA ACAACATAGC CGGCAAGCCC
    TTCCAGACGG GCGCGCAACT CGCTCCCCAC ATGCTGACAA CCGCGTCAAC GGGACAGGGT
    GGTGCGCATC CCGGGGCTGC CGGCGCCAAG GTCCAGGGCT TCCCCGCCGG TTACATACCG
    GTGCCGACGT CGGCGACGCC GGGCGGTGGA CAGACCCTCG TCTTCGGCCA GCTCGAGGTC
    GTACCCCAGC ACCAGACCTC CATTCAGCAA CAGCAGCAAC AGCAGGGCAA CAACAAGAAC
    GACCAAGTGC AAAAGTATAC AACGTGTACG GCTGGCGCAC CATCGGGCCA GAATCGCGGC
    ATGCAATTCG CCCCCTGGCA ATTCGCCGCC CAGGGCATCT GGACCGGACT TCAACCGCAG
    ACGTTGCTCA CGGCAGCTCC AAATCAAATA TTTATACGAG ACCCGACGCA GCCTGACATG
    TTCATACAGA GTCCGCAGCC CATTCAGACG CATAATGCAC TGGCGGCGCA GCAGCAAATC
    CAGGGTGTCC AGCAAATAGC TACGACGGGA GGCAAGCCCC GGGTGATGAA CATACAGCAG
    CAGCAGCAGA CGAACAAGCA GGGCGTCGTG AGCCAACGTC CGCTCAGCAT CCTCCCGTCG
    TCCTTACAGG GCGTCCAGGC GGCCAATATC AGGCCAGCAA GTTCCGTGTC CACGCAGACG
    AACCACGGGG TCCAGGCGAC GGTCCACGCC CAGAGCGGCA AAGGAGGTGG CGGCGCGGGC
    AAAGGCCGCG GTAAGCCGGT GGTTCGCACA AGTCCCGGTC CTAACGCCAT CAATGTCACG
    GTAACGAAGG CCGGTGGCGG CGGCAACGCA TCCGGCGCAC AAACTAAAAA CGCCAATGTC
    CAGCACGCGA CAATGATAAT GCAGCCGCAG CCCGGGCCCC AGACCGCGGG CAACAATAAC
    GGAACGAATA ACAAAATGCT AATAGCGACG AGCACAGCAA CTTCTGCGCA ACCACCCGGC
    TCACCAATGA CCGCCGCTGA CAAGCAAAAT TTCGGCCAGC AACAAAACAA ACAAACCGTT
    ATGCAATCAC CCCAGCAGCA GCAGCAACAA CAGCAGCAGC AGCAGGCCCA GCAGCAGGCC
    CAGGCCCAAG CTCAGCAGCA GCAGGCTCAG GCACAGGCTC AACAGCAGGC CCAACTCCAA
    GCCCAACAGC AGCAGCAGAT ACAGCAGATA TTCATCCAAC AGATTCAGCA GCAACAGCAA
    CTGCAGCAGC AGTACCAGCA GGCCCAGCAG GCGCCCCAGC AGATTCAACC CAAACCCCTT
    ATGGGTATGG CGGTACAGCA GCAGCCTGGC CAGCAGCAGA ACGTCGTCCT TGGTGGTGAG
    CGACCGATAA TGCCGGTAGT CTCGATCAAC CCCGCCCTTA TTGGCAATCA GATCGTCAGT
    GGGGCCCATC AGATTCAGGC ACTACCGATC GTCAGCCAGA CGGCCGATCA ATTGCAGGCC
    GCTGCCGTCG CGGCAGCGGC CCAACAACAG ATGCATCAGG CCGCTACCCA ACAGCAGCTC
    CAGCAGCAGC ATCAACAACA ACAACAGCAG CAGCAGCAGC AGCAGCAACA ACAGCAACAG
    CAGCAGCAAC AACAACAACA ACAGCAGCAA CAGCAGCAGC AACAACAACA GCAGCAGCAG
    CAGCAGCAAC AGCAACAGCA ACAGCAACAG CAGCAACAGA CTTCCACGGA ACAAGGTCAG
    AGTATGCCGA TACTCGTGAC GTCACCCGAC AGGGCCGCAC CCGGCCACAT CGAACTCCAG
    TCGTTGATGC AGCCACCGCC ACCGGCGGCC ACCCCCATGA GCTCCACGGT CGATGATCCT
    TCTAAAATAA TCATCCCTAC GAAGAAGGAA TCCTCGGAGA TGGCCACTGG CGATGATGTA
    TCAATGGATA CGTCTGGTCA GTCGGAAATC GACCAGAGGA ATATCGGCAA GGACGAGCAT
    CTGGATGGAG TGTCGATTAA GAGCGACGAT AAAACCAATA ATCCTCTTAT AAATCTTGCG
    AACGCCGTAA ACTCGATAAC AAATGGCAAT ATCGGCGAGG AGACGACGGT CTTGGAATCT
    CTGCCGATGA CAGTGAGCAG CAAGCAGGTG CCACCCAAGG CAATGGTTAA ACCGCAAGTG
    CTCACCCACG TTATCGAGGG CTTCGTCATA CAAGAAGCAT CGGAGCCATT TGCCGTGAAT
    CGCTCGTCAC TCAATGGATC GATAACGCAA GAAACAAACA ACATTGGTAG AAATCACTCC
    GCGGATAAAG AAAATCACGA GGAGCCACTG ATCAAAAGAA AGAAAAATTC TGTCAATTAC
    TCAACGGATG GAGACCAGGG CCTGCAAGGA AAATGCGAGG CATGTGGCAA TATTCTGGAC
    GAGCAGAACA TGAAAATCAA GAAAGACAAG AGGTTCTGCT CAACTATTTG CGCCAAATCG
    AAAAAGAAAG AAATTCGAGA TAACGGAGAC AAACAATGGT CGGAAATAGA AATTGATGTT
    AAAATTGATA ACGACTCGAT TAAAAAGAAT GGAGACGATA AGTCGATGAT TGGTTTACCT
    CATAATGTGG CATTAGACGA CTCTTTGCCA AAGATAAATC CTGTTAAGTG GACGGTCGGC
    GAAGTTTGCG ACTTTATAAG AAATTTGCCG GGCTGTGCAG ATTACGCCGA GGATTTCGCC
    ATTCAAGAAA TCGACGGCCA GGCTCTCATG CTCCTCAAAG AGGATCACTT AATGTCCGCA
    ATGAGCATCA AGCTCGGGCC GGCCTTGAAG ATCGTAGCAA AAATCGATTC GATGAGGATG
    GATTCAACAA CGAACGCCAG TCCCGTGACT GGCAGTAACG TTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.