NPR1 cDNA ORF clone, Camelus ferus(Wild Bactrian camel)

The following NPR1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the NPR1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCa36640 XM_006196042.2
Latest version!
Camelus ferus natriuretic peptide receptor 1 (NPR1), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCa36640
    Clone ID Related Accession (Same CDS sequence) XM_006196042.2
    Accession Version XM_006196042.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2598bp)
    Protein sequence
    SNP
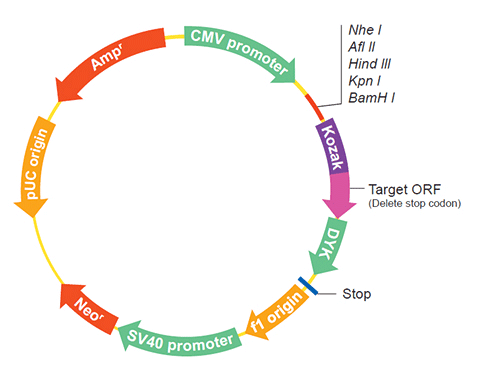
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
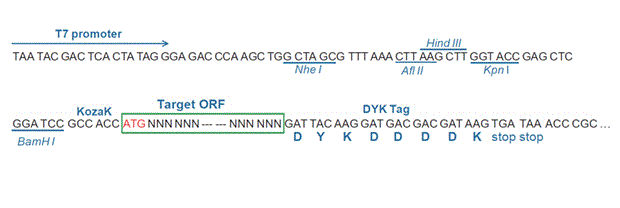
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-11-02
    Organism Camelus ferus(Wild Bactrian camel)
    Product LOW QUALITY PROTEIN: atrial natriuretic peptide receptor 1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_006210482.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Nov 3, 2015 this sequence version replaced XM_006196042.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Camelus ferus Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGCGGGTCC GCGACCGCCT CAACATCACC GTGGACCACC TGGAGTTCGC CGAGGGCGAC 
    CGCGACCACT ACACCATGCT GCTGCGGACC GTGCGGCGCA AAGGCCGAGT TATCTACATC
    TGCAGCTACC CAGATACCTT CAGAACCCTG ATGCTTCTGG CCCTGGAAGC TGGCTTGAGT
    GGGGAGGAGT ATGTTTTCTT CCACCTGGAC CTCTTCGGGC AAAGCCTGCA AGGTGGACAT
    GGCCTTGCTC CCCGCAGGCC CTGGGAGAGA GGGGATGGGC AGGATGTCAG TGCCCACCAG
    GCCTTTCAGG CTGCCAAAAT CATTACATAT AAAGAGCCGG ATAATCCTGA GTACCTGGAA
    TTCTTGCTGA AGTTAAAACA CGTGGCCCGT GAGCAGTTCA ACTTCACCAT GGACGATGGC
    CTGGTGAACA CCATCCCAGC ATCCTTCCAC GACGGGCTCC TGCTGTATGT CCAGGCAGTG
    ACAGAGACTT TAGCACATGG GGGAGCTGTC ACCGATGGGG AGGGCATCAC TCAGCGGATG
    TGGAACCGAA GTTTCCAAGG TGTGACAGGA TACCTGAAAA TGGACAGCAA TGGTGATCGG
    GAGACTGACT TCTCCCTCTG GGATATGGAT CCCGAGACTG GAGCCTTCAG GGTTGTTCTG
    AACTTCAATG GGACTTCCCA AGAGCTGCTG ACCATGTCAG GGTGCAAACT ACACTGGCCC
    CTGGGATACC CACCTCCTGA TGTCCCCAAA TGTGGCTTTG ACAACGAGGA CCCAGCCTGC
    AATCAAGACC ACTTTTCCAC CCTGGAAGTG TTGGCTTTGG TAGGCAGCCT CTCCCTGCTC
    AGCATTCTGA TCATCTCCTT CTTCATCTAC AGGAAGATGC AGCTGGAAAA GGAACTGGCC
    TCAGAGCTGT GGCGCGTGCG CTGGGAGGAC CTGCAGCCCA GCAGTCTTGA GAGGCACCTC
    CGGAGTGCCG GCAGCCGGCT GACCCTGAGT GGGAGGGGCT CCAATTATGG CTCCCTGATG
    ACCACAGAGG GCCAGTTCCA AATCTTTGCC AAGACAGCGT ATTATAAGGG TAACCTTGTG
    GCTGTGAAAC GTGTGAACCG TAAACGCATT GAGCTGACGC GGGAAGTCCT GTTTGAGCTG
    AAGCATATGC GGGATGTGCA GAATGAACAC CTGACCAGGT TTGTGGGGGC CTGCACTGAC
    CCCCCCAACA TCTGTATCCT CACAGAGTAC TGTCCCCGTG GGAGCCTGCA GGACATTCTG
    GAGAATGAGA GCATCACCCT GGACTGGATG TTCCGGTACT CACTCACCAA TGACATCGTC
    AAGGGTATGC TGTTCCTACA CAATGGGGCC ATTTGCTCCC ATGGGAACCT CAAGTCATCC
    AACTGCGTGG TAGATGGGCG CTTCGTGCTC AAGATCACTG ACTACGGGCT GGAGAGCTTC
    AGGGACCCGG AGCCAGAGCA AGGACACACC CTTTATGCCA AAAAGTTGTG GACCGCCCCA
    GAGCTCCTGC GAATGGCCTC ACCCCCTGCC CGGGGCTCCC AGGCTGGTGA CGTGTACAGC
    TTTGGGATCA TCCTTCAGGA GATTGCCCTG AGGAGTGGCG TCTTCCATGT GGAAGGTTTG
    GACCTCAGTC CCAAAGAGAT CATCGAGCGC GTGACTCGGG GCGAGCAGCC CCTTCCGGCC
    CTCCCCGGCC CGCCCCCCTT CCGGCCCTCC CTGGCCCTGC AGAGTCACCT GGAGGAACTG
    GGGCAGCTGA TGCAGCGGTG CTGGGCCGAG GACCCGCAGG AGCGGCCACC CTTCCAACAG
    ATTCGCCTGA TGCTGCGCAA ATTTAATAGG GGGAGCAGCA GCAACATCCT GGACAACCTG
    CTGTCCCGCA TGGAGCAGTA CGCCAACAAC CTGGAGGAGC TGGTGGAGGA GCGGACCCAG
    GCCTACCTGG AGGAGAAGCG CAAGGCAGAG GCCCTGCTCT ACCAGATTCT GCCTCACTCA
    GTGGCTGAGC AGCTGAAGCG CGGGGAGACT GTCCAGGCCG AAGCCTTTGA CAGCGTTACT
    ATCTACTTCA GTGACATTGT GGGTTTCACA GCCCTGTCAG CGGAGAGCAC GCCCATGCAG
    GTGGTGACCC TGCTCAACGA CCTGTACACT TGCTTTGATG CCGTCATAGA CAACTTTGAT
    GTATACAAGG TGGAGACAAT CGGTGACGCC TACATGGTGG TGTCGGGGCT CCCGGTGCGG
    AATGGGAGGC TGCACGCCCC CGAGGTGGCC CGCATGGCCC TGGCGCTGCT GGACGCCGTG
    CGCTCCTTCC GCATCCGCCA CAGGCCCCAG GAGCAGCTGC GCTTGCGCAT CGGCATCCAC
    ACAGGACCCG TTTGTGCTGG TGTAGTGGGG CTGAAGATGC CCCGTTACTG TCTCTTTGGG
    GACACAGTCA ACACGGCCTC AAGAATGGAG TCTAATGGGG AAGCCCTGAA GATCCACTTG
    TCTTCTGAGA CCAAGGCTGT CCTGGAAGAG TTTGGTGGTT TCGAGCTGGA GCTTCGAGGG
    GATGTAGAAA TGAAGGGCAA AGGCAAAGTT CGGACCTACT GGCTCCTGGG GGAGCGGGGG
    AGTAGCACAC GGGGCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_006196104.1
    CDS170..2767
    Translation

    Target ORF information:

    RefSeq Version XM_006196042.2
    Organism Camelus ferus(Wild Bactrian camel)
    Definition Camelus ferus natriuretic peptide receptor 1 (NPR1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_006196042.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGCGGGTCC GCGACCGCCT CAACATCACC GTGGACCACC TGGAGTTCGC CGAGGGCGAC 
    CGCGACCACT ACACCATGCT GCTGCGGACC GTGCGGCGCA AAGGCCGAGT TATCTACATC
    TGCAGCTACC CAGATACCTT CAGAACCCTG ATGCTTCTGG CCCTGGAAGC TGGCTTGAGT
    GGGGAGGAGT ATGTTTTCTT CCACCTGGAC CTCTTCGGGC AAAGCCTGCA AGGTGGACAT
    GGCCTTGCTC CCCGCAGGCC CTGGGAGAGA GGGGATGGGC AGGATGTCAG TGCCCACCAG
    GCCTTTCAGG CTGCCAAAAT CATTACATAT AAAGAGCCGG ATAATCCTGA GTACCTGGAA
    TTCTTGCTGA AGTTAAAACA CGTGGCCCGT GAGCAGTTCA ACTTCACCAT GGACGATGGC
    CTGGTGAACA CCATCCCAGC ATCCTTCCAC GACGGGCTCC TGCTGTATGT CCAGGCAGTG
    ACAGAGACTT TAGCACATGG GGGAGCTGTC ACCGATGGGG AGGGCATCAC TCAGCGGATG
    TGGAACCGAA GTTTCCAAGG TGTGACAGGA TACCTGAAAA TGGACAGCAA TGGTGATCGG
    GAGACTGACT TCTCCCTCTG GGATATGGAT CCCGAGACTG GAGCCTTCAG GGTTGTTCTG
    AACTTCAATG GGACTTCCCA AGAGCTGCTG ACCATGTCAG GGTGCAAACT ACACTGGCCC
    CTGGGATACC CACCTCCTGA TGTCCCCAAA TGTGGCTTTG ACAACGAGGA CCCAGCCTGC
    AATCAAGACC ACTTTTCCAC CCTGGAAGTG TTGGCTTTGG TAGGCAGCCT CTCCCTGCTC
    AGCATTCTGA TCATCTCCTT CTTCATCTAC AGGAAGATGC AGCTGGAAAA GGAACTGGCC
    TCAGAGCTGT GGCGCGTGCG CTGGGAGGAC CTGCAGCCCA GCAGTCTTGA GAGGCACCTC
    CGGAGTGCCG GCAGCCGGCT GACCCTGAGT GGGAGGGGCT CCAATTATGG CTCCCTGATG
    ACCACAGAGG GCCAGTTCCA AATCTTTGCC AAGACAGCGT ATTATAAGGG TAACCTTGTG
    GCTGTGAAAC GTGTGAACCG TAAACGCATT GAGCTGACGC GGGAAGTCCT GTTTGAGCTG
    AAGCATATGC GGGATGTGCA GAATGAACAC CTGACCAGGT TTGTGGGGGC CTGCACTGAC
    CCCCCCAACA TCTGTATCCT CACAGAGTAC TGTCCCCGTG GGAGCCTGCA GGACATTCTG
    GAGAATGAGA GCATCACCCT GGACTGGATG TTCCGGTACT CACTCACCAA TGACATCGTC
    AAGGGTATGC TGTTCCTACA CAATGGGGCC ATTTGCTCCC ATGGGAACCT CAAGTCATCC
    AACTGCGTGG TAGATGGGCG CTTCGTGCTC AAGATCACTG ACTACGGGCT GGAGAGCTTC
    AGGGACCCGG AGCCAGAGCA AGGACACACC CTTTATGCCA AAAAGTTGTG GACCGCCCCA
    GAGCTCCTGC GAATGGCCTC ACCCCCTGCC CGGGGCTCCC AGGCTGGTGA CGTGTACAGC
    TTTGGGATCA TCCTTCAGGA GATTGCCCTG AGGAGTGGCG TCTTCCATGT GGAAGGTTTG
    GACCTCAGTC CCAAAGAGAT CATCGAGCGC GTGACTCGGG GCGAGCAGCC CCTTCCGGCC
    CTCCCCGGCC CGCCCCCCTT CCGGCCCTCC CTGGCCCTGC AGAGTCACCT GGAGGAACTG
    GGGCAGCTGA TGCAGCGGTG CTGGGCCGAG GACCCGCAGG AGCGGCCACC CTTCCAACAG
    ATTCGCCTGA TGCTGCGCAA ATTTAATAGG GGGAGCAGCA GCAACATCCT GGACAACCTG
    CTGTCCCGCA TGGAGCAGTA CGCCAACAAC CTGGAGGAGC TGGTGGAGGA GCGGACCCAG
    GCCTACCTGG AGGAGAAGCG CAAGGCAGAG GCCCTGCTCT ACCAGATTCT GCCTCACTCA
    GTGGCTGAGC AGCTGAAGCG CGGGGAGACT GTCCAGGCCG AAGCCTTTGA CAGCGTTACT
    ATCTACTTCA GTGACATTGT GGGTTTCACA GCCCTGTCAG CGGAGAGCAC GCCCATGCAG
    GTGGTGACCC TGCTCAACGA CCTGTACACT TGCTTTGATG CCGTCATAGA CAACTTTGAT
    GTATACAAGG TGGAGACAAT CGGTGACGCC TACATGGTGG TGTCGGGGCT CCCGGTGCGG
    AATGGGAGGC TGCACGCCCC CGAGGTGGCC CGCATGGCCC TGGCGCTGCT GGACGCCGTG
    CGCTCCTTCC GCATCCGCCA CAGGCCCCAG GAGCAGCTGC GCTTGCGCAT CGGCATCCAC
    ACAGGACCCG TTTGTGCTGG TGTAGTGGGG CTGAAGATGC CCCGTTACTG TCTCTTTGGG
    GACACAGTCA ACACGGCCTC AAGAATGGAG TCTAATGGGG AAGCCCTGAA GATCCACTTG
    TCTTCTGAGA CCAAGGCTGT CCTGGAAGAG TTTGGTGGTT TCGAGCTGGA GCTTCGAGGG
    GATGTAGAAA TGAAGGGCAA AGGCAAAGTT CGGACCTACT GGCTCCTGGG GGAGCGGGGG
    AGTAGCACAC GGGGCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.