GNPTAB cDNA ORF clone, Calidris pugnax(ruff)

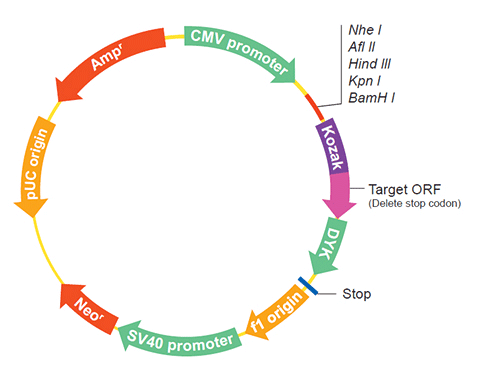
The following GNPTAB gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the GNPTAB cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCa61645 XM_014937346.1
Latest version!
Calidris pugnax N-acetylglucosamine-1-phosphate transferase, alpha and beta subunits (GNPTAB), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OCa61646 XM_014937347.1
Latest version!
Calidris pugnax N-acetylglucosamine-1-phosphate transferase, alpha and beta subunits (GNPTAB), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OCa61647 XM_014937348.1
Latest version!
Calidris pugnax N-acetylglucosamine-1-phosphate transferase, alpha and beta subunits (GNPTAB), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCa61645
    Clone ID Related Accession (Same CDS sequence) XM_014937346.1
    Accession Version XM_014937346.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3777bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
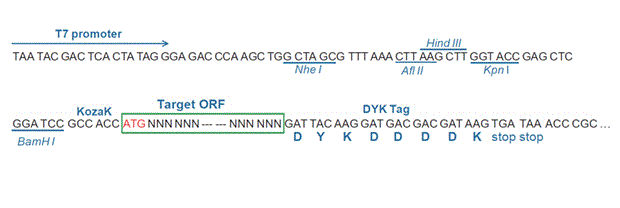
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-08
    Organism Calidris pugnax(ruff)
    Product N-acetylglucosamine-1-phosphotransferase subunits alpha/beta isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015090800.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Calidris pugnax Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTGCTAA AGCTCCTGCA GCGCCAGACC TATACCTGCC TGTCGCACAG GTATGGGCCC 
    TGCCTCTGCC TCGGGGGGCT CGTCCTCATG ATCGTCTCCG CCCTGCAGTT CGGGGAGGTT
    GTCTTGGAGT GGAGTAGAGA CCAGTATCAT GTTATGTTTG ATTCATACAG AGACAATGTT
    GCTGGCAAAT CATTTCAGAA TCGGCTTTGT TTACCCATGC CGATTGATGT GGTGTACACC
    TGGGTGAACG GCACAGATGT TGAACTGATC AAAGAATTGC AACAGGTCAG AGAACAGATG
    GAGGAAGAAC AGAAAATAAT GAGGGAAATA CTCGGAAAGA ATGCAACAGA ACCAACAAAG
    AAGAGTGAGA AGCATCTGGA GTGTTTGCTG ACGCACTGCA TCAAAGTGCC AATGCTTGTC
    CTGGATCCTG CGCTGCCTGC CAATGTCACA CTGAAAGACC TCTCGTCCAT TCATCCTGCT
    TTACAAGCTG CTAACAATAT GTTTTTTGTA GCAAAACCAA AAAATCCTTC TACCAACGTG
    ACAGTAATTG TTTTTGATAG CCCTAAGGAT GTTGAAGCTG CCCATTCTGG AATGTTAAAA
    GACAACAGTA AACAGATAGT ATGGAGGGGC TATTTGACTA CAGATAAAGA AGTTCCAGGT
    CTGGTATTAA TGCAAGACTT GGCCTTCCTT AGTGGATTTC CAGCTACATT CAAAGAAACA
    AATCAGCTAC GAACAAAACT ACCGGAGAGC CTGGCCTCTA AAGTAAAACT GTTGCAGCTC
    TATTCAGAAG CCAGCGTGGC TCTCTTGCAA CTGAATAACC CTAAGGGCTT CCAAGAACTG
    AGCAAGCAAG CAAAGAAGAA CATGACTATA GATGGAAAAG AACTGACGCT TAATCCTGCT
    TATTTACTAT GGGACCTCAG CTCTGTCACT CAGTCTAAAC AGGATGAAGA TATTTCTGCC
    AGCCGTTTTG AAGATAACGA AGAGCTGAGG TACTCGTTGC GATCGATAGA GAGGCATGCC
    CCTTGGGTAC GACACATTTT CATCGTCACT AATGGGCAGA TTCCTTCCTG GCTTAACCTG
    GATAATCCTC GGATAACCAT AGTGACGCAT CAGGAAATAT TTCAGAATGT GAGTCACTTG
    CCTACCTTCA GTTCACCAGC CATTGAAAGT CACATTCATC GTATCAGTGG ACTCTCTCAG
    AAGTTTATCT ATCTCAATGA TGATGTTATG TTTGGGAAGG ATGTTTGGCC TGATGATTTT
    TACAGTCACT CTAAAGGTCA AAAGGTTTAT TTGACCTGGC CTGTGCCAAA CTGTGCTGAG
    GGATGTCCTG GCTCATGGAT TAAAGATGGT TACTGTGACA AAGCCTGTAA TAACTCAGCG
    TGTGACTGGG ATGGAGGTGA TTGCATTGGT AACAGTGGGG GTAGTCGCTA CGTTGCTGGT
    GGAGGTGCAG TCGGAGGTAT TGGGAATGGA CCACCGTGGC AGTTTGGGGC AGGAATAAGT
    GGCGTTTCAT ACTGCAACCA AGGCTGTGCT AATTCCTGGC TAGCAGACAA ATTCTGTGAT
    CAGGCCTGCA ATGTCCTCTC CTGTGCATTT GATGCTGGTG ACTGTGGCCA GGATCACTTT
    GAAGAGATGT ATAAGGTGAC ACTTCAGCAT AATCAGACCT ACTATGTTAT TCCCAAAGGT
    GAATGTCTGC CCTACTTCAG CTTCAGTGAA ATAGCCAAGA AGGCAATTGA GGGTTCATAT
    AGTGATAATC CAATTATCCG ACATGCTTCA GTTGCTAACA AATGGAAGAC TATCCACCTC
    ATACTGAATA GTGGCATGAA TGCAACTGTG ATCTATTTTA ACCTTACGTT TCTAAATAAG
    AATGATGAAG AGTTTAAAAT GCAGGTAGCT GTCGAGGTTG ATACTAGAGA GGAACCAAAA
    CTGAACACAA CTTCCATGCA AAAACCCAAC TCTGATTTTA AAACTGTAAC ATCTATACCA
    GAAGCTGAAA TGATATTTGA GGATATTCCT GAAGAAAAAC GCTTTCCAAG AGTCAGCAGA
    CGTCGAAATG GCACAAAAGA GAGCCTACAT GAGGAGGTGC TAATGCCATC AGTAAACGTG
    TCTCTCCTTC CTGAAGATGT TCAGCTAGCA CTGCAAAACC TGGATTTGAA ACTGCTAAAT
    GGTGATATCA CTCAGAAAGG ATTTAACCTG TCAAAGGCTG CTCTCCTGAG ACCTTTTCAG
    TTCTTAACTA CAGTAAAGAG TATTATAGGC CTGGAAAAGA AGGGCATGCG TAATCATTCG
    GAAGATCAGA AGAACCGTAC CAGCTGGCAG AAGCCTTATG AAGATGTAAA TGATGGCAAA
    ATAAAAATGA TAAAAGCAAA TGAAGAAGTT CCTTCAAAGC TTACAGGAAC AAAGGGGACT
    GTTGTGACAA CGAACACGAA TAAACTTATT TATAAAGTCA AGCCTAAATC CACACTTCCC
    TCCCAGAGCA TAGGAAATAA AAATGAAACT CGAGAAAAAG TATTGAACTC ACTCATATTA
    AGGGAAACTC AGAAATCGAA ACAAACTGAG AATTTAGATA CTGGAGAAGA TGCACAAGGG
    ATGGAAGGAG GAAAAGGCGG TGTGCAGGTG GATACAAATG TAAGGGAGGG GCTAGTGGGA
    AGAAAATTAC AGTCTTATGC TGGAAGTTAC CAAGGCTTTT TGCCATGGGA GAAAAAGAAG
    TATTTCCAGG ACCTCCTTGA TGAAGAAGAG TCATTACTCA AGCAAATGTC ATACTTTACT
    GATGGTAAAC ATTTTGGAAG GCAGCTGAAA GATACATTTG CTGATTCCCT TCGATATGTA
    AATAAGCTTT TGAACAGCAA ATTTGGATTT ACATCTCGGA AAGTCCCTGC TCATATGCCT
    CACATGATTG ACCGCACTGT TATGCAAGAG CTGCAGGATA TGTTTCCCGA GGAGTTTGAC
    AAGACATCAT TTCACAAAGT GCGGCACTCA GAAGATATGC AGTTTGCTTT TTCGTATTTC
    TACTATCTTA TGAGTGCAGT CCAGCCACTG AACATTTCTC AGATCTTCAA TGAGGTTGAT
    ACAGACCAAT CGGGCATCTT GTCTGACCGA GAGATTCGCA CGTTGGCCAC AAGAATCCAT
    GAATTGCCGC TAAGTTTGCA GGATTTGACA GGTCTAGAAC AAATGCTAAT AAATTGCTCT
    AAATCCCTTC CTGCCAACAT CACTCAGATC CATGTCATTC CACCAACTCA GGAAGCGTAT
    TACGATCCCA ATCTGCCTCC AGTAACAAAA AACCTAGTGA CTAATTGCAA ACCTGTGACT
    GACAGAATCC GTAAGGCATA CAAGGACAAA AACAAATACA GGTTTGAAAT CATGGGAGAA
    GAGGAAATTG CCTTCAAAAT GATTCGCACA AATGTTTCTC ATGTGGTTGG TCAGCTGGAT
    GACATACGAA AAAATCCCAG AAAATTCGTT TGCCTAAATG ACAATATTGA TCACAATCAT
    AAGGATGCTC AGACAGTGAA AGCAGTGCTT AGGGACTTTT ATGAATCAAT GTTTCCCATA
    CCCTCTCAAT TTGAACTGCC AAGAGAATAT CGGAATCGTT TCCTTCACAT GCATGAACTC
    CAAGAATGGA GGGCATATAG AGACAAGCTC AAATTCTGGA CCCACTGTGT TCTAGTAACA
    CTGATTGTAT TTACAGTCAT CTCATTTTTT GCTGAACAGC TAATTGCACT TAAACGAAAG
    ATTTTTCCAA GGAGAAGGAT CCAAAAGGAA GTTGGTCATG AACGAATCAA GGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014792832.1
    CDS39..3815
    Translation

    Target ORF information:

    RefSeq Version XM_014937346.1
    Organism Calidris pugnax(ruff)
    Definition Calidris pugnax N-acetylglucosamine-1-phosphate transferase, alpha and beta subunits (GNPTAB), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014937346.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTGCTAA AGCTCCTGCA GCGCCAGACC TATACCTGCC TGTCGCACAG GTATGGGCCC 
    TGCCTCTGCC TCGGGGGGCT CGTCCTCATG ATCGTCTCCG CCCTGCAGTT CGGGGAGGTT
    GTCTTGGAGT GGAGTAGAGA CCAGTATCAT GTTATGTTTG ATTCATACAG AGACAATGTT
    GCTGGCAAAT CATTTCAGAA TCGGCTTTGT TTACCCATGC CGATTGATGT GGTGTACACC
    TGGGTGAACG GCACAGATGT TGAACTGATC AAAGAATTGC AACAGGTCAG AGAACAGATG
    GAGGAAGAAC AGAAAATAAT GAGGGAAATA CTCGGAAAGA ATGCAACAGA ACCAACAAAG
    AAGAGTGAGA AGCATCTGGA GTGTTTGCTG ACGCACTGCA TCAAAGTGCC AATGCTTGTC
    CTGGATCCTG CGCTGCCTGC CAATGTCACA CTGAAAGACC TCTCGTCCAT TCATCCTGCT
    TTACAAGCTG CTAACAATAT GTTTTTTGTA GCAAAACCAA AAAATCCTTC TACCAACGTG
    ACAGTAATTG TTTTTGATAG CCCTAAGGAT GTTGAAGCTG CCCATTCTGG AATGTTAAAA
    GACAACAGTA AACAGATAGT ATGGAGGGGC TATTTGACTA CAGATAAAGA AGTTCCAGGT
    CTGGTATTAA TGCAAGACTT GGCCTTCCTT AGTGGATTTC CAGCTACATT CAAAGAAACA
    AATCAGCTAC GAACAAAACT ACCGGAGAGC CTGGCCTCTA AAGTAAAACT GTTGCAGCTC
    TATTCAGAAG CCAGCGTGGC TCTCTTGCAA CTGAATAACC CTAAGGGCTT CCAAGAACTG
    AGCAAGCAAG CAAAGAAGAA CATGACTATA GATGGAAAAG AACTGACGCT TAATCCTGCT
    TATTTACTAT GGGACCTCAG CTCTGTCACT CAGTCTAAAC AGGATGAAGA TATTTCTGCC
    AGCCGTTTTG AAGATAACGA AGAGCTGAGG TACTCGTTGC GATCGATAGA GAGGCATGCC
    CCTTGGGTAC GACACATTTT CATCGTCACT AATGGGCAGA TTCCTTCCTG GCTTAACCTG
    GATAATCCTC GGATAACCAT AGTGACGCAT CAGGAAATAT TTCAGAATGT GAGTCACTTG
    CCTACCTTCA GTTCACCAGC CATTGAAAGT CACATTCATC GTATCAGTGG ACTCTCTCAG
    AAGTTTATCT ATCTCAATGA TGATGTTATG TTTGGGAAGG ATGTTTGGCC TGATGATTTT
    TACAGTCACT CTAAAGGTCA AAAGGTTTAT TTGACCTGGC CTGTGCCAAA CTGTGCTGAG
    GGATGTCCTG GCTCATGGAT TAAAGATGGT TACTGTGACA AAGCCTGTAA TAACTCAGCG
    TGTGACTGGG ATGGAGGTGA TTGCATTGGT AACAGTGGGG GTAGTCGCTA CGTTGCTGGT
    GGAGGTGCAG TCGGAGGTAT TGGGAATGGA CCACCGTGGC AGTTTGGGGC AGGAATAAGT
    GGCGTTTCAT ACTGCAACCA AGGCTGTGCT AATTCCTGGC TAGCAGACAA ATTCTGTGAT
    CAGGCCTGCA ATGTCCTCTC CTGTGCATTT GATGCTGGTG ACTGTGGCCA GGATCACTTT
    GAAGAGATGT ATAAGGTGAC ACTTCAGCAT AATCAGACCT ACTATGTTAT TCCCAAAGGT
    GAATGTCTGC CCTACTTCAG CTTCAGTGAA ATAGCCAAGA AGGCAATTGA GGGTTCATAT
    AGTGATAATC CAATTATCCG ACATGCTTCA GTTGCTAACA AATGGAAGAC TATCCACCTC
    ATACTGAATA GTGGCATGAA TGCAACTGTG ATCTATTTTA ACCTTACGTT TCTAAATAAG
    AATGATGAAG AGTTTAAAAT GCAGGTAGCT GTCGAGGTTG ATACTAGAGA GGAACCAAAA
    CTGAACACAA CTTCCATGCA AAAACCCAAC TCTGATTTTA AAACTGTAAC ATCTATACCA
    GAAGCTGAAA TGATATTTGA GGATATTCCT GAAGAAAAAC GCTTTCCAAG AGTCAGCAGA
    CGTCGAAATG GCACAAAAGA GAGCCTACAT GAGGAGGTGC TAATGCCATC AGTAAACGTG
    TCTCTCCTTC CTGAAGATGT TCAGCTAGCA CTGCAAAACC TGGATTTGAA ACTGCTAAAT
    GGTGATATCA CTCAGAAAGG ATTTAACCTG TCAAAGGCTG CTCTCCTGAG ACCTTTTCAG
    TTCTTAACTA CAGTAAAGAG TATTATAGGC CTGGAAAAGA AGGGCATGCG TAATCATTCG
    GAAGATCAGA AGAACCGTAC CAGCTGGCAG AAGCCTTATG AAGATGTAAA TGATGGCAAA
    ATAAAAATGA TAAAAGCAAA TGAAGAAGTT CCTTCAAAGC TTACAGGAAC AAAGGGGACT
    GTTGTGACAA CGAACACGAA TAAACTTATT TATAAAGTCA AGCCTAAATC CACACTTCCC
    TCCCAGAGCA TAGGAAATAA AAATGAAACT CGAGAAAAAG TATTGAACTC ACTCATATTA
    AGGGAAACTC AGAAATCGAA ACAAACTGAG AATTTAGATA CTGGAGAAGA TGCACAAGGG
    ATGGAAGGAG GAAAAGGCGG TGTGCAGGTG GATACAAATG TAAGGGAGGG GCTAGTGGGA
    AGAAAATTAC AGTCTTATGC TGGAAGTTAC CAAGGCTTTT TGCCATGGGA GAAAAAGAAG
    TATTTCCAGG ACCTCCTTGA TGAAGAAGAG TCATTACTCA AGCAAATGTC ATACTTTACT
    GATGGTAAAC ATTTTGGAAG GCAGCTGAAA GATACATTTG CTGATTCCCT TCGATATGTA
    AATAAGCTTT TGAACAGCAA ATTTGGATTT ACATCTCGGA AAGTCCCTGC TCATATGCCT
    CACATGATTG ACCGCACTGT TATGCAAGAG CTGCAGGATA TGTTTCCCGA GGAGTTTGAC
    AAGACATCAT TTCACAAAGT GCGGCACTCA GAAGATATGC AGTTTGCTTT TTCGTATTTC
    TACTATCTTA TGAGTGCAGT CCAGCCACTG AACATTTCTC AGATCTTCAA TGAGGTTGAT
    ACAGACCAAT CGGGCATCTT GTCTGACCGA GAGATTCGCA CGTTGGCCAC AAGAATCCAT
    GAATTGCCGC TAAGTTTGCA GGATTTGACA GGTCTAGAAC AAATGCTAAT AAATTGCTCT
    AAATCCCTTC CTGCCAACAT CACTCAGATC CATGTCATTC CACCAACTCA GGAAGCGTAT
    TACGATCCCA ATCTGCCTCC AGTAACAAAA AACCTAGTGA CTAATTGCAA ACCTGTGACT
    GACAGAATCC GTAAGGCATA CAAGGACAAA AACAAATACA GGTTTGAAAT CATGGGAGAA
    GAGGAAATTG CCTTCAAAAT GATTCGCACA AATGTTTCTC ATGTGGTTGG TCAGCTGGAT
    GACATACGAA AAAATCCCAG AAAATTCGTT TGCCTAAATG ACAATATTGA TCACAATCAT
    AAGGATGCTC AGACAGTGAA AGCAGTGCTT AGGGACTTTT ATGAATCAAT GTTTCCCATA
    CCCTCTCAAT TTGAACTGCC AAGAGAATAT CGGAATCGTT TCCTTCACAT GCATGAACTC
    CAAGAATGGA GGGCATATAG AGACAAGCTC AAATTCTGGA CCCACTGTGT TCTAGTAACA
    CTGATTGTAT TTACAGTCAT CTCATTTTTT GCTGAACAGC TAATTGCACT TAAACGAAAG
    ATTTTTCCAA GGAGAAGGAT CCAAAAGGAA GTTGGTCATG AACGAATCAA GGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCa61646
    Clone ID Related Accession (Same CDS sequence) XM_014937347.1
    Accession Version XM_014937347.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3747bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-08
    Organism Calidris pugnax(ruff)
    Product N-acetylglucosamine-1-phosphotransferase subunits alpha/beta isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015090800.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Calidris pugnax Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTGCTAA AGCTCCTGCA GCGCCAGACC TATACCTGCC TGTCGCACAG GTATGGGCCC 
    TGCCTCTGCC TCGGGGGGCT CGTCCTCATG ATCGTCTCCG CCCTGCAGTT CGGGGAGGTT
    GTCTTGGAGT GGAGTAGAGA CCAGTATCAT GTTATGTTTG ATTCATACAG AGACAATGTT
    GCTGGCAAAT CATTTCAGAA TCGGCTTTGT TTACCCATGC CGATTGATGT GGTGTACACC
    TGGGTGAACG GCACAGATGT TGAACTGATC AAAGAATTGC AACAGGTCAG AGAACAGATG
    GAGGAAGAAC AGAAAATAAT GAGGGAAATA CTCGGAAAGA ATGCAACAGA ACCAACAAAG
    AAGAGTGAGA AGCATCTGGA GTGTTTGCTG ACGCACTGCA TCAAAGTGCC AATGCTTGTC
    CTGGATCCTG CGCTGCCTGC CAATGTCACA CTGAAAGACC TCTCGTCCAT TCATCCTGCT
    TTACAAGCTG CTAACAATAT GTTTTTTGTA GCAAAACCAA AAAATCCTTC TACCAACGTG
    ACAGTAATTG TTTTTGATAG CCCTAAGGAT GTTGAAGCTG CCCATTCTGG AATGTTAAAA
    GACAACAGTA AACAGATAGT ATGGAGGGGC TATTTGACTA CAGATAAAGA AGTTCCAGGT
    CTGGTATTAA TGCAAGACTT GGCCTTCCTT AGTGGATTTC CAGCTACATT CAAAGAAACA
    AATCAGCTAC GAACAAAACT ACCGGAGAGC CTGGCCTCTA AAGTAAAACT GTTGCAGCTC
    TATTCAGAAG CCAGCGTGGC TCTCTTGCAA CTGAATAACC CTAAGGGCTT CCAAGAACTG
    AGCAAGCAAG CAAAGAAGAA CATGACTATA GATGGAAAAG AACTGACGCT TAATCCTGCT
    TATTTACTAT GGGACCTCAG CTCTGTCACT CAGTCTAAAC AGGATGAAGA TATTTCTGCC
    AGCCGTTTTG AAGATAACGA AGAGCTGAGG TACTCGTTGC GATCGATAGA GAGGCATGCC
    CCTTGGGTAC GACACATTTT CATCGTCACT AATGGGCAGA TTCCTTCCTG GCTTAACCTG
    GATAATCCTC GGATAACCAT AGTGACGCAT CAGGAAATAT TTCAGAATGT GAGTCACTTG
    CCTACCTTCA GTTCACCAGC CATTGAAAGT CACATTCATC GTATCAGTGG ACTCTCTCAG
    AAGTTTATCT ATCTCAATGA TGATGTTATG TTTGGGAAGG ATGTTTGGCC TGATGATTTT
    TACAGTCACT CTAAAGGTCA AAAGGTTTAT TTGACCTGGC CTGTGCCAAA CTGTGCTGAG
    GGATGTCCTG GCTCATGGAT TAAAGATGGT TACTGTGACA AAGCCTGTAA TAACTCAGCG
    TGTGACTGGG ATGGAGGTGA TTGCATTGGT AACAGTGGGG GTAGTCGCTA CGTTGCTGGT
    GGAGGTGCAG TCGGAGGTAT TGGGAATGGA CCACCGTGGC AGTTTGGGGC AGGAATAAGT
    GGCGTTTCAT ACTGCAACCA AGGCTGTGCT AATTCCTGGC TAGCAGACAA ATTCTGTGAT
    CAGGCCTGCA ATGTCCTCTC CTGTGCATTT GATGCTGGTG ACTGTGGCCA GGATCACTTT
    GAAGAGATGT ATAAGGTGAC ACTTCAGCAT AATCAGACCT ACTATGTTAT TCCCAAAGGT
    GAATGTCTGC CCTACTTCAG CTTCAGTGAA ATAGCCAAGA AGGCAATTGA GGGTTCATAT
    AGTGATAATC CAATTATCCG ACATGCTTCA GTTGCTAACA AATGGAAGAC TATCCACCTC
    ATACTGAATA GTGGCATGAA TGCAACTGTG ATCTATTTTA ACCTTACGTT TCTAAATAAG
    AATGATGAAG AGTTTAAAAT GCAGGTAGCT GTCGAGGTTG ATACTAGAGA GGAACCAAAA
    CTGAACACAA CTTCCATGCA AAAACCCAAC TCTGATTTTA AAACTGTAAC ATCTATACCA
    GAAGCTGAAA TGATATTTGA GGATATTCCT GAAGAAAAAC GCTTTCCAAG AGTCAGCAGA
    CGTCGAAATG GCACAAAAGA GAGCCTACAT GAGGAGGTGC TAATGCCATC AGTAAACGTG
    TCTCTCCTTC CTGAAGATGT TCAGCTAGCA CTGCAAAACC TGGATTTGAA ACTGCTAAAT
    GGTGATATCA CTCAGAAAGG ATTTAACCTG TCAAAGGCTG CTCTCCTGAG ACCTTTTCAG
    TTCTTAACTA CAGTAAAGAG TATTATAGGC CTGGAAAAGA AGGGCATGCG TAATCATTCG
    GAAGATCAGA AGAACCGTAC CAGCTGGCAG AAGCCTTATG AAGATGTAAA TGATGGCAAA
    ATAAAAATGA TAAAAGCAAA TGAAGAAGTT CCTTCAAAGC TTACAGGAAC AAAGGGGACT
    GTTGTGACAA CGAACACGAA TAAACTTATT TATAAAGTCA AGCCTAAATC CACACTTCCC
    TCCCAGAGCA TAGGAAATAA AAATGAAACT CGAGAAAAAG TATTGAACTC ACTCATATTA
    AGGGAAACTC AGAAATCGAA ACAAACTGAG AATTTAGATA CTGGAGAAGA TGCACAAGGG
    ATGGAAGGAG GAAAAGGCGG TGTGCAGGTG GATACAAATG TAAGGGAGGG GCTAGTGGGA
    AGAAAATTAC AGTCTTATGC TGGAAGTTAC CAAGGCTTTT TGCCATGGGA GAAAAAGAAG
    TATTTCCAGG ACCTCCTTGA TGAAGAAGAG TCATTACTCA AGCAAATGTC ATACTTTACT
    GATGGTAAAC ATTTTGGAAG GCAGCTGAAA GATACATTTG CTGATTCCCT TCGATATGTA
    AATAAGCTTT TGAACAGCAA ATTTGGATTT ACATCTCGGA AAGTCCCTGC TCATATGCCT
    CACATGATTG ACCGCACTGT TATGCAAGAG CTGCAGGATA TGTTTCCCGA GGAGTTTGAC
    AAGACATCAT TTCACAAAGT GCGGCACTCA GAAGATATGC AGTTTGCTTT TTCGTATTTC
    TACTATCTTA TGAGTGCAGT CCAGCCACTG AACATTTCTC AGATCTTCAA TGAGGTTGAT
    ACAGACCAAT CGGGCATCTT GTCTGACCGA GAGATTCGCA CGTTGGCCAC AAGAATCCAT
    GAATTGCCGC TAAGTTTGCA GGATTTGACA GGTCTAGAAC AAATGCTAAT AAATTGCTCT
    AAATCCCTTC CTGCCAACAT CACTCAGATC CATGTCATTC CACCAACTCA GGAAGCGTAT
    TACGATCCCA ATCTGCCTCC AGTAACAAAA AACCTAGTGA CTAATTGCAA ACCTGTGACT
    GACAGAATCC GTAAGGCATA CAAGGACAAA AACAAATACA GGTTTGAAAT CATGGGAGAA
    GAGGAAATTG CCTTCAAAAT GATTCGCACA AATGTTTCTC ATGTGGTTGG TCAGCTGGAT
    GACATACGAA AAAATCCCAG AAAATTCGTT TGCCTAAATG ACAATATTGA TCACAATCAT
    AAGGATGCTC AGACAGTGAA AGCAGTGCTT AGGGACTTTT ATGAATCAAT GTTTCCCATA
    CCCTCTCAAT TTGAACTGCC AAGAGAATAT CGGAATCGTT TCCTTCACAT GCATGAACTC
    CAAGAATGGA GGGCATATAG AGACAAGCTC AAATTCTGGA CCCACTGTGT TCTAGTAACA
    CTGATTGTAT TTACAGTCAT CTCATTTTTT GCTGAACAGG TGGGGGCCTT AAGTAACACT
    TTCCGTGGTC TGATGAAGAG GGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014792833.1
    CDS39..3785
    Translation

    Target ORF information:

    RefSeq Version XM_014937347.1
    Organism Calidris pugnax(ruff)
    Definition Calidris pugnax N-acetylglucosamine-1-phosphate transferase, alpha and beta subunits (GNPTAB), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014937347.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGCTGCTAA AGCTCCTGCA GCGCCAGACC TATACCTGCC TGTCGCACAG GTATGGGCCC 
    TGCCTCTGCC TCGGGGGGCT CGTCCTCATG ATCGTCTCCG CCCTGCAGTT CGGGGAGGTT
    GTCTTGGAGT GGAGTAGAGA CCAGTATCAT GTTATGTTTG ATTCATACAG AGACAATGTT
    GCTGGCAAAT CATTTCAGAA TCGGCTTTGT TTACCCATGC CGATTGATGT GGTGTACACC
    TGGGTGAACG GCACAGATGT TGAACTGATC AAAGAATTGC AACAGGTCAG AGAACAGATG
    GAGGAAGAAC AGAAAATAAT GAGGGAAATA CTCGGAAAGA ATGCAACAGA ACCAACAAAG
    AAGAGTGAGA AGCATCTGGA GTGTTTGCTG ACGCACTGCA TCAAAGTGCC AATGCTTGTC
    CTGGATCCTG CGCTGCCTGC CAATGTCACA CTGAAAGACC TCTCGTCCAT TCATCCTGCT
    TTACAAGCTG CTAACAATAT GTTTTTTGTA GCAAAACCAA AAAATCCTTC TACCAACGTG
    ACAGTAATTG TTTTTGATAG CCCTAAGGAT GTTGAAGCTG CCCATTCTGG AATGTTAAAA
    GACAACAGTA AACAGATAGT ATGGAGGGGC TATTTGACTA CAGATAAAGA AGTTCCAGGT
    CTGGTATTAA TGCAAGACTT GGCCTTCCTT AGTGGATTTC CAGCTACATT CAAAGAAACA
    AATCAGCTAC GAACAAAACT ACCGGAGAGC CTGGCCTCTA AAGTAAAACT GTTGCAGCTC
    TATTCAGAAG CCAGCGTGGC TCTCTTGCAA CTGAATAACC CTAAGGGCTT CCAAGAACTG
    AGCAAGCAAG CAAAGAAGAA CATGACTATA GATGGAAAAG AACTGACGCT TAATCCTGCT
    TATTTACTAT GGGACCTCAG CTCTGTCACT CAGTCTAAAC AGGATGAAGA TATTTCTGCC
    AGCCGTTTTG AAGATAACGA AGAGCTGAGG TACTCGTTGC GATCGATAGA GAGGCATGCC
    CCTTGGGTAC GACACATTTT CATCGTCACT AATGGGCAGA TTCCTTCCTG GCTTAACCTG
    GATAATCCTC GGATAACCAT AGTGACGCAT CAGGAAATAT TTCAGAATGT GAGTCACTTG
    CCTACCTTCA GTTCACCAGC CATTGAAAGT CACATTCATC GTATCAGTGG ACTCTCTCAG
    AAGTTTATCT ATCTCAATGA TGATGTTATG TTTGGGAAGG ATGTTTGGCC TGATGATTTT
    TACAGTCACT CTAAAGGTCA AAAGGTTTAT TTGACCTGGC CTGTGCCAAA CTGTGCTGAG
    GGATGTCCTG GCTCATGGAT TAAAGATGGT TACTGTGACA AAGCCTGTAA TAACTCAGCG
    TGTGACTGGG ATGGAGGTGA TTGCATTGGT AACAGTGGGG GTAGTCGCTA CGTTGCTGGT
    GGAGGTGCAG TCGGAGGTAT TGGGAATGGA CCACCGTGGC AGTTTGGGGC AGGAATAAGT
    GGCGTTTCAT ACTGCAACCA AGGCTGTGCT AATTCCTGGC TAGCAGACAA ATTCTGTGAT
    CAGGCCTGCA ATGTCCTCTC CTGTGCATTT GATGCTGGTG ACTGTGGCCA GGATCACTTT
    GAAGAGATGT ATAAGGTGAC ACTTCAGCAT AATCAGACCT ACTATGTTAT TCCCAAAGGT
    GAATGTCTGC CCTACTTCAG CTTCAGTGAA ATAGCCAAGA AGGCAATTGA GGGTTCATAT
    AGTGATAATC CAATTATCCG ACATGCTTCA GTTGCTAACA AATGGAAGAC TATCCACCTC
    ATACTGAATA GTGGCATGAA TGCAACTGTG ATCTATTTTA ACCTTACGTT TCTAAATAAG
    AATGATGAAG AGTTTAAAAT GCAGGTAGCT GTCGAGGTTG ATACTAGAGA GGAACCAAAA
    CTGAACACAA CTTCCATGCA AAAACCCAAC TCTGATTTTA AAACTGTAAC ATCTATACCA
    GAAGCTGAAA TGATATTTGA GGATATTCCT GAAGAAAAAC GCTTTCCAAG AGTCAGCAGA
    CGTCGAAATG GCACAAAAGA GAGCCTACAT GAGGAGGTGC TAATGCCATC AGTAAACGTG
    TCTCTCCTTC CTGAAGATGT TCAGCTAGCA CTGCAAAACC TGGATTTGAA ACTGCTAAAT
    GGTGATATCA CTCAGAAAGG ATTTAACCTG TCAAAGGCTG CTCTCCTGAG ACCTTTTCAG
    TTCTTAACTA CAGTAAAGAG TATTATAGGC CTGGAAAAGA AGGGCATGCG TAATCATTCG
    GAAGATCAGA AGAACCGTAC CAGCTGGCAG AAGCCTTATG AAGATGTAAA TGATGGCAAA
    ATAAAAATGA TAAAAGCAAA TGAAGAAGTT CCTTCAAAGC TTACAGGAAC AAAGGGGACT
    GTTGTGACAA CGAACACGAA TAAACTTATT TATAAAGTCA AGCCTAAATC CACACTTCCC
    TCCCAGAGCA TAGGAAATAA AAATGAAACT CGAGAAAAAG TATTGAACTC ACTCATATTA
    AGGGAAACTC AGAAATCGAA ACAAACTGAG AATTTAGATA CTGGAGAAGA TGCACAAGGG
    ATGGAAGGAG GAAAAGGCGG TGTGCAGGTG GATACAAATG TAAGGGAGGG GCTAGTGGGA
    AGAAAATTAC AGTCTTATGC TGGAAGTTAC CAAGGCTTTT TGCCATGGGA GAAAAAGAAG
    TATTTCCAGG ACCTCCTTGA TGAAGAAGAG TCATTACTCA AGCAAATGTC ATACTTTACT
    GATGGTAAAC ATTTTGGAAG GCAGCTGAAA GATACATTTG CTGATTCCCT TCGATATGTA
    AATAAGCTTT TGAACAGCAA ATTTGGATTT ACATCTCGGA AAGTCCCTGC TCATATGCCT
    CACATGATTG ACCGCACTGT TATGCAAGAG CTGCAGGATA TGTTTCCCGA GGAGTTTGAC
    AAGACATCAT TTCACAAAGT GCGGCACTCA GAAGATATGC AGTTTGCTTT TTCGTATTTC
    TACTATCTTA TGAGTGCAGT CCAGCCACTG AACATTTCTC AGATCTTCAA TGAGGTTGAT
    ACAGACCAAT CGGGCATCTT GTCTGACCGA GAGATTCGCA CGTTGGCCAC AAGAATCCAT
    GAATTGCCGC TAAGTTTGCA GGATTTGACA GGTCTAGAAC AAATGCTAAT AAATTGCTCT
    AAATCCCTTC CTGCCAACAT CACTCAGATC CATGTCATTC CACCAACTCA GGAAGCGTAT
    TACGATCCCA ATCTGCCTCC AGTAACAAAA AACCTAGTGA CTAATTGCAA ACCTGTGACT
    GACAGAATCC GTAAGGCATA CAAGGACAAA AACAAATACA GGTTTGAAAT CATGGGAGAA
    GAGGAAATTG CCTTCAAAAT GATTCGCACA AATGTTTCTC ATGTGGTTGG TCAGCTGGAT
    GACATACGAA AAAATCCCAG AAAATTCGTT TGCCTAAATG ACAATATTGA TCACAATCAT
    AAGGATGCTC AGACAGTGAA AGCAGTGCTT AGGGACTTTT ATGAATCAAT GTTTCCCATA
    CCCTCTCAAT TTGAACTGCC AAGAGAATAT CGGAATCGTT TCCTTCACAT GCATGAACTC
    CAAGAATGGA GGGCATATAG AGACAAGCTC AAATTCTGGA CCCACTGTGT TCTAGTAACA
    CTGATTGTAT TTACAGTCAT CTCATTTTTT GCTGAACAGG TGGGGGCCTT AAGTAACACT
    TTCCGTGGTC TGATGAAGAG GGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCa61647
    Clone ID Related Accession (Same CDS sequence) XM_014937348.1
    Accession Version XM_014937348.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3624bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-08
    Organism Calidris pugnax(ruff)
    Product N-acetylglucosamine-1-phosphotransferase subunits alpha/beta isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015090800.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Calidris pugnax Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGTTTGATT CATACAGAGA CAATGTTGCT GGCAAATCAT TTCAGAATCG GCTTTGTTTA 
    CCCATGCCGA TTGATGTGGT GTACACCTGG GTGAACGGCA CAGATGTTGA ACTGATCAAA
    GAATTGCAAC AGGTCAGAGA ACAGATGGAG GAAGAACAGA AAATAATGAG GGAAATACTC
    GGAAAGAATG CAACAGAACC AACAAAGAAG AGTGAGAAGC ATCTGGAGTG TTTGCTGACG
    CACTGCATCA AAGTGCCAAT GCTTGTCCTG GATCCTGCGC TGCCTGCCAA TGTCACACTG
    AAAGACCTCT CGTCCATTCA TCCTGCTTTA CAAGCTGCTA ACAATATGTT TTTTGTAGCA
    AAACCAAAAA ATCCTTCTAC CAACGTGACA GTAATTGTTT TTGATAGCCC TAAGGATGTT
    GAAGCTGCCC ATTCTGGAAT GTTAAAAGAC AACAGTAAAC AGATAGTATG GAGGGGCTAT
    TTGACTACAG ATAAAGAAGT TCCAGGTCTG GTATTAATGC AAGACTTGGC CTTCCTTAGT
    GGATTTCCAG CTACATTCAA AGAAACAAAT CAGCTACGAA CAAAACTACC GGAGAGCCTG
    GCCTCTAAAG TAAAACTGTT GCAGCTCTAT TCAGAAGCCA GCGTGGCTCT CTTGCAACTG
    AATAACCCTA AGGGCTTCCA AGAACTGAGC AAGCAAGCAA AGAAGAACAT GACTATAGAT
    GGAAAAGAAC TGACGCTTAA TCCTGCTTAT TTACTATGGG ACCTCAGCTC TGTCACTCAG
    TCTAAACAGG ATGAAGATAT TTCTGCCAGC CGTTTTGAAG ATAACGAAGA GCTGAGGTAC
    TCGTTGCGAT CGATAGAGAG GCATGCCCCT TGGGTACGAC ACATTTTCAT CGTCACTAAT
    GGGCAGATTC CTTCCTGGCT TAACCTGGAT AATCCTCGGA TAACCATAGT GACGCATCAG
    GAAATATTTC AGAATGTGAG TCACTTGCCT ACCTTCAGTT CACCAGCCAT TGAAAGTCAC
    ATTCATCGTA TCAGTGGACT CTCTCAGAAG TTTATCTATC TCAATGATGA TGTTATGTTT
    GGGAAGGATG TTTGGCCTGA TGATTTTTAC AGTCACTCTA AAGGTCAAAA GGTTTATTTG
    ACCTGGCCTG TGCCAAACTG TGCTGAGGGA TGTCCTGGCT CATGGATTAA AGATGGTTAC
    TGTGACAAAG CCTGTAATAA CTCAGCGTGT GACTGGGATG GAGGTGATTG CATTGGTAAC
    AGTGGGGGTA GTCGCTACGT TGCTGGTGGA GGTGCAGTCG GAGGTATTGG GAATGGACCA
    CCGTGGCAGT TTGGGGCAGG AATAAGTGGC GTTTCATACT GCAACCAAGG CTGTGCTAAT
    TCCTGGCTAG CAGACAAATT CTGTGATCAG GCCTGCAATG TCCTCTCCTG TGCATTTGAT
    GCTGGTGACT GTGGCCAGGA TCACTTTGAA GAGATGTATA AGGTGACACT TCAGCATAAT
    CAGACCTACT ATGTTATTCC CAAAGGTGAA TGTCTGCCCT ACTTCAGCTT CAGTGAAATA
    GCCAAGAAGG CAATTGAGGG TTCATATAGT GATAATCCAA TTATCCGACA TGCTTCAGTT
    GCTAACAAAT GGAAGACTAT CCACCTCATA CTGAATAGTG GCATGAATGC AACTGTGATC
    TATTTTAACC TTACGTTTCT AAATAAGAAT GATGAAGAGT TTAAAATGCA GGTAGCTGTC
    GAGGTTGATA CTAGAGAGGA ACCAAAACTG AACACAACTT CCATGCAAAA ACCCAACTCT
    GATTTTAAAA CTGTAACATC TATACCAGAA GCTGAAATGA TATTTGAGGA TATTCCTGAA
    GAAAAACGCT TTCCAAGAGT CAGCAGACGT CGAAATGGCA CAAAAGAGAG CCTACATGAG
    GAGGTGCTAA TGCCATCAGT AAACGTGTCT CTCCTTCCTG AAGATGTTCA GCTAGCACTG
    CAAAACCTGG ATTTGAAACT GCTAAATGGT GATATCACTC AGAAAGGATT TAACCTGTCA
    AAGGCTGCTC TCCTGAGACC TTTTCAGTTC TTAACTACAG TAAAGAGTAT TATAGGCCTG
    GAAAAGAAGG GCATGCGTAA TCATTCGGAA GATCAGAAGA ACCGTACCAG CTGGCAGAAG
    CCTTATGAAG ATGTAAATGA TGGCAAAATA AAAATGATAA AAGCAAATGA AGAAGTTCCT
    TCAAAGCTTA CAGGAACAAA GGGGACTGTT GTGACAACGA ACACGAATAA ACTTATTTAT
    AAAGTCAAGC CTAAATCCAC ACTTCCCTCC CAGAGCATAG GAAATAAAAA TGAAACTCGA
    GAAAAAGTAT TGAACTCACT CATATTAAGG GAAACTCAGA AATCGAAACA AACTGAGAAT
    TTAGATACTG GAGAAGATGC ACAAGGGATG GAAGGAGGAA AAGGCGGTGT GCAGGTGGAT
    ACAAATGTAA GGGAGGGGCT AGTGGGAAGA AAATTACAGT CTTATGCTGG AAGTTACCAA
    GGCTTTTTGC CATGGGAGAA AAAGAAGTAT TTCCAGGACC TCCTTGATGA AGAAGAGTCA
    TTACTCAAGC AAATGTCATA CTTTACTGAT GGTAAACATT TTGGAAGGCA GCTGAAAGAT
    ACATTTGCTG ATTCCCTTCG ATATGTAAAT AAGCTTTTGA ACAGCAAATT TGGATTTACA
    TCTCGGAAAG TCCCTGCTCA TATGCCTCAC ATGATTGACC GCACTGTTAT GCAAGAGCTG
    CAGGATATGT TTCCCGAGGA GTTTGACAAG ACATCATTTC ACAAAGTGCG GCACTCAGAA
    GATATGCAGT TTGCTTTTTC GTATTTCTAC TATCTTATGA GTGCAGTCCA GCCACTGAAC
    ATTTCTCAGA TCTTCAATGA GGTTGATACA GACCAATCGG GCATCTTGTC TGACCGAGAG
    ATTCGCACGT TGGCCACAAG AATCCATGAA TTGCCGCTAA GTTTGCAGGA TTTGACAGGT
    CTAGAACAAA TGCTAATAAA TTGCTCTAAA TCCCTTCCTG CCAACATCAC TCAGATCCAT
    GTCATTCCAC CAACTCAGGA AGCGTATTAC GATCCCAATC TGCCTCCAGT AACAAAAAAC
    CTAGTGACTA ATTGCAAACC TGTGACTGAC AGAATCCGTA AGGCATACAA GGACAAAAAC
    AAATACAGGT TTGAAATCAT GGGAGAAGAG GAAATTGCCT TCAAAATGAT TCGCACAAAT
    GTTTCTCATG TGGTTGGTCA GCTGGATGAC ATACGAAAAA ATCCCAGAAA ATTCGTTTGC
    CTAAATGACA ATATTGATCA CAATCATAAG GATGCTCAGA CAGTGAAAGC AGTGCTTAGG
    GACTTTTATG AATCAATGTT TCCCATACCC TCTCAATTTG AACTGCCAAG AGAATATCGG
    AATCGTTTCC TTCACATGCA TGAACTCCAA GAATGGAGGG CATATAGAGA CAAGCTCAAA
    TTCTGGACCC ACTGTGTTCT AGTAACACTG ATTGTATTTA CAGTCATCTC ATTTTTTGCT
    GAACAGCTAA TTGCACTTAA ACGAAAGATT TTTCCAAGGA GAAGGATCCA AAAGGAAGTT
    GGTCATGAAC GAATCAAGGT GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014792834.1
    CDS95..3718
    Translation

    Target ORF information:

    RefSeq Version XM_014937348.1
    Organism Calidris pugnax(ruff)
    Definition Calidris pugnax N-acetylglucosamine-1-phosphate transferase, alpha and beta subunits (GNPTAB), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014937348.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGTTTGATT CATACAGAGA CAATGTTGCT GGCAAATCAT TTCAGAATCG GCTTTGTTTA 
    CCCATGCCGA TTGATGTGGT GTACACCTGG GTGAACGGCA CAGATGTTGA ACTGATCAAA
    GAATTGCAAC AGGTCAGAGA ACAGATGGAG GAAGAACAGA AAATAATGAG GGAAATACTC
    GGAAAGAATG CAACAGAACC AACAAAGAAG AGTGAGAAGC ATCTGGAGTG TTTGCTGACG
    CACTGCATCA AAGTGCCAAT GCTTGTCCTG GATCCTGCGC TGCCTGCCAA TGTCACACTG
    AAAGACCTCT CGTCCATTCA TCCTGCTTTA CAAGCTGCTA ACAATATGTT TTTTGTAGCA
    AAACCAAAAA ATCCTTCTAC CAACGTGACA GTAATTGTTT TTGATAGCCC TAAGGATGTT
    GAAGCTGCCC ATTCTGGAAT GTTAAAAGAC AACAGTAAAC AGATAGTATG GAGGGGCTAT
    TTGACTACAG ATAAAGAAGT TCCAGGTCTG GTATTAATGC AAGACTTGGC CTTCCTTAGT
    GGATTTCCAG CTACATTCAA AGAAACAAAT CAGCTACGAA CAAAACTACC GGAGAGCCTG
    GCCTCTAAAG TAAAACTGTT GCAGCTCTAT TCAGAAGCCA GCGTGGCTCT CTTGCAACTG
    AATAACCCTA AGGGCTTCCA AGAACTGAGC AAGCAAGCAA AGAAGAACAT GACTATAGAT
    GGAAAAGAAC TGACGCTTAA TCCTGCTTAT TTACTATGGG ACCTCAGCTC TGTCACTCAG
    TCTAAACAGG ATGAAGATAT TTCTGCCAGC CGTTTTGAAG ATAACGAAGA GCTGAGGTAC
    TCGTTGCGAT CGATAGAGAG GCATGCCCCT TGGGTACGAC ACATTTTCAT CGTCACTAAT
    GGGCAGATTC CTTCCTGGCT TAACCTGGAT AATCCTCGGA TAACCATAGT GACGCATCAG
    GAAATATTTC AGAATGTGAG TCACTTGCCT ACCTTCAGTT CACCAGCCAT TGAAAGTCAC
    ATTCATCGTA TCAGTGGACT CTCTCAGAAG TTTATCTATC TCAATGATGA TGTTATGTTT
    GGGAAGGATG TTTGGCCTGA TGATTTTTAC AGTCACTCTA AAGGTCAAAA GGTTTATTTG
    ACCTGGCCTG TGCCAAACTG TGCTGAGGGA TGTCCTGGCT CATGGATTAA AGATGGTTAC
    TGTGACAAAG CCTGTAATAA CTCAGCGTGT GACTGGGATG GAGGTGATTG CATTGGTAAC
    AGTGGGGGTA GTCGCTACGT TGCTGGTGGA GGTGCAGTCG GAGGTATTGG GAATGGACCA
    CCGTGGCAGT TTGGGGCAGG AATAAGTGGC GTTTCATACT GCAACCAAGG CTGTGCTAAT
    TCCTGGCTAG CAGACAAATT CTGTGATCAG GCCTGCAATG TCCTCTCCTG TGCATTTGAT
    GCTGGTGACT GTGGCCAGGA TCACTTTGAA GAGATGTATA AGGTGACACT TCAGCATAAT
    CAGACCTACT ATGTTATTCC CAAAGGTGAA TGTCTGCCCT ACTTCAGCTT CAGTGAAATA
    GCCAAGAAGG CAATTGAGGG TTCATATAGT GATAATCCAA TTATCCGACA TGCTTCAGTT
    GCTAACAAAT GGAAGACTAT CCACCTCATA CTGAATAGTG GCATGAATGC AACTGTGATC
    TATTTTAACC TTACGTTTCT AAATAAGAAT GATGAAGAGT TTAAAATGCA GGTAGCTGTC
    GAGGTTGATA CTAGAGAGGA ACCAAAACTG AACACAACTT CCATGCAAAA ACCCAACTCT
    GATTTTAAAA CTGTAACATC TATACCAGAA GCTGAAATGA TATTTGAGGA TATTCCTGAA
    GAAAAACGCT TTCCAAGAGT CAGCAGACGT CGAAATGGCA CAAAAGAGAG CCTACATGAG
    GAGGTGCTAA TGCCATCAGT AAACGTGTCT CTCCTTCCTG AAGATGTTCA GCTAGCACTG
    CAAAACCTGG ATTTGAAACT GCTAAATGGT GATATCACTC AGAAAGGATT TAACCTGTCA
    AAGGCTGCTC TCCTGAGACC TTTTCAGTTC TTAACTACAG TAAAGAGTAT TATAGGCCTG
    GAAAAGAAGG GCATGCGTAA TCATTCGGAA GATCAGAAGA ACCGTACCAG CTGGCAGAAG
    CCTTATGAAG ATGTAAATGA TGGCAAAATA AAAATGATAA AAGCAAATGA AGAAGTTCCT
    TCAAAGCTTA CAGGAACAAA GGGGACTGTT GTGACAACGA ACACGAATAA ACTTATTTAT
    AAAGTCAAGC CTAAATCCAC ACTTCCCTCC CAGAGCATAG GAAATAAAAA TGAAACTCGA
    GAAAAAGTAT TGAACTCACT CATATTAAGG GAAACTCAGA AATCGAAACA AACTGAGAAT
    TTAGATACTG GAGAAGATGC ACAAGGGATG GAAGGAGGAA AAGGCGGTGT GCAGGTGGAT
    ACAAATGTAA GGGAGGGGCT AGTGGGAAGA AAATTACAGT CTTATGCTGG AAGTTACCAA
    GGCTTTTTGC CATGGGAGAA AAAGAAGTAT TTCCAGGACC TCCTTGATGA AGAAGAGTCA
    TTACTCAAGC AAATGTCATA CTTTACTGAT GGTAAACATT TTGGAAGGCA GCTGAAAGAT
    ACATTTGCTG ATTCCCTTCG ATATGTAAAT AAGCTTTTGA ACAGCAAATT TGGATTTACA
    TCTCGGAAAG TCCCTGCTCA TATGCCTCAC ATGATTGACC GCACTGTTAT GCAAGAGCTG
    CAGGATATGT TTCCCGAGGA GTTTGACAAG ACATCATTTC ACAAAGTGCG GCACTCAGAA
    GATATGCAGT TTGCTTTTTC GTATTTCTAC TATCTTATGA GTGCAGTCCA GCCACTGAAC
    ATTTCTCAGA TCTTCAATGA GGTTGATACA GACCAATCGG GCATCTTGTC TGACCGAGAG
    ATTCGCACGT TGGCCACAAG AATCCATGAA TTGCCGCTAA GTTTGCAGGA TTTGACAGGT
    CTAGAACAAA TGCTAATAAA TTGCTCTAAA TCCCTTCCTG CCAACATCAC TCAGATCCAT
    GTCATTCCAC CAACTCAGGA AGCGTATTAC GATCCCAATC TGCCTCCAGT AACAAAAAAC
    CTAGTGACTA ATTGCAAACC TGTGACTGAC AGAATCCGTA AGGCATACAA GGACAAAAAC
    AAATACAGGT TTGAAATCAT GGGAGAAGAG GAAATTGCCT TCAAAATGAT TCGCACAAAT
    GTTTCTCATG TGGTTGGTCA GCTGGATGAC ATACGAAAAA ATCCCAGAAA ATTCGTTTGC
    CTAAATGACA ATATTGATCA CAATCATAAG GATGCTCAGA CAGTGAAAGC AGTGCTTAGG
    GACTTTTATG AATCAATGTT TCCCATACCC TCTCAATTTG AACTGCCAAG AGAATATCGG
    AATCGTTTCC TTCACATGCA TGAACTCCAA GAATGGAGGG CATATAGAGA CAAGCTCAAA
    TTCTGGACCC ACTGTGTTCT AGTAACACTG ATTGTATTTA CAGTCATCTC ATTTTTTGCT
    GAACAGCTAA TTGCACTTAA ACGAAAGATT TTTCCAAGGA GAAGGATCCA AAAGGAAGTT
    GGTCATGAAC GAATCAAGGT GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.