LOC105363382 cDNA ORF clone, Ceratosolen solmsi marchali

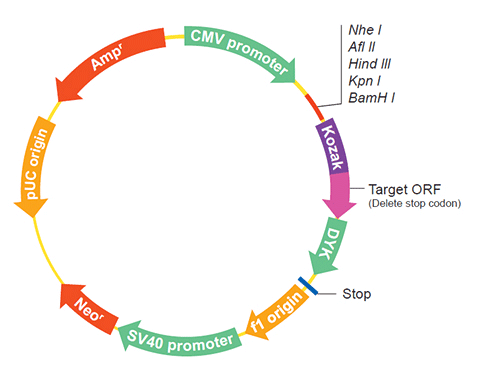
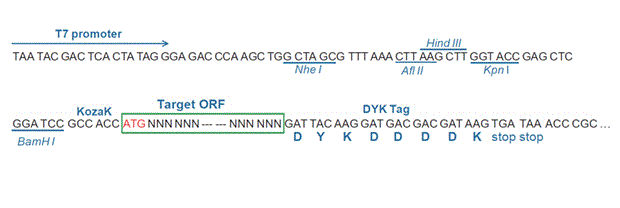
The following LOC105363382 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105363382 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe199073 XM_011501051.1
Latest version!
Ceratosolen solmsi marchali uncharacterized LOC105363382 (LOC105363382), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $797.30
$1139.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe199073
    Clone ID Related Accession (Same CDS sequence) XM_011501051.1
    Accession Version XM_011501051.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4044bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product LOW QUALITY PROTEIN: uncharacterized protein LOC105363382
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948427.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## internal stop codons :: corrected 1 genomic stop codon ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    ATGCCGGAAA AACGGCCAGC GGTGGATCAA ACGAAAAACG AGGAAACATT TGGGAGAGGA 
    GTGGCACGAC CATTACCTGC ATACCATTGT ATTACAGCAT CAAGTTCGAG AATGGGCCCT
    GGGCCTGATT CAGGTAGTAG TGCTCCATCG TCAATATTAC ACTCGTTGGC TACATCACAC
    GATGAAGAGG ATGATGACGA TGAAGAAAAC AGTTCTCACC AATTTAATGA TCGTGGAGGT
    TCTCGGTCAA AAAGCAACCA GCGGTGGATG AAATTACGTA CAACCGTGCA ATTATCTTCG
    GCAATATCCA CCATTCAAAA GAAGCCACCT CTTAAACGCG AAGATTCTTT TCTTAAAAGG
    TTTTCTACTC GACAGATACC TGAGAGTCAG GAGACAATTG ATACTGGAGA AGGTGAAGGT
    GATCTGACAG ATGATAAAAA TTCGAGCAGA AAATATAGAA GACACCGAAG GACACAAAAA
    CCACCACAAA CTGTAGTTAA TCCAGATGAA AATTTTTATT ATTATTGGCT TATGCTTTTA
    TCTACCTGTG TTTTATATAA TCTTTGGACT TTAATTGTTA GACAAAGTAT GCCTGAGTTG
    CAGGATATGG CACCAGCTAT TTGGTTAAGT TGTGATGGAT TTACAGATCT CGTCTTTTTC
    TTGGATGTTG GCGTACAATT TCGCACCGGT TATTTAGAGC AAGGTCTTAT GGTATATAAC
    AGTAAAAAAT TAGCTGGCCA TTATTTCCAA TCTAAATCAT TTGTTTTGGA TCTTTTGGCA
    TTAATACCTT TGGATTTATT ACAAGTCAAT CTTGGAATCA ATCCCATGCT CAGATTTCCA
    AGATTTCTAA AAGTCTACCG AGTTTATAAT TATTATTATA TGGTAGAATC ACGTACAGTT
    TATCCAAATC TTTGGAGAGT GTTAAATCTC ATACATATTC TGTTGATACT TGCACATTGG
    TTTGGATGCT TTTATTATTT ATTAAGTGAA GCTGAGGGAT TTCATGGTGA CTGGGTGTAT
    CCATATCGTC CAGGAGAATA TGCCACTCTT ACCAGAAAAT ATTTGGGATC ATTATATTGG
    TCTACGTTGA CTCTGACTAC CATTGGCGAC CTTCCTACAC CAGAGACTAA TGCCGAATAC
    GTGTTCACAA TAGTCAGCTA CCTAATTGGT GTCTTCATTT TCGCTACAAT TGTGGGGCAA
    GTAGGTAACG TTATTACGAA CCGCAATGCA AATCGACTTG AGTTTGAACG GCTATTAGAC
    GGCGCCAAGA CATATATGAG ACATCACAAA GTACCTGGCG GCATGAAGAG ACGTGTATTA
    CGTTGGTATG ACTATAGCTG GTCACGAGGA AGGATACAAG GTGGAGGAGA TATTAATACA
    GCTCTTGGAT TATTGCCCGA TAAGCTGAAA ACGGAGCTTG CACTACATGT CAACCTATCT
    GTATTAAAAA AAGTTACAAT TTTTCAGATA TTTAATAGAA AGAATTTCCA TTGAATTNNN
    NNNNNNNTGG TTCTAAAAAT GAAGGCTTAT ATATTTACGC CAGGAGACTC AATATGTCGC
    AAAGGAGAAG TGGCGCGAGA GATGTTTATC ATAGCAGATG GCATTCTTGA AGTTATTAGC
    GAAACAGGAA GAGTACTCAC CACAATGAAA GCCGGCGACT TTTTTGGAGA GATTGGTATC
    CTTAACCTTG ATGGCCTTAA TAAACGCACT GCAGATGTAC GTTCAGTTGG TTATTCAGAA
    CTGTTTAGTT TGTCTCGTGA AGATGTACTA TCAGCTCTCA AAGATTACCC AGAAGCTCAA
    GAGATTCTTC AAAAGCTGGG TGAAAAACGT TTACGAGAAG CACAACATGT TGCACGTTCC
    ATTCAAAATT TGCCATCATC TAGTCACGAT TCATCAGATA ATAGCACTAG TAAACGTATC
    GTGGAGAAGC TCAAAAGTGA TGTAAAAGGT TTAAAAAATG TATTAAGAAA AAGTAGAAAA
    AATATTAGAT CTGATGAAAG TCTTGAATTA CAACCTTTGA CATCAAAGTT AGCACAGCTC
    CGACGTCAAA CTAGGATAGA AGAAACTCAG GATATATGCA TATCATCCCC AGAACCCCCA
    ATTTCGCCAT TAGGAGCTGG ACTACCATTA TTATCAAGGT TGAAATTACT TAAAGAAAAA
    CAGGAAAGAG AAGAAAAAAG AAATCTTATG GAAATCGCTA ATCAAATACC AGAACAAATA
    CATACAACTG TAGATGTGCT ATCTTCGCAT AACACCAGTA ATGCAAGCGT AGCAGTACCA
    TTGTTACATC GTCTTTTACA CATTAAATCA AAGACAGATG TTGATACAAT ATTAGATCAC
    GATACTTTTT TTATCAAGGA ATCCCAGCTC CCTCAAAGTA TCATTCCGGA AGAGCATGAA
    ATTTTCATCT CTACCCAGCA AAACAATAGT AGTATCAGCA ACGATTCCAA TATATTGATG
    ATTCAATCAC CAACATCTAC TTGTGTAGAT ATTGAAAATG ATATAAGTAG AAAACCATGG
    GCAATGCTAA AGGAGGCTTC TATTAAGACT ACTAATAAAA ATATTCCTAA ACGTAATTTC
    CAGCACACTT CATTTCCGTC CTGTATCTAT CCAGCTGATA AATTTCAAAT ACGTCAAAAC
    TTAGTTCAAC TAAGACAGCA AACAAAAATG TATGCATCAA TTGATGATTT ATCACCAGAA
    TATTGTGGTT TACCATTCGT AAAAAAATTA AAAATTCTTA ATGAACGTCA AAAATTAGCA
    GAATTAGAAA AAAGTGTAAG AAGCTCCAGC TTCGATTACA GCGGAAGCAC AGAATTAGAG
    TGTGACACTA ATTTAACAAG AAGTCACTCC GAAGCTTGTG CGATCGATTA TAAACGTAAA
    CTTGCTAAAA TGAACAAGGG TCGTATATGT TGCACATTCG GCTCATCAGA TCAAATTTCT
    CCTGAAAATG AAACATTAGA GAGACAAAAT TTAAAAAGTA TCCTTAAAAA ACTTTCAGCT
    GGAAGTAGAC CTGAAAGTTC AGAAACTTCA ACTATAAGTA CTCCTGATCA TAAAATTATT
    AAAGCTGAAT TAAAACAATT AATGCGTGCT CCAACTTTAG AAGGATATGT AGCGAGACAT
    TCGAAACTTT CGAAAAGTGT AACCTTTAAT AAGTATACTT TACAAAGCCC ACCAGATACG
    GAACAGAGAA ATACGACACC TGTTAACACA AAAATAATGA CTTCATCATC CTCCTCCTCA
    TCACTAGCTG AACGAGCAAT TACATTAGTT GCAAAAAGCC ACAAACAAAA TCTTTTCTTA
    TCTCAATCTA ATAAACTTAA GTTTCATCCA GTTGATAAAC AAATTATTAT ACCAACTCAA
    ATATTACCAG AATTAAAGGA AAGCGAATAC ATACGTGAGC TTTTCTCTGA CATTAAAGCA
    ATTATTCAAT CAAAACTAGA AGGAATTCAG AATAATTTCC AACAGAAATT TACGTTATTA
    GAATATGAAA TTCAAAGGCG TGATGAAATA ATTTCTACAC TGAAAGCTCG TATTTTAGAG
    TTGGAGAAAA CTGATAGCTT TAATTACGAA GAGGAAGATT CTGTTGGTGG TAGCACAGAA
    CTCGATACAT CATTAGAAGG TGAAATTATT TTTGATAATG AAGACCATCC TTTTATGCGC
    GACAGTTCTG TCGATACTGT TTTTACAACA CAGGCACAAC CACATCAATC AAATCCTATT
    TCAATAACGC GCAGTTCGAC ACACAATCGT CTTTCTTGGG AGCAACACTC AGAAGAAGAA
    ACACTTGAAC TTCAGGATCT TCCTCGTTCC ATTACACCGG AGAGCGTTTG GATGGGCGAA
    GTAGCAATTG ACGTAGAAAC GAGTGATGAC AGTGAGAATA CAAACATTCA AAGCGATCTA
    ACAGTTACTA ATAAAACAAC TAAAAATATT AGACAGCAGG ATGAAATTTC TGATGGAAAT
    AATCATAATT GGGAAATAAT AATGCTTGCT GAACAATTGG AAAAAAAACG TAGAAGTAGC
    GAGTGCTCTA GTTCAGGTTC CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011499353.1
    CDS36..4079
    Translation

    Target ORF information:

    RefSeq Version XM_011501051.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali uncharacterized LOC105363382 (LOC105363382), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011501051.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    ATGCCGGAAA AACGGCCAGC GGTGGATCAA ACGAAAAACG AGGAAACATT TGGGAGAGGA 
    GTGGCACGAC CATTACCTGC ATACCATTGT ATTACAGCAT CAAGTTCGAG AATGGGCCCT
    GGGCCTGATT CAGGTAGTAG TGCTCCATCG TCAATATTAC ACTCGTTGGC TACATCACAC
    GATGAAGAGG ATGATGACGA TGAAGAAAAC AGTTCTCACC AATTTAATGA TCGTGGAGGT
    TCTCGGTCAA AAAGCAACCA GCGGTGGATG AAATTACGTA CAACCGTGCA ATTATCTTCG
    GCAATATCCA CCATTCAAAA GAAGCCACCT CTTAAACGCG AAGATTCTTT TCTTAAAAGG
    TTTTCTACTC GACAGATACC TGAGAGTCAG GAGACAATTG ATACTGGAGA AGGTGAAGGT
    GATCTGACAG ATGATAAAAA TTCGAGCAGA AAATATAGAA GACACCGAAG GACACAAAAA
    CCACCACAAA CTGTAGTTAA TCCAGATGAA AATTTTTATT ATTATTGGCT TATGCTTTTA
    TCTACCTGTG TTTTATATAA TCTTTGGACT TTAATTGTTA GACAAAGTAT GCCTGAGTTG
    CAGGATATGG CACCAGCTAT TTGGTTAAGT TGTGATGGAT TTACAGATCT CGTCTTTTTC
    TTGGATGTTG GCGTACAATT TCGCACCGGT TATTTAGAGC AAGGTCTTAT GGTATATAAC
    AGTAAAAAAT TAGCTGGCCA TTATTTCCAA TCTAAATCAT TTGTTTTGGA TCTTTTGGCA
    TTAATACCTT TGGATTTATT ACAAGTCAAT CTTGGAATCA ATCCCATGCT CAGATTTCCA
    AGATTTCTAA AAGTCTACCG AGTTTATAAT TATTATTATA TGGTAGAATC ACGTACAGTT
    TATCCAAATC TTTGGAGAGT GTTAAATCTC ATACATATTC TGTTGATACT TGCACATTGG
    TTTGGATGCT TTTATTATTT ATTAAGTGAA GCTGAGGGAT TTCATGGTGA CTGGGTGTAT
    CCATATCGTC CAGGAGAATA TGCCACTCTT ACCAGAAAAT ATTTGGGATC ATTATATTGG
    TCTACGTTGA CTCTGACTAC CATTGGCGAC CTTCCTACAC CAGAGACTAA TGCCGAATAC
    GTGTTCACAA TAGTCAGCTA CCTAATTGGT GTCTTCATTT TCGCTACAAT TGTGGGGCAA
    GTAGGTAACG TTATTACGAA CCGCAATGCA AATCGACTTG AGTTTGAACG GCTATTAGAC
    GGCGCCAAGA CATATATGAG ACATCACAAA GTACCTGGCG GCATGAAGAG ACGTGTATTA
    CGTTGGTATG ACTATAGCTG GTCACGAGGA AGGATACAAG GTGGAGGAGA TATTAATACA
    GCTCTTGGAT TATTGCCCGA TAAGCTGAAA ACGGAGCTTG CACTACATGT CAACCTATCT
    GTATTAAAAA AAGTTACAAT TTTTCAGATA TTTAATAGAA AGAATTTCCA TTGAATTNNN
    NNNNNNNTGG TTCTAAAAAT GAAGGCTTAT ATATTTACGC CAGGAGACTC AATATGTCGC
    AAAGGAGAAG TGGCGCGAGA GATGTTTATC ATAGCAGATG GCATTCTTGA AGTTATTAGC
    GAAACAGGAA GAGTACTCAC CACAATGAAA GCCGGCGACT TTTTTGGAGA GATTGGTATC
    CTTAACCTTG ATGGCCTTAA TAAACGCACT GCAGATGTAC GTTCAGTTGG TTATTCAGAA
    CTGTTTAGTT TGTCTCGTGA AGATGTACTA TCAGCTCTCA AAGATTACCC AGAAGCTCAA
    GAGATTCTTC AAAAGCTGGG TGAAAAACGT TTACGAGAAG CACAACATGT TGCACGTTCC
    ATTCAAAATT TGCCATCATC TAGTCACGAT TCATCAGATA ATAGCACTAG TAAACGTATC
    GTGGAGAAGC TCAAAAGTGA TGTAAAAGGT TTAAAAAATG TATTAAGAAA AAGTAGAAAA
    AATATTAGAT CTGATGAAAG TCTTGAATTA CAACCTTTGA CATCAAAGTT AGCACAGCTC
    CGACGTCAAA CTAGGATAGA AGAAACTCAG GATATATGCA TATCATCCCC AGAACCCCCA
    ATTTCGCCAT TAGGAGCTGG ACTACCATTA TTATCAAGGT TGAAATTACT TAAAGAAAAA
    CAGGAAAGAG AAGAAAAAAG AAATCTTATG GAAATCGCTA ATCAAATACC AGAACAAATA
    CATACAACTG TAGATGTGCT ATCTTCGCAT AACACCAGTA ATGCAAGCGT AGCAGTACCA
    TTGTTACATC GTCTTTTACA CATTAAATCA AAGACAGATG TTGATACAAT ATTAGATCAC
    GATACTTTTT TTATCAAGGA ATCCCAGCTC CCTCAAAGTA TCATTCCGGA AGAGCATGAA
    ATTTTCATCT CTACCCAGCA AAACAATAGT AGTATCAGCA ACGATTCCAA TATATTGATG
    ATTCAATCAC CAACATCTAC TTGTGTAGAT ATTGAAAATG ATATAAGTAG AAAACCATGG
    GCAATGCTAA AGGAGGCTTC TATTAAGACT ACTAATAAAA ATATTCCTAA ACGTAATTTC
    CAGCACACTT CATTTCCGTC CTGTATCTAT CCAGCTGATA AATTTCAAAT ACGTCAAAAC
    TTAGTTCAAC TAAGACAGCA AACAAAAATG TATGCATCAA TTGATGATTT ATCACCAGAA
    TATTGTGGTT TACCATTCGT AAAAAAATTA AAAATTCTTA ATGAACGTCA AAAATTAGCA
    GAATTAGAAA AAAGTGTAAG AAGCTCCAGC TTCGATTACA GCGGAAGCAC AGAATTAGAG
    TGTGACACTA ATTTAACAAG AAGTCACTCC GAAGCTTGTG CGATCGATTA TAAACGTAAA
    CTTGCTAAAA TGAACAAGGG TCGTATATGT TGCACATTCG GCTCATCAGA TCAAATTTCT
    CCTGAAAATG AAACATTAGA GAGACAAAAT TTAAAAAGTA TCCTTAAAAA ACTTTCAGCT
    GGAAGTAGAC CTGAAAGTTC AGAAACTTCA ACTATAAGTA CTCCTGATCA TAAAATTATT
    AAAGCTGAAT TAAAACAATT AATGCGTGCT CCAACTTTAG AAGGATATGT AGCGAGACAT
    TCGAAACTTT CGAAAAGTGT AACCTTTAAT AAGTATACTT TACAAAGCCC ACCAGATACG
    GAACAGAGAA ATACGACACC TGTTAACACA AAAATAATGA CTTCATCATC CTCCTCCTCA
    TCACTAGCTG AACGAGCAAT TACATTAGTT GCAAAAAGCC ACAAACAAAA TCTTTTCTTA
    TCTCAATCTA ATAAACTTAA GTTTCATCCA GTTGATAAAC AAATTATTAT ACCAACTCAA
    ATATTACCAG AATTAAAGGA AAGCGAATAC ATACGTGAGC TTTTCTCTGA CATTAAAGCA
    ATTATTCAAT CAAAACTAGA AGGAATTCAG AATAATTTCC AACAGAAATT TACGTTATTA
    GAATATGAAA TTCAAAGGCG TGATGAAATA ATTTCTACAC TGAAAGCTCG TATTTTAGAG
    TTGGAGAAAA CTGATAGCTT TAATTACGAA GAGGAAGATT CTGTTGGTGG TAGCACAGAA
    CTCGATACAT CATTAGAAGG TGAAATTATT TTTGATAATG AAGACCATCC TTTTATGCGC
    GACAGTTCTG TCGATACTGT TTTTACAACA CAGGCACAAC CACATCAATC AAATCCTATT
    TCAATAACGC GCAGTTCGAC ACACAATCGT CTTTCTTGGG AGCAACACTC AGAAGAAGAA
    ACACTTGAAC TTCAGGATCT TCCTCGTTCC ATTACACCGG AGAGCGTTTG GATGGGCGAA
    GTAGCAATTG ACGTAGAAAC GAGTGATGAC AGTGAGAATA CAAACATTCA AAGCGATCTA
    ACAGTTACTA ATAAAACAAC TAAAAATATT AGACAGCAGG ATGAAATTTC TGATGGAAAT
    AATCATAATT GGGAAATAAT AATGCTTGCT GAACAATTGG AAAAAAAACG TAGAAGTAGC
    GAGTGCTCTA GTTCAGGTTC CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.