LOC105363294 cDNA ORF clone, Ceratosolen solmsi marchali

The following LOC105363294 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105363294 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe198996 XM_011500960.1
Latest version!
Ceratosolen solmsi marchali rho GTPase-activating protein 100F (LOC105363294), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $797.30
$1139.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe198996
    Clone ID Related Accession (Same CDS sequence) XM_011500960.1
    Accession Version XM_011500960.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4203bp)
    Protein sequence
    SNP
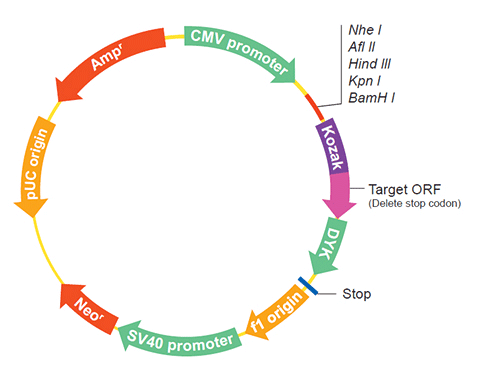
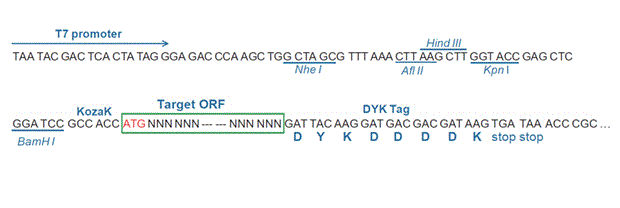
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product rho GTPase-activating protein 100F
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948426.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    ATGCTCTGCT GTGGCCGCAG AAAAGAGGGT CGGGGCGAAG TAACAGACAT AAGCGCAAGT 
    CCAGGGAGAC AGGTATCTCT CAACCAGTTT CGCCCCAAGG AGCCTCTCTC CGTGGTCCTT
    CAGGGAGACT TCAAGAAGGA GAGAAAACTT CTGTTGCAGG TATCTGGAAT ATCGGACGAG
    GTCTACAGGC AAATCGAGGT CGTCGAGAAC GACCATGACG CCTCGACGGC AGCGGCTCTT
    GAGGCTGTCG AGAAGCATGG CGAGATGGTC GTCAAGGTCA TCGAACCACG TCAGATGGGC
    AGACAGGCGT CGGAAGATGC GAAATTGTTC ATCGCCATGC AGGATCCTAA GCATCCAGTG
    AGTTTCGTTG AAATAATCAA GAGGCCCGGC CAAACATTGG GACTCTATAT TCGCGAGGGC
    AACAGTATAG ACAGAAACGA TGGCGTTTTT ATTTCGAGAG TTGCAGTGGA GACGGCAGTA
    CACAATAGCG GATATTTAAA GGTCGGAGAT GAAATACTGG CGGTAAATTT TGTAAACGTG
    ACACGCATGA GTCTGGATGA CGTTGTGGTC GTCATGTCGA TACCAAGACG ACTCGTACTT
    GCCATTAGAC ACGGTTCCCT TATGTTCATG CCGCACAATC GACAAAACGA GCATAAGGCC
    CCACCGGTTG TTGTTATCAA GAAGGAACTC AACGAGGATG AGAACGACCA TATCACCAGT
    AATCATATAA GGGACAGCAA TCGGCGTCGG GGCGACGGTC GCGAGATGTT GCCCTCGCGC
    TCTAAGCTGG GACTATCGGG TCTGGGCTCG ACTCAAGACA TTGTCGCAAG CAACGGCGAC
    CTTTATTATA ACTCAAGGCC GGAGAGTCAC ATTGGCTGGA CGTATCAGCC CCCGCCCCCT
    CCGGTAATTA CCCAGCAGCC TAAGCCGTCC TCGACTCAGC ACTTCCAACC ATATGAGCGT
    GGCTATCCCA AGACCCTCGA GAGCCTTGCC GAGAAGGATT TCACGAAGGT ACACTCGTTT
    TATCCGCCCT CGATGCCGTC GACCAACGGC ACGCGTCGCA TGTCTGCCGG TACCGGCATG
    CAGACGGTCG GAGGCCGATT ACCTGGACAA TCGGTAGGCT CCCACTACGC CGCTGCATAC
    CGACAGCATC CGGGCACGGG TCGCATGATG CCGAGGAGCG GCTCGGACCA ACATCTTCCC
    CGGGTCGACT ACACGAGTAT GACTACGCCG GCTAGACATA CTCTGCTTAG ATCGAGTCTC
    AAGACCGGTT CATCGGCAAT GCGCTACAAT TCGCGCTACG GCCCTCAAAG CGAGACGATG
    TCGTCGCAGC GCCAGGGTCA ATTCGGCACC CTCACAAGAC GTCACAGGCC TTCGCTCGAC
    TACGCTTCCG ACACAGAAGC GACTTGTTCC AGTTCACCCC GTTCGGCCTA CTATTATTAC
    AGGAACAATT TAAAGAACGC AGGACAGAAT AGCGCCGTCT CTCACCTGGC AACGCTATCA
    CGTTCACAGA TCGGCCAGAG CGCAGGCTTG AGATCGAATT CGTTGCCGCG TAGCGGTAGG
    ACGTTGCCGC AGCAGCCGAG CCTTAGACCG GGACTTAGCA CCGTCGCGTC AGGTCTGATC
    GATCAAGAAG ACAGCGACGG AGCTCTCTCA GCTCCTGAAC TTCCCTGTAT CCGACGAGAC
    CGAGGGAGAA TACCGTCGTC ACCAAGTGTA TTTACATCGG ACGAGTACAG GGCTTGGCTA
    AGCCGTACCC CAAGTACTTC AGCCCTCTAT GAGCAGATAC GTGCGACAAC AAACCGACCA
    CCTCGCTACA CATATAGTGC CGAGAACATT CATGCGGCCG TTAATCAGGC CGATTATGGT
    AGCTACGGCT CGTACAGGCC GATGTCAAGT ACACTAGATC GCTTATCAAC GAGATCAGCT
    TCCGCCCAGC AGGTGAATCT TGCGAATCTC CGAGCTTCTA CAGCCATTAG CTCGTCGAAT
    CATCGATCCA CTGGAAATCA AAGGCCTTCC TCGGTTGCCT CCAACGTCAG ATCGTCATTG
    GTCGGTCAGA AATCCAACAC ACTTGGCAAT CCAGGCAGTC AGCGAGCAAC GAGCGTTAGA
    CGAATGCGAA ACATCCTAGA CCTTGAGTCG GCTCGTAGCA TACCTACACC CACACCTACT
    AGAAATATAG ATCAAAGACT GCTGGACATT AATCCTGCAG AGTTCCTCAA ATACAAGATA
    GAAAAGCCAC CAACGGTGGG CACGCCAAGT TCAACAAGTT CTCTACTAAG CTCATTGGCG
    GATAACGCTG GCAGTGACTT CTGTAGCGGC ATTAGCGGCC TTCTTTGGGT ACATTTACTT
    GCTGGACGTG GACTTCGTGC GACTACGTCG AGCTCAGCAG CGACAACGCC ATCGACGCCG
    TCGGGTCAGC CTAACATAGT GAATTGCAGC CTGAGAGACC TGTACTGCGT CTTAGAATGT
    GATCGAGTGC ACAAAGCTCG TACGGTAGTG CGCACGGGTG ATCTCATGTT CGACTGGGAT
    GAGAATTTCG AGCTGGACCT CGTGGGTAAT CGGCAGCTCG ATCTGCTTGT TTATTCATGG
    GATCCGCAAT ATCGACATAA ACTTTGCTAT AAAGGATCGG TGCACTTAGC CACGCTATTA
    AAAGAGTCGC CGATTCATCA ATTGGCCGTG AAGGTCGAAC CCCGAGGTAC GATATATCTG
    AGGTTGAGGT ACACAGACGC CAGCCAAACG TTTCGTAGAA GAGGTTTACC AGTTATCTCG
    CTTGCTACGA GAATCGCACC GCTGTTTGGC ATTGATCTCG ACACTGTTGT GACTCGGGAG
    AATAAAACTG GCGGAGTTCC AGGAGGTGTG TCAACAGCCC TGGCACTCGG GGGTAGTAGT
    GTACCGAATG TACCGATAAT AGTCTGGCGT TGTGTGGAGG AAGTGGAAAG AAGAGGACTA
    GATATTATTG GCTTATATAG ACTTTGTGGA TCAGCAACGA AAAAGCGAAT ACTAAGAGAG
    GCTTTCGAAA GAAATGCTAG ATCAGTTGAT TTATCGTCTG ATAATGTTCC TGACATTAAC
    GTTATAACAG GCGTTTTGAA AGACTACTTG AGAGAATTGC CAGAGCCTCT GTTCACGAAG
    TGCCTCTATC AAATGATGGT CGACGCACTC GGAGTCTGTT TACCGGATGA TCCACAAGGA
    AATGCAAAGT TAATGTTTAG CATTCTCGAT TGCCTACCGA CTGTAAACAA GTGTACATTG
    ATTTATCTAT TGGATCATCT GGCAATGGTC ATTTCCCAAT GCAATAAAAT GTCTCCTGCT
    AGTTTAGCAG TCTGTTTTGG TCCAGTGCTA ATGTTGCATT CGGATGAAGC GGGAGCGATA
    CTTGACTTCC AACAGCCTAT AGCCGTTCTG AAGTATTTAC TCGAAATTTG GCCAGTTAAG
    TCAGTTCGGA AGATTTCTTC AGTCTTTTCA ACACTTCCTC GAGTTATGCC AGCACACGTC
    AACAGCAACT CGCATCAGCC GCAGGCCTCC TCTCAAATTC AGCAACATCA TCAATCCCAA
    ATTCAGCATC AGCAGCAGCA GCCATTACAG CAATCGGGAA CGCTGCCGCG AACAGGGCTG
    CTTTGGCAGC AGCAACACTC ACATCATCAT CAGCCCCTCA CTACTACAGC GGTAGGTCAG
    CATCAGCGGC AGCAACAACA GCAACAACAG CAACAGCAGC AGCAGCAGCA GCAGCAGCAA
    CAGCAGCAAC AACAAATACA GCAAAAACAG CAAACCATTA CAGCTTCCCC GCGCCTCCCT
    CCGCCGCCAC CCATCAAGCC ACGACAGGTG ATAGTTTCAT CTCCCGGTTC ACCTAGCAGC
    GAGGATTCCA GCAGTTATCA GGAATCGGTT AAATTAAATT GCTCGCCAGC TGTTAATAGC
    TCGACATCGA ACCCAGTCAT TGTGAACAAT AAGCCCCATC TTCATTCGAC TAATCCATTC
    CTTAATTCAT TGACTAATGG GAATGGAAAT GGTAACGATA GCAACGATCA TGAAATCAGT
    CACGAGAACG GCCATGGGCA CAGCGTTAGT TTCTTCACTC ATGGAACGAA CGAGGAAGTA
    ACTCCGACAA GTAGTGTCGA TACTGAGGAT GGCACTGTGC ACCATGAAGA AGGTGAACAT
    GGTGTTGAGG GAGACGCTGA AGCCAGCGAT GACGATCATG TTATCAATAC TAGGTCGGCT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011499262.1
    CDS44..4246
    Translation

    Target ORF information:

    RefSeq Version XM_011500960.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali rho GTPase-activating protein 100F (LOC105363294), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011500960.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    ATGCTCTGCT GTGGCCGCAG AAAAGAGGGT CGGGGCGAAG TAACAGACAT AAGCGCAAGT 
    CCAGGGAGAC AGGTATCTCT CAACCAGTTT CGCCCCAAGG AGCCTCTCTC CGTGGTCCTT
    CAGGGAGACT TCAAGAAGGA GAGAAAACTT CTGTTGCAGG TATCTGGAAT ATCGGACGAG
    GTCTACAGGC AAATCGAGGT CGTCGAGAAC GACCATGACG CCTCGACGGC AGCGGCTCTT
    GAGGCTGTCG AGAAGCATGG CGAGATGGTC GTCAAGGTCA TCGAACCACG TCAGATGGGC
    AGACAGGCGT CGGAAGATGC GAAATTGTTC ATCGCCATGC AGGATCCTAA GCATCCAGTG
    AGTTTCGTTG AAATAATCAA GAGGCCCGGC CAAACATTGG GACTCTATAT TCGCGAGGGC
    AACAGTATAG ACAGAAACGA TGGCGTTTTT ATTTCGAGAG TTGCAGTGGA GACGGCAGTA
    CACAATAGCG GATATTTAAA GGTCGGAGAT GAAATACTGG CGGTAAATTT TGTAAACGTG
    ACACGCATGA GTCTGGATGA CGTTGTGGTC GTCATGTCGA TACCAAGACG ACTCGTACTT
    GCCATTAGAC ACGGTTCCCT TATGTTCATG CCGCACAATC GACAAAACGA GCATAAGGCC
    CCACCGGTTG TTGTTATCAA GAAGGAACTC AACGAGGATG AGAACGACCA TATCACCAGT
    AATCATATAA GGGACAGCAA TCGGCGTCGG GGCGACGGTC GCGAGATGTT GCCCTCGCGC
    TCTAAGCTGG GACTATCGGG TCTGGGCTCG ACTCAAGACA TTGTCGCAAG CAACGGCGAC
    CTTTATTATA ACTCAAGGCC GGAGAGTCAC ATTGGCTGGA CGTATCAGCC CCCGCCCCCT
    CCGGTAATTA CCCAGCAGCC TAAGCCGTCC TCGACTCAGC ACTTCCAACC ATATGAGCGT
    GGCTATCCCA AGACCCTCGA GAGCCTTGCC GAGAAGGATT TCACGAAGGT ACACTCGTTT
    TATCCGCCCT CGATGCCGTC GACCAACGGC ACGCGTCGCA TGTCTGCCGG TACCGGCATG
    CAGACGGTCG GAGGCCGATT ACCTGGACAA TCGGTAGGCT CCCACTACGC CGCTGCATAC
    CGACAGCATC CGGGCACGGG TCGCATGATG CCGAGGAGCG GCTCGGACCA ACATCTTCCC
    CGGGTCGACT ACACGAGTAT GACTACGCCG GCTAGACATA CTCTGCTTAG ATCGAGTCTC
    AAGACCGGTT CATCGGCAAT GCGCTACAAT TCGCGCTACG GCCCTCAAAG CGAGACGATG
    TCGTCGCAGC GCCAGGGTCA ATTCGGCACC CTCACAAGAC GTCACAGGCC TTCGCTCGAC
    TACGCTTCCG ACACAGAAGC GACTTGTTCC AGTTCACCCC GTTCGGCCTA CTATTATTAC
    AGGAACAATT TAAAGAACGC AGGACAGAAT AGCGCCGTCT CTCACCTGGC AACGCTATCA
    CGTTCACAGA TCGGCCAGAG CGCAGGCTTG AGATCGAATT CGTTGCCGCG TAGCGGTAGG
    ACGTTGCCGC AGCAGCCGAG CCTTAGACCG GGACTTAGCA CCGTCGCGTC AGGTCTGATC
    GATCAAGAAG ACAGCGACGG AGCTCTCTCA GCTCCTGAAC TTCCCTGTAT CCGACGAGAC
    CGAGGGAGAA TACCGTCGTC ACCAAGTGTA TTTACATCGG ACGAGTACAG GGCTTGGCTA
    AGCCGTACCC CAAGTACTTC AGCCCTCTAT GAGCAGATAC GTGCGACAAC AAACCGACCA
    CCTCGCTACA CATATAGTGC CGAGAACATT CATGCGGCCG TTAATCAGGC CGATTATGGT
    AGCTACGGCT CGTACAGGCC GATGTCAAGT ACACTAGATC GCTTATCAAC GAGATCAGCT
    TCCGCCCAGC AGGTGAATCT TGCGAATCTC CGAGCTTCTA CAGCCATTAG CTCGTCGAAT
    CATCGATCCA CTGGAAATCA AAGGCCTTCC TCGGTTGCCT CCAACGTCAG ATCGTCATTG
    GTCGGTCAGA AATCCAACAC ACTTGGCAAT CCAGGCAGTC AGCGAGCAAC GAGCGTTAGA
    CGAATGCGAA ACATCCTAGA CCTTGAGTCG GCTCGTAGCA TACCTACACC CACACCTACT
    AGAAATATAG ATCAAAGACT GCTGGACATT AATCCTGCAG AGTTCCTCAA ATACAAGATA
    GAAAAGCCAC CAACGGTGGG CACGCCAAGT TCAACAAGTT CTCTACTAAG CTCATTGGCG
    GATAACGCTG GCAGTGACTT CTGTAGCGGC ATTAGCGGCC TTCTTTGGGT ACATTTACTT
    GCTGGACGTG GACTTCGTGC GACTACGTCG AGCTCAGCAG CGACAACGCC ATCGACGCCG
    TCGGGTCAGC CTAACATAGT GAATTGCAGC CTGAGAGACC TGTACTGCGT CTTAGAATGT
    GATCGAGTGC ACAAAGCTCG TACGGTAGTG CGCACGGGTG ATCTCATGTT CGACTGGGAT
    GAGAATTTCG AGCTGGACCT CGTGGGTAAT CGGCAGCTCG ATCTGCTTGT TTATTCATGG
    GATCCGCAAT ATCGACATAA ACTTTGCTAT AAAGGATCGG TGCACTTAGC CACGCTATTA
    AAAGAGTCGC CGATTCATCA ATTGGCCGTG AAGGTCGAAC CCCGAGGTAC GATATATCTG
    AGGTTGAGGT ACACAGACGC CAGCCAAACG TTTCGTAGAA GAGGTTTACC AGTTATCTCG
    CTTGCTACGA GAATCGCACC GCTGTTTGGC ATTGATCTCG ACACTGTTGT GACTCGGGAG
    AATAAAACTG GCGGAGTTCC AGGAGGTGTG TCAACAGCCC TGGCACTCGG GGGTAGTAGT
    GTACCGAATG TACCGATAAT AGTCTGGCGT TGTGTGGAGG AAGTGGAAAG AAGAGGACTA
    GATATTATTG GCTTATATAG ACTTTGTGGA TCAGCAACGA AAAAGCGAAT ACTAAGAGAG
    GCTTTCGAAA GAAATGCTAG ATCAGTTGAT TTATCGTCTG ATAATGTTCC TGACATTAAC
    GTTATAACAG GCGTTTTGAA AGACTACTTG AGAGAATTGC CAGAGCCTCT GTTCACGAAG
    TGCCTCTATC AAATGATGGT CGACGCACTC GGAGTCTGTT TACCGGATGA TCCACAAGGA
    AATGCAAAGT TAATGTTTAG CATTCTCGAT TGCCTACCGA CTGTAAACAA GTGTACATTG
    ATTTATCTAT TGGATCATCT GGCAATGGTC ATTTCCCAAT GCAATAAAAT GTCTCCTGCT
    AGTTTAGCAG TCTGTTTTGG TCCAGTGCTA ATGTTGCATT CGGATGAAGC GGGAGCGATA
    CTTGACTTCC AACAGCCTAT AGCCGTTCTG AAGTATTTAC TCGAAATTTG GCCAGTTAAG
    TCAGTTCGGA AGATTTCTTC AGTCTTTTCA ACACTTCCTC GAGTTATGCC AGCACACGTC
    AACAGCAACT CGCATCAGCC GCAGGCCTCC TCTCAAATTC AGCAACATCA TCAATCCCAA
    ATTCAGCATC AGCAGCAGCA GCCATTACAG CAATCGGGAA CGCTGCCGCG AACAGGGCTG
    CTTTGGCAGC AGCAACACTC ACATCATCAT CAGCCCCTCA CTACTACAGC GGTAGGTCAG
    CATCAGCGGC AGCAACAACA GCAACAACAG CAACAGCAGC AGCAGCAGCA GCAGCAGCAA
    CAGCAGCAAC AACAAATACA GCAAAAACAG CAAACCATTA CAGCTTCCCC GCGCCTCCCT
    CCGCCGCCAC CCATCAAGCC ACGACAGGTG ATAGTTTCAT CTCCCGGTTC ACCTAGCAGC
    GAGGATTCCA GCAGTTATCA GGAATCGGTT AAATTAAATT GCTCGCCAGC TGTTAATAGC
    TCGACATCGA ACCCAGTCAT TGTGAACAAT AAGCCCCATC TTCATTCGAC TAATCCATTC
    CTTAATTCAT TGACTAATGG GAATGGAAAT GGTAACGATA GCAACGATCA TGAAATCAGT
    CACGAGAACG GCCATGGGCA CAGCGTTAGT TTCTTCACTC ATGGAACGAA CGAGGAAGTA
    ACTCCGACAA GTAGTGTCGA TACTGAGGAT GGCACTGTGC ACCATGAAGA AGGTGAACAT
    GGTGTTGAGG GAGACGCTGA AGCCAGCGAT GACGATCATG TTATCAATAC TAGGTCGGCT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.