LOC105360263 cDNA ORF clone, Ceratosolen solmsi marchali

The following LOC105360263 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105360263 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe195884 XM_011497115.1
Latest version!
Ceratosolen solmsi marchali PERQ amino acid-rich with GYF domain-containing protein 2-like (LOC105360263), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 24-26 $881.30
$1259.00
OCe195885 XM_011497116.1
Latest version!
Ceratosolen solmsi marchali PERQ amino acid-rich with GYF domain-containing protein 2-like (LOC105360263), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 24-26 $881.30
$1259.00
OCe195886 XM_011497117.1
Latest version!
Ceratosolen solmsi marchali PERQ amino acid-rich with GYF domain-containing protein 2-like (LOC105360263), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 24-26 $881.30
$1259.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe195884
    Clone ID Related Accession (Same CDS sequence) XM_011497115.1
    Accession Version XM_011497115.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4554bp)
    Protein sequence
    SNP
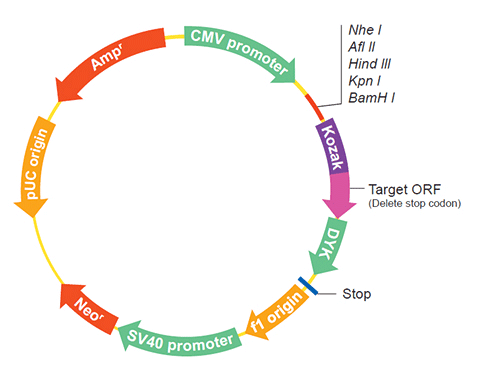
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
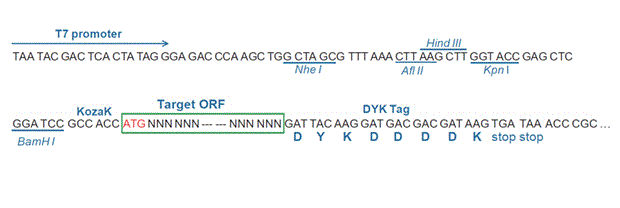
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product PERQ amino acid-rich with GYF domain-containing protein CG11148-like isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948418.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    ATGCAGAGTT CTAGCATCAT GACGGATTCT CTGAAGTTCG GTCCAGAATG GTTACGCAAT 
    TTGGCAGGAG ATGGATGCAG TGGAGGCGGA GGCGGAAGTC TCACAATTCC TCGGTATCAG
    TTGGCGGAGC ATAGATACGG TCGAGAAGAG ATGCTTGCTC TTTTTGATCG TATGTGTAAG
    CCTCCAGAGC CATTGTCAAG TTTTACAGCG CTTTATATAC CAAAAGCTCA GCTACCATTG
    GCATTAATAC AAATGACAGA GGAAGAAACA TGTTTATGGA GTGGGGGAGG TGGAAATAAT
    AGTGCTAGTC GTGGTAGAGG TGGTAGTGTC GATCGTGGAG GGCGGAATAG AAGTGGAAGA
    ACGGGCGGTC ATTATCGTGG TGTGGGCTTT GAAGATATGG GAGAAGGTCC AAGAATTGAA
    ACACAATCAT TTCCGGTGCG AACCAGAGCA TTTGATAGAC CTCCAAGTGA ACGTACCTGG
    TCAGAACGAA ACGGAGTAGA TCCGGCTGAG TGGAACGGGT CAACTAGTCC TAGAAAGGAT
    GTGAGTCGTG CTTTAAGTGG CAATTCTCTT ATGGAAAGTA ATTGGAGGCG CAATCGAGGT
    GGTGGAGGAA ATGACGATGG TTGGCGATTG AATAAAGCAA GAGCTGAAAA ATGGACTAAA
    GAGAGTTGGC GTGATGCTGA TAAAGAACGA GACGAAAAAA TAGATGGCGA TGAAGATAAA
    AAGAGAGAAC GTTGGGATCA TAAAGGGAGT AATAGAGCGT TTGATTCTCA TCCACCTCCA
    TTACGTAAAA ATCGTTCAAA TCATCATGAT AATCACGATA ATCTACCAGA ATGTGAGTTT
    TACAGGGCGA CCGAAAATCC CAGTGAAAGT GGTGGTAGTT TCGATGCCTC CGGAGCATTT
    CATGGCATGT ACTCAGATGA CGATGAGGAG CATCCAGATC GAGTGCATCA CGATAGAAAG
    CAACGGGGCT CACGAATACG TCGTGTTTCG GAGGGTAATG CTTCACAGTA TAAAAATGGT
    GTAAGATCGG CTCCCATTAT TAGTCGGTCA ACAAAATTCG ACCGGGCATT AAACGGTGAA
    CGGCCAAAGT CCTTGCATGC TGAATCTGAA GATCAAATTT TACCACCAGA GAAGGAGACG
    AGACGTAGTT TATCACCAAT AAAGTTAACA TCAGTTTCCA GTAGTCCCTC TATTAAAAAG
    ACCTCGTCCA CGACGAATAA TAACACTAGT CAAACTGTTA GTAGTAGTCA ACCAGCGACG
    AACTCCATCG ATTCGAGGAA GAAAGATAAA GGAACAAAGC AATTAATACA AGAAAAACCT
    CAGAAGAATT CACCACAGAC GACCACTACA AATGTGCCAG TTTCTAAAGC CAAATCGAAA
    ATAGAAAGCC CAATGAAAAT AGATGATCCA AAACCTAAAA CCGAGCGCAA TAAAACATCC
    AGTAAAGCAG AGAACGCCAA CAAACTTGAA TTGCGAAAGC CCGTGGAGCC GACGAAAATC
    AAAATATCAA ATATTCCACA GCAACAACAG CAACAACAAC AACAACAACA ACAACAACAA
    CAGCAACAAC CGCTACAATC AATACCTCAG CGAGTTCCTG CGGATGTGGG TGTCAACATA
    ATACAGCGGC AAGAGCAAAC GGACGACAAA CAGAGAACAG AAACAGACAA CTTGGATAGG
    ATGGAGGAAG AGGTCGCAAA ACTCATTGAT GGCGGAAGTC CTCGAGACGA AAAGCCAGCA
    TCGAGTGTTC TGTCTTCGTC GGCGGTCGTC GTAAATCAAA CGGTTATCGA GTCGACAATA
    CCGCCAGGCA CACAGACCAC TACAGTTATA CAAGAGAAAT GGTATTATAG GGATCCGCAG
    GGCGAGGTTC AGGGTCCTTT CCTTGCCAGC GAGATGGGCG AGTGGCATAA ACAGGGCTAC
    TTTACACCAA ATTTACTGCT CAGGAGAACC TGCGACGAGA GATACACAAC GCTTGGCGAC
    CTCATAAATT TGTGTGGCAG AGTACCATTT AAACCAGGCA CCAATTTCCC TCCACTCAAG
    CTCTCCGATA TGAGAATGTC GCCGAGTGTT GTTGGAGCGG TGCCGAACAC TATGCCAGTA
    CCCGGTGGCT TGCCCAAACC GACCCCCATC GATGATCCGC TACTCCTGTA TCAGTACCAG
    CAATACCGAC TCCTGCAGAA TCAGCAGATG TTCTTGAAGC AGTTGCGTGC GAGTGCCATT
    GGTAAGCTGT CTCAGTCGGA GCAGTGGGCG AACCTCAGCC CCGTCGAGCA AAATCAGCTG
    GTATTGCAAT ATGTGAGATC GATCGATTCG GAAATATCGG AGATGCCACA ATCCCAGCCG
    CCGGCTGTCC CAAGTACTTT TATACCTACG ATGCCGCAAC CGGCACCACC TTCGAGCTCG
    GTACTGCAAA TCTTTCCCCA ACTTCATCAG GCAGCAAAAA GTCATCCAGA ACCAGCGCAC
    GTACCCGCGC CCAGTCCCCA TATGTCTACT GGTGCAATAG ATCCGATCCA GCAACTGATG
    CAACAAATGA GCGGCATGCG AAATTTGCCG CCCTTACCGC AGTCGACGAT CGTTCCAAGT
    CCCCCACAGC CACAACCCCA GCACCAGCCC CAACCGCTAC CCCAACCCCA GGACGACAAT
    CCGATAAAAT CCTGGCTTAG GCAGCTCGCC GTCAATAGCA GTGGACATAT TCAGCAACAA
    CCCCAGCTGC AGACTCAGAT CGAGTCAGTA TGGCATCAAC CACCGCCTCA TCTTACGTCC
    TTTAACGCGC AAAATTGGAT GACGCAGGTT GGTGCGATTC AACCAACAGT ACCTCCTGGC
    CAACTGCCTG GCTCATTATG GGATATTCAT CCTAAGGATA TGAAGACAGA GCAACAAATA
    TTGGAGGAAC AGAATCTAAA AATGCAAGAA GAAAAAAAGA AAGAGGAGCT GCGGAAGAAA
    GAAGAATTAG AAAGACAAAA GGTCGAACAA GAACGCGTTA AACGTCAGCA AGAGGAAGAA
    TTAGCAAGAT TGAAAGCAGC TGAGGAAGCG GCAAAGCGAG AAGAGGCCGA GAGAAAGAAA
    CGTGATGAGG AGAAAAGACG TCTTGAAGAA ATAAAGCATA AGCAGGAAGA AGAGCGGAGA
    AAACTGGAAG AAAGGCGACG TAAGGAAGAG GAGAGGAAAC GCGAGGAAAA GCGAAAACAG
    GATGAAGAGC TGAATAGGAA AAAGCAAGAA GAGGAAAAGA GAAAACGCGA GGAAGCCCAG
    AGACAGGAGG AAAAATTAAG AAGAGAGGAG GAACAAAGAA AAAAATTGGA AGAAGAGCAG
    AAGAGGCAGG AAGAAGAAAG ATTAAGAAAA GAGGAAGAGG CCCGTAAGAA ATCCGAGGCC
    GAGGAACAAG CGAGAAAAGC CGAGCAAAGA CGAAGAGAGG CTGAGGCGCT TCGGAAATTA
    CAAGAACGCA GTAAGGCTCC CTGGGCTCAA GCTCCTCCTG CACCCCCACC AACTGCCCAA
    GCCTCTCTAG CCGAGATTCA AAGGCTTGAA AGAGAAAAGA AGGCTGAAGA TTTGCGGCTT
    CAGCAGTTGC TACAACAGCA GCAATTGGCC CAGCAGAAGG CAGCCGAAGC AGCTCAGGAA
    GCACTTACAG ATTCTGCCAA ACGTTTGCAA TTTAAATGGG CCGAAAAGGC CGCTCCCATT
    AATAATATGA ATCAGGTGAA GAGCCTCGCC CAAATTCAAC AGGAAGAGCA GGAGAGAGTC
    GCCAAAGTTA AGCATCAAGA AAGAGAAAGA CAAGAAAAAG AGAAGGCCAG TCAGAAAGAG
    GCAACTATTA CACTGCAAAA TGTCAGTATT TGGGGTACGG CATCTCAGAG TTTAAATTGG
    TCAAACACTT CAAACTCTAG TAACCAAATT TATGGAGCTG GTGGGGGCTT TTGGGATGAT
    TTGACTCCAA AAGTTAACAC CATTGCTCCA AAAATGGTTA ACGCCGTAAG TTCTAAGACA
    TCGATAAAGC AACAGACGAC CGCCGCCAAA TTATCTCCTC AGCAGAATCA GCATCAGCAT
    CAGCATCAGC ATCAGCAGCA GCAGCAGCAG CAGCAGCAAA ATAATAAAAT GGTGAAGAAT
    AAAAACAAAA AGGAAGAGGA ATTGGTGAAG AAGCTTTTTG AACAAAATAC TGCCAAAACT
    GATGATTTCA CCCAATGGTG TAACAAAGCT TTGACTGGTC TTCAAGTATC AGTAGATATA
    CCTACTTTTA TTGGCTTCTT ACGCGACATT GAAGCAGCAT ATGAAGTTAA AGAATATGTA
    CGTATGTACT TGGGCGATGG TAAACAATGT TCTGAATTCG CTAAGCAGTT TTTAGAAAAA
    AGAAGTAAAT GGAAATCGTC TCAGCGGCCA CAGACACACG CAGATGATTT ATGTAAGCCA
    GCTCCTGCTG TTAATCCAAA TACTTCAACG GAATTTCAAG AAGTAAAGAA TAAATCCAAA
    AAACCGAAGA AAGGCAAAAT GTTTAAAGTA GATAGTAAAA TGCTCGGTTT CAGTGTTATG
    TCTGCCCCAG ATCGCATCAA TGTCGGAGAT CGTGATTATG CAGAAGGCGT ATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011495417.1
    CDS21..4574
    Translation

    Target ORF information:

    RefSeq Version XM_011497115.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali PERQ amino acid-rich with GYF domain-containing protein 2-like (LOC105360263), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011497115.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    ATGCAGAGTT CTAGCATCAT GACGGATTCT CTGAAGTTCG GTCCAGAATG GTTACGCAAT 
    TTGGCAGGAG ATGGATGCAG TGGAGGCGGA GGCGGAAGTC TCACAATTCC TCGGTATCAG
    TTGGCGGAGC ATAGATACGG TCGAGAAGAG ATGCTTGCTC TTTTTGATCG TATGTGTAAG
    CCTCCAGAGC CATTGTCAAG TTTTACAGCG CTTTATATAC CAAAAGCTCA GCTACCATTG
    GCATTAATAC AAATGACAGA GGAAGAAACA TGTTTATGGA GTGGGGGAGG TGGAAATAAT
    AGTGCTAGTC GTGGTAGAGG TGGTAGTGTC GATCGTGGAG GGCGGAATAG AAGTGGAAGA
    ACGGGCGGTC ATTATCGTGG TGTGGGCTTT GAAGATATGG GAGAAGGTCC AAGAATTGAA
    ACACAATCAT TTCCGGTGCG AACCAGAGCA TTTGATAGAC CTCCAAGTGA ACGTACCTGG
    TCAGAACGAA ACGGAGTAGA TCCGGCTGAG TGGAACGGGT CAACTAGTCC TAGAAAGGAT
    GTGAGTCGTG CTTTAAGTGG CAATTCTCTT ATGGAAAGTA ATTGGAGGCG CAATCGAGGT
    GGTGGAGGAA ATGACGATGG TTGGCGATTG AATAAAGCAA GAGCTGAAAA ATGGACTAAA
    GAGAGTTGGC GTGATGCTGA TAAAGAACGA GACGAAAAAA TAGATGGCGA TGAAGATAAA
    AAGAGAGAAC GTTGGGATCA TAAAGGGAGT AATAGAGCGT TTGATTCTCA TCCACCTCCA
    TTACGTAAAA ATCGTTCAAA TCATCATGAT AATCACGATA ATCTACCAGA ATGTGAGTTT
    TACAGGGCGA CCGAAAATCC CAGTGAAAGT GGTGGTAGTT TCGATGCCTC CGGAGCATTT
    CATGGCATGT ACTCAGATGA CGATGAGGAG CATCCAGATC GAGTGCATCA CGATAGAAAG
    CAACGGGGCT CACGAATACG TCGTGTTTCG GAGGGTAATG CTTCACAGTA TAAAAATGGT
    GTAAGATCGG CTCCCATTAT TAGTCGGTCA ACAAAATTCG ACCGGGCATT AAACGGTGAA
    CGGCCAAAGT CCTTGCATGC TGAATCTGAA GATCAAATTT TACCACCAGA GAAGGAGACG
    AGACGTAGTT TATCACCAAT AAAGTTAACA TCAGTTTCCA GTAGTCCCTC TATTAAAAAG
    ACCTCGTCCA CGACGAATAA TAACACTAGT CAAACTGTTA GTAGTAGTCA ACCAGCGACG
    AACTCCATCG ATTCGAGGAA GAAAGATAAA GGAACAAAGC AATTAATACA AGAAAAACCT
    CAGAAGAATT CACCACAGAC GACCACTACA AATGTGCCAG TTTCTAAAGC CAAATCGAAA
    ATAGAAAGCC CAATGAAAAT AGATGATCCA AAACCTAAAA CCGAGCGCAA TAAAACATCC
    AGTAAAGCAG AGAACGCCAA CAAACTTGAA TTGCGAAAGC CCGTGGAGCC GACGAAAATC
    AAAATATCAA ATATTCCACA GCAACAACAG CAACAACAAC AACAACAACA ACAACAACAA
    CAGCAACAAC CGCTACAATC AATACCTCAG CGAGTTCCTG CGGATGTGGG TGTCAACATA
    ATACAGCGGC AAGAGCAAAC GGACGACAAA CAGAGAACAG AAACAGACAA CTTGGATAGG
    ATGGAGGAAG AGGTCGCAAA ACTCATTGAT GGCGGAAGTC CTCGAGACGA AAAGCCAGCA
    TCGAGTGTTC TGTCTTCGTC GGCGGTCGTC GTAAATCAAA CGGTTATCGA GTCGACAATA
    CCGCCAGGCA CACAGACCAC TACAGTTATA CAAGAGAAAT GGTATTATAG GGATCCGCAG
    GGCGAGGTTC AGGGTCCTTT CCTTGCCAGC GAGATGGGCG AGTGGCATAA ACAGGGCTAC
    TTTACACCAA ATTTACTGCT CAGGAGAACC TGCGACGAGA GATACACAAC GCTTGGCGAC
    CTCATAAATT TGTGTGGCAG AGTACCATTT AAACCAGGCA CCAATTTCCC TCCACTCAAG
    CTCTCCGATA TGAGAATGTC GCCGAGTGTT GTTGGAGCGG TGCCGAACAC TATGCCAGTA
    CCCGGTGGCT TGCCCAAACC GACCCCCATC GATGATCCGC TACTCCTGTA TCAGTACCAG
    CAATACCGAC TCCTGCAGAA TCAGCAGATG TTCTTGAAGC AGTTGCGTGC GAGTGCCATT
    GGTAAGCTGT CTCAGTCGGA GCAGTGGGCG AACCTCAGCC CCGTCGAGCA AAATCAGCTG
    GTATTGCAAT ATGTGAGATC GATCGATTCG GAAATATCGG AGATGCCACA ATCCCAGCCG
    CCGGCTGTCC CAAGTACTTT TATACCTACG ATGCCGCAAC CGGCACCACC TTCGAGCTCG
    GTACTGCAAA TCTTTCCCCA ACTTCATCAG GCAGCAAAAA GTCATCCAGA ACCAGCGCAC
    GTACCCGCGC CCAGTCCCCA TATGTCTACT GGTGCAATAG ATCCGATCCA GCAACTGATG
    CAACAAATGA GCGGCATGCG AAATTTGCCG CCCTTACCGC AGTCGACGAT CGTTCCAAGT
    CCCCCACAGC CACAACCCCA GCACCAGCCC CAACCGCTAC CCCAACCCCA GGACGACAAT
    CCGATAAAAT CCTGGCTTAG GCAGCTCGCC GTCAATAGCA GTGGACATAT TCAGCAACAA
    CCCCAGCTGC AGACTCAGAT CGAGTCAGTA TGGCATCAAC CACCGCCTCA TCTTACGTCC
    TTTAACGCGC AAAATTGGAT GACGCAGGTT GGTGCGATTC AACCAACAGT ACCTCCTGGC
    CAACTGCCTG GCTCATTATG GGATATTCAT CCTAAGGATA TGAAGACAGA GCAACAAATA
    TTGGAGGAAC AGAATCTAAA AATGCAAGAA GAAAAAAAGA AAGAGGAGCT GCGGAAGAAA
    GAAGAATTAG AAAGACAAAA GGTCGAACAA GAACGCGTTA AACGTCAGCA AGAGGAAGAA
    TTAGCAAGAT TGAAAGCAGC TGAGGAAGCG GCAAAGCGAG AAGAGGCCGA GAGAAAGAAA
    CGTGATGAGG AGAAAAGACG TCTTGAAGAA ATAAAGCATA AGCAGGAAGA AGAGCGGAGA
    AAACTGGAAG AAAGGCGACG TAAGGAAGAG GAGAGGAAAC GCGAGGAAAA GCGAAAACAG
    GATGAAGAGC TGAATAGGAA AAAGCAAGAA GAGGAAAAGA GAAAACGCGA GGAAGCCCAG
    AGACAGGAGG AAAAATTAAG AAGAGAGGAG GAACAAAGAA AAAAATTGGA AGAAGAGCAG
    AAGAGGCAGG AAGAAGAAAG ATTAAGAAAA GAGGAAGAGG CCCGTAAGAA ATCCGAGGCC
    GAGGAACAAG CGAGAAAAGC CGAGCAAAGA CGAAGAGAGG CTGAGGCGCT TCGGAAATTA
    CAAGAACGCA GTAAGGCTCC CTGGGCTCAA GCTCCTCCTG CACCCCCACC AACTGCCCAA
    GCCTCTCTAG CCGAGATTCA AAGGCTTGAA AGAGAAAAGA AGGCTGAAGA TTTGCGGCTT
    CAGCAGTTGC TACAACAGCA GCAATTGGCC CAGCAGAAGG CAGCCGAAGC AGCTCAGGAA
    GCACTTACAG ATTCTGCCAA ACGTTTGCAA TTTAAATGGG CCGAAAAGGC CGCTCCCATT
    AATAATATGA ATCAGGTGAA GAGCCTCGCC CAAATTCAAC AGGAAGAGCA GGAGAGAGTC
    GCCAAAGTTA AGCATCAAGA AAGAGAAAGA CAAGAAAAAG AGAAGGCCAG TCAGAAAGAG
    GCAACTATTA CACTGCAAAA TGTCAGTATT TGGGGTACGG CATCTCAGAG TTTAAATTGG
    TCAAACACTT CAAACTCTAG TAACCAAATT TATGGAGCTG GTGGGGGCTT TTGGGATGAT
    TTGACTCCAA AAGTTAACAC CATTGCTCCA AAAATGGTTA ACGCCGTAAG TTCTAAGACA
    TCGATAAAGC AACAGACGAC CGCCGCCAAA TTATCTCCTC AGCAGAATCA GCATCAGCAT
    CAGCATCAGC ATCAGCAGCA GCAGCAGCAG CAGCAGCAAA ATAATAAAAT GGTGAAGAAT
    AAAAACAAAA AGGAAGAGGA ATTGGTGAAG AAGCTTTTTG AACAAAATAC TGCCAAAACT
    GATGATTTCA CCCAATGGTG TAACAAAGCT TTGACTGGTC TTCAAGTATC AGTAGATATA
    CCTACTTTTA TTGGCTTCTT ACGCGACATT GAAGCAGCAT ATGAAGTTAA AGAATATGTA
    CGTATGTACT TGGGCGATGG TAAACAATGT TCTGAATTCG CTAAGCAGTT TTTAGAAAAA
    AGAAGTAAAT GGAAATCGTC TCAGCGGCCA CAGACACACG CAGATGATTT ATGTAAGCCA
    GCTCCTGCTG TTAATCCAAA TACTTCAACG GAATTTCAAG AAGTAAAGAA TAAATCCAAA
    AAACCGAAGA AAGGCAAAAT GTTTAAAGTA GATAGTAAAA TGCTCGGTTT CAGTGTTATG
    TCTGCCCCAG ATCGCATCAA TGTCGGAGAT CGTGATTATG CAGAAGGCGT ATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCe195885
    Clone ID Related Accession (Same CDS sequence) XM_011497116.1
    Accession Version XM_011497116.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4542bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product PERQ amino acid-rich with GYF domain-containing protein 2-like isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948418.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    ATGCAGAGTT CTAGCATCAT GACGGATTCT CTGAAGTTCG GTCCAGAATG GTTACGCAAT 
    TTGGCAGGAG ATGGATGCAG TGGAGGCGGA GGCGGAAGTC TCACAATTCC TCGGTATCAG
    TTGGCGGAGC ATAGATACGG TCGAGAAGAG ATGCTTGCTC TTTTTGATCG TATGTGTAAG
    CCTCCAGAGC CATTGTCAAG TTTTACAGCG CTTTATATAC CAAAAGCTCA GCTACCATTG
    GCATTAATAC AAATGACAGA GGAAGAAACA TGTTTATGGA GTGGGGGAGG TGGAAATAAT
    AGTGCTAGTC GTGGTAGAGG TGGTAGTGTC GATCGTGGAG GGCGGAATAG AAGTGGAAGA
    ACGGGCGGTC ATTATCGTGG TGTGGGCTTT GAAGATATGG GAGAAGGTCC AAGAATTGAA
    ACACAATCAT TTCCGGTGCG AACCAGAGCA TTTGATAGAC CTCCAAGTGA ACGTACCTGG
    TCAGAACGAA ACGGAGTAGA TCCGGCTGAG TGGAACGGGT CAACTAGTCC TAGAAAGGAT
    GTGAGTCGTG CTTTAAGTGG CAATTCTCTT ATGGAAAGTA ATTGGAGGCG CAATCGAGGT
    GGTGGAGGAA ATGACGATGG TTGGCGATTG AATAAAGCAA GAGCTGAAAA ATGGACTAAA
    GAGAGTTGGC GTGATGCTGA TAAAGAACGA GACGAAAAAA TAGATGGCGA TGAAGATAAA
    AAGAGAGAAC GTTGGGATCA TAAAGGGAGT AATAGAGCGT TTGATTCTCA TCCACCTCCA
    TTACGTAAAA ATCGTTCAAA TCATCATGAT AATCACGATA ATCTACCAGA ATGGGCGACC
    GAAAATCCCA GTGAAAGTGG TGGTAGTTTC GATGCCTCCG GAGCATTTCA TGGCATGTAC
    TCAGATGACG ATGAGGAGCA TCCAGATCGA GTGCATCACG ATAGAAAGCA ACGGGGCTCA
    CGAATACGTC GTGTTTCGGA GGGTAATGCT TCACAGTATA AAAATGGTGT AAGATCGGCT
    CCCATTATTA GTCGGTCAAC AAAATTCGAC CGGGCATTAA ACGGTGAACG GCCAAAGTCC
    TTGCATGCTG AATCTGAAGA TCAAATTTTA CCACCAGAGA AGGAGACGAG ACGTAGTTTA
    TCACCAATAA AGTTAACATC AGTTTCCAGT AGTCCCTCTA TTAAAAAGAC CTCGTCCACG
    ACGAATAATA ACACTAGTCA AACTGTTAGT AGTAGTCAAC CAGCGACGAA CTCCATCGAT
    TCGAGGAAGA AAGATAAAGG AACAAAGCAA TTAATACAAG AAAAACCTCA GAAGAATTCA
    CCACAGACGA CCACTACAAA TGTGCCAGTT TCTAAAGCCA AATCGAAAAT AGAAAGCCCA
    ATGAAAATAG ATGATCCAAA ACCTAAAACC GAGCGCAATA AAACATCCAG TAAAGCAGAG
    AACGCCAACA AACTTGAATT GCGAAAGCCC GTGGAGCCGA CGAAAATCAA AATATCAAAT
    ATTCCACAGC AACAACAGCA ACAACAACAA CAACAACAAC AACAACAACA GCAACAACCG
    CTACAATCAA TACCTCAGCG AGTTCCTGCG GATGTGGGTG TCAACATAAT ACAGCGGCAA
    GAGCAAACGG ACGACAAACA GAGAACAGAA ACAGACAACT TGGATAGGAT GGAGGAAGAG
    GTCGCAAAAC TCATTGATGG CGGAAGTCCT CGAGACGAAA AGCCAGCATC GAGTGTTCTG
    TCTTCGTCGG CGGTCGTCGT AAATCAAACG GTTATCGAGT CGACAATACC GCCAGGCACA
    CAGACCACTA CAGTTATACA AGAGAAATGG TATTATAGGG ATCCGCAGGG CGAGGTTCAG
    GGTCCTTTCC TTGCCAGCGA GATGGGCGAG TGGCATAAAC AGGGCTACTT TACACCAAAT
    TTACTGCTCA GGAGAACCTG CGACGAGAGA TACACAACGC TTGGCGACCT CATAAATTTG
    TGTGGCAGAG TACCATTTAA ACCAGGCACC AATTTCCCTC CACTCAAGCT CTCCGATATG
    AGAATGTCGC CGAGTGTTGT TGGAGCGGTG CCGAACACTA TGCCAGTACC CGGTGGCTTG
    CCCAAACCGA CCCCCATCGA TGATCCGCTA CTCCTGTATC AGTACCAGCA ATACCGACTC
    CTGCAGAATC AGCAGATGTT CTTGAAGCAG TTGCGTGCGA GTGCCATTGG TAAGCTGTCT
    CAGTCGGAGC AGTGGGCGAA CCTCAGCCCC GTCGAGCAAA ATCAGCTGGT ATTGCAATAT
    GTGAGATCGA TCGATTCGGA AATATCGGAG ATGCCACAAT CCCAGCCGCC GGCTGTCCCA
    AGTACTTTTA TACCTACGAT GCCGCAACCG GCACCACCTT CGAGCTCGGT ACTGCAAATC
    TTTCCCCAAC TTCATCAGGC AGCAAAAAGT CATCCAGAAC CAGCGCACGT ACCCGCGCCC
    AGTCCCCATA TGTCTACTGG TGCAATAGAT CCGATCCAGC AACTGATGCA ACAAATGAGC
    GGCATGCGAA ATTTGCCGCC CTTACCGCAG TCGACGATCG TTCCAAGTCC CCCACAGCCA
    CAACCCCAGC ACCAGCCCCA ACCGCTACCC CAACCCCAGG ACGACAATCC GATAAAATCC
    TGGCTTAGGC AGCTCGCCGT CAATAGCAGT GGACATATTC AGCAACAACC CCAGCTGCAG
    ACTCAGATCG AGTCAGTATG GCATCAACCA CCGCCTCATC TTACGTCCTT TAACGCGCAA
    AATTGGATGA CGCAGGTTGG TGCGATTCAA CCAACAGTAC CTCCTGGCCA ACTGCCTGGC
    TCATTATGGG ATATTCATCC TAAGGATATG AAGACAGAGC AACAAATATT GGAGGAACAG
    AATCTAAAAA TGCAAGAAGA AAAAAAGAAA GAGGAGCTGC GGAAGAAAGA AGAATTAGAA
    AGACAAAAGG TCGAACAAGA ACGCGTTAAA CGTCAGCAAG AGGAAGAATT AGCAAGATTG
    AAAGCAGCTG AGGAAGCGGC AAAGCGAGAA GAGGCCGAGA GAAAGAAACG TGATGAGGAG
    AAAAGACGTC TTGAAGAAAT AAAGCATAAG CAGGAAGAAG AGCGGAGAAA ACTGGAAGAA
    AGGCGACGTA AGGAAGAGGA GAGGAAACGC GAGGAAAAGC GAAAACAGGA TGAAGAGCTG
    AATAGGAAAA AGCAAGAAGA GGAAAAGAGA AAACGCGAGG AAGCCCAGAG ACAGGAGGAA
    AAATTAAGAA GAGAGGAGGA ACAAAGAAAA AAATTGGAAG AAGAGCAGAA GAGGCAGGAA
    GAAGAAAGAT TAAGAAAAGA GGAAGAGGCC CGTAAGAAAT CCGAGGCCGA GGAACAAGCG
    AGAAAAGCCG AGCAAAGACG AAGAGAGGCT GAGGCGCTTC GGAAATTACA AGAACGCAGT
    AAGGCTCCCT GGGCTCAAGC TCCTCCTGCA CCCCCACCAA CTGCCCAAGC CTCTCTAGCC
    GAGATTCAAA GGCTTGAAAG AGAAAAGAAG GCTGAAGATT TGCGGCTTCA GCAGTTGCTA
    CAACAGCAGC AATTGGCCCA GCAGAAGGCA GCCGAAGCAG CTCAGGAAGC ACTTACAGAT
    TCTGCCAAAC GTTTGCAATT TAAATGGGCC GAAAAGGCCG CTCCCATTAA TAATATGAAT
    CAGGTGAAGA GCCTCGCCCA AATTCAACAG GAAGAGCAGG AGAGAGTCGC CAAAGTTAAG
    CATCAAGAAA GAGAAAGACA AGAAAAAGAG AAGGCCAGTC AGAAAGAGGC AACTATTACA
    CTGCAAAATG TCAGTATTTG GGGTACGGCA TCTCAGAGTT TAAATTGGTC AAACACTTCA
    AACTCTAGTA ACCAAATTTA TGGAGCTGGT GGGGGCTTTT GGGATGATTT GACTCCAAAA
    GTTAACACCA TTGCTCCAAA AATGGTTAAC GCCGTAAGTT CTAAGACATC GATAAAGCAA
    CAGACGACCG CCGCCAAATT ATCTCCTCAG CAGAATCAGC ATCAGCATCA GCATCAGCAT
    CAGCAGCAGC AGCAGCAGCA GCAGCAAAAT AATAAAATGG TGAAGAATAA AAACAAAAAG
    GAAGAGGAAT TGGTGAAGAA GCTTTTTGAA CAAAATACTG CCAAAACTGA TGATTTCACC
    CAATGGTGTA ACAAAGCTTT GACTGGTCTT CAAGTATCAG TAGATATACC TACTTTTATT
    GGCTTCTTAC GCGACATTGA AGCAGCATAT GAAGTTAAAG AATATGTACG TATGTACTTG
    GGCGATGGTA AACAATGTTC TGAATTCGCT AAGCAGTTTT TAGAAAAAAG AAGTAAATGG
    AAATCGTCTC AGCGGCCACA GACACACGCA GATGATTTAT GTAAGCCAGC TCCTGCTGTT
    AATCCAAATA CTTCAACGGA ATTTCAAGAA GTAAAGAATA AATCCAAAAA ACCGAAGAAA
    GGCAAAATGT TTAAAGTAGA TAGTAAAATG CTCGGTTTCA GTGTTATGTC TGCCCCAGAT
    CGCATCAATG TCGGAGATCG TGATTATGCA GAAGGCGTAT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011495418.1
    CDS21..4562
    Translation

    Target ORF information:

    RefSeq Version XM_011497116.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali PERQ amino acid-rich with GYF domain-containing protein 2-like (LOC105360263), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011497116.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    ATGCAGAGTT CTAGCATCAT GACGGATTCT CTGAAGTTCG GTCCAGAATG GTTACGCAAT 
    TTGGCAGGAG ATGGATGCAG TGGAGGCGGA GGCGGAAGTC TCACAATTCC TCGGTATCAG
    TTGGCGGAGC ATAGATACGG TCGAGAAGAG ATGCTTGCTC TTTTTGATCG TATGTGTAAG
    CCTCCAGAGC CATTGTCAAG TTTTACAGCG CTTTATATAC CAAAAGCTCA GCTACCATTG
    GCATTAATAC AAATGACAGA GGAAGAAACA TGTTTATGGA GTGGGGGAGG TGGAAATAAT
    AGTGCTAGTC GTGGTAGAGG TGGTAGTGTC GATCGTGGAG GGCGGAATAG AAGTGGAAGA
    ACGGGCGGTC ATTATCGTGG TGTGGGCTTT GAAGATATGG GAGAAGGTCC AAGAATTGAA
    ACACAATCAT TTCCGGTGCG AACCAGAGCA TTTGATAGAC CTCCAAGTGA ACGTACCTGG
    TCAGAACGAA ACGGAGTAGA TCCGGCTGAG TGGAACGGGT CAACTAGTCC TAGAAAGGAT
    GTGAGTCGTG CTTTAAGTGG CAATTCTCTT ATGGAAAGTA ATTGGAGGCG CAATCGAGGT
    GGTGGAGGAA ATGACGATGG TTGGCGATTG AATAAAGCAA GAGCTGAAAA ATGGACTAAA
    GAGAGTTGGC GTGATGCTGA TAAAGAACGA GACGAAAAAA TAGATGGCGA TGAAGATAAA
    AAGAGAGAAC GTTGGGATCA TAAAGGGAGT AATAGAGCGT TTGATTCTCA TCCACCTCCA
    TTACGTAAAA ATCGTTCAAA TCATCATGAT AATCACGATA ATCTACCAGA ATGGGCGACC
    GAAAATCCCA GTGAAAGTGG TGGTAGTTTC GATGCCTCCG GAGCATTTCA TGGCATGTAC
    TCAGATGACG ATGAGGAGCA TCCAGATCGA GTGCATCACG ATAGAAAGCA ACGGGGCTCA
    CGAATACGTC GTGTTTCGGA GGGTAATGCT TCACAGTATA AAAATGGTGT AAGATCGGCT
    CCCATTATTA GTCGGTCAAC AAAATTCGAC CGGGCATTAA ACGGTGAACG GCCAAAGTCC
    TTGCATGCTG AATCTGAAGA TCAAATTTTA CCACCAGAGA AGGAGACGAG ACGTAGTTTA
    TCACCAATAA AGTTAACATC AGTTTCCAGT AGTCCCTCTA TTAAAAAGAC CTCGTCCACG
    ACGAATAATA ACACTAGTCA AACTGTTAGT AGTAGTCAAC CAGCGACGAA CTCCATCGAT
    TCGAGGAAGA AAGATAAAGG AACAAAGCAA TTAATACAAG AAAAACCTCA GAAGAATTCA
    CCACAGACGA CCACTACAAA TGTGCCAGTT TCTAAAGCCA AATCGAAAAT AGAAAGCCCA
    ATGAAAATAG ATGATCCAAA ACCTAAAACC GAGCGCAATA AAACATCCAG TAAAGCAGAG
    AACGCCAACA AACTTGAATT GCGAAAGCCC GTGGAGCCGA CGAAAATCAA AATATCAAAT
    ATTCCACAGC AACAACAGCA ACAACAACAA CAACAACAAC AACAACAACA GCAACAACCG
    CTACAATCAA TACCTCAGCG AGTTCCTGCG GATGTGGGTG TCAACATAAT ACAGCGGCAA
    GAGCAAACGG ACGACAAACA GAGAACAGAA ACAGACAACT TGGATAGGAT GGAGGAAGAG
    GTCGCAAAAC TCATTGATGG CGGAAGTCCT CGAGACGAAA AGCCAGCATC GAGTGTTCTG
    TCTTCGTCGG CGGTCGTCGT AAATCAAACG GTTATCGAGT CGACAATACC GCCAGGCACA
    CAGACCACTA CAGTTATACA AGAGAAATGG TATTATAGGG ATCCGCAGGG CGAGGTTCAG
    GGTCCTTTCC TTGCCAGCGA GATGGGCGAG TGGCATAAAC AGGGCTACTT TACACCAAAT
    TTACTGCTCA GGAGAACCTG CGACGAGAGA TACACAACGC TTGGCGACCT CATAAATTTG
    TGTGGCAGAG TACCATTTAA ACCAGGCACC AATTTCCCTC CACTCAAGCT CTCCGATATG
    AGAATGTCGC CGAGTGTTGT TGGAGCGGTG CCGAACACTA TGCCAGTACC CGGTGGCTTG
    CCCAAACCGA CCCCCATCGA TGATCCGCTA CTCCTGTATC AGTACCAGCA ATACCGACTC
    CTGCAGAATC AGCAGATGTT CTTGAAGCAG TTGCGTGCGA GTGCCATTGG TAAGCTGTCT
    CAGTCGGAGC AGTGGGCGAA CCTCAGCCCC GTCGAGCAAA ATCAGCTGGT ATTGCAATAT
    GTGAGATCGA TCGATTCGGA AATATCGGAG ATGCCACAAT CCCAGCCGCC GGCTGTCCCA
    AGTACTTTTA TACCTACGAT GCCGCAACCG GCACCACCTT CGAGCTCGGT ACTGCAAATC
    TTTCCCCAAC TTCATCAGGC AGCAAAAAGT CATCCAGAAC CAGCGCACGT ACCCGCGCCC
    AGTCCCCATA TGTCTACTGG TGCAATAGAT CCGATCCAGC AACTGATGCA ACAAATGAGC
    GGCATGCGAA ATTTGCCGCC CTTACCGCAG TCGACGATCG TTCCAAGTCC CCCACAGCCA
    CAACCCCAGC ACCAGCCCCA ACCGCTACCC CAACCCCAGG ACGACAATCC GATAAAATCC
    TGGCTTAGGC AGCTCGCCGT CAATAGCAGT GGACATATTC AGCAACAACC CCAGCTGCAG
    ACTCAGATCG AGTCAGTATG GCATCAACCA CCGCCTCATC TTACGTCCTT TAACGCGCAA
    AATTGGATGA CGCAGGTTGG TGCGATTCAA CCAACAGTAC CTCCTGGCCA ACTGCCTGGC
    TCATTATGGG ATATTCATCC TAAGGATATG AAGACAGAGC AACAAATATT GGAGGAACAG
    AATCTAAAAA TGCAAGAAGA AAAAAAGAAA GAGGAGCTGC GGAAGAAAGA AGAATTAGAA
    AGACAAAAGG TCGAACAAGA ACGCGTTAAA CGTCAGCAAG AGGAAGAATT AGCAAGATTG
    AAAGCAGCTG AGGAAGCGGC AAAGCGAGAA GAGGCCGAGA GAAAGAAACG TGATGAGGAG
    AAAAGACGTC TTGAAGAAAT AAAGCATAAG CAGGAAGAAG AGCGGAGAAA ACTGGAAGAA
    AGGCGACGTA AGGAAGAGGA GAGGAAACGC GAGGAAAAGC GAAAACAGGA TGAAGAGCTG
    AATAGGAAAA AGCAAGAAGA GGAAAAGAGA AAACGCGAGG AAGCCCAGAG ACAGGAGGAA
    AAATTAAGAA GAGAGGAGGA ACAAAGAAAA AAATTGGAAG AAGAGCAGAA GAGGCAGGAA
    GAAGAAAGAT TAAGAAAAGA GGAAGAGGCC CGTAAGAAAT CCGAGGCCGA GGAACAAGCG
    AGAAAAGCCG AGCAAAGACG AAGAGAGGCT GAGGCGCTTC GGAAATTACA AGAACGCAGT
    AAGGCTCCCT GGGCTCAAGC TCCTCCTGCA CCCCCACCAA CTGCCCAAGC CTCTCTAGCC
    GAGATTCAAA GGCTTGAAAG AGAAAAGAAG GCTGAAGATT TGCGGCTTCA GCAGTTGCTA
    CAACAGCAGC AATTGGCCCA GCAGAAGGCA GCCGAAGCAG CTCAGGAAGC ACTTACAGAT
    TCTGCCAAAC GTTTGCAATT TAAATGGGCC GAAAAGGCCG CTCCCATTAA TAATATGAAT
    CAGGTGAAGA GCCTCGCCCA AATTCAACAG GAAGAGCAGG AGAGAGTCGC CAAAGTTAAG
    CATCAAGAAA GAGAAAGACA AGAAAAAGAG AAGGCCAGTC AGAAAGAGGC AACTATTACA
    CTGCAAAATG TCAGTATTTG GGGTACGGCA TCTCAGAGTT TAAATTGGTC AAACACTTCA
    AACTCTAGTA ACCAAATTTA TGGAGCTGGT GGGGGCTTTT GGGATGATTT GACTCCAAAA
    GTTAACACCA TTGCTCCAAA AATGGTTAAC GCCGTAAGTT CTAAGACATC GATAAAGCAA
    CAGACGACCG CCGCCAAATT ATCTCCTCAG CAGAATCAGC ATCAGCATCA GCATCAGCAT
    CAGCAGCAGC AGCAGCAGCA GCAGCAAAAT AATAAAATGG TGAAGAATAA AAACAAAAAG
    GAAGAGGAAT TGGTGAAGAA GCTTTTTGAA CAAAATACTG CCAAAACTGA TGATTTCACC
    CAATGGTGTA ACAAAGCTTT GACTGGTCTT CAAGTATCAG TAGATATACC TACTTTTATT
    GGCTTCTTAC GCGACATTGA AGCAGCATAT GAAGTTAAAG AATATGTACG TATGTACTTG
    GGCGATGGTA AACAATGTTC TGAATTCGCT AAGCAGTTTT TAGAAAAAAG AAGTAAATGG
    AAATCGTCTC AGCGGCCACA GACACACGCA GATGATTTAT GTAAGCCAGC TCCTGCTGTT
    AATCCAAATA CTTCAACGGA ATTTCAAGAA GTAAAGAATA AATCCAAAAA ACCGAAGAAA
    GGCAAAATGT TTAAAGTAGA TAGTAAAATG CTCGGTTTCA GTGTTATGTC TGCCCCAGAT
    CGCATCAATG TCGGAGATCG TGATTATGCA GAAGGCGTAT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCe195886
    Clone ID Related Accession (Same CDS sequence) XM_011497117.1
    Accession Version XM_011497117.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4536bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product PERQ amino acid-rich with GYF domain-containing protein CG11148-like isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948418.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    ATGACGGATT CTCTGAAGTT CGGTCCAGAA TGGTTACGCA ATTTGGCAGG AGATGGATGC 
    AGTGGAGGCG GAGGCGGAAG TCTCACAATT CCTCGGTATC AGTTGGCGGA GCATAGATAC
    GGTCGAGAAG AGATGCTTGC TCTTTTTGAT CGTATGTGTA AGCCTCCAGA GCCATTGTCA
    AGTTTTACAG CGCTTTATAT ACCAAAAGCT CAGCTACCAT TGGCATTAAT ACAAATGACA
    GAGGAAGAAA CATGTTTATG GAGTGGGGGA GGTGGAAATA ATAGTGCTAG TCGTGGTAGA
    GGTGGTAGTG TCGATCGTGG AGGGCGGAAT AGAAGTGGAA GAACGGGCGG TCATTATCGT
    GGTGTGGGCT TTGAAGATAT GGGAGAAGGT CCAAGAATTG AAACACAATC ATTTCCGGTG
    CGAACCAGAG CATTTGATAG ACCTCCAAGT GAACGTACCT GGTCAGAACG AAACGGAGTA
    GATCCGGCTG AGTGGAACGG GTCAACTAGT CCTAGAAAGG ATGTGAGTCG TGCTTTAAGT
    GGCAATTCTC TTATGGAAAG TAATTGGAGG CGCAATCGAG GTGGTGGAGG AAATGACGAT
    GGTTGGCGAT TGAATAAAGC AAGAGCTGAA AAATGGACTA AAGAGAGTTG GCGTGATGCT
    GATAAAGAAC GAGACGAAAA AATAGATGGC GATGAAGATA AAAAGAGAGA ACGTTGGGAT
    CATAAAGGGA GTAATAGAGC GTTTGATTCT CATCCACCTC CATTACGTAA AAATCGTTCA
    AATCATCATG ATAATCACGA TAATCTACCA GAATGTGAGT TTTACAGGGC GACCGAAAAT
    CCCAGTGAAA GTGGTGGTAG TTTCGATGCC TCCGGAGCAT TTCATGGCAT GTACTCAGAT
    GACGATGAGG AGCATCCAGA TCGAGTGCAT CACGATAGAA AGCAACGGGG CTCACGAATA
    CGTCGTGTTT CGGAGGGTAA TGCTTCACAG TATAAAAATG GTGTAAGATC GGCTCCCATT
    ATTAGTCGGT CAACAAAATT CGACCGGGCA TTAAACGGTG AACGGCCAAA GTCCTTGCAT
    GCTGAATCTG AAGATCAAAT TTTACCACCA GAGAAGGAGA CGAGACGTAG TTTATCACCA
    ATAAAGTTAA CATCAGTTTC CAGTAGTCCC TCTATTAAAA AGACCTCGTC CACGACGAAT
    AATAACACTA GTCAAACTGT TAGTAGTAGT CAACCAGCGA CGAACTCCAT CGATTCGAGG
    AAGAAAGATA AAGGAACAAA GCAATTAATA CAAGAAAAAC CTCAGAAGAA TTCACCACAG
    ACGACCACTA CAAATGTGCC AGTTTCTAAA GCCAAATCGA AAATAGAAAG CCCAATGAAA
    ATAGATGATC CAAAACCTAA AACCGAGCGC AATAAAACAT CCAGTAAAGC AGAGAACGCC
    AACAAACTTG AATTGCGAAA GCCCGTGGAG CCGACGAAAA TCAAAATATC AAATATTCCA
    CAGCAACAAC AGCAACAACA ACAACAACAA CAACAACAAC AACAGCAACA ACCGCTACAA
    TCAATACCTC AGCGAGTTCC TGCGGATGTG GGTGTCAACA TAATACAGCG GCAAGAGCAA
    ACGGACGACA AACAGAGAAC AGAAACAGAC AACTTGGATA GGATGGAGGA AGAGGTCGCA
    AAACTCATTG ATGGCGGAAG TCCTCGAGAC GAAAAGCCAG CATCGAGTGT TCTGTCTTCG
    TCGGCGGTCG TCGTAAATCA AACGGTTATC GAGTCGACAA TACCGCCAGG CACACAGACC
    ACTACAGTTA TACAAGAGAA ATGGTATTAT AGGGATCCGC AGGGCGAGGT TCAGGGTCCT
    TTCCTTGCCA GCGAGATGGG CGAGTGGCAT AAACAGGGCT ACTTTACACC AAATTTACTG
    CTCAGGAGAA CCTGCGACGA GAGATACACA ACGCTTGGCG ACCTCATAAA TTTGTGTGGC
    AGAGTACCAT TTAAACCAGG CACCAATTTC CCTCCACTCA AGCTCTCCGA TATGAGAATG
    TCGCCGAGTG TTGTTGGAGC GGTGCCGAAC ACTATGCCAG TACCCGGTGG CTTGCCCAAA
    CCGACCCCCA TCGATGATCC GCTACTCCTG TATCAGTACC AGCAATACCG ACTCCTGCAG
    AATCAGCAGA TGTTCTTGAA GCAGTTGCGT GCGAGTGCCA TTGGTAAGCT GTCTCAGTCG
    GAGCAGTGGG CGAACCTCAG CCCCGTCGAG CAAAATCAGC TGGTATTGCA ATATGTGAGA
    TCGATCGATT CGGAAATATC GGAGATGCCA CAATCCCAGC CGCCGGCTGT CCCAAGTACT
    TTTATACCTA CGATGCCGCA ACCGGCACCA CCTTCGAGCT CGGTACTGCA AATCTTTCCC
    CAACTTCATC AGGCAGCAAA AAGTCATCCA GAACCAGCGC ACGTACCCGC GCCCAGTCCC
    CATATGTCTA CTGGTGCAAT AGATCCGATC CAGCAACTGA TGCAACAAAT GAGCGGCATG
    CGAAATTTGC CGCCCTTACC GCAGTCGACG ATCGTTCCAA GTCCCCCACA GCCACAACCC
    CAGCACCAGC CCCAACCGCT ACCCCAACCC CAGGACGACA ATCCGATAAA ATCCTGGCTT
    AGGCAGCTCG CCGTCAATAG CAGTGGACAT ATTCAGCAAC AACCCCAGCT GCAGACTCAG
    ATCGAGTCAG TATGGCATCA ACCACCGCCT CATCTTACGT CCTTTAACGC GCAAAATTGG
    ATGACGCAGG TTGGTGCGAT TCAACCAACA GTACCTCCTG GCCAACTGCC TGGCTCATTA
    TGGGATATTC ATCCTAAGGA TATGAAGACA GAGCAACAAA TATTGGAGGA ACAGAATCTA
    AAAATGCAAG AAGAAAAAAA GAAAGAGGAG CTGCGGAAGA AAGAAGAATT AGAAAGACAA
    AAGGTCGAAC AAGAACGCGT TAAACGTCAG CAAGAGGAAG AATTAGCAAG ATTGAAAGCA
    GCTGAGGAAG CGGCAAAGCG AGAAGAGGCC GAGAGAAAGA AACGTGATGA GGAGAAAAGA
    CGTCTTGAAG AAATAAAGCA TAAGCAGGAA GAAGAGCGGA GAAAACTGGA AGAAAGGCGA
    CGTAAGGAAG AGGAGAGGAA ACGCGAGGAA AAGCGAAAAC AGGATGAAGA GCTGAATAGG
    AAAAAGCAAG AAGAGGAAAA GAGAAAACGC GAGGAAGCCC AGAGACAGGA GGAAAAATTA
    AGAAGAGAGG AGGAACAAAG AAAAAAATTG GAAGAAGAGC AGAAGAGGCA GGAAGAAGAA
    AGATTAAGAA AAGAGGAAGA GGCCCGTAAG AAATCCGAGG CCGAGGAACA AGCGAGAAAA
    GCCGAGCAAA GACGAAGAGA GGCTGAGGCG CTTCGGAAAT TACAAGAACG CAGTAAGGCT
    CCCTGGGCTC AAGCTCCTCC TGCACCCCCA CCAACTGCCC AAGCCTCTCT AGCCGAGATT
    CAAAGGCTTG AAAGAGAAAA GAAGGCTGAA GATTTGCGGC TTCAGCAGTT GCTACAACAG
    CAGCAATTGG CCCAGCAGAA GGCAGCCGAA GCAGCTCAGG AAGCACTTAC AGATTCTGCC
    AAACGTTTGC AATTTAAATG GGCCGAAAAG GCCGCTCCCA TTAATAATAT GAATCAGGTG
    AAGAGCCTCG CCCAAATTCA ACAGGAAGAG CAGGAGAGAG TCGCCAAAGT TAAGCATCAA
    GAAAGAGAAA GACAAGAAAA AGAGAAGGCC AGTCAGAAAG AGGCAACTAT TACACTGCAA
    AATGTCAGTA TTTGGGGTAC GGCATCTCAG AGTTTAAATT GGTCAAACAC TTCAAACTCT
    AGTAACCAAA TTTATGGAGC TGGTGGGGGC TTTTGGGATG ATTTGACTCC AAAAGTTAAC
    ACCATTGCTC CAAAAATGGT TAACGCCGTA AGTTCTAAGA CATCGATAAA GCAACAGACG
    ACCGCCGCCA AATTATCTCC TCAGCAGAAT CAGCATCAGC ATCAGCATCA GCATCAGCAG
    CAGCAGCAGC AGCAGCAGCA AAATAATAAA ATGGTGAAGA ATAAAAACAA AAAGGAAGAG
    GAATTGGTGA AGAAGCTTTT TGAACAAAAT ACTGCCAAAA CTGATGATTT CACCCAATGG
    TGTAACAAAG CTTTGACTGG TCTTCAAGTA TCAGTAGATA TACCTACTTT TATTGGCTTC
    TTACGCGACA TTGAAGCAGC ATATGAAGTT AAAGAATATG TACGTATGTA CTTGGGCGAT
    GGTAAACAAT GTTCTGAATT CGCTAAGCAG TTTTTAGAAA AAAGAAGTAA ATGGAAATCG
    TCTCAGCGGC CACAGACACA CGCAGATGAT TTATGTAAGC CAGCTCCTGC TGTTAATCCA
    AATACTTCAA CGGAATTTCA AGAAGTAAAG AATAAATCCA AAAAACCGAA GAAAGGCAAA
    ATGTTTAAAG TAGATAGTAA AATGCTCGGT TTCAGTGTTA TGTCTGCCCC AGATCGCATC
    AATGTCGGAG ATCGTGATTA TGCAGAAGGC GTATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_011495419.1
    CDS154..4689
    Translation

    Target ORF information:

    RefSeq Version XM_011497117.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali PERQ amino acid-rich with GYF domain-containing protein 2-like (LOC105360263), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011497117.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    ATGACGGATT CTCTGAAGTT CGGTCCAGAA TGGTTACGCA ATTTGGCAGG AGATGGATGC 
    AGTGGAGGCG GAGGCGGAAG TCTCACAATT CCTCGGTATC AGTTGGCGGA GCATAGATAC
    GGTCGAGAAG AGATGCTTGC TCTTTTTGAT CGTATGTGTA AGCCTCCAGA GCCATTGTCA
    AGTTTTACAG CGCTTTATAT ACCAAAAGCT CAGCTACCAT TGGCATTAAT ACAAATGACA
    GAGGAAGAAA CATGTTTATG GAGTGGGGGA GGTGGAAATA ATAGTGCTAG TCGTGGTAGA
    GGTGGTAGTG TCGATCGTGG AGGGCGGAAT AGAAGTGGAA GAACGGGCGG TCATTATCGT
    GGTGTGGGCT TTGAAGATAT GGGAGAAGGT CCAAGAATTG AAACACAATC ATTTCCGGTG
    CGAACCAGAG CATTTGATAG ACCTCCAAGT GAACGTACCT GGTCAGAACG AAACGGAGTA
    GATCCGGCTG AGTGGAACGG GTCAACTAGT CCTAGAAAGG ATGTGAGTCG TGCTTTAAGT
    GGCAATTCTC TTATGGAAAG TAATTGGAGG CGCAATCGAG GTGGTGGAGG AAATGACGAT
    GGTTGGCGAT TGAATAAAGC AAGAGCTGAA AAATGGACTA AAGAGAGTTG GCGTGATGCT
    GATAAAGAAC GAGACGAAAA AATAGATGGC GATGAAGATA AAAAGAGAGA ACGTTGGGAT
    CATAAAGGGA GTAATAGAGC GTTTGATTCT CATCCACCTC CATTACGTAA AAATCGTTCA
    AATCATCATG ATAATCACGA TAATCTACCA GAATGTGAGT TTTACAGGGC GACCGAAAAT
    CCCAGTGAAA GTGGTGGTAG TTTCGATGCC TCCGGAGCAT TTCATGGCAT GTACTCAGAT
    GACGATGAGG AGCATCCAGA TCGAGTGCAT CACGATAGAA AGCAACGGGG CTCACGAATA
    CGTCGTGTTT CGGAGGGTAA TGCTTCACAG TATAAAAATG GTGTAAGATC GGCTCCCATT
    ATTAGTCGGT CAACAAAATT CGACCGGGCA TTAAACGGTG AACGGCCAAA GTCCTTGCAT
    GCTGAATCTG AAGATCAAAT TTTACCACCA GAGAAGGAGA CGAGACGTAG TTTATCACCA
    ATAAAGTTAA CATCAGTTTC CAGTAGTCCC TCTATTAAAA AGACCTCGTC CACGACGAAT
    AATAACACTA GTCAAACTGT TAGTAGTAGT CAACCAGCGA CGAACTCCAT CGATTCGAGG
    AAGAAAGATA AAGGAACAAA GCAATTAATA CAAGAAAAAC CTCAGAAGAA TTCACCACAG
    ACGACCACTA CAAATGTGCC AGTTTCTAAA GCCAAATCGA AAATAGAAAG CCCAATGAAA
    ATAGATGATC CAAAACCTAA AACCGAGCGC AATAAAACAT CCAGTAAAGC AGAGAACGCC
    AACAAACTTG AATTGCGAAA GCCCGTGGAG CCGACGAAAA TCAAAATATC AAATATTCCA
    CAGCAACAAC AGCAACAACA ACAACAACAA CAACAACAAC AACAGCAACA ACCGCTACAA
    TCAATACCTC AGCGAGTTCC TGCGGATGTG GGTGTCAACA TAATACAGCG GCAAGAGCAA
    ACGGACGACA AACAGAGAAC AGAAACAGAC AACTTGGATA GGATGGAGGA AGAGGTCGCA
    AAACTCATTG ATGGCGGAAG TCCTCGAGAC GAAAAGCCAG CATCGAGTGT TCTGTCTTCG
    TCGGCGGTCG TCGTAAATCA AACGGTTATC GAGTCGACAA TACCGCCAGG CACACAGACC
    ACTACAGTTA TACAAGAGAA ATGGTATTAT AGGGATCCGC AGGGCGAGGT TCAGGGTCCT
    TTCCTTGCCA GCGAGATGGG CGAGTGGCAT AAACAGGGCT ACTTTACACC AAATTTACTG
    CTCAGGAGAA CCTGCGACGA GAGATACACA ACGCTTGGCG ACCTCATAAA TTTGTGTGGC
    AGAGTACCAT TTAAACCAGG CACCAATTTC CCTCCACTCA AGCTCTCCGA TATGAGAATG
    TCGCCGAGTG TTGTTGGAGC GGTGCCGAAC ACTATGCCAG TACCCGGTGG CTTGCCCAAA
    CCGACCCCCA TCGATGATCC GCTACTCCTG TATCAGTACC AGCAATACCG ACTCCTGCAG
    AATCAGCAGA TGTTCTTGAA GCAGTTGCGT GCGAGTGCCA TTGGTAAGCT GTCTCAGTCG
    GAGCAGTGGG CGAACCTCAG CCCCGTCGAG CAAAATCAGC TGGTATTGCA ATATGTGAGA
    TCGATCGATT CGGAAATATC GGAGATGCCA CAATCCCAGC CGCCGGCTGT CCCAAGTACT
    TTTATACCTA CGATGCCGCA ACCGGCACCA CCTTCGAGCT CGGTACTGCA AATCTTTCCC
    CAACTTCATC AGGCAGCAAA AAGTCATCCA GAACCAGCGC ACGTACCCGC GCCCAGTCCC
    CATATGTCTA CTGGTGCAAT AGATCCGATC CAGCAACTGA TGCAACAAAT GAGCGGCATG
    CGAAATTTGC CGCCCTTACC GCAGTCGACG ATCGTTCCAA GTCCCCCACA GCCACAACCC
    CAGCACCAGC CCCAACCGCT ACCCCAACCC CAGGACGACA ATCCGATAAA ATCCTGGCTT
    AGGCAGCTCG CCGTCAATAG CAGTGGACAT ATTCAGCAAC AACCCCAGCT GCAGACTCAG
    ATCGAGTCAG TATGGCATCA ACCACCGCCT CATCTTACGT CCTTTAACGC GCAAAATTGG
    ATGACGCAGG TTGGTGCGAT TCAACCAACA GTACCTCCTG GCCAACTGCC TGGCTCATTA
    TGGGATATTC ATCCTAAGGA TATGAAGACA GAGCAACAAA TATTGGAGGA ACAGAATCTA
    AAAATGCAAG AAGAAAAAAA GAAAGAGGAG CTGCGGAAGA AAGAAGAATT AGAAAGACAA
    AAGGTCGAAC AAGAACGCGT TAAACGTCAG CAAGAGGAAG AATTAGCAAG ATTGAAAGCA
    GCTGAGGAAG CGGCAAAGCG AGAAGAGGCC GAGAGAAAGA AACGTGATGA GGAGAAAAGA
    CGTCTTGAAG AAATAAAGCA TAAGCAGGAA GAAGAGCGGA GAAAACTGGA AGAAAGGCGA
    CGTAAGGAAG AGGAGAGGAA ACGCGAGGAA AAGCGAAAAC AGGATGAAGA GCTGAATAGG
    AAAAAGCAAG AAGAGGAAAA GAGAAAACGC GAGGAAGCCC AGAGACAGGA GGAAAAATTA
    AGAAGAGAGG AGGAACAAAG AAAAAAATTG GAAGAAGAGC AGAAGAGGCA GGAAGAAGAA
    AGATTAAGAA AAGAGGAAGA GGCCCGTAAG AAATCCGAGG CCGAGGAACA AGCGAGAAAA
    GCCGAGCAAA GACGAAGAGA GGCTGAGGCG CTTCGGAAAT TACAAGAACG CAGTAAGGCT
    CCCTGGGCTC AAGCTCCTCC TGCACCCCCA CCAACTGCCC AAGCCTCTCT AGCCGAGATT
    CAAAGGCTTG AAAGAGAAAA GAAGGCTGAA GATTTGCGGC TTCAGCAGTT GCTACAACAG
    CAGCAATTGG CCCAGCAGAA GGCAGCCGAA GCAGCTCAGG AAGCACTTAC AGATTCTGCC
    AAACGTTTGC AATTTAAATG GGCCGAAAAG GCCGCTCCCA TTAATAATAT GAATCAGGTG
    AAGAGCCTCG CCCAAATTCA ACAGGAAGAG CAGGAGAGAG TCGCCAAAGT TAAGCATCAA
    GAAAGAGAAA GACAAGAAAA AGAGAAGGCC AGTCAGAAAG AGGCAACTAT TACACTGCAA
    AATGTCAGTA TTTGGGGTAC GGCATCTCAG AGTTTAAATT GGTCAAACAC TTCAAACTCT
    AGTAACCAAA TTTATGGAGC TGGTGGGGGC TTTTGGGATG ATTTGACTCC AAAAGTTAAC
    ACCATTGCTC CAAAAATGGT TAACGCCGTA AGTTCTAAGA CATCGATAAA GCAACAGACG
    ACCGCCGCCA AATTATCTCC TCAGCAGAAT CAGCATCAGC ATCAGCATCA GCATCAGCAG
    CAGCAGCAGC AGCAGCAGCA AAATAATAAA ATGGTGAAGA ATAAAAACAA AAAGGAAGAG
    GAATTGGTGA AGAAGCTTTT TGAACAAAAT ACTGCCAAAA CTGATGATTT CACCCAATGG
    TGTAACAAAG CTTTGACTGG TCTTCAAGTA TCAGTAGATA TACCTACTTT TATTGGCTTC
    TTACGCGACA TTGAAGCAGC ATATGAAGTT AAAGAATATG TACGTATGTA CTTGGGCGAT
    GGTAAACAAT GTTCTGAATT CGCTAAGCAG TTTTTAGAAA AAAGAAGTAA ATGGAAATCG
    TCTCAGCGGC CACAGACACA CGCAGATGAT TTATGTAAGC CAGCTCCTGC TGTTAATCCA
    AATACTTCAA CGGAATTTCA AGAAGTAAAG AATAAATCCA AAAAACCGAA GAAAGGCAAA
    ATGTTTAAAG TAGATAGTAA AATGCTCGGT TTCAGTGTTA TGTCTGCCCC AGATCGCATC
    AATGTCGGAG ATCGTGATTA TGCAGAAGGC GTATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.