INTS10 cDNA ORF clone, Taeniopygia guttata(zebra finch)

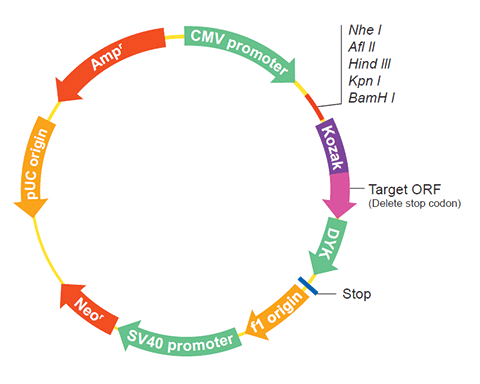
The following INTS10 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the INTS10 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OTd09457 XM_002197551.2
Latest version!
Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 12-14 $426.30
$609.00
OTd17858 XM_012573457.1
Latest version!
Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 12-14 $426.30
$609.00
OTd44767 XM_030271577.1
Latest version!
Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OTd44768 XM_012573457.2
Latest version!
Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OTd44769 XM_030271578.1
Latest version!
Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OTd44770 XM_002197551.3
Latest version!
Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OTd09457
    Clone ID Related Accession (Same CDS sequence) XM_002197551.2
    Accession Version XM_002197551.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2133bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
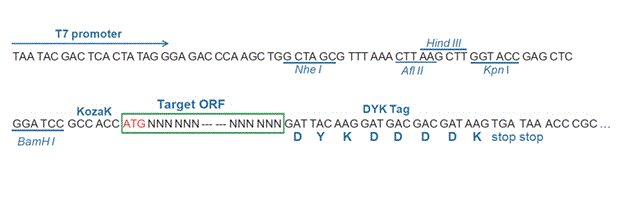
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-05-25
    Organism Taeniopygia guttata(zebra finch)
    Product integrator complex subunit 10 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_002198634.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Feb 12, 2013 this sequence version replaced XM_002197551.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Taeniopygia guttata Annotation Release 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTCGGCGC AGGGGGACTG TGAGTTCCTG GTGAAGCGGG CCCGGGAGCT GGTGCCGGGG 
    GACCTGTGGG CGGCCAAGGC CTGGCTCATC ACGGCGCGGA GCCTCTACCC CGCCGACTTC
    AACATCCAAT ATGAGATGTA CACTATCGAG AGGAATGCTG AAAGGACAGC ATCTGCAGGC
    AGGCTGCTCT ACGACATGTT TGTGAATTTT CCAGACCAAC CTGCTGTATG GAGGGAGATC
    AGCGTTATTA CATCAGCATT AAGGAATGAC TCCCAGGACA AGCAGACACA GTTTTTAAGA
    GGATTATTTG AGACCCTTCC TGGTCGGGTC CAGTGTGAAA TGCTCCTGAA GGCAACAGAG
    CAGTGCTTTA ACACATTAGA AAGGGCAGAA ATGCTCCTTC TGCTTCTGCG GCGTTTCCCA
    GAGACTGTGG TGCAACATGG GGTAGGCCTT GGAGAAACAT TATTAGATTC TGAAAGTATT
    GAAGACCAAG AATCTCCAGT GAATTGTTTT AGAAAATTAT TTGTTTGTGA TGTTCTTCCT
    CTGATAATTA ACAACCCTGA TGTACGACTT CCTGCCAGTT TGTTATATAA ATATCTGAAT
    AAAGCAGCAG AATTTTATAT TAACTACGTA ACTAGATCTA CACAGACAGA AAGTCAATAT
    CAAGGTTCAC AAGATTCCTC TGATATTATG TCTCCAAGCA AGCGCAGCTC TCAGAAATAT
    GTAATAGATG GTCTCACAGA GAAATCATCC CAGATTACAG ATCCTTGGGA GAGGCTGTTT
    AAAATATTGT CCGTGGTGGG AATGAGGTGT GAGTGGCAAA TGGATAAGGG AAGAAGAAGT
    TACGGTGACA TTCTGCATCG AATGAAAGAT CTCTGCAGAT ACATCAGTAA CTTTGATAGT
    GAAGCCCACA TTAAATACAA GAATCAAGTT GTGTATTCCA CGATGTTGGT CTTCTTTAAA
    AATGCTTTTC AGTATGTCAG CAACATCCAG CCATCGCTCT TTCAAGGTCC AAATGCTCCA
    AACCAAACTC CACTGGTTCT TCTCGAGGAT GTACCCAACA TCTATGGTGA TACAGATATT
    GATCGTAACA AACACATACA TAAGAAGAGG AAACTTGCTG AAGGAAGAGA AAAAACAATG
    AGCTCAGATG ACGAGGATCC TTCTGGGAAA GCAAGAAGTC GCCATATTAC AGTAAATAAG
    GCTGATCTTG CAAACTCCAT TGAAGTATTA GAGAGTTTCA AACTGGCAAG AGAGAGCTGG
    GAGCTGCTTT ATTCTCTGGA ATCACTTGAC AAAGAGTTCA CCAGAATTTG TTTGTCATGG
    AAGACAGAAA CTTGGCTTTG GTTAAGAATC TTTCTTACAG ACATGATCAT CTACCAGGGA
    CAATACAAAA AAGCAATTAG CAGCCTACAT CACTTGGCAG CTCTTCAGGG CTCTCATTCT
    CCCCAGCAAA TTACAGGACA AGGATCTTTA GAAAATCAGA GAGCACTAAT CCAGTTAGCA
    TCGTGCCACT TTGCCCTTGG AGAATACCGG CAAACATGTG AAAAAGTGCT CGACCTCATG
    TGCTGTATTT TACTTCCAAT ACAAGAAGGA AGTAAAGTAC AAGAGGAGCA ACCTAAAGTC
    AAGTCAAAAT TCAGGAAAGG GTCTGATTTG AAGCTTTGGC CGTGTACCAG TAGAGCTATC
    ATGCCTTACT GCCTTCATCT GTTGTTAGCT TGTTTCAAGC TCAGAGCTTT CACAGACAGC
    AGAGATGATA TGGCACTGGG CCACGTAGTT GTTCTGCTTC AGCATGAGTG GCCGAGGGGT
    GAGAACTTGT TCCTGAAAGC CATCAACAAA ATCTGCCAGC AAGGAAACTT CCAGTATGAG
    AATTTTTTCA ACTATGTCAC AAATATTGAT ATGTTGGAGG AATTTGCTTA TTTAAGAACA
    CAGGAAGGAG GGAAAATTCA TCTGGAACTG CTGCCAAATC AAGCAATGTT GATCAAGCAC
    CACACAGTTA CCCGGGGTAT AACTAAAGGA GTGAAGGAAG ATTTCCGCCT GGCCATGGAG
    CGCCAGGTCT CGCGCTGTGG GGAAAATCTC ATGGTGGTCT TGCATAGGTT CTGCATTAAT
    GAGAAAATAC TGCTGCTGCA GACTCTTGCT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_002197587.1
    CDS24..2156
    Translation

    Target ORF information:

    RefSeq Version XM_002197551.2
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_002197551.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTCGGCGC AGGGGGACTG TGAGTTCCTG GTGAAGCGGG CCCGGGAGCT GGTGCCGGGG 
    GACCTGTGGG CGGCCAAGGC CTGGCTCATC ACGGCGCGGA GCCTCTACCC CGCCGACTTC
    AACATCCAAT ATGAGATGTA CACTATCGAG AGGAATGCTG AAAGGACAGC ATCTGCAGGC
    AGGCTGCTCT ACGACATGTT TGTGAATTTT CCAGACCAAC CTGCTGTATG GAGGGAGATC
    AGCGTTATTA CATCAGCATT AAGGAATGAC TCCCAGGACA AGCAGACACA GTTTTTAAGA
    GGATTATTTG AGACCCTTCC TGGTCGGGTC CAGTGTGAAA TGCTCCTGAA GGCAACAGAG
    CAGTGCTTTA ACACATTAGA AAGGGCAGAA ATGCTCCTTC TGCTTCTGCG GCGTTTCCCA
    GAGACTGTGG TGCAACATGG GGTAGGCCTT GGAGAAACAT TATTAGATTC TGAAAGTATT
    GAAGACCAAG AATCTCCAGT GAATTGTTTT AGAAAATTAT TTGTTTGTGA TGTTCTTCCT
    CTGATAATTA ACAACCCTGA TGTACGACTT CCTGCCAGTT TGTTATATAA ATATCTGAAT
    AAAGCAGCAG AATTTTATAT TAACTACGTA ACTAGATCTA CACAGACAGA AAGTCAATAT
    CAAGGTTCAC AAGATTCCTC TGATATTATG TCTCCAAGCA AGCGCAGCTC TCAGAAATAT
    GTAATAGATG GTCTCACAGA GAAATCATCC CAGATTACAG ATCCTTGGGA GAGGCTGTTT
    AAAATATTGT CCGTGGTGGG AATGAGGTGT GAGTGGCAAA TGGATAAGGG AAGAAGAAGT
    TACGGTGACA TTCTGCATCG AATGAAAGAT CTCTGCAGAT ACATCAGTAA CTTTGATAGT
    GAAGCCCACA TTAAATACAA GAATCAAGTT GTGTATTCCA CGATGTTGGT CTTCTTTAAA
    AATGCTTTTC AGTATGTCAG CAACATCCAG CCATCGCTCT TTCAAGGTCC AAATGCTCCA
    AACCAAACTC CACTGGTTCT TCTCGAGGAT GTACCCAACA TCTATGGTGA TACAGATATT
    GATCGTAACA AACACATACA TAAGAAGAGG AAACTTGCTG AAGGAAGAGA AAAAACAATG
    AGCTCAGATG ACGAGGATCC TTCTGGGAAA GCAAGAAGTC GCCATATTAC AGTAAATAAG
    GCTGATCTTG CAAACTCCAT TGAAGTATTA GAGAGTTTCA AACTGGCAAG AGAGAGCTGG
    GAGCTGCTTT ATTCTCTGGA ATCACTTGAC AAAGAGTTCA CCAGAATTTG TTTGTCATGG
    AAGACAGAAA CTTGGCTTTG GTTAAGAATC TTTCTTACAG ACATGATCAT CTACCAGGGA
    CAATACAAAA AAGCAATTAG CAGCCTACAT CACTTGGCAG CTCTTCAGGG CTCTCATTCT
    CCCCAGCAAA TTACAGGACA AGGATCTTTA GAAAATCAGA GAGCACTAAT CCAGTTAGCA
    TCGTGCCACT TTGCCCTTGG AGAATACCGG CAAACATGTG AAAAAGTGCT CGACCTCATG
    TGCTGTATTT TACTTCCAAT ACAAGAAGGA AGTAAAGTAC AAGAGGAGCA ACCTAAAGTC
    AAGTCAAAAT TCAGGAAAGG GTCTGATTTG AAGCTTTGGC CGTGTACCAG TAGAGCTATC
    ATGCCTTACT GCCTTCATCT GTTGTTAGCT TGTTTCAAGC TCAGAGCTTT CACAGACAGC
    AGAGATGATA TGGCACTGGG CCACGTAGTT GTTCTGCTTC AGCATGAGTG GCCGAGGGGT
    GAGAACTTGT TCCTGAAAGC CATCAACAAA ATCTGCCAGC AAGGAAACTT CCAGTATGAG
    AATTTTTTCA ACTATGTCAC AAATATTGAT ATGTTGGAGG AATTTGCTTA TTTAAGAACA
    CAGGAAGGAG GGAAAATTCA TCTGGAACTG CTGCCAAATC AAGCAATGTT GATCAAGCAC
    CACACAGTTA CCCGGGGTAT AACTAAAGGA GTGAAGGAAG ATTTCCGCCT GGCCATGGAG
    CGCCAGGTCT CGCGCTGTGG GGAAAATCTC ATGGTGGTCT TGCATAGGTT CTGCATTAAT
    GAGAAAATAC TGCTGCTGCA GACTCTTGCT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd17858
    Clone ID Related Accession (Same CDS sequence) XM_012573457.1
    Accession Version XM_012573457.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2211bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-05-25
    Organism Taeniopygia guttata(zebra finch)
    Product integrator complex subunit 10 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_002198634.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Taeniopygia guttata Annotation Release 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGTCGGCGC AGGGGGACTG TGAGTTCCTG GTGAAGCGGG CCCGGGAGCT GGTGCCGGGG 
    GACCTGTGGG CGGCCAAGGC CTGGCTCATC ACGGCGCGGA GCCTCTACCC CGCCGACTTC
    AACATCCAAT ATGAGATGTA CACTATCGAG AGGAATGCTG AAAGGACAGC ATCTGCAGGC
    AGGCTGCTCT ACGACATGTT TGTGAATTTT CCAGACCAAC CTGCTGTATG GAGGGAGATC
    AGCGTTATTA CATCAGCATT AAGGAATGAC TCCCAGGACA AGCAGACACA GTTTTTAAGA
    GGATTATTTG AGACCCTTCC TGGTCGGGTC CAGTGTGAAA TGCTCCTGAA GGCAACAGAG
    CAGTGCTTTA ACACATTAGA AAGGGCAGAA ATGCTCCTTC TGCTTCTGCG GCGTTTCCCA
    GAGACTGTGG TGCAACATGG GGTAGGCCTT GGAGAAACAT TATTAGATTC TGAAAGTATT
    GAAGACCAAG AATCTCCAGT GAATTGTTTT AGAAAATTAT TTGTTTGTGA TGTTCTTCCT
    CTGATAATTA ACAACCCTGA TGTACGACTT CCTGCCAGTT TGTTATATAA ATATCTGAAT
    AAAGCAGCAG AATTTTATAT TAACTACGTA ACTAGATCTA CACAGACAGA AAGTCAATAT
    CAAGGTTCAC AAGATTCCTC TGATATTATG TCTCCAAGCA AGCGCAGCTC TCAGAAATAT
    GTAATAGATG GTCTCACAGA GAAATCATCC CAGATTACAG ATCCTTGGGA GAGGCTGTTT
    AAAATATTGT CCGTGGTGGG AATGAGGTGT GAGTGGCAAA TGGATAAGGG AAGAAGAAGT
    TACGGTGACA TTCTGCATCG AATGAAAGAT CTCTGCAGAT ACATCAGTAA CTTTGATAGT
    GAAGCCCACA TTAAATACAA GAATCAAGTT GTGTATTCCA CGATGTTGGT CTTCTTTAAA
    AATGCTTTTC AGTATGTCAG CAACATCCAG CCATCGCTCT TTCAAGGTCC AAATGCTCCA
    AACCAAACTC CACTGGTTCT TCTCGAGGAT GTACCCAACA TCTATGGTGA TACAGATATT
    GATCGTAACA AACACATACA TAAGAAGAGG AAACTTGCTG AAGGAAGAGA AAAAACAATG
    AGCTCAGATG ACGAGGATCC TTCTGGGAAA GCAAGAAGTC GCCATATTAC AGTAAATAAG
    GCTGATCTTG CAAACTCCAT TGAAGTATTA GAGAGTTTCA AACTGGCAAG AGAGAGCTGG
    GAGCTGCTTT ATTCTCTGGA ATCACTTGAC AAAGAGTTCA CCAGAATTTG TTTGTCATGG
    AAGACAGAAA CTTGGCTTTG GTTAAGAATC TTTCTTACAG ACATGATCAT CTACCAGGGA
    CAATACAAAA AAGCAATTAG CAGCCTACAT CACTTGGCAG CTCTTCAGGG CTCTCATTCT
    CCCCAGCAAA TTACAGGACA AGGATCTTTA GAAAATCAGA GAGCACTAAT CCAGTTAGCA
    TCGTGCCACT TTGCCCTTGG AGAATACCGG CAAACATGTG AAAAAGTGCT CGACCTCATG
    TGCTGTATTT TACTTCCAAT ACAAGAAGGA AGTAAAGTAC AAGAGGAGCA ACCTAAAGTC
    AAGTCAAAAT TCAGGAAAGG GTCTGATTTG AAGCTTTGGC CGTGTACCAG TAGAGCTATC
    ATGCCTTACT GCCTTCATCT GTTGTTAGCT TGTTTCAAGC TCAGAGCTTT CACAGACAGC
    AGAGATGATA TGGCACTGGG CCACGTAGTT GTTCTGCTTC AGCATGAGTG GCCGAGGGGT
    GAGAACTTGT TCCTGAAAGC CATCAACAAA ATCTGCCAGC AAGGAAACTT CCAGTATGAG
    AATTTTTTCA ACTATGTCAC AAATATTGAT ATGTTGGAGG AATTTGCTTA TTTAAGAACA
    CAGGAAGGAG GGAAAATTCA TCTGGAACTG CTGCCAAATC AAGCAATGTT GATCAAGACC
    TCTAGCCCTC CCATGGGGTT ACTGCAGCAG GAATTCATAC CTGTGCTACA GCCCAGCATA
    CAGACTGCTG ACAGGCACCA CACAGTTACC CGGGGTATAA CTAAAGGAGT GAAGGAAGAT
    TTCCGCCTGG CCATGGAGCG CCAGGTCTCG CGCTGTGGGG AAAATCTCAT GGTGGTCTTG
    CATAGGTTCT GCATTAATGA GAAAATACTG CTGCTGCAGA CTCTTGCTTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012428911.1
    CDS18..2228
    Translation

    Target ORF information:

    RefSeq Version XM_012573457.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012573457.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGTCGGCGC AGGGGGACTG TGAGTTCCTG GTGAAGCGGG CCCGGGAGCT GGTGCCGGGG 
    GACCTGTGGG CGGCCAAGGC CTGGCTCATC ACGGCGCGGA GCCTCTACCC CGCCGACTTC
    AACATCCAAT ATGAGATGTA CACTATCGAG AGGAATGCTG AAAGGACAGC ATCTGCAGGC
    AGGCTGCTCT ACGACATGTT TGTGAATTTT CCAGACCAAC CTGCTGTATG GAGGGAGATC
    AGCGTTATTA CATCAGCATT AAGGAATGAC TCCCAGGACA AGCAGACACA GTTTTTAAGA
    GGATTATTTG AGACCCTTCC TGGTCGGGTC CAGTGTGAAA TGCTCCTGAA GGCAACAGAG
    CAGTGCTTTA ACACATTAGA AAGGGCAGAA ATGCTCCTTC TGCTTCTGCG GCGTTTCCCA
    GAGACTGTGG TGCAACATGG GGTAGGCCTT GGAGAAACAT TATTAGATTC TGAAAGTATT
    GAAGACCAAG AATCTCCAGT GAATTGTTTT AGAAAATTAT TTGTTTGTGA TGTTCTTCCT
    CTGATAATTA ACAACCCTGA TGTACGACTT CCTGCCAGTT TGTTATATAA ATATCTGAAT
    AAAGCAGCAG AATTTTATAT TAACTACGTA ACTAGATCTA CACAGACAGA AAGTCAATAT
    CAAGGTTCAC AAGATTCCTC TGATATTATG TCTCCAAGCA AGCGCAGCTC TCAGAAATAT
    GTAATAGATG GTCTCACAGA GAAATCATCC CAGATTACAG ATCCTTGGGA GAGGCTGTTT
    AAAATATTGT CCGTGGTGGG AATGAGGTGT GAGTGGCAAA TGGATAAGGG AAGAAGAAGT
    TACGGTGACA TTCTGCATCG AATGAAAGAT CTCTGCAGAT ACATCAGTAA CTTTGATAGT
    GAAGCCCACA TTAAATACAA GAATCAAGTT GTGTATTCCA CGATGTTGGT CTTCTTTAAA
    AATGCTTTTC AGTATGTCAG CAACATCCAG CCATCGCTCT TTCAAGGTCC AAATGCTCCA
    AACCAAACTC CACTGGTTCT TCTCGAGGAT GTACCCAACA TCTATGGTGA TACAGATATT
    GATCGTAACA AACACATACA TAAGAAGAGG AAACTTGCTG AAGGAAGAGA AAAAACAATG
    AGCTCAGATG ACGAGGATCC TTCTGGGAAA GCAAGAAGTC GCCATATTAC AGTAAATAAG
    GCTGATCTTG CAAACTCCAT TGAAGTATTA GAGAGTTTCA AACTGGCAAG AGAGAGCTGG
    GAGCTGCTTT ATTCTCTGGA ATCACTTGAC AAAGAGTTCA CCAGAATTTG TTTGTCATGG
    AAGACAGAAA CTTGGCTTTG GTTAAGAATC TTTCTTACAG ACATGATCAT CTACCAGGGA
    CAATACAAAA AAGCAATTAG CAGCCTACAT CACTTGGCAG CTCTTCAGGG CTCTCATTCT
    CCCCAGCAAA TTACAGGACA AGGATCTTTA GAAAATCAGA GAGCACTAAT CCAGTTAGCA
    TCGTGCCACT TTGCCCTTGG AGAATACCGG CAAACATGTG AAAAAGTGCT CGACCTCATG
    TGCTGTATTT TACTTCCAAT ACAAGAAGGA AGTAAAGTAC AAGAGGAGCA ACCTAAAGTC
    AAGTCAAAAT TCAGGAAAGG GTCTGATTTG AAGCTTTGGC CGTGTACCAG TAGAGCTATC
    ATGCCTTACT GCCTTCATCT GTTGTTAGCT TGTTTCAAGC TCAGAGCTTT CACAGACAGC
    AGAGATGATA TGGCACTGGG CCACGTAGTT GTTCTGCTTC AGCATGAGTG GCCGAGGGGT
    GAGAACTTGT TCCTGAAAGC CATCAACAAA ATCTGCCAGC AAGGAAACTT CCAGTATGAG
    AATTTTTTCA ACTATGTCAC AAATATTGAT ATGTTGGAGG AATTTGCTTA TTTAAGAACA
    CAGGAAGGAG GGAAAATTCA TCTGGAACTG CTGCCAAATC AAGCAATGTT GATCAAGACC
    TCTAGCCCTC CCATGGGGTT ACTGCAGCAG GAATTCATAC CTGTGCTACA GCCCAGCATA
    CAGACTGCTG ACAGGCACCA CACAGTTACC CGGGGTATAA CTAAAGGAGT GAAGGAAGAT
    TTCCGCCTGG CCATGGAGCG CCAGGTCTCG CGCTGTGGGG AAAATCTCAT GGTGGTCTTG
    CATAGGTTCT GCATTAATGA GAAAATACTG CTGCTGCAGA CTCTTGCTTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd44767
    Clone ID Related Accession (Same CDS sequence) XM_030271577.1
    Accession Version XM_030271577.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2256bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product integrator complex subunit 10 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044215.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGCAGAGCTC AGATGACGAG
    GATCCTTCTG GGAAAGCAAG AAGTCGCCAT ATTACAGTAA ATAAGGCTGA TCTTGCAAAC
    TCCATTGAAG TATTAGAGAG TTTCAAACTG GCAAGAGAGA GCTGGGAGCT GCTTTATTCT
    CTGGAATCAC TTGACAAAGA GTTCACCAGA ATTTGTTTGT CATGGAAGAC AGAAACTTGG
    CTTTGGTTAA GAATCTTTCT TACAGACATG ATCATCTACC AGGGACAATA CAAAAAAGCA
    ATTAGCAGCC TACATCACTT GGCAGCTCTT CAGGGCTCTC ATTCTCCCCA GCAAATTACA
    GGACAAGGAT CTTTAGAAAA TCAGAGAGCA CTAATCCAGT TAGCATCGTG CCACTTTGCC
    CTTGGAGAAT ACCGGCAAAC GTGTGAAAAA GTGCTTGACC TCATGTGCTG TATTTTACTT
    CCAATACAAG AAGGAAGTAA AGTACAAGAG GAGCAACCTA AAGTCAAGTC AAAATTCAGG
    AAAGGGTCTG ATTTGAAGCT TTGGCCGTGT ACCAGTAGAG CTATCATGCC TTACTGCCTT
    CATCTGTTGT TAGCTTGTTT CAAGCTCAGA GCTTTCACAG ACAGCAGAGA TGATATGGCA
    CTGGGCCACG TAGTTGTTCT GCTTCAGCAT GAGTGGCCGA GGGGTGAGAA CTTGTTCCTG
    AAAGCCATCA ACAAAATCTG CCAGCAAGGA AACTTCCAGT ATGAGAATTT TTTCAACTAT
    GTCACAAATA TTGATATGTT GGAGGAATTT GCTTATTTAA GAACACAGGA AGGAGGGAAA
    ATTCATCTGG AACTGCTGCC AAATCAAGCA ATGTTGATCA AGACCTCTAG CCCTCCCATG
    GGGTTACTGC AGCAGGAATT CATACCTGTG CTACAGCCCA GCATACAGAC TGCTGACAGG
    CACCACACAG TTACCCGGGG TATAACTAAA GGAGTGAAGG AAGATTTCCG CCTGGCCATG
    GAGCGCCAGG TCTCGCGCTG TGGGGAAAAT CTCATGGTGG TCTTGCATAG GTTCTGCATT
    AATGAGAAAA TACTGCTGCT GCAGACTCTT GCTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_030127437.1
    CDS3..2258
    Translation

    Target ORF information:

    RefSeq Version XM_030271577.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030271577.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGCAGAGCTC AGATGACGAG
    GATCCTTCTG GGAAAGCAAG AAGTCGCCAT ATTACAGTAA ATAAGGCTGA TCTTGCAAAC
    TCCATTGAAG TATTAGAGAG TTTCAAACTG GCAAGAGAGA GCTGGGAGCT GCTTTATTCT
    CTGGAATCAC TTGACAAAGA GTTCACCAGA ATTTGTTTGT CATGGAAGAC AGAAACTTGG
    CTTTGGTTAA GAATCTTTCT TACAGACATG ATCATCTACC AGGGACAATA CAAAAAAGCA
    ATTAGCAGCC TACATCACTT GGCAGCTCTT CAGGGCTCTC ATTCTCCCCA GCAAATTACA
    GGACAAGGAT CTTTAGAAAA TCAGAGAGCA CTAATCCAGT TAGCATCGTG CCACTTTGCC
    CTTGGAGAAT ACCGGCAAAC GTGTGAAAAA GTGCTTGACC TCATGTGCTG TATTTTACTT
    CCAATACAAG AAGGAAGTAA AGTACAAGAG GAGCAACCTA AAGTCAAGTC AAAATTCAGG
    AAAGGGTCTG ATTTGAAGCT TTGGCCGTGT ACCAGTAGAG CTATCATGCC TTACTGCCTT
    CATCTGTTGT TAGCTTGTTT CAAGCTCAGA GCTTTCACAG ACAGCAGAGA TGATATGGCA
    CTGGGCCACG TAGTTGTTCT GCTTCAGCAT GAGTGGCCGA GGGGTGAGAA CTTGTTCCTG
    AAAGCCATCA ACAAAATCTG CCAGCAAGGA AACTTCCAGT ATGAGAATTT TTTCAACTAT
    GTCACAAATA TTGATATGTT GGAGGAATTT GCTTATTTAA GAACACAGGA AGGAGGGAAA
    ATTCATCTGG AACTGCTGCC AAATCAAGCA ATGTTGATCA AGACCTCTAG CCCTCCCATG
    GGGTTACTGC AGCAGGAATT CATACCTGTG CTACAGCCCA GCATACAGAC TGCTGACAGG
    CACCACACAG TTACCCGGGG TATAACTAAA GGAGTGAAGG AAGATTTCCG CCTGGCCATG
    GAGCGCCAGG TCTCGCGCTG TGGGGAAAAT CTCATGGTGG TCTTGCATAG GTTCTGCATT
    AATGAGAAAA TACTGCTGCT GCAGACTCTT GCTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd44768
    Clone ID Related Accession (Same CDS sequence) XM_012573457.2
    Accession Version XM_012573457.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2253bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product integrator complex subunit 10 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044215.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Aug 9, 2019 this sequence version replaced XM_012573457.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGAGCTCAGA TGACGAGGAT
    CCTTCTGGGA AAGCAAGAAG TCGCCATATT ACAGTAAATA AGGCTGATCT TGCAAACTCC
    ATTGAAGTAT TAGAGAGTTT CAAACTGGCA AGAGAGAGCT GGGAGCTGCT TTATTCTCTG
    GAATCACTTG ACAAAGAGTT CACCAGAATT TGTTTGTCAT GGAAGACAGA AACTTGGCTT
    TGGTTAAGAA TCTTTCTTAC AGACATGATC ATCTACCAGG GACAATACAA AAAAGCAATT
    AGCAGCCTAC ATCACTTGGC AGCTCTTCAG GGCTCTCATT CTCCCCAGCA AATTACAGGA
    CAAGGATCTT TAGAAAATCA GAGAGCACTA ATCCAGTTAG CATCGTGCCA CTTTGCCCTT
    GGAGAATACC GGCAAACGTG TGAAAAAGTG CTTGACCTCA TGTGCTGTAT TTTACTTCCA
    ATACAAGAAG GAAGTAAAGT ACAAGAGGAG CAACCTAAAG TCAAGTCAAA ATTCAGGAAA
    GGGTCTGATT TGAAGCTTTG GCCGTGTACC AGTAGAGCTA TCATGCCTTA CTGCCTTCAT
    CTGTTGTTAG CTTGTTTCAA GCTCAGAGCT TTCACAGACA GCAGAGATGA TATGGCACTG
    GGCCACGTAG TTGTTCTGCT TCAGCATGAG TGGCCGAGGG GTGAGAACTT GTTCCTGAAA
    GCCATCAACA AAATCTGCCA GCAAGGAAAC TTCCAGTATG AGAATTTTTT CAACTATGTC
    ACAAATATTG ATATGTTGGA GGAATTTGCT TATTTAAGAA CACAGGAAGG AGGGAAAATT
    CATCTGGAAC TGCTGCCAAA TCAAGCAATG TTGATCAAGA CCTCTAGCCC TCCCATGGGG
    TTACTGCAGC AGGAATTCAT ACCTGTGCTA CAGCCCAGCA TACAGACTGC TGACAGGCAC
    CACACAGTTA CCCGGGGTAT AACTAAAGGA GTGAAGGAAG ATTTCCGCCT GGCCATGGAG
    CGCCAGGTCT CGCGCTGTGG GGAAAATCTC ATGGTGGTCT TGCATAGGTT CTGCATTAAT
    GAGAAAATAC TGCTGCTGCA GACTCTTGCT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012428911.2
    CDS2..2254
    Translation

    Target ORF information:

    RefSeq Version XM_012573457.2
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012573457.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGAGCTCAGA TGACGAGGAT
    CCTTCTGGGA AAGCAAGAAG TCGCCATATT ACAGTAAATA AGGCTGATCT TGCAAACTCC
    ATTGAAGTAT TAGAGAGTTT CAAACTGGCA AGAGAGAGCT GGGAGCTGCT TTATTCTCTG
    GAATCACTTG ACAAAGAGTT CACCAGAATT TGTTTGTCAT GGAAGACAGA AACTTGGCTT
    TGGTTAAGAA TCTTTCTTAC AGACATGATC ATCTACCAGG GACAATACAA AAAAGCAATT
    AGCAGCCTAC ATCACTTGGC AGCTCTTCAG GGCTCTCATT CTCCCCAGCA AATTACAGGA
    CAAGGATCTT TAGAAAATCA GAGAGCACTA ATCCAGTTAG CATCGTGCCA CTTTGCCCTT
    GGAGAATACC GGCAAACGTG TGAAAAAGTG CTTGACCTCA TGTGCTGTAT TTTACTTCCA
    ATACAAGAAG GAAGTAAAGT ACAAGAGGAG CAACCTAAAG TCAAGTCAAA ATTCAGGAAA
    GGGTCTGATT TGAAGCTTTG GCCGTGTACC AGTAGAGCTA TCATGCCTTA CTGCCTTCAT
    CTGTTGTTAG CTTGTTTCAA GCTCAGAGCT TTCACAGACA GCAGAGATGA TATGGCACTG
    GGCCACGTAG TTGTTCTGCT TCAGCATGAG TGGCCGAGGG GTGAGAACTT GTTCCTGAAA
    GCCATCAACA AAATCTGCCA GCAAGGAAAC TTCCAGTATG AGAATTTTTT CAACTATGTC
    ACAAATATTG ATATGTTGGA GGAATTTGCT TATTTAAGAA CACAGGAAGG AGGGAAAATT
    CATCTGGAAC TGCTGCCAAA TCAAGCAATG TTGATCAAGA CCTCTAGCCC TCCCATGGGG
    TTACTGCAGC AGGAATTCAT ACCTGTGCTA CAGCCCAGCA TACAGACTGC TGACAGGCAC
    CACACAGTTA CCCGGGGTAT AACTAAAGGA GTGAAGGAAG ATTTCCGCCT GGCCATGGAG
    CGCCAGGTCT CGCGCTGTGG GGAAAATCTC ATGGTGGTCT TGCATAGGTT CTGCATTAAT
    GAGAAAATAC TGCTGCTGCA GACTCTTGCT TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd44769
    Clone ID Related Accession (Same CDS sequence) XM_030271578.1
    Accession Version XM_030271578.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2178bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product integrator complex subunit 10 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044215.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGCAGAGCTC AGATGACGAG
    GATCCTTCTG GGAAAGCAAG AAGTCGCCAT ATTACAGTAA ATAAGGCTGA TCTTGCAAAC
    TCCATTGAAG TATTAGAGAG TTTCAAACTG GCAAGAGAGA GCTGGGAGCT GCTTTATTCT
    CTGGAATCAC TTGACAAAGA GTTCACCAGA ATTTGTTTGT CATGGAAGAC AGAAACTTGG
    CTTTGGTTAA GAATCTTTCT TACAGACATG ATCATCTACC AGGGACAATA CAAAAAAGCA
    ATTAGCAGCC TACATCACTT GGCAGCTCTT CAGGGCTCTC ATTCTCCCCA GCAAATTACA
    GGACAAGGAT CTTTAGAAAA TCAGAGAGCA CTAATCCAGT TAGCATCGTG CCACTTTGCC
    CTTGGAGAAT ACCGGCAAAC GTGTGAAAAA GTGCTTGACC TCATGTGCTG TATTTTACTT
    CCAATACAAG AAGGAAGTAA AGTACAAGAG GAGCAACCTA AAGTCAAGTC AAAATTCAGG
    AAAGGGTCTG ATTTGAAGCT TTGGCCGTGT ACCAGTAGAG CTATCATGCC TTACTGCCTT
    CATCTGTTGT TAGCTTGTTT CAAGCTCAGA GCTTTCACAG ACAGCAGAGA TGATATGGCA
    CTGGGCCACG TAGTTGTTCT GCTTCAGCAT GAGTGGCCGA GGGGTGAGAA CTTGTTCCTG
    AAAGCCATCA ACAAAATCTG CCAGCAAGGA AACTTCCAGT ATGAGAATTT TTTCAACTAT
    GTCACAAATA TTGATATGTT GGAGGAATTT GCTTATTTAA GAACACAGGA AGGAGGGAAA
    ATTCATCTGG AACTGCTGCC AAATCAAGCA ATGTTGATCA AGCACCACAC AGTTACCCGG
    GGTATAACTA AAGGAGTGAA GGAAGATTTC CGCCTGGCCA TGGAGCGCCA GGTCTCGCGC
    TGTGGGGAAA ATCTCATGGT GGTCTTGCAT AGGTTCTGCA TTAATGAGAA AATACTGCTG
    CTGCAGACTC TTGCTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030127438.1
    CDS2..2179
    Translation

    Target ORF information:

    RefSeq Version XM_030271578.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030271578.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGCAGAGCTC AGATGACGAG
    GATCCTTCTG GGAAAGCAAG AAGTCGCCAT ATTACAGTAA ATAAGGCTGA TCTTGCAAAC
    TCCATTGAAG TATTAGAGAG TTTCAAACTG GCAAGAGAGA GCTGGGAGCT GCTTTATTCT
    CTGGAATCAC TTGACAAAGA GTTCACCAGA ATTTGTTTGT CATGGAAGAC AGAAACTTGG
    CTTTGGTTAA GAATCTTTCT TACAGACATG ATCATCTACC AGGGACAATA CAAAAAAGCA
    ATTAGCAGCC TACATCACTT GGCAGCTCTT CAGGGCTCTC ATTCTCCCCA GCAAATTACA
    GGACAAGGAT CTTTAGAAAA TCAGAGAGCA CTAATCCAGT TAGCATCGTG CCACTTTGCC
    CTTGGAGAAT ACCGGCAAAC GTGTGAAAAA GTGCTTGACC TCATGTGCTG TATTTTACTT
    CCAATACAAG AAGGAAGTAA AGTACAAGAG GAGCAACCTA AAGTCAAGTC AAAATTCAGG
    AAAGGGTCTG ATTTGAAGCT TTGGCCGTGT ACCAGTAGAG CTATCATGCC TTACTGCCTT
    CATCTGTTGT TAGCTTGTTT CAAGCTCAGA GCTTTCACAG ACAGCAGAGA TGATATGGCA
    CTGGGCCACG TAGTTGTTCT GCTTCAGCAT GAGTGGCCGA GGGGTGAGAA CTTGTTCCTG
    AAAGCCATCA ACAAAATCTG CCAGCAAGGA AACTTCCAGT ATGAGAATTT TTTCAACTAT
    GTCACAAATA TTGATATGTT GGAGGAATTT GCTTATTTAA GAACACAGGA AGGAGGGAAA
    ATTCATCTGG AACTGCTGCC AAATCAAGCA ATGTTGATCA AGCACCACAC AGTTACCCGG
    GGTATAACTA AAGGAGTGAA GGAAGATTTC CGCCTGGCCA TGGAGCGCCA GGTCTCGCGC
    TGTGGGGAAA ATCTCATGGT GGTCTTGCAT AGGTTCTGCA TTAATGAGAA AATACTGCTG
    CTGCAGACTC TTGCTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd44770
    Clone ID Related Accession (Same CDS sequence) XM_002197551.3
    Accession Version XM_002197551.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2175bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product integrator complex subunit 10 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044215.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Aug 9, 2019 this sequence version replaced XM_002197551.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGAGCTCAGA TGACGAGGAT
    CCTTCTGGGA AAGCAAGAAG TCGCCATATT ACAGTAAATA AGGCTGATCT TGCAAACTCC
    ATTGAAGTAT TAGAGAGTTT CAAACTGGCA AGAGAGAGCT GGGAGCTGCT TTATTCTCTG
    GAATCACTTG ACAAAGAGTT CACCAGAATT TGTTTGTCAT GGAAGACAGA AACTTGGCTT
    TGGTTAAGAA TCTTTCTTAC AGACATGATC ATCTACCAGG GACAATACAA AAAAGCAATT
    AGCAGCCTAC ATCACTTGGC AGCTCTTCAG GGCTCTCATT CTCCCCAGCA AATTACAGGA
    CAAGGATCTT TAGAAAATCA GAGAGCACTA ATCCAGTTAG CATCGTGCCA CTTTGCCCTT
    GGAGAATACC GGCAAACGTG TGAAAAAGTG CTTGACCTCA TGTGCTGTAT TTTACTTCCA
    ATACAAGAAG GAAGTAAAGT ACAAGAGGAG CAACCTAAAG TCAAGTCAAA ATTCAGGAAA
    GGGTCTGATT TGAAGCTTTG GCCGTGTACC AGTAGAGCTA TCATGCCTTA CTGCCTTCAT
    CTGTTGTTAG CTTGTTTCAA GCTCAGAGCT TTCACAGACA GCAGAGATGA TATGGCACTG
    GGCCACGTAG TTGTTCTGCT TCAGCATGAG TGGCCGAGGG GTGAGAACTT GTTCCTGAAA
    GCCATCAACA AAATCTGCCA GCAAGGAAAC TTCCAGTATG AGAATTTTTT CAACTATGTC
    ACAAATATTG ATATGTTGGA GGAATTTGCT TATTTAAGAA CACAGGAAGG AGGGAAAATT
    CATCTGGAAC TGCTGCCAAA TCAAGCAATG TTGATCAAGC ACCACACAGT TACCCGGGGT
    ATAACTAAAG GAGTGAAGGA AGATTTCCGC CTGGCCATGG AGCGCCAGGT CTCGCGCTGT
    GGGGAAAATC TCATGGTGGT CTTGCATAGG TTCTGCATTA ATGAGAAAAT ACTGCTGCTG
    CAGACTCTTG CTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_002197587.2
    CDS2..2176
    Translation

    Target ORF information:

    RefSeq Version XM_002197551.3
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata integrator complex subunit 10 (INTS10), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_002197551.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGCGCGCCG CCCGGCGGCC GGGGCGGAGC GCCGGCTGCA AGATGTCGGC GCAGGGGGAC 
    TGTGAGTTCC TGGTGAAGCG GGCCCGGGAG CTGGTGCCGG GGGACCTGTG GGCGGCCAAG
    GCCTGGCTCA TCACGGCGCG GAGCCTCTAC CCCGCCGACT TCAACATCCA ATATGAGATG
    TACACTATTG AGAGGAATGC TGAAAGGACA GCATCTGCAG GCAGGCTGCT CTACGACATG
    TTTGTGAATT TTCCAGACCA ACCTGCTGTA TGGAGGGAGA TCAGCGTTAT TACATCAGCA
    TTAAGGAATG ACTCCCAGGA CAAGCAGACA CAGTTTTTAA GAGGATTATT TGAGACCCTT
    CCTGGTCGGG TCCAGTGTGA AATGCTCCTG AAGGCAACAG AGCAGTGCTT TAACACATTA
    GAAAGGGCAG AAATGCTCCT TCTGCTTCTG CGGCGTTTCC CAGAGACTGT GGTGCAACAT
    GGGGTAGGCC TTGGAGAAAC ATTATTAGAT TCTGAAAGTA TTGAAGACCA AGAATCTCCA
    GTGAATTGTT TTAGAAAATT ATTTGTTTGT GATGTTCTTC CTCTGATAAT TAACAACCCT
    GATGTACGAC TTCCTGCCAG TTTGTTATAT AAATATCTGA ATAAAGCAGC AGAATTTTAT
    ATTAACTATG TAACTAGATC TACACAGACA GAAAGTCAAT ATCAAGGTTC ACAAGATTCC
    TCTGATATTA TGTCTCCAAG CAAGCGCAGC TCTCAGAAAT ATGTAATAGA TGGTCTCACA
    GAGAAATCAT CCCAGATTAC AGATCCTTGG GAGAGGCTGT TTAAAATACT GTCCGTGGTG
    GGAATGAGGT GTGAGTGGCA AATGGATAAG GGAAGAAGAA ATTATGGTGA CATTCTGCAT
    CGAATGAAAG ATCTCTGCAG ATACATCAGT AACTTTGATA GTGAAGCCCA CATTAAATAC
    AAGAATCAAG TTGTGTATTC CACAATGTTG GTCTTCTTTA AAAATGCTTT TCAGTATGTC
    AGCAACATCC AGCCATCGCT CTTTCAAGGT CCAAATGCTC CAAACCAAAC TCCACTGGTT
    CTTCTCGAGG ATGTACCCAA CATCTATGGT GATACAGATA TTGATCGTAA CAAACACATA
    CATAAGAAGA GGAAACTTGC TGAAGGAAGA GAAAAAACAA TGAGCTCAGA TGACGAGGAT
    CCTTCTGGGA AAGCAAGAAG TCGCCATATT ACAGTAAATA AGGCTGATCT TGCAAACTCC
    ATTGAAGTAT TAGAGAGTTT CAAACTGGCA AGAGAGAGCT GGGAGCTGCT TTATTCTCTG
    GAATCACTTG ACAAAGAGTT CACCAGAATT TGTTTGTCAT GGAAGACAGA AACTTGGCTT
    TGGTTAAGAA TCTTTCTTAC AGACATGATC ATCTACCAGG GACAATACAA AAAAGCAATT
    AGCAGCCTAC ATCACTTGGC AGCTCTTCAG GGCTCTCATT CTCCCCAGCA AATTACAGGA
    CAAGGATCTT TAGAAAATCA GAGAGCACTA ATCCAGTTAG CATCGTGCCA CTTTGCCCTT
    GGAGAATACC GGCAAACGTG TGAAAAAGTG CTTGACCTCA TGTGCTGTAT TTTACTTCCA
    ATACAAGAAG GAAGTAAAGT ACAAGAGGAG CAACCTAAAG TCAAGTCAAA ATTCAGGAAA
    GGGTCTGATT TGAAGCTTTG GCCGTGTACC AGTAGAGCTA TCATGCCTTA CTGCCTTCAT
    CTGTTGTTAG CTTGTTTCAA GCTCAGAGCT TTCACAGACA GCAGAGATGA TATGGCACTG
    GGCCACGTAG TTGTTCTGCT TCAGCATGAG TGGCCGAGGG GTGAGAACTT GTTCCTGAAA
    GCCATCAACA AAATCTGCCA GCAAGGAAAC TTCCAGTATG AGAATTTTTT CAACTATGTC
    ACAAATATTG ATATGTTGGA GGAATTTGCT TATTTAAGAA CACAGGAAGG AGGGAAAATT
    CATCTGGAAC TGCTGCCAAA TCAAGCAATG TTGATCAAGC ACCACACAGT TACCCGGGGT
    ATAACTAAAG GAGTGAAGGA AGATTTCCGC CTGGCCATGG AGCGCCAGGT CTCGCGCTGT
    GGGGAAAATC TCATGGTGGT CTTGCATAGG TTCTGCATTA ATGAGAAAAT ACTGCTGCTG
    CAGACTCTTG CTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.