SMCR8 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

The following SMCR8 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the SMCR8 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs13896 XM_005523064.2
Latest version!
Pseudopodoces humilis Smith-Magenis syndrome chromosome region, candidate 8 (SMCR8), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs13896
    Clone ID Related Accession (Same CDS sequence) XM_005523064.2
    Accession Version XM_005523064.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2799bp)
    Protein sequence
    SNP
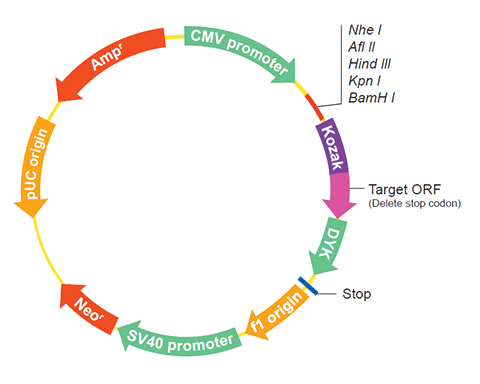
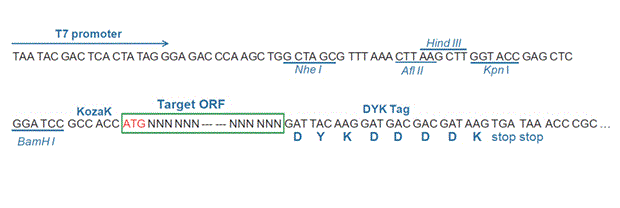
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product Smith-Magenis syndrome chromosomal region candidate gene 8 protein
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087569.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 21, 2015 this sequence version replaced XM_005523064.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGATCAGCG CCCCTGACGT GGTGGCCTTC ACCAGGGAGG AGGAGCTGGA GGATGATCTG 
    TACCGCGAGC CGCCCCTGCC CGAGGAGTAC TCGGTGCCGC TGTTCCCCTT CACCGGCCAG
    GGCGCCAACC CCTGGGCCAA GGTCGCCGGC TCCAAGTTCA CCCGGGACTT CATCCTCATC
    TCCGAGTTCT CGGAGCAAGT GGGGCCCCAG CCCCTCCTGA CCATCCCCGA TGACGCCAAA
    GTGTCGGGCA CCTTCGATCT CAATTATTTT TCCCTGCGGA TCATGTCTGT GGATTATCAG
    GCATCCTTTG TGGGGCACCC TCCTGGCTCT GCCTACCCGA AGTTGAACTT TGTGGAGGAT
    TCCAAGGTGG TGCTGGGGGA CTCCAAGGAA GGGGCCTTTG CCTACGTGCA CCACCTGACC
    CTGTACGACC TGGAGGCCAG GGGCTTTGTC AGGCCCTTCT GCATGGCTTA CATTTCTGCT
    GACGAGCACA AAATCATGCA GCAGTTTCAG GAACTCTCCA CCGAGTTCTC CAAAGCCTCC
    GAATGCCTGA AGACGGGGAA CCGGAAAGCT TTTGCCAATG AACTGGAAAA GAAACTGAAA
    GACCTTGACT ACACCAGGAC CGTCCTGCAC AACGAGACTG AGCAACAGAA GAAAGCCAAC
    GACAAAGGGT ATTACACGAC CCAGGCCATT GAGAAGGCCA ATGAGCTGGC CAGTGTGGAA
    AAGTCAATCA TCGAGCACCA AGACCTGCTG AGGCAAATCC GGTCGTATCC CTACAGGAAG
    CTGAAGGACT CTGAATTCCA CCCCTACGAG CCAGAGTGTG CCCTGGACCG GGCTGACGTG
    GGCAGCGACC AAGACCCGAC TGCCTCTGAC CCTGCTGAGC CTGGTGAAAC TGCTCTTTAC
    ACCCATGTGC CATCCTACAC CCCCAAACTC ATCAAAGCCA AGTCTGCCAA GTGCTTTGAC
    AAGAAGCTGA AGACACTGGA GGAACTCTGT GATGTTTATT TTTTCACCCA GACCCTTGAC
    CAGTTGCACC ATATCGAGAG GACTTTTCGA GGTGATGTGT GTTACCTCTT GACAGAGCAG
    ATAAGCCGGG CTCTCCTAAA GCAACAGAGT GTCACCAACT TCCTCTTTGA GGATGTGTCT
    TTCCTGGATG AAAAACCTCC TGAAAAGCAG TACAGAGGCT GCCAGGGGCT CGGCCAAGAT
    GCCACAGATG AAAAGTGTTC GGAAGAGTCC CTTGCTCCTA AAGTGGTCAT CAGCCTGGGC
    TCCTACAAGT CCAGTGTGGA GTGCGTGCCC ATCAAGATGG AGCAGGAAAT TGAGGACTCT
    GAAGGACCCA AAATGTCTGA GTCCATGATG TCTGAGCACC AGGAGAACCT GGACTATCTG
    GATGCAGATA TCAAAGGCAG CATCAGTAGC GGGGAGAGCA TCGAGGTGCT TGGAACGGAG
    AAATCAGGAT CTGGGCTGAC AAAATCGGAG AGCCAGGCCA GCCTGCCCGT CATTCCCAGC
    CCCCAGGCCG GCCGGAGCAA GGTGGGCAGC CGGCGCACGG TCAGCGAGGA CAGCATCGAG
    GTGCTCAGCA CGTGTCCCTC CGAGTCCCTC ATCCCAGAGG ATTTCAAAGC GAGCTACCCA
    AGTGCCATTA ACGAGGAGCC CCACGCGGAT GACGATGAGG GAGGCCTTCG CTTCACCCCC
    AGACTGAACC CGGGCATCGA TGATGGGCAG GATGACATCT CAAAGCAGGA AAGCTTAGTG
    CAGGTGGATG CTGCCTGTTG TATCGGGAAG GAGAGCCCCA ACTTCCTGGA GCCGCTGCCC
    GAGCTGGGGC AGAAGCCGTG CGAGGAGGAC GGGGTGGTGC GGATCCCCCC GCAGCCGTAC
    CGGCCGGCCG AGCAGGGGCT GCGCGGGGGC TTCCCCTGCC ACGACGGCCT CTCGGGGGGG
    CTCCTGCCCT ACGAGCTCGA TTCGCGCTAC CTGACGGGCA GCAGGGAGGT GAGTAAGAGC
    AGCCTGGACG AGTGCTCGGA CTCCACGAGC TACATCAGCA GCGCCGCCTC CACGTGCTCC
    GACAGGACCC CCTCTCCCGC CCACCTGGGC TGCGCGGCCG GGGAAAGGCA CAGGAAGAAG
    GCCGGGCAGA ACGCGCTGCG CTTCATCCGC CAGTACCCCT TCGCCCACCC CGCCATCTAC
    TCCCTGCTCA GCGGGAGGAC CCTGGTAGTG CTGGGGGAGG ACGAGGCCAT GGTCAAGAGG
    CTCGTGACGG CGCTCTCCAT CTTCGTGCCC AGCTGCGGCG CGTACGCCAA GCCCGTGAAG
    CACTGGGTCA CTTCTGCTCT GCACTTGGTG GATTTCCAGA AGTGGAAGTT GGTTGGACTC
    CAGAGGGCAG TGTCCCCTGC TGGGGTGAAT GTGCTGCACG CCCTGAGCCG CTACAGCCGC
    TACCTGAGCA TCCTGGACGC CGACAGCAAG ACCCTGCGCT GCCCCCTCTA CAAGGGCACC
    GTGGTGGCCC GGCTGGCCGA CCACCGCACG CAGATCAAGC GTGGCAGCAC CTACTACATG
    CACGTCCAAA GCATCCTCAC CCAGCTGTGC TCTAAAGCCT TCCTCTTCAC CTTCTGCCAT
    CATTTGCACC TTCCCATCAG CGAAAGGGAA CCGGAGGAAT CCGTTGTGAA TCGCAGGATG
    AACTTCCTAA AGCTTCAACT GGGCCTTGCC AACGAAGATA TCAAAATCGT GCAGTACTTG
    GCCGAGCTGC TGAAGCTGCA CTACATTCAG GAACCGGGGC AGGGGGGGAA CCCCCTGCTC
    AGATTTGACT ATGTTCCCAG CTTTTTGTAC AAAATCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005523121.1
    CDS83..2881
    Translation

    Target ORF information:

    RefSeq Version XM_005523064.2
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis Smith-Magenis syndrome chromosome region, candidate 8 (SMCR8), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005523064.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGATCAGCG CCCCTGACGT GGTGGCCTTC ACCAGGGAGG AGGAGCTGGA GGATGATCTG 
    TACCGCGAGC CGCCCCTGCC CGAGGAGTAC TCGGTGCCGC TGTTCCCCTT CACCGGCCAG
    GGCGCCAACC CCTGGGCCAA GGTCGCCGGC TCCAAGTTCA CCCGGGACTT CATCCTCATC
    TCCGAGTTCT CGGAGCAAGT GGGGCCCCAG CCCCTCCTGA CCATCCCCGA TGACGCCAAA
    GTGTCGGGCA CCTTCGATCT CAATTATTTT TCCCTGCGGA TCATGTCTGT GGATTATCAG
    GCATCCTTTG TGGGGCACCC TCCTGGCTCT GCCTACCCGA AGTTGAACTT TGTGGAGGAT
    TCCAAGGTGG TGCTGGGGGA CTCCAAGGAA GGGGCCTTTG CCTACGTGCA CCACCTGACC
    CTGTACGACC TGGAGGCCAG GGGCTTTGTC AGGCCCTTCT GCATGGCTTA CATTTCTGCT
    GACGAGCACA AAATCATGCA GCAGTTTCAG GAACTCTCCA CCGAGTTCTC CAAAGCCTCC
    GAATGCCTGA AGACGGGGAA CCGGAAAGCT TTTGCCAATG AACTGGAAAA GAAACTGAAA
    GACCTTGACT ACACCAGGAC CGTCCTGCAC AACGAGACTG AGCAACAGAA GAAAGCCAAC
    GACAAAGGGT ATTACACGAC CCAGGCCATT GAGAAGGCCA ATGAGCTGGC CAGTGTGGAA
    AAGTCAATCA TCGAGCACCA AGACCTGCTG AGGCAAATCC GGTCGTATCC CTACAGGAAG
    CTGAAGGACT CTGAATTCCA CCCCTACGAG CCAGAGTGTG CCCTGGACCG GGCTGACGTG
    GGCAGCGACC AAGACCCGAC TGCCTCTGAC CCTGCTGAGC CTGGTGAAAC TGCTCTTTAC
    ACCCATGTGC CATCCTACAC CCCCAAACTC ATCAAAGCCA AGTCTGCCAA GTGCTTTGAC
    AAGAAGCTGA AGACACTGGA GGAACTCTGT GATGTTTATT TTTTCACCCA GACCCTTGAC
    CAGTTGCACC ATATCGAGAG GACTTTTCGA GGTGATGTGT GTTACCTCTT GACAGAGCAG
    ATAAGCCGGG CTCTCCTAAA GCAACAGAGT GTCACCAACT TCCTCTTTGA GGATGTGTCT
    TTCCTGGATG AAAAACCTCC TGAAAAGCAG TACAGAGGCT GCCAGGGGCT CGGCCAAGAT
    GCCACAGATG AAAAGTGTTC GGAAGAGTCC CTTGCTCCTA AAGTGGTCAT CAGCCTGGGC
    TCCTACAAGT CCAGTGTGGA GTGCGTGCCC ATCAAGATGG AGCAGGAAAT TGAGGACTCT
    GAAGGACCCA AAATGTCTGA GTCCATGATG TCTGAGCACC AGGAGAACCT GGACTATCTG
    GATGCAGATA TCAAAGGCAG CATCAGTAGC GGGGAGAGCA TCGAGGTGCT TGGAACGGAG
    AAATCAGGAT CTGGGCTGAC AAAATCGGAG AGCCAGGCCA GCCTGCCCGT CATTCCCAGC
    CCCCAGGCCG GCCGGAGCAA GGTGGGCAGC CGGCGCACGG TCAGCGAGGA CAGCATCGAG
    GTGCTCAGCA CGTGTCCCTC CGAGTCCCTC ATCCCAGAGG ATTTCAAAGC GAGCTACCCA
    AGTGCCATTA ACGAGGAGCC CCACGCGGAT GACGATGAGG GAGGCCTTCG CTTCACCCCC
    AGACTGAACC CGGGCATCGA TGATGGGCAG GATGACATCT CAAAGCAGGA AAGCTTAGTG
    CAGGTGGATG CTGCCTGTTG TATCGGGAAG GAGAGCCCCA ACTTCCTGGA GCCGCTGCCC
    GAGCTGGGGC AGAAGCCGTG CGAGGAGGAC GGGGTGGTGC GGATCCCCCC GCAGCCGTAC
    CGGCCGGCCG AGCAGGGGCT GCGCGGGGGC TTCCCCTGCC ACGACGGCCT CTCGGGGGGG
    CTCCTGCCCT ACGAGCTCGA TTCGCGCTAC CTGACGGGCA GCAGGGAGGT GAGTAAGAGC
    AGCCTGGACG AGTGCTCGGA CTCCACGAGC TACATCAGCA GCGCCGCCTC CACGTGCTCC
    GACAGGACCC CCTCTCCCGC CCACCTGGGC TGCGCGGCCG GGGAAAGGCA CAGGAAGAAG
    GCCGGGCAGA ACGCGCTGCG CTTCATCCGC CAGTACCCCT TCGCCCACCC CGCCATCTAC
    TCCCTGCTCA GCGGGAGGAC CCTGGTAGTG CTGGGGGAGG ACGAGGCCAT GGTCAAGAGG
    CTCGTGACGG CGCTCTCCAT CTTCGTGCCC AGCTGCGGCG CGTACGCCAA GCCCGTGAAG
    CACTGGGTCA CTTCTGCTCT GCACTTGGTG GATTTCCAGA AGTGGAAGTT GGTTGGACTC
    CAGAGGGCAG TGTCCCCTGC TGGGGTGAAT GTGCTGCACG CCCTGAGCCG CTACAGCCGC
    TACCTGAGCA TCCTGGACGC CGACAGCAAG ACCCTGCGCT GCCCCCTCTA CAAGGGCACC
    GTGGTGGCCC GGCTGGCCGA CCACCGCACG CAGATCAAGC GTGGCAGCAC CTACTACATG
    CACGTCCAAA GCATCCTCAC CCAGCTGTGC TCTAAAGCCT TCCTCTTCAC CTTCTGCCAT
    CATTTGCACC TTCCCATCAG CGAAAGGGAA CCGGAGGAAT CCGTTGTGAA TCGCAGGATG
    AACTTCCTAA AGCTTCAACT GGGCCTTGCC AACGAAGATA TCAAAATCGT GCAGTACTTG
    GCCGAGCTGC TGAAGCTGCA CTACATTCAG GAACCGGGGC AGGGGGGGAA CCCCCTGCTC
    AGATTTGACT ATGTTCCCAG CTTTTTGTAC AAAATCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.