KIAA0355 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

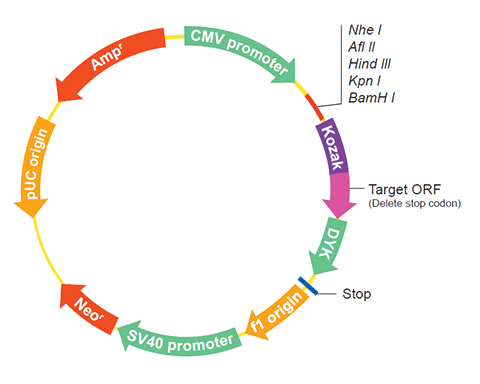
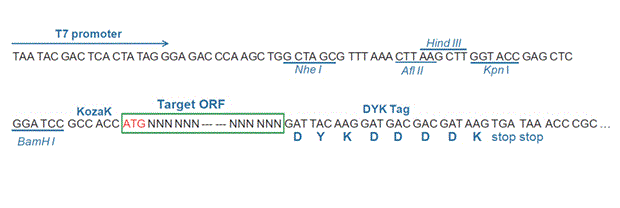
The following KIAA0355 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the KIAA0355 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs22864 XM_014258878.1
Latest version!
Pseudopodoces humilis KIAA0355 ortholog (KIAA0355), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OPs22864 XM_005530125.2
Latest version!
Pseudopodoces humilis KIAA0355 ortholog (KIAA0355), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs22864
    Clone ID Related Accession (Same CDS sequence) XM_005530125.2 , XM_014258878.1
    Accession Version XM_005530125.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3168bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product uncharacterized protein KIAA0355 homolog
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087622.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 21, 2015 this sequence version replaced XM_005530125.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGTATTGCT GCAGTGCACA AGAAAGCAAA ATGGACTATA AGCGGCGCTT TTTGCTTGGC 
    GGGTCCAAGC AGAAAGTGCA GCAACACCAG CAGTATCAAA TGCCCGAGCT GGGCAGGACC
    CTGAGCGCCC CGCTGGCATC GGCCACCCCC AGCACCCCCC TGGTGTCCCC GGCTGCTGCG
    GGCAGCTGCT CCCACCCCGC CTCCCACACG ACTCCCATCG CAGACATCCA GCAGGGAATC
    TCCAAATACC TGGATGCACT CAACGTGTTT TGCCGTACGA GCACTTTCCT CACAGACCTT
    TTCAGCAGCG TGTTTAGGAA CTCGCACTAC TCTAAGGCAG CTATGCAACT GAAAGACGTG
    CAGGAACATG TCATGGAAGC GGCGAGCCGA CTCACAGCAG CAATAAAACC AGAAATAGCA
    AAAATGCTGA TGGAACTGAG TGCAGGAGCT GCAAACTTCA AAGATCAAAA GGAGTTCAGC
    CTACAAGACA TTGAGGTACT TGGGCGATGT TTCTTGACAG TGATGCAGGT CCACTTCCAA
    TTCCTGTCAC AAGCTCTGCA GAAAGTCCAG CCTGTGGCAC ACTCCTGCTT TGCTGAAGCT
    GTGGCTCAGG AGAGGAAGAA CGTTAGTGGG ACTGGAGCCT CAAATATAAG CCCCACAAAT
    GAGCTGGAAG ATGCAATAAG ATCATGGAGA GGAGCAGCAG AGGCCACATC TCGACTGCGA
    GAAAGAGGCT GTGATGGATG TTTGGCAGGA ATTGAAGTTC AGCAACTTTT CTGCTCACAG
    AGTGTGGCCA TCCCTGAACA TCAGCTCAAA GAGCTAAACA TGAAAATTGA CAGTGCTTTG
    CAGGCTTACA AAGTGGCCCT GGAGAGCTTG GGTCATTGTG AATATGCAAT GAAGGCTGGC
    TTCCACTTGA ACCCAAAAGC GATTGAAGCA AGTCTTCAGG GCTGTTGCAG TGAAGCTGAA
    GCCCAGCAGA CAGGAAGGAG ACAGACTCCA CCTCAGCCCA TTCAGTGTGA GCTGCCCACT
    GTCCCTGTCC AGATCGGGTC CCATTTTCTG AAAGGAATCT CCTTCAATGA GTCTGCAGCA
    GAAAACCTGA AGCTGAAAAC GCACACAATG CTGCAGTTGA TCAAGGAAGC TGGATGCCAT
    AATGGACTCA CACCCCGTGA TGACTCTCCT GTGACTGAAG TACTGAACCA GGTCTGCCCT
    TCCACGTGGA GAGGAGCCTG CAAAACTGCT GTGCAGCTCT TGTTTGGCCA GGCTGGACTG
    GTGGTTGTGG ACACGGCACA GATTGAAAAT AAAGAAGCCT ATGCTCCTCA GATAAGTTTA
    GAAGGATCAA GAATTGTGGT GCAAGTTCCA TCAACTTGGT GTCTGAAAGA AGATCCAGCA
    ACGATGTCTT TGCTACAGAG GAGTCTGGAT CCGGAGAAGA CTTTGGGGCT GGTAGATGTG
    CTCTATACTG CTGTGTTTGA TATACACAGG TGGAAGGAAG GAAGGGAGCA AGCTTTGCCT
    TGTATTCAGA TCCAGTTACA GCGTGAAATC TCAGACTTTG GGAGCCAAGT TGACATGCCG
    TCGGGGAACG GAAGCAAATC TTCAGGGGGT CTGCAAAAGA CATTCTCAAA ACTGACTTCA
    CGGTTTACAA AAAAAACTTC CTGCACCAGT ACAAGTAACA CAGGAAGTTA CTCAATCCCC
    AATACACCTT CCAAAAATGT CTTCATAAGT TCCAGCTCAG AGGAGAAAGC TAAAATGCCC
    ACTAACATGG ATGCACGGTT GCAGAACATC CTGAACATTG GTAACTTCCC TCGGACCGCA
    GATGCCCTGC AGCCAGTTCA GAGCACAAAT AACCAGCTCG TCAATGGGTT TCTAGTGGAA
    AGACGGGACA GCTTCTTCAA ACCAGATGAT GGCAAGGATG ACAAAGGTAT GAATTTACCA
    ACTGACCAAG AAATGCAGGA TGTTATAGAT TTCTTGTCTG GTTTTAACAT GGGCAAATCC
    CAGCAGACTT CTCCGATGGT GAAAAGAAGG AACTCTGTTG CATCCTCTAC AGCAACAGAA
    CAAAAGTCAG GAGCAGTTCA ACAGCAGCCG CAGTCTGTGT CTCACACCCC GCTGCATCCT
    CCTCAGCAAG GCTTGTCCCA GCAGCAGTCC CAAAAACAGC AGCAGCAAAT GCAGTATTAT
    CAACACTTGC TTCAACCTAT TGGACCACAG CAACGTGTAC CTGCCAAATG GCTCAGTAAT
    TCTTCACAGC AGCAAGCCCC GGCTGTTGGA GCTGGATTGT CTCATATAAA TCAGTGGAAC
    AATCCTGGTT TTTCAGATTT AAGCTCTGAT TTGTACAGCC TGGGTCTTGT GAGCAGCTAT
    ATGGACAATA TGATGGCAGA AATGTTAGGA CAGAAACCAC AAGGACCTAG AAACAACACA
    TGGCCAAATC GTGACCAAAC TGATGGAGTG TTTGGGATGT TGGGAGAAAT CCTGCCTTTT
    GACCCTGCAG TTGGCTCTGA TCCAGAGTTT GCCCGCTATG TTGCTGGGGT GAACCAGGCT
    ATGCAACAGA AGAGGCAAGC ACAGCATGTC CGTCGTCCAA GCACCACGCG TGGCAACTGG
    CCTCTTCCTG ATGATCCTCA TAAAACCTGG CCCTTTCCTG AGTATTTCAC AGAGGGTGAT
    GTGACAAACA GCTGGTCTGG TACTCAAGGA GACTCTGCCA GCTCAAGTGA TGAGACCTCC
    TCAGCTAACG GAGACAGTTT GTTCTCCATG TTCTCAGGGC CAGACCTTGT TGCTGCTGTA
    AAGCAGAGGA GAAAACACAG CAGTGGCGAA CAGGAACCCA GCACACTGCC ATCGCCTCCT
    CTTCTCTCTG CAGCAGATGA CCGCAGTCAG GATAACAAGA CCAAAACCTG GCCTCCCAAG
    GCCCCGTGGC AGCACACATC CTCTGTGCCC AGCACGCTGC CCAGCCAGAG CACGTCCCTG
    TACCCCATGA GCAGCCCCAT GAGCCAGTGG AGCGACACCA TGCAGATGCT CCAGTCGCCC
    ATGTGGGCCA GCGACTGCGC CCCGGCAGCC GGCATCTCCT CCAGCTTCGC CTACGCGCAG
    CAGCAGCAGC AATCCCAACA GGCTTCCCAG CACAAACAGA TCAACAAGGG CTTCAAATCT
    TTCCCAGTAA AGCACGAACG CAGACCATCT TACCTGCACC AGTACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005530182.1
    CDS899..4066
    Translation

    Target ORF information:

    RefSeq Version XM_005530125.2
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis KIAA0355 ortholog (KIAA0355), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005530125.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGTATTGCT GCAGTGCACA AGAAAGCAAA ATGGACTATA AGCGGCGCTT TTTGCTTGGC 
    GGGTCCAAGC AGAAAGTGCA GCAACACCAG CAGTATCAAA TGCCCGAGCT GGGCAGGACC
    CTGAGCGCCC CGCTGGCATC GGCCACCCCC AGCACCCCCC TGGTGTCCCC GGCTGCTGCG
    GGCAGCTGCT CCCACCCCGC CTCCCACACG ACTCCCATCG CAGACATCCA GCAGGGAATC
    TCCAAATACC TGGATGCACT CAACGTGTTT TGCCGTACGA GCACTTTCCT CACAGACCTT
    TTCAGCAGCG TGTTTAGGAA CTCGCACTAC TCTAAGGCAG CTATGCAACT GAAAGACGTG
    CAGGAACATG TCATGGAAGC GGCGAGCCGA CTCACAGCAG CAATAAAACC AGAAATAGCA
    AAAATGCTGA TGGAACTGAG TGCAGGAGCT GCAAACTTCA AAGATCAAAA GGAGTTCAGC
    CTACAAGACA TTGAGGTACT TGGGCGATGT TTCTTGACAG TGATGCAGGT CCACTTCCAA
    TTCCTGTCAC AAGCTCTGCA GAAAGTCCAG CCTGTGGCAC ACTCCTGCTT TGCTGAAGCT
    GTGGCTCAGG AGAGGAAGAA CGTTAGTGGG ACTGGAGCCT CAAATATAAG CCCCACAAAT
    GAGCTGGAAG ATGCAATAAG ATCATGGAGA GGAGCAGCAG AGGCCACATC TCGACTGCGA
    GAAAGAGGCT GTGATGGATG TTTGGCAGGA ATTGAAGTTC AGCAACTTTT CTGCTCACAG
    AGTGTGGCCA TCCCTGAACA TCAGCTCAAA GAGCTAAACA TGAAAATTGA CAGTGCTTTG
    CAGGCTTACA AAGTGGCCCT GGAGAGCTTG GGTCATTGTG AATATGCAAT GAAGGCTGGC
    TTCCACTTGA ACCCAAAAGC GATTGAAGCA AGTCTTCAGG GCTGTTGCAG TGAAGCTGAA
    GCCCAGCAGA CAGGAAGGAG ACAGACTCCA CCTCAGCCCA TTCAGTGTGA GCTGCCCACT
    GTCCCTGTCC AGATCGGGTC CCATTTTCTG AAAGGAATCT CCTTCAATGA GTCTGCAGCA
    GAAAACCTGA AGCTGAAAAC GCACACAATG CTGCAGTTGA TCAAGGAAGC TGGATGCCAT
    AATGGACTCA CACCCCGTGA TGACTCTCCT GTGACTGAAG TACTGAACCA GGTCTGCCCT
    TCCACGTGGA GAGGAGCCTG CAAAACTGCT GTGCAGCTCT TGTTTGGCCA GGCTGGACTG
    GTGGTTGTGG ACACGGCACA GATTGAAAAT AAAGAAGCCT ATGCTCCTCA GATAAGTTTA
    GAAGGATCAA GAATTGTGGT GCAAGTTCCA TCAACTTGGT GTCTGAAAGA AGATCCAGCA
    ACGATGTCTT TGCTACAGAG GAGTCTGGAT CCGGAGAAGA CTTTGGGGCT GGTAGATGTG
    CTCTATACTG CTGTGTTTGA TATACACAGG TGGAAGGAAG GAAGGGAGCA AGCTTTGCCT
    TGTATTCAGA TCCAGTTACA GCGTGAAATC TCAGACTTTG GGAGCCAAGT TGACATGCCG
    TCGGGGAACG GAAGCAAATC TTCAGGGGGT CTGCAAAAGA CATTCTCAAA ACTGACTTCA
    CGGTTTACAA AAAAAACTTC CTGCACCAGT ACAAGTAACA CAGGAAGTTA CTCAATCCCC
    AATACACCTT CCAAAAATGT CTTCATAAGT TCCAGCTCAG AGGAGAAAGC TAAAATGCCC
    ACTAACATGG ATGCACGGTT GCAGAACATC CTGAACATTG GTAACTTCCC TCGGACCGCA
    GATGCCCTGC AGCCAGTTCA GAGCACAAAT AACCAGCTCG TCAATGGGTT TCTAGTGGAA
    AGACGGGACA GCTTCTTCAA ACCAGATGAT GGCAAGGATG ACAAAGGTAT GAATTTACCA
    ACTGACCAAG AAATGCAGGA TGTTATAGAT TTCTTGTCTG GTTTTAACAT GGGCAAATCC
    CAGCAGACTT CTCCGATGGT GAAAAGAAGG AACTCTGTTG CATCCTCTAC AGCAACAGAA
    CAAAAGTCAG GAGCAGTTCA ACAGCAGCCG CAGTCTGTGT CTCACACCCC GCTGCATCCT
    CCTCAGCAAG GCTTGTCCCA GCAGCAGTCC CAAAAACAGC AGCAGCAAAT GCAGTATTAT
    CAACACTTGC TTCAACCTAT TGGACCACAG CAACGTGTAC CTGCCAAATG GCTCAGTAAT
    TCTTCACAGC AGCAAGCCCC GGCTGTTGGA GCTGGATTGT CTCATATAAA TCAGTGGAAC
    AATCCTGGTT TTTCAGATTT AAGCTCTGAT TTGTACAGCC TGGGTCTTGT GAGCAGCTAT
    ATGGACAATA TGATGGCAGA AATGTTAGGA CAGAAACCAC AAGGACCTAG AAACAACACA
    TGGCCAAATC GTGACCAAAC TGATGGAGTG TTTGGGATGT TGGGAGAAAT CCTGCCTTTT
    GACCCTGCAG TTGGCTCTGA TCCAGAGTTT GCCCGCTATG TTGCTGGGGT GAACCAGGCT
    ATGCAACAGA AGAGGCAAGC ACAGCATGTC CGTCGTCCAA GCACCACGCG TGGCAACTGG
    CCTCTTCCTG ATGATCCTCA TAAAACCTGG CCCTTTCCTG AGTATTTCAC AGAGGGTGAT
    GTGACAAACA GCTGGTCTGG TACTCAAGGA GACTCTGCCA GCTCAAGTGA TGAGACCTCC
    TCAGCTAACG GAGACAGTTT GTTCTCCATG TTCTCAGGGC CAGACCTTGT TGCTGCTGTA
    AAGCAGAGGA GAAAACACAG CAGTGGCGAA CAGGAACCCA GCACACTGCC ATCGCCTCCT
    CTTCTCTCTG CAGCAGATGA CCGCAGTCAG GATAACAAGA CCAAAACCTG GCCTCCCAAG
    GCCCCGTGGC AGCACACATC CTCTGTGCCC AGCACGCTGC CCAGCCAGAG CACGTCCCTG
    TACCCCATGA GCAGCCCCAT GAGCCAGTGG AGCGACACCA TGCAGATGCT CCAGTCGCCC
    ATGTGGGCCA GCGACTGCGC CCCGGCAGCC GGCATCTCCT CCAGCTTCGC CTACGCGCAG
    CAGCAGCAGC AATCCCAACA GGCTTCCCAG CACAAACAGA TCAACAAGGG CTTCAAATCT
    TTCCCAGTAA AGCACGAACG CAGACCATCT TACCTGCACC AGTACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs22864
    Clone ID Related Accession (Same CDS sequence) XM_005530125.2 , XM_014258878.1
    Accession Version XM_014258878.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3168bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product uncharacterized protein KIAA0355 homolog
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087622.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGTATTGCT GCAGTGCACA AGAAAGCAAA ATGGACTATA AGCGGCGCTT TTTGCTTGGC 
    GGGTCCAAGC AGAAAGTGCA GCAACACCAG CAGTATCAAA TGCCCGAGCT GGGCAGGACC
    CTGAGCGCCC CGCTGGCATC GGCCACCCCC AGCACCCCCC TGGTGTCCCC GGCTGCTGCG
    GGCAGCTGCT CCCACCCCGC CTCCCACACG ACTCCCATCG CAGACATCCA GCAGGGAATC
    TCCAAATACC TGGATGCACT CAACGTGTTT TGCCGTACGA GCACTTTCCT CACAGACCTT
    TTCAGCAGCG TGTTTAGGAA CTCGCACTAC TCTAAGGCAG CTATGCAACT GAAAGACGTG
    CAGGAACATG TCATGGAAGC GGCGAGCCGA CTCACAGCAG CAATAAAACC AGAAATAGCA
    AAAATGCTGA TGGAACTGAG TGCAGGAGCT GCAAACTTCA AAGATCAAAA GGAGTTCAGC
    CTACAAGACA TTGAGGTACT TGGGCGATGT TTCTTGACAG TGATGCAGGT CCACTTCCAA
    TTCCTGTCAC AAGCTCTGCA GAAAGTCCAG CCTGTGGCAC ACTCCTGCTT TGCTGAAGCT
    GTGGCTCAGG AGAGGAAGAA CGTTAGTGGG ACTGGAGCCT CAAATATAAG CCCCACAAAT
    GAGCTGGAAG ATGCAATAAG ATCATGGAGA GGAGCAGCAG AGGCCACATC TCGACTGCGA
    GAAAGAGGCT GTGATGGATG TTTGGCAGGA ATTGAAGTTC AGCAACTTTT CTGCTCACAG
    AGTGTGGCCA TCCCTGAACA TCAGCTCAAA GAGCTAAACA TGAAAATTGA CAGTGCTTTG
    CAGGCTTACA AAGTGGCCCT GGAGAGCTTG GGTCATTGTG AATATGCAAT GAAGGCTGGC
    TTCCACTTGA ACCCAAAAGC GATTGAAGCA AGTCTTCAGG GCTGTTGCAG TGAAGCTGAA
    GCCCAGCAGA CAGGAAGGAG ACAGACTCCA CCTCAGCCCA TTCAGTGTGA GCTGCCCACT
    GTCCCTGTCC AGATCGGGTC CCATTTTCTG AAAGGAATCT CCTTCAATGA GTCTGCAGCA
    GAAAACCTGA AGCTGAAAAC GCACACAATG CTGCAGTTGA TCAAGGAAGC TGGATGCCAT
    AATGGACTCA CACCCCGTGA TGACTCTCCT GTGACTGAAG TACTGAACCA GGTCTGCCCT
    TCCACGTGGA GAGGAGCCTG CAAAACTGCT GTGCAGCTCT TGTTTGGCCA GGCTGGACTG
    GTGGTTGTGG ACACGGCACA GATTGAAAAT AAAGAAGCCT ATGCTCCTCA GATAAGTTTA
    GAAGGATCAA GAATTGTGGT GCAAGTTCCA TCAACTTGGT GTCTGAAAGA AGATCCAGCA
    ACGATGTCTT TGCTACAGAG GAGTCTGGAT CCGGAGAAGA CTTTGGGGCT GGTAGATGTG
    CTCTATACTG CTGTGTTTGA TATACACAGG TGGAAGGAAG GAAGGGAGCA AGCTTTGCCT
    TGTATTCAGA TCCAGTTACA GCGTGAAATC TCAGACTTTG GGAGCCAAGT TGACATGCCG
    TCGGGGAACG GAAGCAAATC TTCAGGGGGT CTGCAAAAGA CATTCTCAAA ACTGACTTCA
    CGGTTTACAA AAAAAACTTC CTGCACCAGT ACAAGTAACA CAGGAAGTTA CTCAATCCCC
    AATACACCTT CCAAAAATGT CTTCATAAGT TCCAGCTCAG AGGAGAAAGC TAAAATGCCC
    ACTAACATGG ATGCACGGTT GCAGAACATC CTGAACATTG GTAACTTCCC TCGGACCGCA
    GATGCCCTGC AGCCAGTTCA GAGCACAAAT AACCAGCTCG TCAATGGGTT TCTAGTGGAA
    AGACGGGACA GCTTCTTCAA ACCAGATGAT GGCAAGGATG ACAAAGGTAT GAATTTACCA
    ACTGACCAAG AAATGCAGGA TGTTATAGAT TTCTTGTCTG GTTTTAACAT GGGCAAATCC
    CAGCAGACTT CTCCGATGGT GAAAAGAAGG AACTCTGTTG CATCCTCTAC AGCAACAGAA
    CAAAAGTCAG GAGCAGTTCA ACAGCAGCCG CAGTCTGTGT CTCACACCCC GCTGCATCCT
    CCTCAGCAAG GCTTGTCCCA GCAGCAGTCC CAAAAACAGC AGCAGCAAAT GCAGTATTAT
    CAACACTTGC TTCAACCTAT TGGACCACAG CAACGTGTAC CTGCCAAATG GCTCAGTAAT
    TCTTCACAGC AGCAAGCCCC GGCTGTTGGA GCTGGATTGT CTCATATAAA TCAGTGGAAC
    AATCCTGGTT TTTCAGATTT AAGCTCTGAT TTGTACAGCC TGGGTCTTGT GAGCAGCTAT
    ATGGACAATA TGATGGCAGA AATGTTAGGA CAGAAACCAC AAGGACCTAG AAACAACACA
    TGGCCAAATC GTGACCAAAC TGATGGAGTG TTTGGGATGT TGGGAGAAAT CCTGCCTTTT
    GACCCTGCAG TTGGCTCTGA TCCAGAGTTT GCCCGCTATG TTGCTGGGGT GAACCAGGCT
    ATGCAACAGA AGAGGCAAGC ACAGCATGTC CGTCGTCCAA GCACCACGCG TGGCAACTGG
    CCTCTTCCTG ATGATCCTCA TAAAACCTGG CCCTTTCCTG AGTATTTCAC AGAGGGTGAT
    GTGACAAACA GCTGGTCTGG TACTCAAGGA GACTCTGCCA GCTCAAGTGA TGAGACCTCC
    TCAGCTAACG GAGACAGTTT GTTCTCCATG TTCTCAGGGC CAGACCTTGT TGCTGCTGTA
    AAGCAGAGGA GAAAACACAG CAGTGGCGAA CAGGAACCCA GCACACTGCC ATCGCCTCCT
    CTTCTCTCTG CAGCAGATGA CCGCAGTCAG GATAACAAGA CCAAAACCTG GCCTCCCAAG
    GCCCCGTGGC AGCACACATC CTCTGTGCCC AGCACGCTGC CCAGCCAGAG CACGTCCCTG
    TACCCCATGA GCAGCCCCAT GAGCCAGTGG AGCGACACCA TGCAGATGCT CCAGTCGCCC
    ATGTGGGCCA GCGACTGCGC CCCGGCAGCC GGCATCTCCT CCAGCTTCGC CTACGCGCAG
    CAGCAGCAGC AATCCCAACA GGCTTCCCAG CACAAACAGA TCAACAAGGG CTTCAAATCT
    TTCCCAGTAA AGCACGAACG CAGACCATCT TACCTGCACC AGTACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014114353.1
    CDS872..4039
    Translation

    Target ORF information:

    RefSeq Version XM_014258878.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis KIAA0355 ortholog (KIAA0355), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014258878.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGTATTGCT GCAGTGCACA AGAAAGCAAA ATGGACTATA AGCGGCGCTT TTTGCTTGGC 
    GGGTCCAAGC AGAAAGTGCA GCAACACCAG CAGTATCAAA TGCCCGAGCT GGGCAGGACC
    CTGAGCGCCC CGCTGGCATC GGCCACCCCC AGCACCCCCC TGGTGTCCCC GGCTGCTGCG
    GGCAGCTGCT CCCACCCCGC CTCCCACACG ACTCCCATCG CAGACATCCA GCAGGGAATC
    TCCAAATACC TGGATGCACT CAACGTGTTT TGCCGTACGA GCACTTTCCT CACAGACCTT
    TTCAGCAGCG TGTTTAGGAA CTCGCACTAC TCTAAGGCAG CTATGCAACT GAAAGACGTG
    CAGGAACATG TCATGGAAGC GGCGAGCCGA CTCACAGCAG CAATAAAACC AGAAATAGCA
    AAAATGCTGA TGGAACTGAG TGCAGGAGCT GCAAACTTCA AAGATCAAAA GGAGTTCAGC
    CTACAAGACA TTGAGGTACT TGGGCGATGT TTCTTGACAG TGATGCAGGT CCACTTCCAA
    TTCCTGTCAC AAGCTCTGCA GAAAGTCCAG CCTGTGGCAC ACTCCTGCTT TGCTGAAGCT
    GTGGCTCAGG AGAGGAAGAA CGTTAGTGGG ACTGGAGCCT CAAATATAAG CCCCACAAAT
    GAGCTGGAAG ATGCAATAAG ATCATGGAGA GGAGCAGCAG AGGCCACATC TCGACTGCGA
    GAAAGAGGCT GTGATGGATG TTTGGCAGGA ATTGAAGTTC AGCAACTTTT CTGCTCACAG
    AGTGTGGCCA TCCCTGAACA TCAGCTCAAA GAGCTAAACA TGAAAATTGA CAGTGCTTTG
    CAGGCTTACA AAGTGGCCCT GGAGAGCTTG GGTCATTGTG AATATGCAAT GAAGGCTGGC
    TTCCACTTGA ACCCAAAAGC GATTGAAGCA AGTCTTCAGG GCTGTTGCAG TGAAGCTGAA
    GCCCAGCAGA CAGGAAGGAG ACAGACTCCA CCTCAGCCCA TTCAGTGTGA GCTGCCCACT
    GTCCCTGTCC AGATCGGGTC CCATTTTCTG AAAGGAATCT CCTTCAATGA GTCTGCAGCA
    GAAAACCTGA AGCTGAAAAC GCACACAATG CTGCAGTTGA TCAAGGAAGC TGGATGCCAT
    AATGGACTCA CACCCCGTGA TGACTCTCCT GTGACTGAAG TACTGAACCA GGTCTGCCCT
    TCCACGTGGA GAGGAGCCTG CAAAACTGCT GTGCAGCTCT TGTTTGGCCA GGCTGGACTG
    GTGGTTGTGG ACACGGCACA GATTGAAAAT AAAGAAGCCT ATGCTCCTCA GATAAGTTTA
    GAAGGATCAA GAATTGTGGT GCAAGTTCCA TCAACTTGGT GTCTGAAAGA AGATCCAGCA
    ACGATGTCTT TGCTACAGAG GAGTCTGGAT CCGGAGAAGA CTTTGGGGCT GGTAGATGTG
    CTCTATACTG CTGTGTTTGA TATACACAGG TGGAAGGAAG GAAGGGAGCA AGCTTTGCCT
    TGTATTCAGA TCCAGTTACA GCGTGAAATC TCAGACTTTG GGAGCCAAGT TGACATGCCG
    TCGGGGAACG GAAGCAAATC TTCAGGGGGT CTGCAAAAGA CATTCTCAAA ACTGACTTCA
    CGGTTTACAA AAAAAACTTC CTGCACCAGT ACAAGTAACA CAGGAAGTTA CTCAATCCCC
    AATACACCTT CCAAAAATGT CTTCATAAGT TCCAGCTCAG AGGAGAAAGC TAAAATGCCC
    ACTAACATGG ATGCACGGTT GCAGAACATC CTGAACATTG GTAACTTCCC TCGGACCGCA
    GATGCCCTGC AGCCAGTTCA GAGCACAAAT AACCAGCTCG TCAATGGGTT TCTAGTGGAA
    AGACGGGACA GCTTCTTCAA ACCAGATGAT GGCAAGGATG ACAAAGGTAT GAATTTACCA
    ACTGACCAAG AAATGCAGGA TGTTATAGAT TTCTTGTCTG GTTTTAACAT GGGCAAATCC
    CAGCAGACTT CTCCGATGGT GAAAAGAAGG AACTCTGTTG CATCCTCTAC AGCAACAGAA
    CAAAAGTCAG GAGCAGTTCA ACAGCAGCCG CAGTCTGTGT CTCACACCCC GCTGCATCCT
    CCTCAGCAAG GCTTGTCCCA GCAGCAGTCC CAAAAACAGC AGCAGCAAAT GCAGTATTAT
    CAACACTTGC TTCAACCTAT TGGACCACAG CAACGTGTAC CTGCCAAATG GCTCAGTAAT
    TCTTCACAGC AGCAAGCCCC GGCTGTTGGA GCTGGATTGT CTCATATAAA TCAGTGGAAC
    AATCCTGGTT TTTCAGATTT AAGCTCTGAT TTGTACAGCC TGGGTCTTGT GAGCAGCTAT
    ATGGACAATA TGATGGCAGA AATGTTAGGA CAGAAACCAC AAGGACCTAG AAACAACACA
    TGGCCAAATC GTGACCAAAC TGATGGAGTG TTTGGGATGT TGGGAGAAAT CCTGCCTTTT
    GACCCTGCAG TTGGCTCTGA TCCAGAGTTT GCCCGCTATG TTGCTGGGGT GAACCAGGCT
    ATGCAACAGA AGAGGCAAGC ACAGCATGTC CGTCGTCCAA GCACCACGCG TGGCAACTGG
    CCTCTTCCTG ATGATCCTCA TAAAACCTGG CCCTTTCCTG AGTATTTCAC AGAGGGTGAT
    GTGACAAACA GCTGGTCTGG TACTCAAGGA GACTCTGCCA GCTCAAGTGA TGAGACCTCC
    TCAGCTAACG GAGACAGTTT GTTCTCCATG TTCTCAGGGC CAGACCTTGT TGCTGCTGTA
    AAGCAGAGGA GAAAACACAG CAGTGGCGAA CAGGAACCCA GCACACTGCC ATCGCCTCCT
    CTTCTCTCTG CAGCAGATGA CCGCAGTCAG GATAACAAGA CCAAAACCTG GCCTCCCAAG
    GCCCCGTGGC AGCACACATC CTCTGTGCCC AGCACGCTGC CCAGCCAGAG CACGTCCCTG
    TACCCCATGA GCAGCCCCAT GAGCCAGTGG AGCGACACCA TGCAGATGCT CCAGTCGCCC
    ATGTGGGCCA GCGACTGCGC CCCGGCAGCC GGCATCTCCT CCAGCTTCGC CTACGCGCAG
    CAGCAGCAGC AATCCCAACA GGCTTCCCAG CACAAACAGA TCAACAAGGG CTTCAAATCT
    TTCCCAGTAA AGCACGAACG CAGACCATCT TACCTGCACC AGTACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.