HIPK2 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

The following HIPK2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the HIPK2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs19967 XM_005527893.2
Latest version!
Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OPs19968 XM_014256865.1
Latest version!
Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OPs19968 XM_014256864.1
Latest version!
Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OPs19969 XM_005527894.2
Latest version!
Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs19967
    Clone ID Related Accession (Same CDS sequence) XM_005527893.2
    Accession Version XM_005527893.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3618bp)
    Protein sequence
    SNP
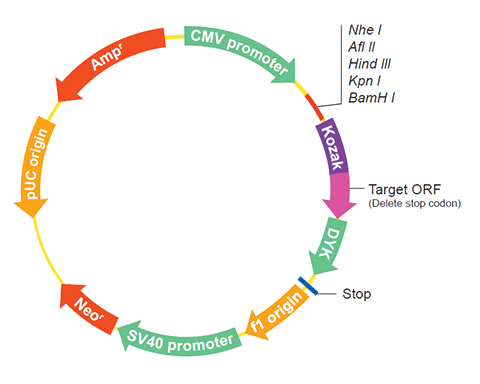
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
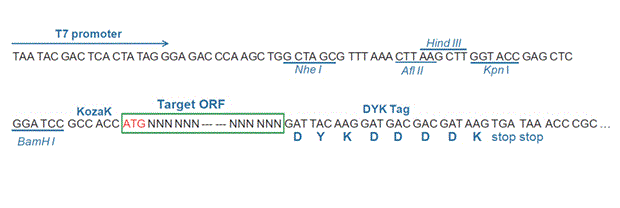
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product homeodomain-interacting protein kinase 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087595.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 21, 2015 this sequence version replaced XM_005527893.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGCCCCCA TGTACGAAGG TATGGCCTCG CATGTGCAAG TTTTCTCTCC TCATACCCTT 
    CAGTCAAGTG CCTTCTGTAG CGTGAAGAAA CTGAAAGTGG AGCCGAGTTC GAACTGGGAT
    ATGACTGGGT ACGGCACACA CAGCAAAGTC TACAACCAGA GCAAGAACGT GCAGTCCTCC
    CAAGCAGCCG CCGCAGCAGC CGTCAACGCC TCCCTCCAGA TCCCCAATCC GAGCATCCCT
    TACGAGCAGA CCATCATCTT CCCAGCAAGC ACGGGGCACA TTGTGGTTAC ATCTGCCAAC
    AGCACTTCTG GTGTGGTTGC AGTGTCTGGG CAAACACTGG GCGGGCCACA CAACCTGATG
    CGTCGCAGCA CTGTGAGCCT TCTGGACACC TACCAAAAAT GTGGACTTAA GCGCAAGAGC
    GAGGAGATCG AGAACACAAG CAGCGTGCAG ATTATCGAGG AGCATCCGCC AATGATTCAG
    AACAATGCCA GTGGGGCCAC TGTAGCCACC GCCACCACCT CCACGGCCAC TTCCAAAAAC
    AGTGGTTCCA ACAGTGAAGG GGATTACCAG CTGGTGCAAC ATGAGGTGCT CTGTTCCATG
    ACCAACACAT ACGAAGTGTT AGAATTTCTT GGCCGTGGAA CCTTCGGACA AGTAGTCAAA
    TGCTGGAAAC GTGGCACTAA TGAGATTGTG GCTATCAAGA TCCTAAAAAA CCACCCTTCT
    TATGCCCGGC AAGGCCAGAT TGAAGTGAGC ATCCTGGCTC GGCTGAGCAC AGAAAGCGCG
    GATGACTACA ACTTTGTCCG TGCTTACGAA TGCTTCCAGC ACAAGAATCA CACATGCTTG
    GTATTTGAAA TGTTGGAGCA GAACCTCTAT GATTTCTTAA AACAAAATAA ATTCAGTCCC
    TTGCCCCTTA AGTACATTCG ACCAATTCTC CAGCAGGTAG CAACTGCCCT AATGAAGCTG
    AAAAGCCTGG GACTGATTCA TGCTGATCTC AAACCAGAGA ACATCATGCT GGTAGACCCA
    TCCCGACAGC CCTATAGGGT CAAGGTCATA GACTTTGGTT CAGCTAGCCA TGTGTCCAAA
    GCTGTGTGTT CTACTTACCT TCAATCCAGA TACTACAGAG CCCCTGAAAT CATCCTCGGT
    TTACCCTTTT GTGAAGCAAT CGATATGTGG TCATTGGGAT GTGTCATTGC AGAGCTGTTC
    TTGGGCTGGC CCTTGTACCC AGGAGCTTCA GAGTACGATC AGATTCGCTA CATTTCACAG
    ACGCAGGGCT TACCAGCAGA GTATTTGTTA AGTGCAGGGA CAAAGACCAC GAGGTTTTTC
    AACAGGGATA CAGACTCACC ATATCCCTTG TGGAGGCTGA AGACGCCAGA TGACCATGAG
    GCAGAGACGG GGATTAAGTC AAAGGAAGCA AGAAAGTATA TTTTCAACTG TTTGGATGAT
    ATGGCACAGG TAAACATGAC AACGGATTTG GAAGGAAGCG ATATGTTGGT GGAAAAGGCA
    GACCGGCGGG AGTTCATAGA TCTGTTAAAG AAGATGTTGA CGATAGACGC GGATAAGAGG
    ATAACACCCA TTGAAACTCT GAGCCACCCT TTTGTCACCA TGACGCACTT GCTCGACTTC
    CCTCACAGCA CACATGTCAA GTCCTGCTTC CAGAACATGG AGATTTGCAA GCGGCGGGTG
    AATATGTACG ACACGGTGAA CCAGAGCAAG ACGCCATTCA TCACCCACGT AGCCCCAAGT
    ACATCGACCA ACCTGACCAT GACTTTTAAC AACCAGCTGA ACACAGTCCA CAACCAGACC
    ACCAACCTGG CTCCCACCTC CTCCAGTGCC ACTATTTCCT TAGCCAACCC CGAGGTCTCC
    ATACTAAATT ACCAATCTGC ACTCTACCAG CCCTCAGCGG CGTCCATGGC TGCGGTGGCC
    CAGCGGAGCA TGCCCCTGCA GACGGGAACA GCGCAGATCT GTGCCCGGCC TGACCCCTTA
    CAGCAAGCCC TCATCGTCTG CCCACCAGGC TTCCAAGGGT TACAAGCCTC CCCTTCGAAG
    CACGCTGGGT ACTCGGTTCG GATGGAGAAC GCCGTTCCCA TTGTCACTCA GGCTCCTGGG
    GCTCAGCCTC TTCAGATCCA GCCAGGACTC CTCGCACAGC AAGCATGGCC CAGTGGCACT
    CAGCAGATCC TGCTCCCCCC CGCCTGGCAG CAGCTGACCG GAGTGGCCAC CCACACCTCT
    GTCCAGCACG CGACCGTCAT CCCGGAGTCC ATGGCAGGCA CCCAACCGCT GGCAGACTGG
    AGGAACACGC ATGCCCACGG CAGCCACTAC AACCCCATCA TGCAGCAGAC CACGCTGCTG
    GCCAGCCACG TGGCCCTGCC CGCCGCCCAG CCCGTCAACG TGGGTGTCGC TCACGTCATG
    CGCCAGCCGC CCGCCGCCGC CTCTGCCAGG AAAAGCAAGC AGCACCAGTC GGCTCCACGC
    AATGCATCCA CCTATGAAGT TTCATCCTCT CAGTCCATCA GCTCGCCCCA GCGGTCGAAA
    CGAGTGAAGG AGAACACCCC TCCCCGCTGT GCCATGGTGC ACAACAGCCC TGCCTGCAGC
    ACCTCGGTCA CCTGCGGCTG GGGCGACGTG GCCACGAGCA GCACGCGGGA GCGGCAGCGG
    CAGACGATCG TCATCCCCGA CACCCCCAGC CCCGCCGTCA GCGTCATCAC CATCAGCAGC
    GACACAGACG AAGAGGAAGA GCAGAAGCAT GCACCCACCA GCACCTTGTC CAAGCAAAGG
    AAGAATGTCA TCAGCTGTGT CACCGTGCAT GACTCCCCCT ACTCCGATTC CTCCAGCAAC
    AACAGCCCTT ACGCCGTGCA ACATCGCACA GGGCAGAATA ATGGGAACAG CTACGACACC
    AAAGGGGTTC CAGAGACTCA CTGCAGTGGG AACCCCCGAA CGATCATCGT GCCACCACTG
    AAAACCCAGG CCAGTGAGGT GTTGGTAGAG TGCGATAGCC TGGCACCAGT CACCACCAGT
    CACCACTCAT CCTCCTACAA GTCCAAGTCC TCCAGCACCG TGACCTCCAC CAGCGGTCAC
    TCTTCAGGGA GCTCGTCTGG AGCCGTTGCC TATAGGCAGC AGCGACCAGG AGCACATTTC
    CAGCAGCAGC AGCCTCTTAA TCTAAGTCAG GGCCAGCAGC ACATCTCGAC CGACCGCACA
    GGGAGTCACC GGAGACAGCA AGCCTACATC ACTCCAACGA TAGCTCAGGC CCCGTACTCT
    TTCCCGCACA ATAGCCCCAG CCACGGTACA GTTCATCCCC ACCTGGCCGC GGCTGCCGCT
    GCTCACCTGC CCACCCAGCC CCACCTGTAC ACATACACCG CCCCCGCCGC CCTGGGCTCC
    ACGGGCACCG TCGCGCACCT GGTGGCCTCG CAAGGCTCCG CCCGGCACGC GGTGCAGCAC
    ACCACCTACC CCGCCAGCAT CGTCCACCAG GTCCCCGTCA GCATGGGCCC GCGCGTCCTG
    CCCTCTCCCA CCATCCACCC GAGTCAGTAC CAGGCTCAGT TTGCCCATCA GACCTATATC
    AGTGCTTCTC CAGCCTCCAC AGTCTACACT GGATACCCAC TGAGCCCCAC CAAGGTCAAC
    CAGTACCCTT ACATCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005527950.2
    CDS215..3832
    Translation

    Target ORF information:

    RefSeq Version XM_005527893.2
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005527893.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGCCCCCA TGTACGAAGG TATGGCCTCG CATGTGCAAG TTTTCTCTCC TCATACCCTT 
    CAGTCAAGTG CCTTCTGTAG CGTGAAGAAA CTGAAAGTGG AGCCGAGTTC GAACTGGGAT
    ATGACTGGGT ACGGCACACA CAGCAAAGTC TACAACCAGA GCAAGAACGT GCAGTCCTCC
    CAAGCAGCCG CCGCAGCAGC CGTCAACGCC TCCCTCCAGA TCCCCAATCC GAGCATCCCT
    TACGAGCAGA CCATCATCTT CCCAGCAAGC ACGGGGCACA TTGTGGTTAC ATCTGCCAAC
    AGCACTTCTG GTGTGGTTGC AGTGTCTGGG CAAACACTGG GCGGGCCACA CAACCTGATG
    CGTCGCAGCA CTGTGAGCCT TCTGGACACC TACCAAAAAT GTGGACTTAA GCGCAAGAGC
    GAGGAGATCG AGAACACAAG CAGCGTGCAG ATTATCGAGG AGCATCCGCC AATGATTCAG
    AACAATGCCA GTGGGGCCAC TGTAGCCACC GCCACCACCT CCACGGCCAC TTCCAAAAAC
    AGTGGTTCCA ACAGTGAAGG GGATTACCAG CTGGTGCAAC ATGAGGTGCT CTGTTCCATG
    ACCAACACAT ACGAAGTGTT AGAATTTCTT GGCCGTGGAA CCTTCGGACA AGTAGTCAAA
    TGCTGGAAAC GTGGCACTAA TGAGATTGTG GCTATCAAGA TCCTAAAAAA CCACCCTTCT
    TATGCCCGGC AAGGCCAGAT TGAAGTGAGC ATCCTGGCTC GGCTGAGCAC AGAAAGCGCG
    GATGACTACA ACTTTGTCCG TGCTTACGAA TGCTTCCAGC ACAAGAATCA CACATGCTTG
    GTATTTGAAA TGTTGGAGCA GAACCTCTAT GATTTCTTAA AACAAAATAA ATTCAGTCCC
    TTGCCCCTTA AGTACATTCG ACCAATTCTC CAGCAGGTAG CAACTGCCCT AATGAAGCTG
    AAAAGCCTGG GACTGATTCA TGCTGATCTC AAACCAGAGA ACATCATGCT GGTAGACCCA
    TCCCGACAGC CCTATAGGGT CAAGGTCATA GACTTTGGTT CAGCTAGCCA TGTGTCCAAA
    GCTGTGTGTT CTACTTACCT TCAATCCAGA TACTACAGAG CCCCTGAAAT CATCCTCGGT
    TTACCCTTTT GTGAAGCAAT CGATATGTGG TCATTGGGAT GTGTCATTGC AGAGCTGTTC
    TTGGGCTGGC CCTTGTACCC AGGAGCTTCA GAGTACGATC AGATTCGCTA CATTTCACAG
    ACGCAGGGCT TACCAGCAGA GTATTTGTTA AGTGCAGGGA CAAAGACCAC GAGGTTTTTC
    AACAGGGATA CAGACTCACC ATATCCCTTG TGGAGGCTGA AGACGCCAGA TGACCATGAG
    GCAGAGACGG GGATTAAGTC AAAGGAAGCA AGAAAGTATA TTTTCAACTG TTTGGATGAT
    ATGGCACAGG TAAACATGAC AACGGATTTG GAAGGAAGCG ATATGTTGGT GGAAAAGGCA
    GACCGGCGGG AGTTCATAGA TCTGTTAAAG AAGATGTTGA CGATAGACGC GGATAAGAGG
    ATAACACCCA TTGAAACTCT GAGCCACCCT TTTGTCACCA TGACGCACTT GCTCGACTTC
    CCTCACAGCA CACATGTCAA GTCCTGCTTC CAGAACATGG AGATTTGCAA GCGGCGGGTG
    AATATGTACG ACACGGTGAA CCAGAGCAAG ACGCCATTCA TCACCCACGT AGCCCCAAGT
    ACATCGACCA ACCTGACCAT GACTTTTAAC AACCAGCTGA ACACAGTCCA CAACCAGACC
    ACCAACCTGG CTCCCACCTC CTCCAGTGCC ACTATTTCCT TAGCCAACCC CGAGGTCTCC
    ATACTAAATT ACCAATCTGC ACTCTACCAG CCCTCAGCGG CGTCCATGGC TGCGGTGGCC
    CAGCGGAGCA TGCCCCTGCA GACGGGAACA GCGCAGATCT GTGCCCGGCC TGACCCCTTA
    CAGCAAGCCC TCATCGTCTG CCCACCAGGC TTCCAAGGGT TACAAGCCTC CCCTTCGAAG
    CACGCTGGGT ACTCGGTTCG GATGGAGAAC GCCGTTCCCA TTGTCACTCA GGCTCCTGGG
    GCTCAGCCTC TTCAGATCCA GCCAGGACTC CTCGCACAGC AAGCATGGCC CAGTGGCACT
    CAGCAGATCC TGCTCCCCCC CGCCTGGCAG CAGCTGACCG GAGTGGCCAC CCACACCTCT
    GTCCAGCACG CGACCGTCAT CCCGGAGTCC ATGGCAGGCA CCCAACCGCT GGCAGACTGG
    AGGAACACGC ATGCCCACGG CAGCCACTAC AACCCCATCA TGCAGCAGAC CACGCTGCTG
    GCCAGCCACG TGGCCCTGCC CGCCGCCCAG CCCGTCAACG TGGGTGTCGC TCACGTCATG
    CGCCAGCCGC CCGCCGCCGC CTCTGCCAGG AAAAGCAAGC AGCACCAGTC GGCTCCACGC
    AATGCATCCA CCTATGAAGT TTCATCCTCT CAGTCCATCA GCTCGCCCCA GCGGTCGAAA
    CGAGTGAAGG AGAACACCCC TCCCCGCTGT GCCATGGTGC ACAACAGCCC TGCCTGCAGC
    ACCTCGGTCA CCTGCGGCTG GGGCGACGTG GCCACGAGCA GCACGCGGGA GCGGCAGCGG
    CAGACGATCG TCATCCCCGA CACCCCCAGC CCCGCCGTCA GCGTCATCAC CATCAGCAGC
    GACACAGACG AAGAGGAAGA GCAGAAGCAT GCACCCACCA GCACCTTGTC CAAGCAAAGG
    AAGAATGTCA TCAGCTGTGT CACCGTGCAT GACTCCCCCT ACTCCGATTC CTCCAGCAAC
    AACAGCCCTT ACGCCGTGCA ACATCGCACA GGGCAGAATA ATGGGAACAG CTACGACACC
    AAAGGGGTTC CAGAGACTCA CTGCAGTGGG AACCCCCGAA CGATCATCGT GCCACCACTG
    AAAACCCAGG CCAGTGAGGT GTTGGTAGAG TGCGATAGCC TGGCACCAGT CACCACCAGT
    CACCACTCAT CCTCCTACAA GTCCAAGTCC TCCAGCACCG TGACCTCCAC CAGCGGTCAC
    TCTTCAGGGA GCTCGTCTGG AGCCGTTGCC TATAGGCAGC AGCGACCAGG AGCACATTTC
    CAGCAGCAGC AGCCTCTTAA TCTAAGTCAG GGCCAGCAGC ACATCTCGAC CGACCGCACA
    GGGAGTCACC GGAGACAGCA AGCCTACATC ACTCCAACGA TAGCTCAGGC CCCGTACTCT
    TTCCCGCACA ATAGCCCCAG CCACGGTACA GTTCATCCCC ACCTGGCCGC GGCTGCCGCT
    GCTCACCTGC CCACCCAGCC CCACCTGTAC ACATACACCG CCCCCGCCGC CCTGGGCTCC
    ACGGGCACCG TCGCGCACCT GGTGGCCTCG CAAGGCTCCG CCCGGCACGC GGTGCAGCAC
    ACCACCTACC CCGCCAGCAT CGTCCACCAG GTCCCCGTCA GCATGGGCCC GCGCGTCCTG
    CCCTCTCCCA CCATCCACCC GAGTCAGTAC CAGGCTCAGT TTGCCCATCA GACCTATATC
    AGTGCTTCTC CAGCCTCCAC AGTCTACACT GGATACCCAC TGAGCCCCAC CAAGGTCAAC
    CAGTACCCTT ACATCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs19968
    Clone ID Related Accession (Same CDS sequence) XM_014256864.1 , XM_014256865.1
    Accession Version XM_014256864.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3597bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product homeodomain-interacting protein kinase 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087595.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGGCCTCGC ATGTGCAAGT TTTCTCTCCT CATACCCTTC AGTCAAGTGC CTTCTGTAGC 
    GTGAAGAAAC TGAAAGTGGA GCCGAGTTCG AACTGGGATA TGACTGGGTA CGGCACACAC
    AGCAAAGTCT ACAACCAGAG CAAGAACGTG CAGTCCTCCC AAGCAGCCGC CGCAGCAGCC
    GTCAACGCCT CCCTCCAGAT CCCCAATCCG AGCATCCCTT ACGAGCAGAC CATCATCTTC
    CCAGCAAGCA CGGGGCACAT TGTGGTTACA TCTGCCAACA GCACTTCTGG TGTGGTTGCA
    GTGTCTGGGC AAACACTGGG CGGGCCACAC AACCTGATGC GTCGCAGCAC TGTGAGCCTT
    CTGGACACCT ACCAAAAATG TGGACTTAAG CGCAAGAGCG AGGAGATCGA GAACACAAGC
    AGCGTGCAGA TTATCGAGGA GCATCCGCCA ATGATTCAGA ACAATGCCAG TGGGGCCACT
    GTAGCCACCG CCACCACCTC CACGGCCACT TCCAAAAACA GTGGTTCCAA CAGTGAAGGG
    GATTACCAGC TGGTGCAACA TGAGGTGCTC TGTTCCATGA CCAACACATA CGAAGTGTTA
    GAATTTCTTG GCCGTGGAAC CTTCGGACAA GTAGTCAAAT GCTGGAAACG TGGCACTAAT
    GAGATTGTGG CTATCAAGAT CCTAAAAAAC CACCCTTCTT ATGCCCGGCA AGGCCAGATT
    GAAGTGAGCA TCCTGGCTCG GCTGAGCACA GAAAGCGCGG ATGACTACAA CTTTGTCCGT
    GCTTACGAAT GCTTCCAGCA CAAGAATCAC ACATGCTTGG TATTTGAAAT GTTGGAGCAG
    AACCTCTATG ATTTCTTAAA ACAAAATAAA TTCAGTCCCT TGCCCCTTAA GTACATTCGA
    CCAATTCTCC AGCAGGTAGC AACTGCCCTA ATGAAGCTGA AAAGCCTGGG ACTGATTCAT
    GCTGATCTCA AACCAGAGAA CATCATGCTG GTAGACCCAT CCCGACAGCC CTATAGGGTC
    AAGGTCATAG ACTTTGGTTC AGCTAGCCAT GTGTCCAAAG CTGTGTGTTC TACTTACCTT
    CAATCCAGAT ACTACAGAGC CCCTGAAATC ATCCTCGGTT TACCCTTTTG TGAAGCAATC
    GATATGTGGT CATTGGGATG TGTCATTGCA GAGCTGTTCT TGGGCTGGCC CTTGTACCCA
    GGAGCTTCAG AGTACGATCA GATTCGCTAC ATTTCACAGA CGCAGGGCTT ACCAGCAGAG
    TATTTGTTAA GTGCAGGGAC AAAGACCACG AGGTTTTTCA ACAGGGATAC AGACTCACCA
    TATCCCTTGT GGAGGCTGAA GACGCCAGAT GACCATGAGG CAGAGACGGG GATTAAGTCA
    AAGGAAGCAA GAAAGTATAT TTTCAACTGT TTGGATGATA TGGCACAGGT AAACATGACA
    ACGGATTTGG AAGGAAGCGA TATGTTGGTG GAAAAGGCAG ACCGGCGGGA GTTCATAGAT
    CTGTTAAAGA AGATGTTGAC GATAGACGCG GATAAGAGGA TAACACCCAT TGAAACTCTG
    AGCCACCCTT TTGTCACCAT GACGCACTTG CTCGACTTCC CTCACAGCAC ACATGTCAAG
    TCCTGCTTCC AGAACATGGA GATTTGCAAG CGGCGGGTGA ATATGTACGA CACGGTGAAC
    CAGAGCAAGA CGCCATTCAT CACCCACGTA GCCCCAAGTA CATCGACCAA CCTGACCATG
    ACTTTTAACA ACCAGCTGAA CACAGTCCAC AACCAGACCA CCAACCTGGC TCCCACCTCC
    TCCAGTGCCA CTATTTCCTT AGCCAACCCC GAGGTCTCCA TACTAAATTA CCAATCTGCA
    CTCTACCAGC CCTCAGCGGC GTCCATGGCT GCGGTGGCCC AGCGGAGCAT GCCCCTGCAG
    ACGGGAACAG CGCAGATCTG TGCCCGGCCT GACCCCTTAC AGCAAGCCCT CATCGTCTGC
    CCACCAGGCT TCCAAGGGTT ACAAGCCTCC CCTTCGAAGC ACGCTGGGTA CTCGGTTCGG
    ATGGAGAACG CCGTTCCCAT TGTCACTCAG GCTCCTGGGG CTCAGCCTCT TCAGATCCAG
    CCAGGACTCC TCGCACAGCA AGCATGGCCC AGTGGCACTC AGCAGATCCT GCTCCCCCCC
    GCCTGGCAGC AGCTGACCGG AGTGGCCACC CACACCTCTG TCCAGCACGC GACCGTCATC
    CCGGAGTCCA TGGCAGGCAC CCAACCGCTG GCAGACTGGA GGAACACGCA TGCCCACGGC
    AGCCACTACA ACCCCATCAT GCAGCAGACC ACGCTGCTGG CCAGCCACGT GGCCCTGCCC
    GCCGCCCAGC CCGTCAACGT GGGTGTCGCT CACGTCATGC GCCAGCCGCC CGCCGCCGCC
    TCTGCCAGGA AAAGCAAGCA GCACCAGTCG GCTCCACGCA ATGCATCCAC CTATGAAGTT
    TCATCCTCTC AGTCCATCAG CTCGCCCCAG CGGTCGAAAC GAGTGAAGGA GAACACCCCT
    CCCCGCTGTG CCATGGTGCA CAACAGCCCT GCCTGCAGCA CCTCGGTCAC CTGCGGCTGG
    GGCGACGTGG CCACGAGCAG CACGCGGGAG CGGCAGCGGC AGACGATCGT CATCCCCGAC
    ACCCCCAGCC CCGCCGTCAG CGTCATCACC ATCAGCAGCG ACACAGACGA AGAGGAAGAG
    CAGAAGCATG CACCCACCAG CACCTTGTCC AAGCAAAGGA AGAATGTCAT CAGCTGTGTC
    ACCGTGCATG ACTCCCCCTA CTCCGATTCC TCCAGCAACA ACAGCCCTTA CGCCGTGCAA
    CATCGCACAG GGCAGAATAA TGGGAACAGC TACGACACCA AAGGGGTTCC AGAGACTCAC
    TGCAGTGGGA ACCCCCGAAC GATCATCGTG CCACCACTGA AAACCCAGGC CAGTGAGGTG
    TTGGTAGAGT GCGATAGCCT GGCACCAGTC ACCACCAGTC ACCACTCATC CTCCTACAAG
    TCCAAGTCCT CCAGCACCGT GACCTCCACC AGCGGTCACT CTTCAGGGAG CTCGTCTGGA
    GCCGTTGCCT ATAGGCAGCA GCGACCAGGA GCACATTTCC AGCAGCAGCA GCCTCTTAAT
    CTAAGTCAGG GCCAGCAGCA CATCTCGACC GACCGCACAG GGAGTCACCG GAGACAGCAA
    GCCTACATCA CTCCAACGAT AGCTCAGGCC CCGTACTCTT TCCCGCACAA TAGCCCCAGC
    CACGGTACAG TTCATCCCCA CCTGGCCGCG GCTGCCGCTG CTCACCTGCC CACCCAGCCC
    CACCTGTACA CATACACCGC CCCCGCCGCC CTGGGCTCCA CGGGCACCGT CGCGCACCTG
    GTGGCCTCGC AAGGCTCCGC CCGGCACGCG GTGCAGCACA CCACCTACCC CGCCAGCATC
    GTCCACCAGG TCCCCGTCAG CATGGGCCCG CGCGTCCTGC CCTCTCCCAC CATCCACCCG
    AGTCAGTACC AGGCTCAGTT TGCCCATCAG ACCTATATCA GTGCTTCTCC AGCCTCCACA
    GTCTACACTG GATACCCACT GAGCCCCACC AAGGTCAACC AGTACCCTTA CATCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014112339.1
    CDS414..4010
    Translation

    Target ORF information:

    RefSeq Version XM_014256864.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014256864.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGGCCTCGC ATGTGCAAGT TTTCTCTCCT CATACCCTTC AGTCAAGTGC CTTCTGTAGC 
    GTGAAGAAAC TGAAAGTGGA GCCGAGTTCG AACTGGGATA TGACTGGGTA CGGCACACAC
    AGCAAAGTCT ACAACCAGAG CAAGAACGTG CAGTCCTCCC AAGCAGCCGC CGCAGCAGCC
    GTCAACGCCT CCCTCCAGAT CCCCAATCCG AGCATCCCTT ACGAGCAGAC CATCATCTTC
    CCAGCAAGCA CGGGGCACAT TGTGGTTACA TCTGCCAACA GCACTTCTGG TGTGGTTGCA
    GTGTCTGGGC AAACACTGGG CGGGCCACAC AACCTGATGC GTCGCAGCAC TGTGAGCCTT
    CTGGACACCT ACCAAAAATG TGGACTTAAG CGCAAGAGCG AGGAGATCGA GAACACAAGC
    AGCGTGCAGA TTATCGAGGA GCATCCGCCA ATGATTCAGA ACAATGCCAG TGGGGCCACT
    GTAGCCACCG CCACCACCTC CACGGCCACT TCCAAAAACA GTGGTTCCAA CAGTGAAGGG
    GATTACCAGC TGGTGCAACA TGAGGTGCTC TGTTCCATGA CCAACACATA CGAAGTGTTA
    GAATTTCTTG GCCGTGGAAC CTTCGGACAA GTAGTCAAAT GCTGGAAACG TGGCACTAAT
    GAGATTGTGG CTATCAAGAT CCTAAAAAAC CACCCTTCTT ATGCCCGGCA AGGCCAGATT
    GAAGTGAGCA TCCTGGCTCG GCTGAGCACA GAAAGCGCGG ATGACTACAA CTTTGTCCGT
    GCTTACGAAT GCTTCCAGCA CAAGAATCAC ACATGCTTGG TATTTGAAAT GTTGGAGCAG
    AACCTCTATG ATTTCTTAAA ACAAAATAAA TTCAGTCCCT TGCCCCTTAA GTACATTCGA
    CCAATTCTCC AGCAGGTAGC AACTGCCCTA ATGAAGCTGA AAAGCCTGGG ACTGATTCAT
    GCTGATCTCA AACCAGAGAA CATCATGCTG GTAGACCCAT CCCGACAGCC CTATAGGGTC
    AAGGTCATAG ACTTTGGTTC AGCTAGCCAT GTGTCCAAAG CTGTGTGTTC TACTTACCTT
    CAATCCAGAT ACTACAGAGC CCCTGAAATC ATCCTCGGTT TACCCTTTTG TGAAGCAATC
    GATATGTGGT CATTGGGATG TGTCATTGCA GAGCTGTTCT TGGGCTGGCC CTTGTACCCA
    GGAGCTTCAG AGTACGATCA GATTCGCTAC ATTTCACAGA CGCAGGGCTT ACCAGCAGAG
    TATTTGTTAA GTGCAGGGAC AAAGACCACG AGGTTTTTCA ACAGGGATAC AGACTCACCA
    TATCCCTTGT GGAGGCTGAA GACGCCAGAT GACCATGAGG CAGAGACGGG GATTAAGTCA
    AAGGAAGCAA GAAAGTATAT TTTCAACTGT TTGGATGATA TGGCACAGGT AAACATGACA
    ACGGATTTGG AAGGAAGCGA TATGTTGGTG GAAAAGGCAG ACCGGCGGGA GTTCATAGAT
    CTGTTAAAGA AGATGTTGAC GATAGACGCG GATAAGAGGA TAACACCCAT TGAAACTCTG
    AGCCACCCTT TTGTCACCAT GACGCACTTG CTCGACTTCC CTCACAGCAC ACATGTCAAG
    TCCTGCTTCC AGAACATGGA GATTTGCAAG CGGCGGGTGA ATATGTACGA CACGGTGAAC
    CAGAGCAAGA CGCCATTCAT CACCCACGTA GCCCCAAGTA CATCGACCAA CCTGACCATG
    ACTTTTAACA ACCAGCTGAA CACAGTCCAC AACCAGACCA CCAACCTGGC TCCCACCTCC
    TCCAGTGCCA CTATTTCCTT AGCCAACCCC GAGGTCTCCA TACTAAATTA CCAATCTGCA
    CTCTACCAGC CCTCAGCGGC GTCCATGGCT GCGGTGGCCC AGCGGAGCAT GCCCCTGCAG
    ACGGGAACAG CGCAGATCTG TGCCCGGCCT GACCCCTTAC AGCAAGCCCT CATCGTCTGC
    CCACCAGGCT TCCAAGGGTT ACAAGCCTCC CCTTCGAAGC ACGCTGGGTA CTCGGTTCGG
    ATGGAGAACG CCGTTCCCAT TGTCACTCAG GCTCCTGGGG CTCAGCCTCT TCAGATCCAG
    CCAGGACTCC TCGCACAGCA AGCATGGCCC AGTGGCACTC AGCAGATCCT GCTCCCCCCC
    GCCTGGCAGC AGCTGACCGG AGTGGCCACC CACACCTCTG TCCAGCACGC GACCGTCATC
    CCGGAGTCCA TGGCAGGCAC CCAACCGCTG GCAGACTGGA GGAACACGCA TGCCCACGGC
    AGCCACTACA ACCCCATCAT GCAGCAGACC ACGCTGCTGG CCAGCCACGT GGCCCTGCCC
    GCCGCCCAGC CCGTCAACGT GGGTGTCGCT CACGTCATGC GCCAGCCGCC CGCCGCCGCC
    TCTGCCAGGA AAAGCAAGCA GCACCAGTCG GCTCCACGCA ATGCATCCAC CTATGAAGTT
    TCATCCTCTC AGTCCATCAG CTCGCCCCAG CGGTCGAAAC GAGTGAAGGA GAACACCCCT
    CCCCGCTGTG CCATGGTGCA CAACAGCCCT GCCTGCAGCA CCTCGGTCAC CTGCGGCTGG
    GGCGACGTGG CCACGAGCAG CACGCGGGAG CGGCAGCGGC AGACGATCGT CATCCCCGAC
    ACCCCCAGCC CCGCCGTCAG CGTCATCACC ATCAGCAGCG ACACAGACGA AGAGGAAGAG
    CAGAAGCATG CACCCACCAG CACCTTGTCC AAGCAAAGGA AGAATGTCAT CAGCTGTGTC
    ACCGTGCATG ACTCCCCCTA CTCCGATTCC TCCAGCAACA ACAGCCCTTA CGCCGTGCAA
    CATCGCACAG GGCAGAATAA TGGGAACAGC TACGACACCA AAGGGGTTCC AGAGACTCAC
    TGCAGTGGGA ACCCCCGAAC GATCATCGTG CCACCACTGA AAACCCAGGC CAGTGAGGTG
    TTGGTAGAGT GCGATAGCCT GGCACCAGTC ACCACCAGTC ACCACTCATC CTCCTACAAG
    TCCAAGTCCT CCAGCACCGT GACCTCCACC AGCGGTCACT CTTCAGGGAG CTCGTCTGGA
    GCCGTTGCCT ATAGGCAGCA GCGACCAGGA GCACATTTCC AGCAGCAGCA GCCTCTTAAT
    CTAAGTCAGG GCCAGCAGCA CATCTCGACC GACCGCACAG GGAGTCACCG GAGACAGCAA
    GCCTACATCA CTCCAACGAT AGCTCAGGCC CCGTACTCTT TCCCGCACAA TAGCCCCAGC
    CACGGTACAG TTCATCCCCA CCTGGCCGCG GCTGCCGCTG CTCACCTGCC CACCCAGCCC
    CACCTGTACA CATACACCGC CCCCGCCGCC CTGGGCTCCA CGGGCACCGT CGCGCACCTG
    GTGGCCTCGC AAGGCTCCGC CCGGCACGCG GTGCAGCACA CCACCTACCC CGCCAGCATC
    GTCCACCAGG TCCCCGTCAG CATGGGCCCG CGCGTCCTGC CCTCTCCCAC CATCCACCCG
    AGTCAGTACC AGGCTCAGTT TGCCCATCAG ACCTATATCA GTGCTTCTCC AGCCTCCACA
    GTCTACACTG GATACCCACT GAGCCCCACC AAGGTCAACC AGTACCCTTA CATCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs19968
    Clone ID Related Accession (Same CDS sequence) XM_014256864.1 , XM_014256865.1
    Accession Version XM_014256865.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3597bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product homeodomain-interacting protein kinase 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087595.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGGCCTCGC ATGTGCAAGT TTTCTCTCCT CATACCCTTC AGTCAAGTGC CTTCTGTAGC 
    GTGAAGAAAC TGAAAGTGGA GCCGAGTTCG AACTGGGATA TGACTGGGTA CGGCACACAC
    AGCAAAGTCT ACAACCAGAG CAAGAACGTG CAGTCCTCCC AAGCAGCCGC CGCAGCAGCC
    GTCAACGCCT CCCTCCAGAT CCCCAATCCG AGCATCCCTT ACGAGCAGAC CATCATCTTC
    CCAGCAAGCA CGGGGCACAT TGTGGTTACA TCTGCCAACA GCACTTCTGG TGTGGTTGCA
    GTGTCTGGGC AAACACTGGG CGGGCCACAC AACCTGATGC GTCGCAGCAC TGTGAGCCTT
    CTGGACACCT ACCAAAAATG TGGACTTAAG CGCAAGAGCG AGGAGATCGA GAACACAAGC
    AGCGTGCAGA TTATCGAGGA GCATCCGCCA ATGATTCAGA ACAATGCCAG TGGGGCCACT
    GTAGCCACCG CCACCACCTC CACGGCCACT TCCAAAAACA GTGGTTCCAA CAGTGAAGGG
    GATTACCAGC TGGTGCAACA TGAGGTGCTC TGTTCCATGA CCAACACATA CGAAGTGTTA
    GAATTTCTTG GCCGTGGAAC CTTCGGACAA GTAGTCAAAT GCTGGAAACG TGGCACTAAT
    GAGATTGTGG CTATCAAGAT CCTAAAAAAC CACCCTTCTT ATGCCCGGCA AGGCCAGATT
    GAAGTGAGCA TCCTGGCTCG GCTGAGCACA GAAAGCGCGG ATGACTACAA CTTTGTCCGT
    GCTTACGAAT GCTTCCAGCA CAAGAATCAC ACATGCTTGG TATTTGAAAT GTTGGAGCAG
    AACCTCTATG ATTTCTTAAA ACAAAATAAA TTCAGTCCCT TGCCCCTTAA GTACATTCGA
    CCAATTCTCC AGCAGGTAGC AACTGCCCTA ATGAAGCTGA AAAGCCTGGG ACTGATTCAT
    GCTGATCTCA AACCAGAGAA CATCATGCTG GTAGACCCAT CCCGACAGCC CTATAGGGTC
    AAGGTCATAG ACTTTGGTTC AGCTAGCCAT GTGTCCAAAG CTGTGTGTTC TACTTACCTT
    CAATCCAGAT ACTACAGAGC CCCTGAAATC ATCCTCGGTT TACCCTTTTG TGAAGCAATC
    GATATGTGGT CATTGGGATG TGTCATTGCA GAGCTGTTCT TGGGCTGGCC CTTGTACCCA
    GGAGCTTCAG AGTACGATCA GATTCGCTAC ATTTCACAGA CGCAGGGCTT ACCAGCAGAG
    TATTTGTTAA GTGCAGGGAC AAAGACCACG AGGTTTTTCA ACAGGGATAC AGACTCACCA
    TATCCCTTGT GGAGGCTGAA GACGCCAGAT GACCATGAGG CAGAGACGGG GATTAAGTCA
    AAGGAAGCAA GAAAGTATAT TTTCAACTGT TTGGATGATA TGGCACAGGT AAACATGACA
    ACGGATTTGG AAGGAAGCGA TATGTTGGTG GAAAAGGCAG ACCGGCGGGA GTTCATAGAT
    CTGTTAAAGA AGATGTTGAC GATAGACGCG GATAAGAGGA TAACACCCAT TGAAACTCTG
    AGCCACCCTT TTGTCACCAT GACGCACTTG CTCGACTTCC CTCACAGCAC ACATGTCAAG
    TCCTGCTTCC AGAACATGGA GATTTGCAAG CGGCGGGTGA ATATGTACGA CACGGTGAAC
    CAGAGCAAGA CGCCATTCAT CACCCACGTA GCCCCAAGTA CATCGACCAA CCTGACCATG
    ACTTTTAACA ACCAGCTGAA CACAGTCCAC AACCAGACCA CCAACCTGGC TCCCACCTCC
    TCCAGTGCCA CTATTTCCTT AGCCAACCCC GAGGTCTCCA TACTAAATTA CCAATCTGCA
    CTCTACCAGC CCTCAGCGGC GTCCATGGCT GCGGTGGCCC AGCGGAGCAT GCCCCTGCAG
    ACGGGAACAG CGCAGATCTG TGCCCGGCCT GACCCCTTAC AGCAAGCCCT CATCGTCTGC
    CCACCAGGCT TCCAAGGGTT ACAAGCCTCC CCTTCGAAGC ACGCTGGGTA CTCGGTTCGG
    ATGGAGAACG CCGTTCCCAT TGTCACTCAG GCTCCTGGGG CTCAGCCTCT TCAGATCCAG
    CCAGGACTCC TCGCACAGCA AGCATGGCCC AGTGGCACTC AGCAGATCCT GCTCCCCCCC
    GCCTGGCAGC AGCTGACCGG AGTGGCCACC CACACCTCTG TCCAGCACGC GACCGTCATC
    CCGGAGTCCA TGGCAGGCAC CCAACCGCTG GCAGACTGGA GGAACACGCA TGCCCACGGC
    AGCCACTACA ACCCCATCAT GCAGCAGACC ACGCTGCTGG CCAGCCACGT GGCCCTGCCC
    GCCGCCCAGC CCGTCAACGT GGGTGTCGCT CACGTCATGC GCCAGCCGCC CGCCGCCGCC
    TCTGCCAGGA AAAGCAAGCA GCACCAGTCG GCTCCACGCA ATGCATCCAC CTATGAAGTT
    TCATCCTCTC AGTCCATCAG CTCGCCCCAG CGGTCGAAAC GAGTGAAGGA GAACACCCCT
    CCCCGCTGTG CCATGGTGCA CAACAGCCCT GCCTGCAGCA CCTCGGTCAC CTGCGGCTGG
    GGCGACGTGG CCACGAGCAG CACGCGGGAG CGGCAGCGGC AGACGATCGT CATCCCCGAC
    ACCCCCAGCC CCGCCGTCAG CGTCATCACC ATCAGCAGCG ACACAGACGA AGAGGAAGAG
    CAGAAGCATG CACCCACCAG CACCTTGTCC AAGCAAAGGA AGAATGTCAT CAGCTGTGTC
    ACCGTGCATG ACTCCCCCTA CTCCGATTCC TCCAGCAACA ACAGCCCTTA CGCCGTGCAA
    CATCGCACAG GGCAGAATAA TGGGAACAGC TACGACACCA AAGGGGTTCC AGAGACTCAC
    TGCAGTGGGA ACCCCCGAAC GATCATCGTG CCACCACTGA AAACCCAGGC CAGTGAGGTG
    TTGGTAGAGT GCGATAGCCT GGCACCAGTC ACCACCAGTC ACCACTCATC CTCCTACAAG
    TCCAAGTCCT CCAGCACCGT GACCTCCACC AGCGGTCACT CTTCAGGGAG CTCGTCTGGA
    GCCGTTGCCT ATAGGCAGCA GCGACCAGGA GCACATTTCC AGCAGCAGCA GCCTCTTAAT
    CTAAGTCAGG GCCAGCAGCA CATCTCGACC GACCGCACAG GGAGTCACCG GAGACAGCAA
    GCCTACATCA CTCCAACGAT AGCTCAGGCC CCGTACTCTT TCCCGCACAA TAGCCCCAGC
    CACGGTACAG TTCATCCCCA CCTGGCCGCG GCTGCCGCTG CTCACCTGCC CACCCAGCCC
    CACCTGTACA CATACACCGC CCCCGCCGCC CTGGGCTCCA CGGGCACCGT CGCGCACCTG
    GTGGCCTCGC AAGGCTCCGC CCGGCACGCG GTGCAGCACA CCACCTACCC CGCCAGCATC
    GTCCACCAGG TCCCCGTCAG CATGGGCCCG CGCGTCCTGC CCTCTCCCAC CATCCACCCG
    AGTCAGTACC AGGCTCAGTT TGCCCATCAG ACCTATATCA GTGCTTCTCC AGCCTCCACA
    GTCTACACTG GATACCCACT GAGCCCCACC AAGGTCAACC AGTACCCTTA CATCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014112340.1
    CDS112..3708
    Translation

    Target ORF information:

    RefSeq Version XM_014256865.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014256865.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGGCCTCGC ATGTGCAAGT TTTCTCTCCT CATACCCTTC AGTCAAGTGC CTTCTGTAGC 
    GTGAAGAAAC TGAAAGTGGA GCCGAGTTCG AACTGGGATA TGACTGGGTA CGGCACACAC
    AGCAAAGTCT ACAACCAGAG CAAGAACGTG CAGTCCTCCC AAGCAGCCGC CGCAGCAGCC
    GTCAACGCCT CCCTCCAGAT CCCCAATCCG AGCATCCCTT ACGAGCAGAC CATCATCTTC
    CCAGCAAGCA CGGGGCACAT TGTGGTTACA TCTGCCAACA GCACTTCTGG TGTGGTTGCA
    GTGTCTGGGC AAACACTGGG CGGGCCACAC AACCTGATGC GTCGCAGCAC TGTGAGCCTT
    CTGGACACCT ACCAAAAATG TGGACTTAAG CGCAAGAGCG AGGAGATCGA GAACACAAGC
    AGCGTGCAGA TTATCGAGGA GCATCCGCCA ATGATTCAGA ACAATGCCAG TGGGGCCACT
    GTAGCCACCG CCACCACCTC CACGGCCACT TCCAAAAACA GTGGTTCCAA CAGTGAAGGG
    GATTACCAGC TGGTGCAACA TGAGGTGCTC TGTTCCATGA CCAACACATA CGAAGTGTTA
    GAATTTCTTG GCCGTGGAAC CTTCGGACAA GTAGTCAAAT GCTGGAAACG TGGCACTAAT
    GAGATTGTGG CTATCAAGAT CCTAAAAAAC CACCCTTCTT ATGCCCGGCA AGGCCAGATT
    GAAGTGAGCA TCCTGGCTCG GCTGAGCACA GAAAGCGCGG ATGACTACAA CTTTGTCCGT
    GCTTACGAAT GCTTCCAGCA CAAGAATCAC ACATGCTTGG TATTTGAAAT GTTGGAGCAG
    AACCTCTATG ATTTCTTAAA ACAAAATAAA TTCAGTCCCT TGCCCCTTAA GTACATTCGA
    CCAATTCTCC AGCAGGTAGC AACTGCCCTA ATGAAGCTGA AAAGCCTGGG ACTGATTCAT
    GCTGATCTCA AACCAGAGAA CATCATGCTG GTAGACCCAT CCCGACAGCC CTATAGGGTC
    AAGGTCATAG ACTTTGGTTC AGCTAGCCAT GTGTCCAAAG CTGTGTGTTC TACTTACCTT
    CAATCCAGAT ACTACAGAGC CCCTGAAATC ATCCTCGGTT TACCCTTTTG TGAAGCAATC
    GATATGTGGT CATTGGGATG TGTCATTGCA GAGCTGTTCT TGGGCTGGCC CTTGTACCCA
    GGAGCTTCAG AGTACGATCA GATTCGCTAC ATTTCACAGA CGCAGGGCTT ACCAGCAGAG
    TATTTGTTAA GTGCAGGGAC AAAGACCACG AGGTTTTTCA ACAGGGATAC AGACTCACCA
    TATCCCTTGT GGAGGCTGAA GACGCCAGAT GACCATGAGG CAGAGACGGG GATTAAGTCA
    AAGGAAGCAA GAAAGTATAT TTTCAACTGT TTGGATGATA TGGCACAGGT AAACATGACA
    ACGGATTTGG AAGGAAGCGA TATGTTGGTG GAAAAGGCAG ACCGGCGGGA GTTCATAGAT
    CTGTTAAAGA AGATGTTGAC GATAGACGCG GATAAGAGGA TAACACCCAT TGAAACTCTG
    AGCCACCCTT TTGTCACCAT GACGCACTTG CTCGACTTCC CTCACAGCAC ACATGTCAAG
    TCCTGCTTCC AGAACATGGA GATTTGCAAG CGGCGGGTGA ATATGTACGA CACGGTGAAC
    CAGAGCAAGA CGCCATTCAT CACCCACGTA GCCCCAAGTA CATCGACCAA CCTGACCATG
    ACTTTTAACA ACCAGCTGAA CACAGTCCAC AACCAGACCA CCAACCTGGC TCCCACCTCC
    TCCAGTGCCA CTATTTCCTT AGCCAACCCC GAGGTCTCCA TACTAAATTA CCAATCTGCA
    CTCTACCAGC CCTCAGCGGC GTCCATGGCT GCGGTGGCCC AGCGGAGCAT GCCCCTGCAG
    ACGGGAACAG CGCAGATCTG TGCCCGGCCT GACCCCTTAC AGCAAGCCCT CATCGTCTGC
    CCACCAGGCT TCCAAGGGTT ACAAGCCTCC CCTTCGAAGC ACGCTGGGTA CTCGGTTCGG
    ATGGAGAACG CCGTTCCCAT TGTCACTCAG GCTCCTGGGG CTCAGCCTCT TCAGATCCAG
    CCAGGACTCC TCGCACAGCA AGCATGGCCC AGTGGCACTC AGCAGATCCT GCTCCCCCCC
    GCCTGGCAGC AGCTGACCGG AGTGGCCACC CACACCTCTG TCCAGCACGC GACCGTCATC
    CCGGAGTCCA TGGCAGGCAC CCAACCGCTG GCAGACTGGA GGAACACGCA TGCCCACGGC
    AGCCACTACA ACCCCATCAT GCAGCAGACC ACGCTGCTGG CCAGCCACGT GGCCCTGCCC
    GCCGCCCAGC CCGTCAACGT GGGTGTCGCT CACGTCATGC GCCAGCCGCC CGCCGCCGCC
    TCTGCCAGGA AAAGCAAGCA GCACCAGTCG GCTCCACGCA ATGCATCCAC CTATGAAGTT
    TCATCCTCTC AGTCCATCAG CTCGCCCCAG CGGTCGAAAC GAGTGAAGGA GAACACCCCT
    CCCCGCTGTG CCATGGTGCA CAACAGCCCT GCCTGCAGCA CCTCGGTCAC CTGCGGCTGG
    GGCGACGTGG CCACGAGCAG CACGCGGGAG CGGCAGCGGC AGACGATCGT CATCCCCGAC
    ACCCCCAGCC CCGCCGTCAG CGTCATCACC ATCAGCAGCG ACACAGACGA AGAGGAAGAG
    CAGAAGCATG CACCCACCAG CACCTTGTCC AAGCAAAGGA AGAATGTCAT CAGCTGTGTC
    ACCGTGCATG ACTCCCCCTA CTCCGATTCC TCCAGCAACA ACAGCCCTTA CGCCGTGCAA
    CATCGCACAG GGCAGAATAA TGGGAACAGC TACGACACCA AAGGGGTTCC AGAGACTCAC
    TGCAGTGGGA ACCCCCGAAC GATCATCGTG CCACCACTGA AAACCCAGGC CAGTGAGGTG
    TTGGTAGAGT GCGATAGCCT GGCACCAGTC ACCACCAGTC ACCACTCATC CTCCTACAAG
    TCCAAGTCCT CCAGCACCGT GACCTCCACC AGCGGTCACT CTTCAGGGAG CTCGTCTGGA
    GCCGTTGCCT ATAGGCAGCA GCGACCAGGA GCACATTTCC AGCAGCAGCA GCCTCTTAAT
    CTAAGTCAGG GCCAGCAGCA CATCTCGACC GACCGCACAG GGAGTCACCG GAGACAGCAA
    GCCTACATCA CTCCAACGAT AGCTCAGGCC CCGTACTCTT TCCCGCACAA TAGCCCCAGC
    CACGGTACAG TTCATCCCCA CCTGGCCGCG GCTGCCGCTG CTCACCTGCC CACCCAGCCC
    CACCTGTACA CATACACCGC CCCCGCCGCC CTGGGCTCCA CGGGCACCGT CGCGCACCTG
    GTGGCCTCGC AAGGCTCCGC CCGGCACGCG GTGCAGCACA CCACCTACCC CGCCAGCATC
    GTCCACCAGG TCCCCGTCAG CATGGGCCCG CGCGTCCTGC CCTCTCCCAC CATCCACCCG
    AGTCAGTACC AGGCTCAGTT TGCCCATCAG ACCTATATCA GTGCTTCTCC AGCCTCCACA
    GTCTACACTG GATACCCACT GAGCCCCACC AAGGTCAACC AGTACCCTTA CATCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs19969
    Clone ID Related Accession (Same CDS sequence) XM_005527894.2
    Accession Version XM_005527894.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3525bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product homeodomain-interacting protein kinase 2 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087595.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 21, 2015 this sequence version replaced XM_005527894.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGGCCCCCA TGTACGAAGG TATGGCCTCG CATGTGCAAG TTTTCTCTCC TCATACCCTT 
    CAGTCAAGTG CCTTCTGTAG CGTGAAGAAA CTGAAAGTGG AGCCGAGTTC GAACTGGGAT
    ATGACTGGGT ACGGCACACA CAGCAAAGTC TACAACCAGA GCAAGAACGT GCAGTCCTCC
    CAAGCAGCCG CCGCAGCAGC CGTCAACGCC TCCCTCCAGA TCCCCAATCC GAGCATCCCT
    TACGAGCAGA CCATCATCTT CCCAGCAAGC ACGGGGCACA TTGTGGTTAC ATCTGCCAAC
    AGCACTTCTG GTGTGGTTGC AGTGTCTGGG CAAACACTGG GCGGGCCACA CAACCTGATG
    CGTCGCAGCA CTGTGAGCCT TCTGGACACC TACCAAAAAT GTGGACTTAA GCGCAAGAGC
    GAGGAGATCG AGAACACAAG CAGCGTGCAG ATTATCGAGG AGCATCCGCC AATGATTCAG
    AACAATGCCA GTGGGGCCAC TGTAGCCACC GCCACCACCT CCACGGCCAC TTCCAAAAAC
    AGTGGTTCCA ACAGTGAAGG GGATTACCAG CTGGTGCAAC ATGAGGTGCT CTGTTCCATG
    ACCAACACAT ACGAAGTGTT AGAATTTCTT GGCCGTGGAA CCTTCGGACA AGTAGTCAAA
    TGCTGGAAAC GTGGCACTAA TGAGATTGTG GCTATCAAGA TCCTAAAAAA CCACCCTTCT
    TATGCCCGGC AAGGCCAGAT TGAAGTGAGC ATCCTGGCTC GGCTGAGCAC AGAAAGCGCG
    GATGACTACA ACTTTGTCCG TGCTTACGAA TGCTTCCAGC ACAAGAATCA CACATGCTTG
    GTATTTGAAA TGTTGGAGCA GAACCTCTAT GATTTCTTAA AACAAAATAA ATTCAGTCCC
    TTGCCCCTTA AGTACATTCG ACCAATTCTC CAGCAGGTAG CAACTGCCCT AATGAAGCTG
    AAAAGCCTGG GACTGATTCA TGCTGATCTC AAACCAGAGA ACATCATGCT GGTAGACCCA
    TCCCGACAGC CCTATAGGGT CAAGGTCATA GACTTTGGTT CAGCTAGCCA TGTGTCCAAA
    GCTGTGTGTT CTACTTACCT TCAATCCAGA TACTACAGAG CCCCTGAAAT CATCCTCGGT
    TTACCCTTTT GTGAAGCAAT CGATATGTGG TCATTGGGAT GTGTCATTGC AGAGCTGTTC
    TTGGGCTGGC CCTTGTACCC AGGAGCTTCA GAGTACGATC AGATTCGCTA CATTTCACAG
    ACGCAGGGCT TACCAGCAGA GTATTTGTTA AGTGCAGGGA CAAAGACCAC GAGGTTTTTC
    AACAGGGATA CAGACTCACC ATATCCCTTG TGGAGGCTGA AGACGCCAGA TGACCATGAG
    GCAGAGACGG GGATTAAGTC AAAGGAAGCA AGAAAGTATA TTTTCAACTG TTTGGATGAT
    ATGGCACAGG TAAACATGAC AACGGATTTG GAAGGAAGCG ATATGTTGGT GGAAAAGGCA
    GACCGGCGGG AGTTCATAGA TCTGTTAAAG AAGATGTTGA CGATAGACGC GGATAAGAGG
    ATAACACCCA TTGAAACTCT GAGCCACCCT TTTGTCACCA TGACGCACTT GCTCGACTTC
    CCTCACAGCA CACATGTCAA GTCCTGCTTC CAGAACATGG AGATTTGCAA GCGGCGGGTG
    AATATGTACG ACACGGTGAA CCAGAGCAAG ACGCCATTCA TCACCCACGT AGCCCCAAGT
    ACATCGACCA ACCTGACCAT GACTTTTAAC AACCAGCTGA ACACAGTCCA CAACCAGCCC
    TCAGCGGCGT CCATGGCTGC GGTGGCCCAG CGGAGCATGC CCCTGCAGAC GGGAACAGCG
    CAGATCTGTG CCCGGCCTGA CCCCTTACAG CAAGCCCTCA TCGTCTGCCC ACCAGGCTTC
    CAAGGGTTAC AAGCCTCCCC TTCGAAGCAC GCTGGGTACT CGGTTCGGAT GGAGAACGCC
    GTTCCCATTG TCACTCAGGC TCCTGGGGCT CAGCCTCTTC AGATCCAGCC AGGACTCCTC
    GCACAGCAAG CATGGCCCAG TGGCACTCAG CAGATCCTGC TCCCCCCCGC CTGGCAGCAG
    CTGACCGGAG TGGCCACCCA CACCTCTGTC CAGCACGCGA CCGTCATCCC GGAGTCCATG
    GCAGGCACCC AACCGCTGGC AGACTGGAGG AACACGCATG CCCACGGCAG CCACTACAAC
    CCCATCATGC AGCAGACCAC GCTGCTGGCC AGCCACGTGG CCCTGCCCGC CGCCCAGCCC
    GTCAACGTGG GTGTCGCTCA CGTCATGCGC CAGCCGCCCG CCGCCGCCTC TGCCAGGAAA
    AGCAAGCAGC ACCAGTCGGC TCCACGCAAT GCATCCACCT ATGAAGTTTC ATCCTCTCAG
    TCCATCAGCT CGCCCCAGCG GTCGAAACGA GTGAAGGAGA ACACCCCTCC CCGCTGTGCC
    ATGGTGCACA ACAGCCCTGC CTGCAGCACC TCGGTCACCT GCGGCTGGGG CGACGTGGCC
    ACGAGCAGCA CGCGGGAGCG GCAGCGGCAG ACGATCGTCA TCCCCGACAC CCCCAGCCCC
    GCCGTCAGCG TCATCACCAT CAGCAGCGAC ACAGACGAAG AGGAAGAGCA GAAGCATGCA
    CCCACCAGCA CCTTGTCCAA GCAAAGGAAG AATGTCATCA GCTGTGTCAC CGTGCATGAC
    TCCCCCTACT CCGATTCCTC CAGCAACAAC AGCCCTTACG CCGTGCAACA TCGCACAGGG
    CAGAATAATG GGAACAGCTA CGACACCAAA GGGGTTCCAG AGACTCACTG CAGTGGGAAC
    CCCCGAACGA TCATCGTGCC ACCACTGAAA ACCCAGGCCA GTGAGGTGTT GGTAGAGTGC
    GATAGCCTGG CACCAGTCAC CACCAGTCAC CACTCATCCT CCTACAAGTC CAAGTCCTCC
    AGCACCGTGA CCTCCACCAG CGGTCACTCT TCAGGGAGCT CGTCTGGAGC CGTTGCCTAT
    AGGCAGCAGC GACCAGGAGC ACATTTCCAG CAGCAGCAGC CTCTTAATCT AAGTCAGGGC
    CAGCAGCACA TCTCGACCGA CCGCACAGGG AGTCACCGGA GACAGCAAGC CTACATCACT
    CCAACGATAG CTCAGGCCCC GTACTCTTTC CCGCACAATA GCCCCAGCCA CGGTACAGTT
    CATCCCCACC TGGCCGCGGC TGCCGCTGCT CACCTGCCCA CCCAGCCCCA CCTGTACACA
    TACACCGCCC CCGCCGCCCT GGGCTCCACG GGCACCGTCG CGCACCTGGT GGCCTCGCAA
    GGCTCCGCCC GGCACGCGGT GCAGCACACC ACCTACCCCG CCAGCATCGT CCACCAGGTC
    CCCGTCAGCA TGGGCCCGCG CGTCCTGCCC TCTCCCACCA TCCACCCGAG TCAGTACCAG
    GCTCAGTTTG CCCATCAGAC CTATATCAGT GCTTCTCCAG CCTCCACAGT CTACACTGGA
    TACCCACTGA GCCCCACCAA GGTCAACCAG TACCCTTACA TCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005527951.2
    CDS215..3739
    Translation

    Target ORF information:

    RefSeq Version XM_005527894.2
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis homeodomain interacting protein kinase 2 (HIPK2), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005527894.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGGCCCCCA TGTACGAAGG TATGGCCTCG CATGTGCAAG TTTTCTCTCC TCATACCCTT 
    CAGTCAAGTG CCTTCTGTAG CGTGAAGAAA CTGAAAGTGG AGCCGAGTTC GAACTGGGAT
    ATGACTGGGT ACGGCACACA CAGCAAAGTC TACAACCAGA GCAAGAACGT GCAGTCCTCC
    CAAGCAGCCG CCGCAGCAGC CGTCAACGCC TCCCTCCAGA TCCCCAATCC GAGCATCCCT
    TACGAGCAGA CCATCATCTT CCCAGCAAGC ACGGGGCACA TTGTGGTTAC ATCTGCCAAC
    AGCACTTCTG GTGTGGTTGC AGTGTCTGGG CAAACACTGG GCGGGCCACA CAACCTGATG
    CGTCGCAGCA CTGTGAGCCT TCTGGACACC TACCAAAAAT GTGGACTTAA GCGCAAGAGC
    GAGGAGATCG AGAACACAAG CAGCGTGCAG ATTATCGAGG AGCATCCGCC AATGATTCAG
    AACAATGCCA GTGGGGCCAC TGTAGCCACC GCCACCACCT CCACGGCCAC TTCCAAAAAC
    AGTGGTTCCA ACAGTGAAGG GGATTACCAG CTGGTGCAAC ATGAGGTGCT CTGTTCCATG
    ACCAACACAT ACGAAGTGTT AGAATTTCTT GGCCGTGGAA CCTTCGGACA AGTAGTCAAA
    TGCTGGAAAC GTGGCACTAA TGAGATTGTG GCTATCAAGA TCCTAAAAAA CCACCCTTCT
    TATGCCCGGC AAGGCCAGAT TGAAGTGAGC ATCCTGGCTC GGCTGAGCAC AGAAAGCGCG
    GATGACTACA ACTTTGTCCG TGCTTACGAA TGCTTCCAGC ACAAGAATCA CACATGCTTG
    GTATTTGAAA TGTTGGAGCA GAACCTCTAT GATTTCTTAA AACAAAATAA ATTCAGTCCC
    TTGCCCCTTA AGTACATTCG ACCAATTCTC CAGCAGGTAG CAACTGCCCT AATGAAGCTG
    AAAAGCCTGG GACTGATTCA TGCTGATCTC AAACCAGAGA ACATCATGCT GGTAGACCCA
    TCCCGACAGC CCTATAGGGT CAAGGTCATA GACTTTGGTT CAGCTAGCCA TGTGTCCAAA
    GCTGTGTGTT CTACTTACCT TCAATCCAGA TACTACAGAG CCCCTGAAAT CATCCTCGGT
    TTACCCTTTT GTGAAGCAAT CGATATGTGG TCATTGGGAT GTGTCATTGC AGAGCTGTTC
    TTGGGCTGGC CCTTGTACCC AGGAGCTTCA GAGTACGATC AGATTCGCTA CATTTCACAG
    ACGCAGGGCT TACCAGCAGA GTATTTGTTA AGTGCAGGGA CAAAGACCAC GAGGTTTTTC
    AACAGGGATA CAGACTCACC ATATCCCTTG TGGAGGCTGA AGACGCCAGA TGACCATGAG
    GCAGAGACGG GGATTAAGTC AAAGGAAGCA AGAAAGTATA TTTTCAACTG TTTGGATGAT
    ATGGCACAGG TAAACATGAC AACGGATTTG GAAGGAAGCG ATATGTTGGT GGAAAAGGCA
    GACCGGCGGG AGTTCATAGA TCTGTTAAAG AAGATGTTGA CGATAGACGC GGATAAGAGG
    ATAACACCCA TTGAAACTCT GAGCCACCCT TTTGTCACCA TGACGCACTT GCTCGACTTC
    CCTCACAGCA CACATGTCAA GTCCTGCTTC CAGAACATGG AGATTTGCAA GCGGCGGGTG
    AATATGTACG ACACGGTGAA CCAGAGCAAG ACGCCATTCA TCACCCACGT AGCCCCAAGT
    ACATCGACCA ACCTGACCAT GACTTTTAAC AACCAGCTGA ACACAGTCCA CAACCAGCCC
    TCAGCGGCGT CCATGGCTGC GGTGGCCCAG CGGAGCATGC CCCTGCAGAC GGGAACAGCG
    CAGATCTGTG CCCGGCCTGA CCCCTTACAG CAAGCCCTCA TCGTCTGCCC ACCAGGCTTC
    CAAGGGTTAC AAGCCTCCCC TTCGAAGCAC GCTGGGTACT CGGTTCGGAT GGAGAACGCC
    GTTCCCATTG TCACTCAGGC TCCTGGGGCT CAGCCTCTTC AGATCCAGCC AGGACTCCTC
    GCACAGCAAG CATGGCCCAG TGGCACTCAG CAGATCCTGC TCCCCCCCGC CTGGCAGCAG
    CTGACCGGAG TGGCCACCCA CACCTCTGTC CAGCACGCGA CCGTCATCCC GGAGTCCATG
    GCAGGCACCC AACCGCTGGC AGACTGGAGG AACACGCATG CCCACGGCAG CCACTACAAC
    CCCATCATGC AGCAGACCAC GCTGCTGGCC AGCCACGTGG CCCTGCCCGC CGCCCAGCCC
    GTCAACGTGG GTGTCGCTCA CGTCATGCGC CAGCCGCCCG CCGCCGCCTC TGCCAGGAAA
    AGCAAGCAGC ACCAGTCGGC TCCACGCAAT GCATCCACCT ATGAAGTTTC ATCCTCTCAG
    TCCATCAGCT CGCCCCAGCG GTCGAAACGA GTGAAGGAGA ACACCCCTCC CCGCTGTGCC
    ATGGTGCACA ACAGCCCTGC CTGCAGCACC TCGGTCACCT GCGGCTGGGG CGACGTGGCC
    ACGAGCAGCA CGCGGGAGCG GCAGCGGCAG ACGATCGTCA TCCCCGACAC CCCCAGCCCC
    GCCGTCAGCG TCATCACCAT CAGCAGCGAC ACAGACGAAG AGGAAGAGCA GAAGCATGCA
    CCCACCAGCA CCTTGTCCAA GCAAAGGAAG AATGTCATCA GCTGTGTCAC CGTGCATGAC
    TCCCCCTACT CCGATTCCTC CAGCAACAAC AGCCCTTACG CCGTGCAACA TCGCACAGGG
    CAGAATAATG GGAACAGCTA CGACACCAAA GGGGTTCCAG AGACTCACTG CAGTGGGAAC
    CCCCGAACGA TCATCGTGCC ACCACTGAAA ACCCAGGCCA GTGAGGTGTT GGTAGAGTGC
    GATAGCCTGG CACCAGTCAC CACCAGTCAC CACTCATCCT CCTACAAGTC CAAGTCCTCC
    AGCACCGTGA CCTCCACCAG CGGTCACTCT TCAGGGAGCT CGTCTGGAGC CGTTGCCTAT
    AGGCAGCAGC GACCAGGAGC ACATTTCCAG CAGCAGCAGC CTCTTAATCT AAGTCAGGGC
    CAGCAGCACA TCTCGACCGA CCGCACAGGG AGTCACCGGA GACAGCAAGC CTACATCACT
    CCAACGATAG CTCAGGCCCC GTACTCTTTC CCGCACAATA GCCCCAGCCA CGGTACAGTT
    CATCCCCACC TGGCCGCGGC TGCCGCTGCT CACCTGCCCA CCCAGCCCCA CCTGTACACA
    TACACCGCCC CCGCCGCCCT GGGCTCCACG GGCACCGTCG CGCACCTGGT GGCCTCGCAA
    GGCTCCGCCC GGCACGCGGT GCAGCACACC ACCTACCCCG CCAGCATCGT CCACCAGGTC
    CCCGTCAGCA TGGGCCCGCG CGTCCTGCCC TCTCCCACCA TCCACCCGAG TCAGTACCAG
    GCTCAGTTTG CCCATCAGAC CTATATCAGT GCTTCTCCAG CCTCCACAGT CTACACTGGA
    TACCCACTGA GCCCCACCAA GGTCAACCAG TACCCTTACA TCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.