TMCO4 cDNA ORF clone, Protobothrops mucrosquamatus

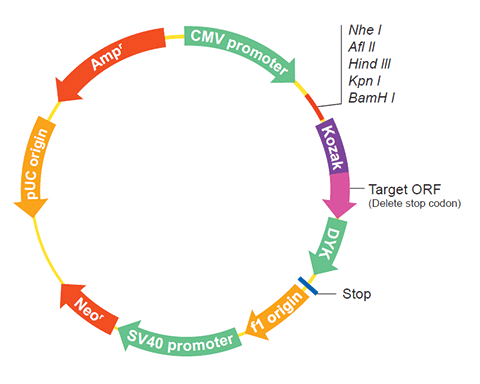
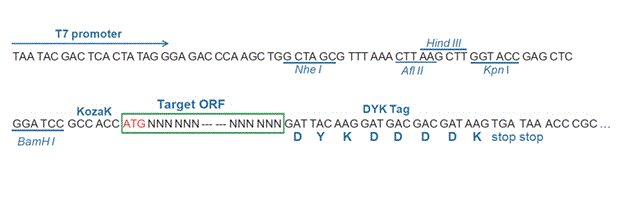
The following TMCO4 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the TMCO4 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPr200789 XM_029285841.1
Latest version!
Protobothrops mucrosquamatus transmembrane and coiled-coil domains 4 (TMCO4), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $307.30
$439.00
OPr37368 XM_015824734.1
Latest version!
Protobothrops mucrosquamatus transmembrane and coiled-coil domains 4 (TMCO4), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPr200789
    Clone ID Related Accession (Same CDS sequence) XM_029285841.1
    Accession Version XM_029285841.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1962bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-05-22
    Organism Protobothrops mucrosquamatus
    Product transmembrane and coiled-coil domain-containing protein 4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015388414.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Protobothrops mucrosquamatus Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 19% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGTCTGCTG ATCCCCGGCC AGGCTGGAGG CCCTGGAGAA GCCAGCCACA GAAGGAAGAA 
    GAAGAAGAAG AAGACCCGGG ACCGAGGACA CGTCCAGGCG CCCAGTTGGG TGAGCCGGGG
    AAATACGCCT ACGCGGCTCT CTGTGCCATT TCCTTGGCCT CGTTGTTTCC GGATCAGGAG
    GAGAGTGCCT ACAGGACCGG AGTGGTGGAG AACCTGGTCC GGTGGCTGGA GCTGTCGGAG
    GCGGTGATGC CCTCCATGCT GGCCTTTGCT GGGGGGCTGG GGGCTGAAGG GACAGAGACC
    TTCGCTCGGA TTCTTCTGGG CGAGACGCTT CTGAAGGATC AGCCCGGCGC CATCATGCTG
    GACCTGGTTT CCTTTTCTCT CAAGGATGGC TACTACGACG CTCGCATGCG GGTGCTTCTC
    TCCCACGTGG CCTGTTTGCT GAGGATCCCG TTGGCAGAAC TGGAAGAGGC AGAGGACTAT
    CTCCTTGAAT GTCTGAAGGA GGAGAAAGAG GCGGAATCGG AAACGGACGA AGGCAAGCGG
    AAGAAGAAGG AGAGAAGGAA GAGGCTGAAG CGCTACCTGC TGATCGGCTT GGCGACGGTA
    GGAGGAGGGA CGGTCATCGG CCTGACCGGG GGTCTGGCTG CCCCCTTGGT GGGCATGGGA
    GCAGCCACCA TCATCGGAAC TGCTGGAGCC ACGGCCTTGG GGTCAGCAGC TGGGATGGCC
    ATTATCGGTT CGCTCTTTGG AGCTGCTGGG GCCGGACTCG TGGGGTACAA GATGAAAAAG
    CGCGTAGGGG CCATAGAAGA ATTCGAATTC CTTCCCTTAA CCGAAGCGAA GCAGCTCCAT
    ATCACCATTG CCATCACCGG CTGGCTTTCT GCTGGGAAGT ACGGCAGTTT CACAGCCCCC
    TGGAGCAGCC TCTTACAGTC CAAGGAGCAG TACTGCTTAG CCTGGGAGTC CAAGTACCTG
    CTGGAGCTGG GCAGCGCCCT GGACGCCTTG TGGAATGGGC TGGTTAACAT GGTCGCCCAG
    GAGGCCCTCA AGTACACGGT CTTGGCGGGG ATCGTGACGG CCCTCACCTG GCCTGCTTCG
    CTGCTGGCAG TGGCTGGTGT GATAGACAAC CCCTGGGGTG TGTGTCTCCA TCGCTCCGCT
    GAGGTCGGGA AACACTTGGC ACAGATACTT CTTAGCCGGC GGCAGGGCAA ACGGCCGGTG
    ACGCTGGTCG GATTCAGTCT CGGTGCTAGG GTGATCTACT TTTGCCTGCA GGAGATGGCC
    AAGGAGAAAG ACTGCGAAGG GATCATTGAA GACGTGGTGC TGCTGGGGGC CCCGATAGAA
    GGAGATCCCA AACCCTGGAA GCTGATCACC AAAGTCATTT CAGGCAAGAT CATCAACGGC
    TTCTGCAGGG GAGACTGGCT GTTGAAATTT GTCTACCGCA CGTCGTCCAT TCAGCTGAGC
    GTGGCAGGGC TTCAGCCCAT CTGCCTGGAT GACCGCCGGG TGGTCAACGT GGACCTGTCT
    TCCGTGGTGA ATGGTCACCT GGACTACATG AAGCAGATGG ACACCATCCT GAAGGCCGTG
    GGGCTCAAAA CGAGGCCGGC CCTGCAAGAA CGAGGGGGGC TCCTGGCAGC GTCTTCCGCC
    CCCAGTGAGA AGGAGGAGGA GGAGGAGGAG GAGGAGAAAC AGGGGGTGTC TCCGGACGGC
    ACCGCCACCT CCTCGGAGGA GCCCAGTGTG GTGGGCAGGC CCGATTCTCA GACAGACAGG
    TGGGGGCTCC TGGAAACCTC CAAAGCTGAT GTGAGAGTCG GCATTCTTTT CTCTTTGATG
    TCTGGTATCC TGCCCCTGGA CACGGAGGCT CTACTCTTTG CCGCCACGTC TCCGACTGTG
    CCAAAAGCTG TGAAGTCAGC GCTGCAGGTC CCTGACCACA GCTCCCATTC TCCCCTGGAC
    AAGGGTGGCT TTGTAGTCCA GTTGGGTCTG GGGGGGGAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029141674.1
    CDS1..1962
    Translation

    Target ORF information:

    RefSeq Version XM_029285841.1
    Organism Protobothrops mucrosquamatus
    Definition Protobothrops mucrosquamatus transmembrane and coiled-coil domains 4 (TMCO4), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029285841.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGTCTGCTG ATCCCCGGCC AGGCTGGAGG CCCTGGAGAA GCCAGCCACA GAAGGAAGAA 
    GAAGAAGAAG AAGACCCGGG ACCGAGGACA CGTCCAGGCG CCCAGTTGGG TGAGCCGGGG
    AAATACGCCT ACGCGGCTCT CTGTGCCATT TCCTTGGCCT CGTTGTTTCC GGATCAGGAG
    GAGAGTGCCT ACAGGACCGG AGTGGTGGAG AACCTGGTCC GGTGGCTGGA GCTGTCGGAG
    GCGGTGATGC CCTCCATGCT GGCCTTTGCT GGGGGGCTGG GGGCTGAAGG GACAGAGACC
    TTCGCTCGGA TTCTTCTGGG CGAGACGCTT CTGAAGGATC AGCCCGGCGC CATCATGCTG
    GACCTGGTTT CCTTTTCTCT CAAGGATGGC TACTACGACG CTCGCATGCG GGTGCTTCTC
    TCCCACGTGG CCTGTTTGCT GAGGATCCCG TTGGCAGAAC TGGAAGAGGC AGAGGACTAT
    CTCCTTGAAT GTCTGAAGGA GGAGAAAGAG GCGGAATCGG AAACGGACGA AGGCAAGCGG
    AAGAAGAAGG AGAGAAGGAA GAGGCTGAAG CGCTACCTGC TGATCGGCTT GGCGACGGTA
    GGAGGAGGGA CGGTCATCGG CCTGACCGGG GGTCTGGCTG CCCCCTTGGT GGGCATGGGA
    GCAGCCACCA TCATCGGAAC TGCTGGAGCC ACGGCCTTGG GGTCAGCAGC TGGGATGGCC
    ATTATCGGTT CGCTCTTTGG AGCTGCTGGG GCCGGACTCG TGGGGTACAA GATGAAAAAG
    CGCGTAGGGG CCATAGAAGA ATTCGAATTC CTTCCCTTAA CCGAAGCGAA GCAGCTCCAT
    ATCACCATTG CCATCACCGG CTGGCTTTCT GCTGGGAAGT ACGGCAGTTT CACAGCCCCC
    TGGAGCAGCC TCTTACAGTC CAAGGAGCAG TACTGCTTAG CCTGGGAGTC CAAGTACCTG
    CTGGAGCTGG GCAGCGCCCT GGACGCCTTG TGGAATGGGC TGGTTAACAT GGTCGCCCAG
    GAGGCCCTCA AGTACACGGT CTTGGCGGGG ATCGTGACGG CCCTCACCTG GCCTGCTTCG
    CTGCTGGCAG TGGCTGGTGT GATAGACAAC CCCTGGGGTG TGTGTCTCCA TCGCTCCGCT
    GAGGTCGGGA AACACTTGGC ACAGATACTT CTTAGCCGGC GGCAGGGCAA ACGGCCGGTG
    ACGCTGGTCG GATTCAGTCT CGGTGCTAGG GTGATCTACT TTTGCCTGCA GGAGATGGCC
    AAGGAGAAAG ACTGCGAAGG GATCATTGAA GACGTGGTGC TGCTGGGGGC CCCGATAGAA
    GGAGATCCCA AACCCTGGAA GCTGATCACC AAAGTCATTT CAGGCAAGAT CATCAACGGC
    TTCTGCAGGG GAGACTGGCT GTTGAAATTT GTCTACCGCA CGTCGTCCAT TCAGCTGAGC
    GTGGCAGGGC TTCAGCCCAT CTGCCTGGAT GACCGCCGGG TGGTCAACGT GGACCTGTCT
    TCCGTGGTGA ATGGTCACCT GGACTACATG AAGCAGATGG ACACCATCCT GAAGGCCGTG
    GGGCTCAAAA CGAGGCCGGC CCTGCAAGAA CGAGGGGGGC TCCTGGCAGC GTCTTCCGCC
    CCCAGTGAGA AGGAGGAGGA GGAGGAGGAG GAGGAGAAAC AGGGGGTGTC TCCGGACGGC
    ACCGCCACCT CCTCGGAGGA GCCCAGTGTG GTGGGCAGGC CCGATTCTCA GACAGACAGG
    TGGGGGCTCC TGGAAACCTC CAAAGCTGAT GTGAGAGTCG GCATTCTTTT CTCTTTGATG
    TCTGGTATCC TGCCCCTGGA CACGGAGGCT CTACTCTTTG CCGCCACGTC TCCGACTGTG
    CCAAAAGCTG TGAAGTCAGC GCTGCAGGTC CCTGACCACA GCTCCCATTC TCCCCTGGAC
    AAGGGTGGCT TTGTAGTCCA GTTGGGTCTG GGGGGGGAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPr37368
    Clone ID Related Accession (Same CDS sequence) XM_015824734.1
    Accession Version XM_015824734.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2043bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-03-01
    Organism Protobothrops mucrosquamatus
    Product transmembrane and coiled-coil domain-containing protein 4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015388414.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Protobothrops mucrosquamatus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 12% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCTGCTG ATCCCCGGCC AGGCTGGAGG CCCTGGAGAA GCCAGCCACA GAAGGAAGAA 
    GAAGAAGAAG AAGACCCGGG ACCGAGGACA CGTCCAGGCG CCCAGTTGGG TGAGCCGGGG
    AAATACGCCT ACGCGGCTCT CTGTGCCATT TCCTTGGCCT CGTTGTTTCC GGATCAGGAG
    GAGAGTGCCT ACAGGACCGG AGTGGTGGAG AACCTGGTCC GGTGGCTGGA GCTGTCGGAG
    GCGGTGATGC CCTCCATGCT GGCCTTTGCT GGGGGGCTGG GGGCTGAAGG GACAGAGACC
    TTCGCTCGGA TTCTTCTGGG CGAGACGCTT CTGAAGGATC AGCCCGGCGC CATCATGCTG
    GACCTGGTTT CCTTTTCTCT CAAGGATGGC TACTACGACG CTCGCATGCG GGTGCTTCTC
    TCCCACGTGG CCTGTTTGCT GAGGATCCCG TTGGCAGAAC TGGAAGAGGC AGAGGACTAT
    CTCCTTGAAT GTCTGAAGGA GGAGAAAGAG GCGGAATCGG AAACGGACGA AGGCAAGCGG
    AAGAAGAAGG AGAGAAGGAA GAGGCTGAAG CGCTACCTGC TGATCGGCTT GGCGACGGTA
    GGAGGAGGGA CGGTCATCGG CCTGACCGGG GGTCTGGCTG CCCCCTTGGT GGGCATGGGA
    GCAGCCACCA TCATCGGAAC TGCTGGAGCC ACGGCCTTGG GGTCAGCAGC TGGGATGGCC
    ATTATCGGTT CGCTCTTTGG AGCTGCTGGG GCCGGACTCG TGGGGTACAA GATGAAAAAG
    CGCGTAGGGG CCATAGAAGA ATTCGAATTC CTTCCCTTAA CCGAAGCGAA GCAGCTCCAT
    ATCACCATTG CCATCACCGG CTGGCTTTCT GCTGGGAAGT ACGGCAGTTT CACAGCCCCC
    TGGAGCAGCC TCTTACAGTC CAAGGAGCAG TACTGCTTAG CCTGGGAGTC CAAGTACCTG
    CTGGAGCTGG GCAGCGCCCT GGACGCCTTG TGGAATGGGC TGGTTAACAT GGTCGCCCAG
    GAGGCCCTCA AGTACACGGT CTTGGCGGGG ATCGTGACGG CCCTCACCTG GCCTGCTTCG
    CTGCTGGCAG TGGCTGGTGT GATAGACAAC CCCTGGGGTG TGTGTCTCCA TCGCTCCGCT
    GAGGTCGGGA AACACTTGGC ACAGATACTT CTTAGCCGGC GGCAGGGCAA ACGGCCGGTG
    ACGCTGGTCG GATTCAGTCT CGGTGCTAGG GTGATCTACT TTTGCCTGCA GGAGATGGCC
    AAGGAGAAAG ACTGCGAAGG GATCATTGAA GACGTGGTGC TGCTGGGGGC CCCGATAGAA
    GGAGATCCCA AACCCTGGAA GCTGATCACC AAAGTCATTT CAGGCAAGAT CATCAACGGC
    TTCTGCAGGG GAGACTGGCT GTTGAAATTT GTCTACCGCA CGTCGTCCAT TCAGCTGAGC
    GTGGCAGGGC TTCAGCCCAT CTGCCTGGAT GACCGCCGGG TGGTCAACGT GGACCTGTCT
    TCCGTGGTGA ATGGTCACCT GGACTACATG AAGCAGATGG ACACCATCCT GAAGGCCGTG
    GGGCTCAAAA CGAGGCCGGC CCTGCAAGAA CGAGGGGGGC TCCTGGCAGC GTCTTCCGCC
    CCCAGTGAGA AGGAGGAGGA GGAGGAGGAG GAGGAGAAAC AGGGGGTGTC TCCGGACGGC
    ACCGCCACCT CCTCGGAGGA GCCCAGTGTG GTGGGCAGGC CCGATGTGGG TGGACCTGCG
    GAGGGGGAAG GCCTCCAGGG CAATGAAGAC TACTGGTGTT GGGAGGCGGT CTCCGCTCCC
    GGACAGTCTC AGACAGACAG GTGGGGGCTC CTGGAAACCT CCAAAGCTGA TGTGAGAGTC
    GGCATTCTTT TCTCTTTGAT GTCTGGTATC CTGCCCCTGG ACACGGAGGC TCTACTCTTT
    GCCGCCACGT CTCCGACTGT GCCAAAAGCT GTGAAGTCAG CGCTGCAGGT CCCTGACCAC
    AGCTCCCATT CTCCCCTGGA CAAGGGTGGC TTTGTAGTCC AGTTGGGTCT GGGGGGGGAG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_015680220.1
    CDS119..2161
    Translation

    Target ORF information:

    RefSeq Version XM_015824734.1
    Organism Protobothrops mucrosquamatus
    Definition Protobothrops mucrosquamatus transmembrane and coiled-coil domains 4 (TMCO4), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_015824734.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCTGCTG ATCCCCGGCC AGGCTGGAGG CCCTGGAGAA GCCAGCCACA GAAGGAAGAA 
    GAAGAAGAAG AAGACCCGGG ACCGAGGACA CGTCCAGGCG CCCAGTTGGG TGAGCCGGGG
    AAATACGCCT ACGCGGCTCT CTGTGCCATT TCCTTGGCCT CGTTGTTTCC GGATCAGGAG
    GAGAGTGCCT ACAGGACCGG AGTGGTGGAG AACCTGGTCC GGTGGCTGGA GCTGTCGGAG
    GCGGTGATGC CCTCCATGCT GGCCTTTGCT GGGGGGCTGG GGGCTGAAGG GACAGAGACC
    TTCGCTCGGA TTCTTCTGGG CGAGACGCTT CTGAAGGATC AGCCCGGCGC CATCATGCTG
    GACCTGGTTT CCTTTTCTCT CAAGGATGGC TACTACGACG CTCGCATGCG GGTGCTTCTC
    TCCCACGTGG CCTGTTTGCT GAGGATCCCG TTGGCAGAAC TGGAAGAGGC AGAGGACTAT
    CTCCTTGAAT GTCTGAAGGA GGAGAAAGAG GCGGAATCGG AAACGGACGA AGGCAAGCGG
    AAGAAGAAGG AGAGAAGGAA GAGGCTGAAG CGCTACCTGC TGATCGGCTT GGCGACGGTA
    GGAGGAGGGA CGGTCATCGG CCTGACCGGG GGTCTGGCTG CCCCCTTGGT GGGCATGGGA
    GCAGCCACCA TCATCGGAAC TGCTGGAGCC ACGGCCTTGG GGTCAGCAGC TGGGATGGCC
    ATTATCGGTT CGCTCTTTGG AGCTGCTGGG GCCGGACTCG TGGGGTACAA GATGAAAAAG
    CGCGTAGGGG CCATAGAAGA ATTCGAATTC CTTCCCTTAA CCGAAGCGAA GCAGCTCCAT
    ATCACCATTG CCATCACCGG CTGGCTTTCT GCTGGGAAGT ACGGCAGTTT CACAGCCCCC
    TGGAGCAGCC TCTTACAGTC CAAGGAGCAG TACTGCTTAG CCTGGGAGTC CAAGTACCTG
    CTGGAGCTGG GCAGCGCCCT GGACGCCTTG TGGAATGGGC TGGTTAACAT GGTCGCCCAG
    GAGGCCCTCA AGTACACGGT CTTGGCGGGG ATCGTGACGG CCCTCACCTG GCCTGCTTCG
    CTGCTGGCAG TGGCTGGTGT GATAGACAAC CCCTGGGGTG TGTGTCTCCA TCGCTCCGCT
    GAGGTCGGGA AACACTTGGC ACAGATACTT CTTAGCCGGC GGCAGGGCAA ACGGCCGGTG
    ACGCTGGTCG GATTCAGTCT CGGTGCTAGG GTGATCTACT TTTGCCTGCA GGAGATGGCC
    AAGGAGAAAG ACTGCGAAGG GATCATTGAA GACGTGGTGC TGCTGGGGGC CCCGATAGAA
    GGAGATCCCA AACCCTGGAA GCTGATCACC AAAGTCATTT CAGGCAAGAT CATCAACGGC
    TTCTGCAGGG GAGACTGGCT GTTGAAATTT GTCTACCGCA CGTCGTCCAT TCAGCTGAGC
    GTGGCAGGGC TTCAGCCCAT CTGCCTGGAT GACCGCCGGG TGGTCAACGT GGACCTGTCT
    TCCGTGGTGA ATGGTCACCT GGACTACATG AAGCAGATGG ACACCATCCT GAAGGCCGTG
    GGGCTCAAAA CGAGGCCGGC CCTGCAAGAA CGAGGGGGGC TCCTGGCAGC GTCTTCCGCC
    CCCAGTGAGA AGGAGGAGGA GGAGGAGGAG GAGGAGAAAC AGGGGGTGTC TCCGGACGGC
    ACCGCCACCT CCTCGGAGGA GCCCAGTGTG GTGGGCAGGC CCGATGTGGG TGGACCTGCG
    GAGGGGGAAG GCCTCCAGGG CAATGAAGAC TACTGGTGTT GGGAGGCGGT CTCCGCTCCC
    GGACAGTCTC AGACAGACAG GTGGGGGCTC CTGGAAACCT CCAAAGCTGA TGTGAGAGTC
    GGCATTCTTT TCTCTTTGAT GTCTGGTATC CTGCCCCTGG ACACGGAGGC TCTACTCTTT
    GCCGCCACGT CTCCGACTGT GCCAAAAGCT GTGAAGTCAG CGCTGCAGGT CCCTGACCAC
    AGCTCCCATT CTCCCCTGGA CAAGGGTGGC TTTGTAGTCC AGTTGGGTCT GGGGGGGGAG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.