CASKIN2 cDNA ORF clone, Protobothrops mucrosquamatus

The following CASKIN2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the CASKIN2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPr200182 XM_029285207.1
Latest version!
Protobothrops mucrosquamatus CASK interacting protein 2 (CASKIN2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $727.30
$1039.00
OPr35055 XM_015821825.1
Latest version!
Protobothrops mucrosquamatus CASK interacting protein 2 (CASKIN2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $727.30
$1039.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPr200182
    Clone ID Related Accession (Same CDS sequence) XM_029285207.1
    Accession Version XM_029285207.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4452bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
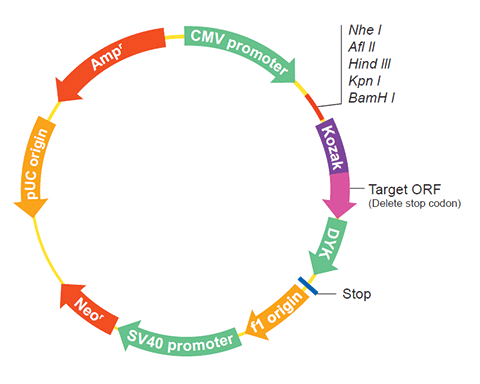
    Clone information Clone Map MSDS
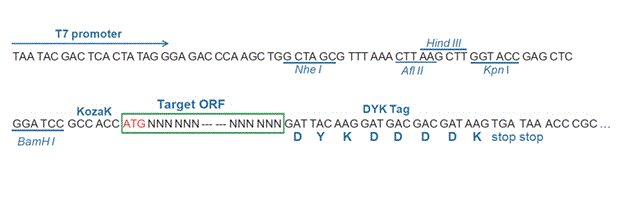
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-05-22
    Organism Protobothrops mucrosquamatus
    Product caskin-2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015387591.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Protobothrops mucrosquamatus Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    ATGGGGCGAG AACAGGAATT GATCCAGGCT GTGAAAAATG AGGATGTACC TGGTGTACAG 
    AAATTGGTAG CAAAGATCAA GGTGTCCAAA AGTAAACTCT TGGGATCAAC TAAACGGCTG
    AATGTGAACT ACCAGGATGT GGATGGGTTT TCAGCTTTGC ACCATGCAGC CTTGGTTGGA
    AGCCTGGAAC TTATCTCCCT GTTGCTGGAG GCACAGGCCG TTGTGGATAT TAAGGACACA
    AACGGAATGC GCCCTTTACA CTATGCTGCC TGGCAAGGGA AAGTGGAGCC CGTGCGCCTC
    CTGCTACGGG CGTCTGCCTC AGTCAATATG GCATCATTGG ATGGACAGGT CCCACTGCAC
    CTGTCTGCCC AGTATGGCCA CTATGAAGTG TCAGAGATGT TGCTTCAGCA CCAATCCAAC
    CCGTGTCTTA TAAATAAGGC TAAGAAAACC CCCTTGGACT TGGCTTGTGA GTTTGGGAGG
    CTGAAGGTAG CCCAGTTGCT TCTAAACAGC CATATGTGTG TGGCTCTTCT TGAGGGACAA
    TTCAAAGACA CAAGTGACCC CAACTACACT ACACCTCTAC ACCTGGCAGC CAAGAATGGG
    CACAAGGAGA TTATCAGACA ACTCCTGAAA GCGGGAATTG AGATCAACAG GCAGACAAAA
    ACAGGCACTG CCTTGCATGA AGCTGCCCTG TATGGCAAGA CAGAAGTGGT GCGCCTCCTG
    CTGCAGGGGG GCATTGATGT CAACATTCGC AACACCTACA ACCAGACAGC CTTGGATATT
    GTGAACCAGT TCACCACTTC ACATGCCAGC AAGGACATCA AGCAGCTCTT ACGAGAGGCA
    TCAGGAATCT TGAAGGTCCG TGCTTTAAAG GATTTCTGGA ATCTGCACGA TCCAACAGCT
    CTCAACATCC GTGCTGGAGA TGTCATTACG GTCCTGGAGC AGCATGCAGA CGGACGGTGG
    AAGGGCCATA TCCACGATGC TCAGAAAGGC ACTGACCGAG TTGGCTATTT TCCTCCATCC
    ATTGTAGAAG TAATCAGCAA GCGGACAGGC CTGACTCTTT CCCGCACGGT GTCCACACAT
    CAGTGCCAGA GCCATGCAAA GGGACTGCAG GTTACCACCA CAGCCACCCC TCCTGGTGGG
    CTACAACTAC ATACCGACGC CTCTCCGCCA CAGGCACCTC TCAGCCTCCC TGCAGGTTGG
    GGCCACCTCA CTCTGACTAG GACAGCTCCA GCACCTGAGA GCCCAGCAGG TGATAGAAAC
    AGTGTGGGCA GCGAAGGCAG CATTGGCAGT ATCCGAAGCG CTGGTAGTGG TCAAAGTACG
    GAGGGTACCA ATGGACAATT CGTGGGACTC CTTATTGAGA ATGTAAAGCC ACTTTTGCCT
    GGTGGGGAGG ATCTGCAGCA ACATGTCCTG AGTTCAAATT CTCACAATGG CCAAACCAGC
    TCCTTGGGGA CACAAGTGCA TCAGAATTTC TCCAATGACA GGATCTTCTC CCACCAATAT
    TTACGCCCAG AGCAGCTCCT GGAAGGGAAG GATGCTGCAG CCATTTACAA TTGGCTATGC
    GAATTCCAGC TGGAGTGTTA TACGGGCAAC TTTCTGAATG CAGGTTATGA TGTGCCAACA
    ATCAGCCGCA TGACTCCAGA GGATCTCACA GCAATTGGGG TAACCAAACC AGGCCACAGG
    AAGAAAATTT CGACAGAGAT TGGACAGCTC AGCATTTCTG AATGGCTCCC AAATTATATT
    CCTGATGACT TGATGGAATG GTTGAGTGCT ATTGGTCTAC CACAGTACCA CAAAAAGTTG
    GTGAGCAACG GTTATGACTC CATCAACATT GTGACCGATC TGACTTGGGA GGATTTGCAA
    GAGATTGGCA TCAACAAACT TGGCCACCAA AAGAAGATCA TGCTGGCTGT CAAGAGATTG
    ACTGATCTTT GTAAAAGTCA GAGCCAGGCT GAAGTCAACA CTCTTAGGCG CAAGATCCCT
    GGTACCTTGG AAATAGTCAC CATTGAGACC GTGGAGAATG GGGAGTGCCA TTCTCCTCTC
    ACCCCCAAAA TGACCACTTT TCAGGACAGT GAGCTGAGCC ATGAGCTCCA GACAGCCATG
    TCCAACAGCT GCCAAGAGAC ATTGACCATC AAGAGTACCC AAGGCATGTC ACGGAGCCAA
    GAGAGCATTG GTGCACGTTC TAGAGGATCA GGACATTCCC AGGAGAACAT GCTGTCCCAA
    AGCACGTCCT CTAGCCATTC TGAGGAGAGT TTGGGTAGTG GCGAAGGGAG CAGCGGGAGC
    AGTGGAGGGC ATTCTTTCAC CCAGCCCCAT CCTGCGGAGA ACTCTGCCAG TACCCAGGGT
    CGACCCAGCC CAGACCACTA TGGGAAATTC ATTCCATTGC TCAATGGACC AGATGGAACC
    AGTGGCTATT CTAGCAGTTG TGTGGGAAGT CCCCTAAAGG AGAGAAATCT GCCCGAGGGG
    ATGGATCACT ACCAGAGACC AAGTGCTTCA CCAGAGCCAT CAAGCCCCCT ACCAGTCCCC
    TCCCCCTGCA CATTGCCCCA TGCTGCCAGC AAGGGAACAG CCCCATATGT CTTCATGTAT
    CCCCACATAT CACTGAAGGC CCAGTCAGCT CCTCCACCTT CCATGCCTGA ACAGGCCAAG
    GCATCTACCC ATTTGTCTGT CCAGAGGACC ACCCTCCAGT CAACTGCCCA GAAAGCTTTC
    TCCTACCTTC ATTCCCACTG CGGCCCTACA GAGCCACCTC AGGTGCCCCC AAAGCCTAGG
    CCTGAACTGC AAAACGGTGA GGGTTTTAAG CACAAGAAAC GCTCACAAAG CTTGAACCGC
    TATGCGCTGT CTGATGGGGA ACCTGATGAA GAAGAACCAG CCAGTAGCTC AGTGGGCTCT
    TACGCTACCC TAACCAGGCG ACCTGGGCGC AGTCAAGTGT CACGCACACA ACCACCTTCA
    GAAGCTAAAG TCTTGCGCAG TCAGTCTTTT GCTATCCGTG CCCGGAAAAA AGGCCCTCCA
    CCTCCACCTC CTAAACGCCT CAGTTCAGTC TCCAGCCCTT TAGCAGTTGA TGCAGAGTTT
    GAACAAGGTC AACAGATGCA GAACGGATCC TTGGTCTCCA AGGACAAAGG GGATAATACT
    AATGATAGAG CTTGCCTGGG GGAAAATACA GTTGCTAAGC TTGATAGGCC AATCTATGAT
    GGAAGCCCAG CCCAGCCTCT TCAGTCTTCT CAGATCCCCA GTTGTGGTCA GGAAGGTGCC
    AAGAAAGGTG GCCTACACAA TTCAGTTCAG GGAGGCCTTG GTAACACCAA TACCCTAAAT
    AGTAGAAGTC AAGTTTTGGA AGGCAACACT CCCAGGAGAC GAACATTCAG TGAATCAGCA
    GTTACCATGA CAGAGGCGTT GCAGCGTAAC CATGAAGATA TCCGATCAGA CACTGAGGAA
    GATGGTCCAG CTGAGAAGGA TGACTGTGCC AAATCCCCTT GTTCTTCCCA AAACAGCTCC
    AGTGAGTGCA TCCCCTTTGC AGAAGAAGGC AACCTAACCA TCAAACAGCG ACCAAAGCCT
    TTGGGGCAGC TCAAAACAGA GGCCCTGGCT CCAGACTCAG ACTCTGCTCC TGCTCAGTCC
    AATGGGAAAG AGTCTTCAGG GGCTTCAGCA AAAGAAGCCC CAGTGTTGGA ATTCAATCTC
    ACAGAATCCG ACACGGTCAA GAGGCGGCCC CGGTGCAAAG AGAGGGAACC TCTCCAAAAT
    GTCCTGAAGG CCTTTGGCAT GGCCACTCCA AGCCCTGGCA TGACCATCGC CCCGCAGTAC
    GCCCAGGCCC AGACAGTCAG CATCAGTGGG CCTTCGCTGC ACATGATGGA ACCGCTCCCT
    ACCACAGGCC CGTTGGAGGA TGACAACATG GCGTTCCAAA TAGTTGAGAT AGAGAAAAGC
    ATCCTGTCCC TAGAGAAGGG GATTAGCAAG CTTCCTGTCT CTTTGAAACC AGCCAGTCCA
    GGGCCACCGC ACAGTGAGAG GCCTGGAGGG TCAGCCCAGC TCAGAATACC GGCCACGGCA
    ACAGACATGA CGGCCATGCC GACATCCATC GCTTCTACCA AGCTGGTATT TTCAGGACCC
    AAAACCATCT ATCAGCAAGT CTTGCCAAAC TCTCACCACA CAAGTCCCTC CAGAGCAACC
    CCTGAGACAG TGTCGGAGGT ATCTGGTCCC TATCCCATGA AACTGGGCCT CAGCAATAAG
    CCTTCCTTAA ATTTTGGGGT GCCCCTTCCA CCAAGAGCTT CAAGCATGTG CCCAGATATA
    ACACAGAGCC AGCAGCGTCT GGAACAAACC AGTTCATCTT TGGCATCCAC ACTTGAGGCT
    GCCGAAAAGG AGATCCTTGC AGAGGAAGCA GACAGTTGCT ATGGGACAAC ACACTCAGCC
    AAGAACATTC TTGAAGACAT CAGCAACATG TTCAACGACC TAGCTGAACA GCTGGATGCC
    ATGTTGGACT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029141040.1
    CDS108..4559
    Translation

    Target ORF information:

    RefSeq Version XM_029285207.1
    Organism Protobothrops mucrosquamatus
    Definition Protobothrops mucrosquamatus CASK interacting protein 2 (CASKIN2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029285207.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    ATGGGGCGAG AACAGGAATT GATCCAGGCT GTGAAAAATG AGGATGTACC TGGTGTACAG 
    AAATTGGTAG CAAAGATCAA GGTGTCCAAA AGTAAACTCT TGGGATCAAC TAAACGGCTG
    AATGTGAACT ACCAGGATGT GGATGGGTTT TCAGCTTTGC ACCATGCAGC CTTGGTTGGA
    AGCCTGGAAC TTATCTCCCT GTTGCTGGAG GCACAGGCCG TTGTGGATAT TAAGGACACA
    AACGGAATGC GCCCTTTACA CTATGCTGCC TGGCAAGGGA AAGTGGAGCC CGTGCGCCTC
    CTGCTACGGG CGTCTGCCTC AGTCAATATG GCATCATTGG ATGGACAGGT CCCACTGCAC
    CTGTCTGCCC AGTATGGCCA CTATGAAGTG TCAGAGATGT TGCTTCAGCA CCAATCCAAC
    CCGTGTCTTA TAAATAAGGC TAAGAAAACC CCCTTGGACT TGGCTTGTGA GTTTGGGAGG
    CTGAAGGTAG CCCAGTTGCT TCTAAACAGC CATATGTGTG TGGCTCTTCT TGAGGGACAA
    TTCAAAGACA CAAGTGACCC CAACTACACT ACACCTCTAC ACCTGGCAGC CAAGAATGGG
    CACAAGGAGA TTATCAGACA ACTCCTGAAA GCGGGAATTG AGATCAACAG GCAGACAAAA
    ACAGGCACTG CCTTGCATGA AGCTGCCCTG TATGGCAAGA CAGAAGTGGT GCGCCTCCTG
    CTGCAGGGGG GCATTGATGT CAACATTCGC AACACCTACA ACCAGACAGC CTTGGATATT
    GTGAACCAGT TCACCACTTC ACATGCCAGC AAGGACATCA AGCAGCTCTT ACGAGAGGCA
    TCAGGAATCT TGAAGGTCCG TGCTTTAAAG GATTTCTGGA ATCTGCACGA TCCAACAGCT
    CTCAACATCC GTGCTGGAGA TGTCATTACG GTCCTGGAGC AGCATGCAGA CGGACGGTGG
    AAGGGCCATA TCCACGATGC TCAGAAAGGC ACTGACCGAG TTGGCTATTT TCCTCCATCC
    ATTGTAGAAG TAATCAGCAA GCGGACAGGC CTGACTCTTT CCCGCACGGT GTCCACACAT
    CAGTGCCAGA GCCATGCAAA GGGACTGCAG GTTACCACCA CAGCCACCCC TCCTGGTGGG
    CTACAACTAC ATACCGACGC CTCTCCGCCA CAGGCACCTC TCAGCCTCCC TGCAGGTTGG
    GGCCACCTCA CTCTGACTAG GACAGCTCCA GCACCTGAGA GCCCAGCAGG TGATAGAAAC
    AGTGTGGGCA GCGAAGGCAG CATTGGCAGT ATCCGAAGCG CTGGTAGTGG TCAAAGTACG
    GAGGGTACCA ATGGACAATT CGTGGGACTC CTTATTGAGA ATGTAAAGCC ACTTTTGCCT
    GGTGGGGAGG ATCTGCAGCA ACATGTCCTG AGTTCAAATT CTCACAATGG CCAAACCAGC
    TCCTTGGGGA CACAAGTGCA TCAGAATTTC TCCAATGACA GGATCTTCTC CCACCAATAT
    TTACGCCCAG AGCAGCTCCT GGAAGGGAAG GATGCTGCAG CCATTTACAA TTGGCTATGC
    GAATTCCAGC TGGAGTGTTA TACGGGCAAC TTTCTGAATG CAGGTTATGA TGTGCCAACA
    ATCAGCCGCA TGACTCCAGA GGATCTCACA GCAATTGGGG TAACCAAACC AGGCCACAGG
    AAGAAAATTT CGACAGAGAT TGGACAGCTC AGCATTTCTG AATGGCTCCC AAATTATATT
    CCTGATGACT TGATGGAATG GTTGAGTGCT ATTGGTCTAC CACAGTACCA CAAAAAGTTG
    GTGAGCAACG GTTATGACTC CATCAACATT GTGACCGATC TGACTTGGGA GGATTTGCAA
    GAGATTGGCA TCAACAAACT TGGCCACCAA AAGAAGATCA TGCTGGCTGT CAAGAGATTG
    ACTGATCTTT GTAAAAGTCA GAGCCAGGCT GAAGTCAACA CTCTTAGGCG CAAGATCCCT
    GGTACCTTGG AAATAGTCAC CATTGAGACC GTGGAGAATG GGGAGTGCCA TTCTCCTCTC
    ACCCCCAAAA TGACCACTTT TCAGGACAGT GAGCTGAGCC ATGAGCTCCA GACAGCCATG
    TCCAACAGCT GCCAAGAGAC ATTGACCATC AAGAGTACCC AAGGCATGTC ACGGAGCCAA
    GAGAGCATTG GTGCACGTTC TAGAGGATCA GGACATTCCC AGGAGAACAT GCTGTCCCAA
    AGCACGTCCT CTAGCCATTC TGAGGAGAGT TTGGGTAGTG GCGAAGGGAG CAGCGGGAGC
    AGTGGAGGGC ATTCTTTCAC CCAGCCCCAT CCTGCGGAGA ACTCTGCCAG TACCCAGGGT
    CGACCCAGCC CAGACCACTA TGGGAAATTC ATTCCATTGC TCAATGGACC AGATGGAACC
    AGTGGCTATT CTAGCAGTTG TGTGGGAAGT CCCCTAAAGG AGAGAAATCT GCCCGAGGGG
    ATGGATCACT ACCAGAGACC AAGTGCTTCA CCAGAGCCAT CAAGCCCCCT ACCAGTCCCC
    TCCCCCTGCA CATTGCCCCA TGCTGCCAGC AAGGGAACAG CCCCATATGT CTTCATGTAT
    CCCCACATAT CACTGAAGGC CCAGTCAGCT CCTCCACCTT CCATGCCTGA ACAGGCCAAG
    GCATCTACCC ATTTGTCTGT CCAGAGGACC ACCCTCCAGT CAACTGCCCA GAAAGCTTTC
    TCCTACCTTC ATTCCCACTG CGGCCCTACA GAGCCACCTC AGGTGCCCCC AAAGCCTAGG
    CCTGAACTGC AAAACGGTGA GGGTTTTAAG CACAAGAAAC GCTCACAAAG CTTGAACCGC
    TATGCGCTGT CTGATGGGGA ACCTGATGAA GAAGAACCAG CCAGTAGCTC AGTGGGCTCT
    TACGCTACCC TAACCAGGCG ACCTGGGCGC AGTCAAGTGT CACGCACACA ACCACCTTCA
    GAAGCTAAAG TCTTGCGCAG TCAGTCTTTT GCTATCCGTG CCCGGAAAAA AGGCCCTCCA
    CCTCCACCTC CTAAACGCCT CAGTTCAGTC TCCAGCCCTT TAGCAGTTGA TGCAGAGTTT
    GAACAAGGTC AACAGATGCA GAACGGATCC TTGGTCTCCA AGGACAAAGG GGATAATACT
    AATGATAGAG CTTGCCTGGG GGAAAATACA GTTGCTAAGC TTGATAGGCC AATCTATGAT
    GGAAGCCCAG CCCAGCCTCT TCAGTCTTCT CAGATCCCCA GTTGTGGTCA GGAAGGTGCC
    AAGAAAGGTG GCCTACACAA TTCAGTTCAG GGAGGCCTTG GTAACACCAA TACCCTAAAT
    AGTAGAAGTC AAGTTTTGGA AGGCAACACT CCCAGGAGAC GAACATTCAG TGAATCAGCA
    GTTACCATGA CAGAGGCGTT GCAGCGTAAC CATGAAGATA TCCGATCAGA CACTGAGGAA
    GATGGTCCAG CTGAGAAGGA TGACTGTGCC AAATCCCCTT GTTCTTCCCA AAACAGCTCC
    AGTGAGTGCA TCCCCTTTGC AGAAGAAGGC AACCTAACCA TCAAACAGCG ACCAAAGCCT
    TTGGGGCAGC TCAAAACAGA GGCCCTGGCT CCAGACTCAG ACTCTGCTCC TGCTCAGTCC
    AATGGGAAAG AGTCTTCAGG GGCTTCAGCA AAAGAAGCCC CAGTGTTGGA ATTCAATCTC
    ACAGAATCCG ACACGGTCAA GAGGCGGCCC CGGTGCAAAG AGAGGGAACC TCTCCAAAAT
    GTCCTGAAGG CCTTTGGCAT GGCCACTCCA AGCCCTGGCA TGACCATCGC CCCGCAGTAC
    GCCCAGGCCC AGACAGTCAG CATCAGTGGG CCTTCGCTGC ACATGATGGA ACCGCTCCCT
    ACCACAGGCC CGTTGGAGGA TGACAACATG GCGTTCCAAA TAGTTGAGAT AGAGAAAAGC
    ATCCTGTCCC TAGAGAAGGG GATTAGCAAG CTTCCTGTCT CTTTGAAACC AGCCAGTCCA
    GGGCCACCGC ACAGTGAGAG GCCTGGAGGG TCAGCCCAGC TCAGAATACC GGCCACGGCA
    ACAGACATGA CGGCCATGCC GACATCCATC GCTTCTACCA AGCTGGTATT TTCAGGACCC
    AAAACCATCT ATCAGCAAGT CTTGCCAAAC TCTCACCACA CAAGTCCCTC CAGAGCAACC
    CCTGAGACAG TGTCGGAGGT ATCTGGTCCC TATCCCATGA AACTGGGCCT CAGCAATAAG
    CCTTCCTTAA ATTTTGGGGT GCCCCTTCCA CCAAGAGCTT CAAGCATGTG CCCAGATATA
    ACACAGAGCC AGCAGCGTCT GGAACAAACC AGTTCATCTT TGGCATCCAC ACTTGAGGCT
    GCCGAAAAGG AGATCCTTGC AGAGGAAGCA GACAGTTGCT ATGGGACAAC ACACTCAGCC
    AAGAACATTC TTGAAGACAT CAGCAACATG TTCAACGACC TAGCTGAACA GCTGGATGCC
    ATGTTGGACT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPr35055
    Clone ID Related Accession (Same CDS sequence) XM_015821825.1
    Accession Version XM_015821825.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4107bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-03-01
    Organism Protobothrops mucrosquamatus
    Product LOW QUALITY PROTEIN: caskin-2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015387591.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Protobothrops mucrosquamatus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 25% of CDS bases frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    ATGGGGCGAG AACAGGAATT GATCCAGGCT GTGAAAAATG AGGATGTACC TGGTGTACAG 
    AAATTGGTAG CAAAGATCAA GGTGTCCAAA AGTAAACTCT TGGGATCAAC TAAACGGCTG
    AATGTGAACT ACCAGGATGT GGATGGGTTT TCAGCTTTGC ACCATGCAGC CTTGGTTGGA
    AGCCTGGAAC TTATCTCCCT GTTGCTGGAG GCACAGGCCG TTGTGGATAT TAAGGACACA
    AACGGAATGC GCCCTTTACA CTATGCTGCC TGGCAAGGGA AAGTGGAGCC CGTGCGCCTC
    CTGCTACGGG CGTCTGCCTC AGTCAATATG GCATCATTGG ATGGACAGGT CCCACTGCAC
    CTGTCTGCCC AGTATGGCCA CTATGAAGTG TCAGAGATGT TGCTTCAGCA CCAATCCAAC
    CCGTGTCTTA TAAATAAGGC TAAGAAAACC CCCTTGGACT TGGCTTGTGA GTTTGGGAGG
    CTGAAGGTAG CCCAGTTGCT TCTAAACAGC CATATGTGTG TGGCTCTTCT TGAGGGACAA
    TTCAAAGACA CAAGTGACCC CAACTACACT ACACCTCTAC ACCTGGCAGC CAAGAATGGG
    CACAAGGAGA TTATCAGACA ACTCCTGAAA GCGGGAATTG AGATCAACAG GCAGACAAAA
    ACAGGCACTG CCTTGCATGA AGCTGCCCTG TATGGCAAGA CAGAAGTGGT GCGCCTCCTG
    CTGCAGGGGG GCATTGATGT CAACATTCGC AACACCTACA ACCAGACAGC CTTGGATATT
    GTGAACCAGT TCACCACTTC ACATGCCAGC AAGGACATCA AGCAGCTCTT ACGAGAGGCA
    TCAGGAATCT TGAAGGTCCG TGCTTTAAAG GATTTCTGGA ATCTGCACGA TCCAACAGCT
    CTCAACATCC GTGCTGGAGA TGTCATTACG GTCCTGGAGC AGCATGCAGA CGGACGGTGG
    AAGGGCCATA TCCACGATGC TCAGAAAGGC ACTGACCGAG TTGGCTATTT TCCTCCATCC
    ATTGTAGAAG TAATCAGCAA GCGGACAGGT TGGCCCCGGG TTATAAAGGG AAAGTTACCA
    CCACAGCCAC CCCTCCTGGT GGGCTACAAC TACATACCGA CGCCTCCGCC ACAGGCACCT
    CTCAGCCTCC CTGCAGGTTG GGGCCACCTC ACTCTGACTA GGACAGCTCC AGCACCTGAG
    AGCCCAGCAG GTGATAGAAA CAGTGTGGGC AGCGAAGGCA GCATTGGCAG TATCCGAAGC
    GCTGGTAGTG GTCAAAGTAC GGAGGGTACC AATGGACAAT TCGTGGGACT CCTTATTGAG
    AATGTAAAGC CACTTTTGCC TGGTGGGGAG GATCTAGTTA TTGGAGGTTT TCTAGTCCAT
    CCCCCTGCTC AGGCAGGAAA CCCTATATCA GGGAATTTCT CCAATGACAG GATCTTCTCC
    CACCAATATT TACGCCCAGA GCAGCTCCTG GAAGGGAAGG ATGCTGCAGC CATTTACAAT
    TGGCTATGCG AATTCCAGCT GGAGTGTTAT ACGGGCAACT TTCTGAATGC AGGTTATGAT
    GTGCCAACAA TCAGCCGCAT GACTCCAGAG GATCTCACAG CAATTGGGGT AACCAAACCA
    GGCCACAGGA AGAAAATTTC GACAGAGATT GGACAGCTCA GCATTTCTGA ATGGCTCCCA
    AATTATATTC CTGATGACTT GATGGAATGG TTGAGTGCTA TTGGTCTACC ACAGTACCAC
    AAAAAGTTGG TGAGCAACGG TTATGACTCC ATCAACATTG TGACCGATCT GACTTGGGAG
    GATTTGCAAG AGATTGGCAT CAACAAACTT GGCCACCAAA AGAAGATCAT GCTGGCTGTC
    AAGAGATTGA CTGATCTTTG TAAAAGTCAG AGCCAGGCTG AAGTCAACAC TCTTAGGCGC
    AAGATCCCTG GTACCTTGGA AATAGTCACC ATTGAGACCG TGGAGAATGG GGAGTGCCAT
    TCTCCTCTCA CCCCCAAAAT GACCACTTTT CAGGACAGTG AGCTGAGCCA TGAGCTCCAG
    ACAGCCATGT CCAACAGCTG CCAAGAGACA TTGACCATCA AGAGTACCCA AGGCATGTCA
    CGGAGCCAAG AGAGCATTGG TGCACGTTCT AGAGGATCAG GACATTCCCA GGAGAACATG
    CTGTCCCAAA GCACGTCCTC TAGCCATTCT GAGGAGAGTT TGGGTAGTGG CGAAGGGAGC
    AGCGGGAGCA GTGGAGGGCA TTCTTTCACC CAGCCCCATC CTGCGGAGAA CTCTGCCAGT
    ACCCAGGGTC GACCCAGCCC AGACCACTAT GGGAAATTCA TTCCATTGCT CAATGGACCA
    GATGGAACCA GTGGCTATTC TAGCAGTTGT GTGGGAAGTC CCCTAAAGGA GAGAAATCTG
    CCCGAGGGGA TGGATCACTA CCAGAGACCA AGTGCTTCAC CAGAGCCATC AAGCCCCCTA
    CCAGTCCCCT CCCCCTGCAC ATTGCCCCAT GCTGCCAGCA AGGGAACAGC CCCATATGTC
    TTCATGTATC CCCACATATC ACTGAAGGCC CAGTCAGCTC CTCCACCTTC CATGCCTGAA
    CAGGCCAAGG CATCTACCCA TTTGTCTGTC CAGAGGACCA CCCTCCAGTC AACTGCCCAG
    AAAGCTTTCT CCTACCTTCA TTCCCACTGC GGCCCTACAG AGCCACCTCA GGTGCCCCCA
    AAGCCTAGGC CTGAACTGCA AAACGGTGAG GGTTTTAAGC ACAAGAAACG CTCACAAAGC
    TTGAACCGCT ATGCGCTGTC TGATGGGGAA CCTGATGAAG AAGAACCAGC CAGTAGCTCA
    GTGGGCTCTT ACGCTACCCT AACCAGGCGA CCTGGGCGCA GTCAAGTGTC ACGCACACAA
    CCACCTTCAG AAGCTAAAGT CTTGCGCAGT CAGTCTTTTG CTATCCGTGC CCGGAAAAAA
    GGCCCTCCAC CTCCACCTCC TAAACGCCTC AGTTCAGTCT CCAGCCCTTT AGCAGTTGAT
    GCAGAGTTTG AACAAGGTCA ACAGATGCAG AACGGATCCT TGGTCTCCAA GGACAAAGGG
    GATAATACTA ATGATAGAGC TTGCCTGGGG GAAAATACAG TTGCTAAGCT TGATAGGCCA
    ATCTATGATG GAAGCCCAGC CCAGCCTCTT CAGTCTTCTC AGATCCCCAG TTGTGGTCAG
    GAAGGTGCCA AGAAAGGTGG CCTACACAAT TCAGTTCAGG GAGGCCTTGG TAACACCAAT
    ACCCTAAATA GTAGAAGTCA AGTTTTGGAA GGCAACACTC CCAGGAGACG AACATTCAGT
    GAATCAGCAG TTACCATGAC AGAGGCGTTG CAGCGTAACC ATGAAGATAT CCGATCAGAC
    ACTGAGGAAG ATGGTCCAGC TGAGAAGGAT GACTGTGCCA AATCCCCTTG TTCTTCCCAA
    AACAGCTCCA GTGAGTGCAT CCCCTTTGCA GAAGAAGGCA ACCTAACCAT CAAACAGCGA
    CCAAAGCCTT TGGGGCCTTC AGCAAAAGAA GCCCCAGTGT TGGAATTCAA TCTCACAGAA
    TCCGACACGG TCAAGAGGCG GCCCCGGTGC AAAGAGAGGG AACCTCTCCA AAATGTCCTG
    AAGGCCTTTG GCATGGCCAC TCCAAGCCCT GGCATGACCA TCGCCCCGCA GTACGCCCAG
    GCCCAGACAG TCAGCATCAA CATGACGGCC ATGCCGACAT CCATCGCTTC TACCAAGCTG
    GTATTTTCAG GACCCAAAAC CATCTATCAG CAAGTCTTGC CAAACTCTCA CCACACAAGT
    CCCTCCAGAG CAACCCCTGA GACAGTGTCG GAGGTATCTG GTCCCTATCC CATGAAACTG
    GGCCTCAGCA ATAAGCCTTC CTTAAATTTT GGGGTGCCCC TTCCACCAAG AGCTTCAAGC
    ATGTGCCCAG ATATAACACA GAGCCAGCAG CGTCTGGAAC AAACCAGTTC ATCTTTGGCA
    TCCACACTTG AGGCTGCCGA AAAGGAGATC CTTGCAGAGG AAGCAGACAG TTGCTATGGG
    ACAACACACT CAGCCAAGAA CATTCTTGAA GACATCAGCA ACATGTTCAA CGACCTAGCT
    GAACAGCTGG ATGCCATGTT GGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_015677311.1
    CDS108..4214
    Translation

    Target ORF information:

    RefSeq Version XM_015821825.1
    Organism Protobothrops mucrosquamatus
    Definition Protobothrops mucrosquamatus CASK interacting protein 2 (CASKIN2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_015821825.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    ATGGGGCGAG AACAGGAATT GATCCAGGCT GTGAAAAATG AGGATGTACC TGGTGTACAG 
    AAATTGGTAG CAAAGATCAA GGTGTCCAAA AGTAAACTCT TGGGATCAAC TAAACGGCTG
    AATGTGAACT ACCAGGATGT GGATGGGTTT TCAGCTTTGC ACCATGCAGC CTTGGTTGGA
    AGCCTGGAAC TTATCTCCCT GTTGCTGGAG GCACAGGCCG TTGTGGATAT TAAGGACACA
    AACGGAATGC GCCCTTTACA CTATGCTGCC TGGCAAGGGA AAGTGGAGCC CGTGCGCCTC
    CTGCTACGGG CGTCTGCCTC AGTCAATATG GCATCATTGG ATGGACAGGT CCCACTGCAC
    CTGTCTGCCC AGTATGGCCA CTATGAAGTG TCAGAGATGT TGCTTCAGCA CCAATCCAAC
    CCGTGTCTTA TAAATAAGGC TAAGAAAACC CCCTTGGACT TGGCTTGTGA GTTTGGGAGG
    CTGAAGGTAG CCCAGTTGCT TCTAAACAGC CATATGTGTG TGGCTCTTCT TGAGGGACAA
    TTCAAAGACA CAAGTGACCC CAACTACACT ACACCTCTAC ACCTGGCAGC CAAGAATGGG
    CACAAGGAGA TTATCAGACA ACTCCTGAAA GCGGGAATTG AGATCAACAG GCAGACAAAA
    ACAGGCACTG CCTTGCATGA AGCTGCCCTG TATGGCAAGA CAGAAGTGGT GCGCCTCCTG
    CTGCAGGGGG GCATTGATGT CAACATTCGC AACACCTACA ACCAGACAGC CTTGGATATT
    GTGAACCAGT TCACCACTTC ACATGCCAGC AAGGACATCA AGCAGCTCTT ACGAGAGGCA
    TCAGGAATCT TGAAGGTCCG TGCTTTAAAG GATTTCTGGA ATCTGCACGA TCCAACAGCT
    CTCAACATCC GTGCTGGAGA TGTCATTACG GTCCTGGAGC AGCATGCAGA CGGACGGTGG
    AAGGGCCATA TCCACGATGC TCAGAAAGGC ACTGACCGAG TTGGCTATTT TCCTCCATCC
    ATTGTAGAAG TAATCAGCAA GCGGACAGGT TGGCCCCGGG TTATAAAGGG AAAGTTACCA
    CCACAGCCAC CCCTCCTGGT GGGCTACAAC TACATACCGA CGCCTCCGCC ACAGGCACCT
    CTCAGCCTCC CTGCAGGTTG GGGCCACCTC ACTCTGACTA GGACAGCTCC AGCACCTGAG
    AGCCCAGCAG GTGATAGAAA CAGTGTGGGC AGCGAAGGCA GCATTGGCAG TATCCGAAGC
    GCTGGTAGTG GTCAAAGTAC GGAGGGTACC AATGGACAAT TCGTGGGACT CCTTATTGAG
    AATGTAAAGC CACTTTTGCC TGGTGGGGAG GATCTAGTTA TTGGAGGTTT TCTAGTCCAT
    CCCCCTGCTC AGGCAGGAAA CCCTATATCA GGGAATTTCT CCAATGACAG GATCTTCTCC
    CACCAATATT TACGCCCAGA GCAGCTCCTG GAAGGGAAGG ATGCTGCAGC CATTTACAAT
    TGGCTATGCG AATTCCAGCT GGAGTGTTAT ACGGGCAACT TTCTGAATGC AGGTTATGAT
    GTGCCAACAA TCAGCCGCAT GACTCCAGAG GATCTCACAG CAATTGGGGT AACCAAACCA
    GGCCACAGGA AGAAAATTTC GACAGAGATT GGACAGCTCA GCATTTCTGA ATGGCTCCCA
    AATTATATTC CTGATGACTT GATGGAATGG TTGAGTGCTA TTGGTCTACC ACAGTACCAC
    AAAAAGTTGG TGAGCAACGG TTATGACTCC ATCAACATTG TGACCGATCT GACTTGGGAG
    GATTTGCAAG AGATTGGCAT CAACAAACTT GGCCACCAAA AGAAGATCAT GCTGGCTGTC
    AAGAGATTGA CTGATCTTTG TAAAAGTCAG AGCCAGGCTG AAGTCAACAC TCTTAGGCGC
    AAGATCCCTG GTACCTTGGA AATAGTCACC ATTGAGACCG TGGAGAATGG GGAGTGCCAT
    TCTCCTCTCA CCCCCAAAAT GACCACTTTT CAGGACAGTG AGCTGAGCCA TGAGCTCCAG
    ACAGCCATGT CCAACAGCTG CCAAGAGACA TTGACCATCA AGAGTACCCA AGGCATGTCA
    CGGAGCCAAG AGAGCATTGG TGCACGTTCT AGAGGATCAG GACATTCCCA GGAGAACATG
    CTGTCCCAAA GCACGTCCTC TAGCCATTCT GAGGAGAGTT TGGGTAGTGG CGAAGGGAGC
    AGCGGGAGCA GTGGAGGGCA TTCTTTCACC CAGCCCCATC CTGCGGAGAA CTCTGCCAGT
    ACCCAGGGTC GACCCAGCCC AGACCACTAT GGGAAATTCA TTCCATTGCT CAATGGACCA
    GATGGAACCA GTGGCTATTC TAGCAGTTGT GTGGGAAGTC CCCTAAAGGA GAGAAATCTG
    CCCGAGGGGA TGGATCACTA CCAGAGACCA AGTGCTTCAC CAGAGCCATC AAGCCCCCTA
    CCAGTCCCCT CCCCCTGCAC ATTGCCCCAT GCTGCCAGCA AGGGAACAGC CCCATATGTC
    TTCATGTATC CCCACATATC ACTGAAGGCC CAGTCAGCTC CTCCACCTTC CATGCCTGAA
    CAGGCCAAGG CATCTACCCA TTTGTCTGTC CAGAGGACCA CCCTCCAGTC AACTGCCCAG
    AAAGCTTTCT CCTACCTTCA TTCCCACTGC GGCCCTACAG AGCCACCTCA GGTGCCCCCA
    AAGCCTAGGC CTGAACTGCA AAACGGTGAG GGTTTTAAGC ACAAGAAACG CTCACAAAGC
    TTGAACCGCT ATGCGCTGTC TGATGGGGAA CCTGATGAAG AAGAACCAGC CAGTAGCTCA
    GTGGGCTCTT ACGCTACCCT AACCAGGCGA CCTGGGCGCA GTCAAGTGTC ACGCACACAA
    CCACCTTCAG AAGCTAAAGT CTTGCGCAGT CAGTCTTTTG CTATCCGTGC CCGGAAAAAA
    GGCCCTCCAC CTCCACCTCC TAAACGCCTC AGTTCAGTCT CCAGCCCTTT AGCAGTTGAT
    GCAGAGTTTG AACAAGGTCA ACAGATGCAG AACGGATCCT TGGTCTCCAA GGACAAAGGG
    GATAATACTA ATGATAGAGC TTGCCTGGGG GAAAATACAG TTGCTAAGCT TGATAGGCCA
    ATCTATGATG GAAGCCCAGC CCAGCCTCTT CAGTCTTCTC AGATCCCCAG TTGTGGTCAG
    GAAGGTGCCA AGAAAGGTGG CCTACACAAT TCAGTTCAGG GAGGCCTTGG TAACACCAAT
    ACCCTAAATA GTAGAAGTCA AGTTTTGGAA GGCAACACTC CCAGGAGACG AACATTCAGT
    GAATCAGCAG TTACCATGAC AGAGGCGTTG CAGCGTAACC ATGAAGATAT CCGATCAGAC
    ACTGAGGAAG ATGGTCCAGC TGAGAAGGAT GACTGTGCCA AATCCCCTTG TTCTTCCCAA
    AACAGCTCCA GTGAGTGCAT CCCCTTTGCA GAAGAAGGCA ACCTAACCAT CAAACAGCGA
    CCAAAGCCTT TGGGGCCTTC AGCAAAAGAA GCCCCAGTGT TGGAATTCAA TCTCACAGAA
    TCCGACACGG TCAAGAGGCG GCCCCGGTGC AAAGAGAGGG AACCTCTCCA AAATGTCCTG
    AAGGCCTTTG GCATGGCCAC TCCAAGCCCT GGCATGACCA TCGCCCCGCA GTACGCCCAG
    GCCCAGACAG TCAGCATCAA CATGACGGCC ATGCCGACAT CCATCGCTTC TACCAAGCTG
    GTATTTTCAG GACCCAAAAC CATCTATCAG CAAGTCTTGC CAAACTCTCA CCACACAAGT
    CCCTCCAGAG CAACCCCTGA GACAGTGTCG GAGGTATCTG GTCCCTATCC CATGAAACTG
    GGCCTCAGCA ATAAGCCTTC CTTAAATTTT GGGGTGCCCC TTCCACCAAG AGCTTCAAGC
    ATGTGCCCAG ATATAACACA GAGCCAGCAG CGTCTGGAAC AAACCAGTTC ATCTTTGGCA
    TCCACACTTG AGGCTGCCGA AAAGGAGATC CTTGCAGAGG AAGCAGACAG TTGCTATGGG
    ACAACACACT CAGCCAAGAA CATTCTTGAA GACATCAGCA ACATGTTCAA CGACCTAGCT
    GAACAGCTGG ATGCCATGTT GGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.