LOC103465827 cDNA ORF clone, Poecilia reticulata(guppy)

The following LOC103465827 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC103465827 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPo196239 XM_017305239.1
Latest version!
Poecilia reticulata neuronal cell adhesion molecule-like (LOC103465827), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPo196239
    Clone ID Related Accession (Same CDS sequence) XM_017305239.1
    Accession Version XM_017305239.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3618bp)
    Protein sequence
    SNP
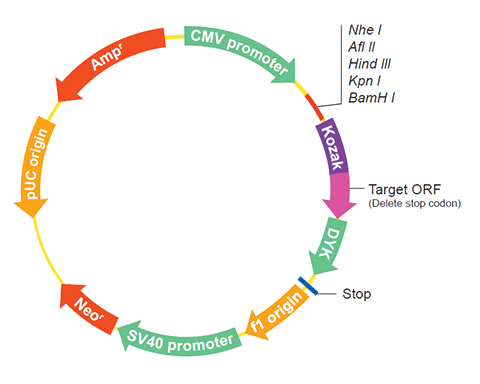
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
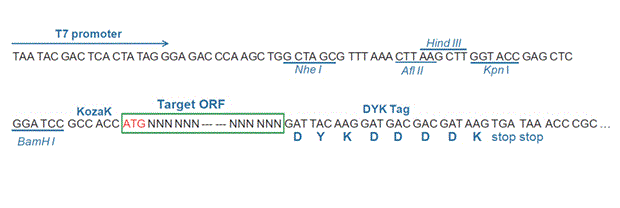
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product neuronal cell adhesion molecule-like
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024336.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGATGATGA TGGAGATGAG GAGTTTGGAA GCAGTGCTGC TGGTGTTGAT CCTCGGACAC 
    CTCGCCTCTG CTCTGGAGGT CCCACTAGAC CTTCTTCCAG GATTGGCACA GCCTCCAACA
    ATAACTCACC AGTCCCCAAA GGACTACATC GTGGATCCTC GAGAGAATAT TATAATTCAC
    TGTGAGGCGA AGGGGAAGCC GCATCCCAGC TTCTCCTGGA CAAGAAATGG GAGCCACTTT
    GACGTTGATC AGGATGAAAG CGTCACCATG AGGCCTCACT CCGGTACTCT GGTGGTGGAC
    ATCACCAGAG CAAGACCTGA ACATTACGAG GGCGTGTTTC AGTGCACGGC GAGGAACAAA
    CACGGATCTG CTGTGTCCAA CAATATCGTC GTCAGACAGT CAAAGTCCCC CTTGTGGTCA
    AAGGAGAAAA ATAAACCAAT CGTGGTTCAG AAGGGAGTTT CCTTGGTGCT GCCATGCCGA
    CCTCCAGCAG GACTTCCACC TCCAATCATA TTCTGGATGG ACAATAACTT CCAGAAGTTA
    CCTCAGAGCA AGAGGGTGTC CCAGTCGTTG AATGGCGACC TGTACTTCTC CAACGTTTGC
    CTAGAGGATT CCAGGAACGA CTACATCTGT TACGCTCGTT TCACACACAC GCAAACCATC
    CAGCAGAAAC AGCCCATCAC TGTCAAAGTG CTCAACCAGG CCCAAGTGGA TGATAGGAAG
    CCAACCTTCC TCATCCCATC TGGCCACTCA AGCTACAAGA TGGTGCTGAG GGGACACGTA
    CTGGAGATGG AGTGCATTGC CGAAGGACTG CCCACCCCTG AGGTATCCTG GACCAAAGTG
    AGCGGAGACC TACCCAGCAG GCGCACGTCC TTCCTTCACT TCAACAAGAC CCTGCGGATT
    GTGAACGTGT CTGAGTCGGA TGAGGGAGAT TACAGCTGCA CAGCCAAGAA CCAGCTTGGC
    TCTGCGCACC ACATCATCAC CGTTGAGGTC AAAGCTGCGC CTTATTGGAT CAGTGGACCT
    CCAAAGAATC TTGTTCTGGC TCCAGGAGAG AATGGAGCAC TGACTTGCAG GGCCAGCGGC
    ACACCCAAAC CCTCCATCAT ATGGTCAATG AATGGTGACC GCATAGAGAA TTTACCTACA
    GATATCAGCA GAAAGGTGGA GGACGACACA ATCATCTTCA CCGACGTTCA GGTTGGAACC
    AGCGCTGTGT ACCAGTGCAA CATCTCAAAC CCGTACGGTT ACCTCCTTTC CAACGCTTTC
    GTCAACGTCC TCCATGAGTC ACCCAGAGTG CTGACGCCAG CCAACAAGAT CTACCAGGTC
    ATCGAAAATC GCCCGGCCCT CATGGACTGC TCCTCTTTTG GGTCACCAAT TCCCAAAATT
    GAGTGGTTTA AAGACAGCCG AGCCAGCACC CTGAATGGGG AACCTTACAT CCTGCATGAC
    AATGGTACTT TGGAGATTCA AGTAGCTCAG CCGCAGCACA AAGGCAAATA CACCTGCATT
    GCCAGGAACT CGCTTGGATC CTCTGAGAAT CACGTTTACC TGCATATAAA AGAGCCTACC
    MGKATCCTAA AGCAACCGGT TGACACGGTG GTCCAAAGGG GCCGATCTGT GACGTTCGAG
    TGCACAATAA AACACGACAA GGATCTCTTA CCCACTTTGA TTTGGCTTAA GGATGATGAG
    GAGCTTCCCG ACGATGAGCG ATTCCTCGTA GAGTCCAACA GTGCGTCTAC CTCCGATGTG
    TCAGAGAGAG AATGGCACAG AGATCATGTG GAGCTGCCTA ACGATGATCG ATTTGTCGTA
    CAATTCAACA GCCTGTCCAT CACTGACGTG TTGGAGAGAG ATGCAGGGGT GTACACGTGC
    TACGTAAACA CAACTCTGGA CCAAGACTCG GTCACCGCTG AGCTCACTGT TGTCGAGACC
    ACACCAGCTC CAGCTGTCAT CCACGGGCGA CCCGACGCCC CCACAGACCT GGAGTTGACA
    GATGAGAAAG AGAGGAGCGT TCAGCTTACT TGGATCCCTG GGGAGGAACA TAACAGCCCT
    ATTCAGGAAT TTGTAATCCA GTATGAAGAC TCGCTGCACC ACCAAGGACA CTGGCATGAC
    ATTGCCCGGG TTCCCGGGAC CAAGACAACT GCTCATCTCA AGCTTTCTCC ATATGTCCAC
    TACACATTCA GAGTGCTGGC CCGTAACGCC GTGGGTCTGA GCGAGCCGAG CAGCCCCTCT
    CGAATGTATA AAACTGAGCC TGCAGCTCCT GACCAGAACC CAAAAAATGT ACGTGGATCT
    GGAAATAAAC ATAACAATCT TGTTATCACC TGGGAGCCTC TGTCAGGCCT TCAGTCCAAY
    GGTCCTGGGC TTTATTATAT AGTGAGTTGG AGGCAGAAGA GGCCAGGCAG CGACTGGATA
    ACAGCCACTA CCAACAACTC CATGTATACT GTATCTGAAA TACCCACATA TAGTCCATTT
    GAGATAAAGG TTCAGGCTGT AAACAACCAC GGAGAAGGAC CAGAGCCCGC TGTTGCTATC
    GGCTACTCAG GAGAAGATTT GCCAGCAGCA GCTCCAGCAA ATGTTCAGGT TGTAGTGCTA
    AACAGCACCT TGGCTCGGGT ACGATGGGAT CCTGTGCCTC CTCATTTAAT ACGAGGGCAG
    ATCCAAGGAT ACAAGGTTCA TTACTCGARG ATGCACAGCC TTCACAAACA CAACCCCCAT
    CACACGGAGA AGCGCATGCT CACTTTTAGT GGGAACCACA GCCAAGGCCT GCTGCCCGGG
    TTGCACCCAT TCAGCCACTA TTCTTTTTAC GTAAGCGTCT TCAATAAGAA AGGAGAGGGT
    CCCAAAAGTG AAAAGCAGGA GTTTAAGACA CCTGAAGGAG AGCCTGGGCC ACCCTCCTTG
    CTGTCTGTCA CAAACCCAAG CCTAGATTCA CTGACCCTCG AATGGAGTCC TCCTCATGAG
    CATAATGGGC ACATCACTGG CTACAACCTG AGATACCAGC CAGTCAATAA CTCCAATGAA
    CTTGGCCCAG AAGAGGAGCT GGCCCTGGCT GCCAATGAGA CCTCAGTCAC TTTGCAAAAC
    CTCAAGTACA GCCCACGCTA CAAGTTTTAT TTGAATGCGA GAACAAGCGT TGGAGCGGGC
    CCGGCCATTT CTCAGGAAGC TGTCGTCAAG CAGGATGAAG CTGTGACGAG CAGACAGGTA
    GACATCGCCA CTCAGGGATG GTTCATTGGC CTCATGTGCG CCATCGCCCT GCTCATCCTG
    ATCCTCCTCA TTATCTGCTT CATTCAGAGG AATAAAGGAG GAAAATACCC CGTCAAAGAA
    AAGGAGGATG CGCACACAGA CCCGGAGTTC CAGCCAATGA AAGATGATGA CTGTACTTTT
    GTGGAATACA GTGACAATGA GGACCATAAA CTGGTAAAAG AGAGCCGCAC GCCGTCTAAC
    GGGACGGTTA AGAGAGACGA CAGTGACGAC AGCTTAGTTG ACTACGGGGA AGGAGGAGAC
    GGACAGTTCA ACGAGGACGG CTCCTTTATT GGCCAGTATA GTGGGAAGAG TTCCAGCAGG
    GACAATGCTG AGGGCCCTGA GAGCTCAGGG GCCCCGTCCC CGATTAACGC CATGAACTCC
    TTGAACTCTT TTGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017160728.1
    CDS337..3954
    Translation

    Target ORF information:

    RefSeq Version XM_017305239.1
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata neuronal cell adhesion molecule-like (LOC103465827), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017305239.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGATGATGA TGGAGATGAG GAGTTTGGAA GCAGTGCTGC TGGTGTTGAT CCTCGGACAC 
    CTCGCCTCTG CTCTGGAGGT CCCACTAGAC CTTCTTCCAG GATTGGCACA GCCTCCAACA
    ATAACTCACC AGTCCCCAAA GGACTACATC GTGGATCCTC GAGAGAATAT TATAATTCAC
    TGTGAGGCGA AGGGGAAGCC GCATCCCAGC TTCTCCTGGA CAAGAAATGG GAGCCACTTT
    GACGTTGATC AGGATGAAAG CGTCACCATG AGGCCTCACT CCGGTACTCT GGTGGTGGAC
    ATCACCAGAG CAAGACCTGA ACATTACGAG GGCGTGTTTC AGTGCACGGC GAGGAACAAA
    CACGGATCTG CTGTGTCCAA CAATATCGTC GTCAGACAGT CAAAGTCCCC CTTGTGGTCA
    AAGGAGAAAA ATAAACCAAT CGTGGTTCAG AAGGGAGTTT CCTTGGTGCT GCCATGCCGA
    CCTCCAGCAG GACTTCCACC TCCAATCATA TTCTGGATGG ACAATAACTT CCAGAAGTTA
    CCTCAGAGCA AGAGGGTGTC CCAGTCGTTG AATGGCGACC TGTACTTCTC CAACGTTTGC
    CTAGAGGATT CCAGGAACGA CTACATCTGT TACGCTCGTT TCACACACAC GCAAACCATC
    CAGCAGAAAC AGCCCATCAC TGTCAAAGTG CTCAACCAGG CCCAAGTGGA TGATAGGAAG
    CCAACCTTCC TCATCCCATC TGGCCACTCA AGCTACAAGA TGGTGCTGAG GGGACACGTA
    CTGGAGATGG AGTGCATTGC CGAAGGACTG CCCACCCCTG AGGTATCCTG GACCAAAGTG
    AGCGGAGACC TACCCAGCAG GCGCACGTCC TTCCTTCACT TCAACAAGAC CCTGCGGATT
    GTGAACGTGT CTGAGTCGGA TGAGGGAGAT TACAGCTGCA CAGCCAAGAA CCAGCTTGGC
    TCTGCGCACC ACATCATCAC CGTTGAGGTC AAAGCTGCGC CTTATTGGAT CAGTGGACCT
    CCAAAGAATC TTGTTCTGGC TCCAGGAGAG AATGGAGCAC TGACTTGCAG GGCCAGCGGC
    ACACCCAAAC CCTCCATCAT ATGGTCAATG AATGGTGACC GCATAGAGAA TTTACCTACA
    GATATCAGCA GAAAGGTGGA GGACGACACA ATCATCTTCA CCGACGTTCA GGTTGGAACC
    AGCGCTGTGT ACCAGTGCAA CATCTCAAAC CCGTACGGTT ACCTCCTTTC CAACGCTTTC
    GTCAACGTCC TCCATGAGTC ACCCAGAGTG CTGACGCCAG CCAACAAGAT CTACCAGGTC
    ATCGAAAATC GCCCGGCCCT CATGGACTGC TCCTCTTTTG GGTCACCAAT TCCCAAAATT
    GAGTGGTTTA AAGACAGCCG AGCCAGCACC CTGAATGGGG AACCTTACAT CCTGCATGAC
    AATGGTACTT TGGAGATTCA AGTAGCTCAG CCGCAGCACA AAGGCAAATA CACCTGCATT
    GCCAGGAACT CGCTTGGATC CTCTGAGAAT CACGTTTACC TGCATATAAA AGAGCCTACC
    MGKATCCTAA AGCAACCGGT TGACACGGTG GTCCAAAGGG GCCGATCTGT GACGTTCGAG
    TGCACAATAA AACACGACAA GGATCTCTTA CCCACTTTGA TTTGGCTTAA GGATGATGAG
    GAGCTTCCCG ACGATGAGCG ATTCCTCGTA GAGTCCAACA GTGCGTCTAC CTCCGATGTG
    TCAGAGAGAG AATGGCACAG AGATCATGTG GAGCTGCCTA ACGATGATCG ATTTGTCGTA
    CAATTCAACA GCCTGTCCAT CACTGACGTG TTGGAGAGAG ATGCAGGGGT GTACACGTGC
    TACGTAAACA CAACTCTGGA CCAAGACTCG GTCACCGCTG AGCTCACTGT TGTCGAGACC
    ACACCAGCTC CAGCTGTCAT CCACGGGCGA CCCGACGCCC CCACAGACCT GGAGTTGACA
    GATGAGAAAG AGAGGAGCGT TCAGCTTACT TGGATCCCTG GGGAGGAACA TAACAGCCCT
    ATTCAGGAAT TTGTAATCCA GTATGAAGAC TCGCTGCACC ACCAAGGACA CTGGCATGAC
    ATTGCCCGGG TTCCCGGGAC CAAGACAACT GCTCATCTCA AGCTTTCTCC ATATGTCCAC
    TACACATTCA GAGTGCTGGC CCGTAACGCC GTGGGTCTGA GCGAGCCGAG CAGCCCCTCT
    CGAATGTATA AAACTGAGCC TGCAGCTCCT GACCAGAACC CAAAAAATGT ACGTGGATCT
    GGAAATAAAC ATAACAATCT TGTTATCACC TGGGAGCCTC TGTCAGGCCT TCAGTCCAAY
    GGTCCTGGGC TTTATTATAT AGTGAGTTGG AGGCAGAAGA GGCCAGGCAG CGACTGGATA
    ACAGCCACTA CCAACAACTC CATGTATACT GTATCTGAAA TACCCACATA TAGTCCATTT
    GAGATAAAGG TTCAGGCTGT AAACAACCAC GGAGAAGGAC CAGAGCCCGC TGTTGCTATC
    GGCTACTCAG GAGAAGATTT GCCAGCAGCA GCTCCAGCAA ATGTTCAGGT TGTAGTGCTA
    AACAGCACCT TGGCTCGGGT ACGATGGGAT CCTGTGCCTC CTCATTTAAT ACGAGGGCAG
    ATCCAAGGAT ACAAGGTTCA TTACTCGARG ATGCACAGCC TTCACAAACA CAACCCCCAT
    CACACGGAGA AGCGCATGCT CACTTTTAGT GGGAACCACA GCCAAGGCCT GCTGCCCGGG
    TTGCACCCAT TCAGCCACTA TTCTTTTTAC GTAAGCGTCT TCAATAAGAA AGGAGAGGGT
    CCCAAAAGTG AAAAGCAGGA GTTTAAGACA CCTGAAGGAG AGCCTGGGCC ACCCTCCTTG
    CTGTCTGTCA CAAACCCAAG CCTAGATTCA CTGACCCTCG AATGGAGTCC TCCTCATGAG
    CATAATGGGC ACATCACTGG CTACAACCTG AGATACCAGC CAGTCAATAA CTCCAATGAA
    CTTGGCCCAG AAGAGGAGCT GGCCCTGGCT GCCAATGAGA CCTCAGTCAC TTTGCAAAAC
    CTCAAGTACA GCCCACGCTA CAAGTTTTAT TTGAATGCGA GAACAAGCGT TGGAGCGGGC
    CCGGCCATTT CTCAGGAAGC TGTCGTCAAG CAGGATGAAG CTGTGACGAG CAGACAGGTA
    GACATCGCCA CTCAGGGATG GTTCATTGGC CTCATGTGCG CCATCGCCCT GCTCATCCTG
    ATCCTCCTCA TTATCTGCTT CATTCAGAGG AATAAAGGAG GAAAATACCC CGTCAAAGAA
    AAGGAGGATG CGCACACAGA CCCGGAGTTC CAGCCAATGA AAGATGATGA CTGTACTTTT
    GTGGAATACA GTGACAATGA GGACCATAAA CTGGTAAAAG AGAGCCGCAC GCCGTCTAAC
    GGGACGGTTA AGAGAGACGA CAGTGACGAC AGCTTAGTTG ACTACGGGGA AGGAGGAGAC
    GGACAGTTCA ACGAGGACGG CTCCTTTATT GGCCAGTATA GTGGGAAGAG TTCCAGCAGG
    GACAATGCTG AGGGCCCTGA GAGCTCAGGG GCCCCGTCCC CGATTAACGC CATGAACTCC
    TTGAACTCTT TTGTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.