mybl2 cDNA ORF clone, Poecilia reticulata(guppy)

The following mybl2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the mybl2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPo194030 XM_008410185.2
Latest version!
Poecilia reticulata MYB proto-oncogene like 2 (mybl2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPo194030
    Clone ID Related Accession (Same CDS sequence) XM_008410185.2
    Accession Version XM_008410185.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1893bp)
    Protein sequence
    SNP
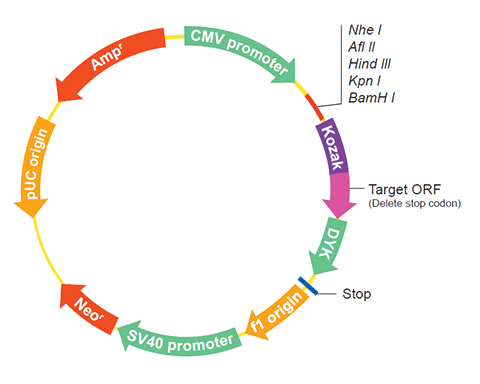
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
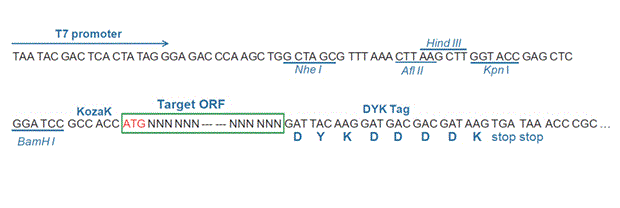
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product myb-related protein B
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024335.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 21, 2016 this sequence version replaced XM_008410185.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGTCCTGGT GGCCGCGCGG TGAGGATGGA GACGACACCA TGCATCAGGA CACTGATTCT 
    GATGTGGCTG AGCAGAGGGA CGGAGGGAAG GGGAAGGTGA AGTGGACACA AGATGAGGAT
    GACAAGCTCA AAGCGCTGGT CCACAAACTG GGATCCAGTG ACTGGAAACA CATAGCCAGC
    TACATCCCAA GTCACACAGA GCAGCAGTGC CAGCACCGCT GGTTTAAAGT TCTCGATCCA
    GAGCTGGTTA AAGGTCCCTG GACTAAGGAG GAGGACGAGA AGGTCATCGA GCTTGTGAAT
    CTCTACGGCA ACAAGCAGTG GGCAATGGTG GCCAAGCATC TGAAGGGTCG GCTGGGGAAG
    CAGTGCAGAG AGCGCTGGCA CAACCACCTC AACCCCAACG TGAAGAAGTC GTCATGGACA
    GCCGAGGAGG ACCTCGTCAT CTACAAGGCC CACTGCCTGC TGGGAAACCG CTGGGCCGAG
    ATCGCCAAGC TGCTGCCTGG AAGGACGGAC AATGCCGTCA AGAACCACTG GAACTCCACC
    ATCAAACGCA AGCTGGAGAT GGGCTTCTAC GCCCGAGAGG TGTTCAAGCC GAACGAGCTC
    GAAGAGCTGT TGGCACGCCT GAATAAAGAC GCGCAGGGGG GCAGCAGCTG TCAGGATGCT
    TCAAGCAAAG AAACGGAGCA GAAAGACCAG CTTCCACTGC AGGAAGCGCC AGCTGCCAGC
    GAAGCAGAAC CGTCCAAAGC CGTCTCCTCA CCAAGGGATG ATTCAGGCAT TAAGACGGAA
    GTTGACGCTG GCGATGAAGC CAGCGGTACC AACTGGGTGG TGGACAGCTC CGGCTTCCTT
    TCCCCCACTG GCCCCGCCCT GAAGGAAGTG CTCGACATGG TGGACGGGGA CCTGGACGGC
    TGGTGCAACC TGGCGGCCTT TGACCTTCCA GAGGACAGCC CTAGCCCCGA GCGCCACCAG
    TTCCGCCTGG AGGGCTCCGC CCTGCAGGAG CTGAGCAAAG GCAGCAGGGG AGAACTTATC
    CCCATCTCCC CCGGGGGGAT CAGCCCGCCG TCCATCCTGA CCCGCCGCAG CCGAAGACGT
    GTCACACTGT CTCCAGACGG AGCACACTCC ATGACGCCCA AGAGCACTCC GGTCAAAATC
    CTGCCATTTT CTCCATCTCA GTTCTTGAAC CTGTGGACGA AGCAGGACTC TCATGACCTG
    GAGAATCCCT CCCTCACATC CACGCCAGTA TGCAGTCAGA AGGTCATAGT GACCACACCG
    CTGCAGCGAG ACAAGACCCC CCTCACCCAG AAGGAGAACT CAGTGTTTGT TACACCTAAC
    CACAAATCGG AGCTGAGCAC AACCCCAAGG ACGCCGACGC CGTTCAAAAA TGCCATGGAA
    AAGTATGGCC CCCTGCAGCC TCTGCCTCAG ACTCCGAACC TCGAAGATGA CATCAACGAG
    GTCATCCTGA GAGAAGCAGG CATTAACATG GTCGTCGTCC AGGCAACGCC GCCTGATCCT
    CGTCGCAAAA CAATGCACCG CCCTCCTATG AAGAAAGTTC GGAAGTCCCT GGCTCTAGAT
    GTCATGGACT GCCAGGTGGT GCCAACATCC AAGCGCAAAT CCAGCAAAGC GGAGGCCAAA
    CGCAGCATCA AGGAAGAACC AGTGACGGTT TGTCTCAACT CCTCATCATT TTGCAGCAAG
    AGGCATGAAA ACATATTAGA TCAGGGCTTC CTGTTGGGAC CGAGCGACAC AACCATATTT
    CCCAGCGCGG CACCTCCTGC ACCTATGTCA AAAGAATGGA AGAAGGTGGT TTGTGGGCAA
    ACTAAAGACC AGCTCATAAT GACGGAGAAG GCGAGACGCT ACCTCCGCTC TCTGAAGAGC
    CATCCACCCA GCCGGGCTCT GATTCTGTCC TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008408407.1
    CDS296..2188
    Translation

    Target ORF information:

    RefSeq Version XM_008410185.2
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata MYB proto-oncogene like 2 (mybl2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008410185.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGTCCTGGT GGCCGCGCGG TGAGGATGGA GACGACACCA TGCATCAGGA CACTGATTCT 
    GATGTGGCTG AGCAGAGGGA CGGAGGGAAG GGGAAGGTGA AGTGGACACA AGATGAGGAT
    GACAAGCTCA AAGCGCTGGT CCACAAACTG GGATCCAGTG ACTGGAAACA CATAGCCAGC
    TACATCCCAA GTCACACAGA GCAGCAGTGC CAGCACCGCT GGTTTAAAGT TCTCGATCCA
    GAGCTGGTTA AAGGTCCCTG GACTAAGGAG GAGGACGAGA AGGTCATCGA GCTTGTGAAT
    CTCTACGGCA ACAAGCAGTG GGCAATGGTG GCCAAGCATC TGAAGGGTCG GCTGGGGAAG
    CAGTGCAGAG AGCGCTGGCA CAACCACCTC AACCCCAACG TGAAGAAGTC GTCATGGACA
    GCCGAGGAGG ACCTCGTCAT CTACAAGGCC CACTGCCTGC TGGGAAACCG CTGGGCCGAG
    ATCGCCAAGC TGCTGCCTGG AAGGACGGAC AATGCCGTCA AGAACCACTG GAACTCCACC
    ATCAAACGCA AGCTGGAGAT GGGCTTCTAC GCCCGAGAGG TGTTCAAGCC GAACGAGCTC
    GAAGAGCTGT TGGCACGCCT GAATAAAGAC GCGCAGGGGG GCAGCAGCTG TCAGGATGCT
    TCAAGCAAAG AAACGGAGCA GAAAGACCAG CTTCCACTGC AGGAAGCGCC AGCTGCCAGC
    GAAGCAGAAC CGTCCAAAGC CGTCTCCTCA CCAAGGGATG ATTCAGGCAT TAAGACGGAA
    GTTGACGCTG GCGATGAAGC CAGCGGTACC AACTGGGTGG TGGACAGCTC CGGCTTCCTT
    TCCCCCACTG GCCCCGCCCT GAAGGAAGTG CTCGACATGG TGGACGGGGA CCTGGACGGC
    TGGTGCAACC TGGCGGCCTT TGACCTTCCA GAGGACAGCC CTAGCCCCGA GCGCCACCAG
    TTCCGCCTGG AGGGCTCCGC CCTGCAGGAG CTGAGCAAAG GCAGCAGGGG AGAACTTATC
    CCCATCTCCC CCGGGGGGAT CAGCCCGCCG TCCATCCTGA CCCGCCGCAG CCGAAGACGT
    GTCACACTGT CTCCAGACGG AGCACACTCC ATGACGCCCA AGAGCACTCC GGTCAAAATC
    CTGCCATTTT CTCCATCTCA GTTCTTGAAC CTGTGGACGA AGCAGGACTC TCATGACCTG
    GAGAATCCCT CCCTCACATC CACGCCAGTA TGCAGTCAGA AGGTCATAGT GACCACACCG
    CTGCAGCGAG ACAAGACCCC CCTCACCCAG AAGGAGAACT CAGTGTTTGT TACACCTAAC
    CACAAATCGG AGCTGAGCAC AACCCCAAGG ACGCCGACGC CGTTCAAAAA TGCCATGGAA
    AAGTATGGCC CCCTGCAGCC TCTGCCTCAG ACTCCGAACC TCGAAGATGA CATCAACGAG
    GTCATCCTGA GAGAAGCAGG CATTAACATG GTCGTCGTCC AGGCAACGCC GCCTGATCCT
    CGTCGCAAAA CAATGCACCG CCCTCCTATG AAGAAAGTTC GGAAGTCCCT GGCTCTAGAT
    GTCATGGACT GCCAGGTGGT GCCAACATCC AAGCGCAAAT CCAGCAAAGC GGAGGCCAAA
    CGCAGCATCA AGGAAGAACC AGTGACGGTT TGTCTCAACT CCTCATCATT TTGCAGCAAG
    AGGCATGAAA ACATATTAGA TCAGGGCTTC CTGTTGGGAC CGAGCGACAC AACCATATTT
    CCCAGCGCGG CACCTCCTGC ACCTATGTCA AAAGAATGGA AGAAGGTGGT TTGTGGGCAA
    ACTAAAGACC AGCTCATAAT GACGGAGAAG GCGAGACGCT ACCTCCGCTC TCTGAAGAGC
    CATCCACCCA GCCGGGCTCT GATTCTGTCC TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.