sfi1 cDNA ORF clone, Poecilia reticulata(guppy)

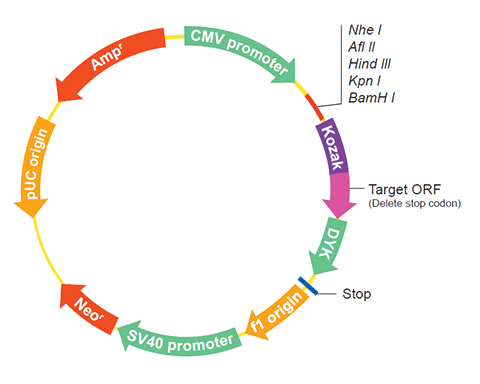
The following sfi1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the sfi1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPo195033 XM_017304931.1
Latest version!
Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OPo195033 XM_008408796.2
Latest version!
Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OPo195033 XM_017304932.1
Latest version!
Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OPo195034 XM_017304933.1
Latest version!
Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPo195033
    Clone ID Related Accession (Same CDS sequence) XM_017304932.1 , XM_008408796.2 , XM_017304931.1
    Accession Version XM_017304932.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3384bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
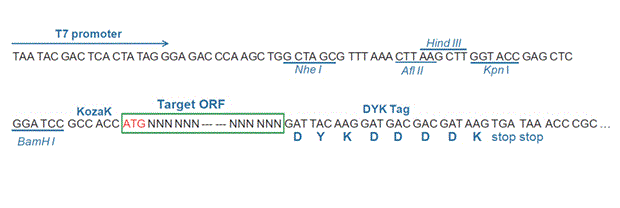
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product protein SFI1 homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024335.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GAGAACCAGA GAGCTGCAGG CCTGCCTTCA GGGGGATTTA
    CGCAGACTGC GGTGGGCTGT AGAGAAATGG AAGAAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017160421.1
    CDS101..3484
    Translation

    Target ORF information:

    RefSeq Version XM_017304932.1
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017304932.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GAGAACCAGA GAGCTGCAGG CCTGCCTTCA GGGGGATTTA
    CGCAGACTGC GGTGGGCTGT AGAGAAATGG AAGAAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPo195033
    Clone ID Related Accession (Same CDS sequence) XM_017304932.1 , XM_008408796.2 , XM_017304931.1
    Accession Version XM_008408796.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3384bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product protein SFI1 homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024335.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 21, 2016 this sequence version replaced XM_008408796.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GAGAACCAGA GAGCTGCAGG CCTGCCTTCA GGGGGATTTA
    CGCAGACTGC GGTGGGCTGT AGAGAAATGG AAGAAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008407018.1
    CDS101..3484
    Translation

    Target ORF information:

    RefSeq Version XM_008408796.2
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008408796.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GAGAACCAGA GAGCTGCAGG CCTGCCTTCA GGGGGATTTA
    CGCAGACTGC GGTGGGCTGT AGAGAAATGG AAGAAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPo195033
    Clone ID Related Accession (Same CDS sequence) XM_017304932.1 , XM_008408796.2 , XM_017304931.1
    Accession Version XM_017304931.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3384bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product protein SFI1 homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024335.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GAGAACCAGA GAGCTGCAGG CCTGCCTTCA GGGGGATTTA
    CGCAGACTGC GGTGGGCTGT AGAGAAATGG AAGAAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_017160420.1
    CDS101..3484
    Translation

    Target ORF information:

    RefSeq Version XM_017304931.1
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017304931.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GAGAACCAGA GAGCTGCAGG CCTGCCTTCA GGGGGATTTA
    CGCAGACTGC GGTGGGCTGT AGAGAAATGG AAGAAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPo195034
    Clone ID Related Accession (Same CDS sequence) XM_017304933.1
    Accession Version XM_017304933.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3324bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-06-20
    Organism Poecilia reticulata(guppy)
    Product protein SFI1 homolog isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_024335.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Poecilia reticulata Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GTGGCGACGA TCTGAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017160422.1
    CDS101..3424
    Translation

    Target ORF information:

    RefSeq Version XM_017304933.1
    Organism Poecilia reticulata(guppy)
    Definition Poecilia reticulata SFI1 centrin binding protein (sfi1), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017304933.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGCAAGGCG AATCCGTCCA AAACTCAGAC CGGGTAAGAC TGCGACCCTT CAGATCTGAG 
    GGTGAATCTA GACAGATGCG CAGAGTTCAG ACCAGGAAGG TTCCTTACAG AGTGGGATAC
    AACTGGAACA AGGGAGGGAG ACTCAAGGAG CTCAGGATAA GACACTTGGC GAGAAAATTC
    CTGAAGATAT GGATGCACAA CACCTTTGGT CGAGTTCTAC CCCTGCAAGC CAGGTCCCAC
    TACAGTAGAG GCCTCCTGAG ACGAGCCTTT GAAACATGGA GGGACGACTG GTGGACATCC
    AGGAGGGAAT GGAGTCTTCT AATGAGAGCA GAGTGCCACT ACAGGTATTA CCTGTTAAAC
    CTGGCATTTT ATGGGTGGAG GAATTTTACA TCTCTGCAGA GACAGAAAAA GGATAAATTA
    CAACATGCAC AATCATTAGC TAATAGGCGA CTGGTCCGAG TGGCTTTGAA CAGATGGAAG
    GTTTTCATTG AGATCAGGAG AGGACATTGG AGGATGCTTG AATCCTTCCT TGAGCGGAAG
    AGGCTTTCGG ATTTGCACTC AGTGTGGAAT TTGTGGCAGA CGAGGCTGCA GAAGCAGCAG
    CACCTCATGA TGTTAGAGGA TCAAGCACAA AAGCAAAGGG CGCTGAGCTT ACAGAGCAAG
    GCATGGAGTC TCTGGAAAGA GACTCATAGA ACTGCTTCTT ACCAGAAAGA AGAAGAATCC
    AAAGCAGCTC TCTACTTCAT TGTCCGCCTT AAGACAAGAG CATTTTGTCG GTGGAAGAGT
    TTCGCCTCCC ATCAGAAGAC CAAGAAAGAC ACACAAGCCG TGGCTCAGCG CGCCTGTCGT
    CTCCGCCTGG TCAGGAAGTA TTGGAGGGAA TGGAGAAAAG CTCTGAGTCA CGAACAGAAT
    GAAGAGAGGC GCTTGCGAGT TGCAAACCGC TTGGCTGTTC AGAGCACTCG ACGCAGAGTG
    CTGGTGCACT GGAAAGCCTA TGTTCAGCTG TGCAGAGAAG AAGCAGAGAG GAACCAGACA
    GCATGTCAGC ATTTCCAGCA TCATTTACTG CGCGCTGGAC TGCGGGGGCT CGCTCTGAAC
    GTCAGCTGGA ACAAAGCGCG GCGACTCAAC AACAACATGG CCGTCCAGCA CCGTCAACAA
    ACAATGCTGG CAAAGTGCTG GAGGCTGTGG ACGGATCGAC TGGAGGAGGT TGAGGATCAG
    AGCTTTCAGC CCCTAATCGA CAAGGCGCTG AATATTTACA GGGTTTTCTT GCTGAGGCGT
    TGCTTCCACC ACTGGAGAGA AACGTTTGCT GAACAGATCC ATATGCAGGA AGTGGAGTGT
    CGCGCGGACG TTTGGTTTGC TGAGCGGACC TTACCCCGGT GTTTCCAGTC TTGGGTGGAG
    TTCACTCTGC AGGGACAGCT GCGAGAACAG AGAAGACTCG AAGCCGAAGC CGTCAATCGG
    AAGCGTCAGT TCGCCTGGGT GTTTTACACC TGGTGGGGAC GGTCAGAGAA GCACAAGGAG
    GAGAAGCTCT CTGAGCGGAT GGCGGTTCTG CATGACGAGC AGCGCTGCGC GCGGGGAGCC
    TGGCTGCGGT GGAGAGGACG CGTGCAGCAG CAGATCAGAG AGGCAGAGAA ACAGGAAGCT
    TCGCGCCGTC TGCACACTCA CAGGCTTCTG CACAACACGC TGGTGCAGTG GAGGAACCAC
    AGCTCTGAGA TCAGAGACAG GTGGCGACGA TCTGAGTTTG TTCAGAAGCG GCGAATGAAG
    AAAAGCAGAC TGAAGGAGAT TCGAGACTAC TATGAAGCTA AACTTCTCAA ACAAAGCTTC
    CTGGCCTTGG AGAATCACCG CTTTGAGATG TCTCTGATGT GTGAACGTGC AAAGGAGCTT
    CAACAGCAGC GAACGCAGAT TTTCCTCAGG AAATCTCTAA CAGCATGGAG GGAGAAAGCA
    GAGCTGCTGG CTGAGGTTCG ACTCGCAGAG CAACAAGCCC AGGGGCATTT CCAACAATCC
    GTTCGGCAGA AGGTTTTTCA TGCTTGGAGA GAAGTAACGA GACGTGCACT GTTGAAGCGC
    CACCAGCAGA GGGAGTTGCT CAGGCAGGCT CAGAAAACAC TCAATGAAGC TCGGCTGCGG
    CTGATTTTCA GACAGTGGAG GGAACGAACC ACAGAGGCTC GGACGCTGAG GATGAACATG
    GAAAAGGCCA GAAGGCATCA CAACTCCAAG CTGCTCTCTA CAACCCTGAA TGCATGGAGC
    AATTATCACT GCCAGCAACA GAGAGTCAAG GTCATGAAAA GACAAGGACT CCTGTTGCTG
    AGGTTTAAGA TGTACCAGAA GTTCTTTGAG CGATGGAAAA CAAAGCTGCA GCACAGATGC
    AGGGAGGCTA ACCAGACGGA GCGAGCTCTC TGGCACTGGT CTCTCACCCT TCAGGCCAAG
    GTGTTGCAGG GATGGAGGCT CTGGGTGACA GAGCAGCGCA GCAAGCGGGA GCACGCAGCC
    AGAGCGGCGC AGGTATACAG AGACCAGCTG CTGAGGGAGG GCGTGACGTA CATCCTCACG
    TACGCCGCGC ACATGAACGA CCTGACAGCG AGTCTGACGC AGCTCAGCCA GGAACAGAGA
    TCGCAGCGCC TGCAGAGAGT CGTGAGGCGC TGCGCCATGC GGTGGAAGCG GCGGGCGTTG
    GGCAAATCAC AAAAGGAGCA AGAAGTCAGA GCGCAGCCAC AGAAGAAGAG TGTGACCTTC
    TGCTTGCCAG GTCCTGGCGA CGGTTCCACG CCTCACTCAG CAGAGCAGGA AGCTGAAGCA
    CTTGGCGGCC CCACTGAAGC AGCACTGAAA CCGAGTCAGA CAGGCTTCAT ATCTGGAGCT
    GAGTCGCCTC TGGAGAGCAG AACTCAAGAT CTTCTTCTGC CACCGTCAGC CTTCATGACC
    TCAAAGATGC AGGAATCTTT GGACAGTTCA GGTCTCAGAG AAAATCCATT TGTTTCCCTT
    CGTGAGTTTG AGACTTGCTC TACACACCTC CCAGCAGGTT TTCAAGATCC CAATTTGAAA
    AATTCTCCTG AAAAAGAAGC ATCGGTTCTG ATGAGGGAGC TTCTCAGCGT TCGCACGGAC
    ATGAAGAACT TCCAGCAGAG CAAGAAGCAA CTTCGGGCAT GGTGCAAGCT GAGAGACGTG
    TTGCAGAGTT GGCTGCAGAC GAGTGCAGAG GATGAACAAG TGGAAAAAAG CGCAGTTTGT
    GAGGAGCTGA AGGAGCTGGA GAAGCGCATT CAGCAACTGT CCACGGAGCT GGAAAAGCAG
    AAACCTACCA TCCTGCTTCA TGTGGAGAGG ATCCAACATT TGCAGACTGT CGTCAGTACC
    GCAGGAGTTT ATCCTCTCTG TTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.