SLC34A3 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

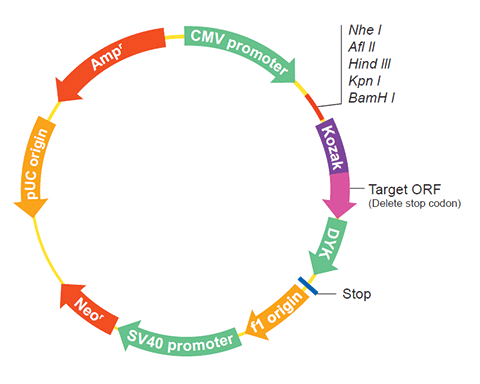
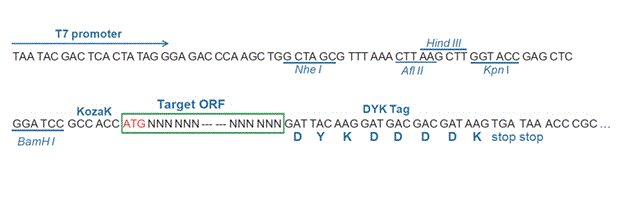
The following SLC34A3 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the SLC34A3 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa57394 XM_008970124.2
Latest version!
Pan paniscus solute carrier family 34 member 3 (SLC34A3), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPa57394 XM_024930081.1
Latest version!
Pan paniscus solute carrier family 34 member 3 (SLC34A3), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPa57395 XM_008970125.1
Latest version!
Pan paniscus solute carrier family 34 member 3 (SLC34A3), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
View Old Accession Versions >>
OPa57394 XM_008970124.1 Pan paniscus solute carrier family 34 (type II sodium/phosphate cotransporter), member 3 (SLC34A3), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa57394
    Clone ID Related Accession (Same CDS sequence) XM_008970124.2 , XM_008970124.1 , XM_024930081.1
    Accession Version XM_008970124.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1803bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product sodium-dependent phosphate transport protein 2C isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027877.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008970124.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGGT TGCCCTCATC CACTTCTTCT TCAACCTGGC CGGCATCCTG
    CTGTGGTACC TGGTGCCTGC ACTGCGGCTG CCCATCCCGC TGGCCAGGCA CTTCGGGGTG
    GTGACCGCCC GTTACCGCTG GGTGGCTGGG GTCTACCTGC TGCTCGGATT CCTGCTGCTG
    CCCCTGGCGG CCTTCGGGCT CTCCCTGGCA GGGGGCATGG TGCTGGCCGC TGTCGGGGGT
    CCCTTGGTGG GGCTGGTCCT CCTCGTCATC CTGGTTACTG TCCTGCAGCG GCGCCGGCCG
    GCCTGGCTGC CTGTCCACCT GCGCTCCTGG GCTTGGCTCC CCGTCTGGCT CCATTCTCTG
    GAGCCCTGGG ACCGCCTGGT GACCCGCTGC TGCCCCTGCA ACATCTGCAG CCCCCCGAAG
    GCCACCACCA AAGAGGCCCA CTGCTACGAG AACCCTGAGA TCTTGGCCTC CCAGCAGTTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008968372.1
    CDS591..2393
    Translation

    Target ORF information:

    RefSeq Version XM_008970124.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus solute carrier family 34 member 3 (SLC34A3), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008970124.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGGT TGCCCTCATC CACTTCTTCT TCAACCTGGC CGGCATCCTG
    CTGTGGTACC TGGTGCCTGC ACTGCGGCTG CCCATCCCGC TGGCCAGGCA CTTCGGGGTG
    GTGACCGCCC GTTACCGCTG GGTGGCTGGG GTCTACCTGC TGCTCGGATT CCTGCTGCTG
    CCCCTGGCGG CCTTCGGGCT CTCCCTGGCA GGGGGCATGG TGCTGGCCGC TGTCGGGGGT
    CCCTTGGTGG GGCTGGTCCT CCTCGTCATC CTGGTTACTG TCCTGCAGCG GCGCCGGCCG
    GCCTGGCTGC CTGTCCACCT GCGCTCCTGG GCTTGGCTCC CCGTCTGGCT CCATTCTCTG
    GAGCCCTGGG ACCGCCTGGT GACCCGCTGC TGCCCCTGCA ACATCTGCAG CCCCCCGAAG
    GCCACCACCA AAGAGGCCCA CTGCTACGAG AACCCTGAGA TCTTGGCCTC CCAGCAGTTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa57394
    Clone ID Related Accession (Same CDS sequence) XM_008970124.2 , XM_008970124.1 , XM_024930081.1
    Accession Version XM_008970124.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1803bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product sodium-dependent phosphate transport protein 2C isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014105.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGGT TGCCCTCATC CACTTCTTCT TCAACCTGGC CGGCATCCTG
    CTGTGGTACC TGGTGCCTGC ACTGCGGCTG CCCATCCCGC TGGCCAGGCA CTTCGGGGTG
    GTGACCGCCC GTTACCGCTG GGTGGCTGGG GTCTACCTGC TGCTCGGATT CCTGCTGCTG
    CCCCTGGCGG CCTTCGGGCT CTCCCTGGCA GGGGGCATGG TGCTGGCCGC TGTCGGGGGT
    CCCTTGGTGG GGCTGGTCCT CCTCGTCATC CTGGTTACTG TCCTGCAGCG GCGCCGGCCG
    GCCTGGCTGC CTGTCCACCT GCGCTCCTGG GCTTGGCTCC CCGTCTGGCT CCATTCTCTG
    GAGCCCTGGG ACCGCCTGGT GACCCGCTGC TGCCCCTGCA ACATCTGCAG CCCCCCGAAG
    GCCACCACCA AAGAGGCCCA CTGCTACGAG AACCCTGAGA TCTTGGCCTC CCAGCAGTTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008968372.1
    CDS591..2393
    Translation

    Target ORF information:

    RefSeq Version XM_008970124.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus solute carrier family 34 (type II sodium/phosphate cotransporter), member 3 (SLC34A3), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008970124.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGGT TGCCCTCATC CACTTCTTCT TCAACCTGGC CGGCATCCTG
    CTGTGGTACC TGGTGCCTGC ACTGCGGCTG CCCATCCCGC TGGCCAGGCA CTTCGGGGTG
    GTGACCGCCC GTTACCGCTG GGTGGCTGGG GTCTACCTGC TGCTCGGATT CCTGCTGCTG
    CCCCTGGCGG CCTTCGGGCT CTCCCTGGCA GGGGGCATGG TGCTGGCCGC TGTCGGGGGT
    CCCTTGGTGG GGCTGGTCCT CCTCGTCATC CTGGTTACTG TCCTGCAGCG GCGCCGGCCG
    GCCTGGCTGC CTGTCCACCT GCGCTCCTGG GCTTGGCTCC CCGTCTGGCT CCATTCTCTG
    GAGCCCTGGG ACCGCCTGGT GACCCGCTGC TGCCCCTGCA ACATCTGCAG CCCCCCGAAG
    GCCACCACCA AAGAGGCCCA CTGCTACGAG AACCCTGAGA TCTTGGCCTC CCAGCAGTTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa57394
    Clone ID Related Accession (Same CDS sequence) XM_008970124.2 , XM_008970124.1 , XM_024930081.1
    Accession Version XM_024930081.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1803bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product sodium-dependent phosphate transport protein 2C isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027877.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGGT TGCCCTCATC CACTTCTTCT TCAACCTGGC CGGCATCCTG
    CTGTGGTACC TGGTGCCTGC ACTGCGGCTG CCCATCCCGC TGGCCAGGCA CTTCGGGGTG
    GTGACCGCCC GTTACCGCTG GGTGGCTGGG GTCTACCTGC TGCTCGGATT CCTGCTGCTG
    CCCCTGGCGG CCTTCGGGCT CTCCCTGGCA GGGGGCATGG TGCTGGCCGC TGTCGGGGGT
    CCCTTGGTGG GGCTGGTCCT CCTCGTCATC CTGGTTACTG TCCTGCAGCG GCGCCGGCCG
    GCCTGGCTGC CTGTCCACCT GCGCTCCTGG GCTTGGCTCC CCGTCTGGCT CCATTCTCTG
    GAGCCCTGGG ACCGCCTGGT GACCCGCTGC TGCCCCTGCA ACATCTGCAG CCCCCCGAAG
    GCCACCACCA AAGAGGCCCA CTGCTACGAG AACCCTGAGA TCTTGGCCTC CCAGCAGTTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_024785849.1
    CDS588..2390
    Translation

    Target ORF information:

    RefSeq Version XM_024930081.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus solute carrier family 34 member 3 (SLC34A3), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_024930081.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGGT TGCCCTCATC CACTTCTTCT TCAACCTGGC CGGCATCCTG
    CTGTGGTACC TGGTGCCTGC ACTGCGGCTG CCCATCCCGC TGGCCAGGCA CTTCGGGGTG
    GTGACCGCCC GTTACCGCTG GGTGGCTGGG GTCTACCTGC TGCTCGGATT CCTGCTGCTG
    CCCCTGGCGG CCTTCGGGCT CTCCCTGGCA GGGGGCATGG TGCTGGCCGC TGTCGGGGGT
    CCCTTGGTGG GGCTGGTCCT CCTCGTCATC CTGGTTACTG TCCTGCAGCG GCGCCGGCCG
    GCCTGGCTGC CTGTCCACCT GCGCTCCTGG GCTTGGCTCC CCGTCTGGCT CCATTCTCTG
    GAGCCCTGGG ACCGCCTGGT GACCCGCTGC TGCCCCTGCA ACATCTGCAG CCCCCCGAAG
    GCCACCACCA AAGAGGCCCA CTGCTACGAG AACCCTGAGA TCTTGGCCTC CCAGCAGTTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa57395
    Clone ID Related Accession (Same CDS sequence) XM_008970125.1
    Accession Version XM_008970125.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1743bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product sodium-dependent phosphate transport protein 2C isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027877.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGCC CGTCTGCGGC CTGCTGCCCG GAGGCCCAAC AGGTTCAGCT
    CCTGAAACTC CAGGTCATGC TGCACCGCCG CTGACAGGAA GAGACAAGTG CGGCACCCCC
    TGGAACCCAC CCTCATTCTT CTTGCCTCTG CCCTGTCTCT ATCCACTTAG ACCCTCCCAG
    TGCAGGGTCC TGCTCCACCC CCTGCAGGAA GCCCTCCAGA CTGCACCTGT GTGTGGACTC
    CTCCAAGTCC GGCAGCCCCT GGAGGGGCCC GTGTGTTCTC CCCTCCTGTG GCCCTGTGCC
    TCCTCCCCGC AGGGCCTGGA CTGTGCAGGC TCAGCACACT GGGGACTGAG GAGACGGGGT
    CTCTTGGCAG GAGGCACAGG CAGAGCCAGG TCGGAGGGTG CTTCCCCCGC AGGTCCCCCT
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008968373.1
    CDS594..2336
    Translation

    Target ORF information:

    RefSeq Version XM_008970125.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus solute carrier family 34 member 3 (SLC34A3), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008970125.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGCCGAGTT CCCTTCCTGG CAGCCAGGTC CCCCACCCCA CTCTGGACGC GGTTGACCTA 
    GTGGAAAGGA CTCCGAGGAA TGAAGGGACC TCCAGTTCTG CTCCAGTCTT GGAGGAAGGG
    GACACAGACC CCTGGACCCT CCCTCAGCTG AAGGACACAA GCCAGCCCTG GAAAGAGCTC
    CGTGTGGCCG GCAGGCTGCG CCGCGTGGCC GGCAGCGTCC TCAAGGCCTG CGGGCTCCTC
    GGCAGCCTGT ACTTCTTCAT CTGCTCTCTG GACGTCCTCA GCTCCGCCTT CCAGCTGCTG
    GGCAGCAAAT TGGCCGGAGA CATCTTCAAG GACAACGTGG TGCTGTCCAA CCCTGTGGCT
    GGACTGGTCA TTGGCGTGCT GGTCACAGCC CTGGTGCAGA GTTCCAGCAC GTCCTCCTCC
    ATCGTGGTCA GCATGGTGGC TGCTAAGCTG CTGACTGTCC GGGCGTCTGT GCCCATCATC
    ATGGGTGTCA ACGTAGGCAC ATCCATCACC AGCACCCTGG TCTCAATGGC GCAGTCAGGG
    GACCGGGATG AATTTCAGAG GGCTTTCAGC GGCTCGGCGG TGCACGGGAT CTTCAACTGG
    CTCACGGTGC TGGTCCTGCT GCCACTGGAG AGTGCCACGG CCCTGCTGGA GAGGCTGAGC
    GAGCTGGCCC TGGGTGCCGC CAGCCTGACG CCCGGGGCGC AGGCGCCCGA CATCCTCAAG
    GTGCTGACGA AGCCGCTCAC ACACCTCATC GTGCAGTTGG ACTCCGACAT GATCATGAGC
    AGTGCCACAG GCAACGCCAC TAACAGCAGT CTCATTAAGC ACTGGTGCGG CACCACAGGG
    CAGCCGACCC AGGAGAACAG CAGCGACTGT GGTGCCTTCG GCCCGTGCAC AGAGAAGAAC
    AGCACAGCCC CGGCGGACAG GCTGCCCTGC CGCCACCTGT TTGCGGGCAC GGAGCTCACG
    GACCTGGCCG TGGGCTGCAT CCTGCTGGCC GGCTCCCTGC TGGTGCTCTG CGGCTGCCTG
    GTCCTCATAG TCAAGCTGCT CAACTCTGTG CTGCGCGGCC GCGTGGCCCA GGTCGTGAGG
    ACGGTCATCA ATGCAGACTT CCCCTTCCCG CTGGGCTGGC TCAGCGGCTA CCTGGCCGTC
    CTCGCGGGCG CTGGCCTGAC CTTCGCACTG CAGAGCAGCA GCGTCTTCAC GGCGGCCGTC
    GTGCCCCTCA TGGGGGTCGG GGTGATCAGT CTGGACCGGG CGTACCCCCT CTTACTGGGC
    TCCAACATCG GCACCACTAC CACAGCCCTG CTGGCTGCCC TGGCCAGCCC CGCAGACAGG
    ATGCTCAGCG CCCTGCAGCC CGTCTGCGGC CTGCTGCCCG GAGGCCCAAC AGGTTCAGCT
    CCTGAAACTC CAGGTCATGC TGCACCGCCG CTGACAGGAA GAGACAAGTG CGGCACCCCC
    TGGAACCCAC CCTCATTCTT CTTGCCTCTG CCCTGTCTCT ATCCACTTAG ACCCTCCCAG
    TGCAGGGTCC TGCTCCACCC CCTGCAGGAA GCCCTCCAGA CTGCACCTGT GTGTGGACTC
    CTCCAAGTCC GGCAGCCCCT GGAGGGGCCC GTGTGTTCTC CCCTCCTGTG GCCCTGTGCC
    TCCTCCCCGC AGGGCCTGGA CTGTGCAGGC TCAGCACACT GGGGACTGAG GAGACGGGGT
    CTCTTGGCAG GAGGCACAGG CAGAGCCAGG TCGGAGGGTG CTTCCCCCGC AGGTCCCCCT
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.