PPM1E cDNA ORF clone, Opisthocomus hoazin

The following PPM1E gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the PPM1E cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OOp15992 XM_009945838.1
Latest version!
Opisthocomus hoazin protein phosphatase, Mg2+/Mn2+ dependent, 1E (PPM1E), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OOp15992
    Clone ID Related Accession (Same CDS sequence) XM_009945838.1
    Accession Version XM_009945838.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2139bp)
    Protein sequence
    SNP
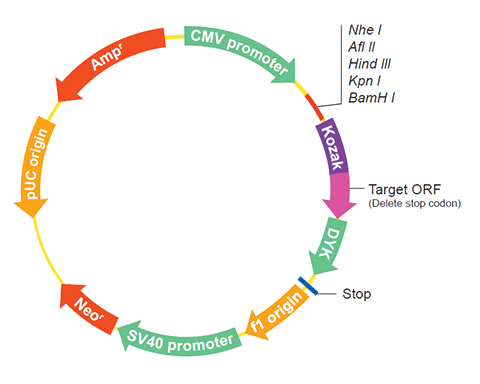
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
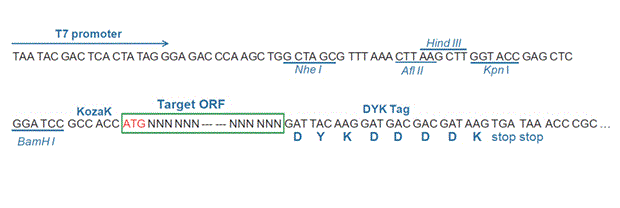
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-27
    Organism Opisthocomus hoazin
    Product protein phosphatase 1E
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009900391.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Opisthocomus hoazin Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 28% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAAACAGA CTACTTACGA GCTCCCCTTT GCCAGGACAC CGCACGGGCA GACATCGCTG 
    ACGGATCCGT GTGGCTACGC ACACGCTGAT CCCGAACCTA AATTAGGGGC AGAAGTTTTG
    TTGCCAACCG TTGGAAACGG TAATTGCCCT TCATTTTTGG CTGCTGCTTT AGCTAGAGCA
    ACTTCAGATG AAGTCCTTCA GAGTGACCTT TCAGCACACT ACTTACCAAA GCATGTGGAC
    AACGCAGATG GGATCATACA GATTGAGACA GTGAAGCTGG CCCGCTTAGT TTTTAGCAAA
    CTGCACGAGA TCTGCAGCAA CTGGGTGAAA GACTTTCCAC TCCAGCCAAA GCCCCACCGC
    TACTACGAGA CATCCATCCA TGCCATCAAG AATATGCGCA GGAAGATGGA AGACAAGCAC
    GTCTGTATCC CAGACTTCAA CATGCTCTTC AACCTTGAGG ACCAAGAAGA GCAAGCTTAT
    TTTGCAGTGT TTGATGGTCA CGGGGGAGTG GACGCTGCCA TCTATGCCTC CATCCATCTC
    CACCAGAACT TGGTCCACCA GGAGATGTTT CAGCAGGACC CGGCAGAGGC ACTGTGCCGA
    GCTTTCCGGG TGACCGATGA GCGGTTTGTC CAGAAGGCAG CAAGAGAGAG TCTGCGCTGT
    GGAACCACCG GGGTGGTGAC TTTCATCCGA GGAAACATGC TGCATGTGGC TTGGCTTGGG
    GACTCCCAGG TCATGCTCGT GAGGAGAGGC CAGGCTGTGG AACTGATGAA ACCCCACAAA
    CCAGATCGAG AGGATGAGAA GAAGCGCATC GAGGCACTCG GTGGCTGCGT GGTCTGGTTT
    GGAGCCTGGA GGGTGAATGG GAGCCTGTCA GTCTCCAGAG CTATTGGGGA TGCTGAGCAC
    AAGCCATACA TCTGTGGGGA TGCAGACTCT GCCTCCACTG TACTAGATGG CTCTGAAGAC
    TACCTCATTT TAGCCTGCGA TGGCTTCTAC GACACAGTCA ATCCCGATGA GGCAGTCAAA
    GTGGTGGCTG ACCATCTAAA GGAGAATAAT GGCGACAGCA GCATGGTAGC ACATAAATTA
    GTGGCATCTG CTCGGGATGC CGGTTCCAGC GACAACATTA CTGTCATTGT GGTATTTCTC
    AGGGATATGA ATGCAGCAGT CAGCGTCAGC GAGGAGTCGG ACTGGACAGA GAACTCTTTT
    CAAGGTGGGC AAGAAGACGG TGGGGAAGAT AAGGAGAACC ATGGCGACTG CAAAAGGCCG
    TGGCCCCAGC ACCAGTGCTC AGCACCTGCA GACCTAGGGT ACGATGGACG AGTGGATTCC
    TTCACCGACA GAACTAGCTT AAGCATAGGA TCGAGCATCA ACCTGTTTGA CGATCAAGGC
    TATTTAGACC TGACAAAAAC AGAAACTAGT ACACCTCAGA GTGCCAAATG TCCGCCACCA
    ATTCAAGCGT TTAGTCCTGG CATACCAAAG AGTGCGAGTG TGATCAGCGG CTCAACAGCA
    AAGAAGGAAT CACCGGAGCG CGCCGCGTCG TCGATCTGTG GACAGAGCGA TCCCAGGGAG
    TACAACGCTC CTCTCGCCTC GGGGGCCACA GGGCAGAGCC TCTACAGGGT GAAGGGTTTC
    TCCCCCGTTG TCTTTGGGCT GGAAGACGAA CTGTTCAGAT CCTTGGGAAA ACGAGCTGTG
    TCCTTTCGCT TCCGGCTCTG TAACGGGAAG AGGCGACGAG CAGCCAGGCT CAGACCAAAG
    TTTCCCATGC CGCTCCTGGC TCGAGAGCCT TCCCGTGTAG GATCGAGTCT GTCCCCACCT
    GTGCGGGGCC GCAGCAGCAC GAAGCTGTTG GCAGGACGCT CCCCGTGGCG GAGGCTGCCT
    GGGCCCAGCG CTTACAGCCA GAGCGCGTTT TCGATGCGAA GACAAACCTT AGCTGTTGTC
    AGCGTTCTCT TTAGCTGCAG CGTATGTTCC AAGTCAGATT TACTGAGGAA ATTTGAGAAA
    CGACATCTTG GACCACGAGC AGGGGATGCT GGCTGCGAGC GCCTGGCCTA CTCCTGCTCC
    CGCACGGGTA GCTGCGGGGC GAGCCGGGCA CTGCTGTTCG CCCTCCAGTA CGTTCCTGTT
    CGTGAAACTA GCGTGTGCGG TGTGAAGTGG ATAAAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009944140.1
    CDS1..2139
    Translation

    Target ORF information:

    RefSeq Version XM_009945838.1
    Organism Opisthocomus hoazin
    Definition Opisthocomus hoazin protein phosphatase, Mg2+/Mn2+ dependent, 1E (PPM1E), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009945838.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAAACAGA CTACTTACGA GCTCCCCTTT GCCAGGACAC CGCACGGGCA GACATCGCTG 
    ACGGATCCGT GTGGCTACGC ACACGCTGAT CCCGAACCTA AATTAGGGGC AGAAGTTTTG
    TTGCCAACCG TTGGAAACGG TAATTGCCCT TCATTTTTGG CTGCTGCTTT AGCTAGAGCA
    ACTTCAGATG AAGTCCTTCA GAGTGACCTT TCAGCACACT ACTTACCAAA GCATGTGGAC
    AACGCAGATG GGATCATACA GATTGAGACA GTGAAGCTGG CCCGCTTAGT TTTTAGCAAA
    CTGCACGAGA TCTGCAGCAA CTGGGTGAAA GACTTTCCAC TCCAGCCAAA GCCCCACCGC
    TACTACGAGA CATCCATCCA TGCCATCAAG AATATGCGCA GGAAGATGGA AGACAAGCAC
    GTCTGTATCC CAGACTTCAA CATGCTCTTC AACCTTGAGG ACCAAGAAGA GCAAGCTTAT
    TTTGCAGTGT TTGATGGTCA CGGGGGAGTG GACGCTGCCA TCTATGCCTC CATCCATCTC
    CACCAGAACT TGGTCCACCA GGAGATGTTT CAGCAGGACC CGGCAGAGGC ACTGTGCCGA
    GCTTTCCGGG TGACCGATGA GCGGTTTGTC CAGAAGGCAG CAAGAGAGAG TCTGCGCTGT
    GGAACCACCG GGGTGGTGAC TTTCATCCGA GGAAACATGC TGCATGTGGC TTGGCTTGGG
    GACTCCCAGG TCATGCTCGT GAGGAGAGGC CAGGCTGTGG AACTGATGAA ACCCCACAAA
    CCAGATCGAG AGGATGAGAA GAAGCGCATC GAGGCACTCG GTGGCTGCGT GGTCTGGTTT
    GGAGCCTGGA GGGTGAATGG GAGCCTGTCA GTCTCCAGAG CTATTGGGGA TGCTGAGCAC
    AAGCCATACA TCTGTGGGGA TGCAGACTCT GCCTCCACTG TACTAGATGG CTCTGAAGAC
    TACCTCATTT TAGCCTGCGA TGGCTTCTAC GACACAGTCA ATCCCGATGA GGCAGTCAAA
    GTGGTGGCTG ACCATCTAAA GGAGAATAAT GGCGACAGCA GCATGGTAGC ACATAAATTA
    GTGGCATCTG CTCGGGATGC CGGTTCCAGC GACAACATTA CTGTCATTGT GGTATTTCTC
    AGGGATATGA ATGCAGCAGT CAGCGTCAGC GAGGAGTCGG ACTGGACAGA GAACTCTTTT
    CAAGGTGGGC AAGAAGACGG TGGGGAAGAT AAGGAGAACC ATGGCGACTG CAAAAGGCCG
    TGGCCCCAGC ACCAGTGCTC AGCACCTGCA GACCTAGGGT ACGATGGACG AGTGGATTCC
    TTCACCGACA GAACTAGCTT AAGCATAGGA TCGAGCATCA ACCTGTTTGA CGATCAAGGC
    TATTTAGACC TGACAAAAAC AGAAACTAGT ACACCTCAGA GTGCCAAATG TCCGCCACCA
    ATTCAAGCGT TTAGTCCTGG CATACCAAAG AGTGCGAGTG TGATCAGCGG CTCAACAGCA
    AAGAAGGAAT CACCGGAGCG CGCCGCGTCG TCGATCTGTG GACAGAGCGA TCCCAGGGAG
    TACAACGCTC CTCTCGCCTC GGGGGCCACA GGGCAGAGCC TCTACAGGGT GAAGGGTTTC
    TCCCCCGTTG TCTTTGGGCT GGAAGACGAA CTGTTCAGAT CCTTGGGAAA ACGAGCTGTG
    TCCTTTCGCT TCCGGCTCTG TAACGGGAAG AGGCGACGAG CAGCCAGGCT CAGACCAAAG
    TTTCCCATGC CGCTCCTGGC TCGAGAGCCT TCCCGTGTAG GATCGAGTCT GTCCCCACCT
    GTGCGGGGCC GCAGCAGCAC GAAGCTGTTG GCAGGACGCT CCCCGTGGCG GAGGCTGCCT
    GGGCCCAGCG CTTACAGCCA GAGCGCGTTT TCGATGCGAA GACAAACCTT AGCTGTTGTC
    AGCGTTCTCT TTAGCTGCAG CGTATGTTCC AAGTCAGATT TACTGAGGAA ATTTGAGAAA
    CGACATCTTG GACCACGAGC AGGGGATGCT GGCTGCGAGC GCCTGGCCTA CTCCTGCTCC
    CGCACGGGTA GCTGCGGGGC GAGCCGGGCA CTGCTGTTCG CCCTCCAGTA CGTTCCTGTT
    CGTGAAACTA GCGTGTGCGG TGTGAAGTGG ATAAAGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.