Srebf2 cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

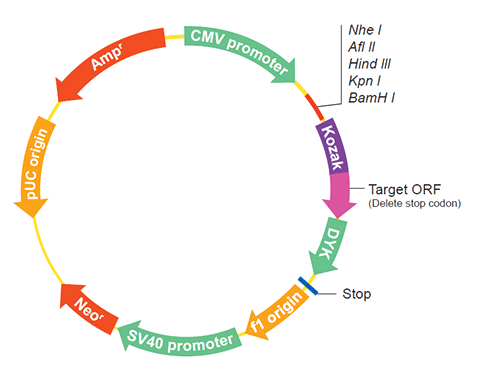
The following Srebf2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Srebf2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa133966 XM_029569135.1
Latest version!
Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ONa28005 XM_008844789.3
Latest version!
Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa28006 XM_017801027.1
Latest version!
Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa28006 XM_029569134.1
Latest version!
Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
ONa28006 XM_029569133.1
Latest version!
Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
View Old Accession Versions >>
ONa28005 XM_008844789.2 Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa133966
    Clone ID Related Accession (Same CDS sequence) XM_029569135.1
    Accession Version XM_029569135.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3093bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
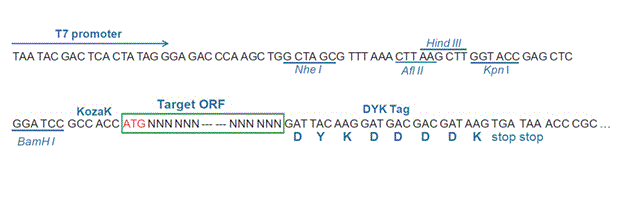
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product sterol regulatory element-binding protein 2 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008348199.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGACGACA GTGGCGAGTT GGGCGGTCTG GAGACCATGG AGACCCTCAC GGAGCTGGGC 
    GACGAGCTGA CCCTGGGGGA CATCGACGAG ATGCTGCAGT TTGTCAGCAA TCAAGTGGGA
    GAGTTCCCAG ATTTGTTTTC AGAGCAGCTC TGCAGTTCCT TCCCTGGAGG CGGTGGCAGT
    GGCAGCAATG GCGGCGGAGG CGCCAGCAGC AGTGGTAGAA GCAGCAGTGG TGGAGCTGCA
    GACACCTCGG TTCAGCGGCC ATTCAGCCAG GTCCCGTTAC CTACCTTCTC TCCTTCAGCT
    GCCTCCCCTC AGGCTCCAGC CCTTCAGGTC AAGGTCTCGC CCTCCACTGT ACCCACCCCG
    CCCCGTGCAA CGCCTATTCT CCAGCCCCGA CCCCAGCCCC AGCCTCCAGC TCAGCTGCAG
    CAGCAGACGG TAATGATCAC CCCAACATTC AGTACTGCTC CACAGACGAG GATCATCCAG
    CAGCCTTTGA TATACCAGAA TGCAGCTACC AGCTTTCAAG TCCTTCAGCC TCAAGTCCAA
    AGCCTGGTGA CATCTTCGCA GGTACAGCCA GTCACCATCC AGCAGCAGGT GCAGACAGTA
    CAGGCGCAGC GTGTGTTGAC ACAAACAGCT AACGGCACAT TGCAGACCCT TGCCCCAGCC
    ACAGTGCAGA CAGTTGCTGC GCCCCAGGTG CAGCAGGTCC CGGTCCTCGT CCAACCTCAG
    ATCATTAAGA CAGATTCCCT TGTTTTGACC ACTCTGAAAA CAGATGGCAG CCCTGTCATG
    GCTGCAGTCC AGAACCCAGC CCTCACTGCT CTCACCACCC CCATCCAGAC AGCGGCCCTT
    CAAGTACCAA CTCTAGTGGG CAGCAGTGGG ACCATTCTGA CCACAATGCC TGTAATGATG
    GGACAAGAGA AAGTTCCTAT TAAGCAAGTA CCCGGCGGTG TCAAGCAGCT GGAGCCCCCC
    AAAGAAGGAG AAAGGCGGAC AACACACAAC ATCATTGAAA AGCGATACCG GTCCTCTATC
    AATGACAAAA TCATTGAGTT GAAGGACTTG GTCATGGGCA CAGATGCCAA GATGCACAAG
    TCTGGCGTCC TGAGGAAGGC CATTGATTAT ATCAAATACT TGCAGCAGGT CAATCACAAG
    CTACGCCAGG AGAACATGGT GCTGAAGCTG GCAAATCAGA AAAACAAGCT CCTGAAGGGC
    ATTGACCTGG GCAGCCTGGT GGACAGTGAT ATGGACCTGA AGATTGATGA CTTTAATCAG
    AATGTCCTTC TGATGTCTCC CCCAGCCTCT GACTCAGGGT CTCAGGCTGG CTTCTCCCCC
    TATTCCATTG ACTCTGAGCC AGGAAGTCCT CTGTTGGATG ATGCAAAGGT CAAAGATGAA
    CCAGACTCTC CTCCTGTAGC ACTTGGCATG GTGGACCGCT CTCGAATTCT GTTATGTGTC
    CTTACCTTCT TGGGCCTCTC CTTTAACCCC CTGACTTCCC TGCTGCAATG GGGAGGCGCC
    CATGACGACC AGCACCCATA CTCAGGCTCT GGCCGTAGTG TACTATCATT GGAGTCAGGT
    TCTGGGGGCT GGTTTGACTG GATGATGCCA ACTCTCCTCC TGTGGCTGGT AAATGGTGTG
    ATTGTCTTGA GCGTCTTTGT GAAGCTGTTG GTCCACGGGG AGCCAGTGAT CCGGCCACAC
    TCACGCTCCT CAGTCACCTT CTGGAGGCAC CGGAAGCAGG CAGACCTAGA CCTTGCCAAA
    GGGGATTTTG CAGCTGCTGC AGCCAACCTA CAAACCTGCT TGTCGGTTTT GGGCCGGGCG
    CTGCCCACCT CCCGCCTGGA CTTGGCCTGC AGCCTCTCCT GGAACGTGAT CCGCCACAGC
    CTGCAGAAGC TACGCTTGGT ACGCTGGCTG CTCAAAAAAG TCTTGCAGCG CTGGCGGGCC
    ACCCCTGCCA CTGCATCTGG CTTCGAGGAT GAAGCAAAGA GCAGTGCGAG GGATGCAGCC
    CTGGCCTATC ATCGGCTACA CCAGCTGCAT ATCACAGGGA AGCTTCCTGC TGGATCTGCC
    TGTTCAGATG TACACATGGC TTTGTGTGCT GTGAACCTAG CTGAATGTGC CGAGGAGAAA
    ATCCCACCCA GTACACTGAT TGAGATCCAC CTGACAGCTG CCATGGGGCT CAAGACCCGG
    TGTGGAGGCA AGCTGGGCTT CTTGGCTAGC TACTTCCTCA GTCGTGCCCA GAGTCTGTGT
    GGCCCAGAGC ACAGCACTGT CCCTGACTCC CTACGCTGGC TCTGCCACCC CTTGGGCCAG
    AAGTTTTTCA TGGAGCGAAG CTGGTCCGTG AAGTCAGCAG CCAAAGAGAG CCTGTTCTGT
    GCCCAGAGGA ACCCAGCTGA CCCCATCGCC CAGGTCCACC AGGCCTTCTG CAAGAACCTG
    CTGGAACGAG CTGTGGAATC CTTGGTGAAA CCTCAGACCA AGAAGAAGGC AGGAGACCAG
    GAAGAAGAGA GCTGTGAGTT TTCCAGTGCC CTGGAGTACT TGAAATTACT TCATTCTTTT
    GTGGATTCTG TGGGATTTGT GACCCCACCA TTCTCCAGCA GTTCTGTGCT CAAGTCAGCC
    CTTGGTCCAG ATACCATCTG TCGGTGGTGG ACATCCGCAA TTACTATGGC CATCAGCTGG
    CTCCAAGGAG ATGATGCAGC TGTGCGCTCT CATTTTACAG AAGTAGAACG GGTCCCCAAG
    GCCCTGGAAG TGACTGAGAG TCCCTTGGTA AAGGCTGTCT TCTACACCTG TAGAGCCATG
    CATGCCTCGC TCTCTGGAAA AGCAGATGGG CAACAGAATT CCTTCCGTCA TTGTGAGAGG
    GCCAGTGGTC ACCTGTGGAG CAGTCTCAAT GTCACCGGAG CCACCCCTGA TCCTGCCCTT
    AACCACGTGG TCCAGCTGCT CACCTGTGAC CTACTACTGT CACTGCGGAC AGCACTTTGG
    CAAAAGCAGG CAAGCACCGG CCAGGTCCTG GGCGAGACCT ACCATGCATC AGGCACTGAA
    CTGGCTGGCT TCCAGCGGGA CCTGGGCAGC CTGCGCAGGC TAGCTCATAG CTTCCGCCCA
    GCATACCGCA AGCCTGGAAG CTGCCTCCGA TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029424995.1
    CDS152..3244
    Translation

    Target ORF information:

    RefSeq Version XM_029569135.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029569135.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGGACGACA GTGGCGAGTT GGGCGGTCTG GAGACCATGG AGACCCTCAC GGAGCTGGGC 
    GACGAGCTGA CCCTGGGGGA CATCGACGAG ATGCTGCAGT TTGTCAGCAA TCAAGTGGGA
    GAGTTCCCAG ATTTGTTTTC AGAGCAGCTC TGCAGTTCCT TCCCTGGAGG CGGTGGCAGT
    GGCAGCAATG GCGGCGGAGG CGCCAGCAGC AGTGGTAGAA GCAGCAGTGG TGGAGCTGCA
    GACACCTCGG TTCAGCGGCC ATTCAGCCAG GTCCCGTTAC CTACCTTCTC TCCTTCAGCT
    GCCTCCCCTC AGGCTCCAGC CCTTCAGGTC AAGGTCTCGC CCTCCACTGT ACCCACCCCG
    CCCCGTGCAA CGCCTATTCT CCAGCCCCGA CCCCAGCCCC AGCCTCCAGC TCAGCTGCAG
    CAGCAGACGG TAATGATCAC CCCAACATTC AGTACTGCTC CACAGACGAG GATCATCCAG
    CAGCCTTTGA TATACCAGAA TGCAGCTACC AGCTTTCAAG TCCTTCAGCC TCAAGTCCAA
    AGCCTGGTGA CATCTTCGCA GGTACAGCCA GTCACCATCC AGCAGCAGGT GCAGACAGTA
    CAGGCGCAGC GTGTGTTGAC ACAAACAGCT AACGGCACAT TGCAGACCCT TGCCCCAGCC
    ACAGTGCAGA CAGTTGCTGC GCCCCAGGTG CAGCAGGTCC CGGTCCTCGT CCAACCTCAG
    ATCATTAAGA CAGATTCCCT TGTTTTGACC ACTCTGAAAA CAGATGGCAG CCCTGTCATG
    GCTGCAGTCC AGAACCCAGC CCTCACTGCT CTCACCACCC CCATCCAGAC AGCGGCCCTT
    CAAGTACCAA CTCTAGTGGG CAGCAGTGGG ACCATTCTGA CCACAATGCC TGTAATGATG
    GGACAAGAGA AAGTTCCTAT TAAGCAAGTA CCCGGCGGTG TCAAGCAGCT GGAGCCCCCC
    AAAGAAGGAG AAAGGCGGAC AACACACAAC ATCATTGAAA AGCGATACCG GTCCTCTATC
    AATGACAAAA TCATTGAGTT GAAGGACTTG GTCATGGGCA CAGATGCCAA GATGCACAAG
    TCTGGCGTCC TGAGGAAGGC CATTGATTAT ATCAAATACT TGCAGCAGGT CAATCACAAG
    CTACGCCAGG AGAACATGGT GCTGAAGCTG GCAAATCAGA AAAACAAGCT CCTGAAGGGC
    ATTGACCTGG GCAGCCTGGT GGACAGTGAT ATGGACCTGA AGATTGATGA CTTTAATCAG
    AATGTCCTTC TGATGTCTCC CCCAGCCTCT GACTCAGGGT CTCAGGCTGG CTTCTCCCCC
    TATTCCATTG ACTCTGAGCC AGGAAGTCCT CTGTTGGATG ATGCAAAGGT CAAAGATGAA
    CCAGACTCTC CTCCTGTAGC ACTTGGCATG GTGGACCGCT CTCGAATTCT GTTATGTGTC
    CTTACCTTCT TGGGCCTCTC CTTTAACCCC CTGACTTCCC TGCTGCAATG GGGAGGCGCC
    CATGACGACC AGCACCCATA CTCAGGCTCT GGCCGTAGTG TACTATCATT GGAGTCAGGT
    TCTGGGGGCT GGTTTGACTG GATGATGCCA ACTCTCCTCC TGTGGCTGGT AAATGGTGTG
    ATTGTCTTGA GCGTCTTTGT GAAGCTGTTG GTCCACGGGG AGCCAGTGAT CCGGCCACAC
    TCACGCTCCT CAGTCACCTT CTGGAGGCAC CGGAAGCAGG CAGACCTAGA CCTTGCCAAA
    GGGGATTTTG CAGCTGCTGC AGCCAACCTA CAAACCTGCT TGTCGGTTTT GGGCCGGGCG
    CTGCCCACCT CCCGCCTGGA CTTGGCCTGC AGCCTCTCCT GGAACGTGAT CCGCCACAGC
    CTGCAGAAGC TACGCTTGGT ACGCTGGCTG CTCAAAAAAG TCTTGCAGCG CTGGCGGGCC
    ACCCCTGCCA CTGCATCTGG CTTCGAGGAT GAAGCAAAGA GCAGTGCGAG GGATGCAGCC
    CTGGCCTATC ATCGGCTACA CCAGCTGCAT ATCACAGGGA AGCTTCCTGC TGGATCTGCC
    TGTTCAGATG TACACATGGC TTTGTGTGCT GTGAACCTAG CTGAATGTGC CGAGGAGAAA
    ATCCCACCCA GTACACTGAT TGAGATCCAC CTGACAGCTG CCATGGGGCT CAAGACCCGG
    TGTGGAGGCA AGCTGGGCTT CTTGGCTAGC TACTTCCTCA GTCGTGCCCA GAGTCTGTGT
    GGCCCAGAGC ACAGCACTGT CCCTGACTCC CTACGCTGGC TCTGCCACCC CTTGGGCCAG
    AAGTTTTTCA TGGAGCGAAG CTGGTCCGTG AAGTCAGCAG CCAAAGAGAG CCTGTTCTGT
    GCCCAGAGGA ACCCAGCTGA CCCCATCGCC CAGGTCCACC AGGCCTTCTG CAAGAACCTG
    CTGGAACGAG CTGTGGAATC CTTGGTGAAA CCTCAGACCA AGAAGAAGGC AGGAGACCAG
    GAAGAAGAGA GCTGTGAGTT TTCCAGTGCC CTGGAGTACT TGAAATTACT TCATTCTTTT
    GTGGATTCTG TGGGATTTGT GACCCCACCA TTCTCCAGCA GTTCTGTGCT CAAGTCAGCC
    CTTGGTCCAG ATACCATCTG TCGGTGGTGG ACATCCGCAA TTACTATGGC CATCAGCTGG
    CTCCAAGGAG ATGATGCAGC TGTGCGCTCT CATTTTACAG AAGTAGAACG GGTCCCCAAG
    GCCCTGGAAG TGACTGAGAG TCCCTTGGTA AAGGCTGTCT TCTACACCTG TAGAGCCATG
    CATGCCTCGC TCTCTGGAAA AGCAGATGGG CAACAGAATT CCTTCCGTCA TTGTGAGAGG
    GCCAGTGGTC ACCTGTGGAG CAGTCTCAAT GTCACCGGAG CCACCCCTGA TCCTGCCCTT
    AACCACGTGG TCCAGCTGCT CACCTGTGAC CTACTACTGT CACTGCGGAC AGCACTTTGG
    CAAAAGCAGG CAAGCACCGG CCAGGTCCTG GGCGAGACCT ACCATGCATC AGGCACTGAA
    CTGGCTGGCT TCCAGCGGGA CCTGGGCAGC CTGCGCAGGC TAGCTCATAG CTTCCGCCCA
    GCATACCGCA AGCCTGGAAG CTGCCTCCGA TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa28005
    Clone ID Related Accession (Same CDS sequence) XM_008844789.3 , XM_008844789.2
    Accession Version XM_008844789.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3405bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product sterol regulatory element-binding protein 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008348199.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008844789.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGGACGACA GTGGCGAGTT GGGCGGTCTG GAGACCATGG AGACCCTCAC GGAGCTGGGC 
    GACGAGCTGA CCCTGGGGGA CATCGACGAG ATGCTGCAGT TTGTCAGCAA TCAAGTGGGA
    GAGTTCCCAG ATTTGTTTTC AGAGCAGCTC TGCAGTTCCT TCCCTGGAGG CGGTGGCAGT
    GGCAGCAATG GCGGCGGAGG CGCCAGCAGC AGTGGTAGAA GCAGCAGTGG TGGAGCTGCA
    GACACCTCGG TTCAGCGGCC ATTCAGCCAG GTCCCGTTAC CTACCTTCTC TCCTTCAGCT
    GCCTCCCCTC AGGCTCCAGC CCTTCAGGTC AAGGTCTCGC CCTCCACTGT ACCCACCCCG
    CCCCGTGCAA CGCCTATTCT CCAGCCCCGA CCCCAGCCCC AGCCTCCAGC TCAGCTGCAG
    CAGCAGACGG TAATGATCAC CCCAACATTC AGTACTGCTC CACAGACGAG GATCATCCAG
    CAGCCTTTGA TATACCAGAA TGCAGCTACC AGCTTTCAAG TCCTTCAGCC TCAAGTCCAA
    AGCCTGGTGA CATCTTCGCA GGTACAGCCA GTCACCATCC AGCAGCAGGT GCAGACAGTA
    CAGGCGCAGC GTGTGTTGAC ACAAACAGCT AACGGCACAT TGCAGACCCT TGCCCCAGCC
    ACAGTGCAGA CAGTTGCTGC GCCCCAGGTG CAGCAGGTCC CGGTCCTCGT CCAACCTCAG
    ATCATTAAGA CAGATTCCCT TGTTTTGACC ACTCTGAAAA CAGATGGCAG CCCTGTCATG
    GCTGCAGTCC AGAACCCAGC CCTCACTGCT CTCACCACCC CCATCCAGAC AGCGGCCCTT
    CAAGTACCAA CTCTAGTGGG CAGCAGTGGG ACCATTCTGA CCACAATGCC TGTAATGATG
    GGACAAGAGA AAGTTCCTAT TAAGCAAGTA CCCGGCGGTG TCAAGCAGCT GGAGCCCCCC
    AAAGAAGGAG AAAGGCGGAC AACACACAAC ATCATTGAAA AGCGATACCG GTCCTCTATC
    AATGACAAAA TCATTGAGTT GAAGGACTTG GTCATGGGCA CAGATGCCAA GATGCACAAG
    TCTGGCGTCC TGAGGAAGGC CATTGATTAT ATCAAATACT TGCAGCAGGT CAATCACAAG
    CTACGCCAGG AGAACATGGT GCTGAAGCTG GCAAATCAGA AAAACAAGCT CCTGAAGGGC
    ATTGACCTGG GCAGCCTGGT GGACAGTGAT ATGGACCTGA AGATTGATGA CTTTAATCAG
    AATGTCCTTC TGATGTCTCC CCCAGCCTCT GACTCAGGGT CTCAGGCTGG CTTCTCCCCC
    TATTCCATTG ACTCTGAGCC AGGAAGTCCT CTGTTGGATG ATGCAAAGGT CAAAGATGAA
    CCAGACTCTC CTCCTGTAGC ACTTGGCATG GTGGACCGCT CTCGAATTCT GTTATGTGTC
    CTTACCTTCT TGGGCCTCTC CTTTAACCCC CTGACTTCCC TGCTGCAATG GGGAGGCGCC
    CATGACGACC AGCACCCATA CTCAGGCTCT GGCCGTAGTG TACTATCATT GGAGTCAGGT
    TCTGGGGGCT GGTTTGACTG GATGATGCCA ACTCTCCTCC TGTGGCTGGT AAATGGTGTG
    ATTGTCTTGA GCGTCTTTGT GAAGCTGTTG GTCCACGGGG AGCCAGTGAT CCGGCCACAC
    TCACGCTCCT CAGTCACCTT CTGGAGGCAC CGGAAGCAGG CAGACCTAGA CCTTGCCAAA
    GGGGATTTTG CAGCTGCTGC AGCCAACCTA CAAACCTGCT TGTCGGTTTT GGGCCGGGCG
    CTGCCCACCT CCCGCCTGGA CTTGGCCTGC AGCCTCTCCT GGAACGTGAT CCGCCACAGC
    CTGCAGAAGC TACGCTTGGT ACGCTGGCTG CTCAAAAAAG TCTTGCAGCG CTGGCGGGCC
    ACCCCTGCCA CTGCATCTGG CTTCGAGGAT GAAGCAAAGA GCAGTGCGAG GGATGCAGCC
    CTGGCCTATC ATCGGCTACA CCAGCTGCAT ATCACAGGGA AGCTTCCTGC TGGATCTGCC
    TGTTCAGATG TACACATGGC TTTGTGTGCT GTGAACCTAG CTGAATGTGC CGAGGAGAAA
    ATCCCACCCA GTACACTGAT TGAGATCCAC CTGACAGCTG CCATGGGGCT CAAGACCCGG
    TGTGGAGGCA AGCTGGGCTT CTTGGCTAGC TACTTCCTCA GTCGTGCCCA GAGTCTGTGT
    GGCCCAGAGC ACAGCACTGT CCCTGACTCC CTACGCTGGC TCTGCCACCC CTTGGGCCAG
    AAGTTTTTCA TGGAGCGAAG CTGGTCCGTG AAGTCAGCAG CCAAAGAGAG CCTGTTCTGT
    GCCCAGAGGA ACCCAGCTGA CCCCATCGCC CAGGTCCACC AGGCCTTCTG CAAGAACCTG
    CTGGAACGAG CTGTGGAATC CTTGGTGAAA CCTCAGACCA AGAAGAAGGC AGGAGACCAG
    GAAGAAGAGA GCTGTGAGTT TTCCAGTGCC CTGGAGTACT TGAAATTACT TCATTCTTTT
    GTGGATTCTG TGGGATTTGT GACCCCACCA TTCTCCAGCA GTTCTGTGCT CAAGTCAGCC
    CTTGGTCCAG ATACCATCTG TCGGTGGTGG ACATCCGCAA TTACTATGGC CATCAGCTGG
    CTCCAAGGAG ATGATGCAGC TGTGCGCTCT CATTTTACAG AAGTAGAACG GGTCCCCAAG
    GCCCTGGAAG TGACTGAGAG TCCCTTGGTA AAGGCTGTCT TCTACACCTG TAGAGCCATG
    CATGCCTCGC TCTCTGGAAA AGCAGATGGG CAACAGAATT CCTTCCGTCA TTGTGAGAGG
    GCCAGTGGTC ACCTGTGGAG CAGTCTCAAT GTCACCGGAG CCACCCCTGA TCCTGCCCTT
    AACCACGTGG TCCAGCTGCT CACCTGTGAC CTACTACTGT CACTGCGGAC AGCACTTTGG
    CAAAAGCAGG CAAGCACCGG CCAGGTCCTG GGCGAGACCT ACCATGCATC AGGCACTGAA
    CTGGCTGGCT TCCAGCGGGA CCTGGGCAGC CTGCGCAGGC TAGCTCATAG CTTCCGCCCA
    GCATACCGCA AGGTGTTCCT GCATGAAGCC ACTGTGCGCT TGATGGCAGG AGCCAGCCCC
    ACCCGGACTC ACCAGCTGCT GGAGCATAGC CTGAGGCGGC GCACCACTCA GAACACCAAG
    CATGGAGAGG TGGACACCTG GCCTGGCCAG CGAGAGCGGG CCACTGCCAT CCTACTGGCC
    TGCCGCCATC TTCCCATCTC CTTCCTGTCT TCCCCAGGCC AGCGGGCAGT GCTGCTGGCC
    GAAGCTGCCC GCACCCTGGA GAAGGTGGGT GACCGGCGTT CCTGCAACGA CTGCCAGCAG
    ATGCTCGTCA AGCTGGGTGG TGGCACTGCC ATTGCTGCCT CCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008843011.1
    CDS165..3569
    Translation

    Target ORF information:

    RefSeq Version XM_008844789.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008844789.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGGACGACA GTGGCGAGTT GGGCGGTCTG GAGACCATGG AGACCCTCAC GGAGCTGGGC 
    GACGAGCTGA CCCTGGGGGA CATCGACGAG ATGCTGCAGT TTGTCAGCAA TCAAGTGGGA
    GAGTTCCCAG ATTTGTTTTC AGAGCAGCTC TGCAGTTCCT TCCCTGGAGG CGGTGGCAGT
    GGCAGCAATG GCGGCGGAGG CGCCAGCAGC AGTGGTAGAA GCAGCAGTGG TGGAGCTGCA
    GACACCTCGG TTCAGCGGCC ATTCAGCCAG GTCCCGTTAC CTACCTTCTC TCCTTCAGCT
    GCCTCCCCTC AGGCTCCAGC CCTTCAGGTC AAGGTCTCGC CCTCCACTGT ACCCACCCCG
    CCCCGTGCAA CGCCTATTCT CCAGCCCCGA CCCCAGCCCC AGCCTCCAGC TCAGCTGCAG
    CAGCAGACGG TAATGATCAC CCCAACATTC AGTACTGCTC CACAGACGAG GATCATCCAG
    CAGCCTTTGA TATACCAGAA TGCAGCTACC AGCTTTCAAG TCCTTCAGCC TCAAGTCCAA
    AGCCTGGTGA CATCTTCGCA GGTACAGCCA GTCACCATCC AGCAGCAGGT GCAGACAGTA
    CAGGCGCAGC GTGTGTTGAC ACAAACAGCT AACGGCACAT TGCAGACCCT TGCCCCAGCC
    ACAGTGCAGA CAGTTGCTGC GCCCCAGGTG CAGCAGGTCC CGGTCCTCGT CCAACCTCAG
    ATCATTAAGA CAGATTCCCT TGTTTTGACC ACTCTGAAAA CAGATGGCAG CCCTGTCATG
    GCTGCAGTCC AGAACCCAGC CCTCACTGCT CTCACCACCC CCATCCAGAC AGCGGCCCTT
    CAAGTACCAA CTCTAGTGGG CAGCAGTGGG ACCATTCTGA CCACAATGCC TGTAATGATG
    GGACAAGAGA AAGTTCCTAT TAAGCAAGTA CCCGGCGGTG TCAAGCAGCT GGAGCCCCCC
    AAAGAAGGAG AAAGGCGGAC AACACACAAC ATCATTGAAA AGCGATACCG GTCCTCTATC
    AATGACAAAA TCATTGAGTT GAAGGACTTG GTCATGGGCA CAGATGCCAA GATGCACAAG
    TCTGGCGTCC TGAGGAAGGC CATTGATTAT ATCAAATACT TGCAGCAGGT CAATCACAAG
    CTACGCCAGG AGAACATGGT GCTGAAGCTG GCAAATCAGA AAAACAAGCT CCTGAAGGGC
    ATTGACCTGG GCAGCCTGGT GGACAGTGAT ATGGACCTGA AGATTGATGA CTTTAATCAG
    AATGTCCTTC TGATGTCTCC CCCAGCCTCT GACTCAGGGT CTCAGGCTGG CTTCTCCCCC
    TATTCCATTG ACTCTGAGCC AGGAAGTCCT CTGTTGGATG ATGCAAAGGT CAAAGATGAA
    CCAGACTCTC CTCCTGTAGC ACTTGGCATG GTGGACCGCT CTCGAATTCT GTTATGTGTC
    CTTACCTTCT TGGGCCTCTC CTTTAACCCC CTGACTTCCC TGCTGCAATG GGGAGGCGCC
    CATGACGACC AGCACCCATA CTCAGGCTCT GGCCGTAGTG TACTATCATT GGAGTCAGGT
    TCTGGGGGCT GGTTTGACTG GATGATGCCA ACTCTCCTCC TGTGGCTGGT AAATGGTGTG
    ATTGTCTTGA GCGTCTTTGT GAAGCTGTTG GTCCACGGGG AGCCAGTGAT CCGGCCACAC
    TCACGCTCCT CAGTCACCTT CTGGAGGCAC CGGAAGCAGG CAGACCTAGA CCTTGCCAAA
    GGGGATTTTG CAGCTGCTGC AGCCAACCTA CAAACCTGCT TGTCGGTTTT GGGCCGGGCG
    CTGCCCACCT CCCGCCTGGA CTTGGCCTGC AGCCTCTCCT GGAACGTGAT CCGCCACAGC
    CTGCAGAAGC TACGCTTGGT ACGCTGGCTG CTCAAAAAAG TCTTGCAGCG CTGGCGGGCC
    ACCCCTGCCA CTGCATCTGG CTTCGAGGAT GAAGCAAAGA GCAGTGCGAG GGATGCAGCC
    CTGGCCTATC ATCGGCTACA CCAGCTGCAT ATCACAGGGA AGCTTCCTGC TGGATCTGCC
    TGTTCAGATG TACACATGGC TTTGTGTGCT GTGAACCTAG CTGAATGTGC CGAGGAGAAA
    ATCCCACCCA GTACACTGAT TGAGATCCAC CTGACAGCTG CCATGGGGCT CAAGACCCGG
    TGTGGAGGCA AGCTGGGCTT CTTGGCTAGC TACTTCCTCA GTCGTGCCCA GAGTCTGTGT
    GGCCCAGAGC ACAGCACTGT CCCTGACTCC CTACGCTGGC TCTGCCACCC CTTGGGCCAG
    AAGTTTTTCA TGGAGCGAAG CTGGTCCGTG AAGTCAGCAG CCAAAGAGAG CCTGTTCTGT
    GCCCAGAGGA ACCCAGCTGA CCCCATCGCC CAGGTCCACC AGGCCTTCTG CAAGAACCTG
    CTGGAACGAG CTGTGGAATC CTTGGTGAAA CCTCAGACCA AGAAGAAGGC AGGAGACCAG
    GAAGAAGAGA GCTGTGAGTT TTCCAGTGCC CTGGAGTACT TGAAATTACT TCATTCTTTT
    GTGGATTCTG TGGGATTTGT GACCCCACCA TTCTCCAGCA GTTCTGTGCT CAAGTCAGCC
    CTTGGTCCAG ATACCATCTG TCGGTGGTGG ACATCCGCAA TTACTATGGC CATCAGCTGG
    CTCCAAGGAG ATGATGCAGC TGTGCGCTCT CATTTTACAG AAGTAGAACG GGTCCCCAAG
    GCCCTGGAAG TGACTGAGAG TCCCTTGGTA AAGGCTGTCT TCTACACCTG TAGAGCCATG
    CATGCCTCGC TCTCTGGAAA AGCAGATGGG CAACAGAATT CCTTCCGTCA TTGTGAGAGG
    GCCAGTGGTC ACCTGTGGAG CAGTCTCAAT GTCACCGGAG CCACCCCTGA TCCTGCCCTT
    AACCACGTGG TCCAGCTGCT CACCTGTGAC CTACTACTGT CACTGCGGAC AGCACTTTGG
    CAAAAGCAGG CAAGCACCGG CCAGGTCCTG GGCGAGACCT ACCATGCATC AGGCACTGAA
    CTGGCTGGCT TCCAGCGGGA CCTGGGCAGC CTGCGCAGGC TAGCTCATAG CTTCCGCCCA
    GCATACCGCA AGGTGTTCCT GCATGAAGCC ACTGTGCGCT TGATGGCAGG AGCCAGCCCC
    ACCCGGACTC ACCAGCTGCT GGAGCATAGC CTGAGGCGGC GCACCACTCA GAACACCAAG
    CATGGAGAGG TGGACACCTG GCCTGGCCAG CGAGAGCGGG CCACTGCCAT CCTACTGGCC
    TGCCGCCATC TTCCCATCTC CTTCCTGTCT TCCCCAGGCC AGCGGGCAGT GCTGCTGGCC
    GAAGCTGCCC GCACCCTGGA GAAGGTGGGT GACCGGCGTT CCTGCAACGA CTGCCAGCAG
    ATGCTCGTCA AGCTGGGTGG TGGCACTGCC ATTGCTGCCT CCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa28005
    Clone ID Related Accession (Same CDS sequence) XM_008844789.3 , XM_008844789.2
    Accession Version XM_008844789.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3405bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product sterol regulatory element-binding protein 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008348199.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008844789.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGGACGACA GTGGCGAGTT GGGCGGTCTG GAGACCATGG AGACCCTCAC GGAGCTGGGC 
    GACGAGCTGA CCCTGGGGGA CATCGACGAG ATGCTGCAGT TTGTCAGCAA TCAAGTGGGA
    GAGTTCCCAG ATTTGTTTTC AGAGCAGCTC TGCAGTTCCT TCCCTGGAGG CGGTGGCAGT
    GGCAGCAATG GCGGCGGAGG CGCCAGCAGC AGTGGTAGAA GCAGCAGTGG TGGAGCTGCA
    GACACCTCGG TTCAGCGGCC ATTCAGCCAG GTCCCGTTAC CTACCTTCTC TCCTTCAGCT
    GCCTCCCCTC AGGCTCCAGC CCTTCAGGTC AAGGTCTCGC CCTCCACTGT ACCCACCCCG
    CCCCGTGCAA CGCCTATTCT CCAGCCCCGA CCCCAGCCCC AGCCTCCAGC TCAGCTGCAG
    CAGCAGACGG TAATGATCAC CCCAACATTC AGTACTGCTC CACAGACGAG GATCATCCAG
    CAGCCTTTGA TATACCAGAA TGCAGCTACC AGCTTTCAAG TCCTTCAGCC TCAAGTCCAA
    AGCCTGGTGA CATCTTCGCA GGTACAGCCA GTCACCATCC AGCAGCAGGT GCAGACAGTA
    CAGGCGCAGC GTGTGTTGAC ACAAACAGCT AACGGCACAT TGCAGACCCT TGCCCCAGCC
    ACAGTGCAGA CAGTTGCTGC GCCCCAGGTG CAGCAGGTCC CGGTCCTCGT CCAACCTCAG
    ATCATTAAGA CAGATTCCCT TGTTTTGACC ACTCTGAAAA CAGATGGCAG CCCTGTCATG
    GCTGCAGTCC AGAACCCAGC CCTCACTGCT CTCACCACCC CCATCCAGAC AGCGGCCCTT
    CAAGTACCAA CTCTAGTGGG CAGCAGTGGG ACCATTCTGA CCACAATGCC TGTAATGATG
    GGACAAGAGA AAGTTCCTAT TAAGCAAGTA CCCGGCGGTG TCAAGCAGCT GGAGCCCCCC
    AAAGAAGGAG AAAGGCGGAC AACACACAAC ATCATTGAAA AGCGATACCG GTCCTCTATC
    AATGACAAAA TCATTGAGTT GAAGGACTTG GTCATGGGCA CAGATGCCAA GATGCACAAG
    TCTGGCGTCC TGAGGAAGGC CATTGATTAT ATCAAATACT TGCAGCAGGT CAATCACAAG
    CTACGCCAGG AGAACATGGT GCTGAAGCTG GCAAATCAGA AAAACAAGCT CCTGAAGGGC
    ATTGACCTGG GCAGCCTGGT GGACAGTGAT ATGGACCTGA AGATTGATGA CTTTAATCAG
    AATGTCCTTC TGATGTCTCC CCCAGCCTCT GACTCAGGGT CTCAGGCTGG CTTCTCCCCC
    TATTCCATTG ACTCTGAGCC AGGAAGTCCT CTGTTGGATG ATGCAAAGGT CAAAGATGAA
    CCAGACTCTC CTCCTGTAGC ACTTGGCATG GTGGACCGCT CTCGAATTCT GTTATGTGTC
    CTTACCTTCT TGGGCCTCTC CTTTAACCCC CTGACTTCCC TGCTGCAATG GGGAGGCGCC
    CATGACGACC AGCACCCATA CTCAGGCTCT GGCCGTAGTG TACTATCATT GGAGTCAGGT
    TCTGGGGGCT GGTTTGACTG GATGATGCCA ACTCTCCTCC TGTGGCTGGT AAATGGTGTG
    ATTGTCTTGA GCGTCTTTGT GAAGCTGTTG GTCCACGGGG AGCCAGTGAT CCGGCCACAC
    TCACGCTCCT CAGTCACCTT CTGGAGGCAC CGGAAGCAGG CAGACCTAGA CCTTGCCAAA
    GGGGATTTTG CAGCTGCTGC AGCCAACCTA CAAACCTGCT TGTCGGTTTT GGGCCGGGCG
    CTGCCCACCT CCCGCCTGGA CTTGGCCTGC AGCCTCTCCT GGAACGTGAT CCGCCACAGC
    CTGCAGAAGC TACGCTTGGT ACGCTGGCTG CTCAAAAAAG TCTTGCAGCG CTGGCGGGCC
    ACCCCTGCCA CTGCATCTGG CTTCGAGGAT GAAGCAAAGA GCAGTGCGAG GGATGCAGCC
    CTGGCCTATC ATCGGCTACA CCAGCTGCAT ATCACAGGGA AGCTTCCTGC TGGATCTGCC
    TGTTCAGATG TACACATGGC TTTGTGTGCT GTGAACCTAG CTGAATGTGC CGAGGAGAAA
    ATCCCACCCA GTACACTGAT TGAGATCCAC CTGACAGCTG CCATGGGGCT CAAGACCCGG
    TGTGGAGGCA AGCTGGGCTT CTTGGCTAGC TACTTCCTCA GTCGTGCCCA GAGTCTGTGT
    GGCCCAGAGC ACAGCACTGT CCCTGACTCC CTACGCTGGC TCTGCCACCC CTTGGGCCAG
    AAGTTTTTCA TGGAGCGAAG CTGGTCCGTG AAGTCAGCAG CCAAAGAGAG CCTGTTCTGT
    GCCCAGAGGA ACCCAGCTGA CCCCATCGCC CAGGTCCACC AGGCCTTCTG CAAGAACCTG
    CTGGAACGAG CTGTGGAATC CTTGGTGAAA CCTCAGACCA AGAAGAAGGC AGGAGACCAG
    GAAGAAGAGA GCTGTGAGTT TTCCAGTGCC CTGGAGTACT TGAAATTACT TCATTCTTTT
    GTGGATTCTG TGGGATTTGT GACCCCACCA TTCTCCAGCA GTTCTGTGCT CAAGTCAGCC
    CTTGGTCCAG ATACCATCTG TCGGTGGTGG ACATCCGCAA TTACTATGGC CATCAGCTGG
    CTCCAAGGAG ATGATGCAGC TGTGCGCTCT CATTTTACAG AAGTAGAACG GGTCCCCAAG
    GCCCTGGAAG TGACTGAGAG TCCCTTGGTA AAGGCTGTCT TCTACACCTG TAGAGCCATG
    CATGCCTCGC TCTCTGGAAA AGCAGATGGG CAACAGAATT CCTTCCGTCA TTGTGAGAGG
    GCCAGTGGTC ACCTGTGGAG CAGTCTCAAT GTCACCGGAG CCACCCCTGA TCCTGCCCTT
    AACCACGTGG TCCAGCTGCT CACCTGTGAC CTACTACTGT CACTGCGGAC AGCACTTTGG
    CAAAAGCAGG CAAGCACCGG CCAGGTCCTG GGCGAGACCT ACCATGCATC AGGCACTGAA
    CTGGCTGGCT TCCAGCGGGA CCTGGGCAGC CTGCGCAGGC TAGCTCATAG CTTCCGCCCA
    GCATACCGCA AGGTGTTCCT GCATGAAGCC ACTGTGCGCT TGATGGCAGG AGCCAGCCCC
    ACCCGGACTC ACCAGCTGCT GGAGCATAGC CTGAGGCGGC GCACCACTCA GAACACCAAG
    CATGGAGAGG TGGACACCTG GCCTGGCCAG CGAGAGCGGG CCACTGCCAT CCTACTGGCC
    TGCCGCCATC TTCCCATCTC CTTCCTGTCT TCCCCAGGCC AGCGGGCAGT GCTGCTGGCC
    GAAGCTGCCC GCACCCTGGA GAAGGTGGGT GACCGGCGTT CCTGCAACGA CTGCCAGCAG
    ATGCTCGTCA AGCTGGGTGG TGGCACTGCC ATTGCTGCCT CCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008843011.1
    CDS188..3592
    Translation

    Target ORF information:

    RefSeq Version XM_008844789.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008844789.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    ATGGACGACA GTGGCGAGTT GGGCGGTCTG GAGACCATGG AGACCCTCAC GGAGCTGGGC 
    GACGAGCTGA CCCTGGGGGA CATCGACGAG ATGCTGCAGT TTGTCAGCAA TCAAGTGGGA
    GAGTTCCCAG ATTTGTTTTC AGAGCAGCTC TGCAGTTCCT TCCCTGGAGG CGGTGGCAGT
    GGCAGCAATG GCGGCGGAGG CGCCAGCAGC AGTGGTAGAA GCAGCAGTGG TGGAGCTGCA
    GACACCTCGG TTCAGCGGCC ATTCAGCCAG GTCCCGTTAC CTACCTTCTC TCCTTCAGCT
    GCCTCCCCTC AGGCTCCAGC CCTTCAGGTC AAGGTCTCGC CCTCCACTGT ACCCACCCCG
    CCCCGTGCAA CGCCTATTCT CCAGCCCCGA CCCCAGCCCC AGCCTCCAGC TCAGCTGCAG
    CAGCAGACGG TAATGATCAC CCCAACATTC AGTACTGCTC CACAGACGAG GATCATCCAG
    CAGCCTTTGA TATACCAGAA TGCAGCTACC AGCTTTCAAG TCCTTCAGCC TCAAGTCCAA
    AGCCTGGTGA CATCTTCGCA GGTACAGCCA GTCACCATCC AGCAGCAGGT GCAGACAGTA
    CAGGCGCAGC GTGTGTTGAC ACAAACAGCT AACGGCACAT TGCAGACCCT TGCCCCAGCC
    ACAGTGCAGA CAGTTGCTGC GCCCCAGGTG CAGCAGGTCC CGGTCCTCGT CCAACCTCAG
    ATCATTAAGA CAGATTCCCT TGTTTTGACC ACTCTGAAAA CAGATGGCAG CCCTGTCATG
    GCTGCAGTCC AGAACCCAGC CCTCACTGCT CTCACCACCC CCATCCAGAC AGCGGCCCTT
    CAAGTACCAA CTCTAGTGGG CAGCAGTGGG ACCATTCTGA CCACAATGCC TGTAATGATG
    GGACAAGAGA AAGTTCCTAT TAAGCAAGTA CCCGGCGGTG TCAAGCAGCT GGAGCCCCCC
    AAAGAAGGAG AAAGGCGGAC AACACACAAC ATCATTGAAA AGCGATACCG GTCCTCTATC
    AATGACAAAA TCATTGAGTT GAAGGACTTG GTCATGGGCA CAGATGCCAA GATGCACAAG
    TCTGGCGTCC TGAGGAAGGC CATTGATTAT ATCAAATACT TGCAGCAGGT CAATCACAAG
    CTACGCCAGG AGAACATGGT GCTGAAGCTG GCAAATCAGA AAAACAAGCT CCTGAAGGGC
    ATTGACCTGG GCAGCCTGGT GGACAGTGAT ATGGACCTGA AGATTGATGA CTTTAATCAG
    AATGTCCTTC TGATGTCTCC CCCAGCCTCT GACTCAGGGT CTCAGGCTGG CTTCTCCCCC
    TATTCCATTG ACTCTGAGCC AGGAAGTCCT CTGTTGGATG ATGCAAAGGT CAAAGATGAA
    CCAGACTCTC CTCCTGTAGC ACTTGGCATG GTGGACCGCT CTCGAATTCT GTTATGTGTC
    CTTACCTTCT TGGGCCTCTC CTTTAACCCC CTGACTTCCC TGCTGCAATG GGGAGGCGCC
    CATGACGACC AGCACCCATA CTCAGGCTCT GGCCGTAGTG TACTATCATT GGAGTCAGGT
    TCTGGGGGCT GGTTTGACTG GATGATGCCA ACTCTCCTCC TGTGGCTGGT AAATGGTGTG
    ATTGTCTTGA GCGTCTTTGT GAAGCTGTTG GTCCACGGGG AGCCAGTGAT CCGGCCACAC
    TCACGCTCCT CAGTCACCTT CTGGAGGCAC CGGAAGCAGG CAGACCTAGA CCTTGCCAAA
    GGGGATTTTG CAGCTGCTGC AGCCAACCTA CAAACCTGCT TGTCGGTTTT GGGCCGGGCG
    CTGCCCACCT CCCGCCTGGA CTTGGCCTGC AGCCTCTCCT GGAACGTGAT CCGCCACAGC
    CTGCAGAAGC TACGCTTGGT ACGCTGGCTG CTCAAAAAAG TCTTGCAGCG CTGGCGGGCC
    ACCCCTGCCA CTGCATCTGG CTTCGAGGAT GAAGCAAAGA GCAGTGCGAG GGATGCAGCC
    CTGGCCTATC ATCGGCTACA CCAGCTGCAT ATCACAGGGA AGCTTCCTGC TGGATCTGCC
    TGTTCAGATG TACACATGGC TTTGTGTGCT GTGAACCTAG CTGAATGTGC CGAGGAGAAA
    ATCCCACCCA GTACACTGAT TGAGATCCAC CTGACAGCTG CCATGGGGCT CAAGACCCGG
    TGTGGAGGCA AGCTGGGCTT CTTGGCTAGC TACTTCCTCA GTCGTGCCCA GAGTCTGTGT
    GGCCCAGAGC ACAGCACTGT CCCTGACTCC CTACGCTGGC TCTGCCACCC CTTGGGCCAG
    AAGTTTTTCA TGGAGCGAAG CTGGTCCGTG AAGTCAGCAG CCAAAGAGAG CCTGTTCTGT
    GCCCAGAGGA ACCCAGCTGA CCCCATCGCC CAGGTCCACC AGGCCTTCTG CAAGAACCTG
    CTGGAACGAG CTGTGGAATC CTTGGTGAAA CCTCAGACCA AGAAGAAGGC AGGAGACCAG
    GAAGAAGAGA GCTGTGAGTT TTCCAGTGCC CTGGAGTACT TGAAATTACT TCATTCTTTT
    GTGGATTCTG TGGGATTTGT GACCCCACCA TTCTCCAGCA GTTCTGTGCT CAAGTCAGCC
    CTTGGTCCAG ATACCATCTG TCGGTGGTGG ACATCCGCAA TTACTATGGC CATCAGCTGG
    CTCCAAGGAG ATGATGCAGC TGTGCGCTCT CATTTTACAG AAGTAGAACG GGTCCCCAAG
    GCCCTGGAAG TGACTGAGAG TCCCTTGGTA AAGGCTGTCT TCTACACCTG TAGAGCCATG
    CATGCCTCGC TCTCTGGAAA AGCAGATGGG CAACAGAATT CCTTCCGTCA TTGTGAGAGG
    GCCAGTGGTC ACCTGTGGAG CAGTCTCAAT GTCACCGGAG CCACCCCTGA TCCTGCCCTT
    AACCACGTGG TCCAGCTGCT CACCTGTGAC CTACTACTGT CACTGCGGAC AGCACTTTGG
    CAAAAGCAGG CAAGCACCGG CCAGGTCCTG GGCGAGACCT ACCATGCATC AGGCACTGAA
    CTGGCTGGCT TCCAGCGGGA CCTGGGCAGC CTGCGCAGGC TAGCTCATAG CTTCCGCCCA
    GCATACCGCA AGGTGTTCCT GCATGAAGCC ACTGTGCGCT TGATGGCAGG AGCCAGCCCC
    ACCCGGACTC ACCAGCTGCT GGAGCATAGC CTGAGGCGGC GCACCACTCA GAACACCAAG
    CATGGAGAGG TGGACACCTG GCCTGGCCAG CGAGAGCGGG CCACTGCCAT CCTACTGGCC
    TGCCGCCATC TTCCCATCTC CTTCCTGTCT TCCCCAGGCC AGCGGGCAGT GCTGCTGGCC
    GAAGCTGCCC GCACCCTGGA GAAGGTGGGT GACCGGCGTT CCTGCAACGA CTGCCAGCAG
    ATGCTCGTCA AGCTGGGTGG TGGCACTGCC ATTGCTGCCT CCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa28006
    Clone ID Related Accession (Same CDS sequence) XM_029569134.1 , XM_017801027.1 , XM_029569133.1
    Accession Version XM_029569134.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3354bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product sterol regulatory element-binding protein 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008348199.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGTTATGGA AAAATCAGAG ACCAACGCTG ATGTCAGAGA TGCTGCAGTT TGTCAGCAAT 
    CAAGTGGGAG AGTTCCCAGA TTTGTTTTCA GAGCAGCTCT GCAGTTCCTT CCCTGGAGGC
    GGTGGCAGTG GCAGCAATGG CGGCGGAGGC GCCAGCAGCA GTGGTAGAAG CAGCAGTGGT
    GGAGCTGCAG ACACCTCGGT TCAGCGGCCA TTCAGCCAGG TCCCGTTACC TACCTTCTCT
    CCTTCAGCTG CCTCCCCTCA GGCTCCAGCC CTTCAGGTCA AGGTCTCGCC CTCCACTGTA
    CCCACCCCGC CCCGTGCAAC GCCTATTCTC CAGCCCCGAC CCCAGCCCCA GCCTCCAGCT
    CAGCTGCAGC AGCAGACGGT AATGATCACC CCAACATTCA GTACTGCTCC ACAGACGAGG
    ATCATCCAGC AGCCTTTGAT ATACCAGAAT GCAGCTACCA GCTTTCAAGT CCTTCAGCCT
    CAAGTCCAAA GCCTGGTGAC ATCTTCGCAG GTACAGCCAG TCACCATCCA GCAGCAGGTG
    CAGACAGTAC AGGCGCAGCG TGTGTTGACA CAAACAGCTA ACGGCACATT GCAGACCCTT
    GCCCCAGCCA CAGTGCAGAC AGTTGCTGCG CCCCAGGTGC AGCAGGTCCC GGTCCTCGTC
    CAACCTCAGA TCATTAAGAC AGATTCCCTT GTTTTGACCA CTCTGAAAAC AGATGGCAGC
    CCTGTCATGG CTGCAGTCCA GAACCCAGCC CTCACTGCTC TCACCACCCC CATCCAGACA
    GCGGCCCTTC AAGTACCAAC TCTAGTGGGC AGCAGTGGGA CCATTCTGAC CACAATGCCT
    GTAATGATGG GACAAGAGAA AGTTCCTATT AAGCAAGTAC CCGGCGGTGT CAAGCAGCTG
    GAGCCCCCCA AAGAAGGAGA AAGGCGGACA ACACACAACA TCATTGAAAA GCGATACCGG
    TCCTCTATCA ATGACAAAAT CATTGAGTTG AAGGACTTGG TCATGGGCAC AGATGCCAAG
    ATGCACAAGT CTGGCGTCCT GAGGAAGGCC ATTGATTATA TCAAATACTT GCAGCAGGTC
    AATCACAAGC TACGCCAGGA GAACATGGTG CTGAAGCTGG CAAATCAGAA AAACAAGCTC
    CTGAAGGGCA TTGACCTGGG CAGCCTGGTG GACAGTGATA TGGACCTGAA GATTGATGAC
    TTTAATCAGA ATGTCCTTCT GATGTCTCCC CCAGCCTCTG ACTCAGGGTC TCAGGCTGGC
    TTCTCCCCCT ATTCCATTGA CTCTGAGCCA GGAAGTCCTC TGTTGGATGA TGCAAAGGTC
    AAAGATGAAC CAGACTCTCC TCCTGTAGCA CTTGGCATGG TGGACCGCTC TCGAATTCTG
    TTATGTGTCC TTACCTTCTT GGGCCTCTCC TTTAACCCCC TGACTTCCCT GCTGCAATGG
    GGAGGCGCCC ATGACGACCA GCACCCATAC TCAGGCTCTG GCCGTAGTGT ACTATCATTG
    GAGTCAGGTT CTGGGGGCTG GTTTGACTGG ATGATGCCAA CTCTCCTCCT GTGGCTGGTA
    AATGGTGTGA TTGTCTTGAG CGTCTTTGTG AAGCTGTTGG TCCACGGGGA GCCAGTGATC
    CGGCCACACT CACGCTCCTC AGTCACCTTC TGGAGGCACC GGAAGCAGGC AGACCTAGAC
    CTTGCCAAAG GGGATTTTGC AGCTGCTGCA GCCAACCTAC AAACCTGCTT GTCGGTTTTG
    GGCCGGGCGC TGCCCACCTC CCGCCTGGAC TTGGCCTGCA GCCTCTCCTG GAACGTGATC
    CGCCACAGCC TGCAGAAGCT ACGCTTGGTA CGCTGGCTGC TCAAAAAAGT CTTGCAGCGC
    TGGCGGGCCA CCCCTGCCAC TGCATCTGGC TTCGAGGATG AAGCAAAGAG CAGTGCGAGG
    GATGCAGCCC TGGCCTATCA TCGGCTACAC CAGCTGCATA TCACAGGGAA GCTTCCTGCT
    GGATCTGCCT GTTCAGATGT ACACATGGCT TTGTGTGCTG TGAACCTAGC TGAATGTGCC
    GAGGAGAAAA TCCCACCCAG TACACTGATT GAGATCCACC TGACAGCTGC CATGGGGCTC
    AAGACCCGGT GTGGAGGCAA GCTGGGCTTC TTGGCTAGCT ACTTCCTCAG TCGTGCCCAG
    AGTCTGTGTG GCCCAGAGCA CAGCACTGTC CCTGACTCCC TACGCTGGCT CTGCCACCCC
    TTGGGCCAGA AGTTTTTCAT GGAGCGAAGC TGGTCCGTGA AGTCAGCAGC CAAAGAGAGC
    CTGTTCTGTG CCCAGAGGAA CCCAGCTGAC CCCATCGCCC AGGTCCACCA GGCCTTCTGC
    AAGAACCTGC TGGAACGAGC TGTGGAATCC TTGGTGAAAC CTCAGACCAA GAAGAAGGCA
    GGAGACCAGG AAGAAGAGAG CTGTGAGTTT TCCAGTGCCC TGGAGTACTT GAAATTACTT
    CATTCTTTTG TGGATTCTGT GGGATTTGTG ACCCCACCAT TCTCCAGCAG TTCTGTGCTC
    AAGTCAGCCC TTGGTCCAGA TACCATCTGT CGGTGGTGGA CATCCGCAAT TACTATGGCC
    ATCAGCTGGC TCCAAGGAGA TGATGCAGCT GTGCGCTCTC ATTTTACAGA AGTAGAACGG
    GTCCCCAAGG CCCTGGAAGT GACTGAGAGT CCCTTGGTAA AGGCTGTCTT CTACACCTGT
    AGAGCCATGC ATGCCTCGCT CTCTGGAAAA GCAGATGGGC AACAGAATTC CTTCCGTCAT
    TGTGAGAGGG CCAGTGGTCA CCTGTGGAGC AGTCTCAATG TCACCGGAGC CACCCCTGAT
    CCTGCCCTTA ACCACGTGGT CCAGCTGCTC ACCTGTGACC TACTACTGTC ACTGCGGACA
    GCACTTTGGC AAAAGCAGGC AAGCACCGGC CAGGTCCTGG GCGAGACCTA CCATGCATCA
    GGCACTGAAC TGGCTGGCTT CCAGCGGGAC CTGGGCAGCC TGCGCAGGCT AGCTCATAGC
    TTCCGCCCAG CATACCGCAA GGTGTTCCTG CATGAAGCCA CTGTGCGCTT GATGGCAGGA
    GCCAGCCCCA CCCGGACTCA CCAGCTGCTG GAGCATAGCC TGAGGCGGCG CACCACTCAG
    AACACCAAGC ATGGAGAGGT GGACACCTGG CCTGGCCAGC GAGAGCGGGC CACTGCCATC
    CTACTGGCCT GCCGCCATCT TCCCATCTCC TTCCTGTCTT CCCCAGGCCA GCGGGCAGTG
    CTGCTGGCCG AAGCTGCCCG CACCCTGGAG AAGGTGGGTG ACCGGCGTTC CTGCAACGAC
    TGCCAGCAGA TGCTCGTCAA GCTGGGTGGT GGCACTGCCA TTGCTGCCTC CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029424994.1
    CDS326..3679
    Translation

    Target ORF information:

    RefSeq Version XM_029569134.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029569134.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGTTATGGA AAAATCAGAG ACCAACGCTG ATGTCAGAGA TGCTGCAGTT TGTCAGCAAT 
    CAAGTGGGAG AGTTCCCAGA TTTGTTTTCA GAGCAGCTCT GCAGTTCCTT CCCTGGAGGC
    GGTGGCAGTG GCAGCAATGG CGGCGGAGGC GCCAGCAGCA GTGGTAGAAG CAGCAGTGGT
    GGAGCTGCAG ACACCTCGGT TCAGCGGCCA TTCAGCCAGG TCCCGTTACC TACCTTCTCT
    CCTTCAGCTG CCTCCCCTCA GGCTCCAGCC CTTCAGGTCA AGGTCTCGCC CTCCACTGTA
    CCCACCCCGC CCCGTGCAAC GCCTATTCTC CAGCCCCGAC CCCAGCCCCA GCCTCCAGCT
    CAGCTGCAGC AGCAGACGGT AATGATCACC CCAACATTCA GTACTGCTCC ACAGACGAGG
    ATCATCCAGC AGCCTTTGAT ATACCAGAAT GCAGCTACCA GCTTTCAAGT CCTTCAGCCT
    CAAGTCCAAA GCCTGGTGAC ATCTTCGCAG GTACAGCCAG TCACCATCCA GCAGCAGGTG
    CAGACAGTAC AGGCGCAGCG TGTGTTGACA CAAACAGCTA ACGGCACATT GCAGACCCTT
    GCCCCAGCCA CAGTGCAGAC AGTTGCTGCG CCCCAGGTGC AGCAGGTCCC GGTCCTCGTC
    CAACCTCAGA TCATTAAGAC AGATTCCCTT GTTTTGACCA CTCTGAAAAC AGATGGCAGC
    CCTGTCATGG CTGCAGTCCA GAACCCAGCC CTCACTGCTC TCACCACCCC CATCCAGACA
    GCGGCCCTTC AAGTACCAAC TCTAGTGGGC AGCAGTGGGA CCATTCTGAC CACAATGCCT
    GTAATGATGG GACAAGAGAA AGTTCCTATT AAGCAAGTAC CCGGCGGTGT CAAGCAGCTG
    GAGCCCCCCA AAGAAGGAGA AAGGCGGACA ACACACAACA TCATTGAAAA GCGATACCGG
    TCCTCTATCA ATGACAAAAT CATTGAGTTG AAGGACTTGG TCATGGGCAC AGATGCCAAG
    ATGCACAAGT CTGGCGTCCT GAGGAAGGCC ATTGATTATA TCAAATACTT GCAGCAGGTC
    AATCACAAGC TACGCCAGGA GAACATGGTG CTGAAGCTGG CAAATCAGAA AAACAAGCTC
    CTGAAGGGCA TTGACCTGGG CAGCCTGGTG GACAGTGATA TGGACCTGAA GATTGATGAC
    TTTAATCAGA ATGTCCTTCT GATGTCTCCC CCAGCCTCTG ACTCAGGGTC TCAGGCTGGC
    TTCTCCCCCT ATTCCATTGA CTCTGAGCCA GGAAGTCCTC TGTTGGATGA TGCAAAGGTC
    AAAGATGAAC CAGACTCTCC TCCTGTAGCA CTTGGCATGG TGGACCGCTC TCGAATTCTG
    TTATGTGTCC TTACCTTCTT GGGCCTCTCC TTTAACCCCC TGACTTCCCT GCTGCAATGG
    GGAGGCGCCC ATGACGACCA GCACCCATAC TCAGGCTCTG GCCGTAGTGT ACTATCATTG
    GAGTCAGGTT CTGGGGGCTG GTTTGACTGG ATGATGCCAA CTCTCCTCCT GTGGCTGGTA
    AATGGTGTGA TTGTCTTGAG CGTCTTTGTG AAGCTGTTGG TCCACGGGGA GCCAGTGATC
    CGGCCACACT CACGCTCCTC AGTCACCTTC TGGAGGCACC GGAAGCAGGC AGACCTAGAC
    CTTGCCAAAG GGGATTTTGC AGCTGCTGCA GCCAACCTAC AAACCTGCTT GTCGGTTTTG
    GGCCGGGCGC TGCCCACCTC CCGCCTGGAC TTGGCCTGCA GCCTCTCCTG GAACGTGATC
    CGCCACAGCC TGCAGAAGCT ACGCTTGGTA CGCTGGCTGC TCAAAAAAGT CTTGCAGCGC
    TGGCGGGCCA CCCCTGCCAC TGCATCTGGC TTCGAGGATG AAGCAAAGAG CAGTGCGAGG
    GATGCAGCCC TGGCCTATCA TCGGCTACAC CAGCTGCATA TCACAGGGAA GCTTCCTGCT
    GGATCTGCCT GTTCAGATGT ACACATGGCT TTGTGTGCTG TGAACCTAGC TGAATGTGCC
    GAGGAGAAAA TCCCACCCAG TACACTGATT GAGATCCACC TGACAGCTGC CATGGGGCTC
    AAGACCCGGT GTGGAGGCAA GCTGGGCTTC TTGGCTAGCT ACTTCCTCAG TCGTGCCCAG
    AGTCTGTGTG GCCCAGAGCA CAGCACTGTC CCTGACTCCC TACGCTGGCT CTGCCACCCC
    TTGGGCCAGA AGTTTTTCAT GGAGCGAAGC TGGTCCGTGA AGTCAGCAGC CAAAGAGAGC
    CTGTTCTGTG CCCAGAGGAA CCCAGCTGAC CCCATCGCCC AGGTCCACCA GGCCTTCTGC
    AAGAACCTGC TGGAACGAGC TGTGGAATCC TTGGTGAAAC CTCAGACCAA GAAGAAGGCA
    GGAGACCAGG AAGAAGAGAG CTGTGAGTTT TCCAGTGCCC TGGAGTACTT GAAATTACTT
    CATTCTTTTG TGGATTCTGT GGGATTTGTG ACCCCACCAT TCTCCAGCAG TTCTGTGCTC
    AAGTCAGCCC TTGGTCCAGA TACCATCTGT CGGTGGTGGA CATCCGCAAT TACTATGGCC
    ATCAGCTGGC TCCAAGGAGA TGATGCAGCT GTGCGCTCTC ATTTTACAGA AGTAGAACGG
    GTCCCCAAGG CCCTGGAAGT GACTGAGAGT CCCTTGGTAA AGGCTGTCTT CTACACCTGT
    AGAGCCATGC ATGCCTCGCT CTCTGGAAAA GCAGATGGGC AACAGAATTC CTTCCGTCAT
    TGTGAGAGGG CCAGTGGTCA CCTGTGGAGC AGTCTCAATG TCACCGGAGC CACCCCTGAT
    CCTGCCCTTA ACCACGTGGT CCAGCTGCTC ACCTGTGACC TACTACTGTC ACTGCGGACA
    GCACTTTGGC AAAAGCAGGC AAGCACCGGC CAGGTCCTGG GCGAGACCTA CCATGCATCA
    GGCACTGAAC TGGCTGGCTT CCAGCGGGAC CTGGGCAGCC TGCGCAGGCT AGCTCATAGC
    TTCCGCCCAG CATACCGCAA GGTGTTCCTG CATGAAGCCA CTGTGCGCTT GATGGCAGGA
    GCCAGCCCCA CCCGGACTCA CCAGCTGCTG GAGCATAGCC TGAGGCGGCG CACCACTCAG
    AACACCAAGC ATGGAGAGGT GGACACCTGG CCTGGCCAGC GAGAGCGGGC CACTGCCATC
    CTACTGGCCT GCCGCCATCT TCCCATCTCC TTCCTGTCTT CCCCAGGCCA GCGGGCAGTG
    CTGCTGGCCG AAGCTGCCCG CACCCTGGAG AAGGTGGGTG ACCGGCGTTC CTGCAACGAC
    TGCCAGCAGA TGCTCGTCAA GCTGGGTGGT GGCACTGCCA TTGCTGCCTC CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa28006
    Clone ID Related Accession (Same CDS sequence) XM_029569134.1 , XM_017801027.1 , XM_029569133.1
    Accession Version XM_017801027.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3354bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product sterol regulatory element-binding protein 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008348199.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGTTATGGA AAAATCAGAG ACCAACGCTG ATGTCAGAGA TGCTGCAGTT TGTCAGCAAT 
    CAAGTGGGAG AGTTCCCAGA TTTGTTTTCA GAGCAGCTCT GCAGTTCCTT CCCTGGAGGC
    GGTGGCAGTG GCAGCAATGG CGGCGGAGGC GCCAGCAGCA GTGGTAGAAG CAGCAGTGGT
    GGAGCTGCAG ACACCTCGGT TCAGCGGCCA TTCAGCCAGG TCCCGTTACC TACCTTCTCT
    CCTTCAGCTG CCTCCCCTCA GGCTCCAGCC CTTCAGGTCA AGGTCTCGCC CTCCACTGTA
    CCCACCCCGC CCCGTGCAAC GCCTATTCTC CAGCCCCGAC CCCAGCCCCA GCCTCCAGCT
    CAGCTGCAGC AGCAGACGGT AATGATCACC CCAACATTCA GTACTGCTCC ACAGACGAGG
    ATCATCCAGC AGCCTTTGAT ATACCAGAAT GCAGCTACCA GCTTTCAAGT CCTTCAGCCT
    CAAGTCCAAA GCCTGGTGAC ATCTTCGCAG GTACAGCCAG TCACCATCCA GCAGCAGGTG
    CAGACAGTAC AGGCGCAGCG TGTGTTGACA CAAACAGCTA ACGGCACATT GCAGACCCTT
    GCCCCAGCCA CAGTGCAGAC AGTTGCTGCG CCCCAGGTGC AGCAGGTCCC GGTCCTCGTC
    CAACCTCAGA TCATTAAGAC AGATTCCCTT GTTTTGACCA CTCTGAAAAC AGATGGCAGC
    CCTGTCATGG CTGCAGTCCA GAACCCAGCC CTCACTGCTC TCACCACCCC CATCCAGACA
    GCGGCCCTTC AAGTACCAAC TCTAGTGGGC AGCAGTGGGA CCATTCTGAC CACAATGCCT
    GTAATGATGG GACAAGAGAA AGTTCCTATT AAGCAAGTAC CCGGCGGTGT CAAGCAGCTG
    GAGCCCCCCA AAGAAGGAGA AAGGCGGACA ACACACAACA TCATTGAAAA GCGATACCGG
    TCCTCTATCA ATGACAAAAT CATTGAGTTG AAGGACTTGG TCATGGGCAC AGATGCCAAG
    ATGCACAAGT CTGGCGTCCT GAGGAAGGCC ATTGATTATA TCAAATACTT GCAGCAGGTC
    AATCACAAGC TACGCCAGGA GAACATGGTG CTGAAGCTGG CAAATCAGAA AAACAAGCTC
    CTGAAGGGCA TTGACCTGGG CAGCCTGGTG GACAGTGATA TGGACCTGAA GATTGATGAC
    TTTAATCAGA ATGTCCTTCT GATGTCTCCC CCAGCCTCTG ACTCAGGGTC TCAGGCTGGC
    TTCTCCCCCT ATTCCATTGA CTCTGAGCCA GGAAGTCCTC TGTTGGATGA TGCAAAGGTC
    AAAGATGAAC CAGACTCTCC TCCTGTAGCA CTTGGCATGG TGGACCGCTC TCGAATTCTG
    TTATGTGTCC TTACCTTCTT GGGCCTCTCC TTTAACCCCC TGACTTCCCT GCTGCAATGG
    GGAGGCGCCC ATGACGACCA GCACCCATAC TCAGGCTCTG GCCGTAGTGT ACTATCATTG
    GAGTCAGGTT CTGGGGGCTG GTTTGACTGG ATGATGCCAA CTCTCCTCCT GTGGCTGGTA
    AATGGTGTGA TTGTCTTGAG CGTCTTTGTG AAGCTGTTGG TCCACGGGGA GCCAGTGATC
    CGGCCACACT CACGCTCCTC AGTCACCTTC TGGAGGCACC GGAAGCAGGC AGACCTAGAC
    CTTGCCAAAG GGGATTTTGC AGCTGCTGCA GCCAACCTAC AAACCTGCTT GTCGGTTTTG
    GGCCGGGCGC TGCCCACCTC CCGCCTGGAC TTGGCCTGCA GCCTCTCCTG GAACGTGATC
    CGCCACAGCC TGCAGAAGCT ACGCTTGGTA CGCTGGCTGC TCAAAAAAGT CTTGCAGCGC
    TGGCGGGCCA CCCCTGCCAC TGCATCTGGC TTCGAGGATG AAGCAAAGAG CAGTGCGAGG
    GATGCAGCCC TGGCCTATCA TCGGCTACAC CAGCTGCATA TCACAGGGAA GCTTCCTGCT
    GGATCTGCCT GTTCAGATGT ACACATGGCT TTGTGTGCTG TGAACCTAGC TGAATGTGCC
    GAGGAGAAAA TCCCACCCAG TACACTGATT GAGATCCACC TGACAGCTGC CATGGGGCTC
    AAGACCCGGT GTGGAGGCAA GCTGGGCTTC TTGGCTAGCT ACTTCCTCAG TCGTGCCCAG
    AGTCTGTGTG GCCCAGAGCA CAGCACTGTC CCTGACTCCC TACGCTGGCT CTGCCACCCC
    TTGGGCCAGA AGTTTTTCAT GGAGCGAAGC TGGTCCGTGA AGTCAGCAGC CAAAGAGAGC
    CTGTTCTGTG CCCAGAGGAA CCCAGCTGAC CCCATCGCCC AGGTCCACCA GGCCTTCTGC
    AAGAACCTGC TGGAACGAGC TGTGGAATCC TTGGTGAAAC CTCAGACCAA GAAGAAGGCA
    GGAGACCAGG AAGAAGAGAG CTGTGAGTTT TCCAGTGCCC TGGAGTACTT GAAATTACTT
    CATTCTTTTG TGGATTCTGT GGGATTTGTG ACCCCACCAT TCTCCAGCAG TTCTGTGCTC
    AAGTCAGCCC TTGGTCCAGA TACCATCTGT CGGTGGTGGA CATCCGCAAT TACTATGGCC
    ATCAGCTGGC TCCAAGGAGA TGATGCAGCT GTGCGCTCTC ATTTTACAGA AGTAGAACGG
    GTCCCCAAGG CCCTGGAAGT GACTGAGAGT CCCTTGGTAA AGGCTGTCTT CTACACCTGT
    AGAGCCATGC ATGCCTCGCT CTCTGGAAAA GCAGATGGGC AACAGAATTC CTTCCGTCAT
    TGTGAGAGGG CCAGTGGTCA CCTGTGGAGC AGTCTCAATG TCACCGGAGC CACCCCTGAT
    CCTGCCCTTA ACCACGTGGT CCAGCTGCTC ACCTGTGACC TACTACTGTC ACTGCGGACA
    GCACTTTGGC AAAAGCAGGC AAGCACCGGC CAGGTCCTGG GCGAGACCTA CCATGCATCA
    GGCACTGAAC TGGCTGGCTT CCAGCGGGAC CTGGGCAGCC TGCGCAGGCT AGCTCATAGC
    TTCCGCCCAG CATACCGCAA GGTGTTCCTG CATGAAGCCA CTGTGCGCTT GATGGCAGGA
    GCCAGCCCCA CCCGGACTCA CCAGCTGCTG GAGCATAGCC TGAGGCGGCG CACCACTCAG
    AACACCAAGC ATGGAGAGGT GGACACCTGG CCTGGCCAGC GAGAGCGGGC CACTGCCATC
    CTACTGGCCT GCCGCCATCT TCCCATCTCC TTCCTGTCTT CCCCAGGCCA GCGGGCAGTG
    CTGCTGGCCG AAGCTGCCCG CACCCTGGAG AAGGTGGGTG ACCGGCGTTC CTGCAACGAC
    TGCCAGCAGA TGCTCGTCAA GCTGGGTGGT GGCACTGCCA TTGCTGCCTC CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017656516.1
    CDS72..3425
    Translation

    Target ORF information:

    RefSeq Version XM_017801027.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_017801027.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGTTATGGA AAAATCAGAG ACCAACGCTG ATGTCAGAGA TGCTGCAGTT TGTCAGCAAT 
    CAAGTGGGAG AGTTCCCAGA TTTGTTTTCA GAGCAGCTCT GCAGTTCCTT CCCTGGAGGC
    GGTGGCAGTG GCAGCAATGG CGGCGGAGGC GCCAGCAGCA GTGGTAGAAG CAGCAGTGGT
    GGAGCTGCAG ACACCTCGGT TCAGCGGCCA TTCAGCCAGG TCCCGTTACC TACCTTCTCT
    CCTTCAGCTG CCTCCCCTCA GGCTCCAGCC CTTCAGGTCA AGGTCTCGCC CTCCACTGTA
    CCCACCCCGC CCCGTGCAAC GCCTATTCTC CAGCCCCGAC CCCAGCCCCA GCCTCCAGCT
    CAGCTGCAGC AGCAGACGGT AATGATCACC CCAACATTCA GTACTGCTCC ACAGACGAGG
    ATCATCCAGC AGCCTTTGAT ATACCAGAAT GCAGCTACCA GCTTTCAAGT CCTTCAGCCT
    CAAGTCCAAA GCCTGGTGAC ATCTTCGCAG GTACAGCCAG TCACCATCCA GCAGCAGGTG
    CAGACAGTAC AGGCGCAGCG TGTGTTGACA CAAACAGCTA ACGGCACATT GCAGACCCTT
    GCCCCAGCCA CAGTGCAGAC AGTTGCTGCG CCCCAGGTGC AGCAGGTCCC GGTCCTCGTC
    CAACCTCAGA TCATTAAGAC AGATTCCCTT GTTTTGACCA CTCTGAAAAC AGATGGCAGC
    CCTGTCATGG CTGCAGTCCA GAACCCAGCC CTCACTGCTC TCACCACCCC CATCCAGACA
    GCGGCCCTTC AAGTACCAAC TCTAGTGGGC AGCAGTGGGA CCATTCTGAC CACAATGCCT
    GTAATGATGG GACAAGAGAA AGTTCCTATT AAGCAAGTAC CCGGCGGTGT CAAGCAGCTG
    GAGCCCCCCA AAGAAGGAGA AAGGCGGACA ACACACAACA TCATTGAAAA GCGATACCGG
    TCCTCTATCA ATGACAAAAT CATTGAGTTG AAGGACTTGG TCATGGGCAC AGATGCCAAG
    ATGCACAAGT CTGGCGTCCT GAGGAAGGCC ATTGATTATA TCAAATACTT GCAGCAGGTC
    AATCACAAGC TACGCCAGGA GAACATGGTG CTGAAGCTGG CAAATCAGAA AAACAAGCTC
    CTGAAGGGCA TTGACCTGGG CAGCCTGGTG GACAGTGATA TGGACCTGAA GATTGATGAC
    TTTAATCAGA ATGTCCTTCT GATGTCTCCC CCAGCCTCTG ACTCAGGGTC TCAGGCTGGC
    TTCTCCCCCT ATTCCATTGA CTCTGAGCCA GGAAGTCCTC TGTTGGATGA TGCAAAGGTC
    AAAGATGAAC CAGACTCTCC TCCTGTAGCA CTTGGCATGG TGGACCGCTC TCGAATTCTG
    TTATGTGTCC TTACCTTCTT GGGCCTCTCC TTTAACCCCC TGACTTCCCT GCTGCAATGG
    GGAGGCGCCC ATGACGACCA GCACCCATAC TCAGGCTCTG GCCGTAGTGT ACTATCATTG
    GAGTCAGGTT CTGGGGGCTG GTTTGACTGG ATGATGCCAA CTCTCCTCCT GTGGCTGGTA
    AATGGTGTGA TTGTCTTGAG CGTCTTTGTG AAGCTGTTGG TCCACGGGGA GCCAGTGATC
    CGGCCACACT CACGCTCCTC AGTCACCTTC TGGAGGCACC GGAAGCAGGC AGACCTAGAC
    CTTGCCAAAG GGGATTTTGC AGCTGCTGCA GCCAACCTAC AAACCTGCTT GTCGGTTTTG
    GGCCGGGCGC TGCCCACCTC CCGCCTGGAC TTGGCCTGCA GCCTCTCCTG GAACGTGATC
    CGCCACAGCC TGCAGAAGCT ACGCTTGGTA CGCTGGCTGC TCAAAAAAGT CTTGCAGCGC
    TGGCGGGCCA CCCCTGCCAC TGCATCTGGC TTCGAGGATG AAGCAAAGAG CAGTGCGAGG
    GATGCAGCCC TGGCCTATCA TCGGCTACAC CAGCTGCATA TCACAGGGAA GCTTCCTGCT
    GGATCTGCCT GTTCAGATGT ACACATGGCT TTGTGTGCTG TGAACCTAGC TGAATGTGCC
    GAGGAGAAAA TCCCACCCAG TACACTGATT GAGATCCACC TGACAGCTGC CATGGGGCTC
    AAGACCCGGT GTGGAGGCAA GCTGGGCTTC TTGGCTAGCT ACTTCCTCAG TCGTGCCCAG
    AGTCTGTGTG GCCCAGAGCA CAGCACTGTC CCTGACTCCC TACGCTGGCT CTGCCACCCC
    TTGGGCCAGA AGTTTTTCAT GGAGCGAAGC TGGTCCGTGA AGTCAGCAGC CAAAGAGAGC
    CTGTTCTGTG CCCAGAGGAA CCCAGCTGAC CCCATCGCCC AGGTCCACCA GGCCTTCTGC
    AAGAACCTGC TGGAACGAGC TGTGGAATCC TTGGTGAAAC CTCAGACCAA GAAGAAGGCA
    GGAGACCAGG AAGAAGAGAG CTGTGAGTTT TCCAGTGCCC TGGAGTACTT GAAATTACTT
    CATTCTTTTG TGGATTCTGT GGGATTTGTG ACCCCACCAT TCTCCAGCAG TTCTGTGCTC
    AAGTCAGCCC TTGGTCCAGA TACCATCTGT CGGTGGTGGA CATCCGCAAT TACTATGGCC
    ATCAGCTGGC TCCAAGGAGA TGATGCAGCT GTGCGCTCTC ATTTTACAGA AGTAGAACGG
    GTCCCCAAGG CCCTGGAAGT GACTGAGAGT CCCTTGGTAA AGGCTGTCTT CTACACCTGT
    AGAGCCATGC ATGCCTCGCT CTCTGGAAAA GCAGATGGGC AACAGAATTC CTTCCGTCAT
    TGTGAGAGGG CCAGTGGTCA CCTGTGGAGC AGTCTCAATG TCACCGGAGC CACCCCTGAT
    CCTGCCCTTA ACCACGTGGT CCAGCTGCTC ACCTGTGACC TACTACTGTC ACTGCGGACA
    GCACTTTGGC AAAAGCAGGC AAGCACCGGC CAGGTCCTGG GCGAGACCTA CCATGCATCA
    GGCACTGAAC TGGCTGGCTT CCAGCGGGAC CTGGGCAGCC TGCGCAGGCT AGCTCATAGC
    TTCCGCCCAG CATACCGCAA GGTGTTCCTG CATGAAGCCA CTGTGCGCTT GATGGCAGGA
    GCCAGCCCCA CCCGGACTCA CCAGCTGCTG GAGCATAGCC TGAGGCGGCG CACCACTCAG
    AACACCAAGC ATGGAGAGGT GGACACCTGG CCTGGCCAGC GAGAGCGGGC CACTGCCATC
    CTACTGGCCT GCCGCCATCT TCCCATCTCC TTCCTGTCTT CCCCAGGCCA GCGGGCAGTG
    CTGCTGGCCG AAGCTGCCCG CACCCTGGAG AAGGTGGGTG ACCGGCGTTC CTGCAACGAC
    TGCCAGCAGA TGCTCGTCAA GCTGGGTGGT GGCACTGCCA TTGCTGCCTC CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa28006
    Clone ID Related Accession (Same CDS sequence) XM_029569134.1 , XM_017801027.1 , XM_029569133.1
    Accession Version XM_029569133.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3354bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product sterol regulatory element-binding protein 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008348199.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGTTATGGA AAAATCAGAG ACCAACGCTG ATGTCAGAGA TGCTGCAGTT TGTCAGCAAT 
    CAAGTGGGAG AGTTCCCAGA TTTGTTTTCA GAGCAGCTCT GCAGTTCCTT CCCTGGAGGC
    GGTGGCAGTG GCAGCAATGG CGGCGGAGGC GCCAGCAGCA GTGGTAGAAG CAGCAGTGGT
    GGAGCTGCAG ACACCTCGGT TCAGCGGCCA TTCAGCCAGG TCCCGTTACC TACCTTCTCT
    CCTTCAGCTG CCTCCCCTCA GGCTCCAGCC CTTCAGGTCA AGGTCTCGCC CTCCACTGTA
    CCCACCCCGC CCCGTGCAAC GCCTATTCTC CAGCCCCGAC CCCAGCCCCA GCCTCCAGCT
    CAGCTGCAGC AGCAGACGGT AATGATCACC CCAACATTCA GTACTGCTCC ACAGACGAGG
    ATCATCCAGC AGCCTTTGAT ATACCAGAAT GCAGCTACCA GCTTTCAAGT CCTTCAGCCT
    CAAGTCCAAA GCCTGGTGAC ATCTTCGCAG GTACAGCCAG TCACCATCCA GCAGCAGGTG
    CAGACAGTAC AGGCGCAGCG TGTGTTGACA CAAACAGCTA ACGGCACATT GCAGACCCTT
    GCCCCAGCCA CAGTGCAGAC AGTTGCTGCG CCCCAGGTGC AGCAGGTCCC GGTCCTCGTC
    CAACCTCAGA TCATTAAGAC AGATTCCCTT GTTTTGACCA CTCTGAAAAC AGATGGCAGC
    CCTGTCATGG CTGCAGTCCA GAACCCAGCC CTCACTGCTC TCACCACCCC CATCCAGACA
    GCGGCCCTTC AAGTACCAAC TCTAGTGGGC AGCAGTGGGA CCATTCTGAC CACAATGCCT
    GTAATGATGG GACAAGAGAA AGTTCCTATT AAGCAAGTAC CCGGCGGTGT CAAGCAGCTG
    GAGCCCCCCA AAGAAGGAGA AAGGCGGACA ACACACAACA TCATTGAAAA GCGATACCGG
    TCCTCTATCA ATGACAAAAT CATTGAGTTG AAGGACTTGG TCATGGGCAC AGATGCCAAG
    ATGCACAAGT CTGGCGTCCT GAGGAAGGCC ATTGATTATA TCAAATACTT GCAGCAGGTC
    AATCACAAGC TACGCCAGGA GAACATGGTG CTGAAGCTGG CAAATCAGAA AAACAAGCTC
    CTGAAGGGCA TTGACCTGGG CAGCCTGGTG GACAGTGATA TGGACCTGAA GATTGATGAC
    TTTAATCAGA ATGTCCTTCT GATGTCTCCC CCAGCCTCTG ACTCAGGGTC TCAGGCTGGC
    TTCTCCCCCT ATTCCATTGA CTCTGAGCCA GGAAGTCCTC TGTTGGATGA TGCAAAGGTC
    AAAGATGAAC CAGACTCTCC TCCTGTAGCA CTTGGCATGG TGGACCGCTC TCGAATTCTG
    TTATGTGTCC TTACCTTCTT GGGCCTCTCC TTTAACCCCC TGACTTCCCT GCTGCAATGG
    GGAGGCGCCC ATGACGACCA GCACCCATAC TCAGGCTCTG GCCGTAGTGT ACTATCATTG
    GAGTCAGGTT CTGGGGGCTG GTTTGACTGG ATGATGCCAA CTCTCCTCCT GTGGCTGGTA
    AATGGTGTGA TTGTCTTGAG CGTCTTTGTG AAGCTGTTGG TCCACGGGGA GCCAGTGATC
    CGGCCACACT CACGCTCCTC AGTCACCTTC TGGAGGCACC GGAAGCAGGC AGACCTAGAC
    CTTGCCAAAG GGGATTTTGC AGCTGCTGCA GCCAACCTAC AAACCTGCTT GTCGGTTTTG
    GGCCGGGCGC TGCCCACCTC CCGCCTGGAC TTGGCCTGCA GCCTCTCCTG GAACGTGATC
    CGCCACAGCC TGCAGAAGCT ACGCTTGGTA CGCTGGCTGC TCAAAAAAGT CTTGCAGCGC
    TGGCGGGCCA CCCCTGCCAC TGCATCTGGC TTCGAGGATG AAGCAAAGAG CAGTGCGAGG
    GATGCAGCCC TGGCCTATCA TCGGCTACAC CAGCTGCATA TCACAGGGAA GCTTCCTGCT
    GGATCTGCCT GTTCAGATGT ACACATGGCT TTGTGTGCTG TGAACCTAGC TGAATGTGCC
    GAGGAGAAAA TCCCACCCAG TACACTGATT GAGATCCACC TGACAGCTGC CATGGGGCTC
    AAGACCCGGT GTGGAGGCAA GCTGGGCTTC TTGGCTAGCT ACTTCCTCAG TCGTGCCCAG
    AGTCTGTGTG GCCCAGAGCA CAGCACTGTC CCTGACTCCC TACGCTGGCT CTGCCACCCC
    TTGGGCCAGA AGTTTTTCAT GGAGCGAAGC TGGTCCGTGA AGTCAGCAGC CAAAGAGAGC
    CTGTTCTGTG CCCAGAGGAA CCCAGCTGAC CCCATCGCCC AGGTCCACCA GGCCTTCTGC
    AAGAACCTGC TGGAACGAGC TGTGGAATCC TTGGTGAAAC CTCAGACCAA GAAGAAGGCA
    GGAGACCAGG AAGAAGAGAG CTGTGAGTTT TCCAGTGCCC TGGAGTACTT GAAATTACTT
    CATTCTTTTG TGGATTCTGT GGGATTTGTG ACCCCACCAT TCTCCAGCAG TTCTGTGCTC
    AAGTCAGCCC TTGGTCCAGA TACCATCTGT CGGTGGTGGA CATCCGCAAT TACTATGGCC
    ATCAGCTGGC TCCAAGGAGA TGATGCAGCT GTGCGCTCTC ATTTTACAGA AGTAGAACGG
    GTCCCCAAGG CCCTGGAAGT GACTGAGAGT CCCTTGGTAA AGGCTGTCTT CTACACCTGT
    AGAGCCATGC ATGCCTCGCT CTCTGGAAAA GCAGATGGGC AACAGAATTC CTTCCGTCAT
    TGTGAGAGGG CCAGTGGTCA CCTGTGGAGC AGTCTCAATG TCACCGGAGC CACCCCTGAT
    CCTGCCCTTA ACCACGTGGT CCAGCTGCTC ACCTGTGACC TACTACTGTC ACTGCGGACA
    GCACTTTGGC AAAAGCAGGC AAGCACCGGC CAGGTCCTGG GCGAGACCTA CCATGCATCA
    GGCACTGAAC TGGCTGGCTT CCAGCGGGAC CTGGGCAGCC TGCGCAGGCT AGCTCATAGC
    TTCCGCCCAG CATACCGCAA GGTGTTCCTG CATGAAGCCA CTGTGCGCTT GATGGCAGGA
    GCCAGCCCCA CCCGGACTCA CCAGCTGCTG GAGCATAGCC TGAGGCGGCG CACCACTCAG
    AACACCAAGC ATGGAGAGGT GGACACCTGG CCTGGCCAGC GAGAGCGGGC CACTGCCATC
    CTACTGGCCT GCCGCCATCT TCCCATCTCC TTCCTGTCTT CCCCAGGCCA GCGGGCAGTG
    CTGCTGGCCG AAGCTGCCCG CACCCTGGAG AAGGTGGGTG ACCGGCGTTC CTGCAACGAC
    TGCCAGCAGA TGCTCGTCAA GCTGGGTGGT GGCACTGCCA TTGCTGCCTC CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029424993.1
    CDS474..3827
    Translation

    Target ORF information:

    RefSeq Version XM_029569133.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili sterol regulatory element binding transcription factor 2 (Srebf2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029569133.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGTTATGGA AAAATCAGAG ACCAACGCTG ATGTCAGAGA TGCTGCAGTT TGTCAGCAAT 
    CAAGTGGGAG AGTTCCCAGA TTTGTTTTCA GAGCAGCTCT GCAGTTCCTT CCCTGGAGGC
    GGTGGCAGTG GCAGCAATGG CGGCGGAGGC GCCAGCAGCA GTGGTAGAAG CAGCAGTGGT
    GGAGCTGCAG ACACCTCGGT TCAGCGGCCA TTCAGCCAGG TCCCGTTACC TACCTTCTCT
    CCTTCAGCTG CCTCCCCTCA GGCTCCAGCC CTTCAGGTCA AGGTCTCGCC CTCCACTGTA
    CCCACCCCGC CCCGTGCAAC GCCTATTCTC CAGCCCCGAC CCCAGCCCCA GCCTCCAGCT
    CAGCTGCAGC AGCAGACGGT AATGATCACC CCAACATTCA GTACTGCTCC ACAGACGAGG
    ATCATCCAGC AGCCTTTGAT ATACCAGAAT GCAGCTACCA GCTTTCAAGT CCTTCAGCCT
    CAAGTCCAAA GCCTGGTGAC ATCTTCGCAG GTACAGCCAG TCACCATCCA GCAGCAGGTG
    CAGACAGTAC AGGCGCAGCG TGTGTTGACA CAAACAGCTA ACGGCACATT GCAGACCCTT
    GCCCCAGCCA CAGTGCAGAC AGTTGCTGCG CCCCAGGTGC AGCAGGTCCC GGTCCTCGTC
    CAACCTCAGA TCATTAAGAC AGATTCCCTT GTTTTGACCA CTCTGAAAAC AGATGGCAGC
    CCTGTCATGG CTGCAGTCCA GAACCCAGCC CTCACTGCTC TCACCACCCC CATCCAGACA
    GCGGCCCTTC AAGTACCAAC TCTAGTGGGC AGCAGTGGGA CCATTCTGAC CACAATGCCT
    GTAATGATGG GACAAGAGAA AGTTCCTATT AAGCAAGTAC CCGGCGGTGT CAAGCAGCTG
    GAGCCCCCCA AAGAAGGAGA AAGGCGGACA ACACACAACA TCATTGAAAA GCGATACCGG
    TCCTCTATCA ATGACAAAAT CATTGAGTTG AAGGACTTGG TCATGGGCAC AGATGCCAAG
    ATGCACAAGT CTGGCGTCCT GAGGAAGGCC ATTGATTATA TCAAATACTT GCAGCAGGTC
    AATCACAAGC TACGCCAGGA GAACATGGTG CTGAAGCTGG CAAATCAGAA AAACAAGCTC
    CTGAAGGGCA TTGACCTGGG CAGCCTGGTG GACAGTGATA TGGACCTGAA GATTGATGAC
    TTTAATCAGA ATGTCCTTCT GATGTCTCCC CCAGCCTCTG ACTCAGGGTC TCAGGCTGGC
    TTCTCCCCCT ATTCCATTGA CTCTGAGCCA GGAAGTCCTC TGTTGGATGA TGCAAAGGTC
    AAAGATGAAC CAGACTCTCC TCCTGTAGCA CTTGGCATGG TGGACCGCTC TCGAATTCTG
    TTATGTGTCC TTACCTTCTT GGGCCTCTCC TTTAACCCCC TGACTTCCCT GCTGCAATGG
    GGAGGCGCCC ATGACGACCA GCACCCATAC TCAGGCTCTG GCCGTAGTGT ACTATCATTG
    GAGTCAGGTT CTGGGGGCTG GTTTGACTGG ATGATGCCAA CTCTCCTCCT GTGGCTGGTA
    AATGGTGTGA TTGTCTTGAG CGTCTTTGTG AAGCTGTTGG TCCACGGGGA GCCAGTGATC
    CGGCCACACT CACGCTCCTC AGTCACCTTC TGGAGGCACC GGAAGCAGGC AGACCTAGAC
    CTTGCCAAAG GGGATTTTGC AGCTGCTGCA GCCAACCTAC AAACCTGCTT GTCGGTTTTG
    GGCCGGGCGC TGCCCACCTC CCGCCTGGAC TTGGCCTGCA GCCTCTCCTG GAACGTGATC
    CGCCACAGCC TGCAGAAGCT ACGCTTGGTA CGCTGGCTGC TCAAAAAAGT CTTGCAGCGC
    TGGCGGGCCA CCCCTGCCAC TGCATCTGGC TTCGAGGATG AAGCAAAGAG CAGTGCGAGG
    GATGCAGCCC TGGCCTATCA TCGGCTACAC CAGCTGCATA TCACAGGGAA GCTTCCTGCT
    GGATCTGCCT GTTCAGATGT ACACATGGCT TTGTGTGCTG TGAACCTAGC TGAATGTGCC
    GAGGAGAAAA TCCCACCCAG TACACTGATT GAGATCCACC TGACAGCTGC CATGGGGCTC
    AAGACCCGGT GTGGAGGCAA GCTGGGCTTC TTGGCTAGCT ACTTCCTCAG TCGTGCCCAG
    AGTCTGTGTG GCCCAGAGCA CAGCACTGTC CCTGACTCCC TACGCTGGCT CTGCCACCCC
    TTGGGCCAGA AGTTTTTCAT GGAGCGAAGC TGGTCCGTGA AGTCAGCAGC CAAAGAGAGC
    CTGTTCTGTG CCCAGAGGAA CCCAGCTGAC CCCATCGCCC AGGTCCACCA GGCCTTCTGC
    AAGAACCTGC TGGAACGAGC TGTGGAATCC TTGGTGAAAC CTCAGACCAA GAAGAAGGCA
    GGAGACCAGG AAGAAGAGAG CTGTGAGTTT TCCAGTGCCC TGGAGTACTT GAAATTACTT
    CATTCTTTTG TGGATTCTGT GGGATTTGTG ACCCCACCAT TCTCCAGCAG TTCTGTGCTC
    AAGTCAGCCC TTGGTCCAGA TACCATCTGT CGGTGGTGGA CATCCGCAAT TACTATGGCC
    ATCAGCTGGC TCCAAGGAGA TGATGCAGCT GTGCGCTCTC ATTTTACAGA AGTAGAACGG
    GTCCCCAAGG CCCTGGAAGT GACTGAGAGT CCCTTGGTAA AGGCTGTCTT CTACACCTGT
    AGAGCCATGC ATGCCTCGCT CTCTGGAAAA GCAGATGGGC AACAGAATTC CTTCCGTCAT
    TGTGAGAGGG CCAGTGGTCA CCTGTGGAGC AGTCTCAATG TCACCGGAGC CACCCCTGAT
    CCTGCCCTTA ACCACGTGGT CCAGCTGCTC ACCTGTGACC TACTACTGTC ACTGCGGACA
    GCACTTTGGC AAAAGCAGGC AAGCACCGGC CAGGTCCTGG GCGAGACCTA CCATGCATCA
    GGCACTGAAC TGGCTGGCTT CCAGCGGGAC CTGGGCAGCC TGCGCAGGCT AGCTCATAGC
    TTCCGCCCAG CATACCGCAA GGTGTTCCTG CATGAAGCCA CTGTGCGCTT GATGGCAGGA
    GCCAGCCCCA CCCGGACTCA CCAGCTGCTG GAGCATAGCC TGAGGCGGCG CACCACTCAG
    AACACCAAGC ATGGAGAGGT GGACACCTGG CCTGGCCAGC GAGAGCGGGC CACTGCCATC
    CTACTGGCCT GCCGCCATCT TCCCATCTCC TTCCTGTCTT CCCCAGGCCA GCGGGCAGTG
    CTGCTGGCCG AAGCTGCCCG CACCCTGGAG AAGGTGGGTG ACCGGCGTTC CTGCAACGAC
    TGCCAGCAGA TGCTCGTCAA GCTGGGTGGT GGCACTGCCA TTGCTGCCTC CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.